Anterior reduz o tempo de revisão clínica em 75% com Amazon Bedrock e Llama
por Harshvardhan Chunawala, Chakravarthy Nagarajan, Khadija Mahmoud, Anuj Iravane | 22 de abril de 2026
Transformando centenas de páginas em insights clínicos acionáveis
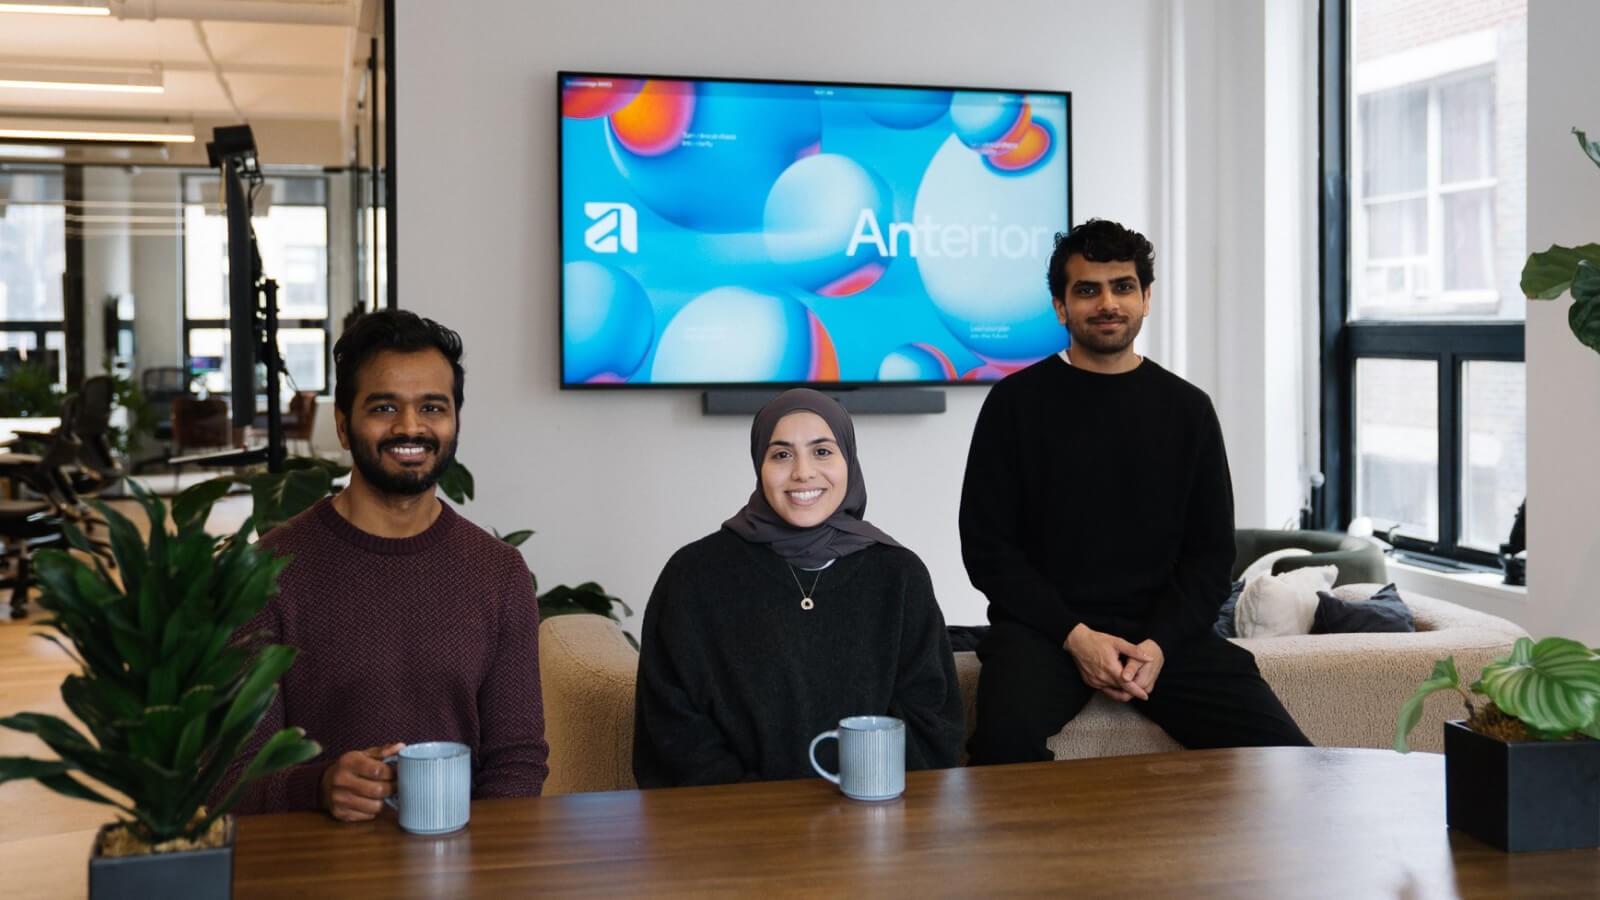
Anterior, uma empresa de IA liderada por médicos que cria automação para pagadores de serviços de saúde (seguradoras), decidiu resolver um dos problemas de dados mais difíceis da área de saúde: identificar e estruturar documentos clínicos que geralmente chegam como centenas de páginas de registros não estruturados. Depois de implementar os modelos Llama da Meta no Amazon Bedrock para potencializar a identificação de documentos nos ambientes Amazon Web Services (AWS) dos clientes, a Anterior alcançou um desempenho de nível de produção enquanto atendia aos rígidos requisitos de governança de dados de saúde. Usando essa abordagem, a Anterior forneceu a extração completa de documentos, melhorou a precisão dos metadados e permitiu a automação posterior que reduz a revisão clínica manual em 75 por cento.
Enfrentando o desafio de identificação de documentos da área de
Os custos administrativos de saúde nos Estados Unidos excedem 950 bilhões de dólares por ano em um setor de 5 trilhões de dólares. Grande parte dessa carga vem dos fluxos de trabalho de revisão clínica dentro dos planos de saúde, nos quais médicos e enfermeiros revisam manualmente grandes pacotes de registros médicos para aprovar tratamentos, verificar a cobertura e gerenciar o atendimento ao paciente. A Anterior é uma empresa de IA liderada por médicos focada em automatizar esses fluxos de trabalho para pagadores de serviços de saúde, organizações que estão na interseção de provedores e pacientes.
No centro desses fluxos de trabalho está uma tarefa que parece aparentemente simples: antes que a IA possa raciocinar sobre um caso clínico, ela precisa entender o que está vendo. A identificação de documentos é o pré-requisito para toda automação posterior. A Anterior deve segmentar cada pacote clínico recebido em seus documentos constituintes, identificar onde cada um começa e termina e extrair metadados estruturados, incluindo tipo de documento, título, autor e data de criação. Somente então a automação clínica pode prosseguir, seja encaminhando um relatório de ressonância magnética para a etapa certa em uma revisão de autorização prévia, exibindo imagens recentes para um médico ou verificando se a documentação apóia um tratamento recomendado. No entanto, os pacotes clínicos podem ter centenas de páginas e chegar como faxes, PDFs digitalizados e arquivos mesclados de vários documentos. Eles podem combinar imagens, tabelas, formulários e até notas manuscritas de uma forma que as abordagens tradicionais de IA e ML há muito se esforçam para lidar de forma confiável em escala de produção.
Os riscos de errar são altos. “Mesmo pequenos erros na identificação de documentos podem ocorrer em cascata, porque você está baseando as decisões clínicas em informações incompletas ou incorretas”, disse Khadija Mahmoud, MD, cientista clínica da Anterior. Um limite de documento identificado incorretamente pode significar a descoberta de informações clínicas da parte errada do prontuário de um paciente, enquanto uma página perdida pode criar uma lacuna de conformidade. Qualquer modelo capaz de lidar com a identificação de documentos de nível de produção também precisa atender a requisitos rígidos de governança de dados de saúde. Muitos dos maiores clientes da Anterior exigem que todo o processamento de IA, incluindo a inferência de LLM sobre informações protegidas de saúde (PHI), ocorra inteiramente em seu ambiente da AWS, tornando inaceitáveis APIs externas ou infraestrutura de terceiros.
Construindo um pipeline escalável para automação clínica
A Anterior implementou um fluxo de trabalho de identificação de documentos baseado em modelos Meta Llama executados no Amazon Bedrock. Essa arquitetura processa pacotes complexos de documentos clínicos de ponta a ponta no ambiente AWS de um cliente, para que os dados do paciente nunca saiam desse limite. O fluxo de trabalho funciona como um pipeline de dois estágios. No primeiro estágio, grandes PDFs clínicos são processados usando reconhecimento óptico de caracteres (OCR) e análise com reconhecimento de layout. Cada página é convertida em extratos de texto estruturado, preservando as referências da página e os identificadores exclusivos. No segundo estágio, um modelo de linguagem analisa esses extratos analisados para determinar os limites do documento, classificar o tipo de documento e extrair metadados como título, autor, data de criação e uma descrição clínica. É nesse estágio que os modelos Llama na Amazon Bedrock fazem o trabalho.
A Anteriormente avaliou o Llama 4 Maverick 17B e o Llama 4 Scout 17B em relação a um modelo multimodal proprietário em escala de fronteira usando prompts, conjuntos de dados e critérios de avaliação idênticos. A avaliação foi executada inteiramente dentro da infraestrutura da AWS e mediu a prontidão da produção em termos de precisão, integridade, consistência e latência. Os conjuntos de dados foram gerados por meio do pipeline de dados sintéticos da Anterior e selecionados por cientistas clínicos para refletir a complexidade do mundo real: formatação ambígua, pacotes de vários documentos e casos extremos. O Llama era um forte candidato por vários motivos: ele suporta entradas multimodais (que se alinham à natureza inerentemente multimodal dos dados clínicos), permite inferências eficientes para cargas de trabalho de alto rendimento e oferece uma grande janela de contexto que lida confortavelmente com pacotes clínicos longos. Também está entre os modelos de peso aberto mais ajustáveis disponíveis, permitindo que a Anterior adapte o comportamento do modelo por meio de restrições de solicitação e de nível de sistema e explore modelos menores e especializados, ajustados a tarefas clínicas específicas, em vez de depender apenas de modelos em escala de fronteira.
Administrar o Llama no Amazon Bedrock permitiu que a equipe de médicos e engenheiros da empresa se concentrasse na solução do problema clínico em vez de gerenciar a infraestrutura. O Bedrock fornece uma interface unificada para avaliar e implantar modelos básicos e, ao mesmo tempo, integrar-se diretamente aos ambientes da AWS. “Muitos dos principais planos de saúde com os quais trabalhamos fazem a mesma pergunta: 'Podemos executar IA em PHI em nosso ambiente da AWS? ' Os modelos Llama hospedados na Bedrock permitem que digamos sim sem comprometer o desempenho”, disse Anuj Iravane, líder de IA aplicada na Anterior. O Bedrock também preserva a flexibilidade: a Anterior pode avaliar modelos adicionais ou implantar versões personalizadas e ajustadas à medida que os requisitos clínicos evoluem, sem reconstruir sua arquitetura.
Acelerando as decisões clínicas e a eficiência operacional
Em um conjunto de dados de casos clínicos sintéticos curados por médicos, tanto o Llama 4 Maverick 17B quanto o Llama 4 Scout 17B apresentaram desempenho de nível de produção para identificação de documentos clínicos. Os modelos combinaram um modelo em escala de fronteira com centenas de bilhões de parâmetros enquanto funcionavam com mais eficiência, apesar de usarem 17B de parâmetros ativos em arquiteturas de modelos maiores. Eles alcançaram uma cobertura completa da página, o que significa que cada página em um pacote clínico foi atribuída exatamente uma vez, sem conteúdo descartado ou duplicado. Os resultados foram particularmente fortes na extração de metadados. Os modelos Lhama corresponderam ou excederam a linha de base da fronteira ao identificar informações importantes, como autoria e descrições de documentos. A precisão da identificação do autor chegou a 97 por cento, em comparação com 93,5% no modelo de fronteira, enquanto a fidelidade da descrição atingiu 98,4 por cento. “Ficamos impressionados”, disse Iravane. “Os modelos Llama no Bedrock igualaram nossa linha de base de fronteira por uma fração do custo — e, na extração de metadados, eles realmente superaram essa meta. Você não precisa do maior modelo para resolver os problemas mais difíceis da área de saúde.”
A latência entre os modelos era comparável, mas as vantagens de eficiência dos modelos Llama menores executados em Bedrock são compostas em grande escala. À medida que os volumes de documentos aumentam, a Anterior pode processar mais casos por unidade de computação a um custo menor por documento sem sacrificar a precisão. O impacto posterior nos fluxos de trabalho de saúde é significativo. Na revisão prévia da autorização, a plataforma Anterior reduz o tempo de revisão clínica manual em 75 por cento, mantendo a precisão clínica de 99,24 por cento. Um estudo de caso da KLAS Research descobriu que o sistema reduziu o tempo de espera dos pacientes pela aprovação do tratamento do câncer de dias ou semanas para apenas 155 segundos. Para uma organização regional de saúde que atende cerca de um milhão de vidas cobertas, essas melhorias se traduzem em aproximadamente 30 milhões de dólares em economias operacionais anuais. Em última análise, uma compreensão mais rápida dos documentos significa decisões clínicas mais rápidas e acesso mais rápido aos cuidados dos pacientes.
A Anterior passou da integração inicial para a implantação em seis semanas. Os modelos Llama agora fazem parte do fluxo de trabalho de identificação de documentos de produção da empresa, atendendo a vários clientes corporativos. Os resultados também validaram uma abordagem arquitetônica mais ampla: que modelos menores de peso aberto hospedados no Amazon Bedrock podem competir com modelos de uso geral em escala de fronteira em todos os fluxos de trabalho de saúde. “Grande parte do setor de saúde dos EUA vive na AWS”, disse Iravane. “Provar que os modelos Llama no Bedrock podem igualar o desempenho de ponta significa que nossos clientes podem implantar mais rapidamente, controlar melhor os custos e manter a postura de segurança de que precisam.”
Harshvardhan Chunawala
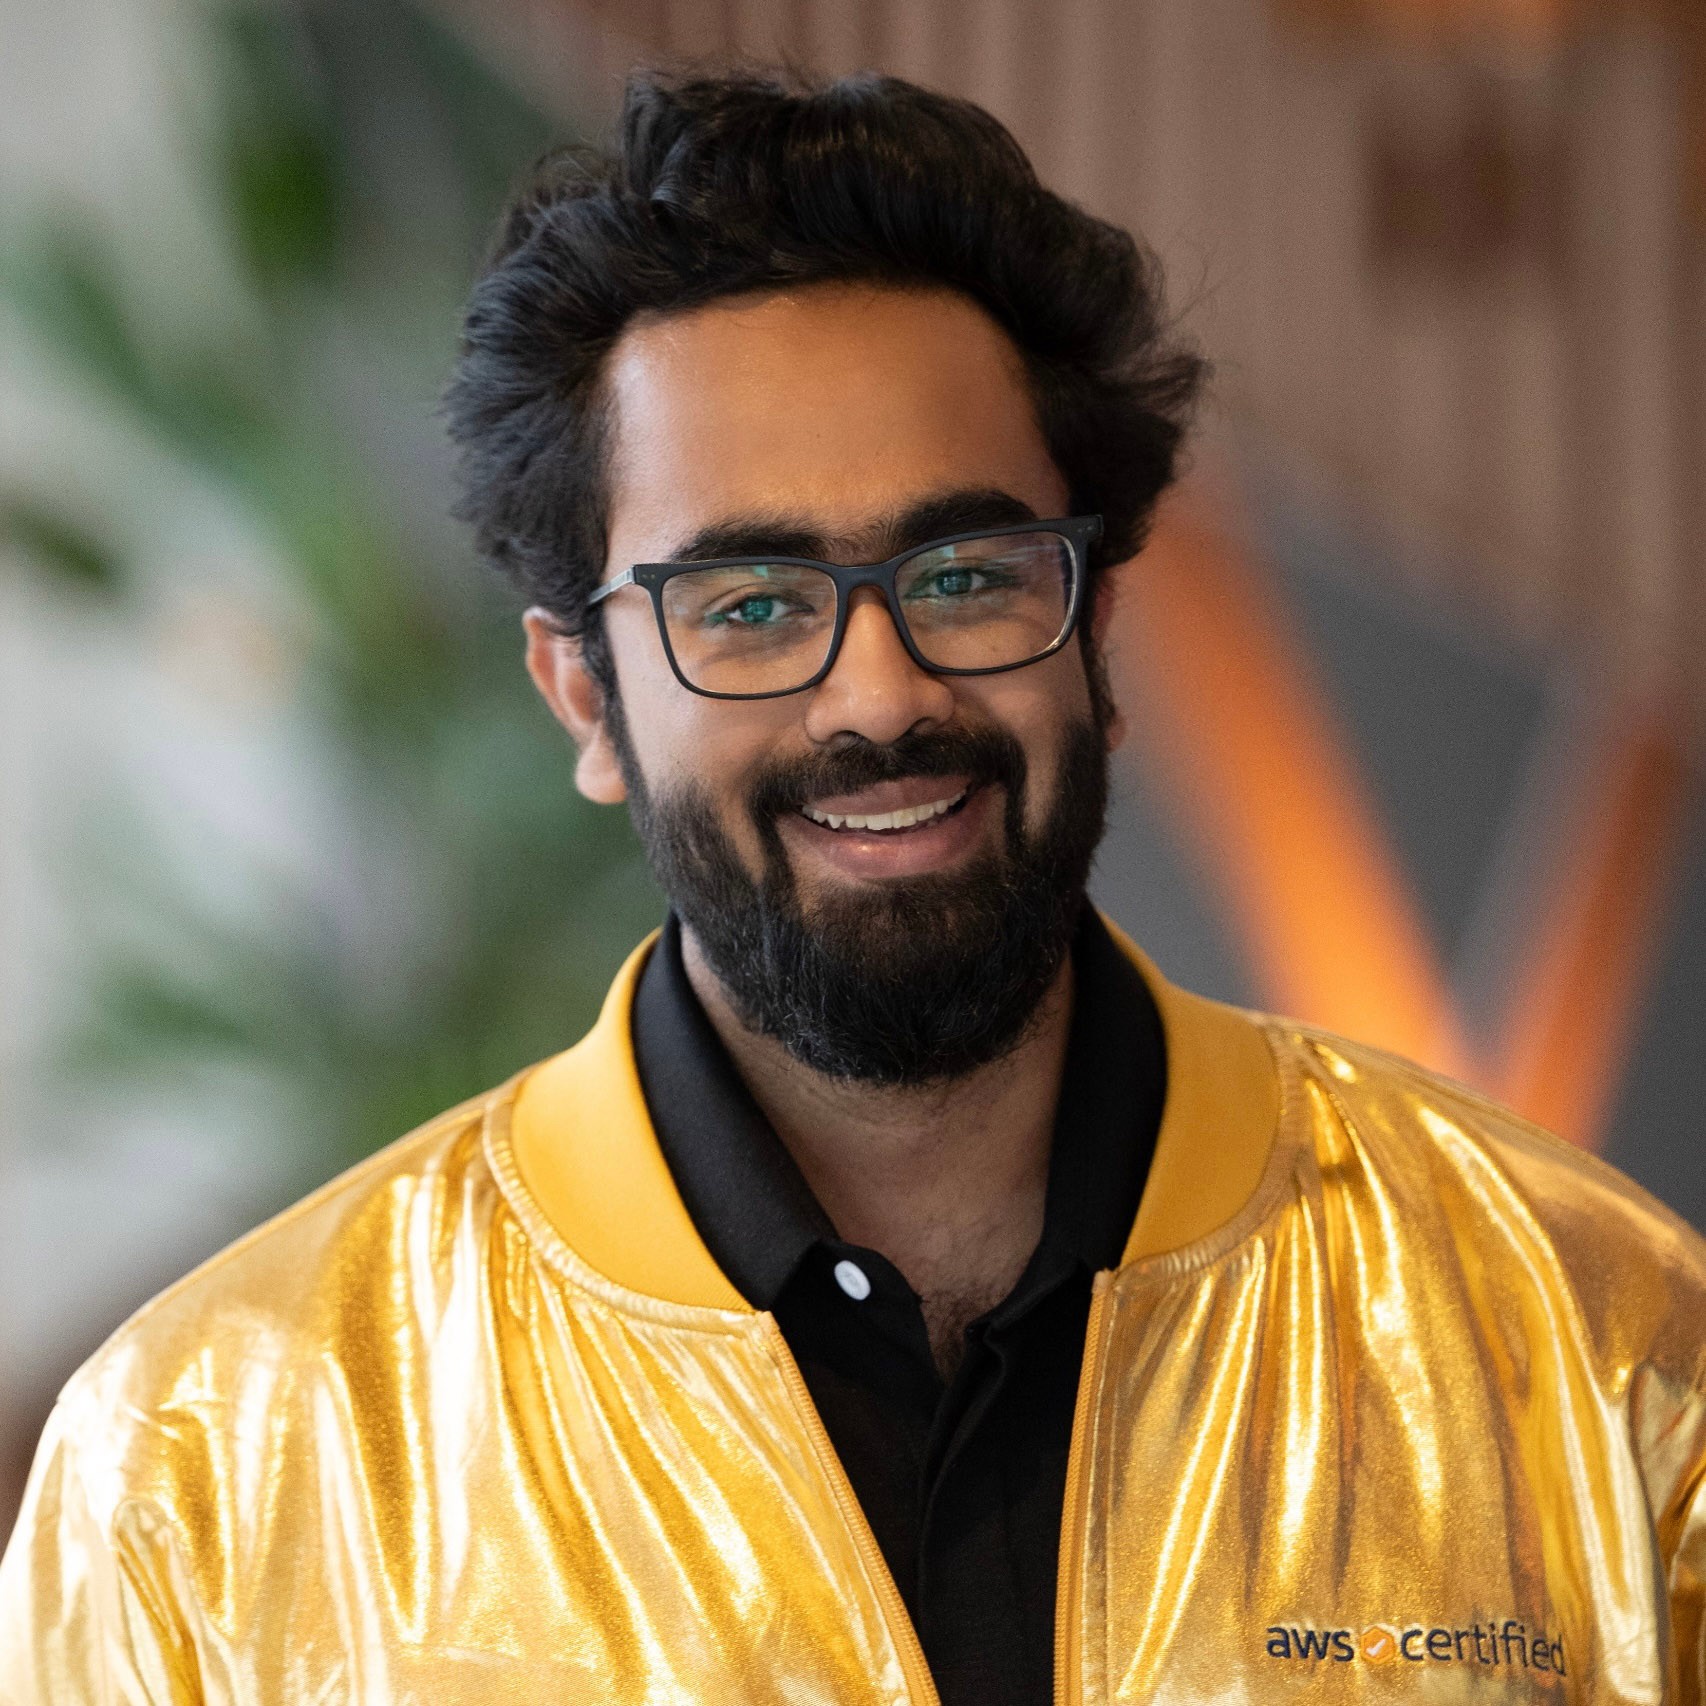 Harshvardhan Chunawala é arquiteto de soluções na Amazon Web Services e educador autorizado pela AWS Academy, além de titular do AWS Golden Jacket. Ele faz parcerias com fundadores de startups e executivos de alto escalão em todo o mundo para arquitetar uma infraestrutura de nuvem escalável e segura na AWS em todos os setores. Na AWS, ele atua como membro do TFC nas áreas aeroespacial, AI/ML, segurança, educação e ISV. Ele colabora com várias equipes da Amazon, incluindo Amazon Leo, Amazon Security e AWS Agentic AI, entre outras, para moldar e fornecer recursos de nuvem de ponta em serviços de satélite, segurança e inteligência artificial confiável. Tecnólogo reconhecido mundialmente e especialista em segurança na nuvem, Harshvardhan é membro do corpo docente visitante e pesquisador na Carnegie Mellon University (CMU), orientando a próxima geração de profissionais e empreendedores da nuvem. Harshvardhan atuou como líder de engenharia de missões espaciais e operador de missão na CMU para a primeira missão lunar da América desde a Apollo 17. Fora do trabalho, Harshvardhan persegue seu amor pelos céus fazendo paraquedismo e pilotando aviões.
Chakravarthy Nagarajan
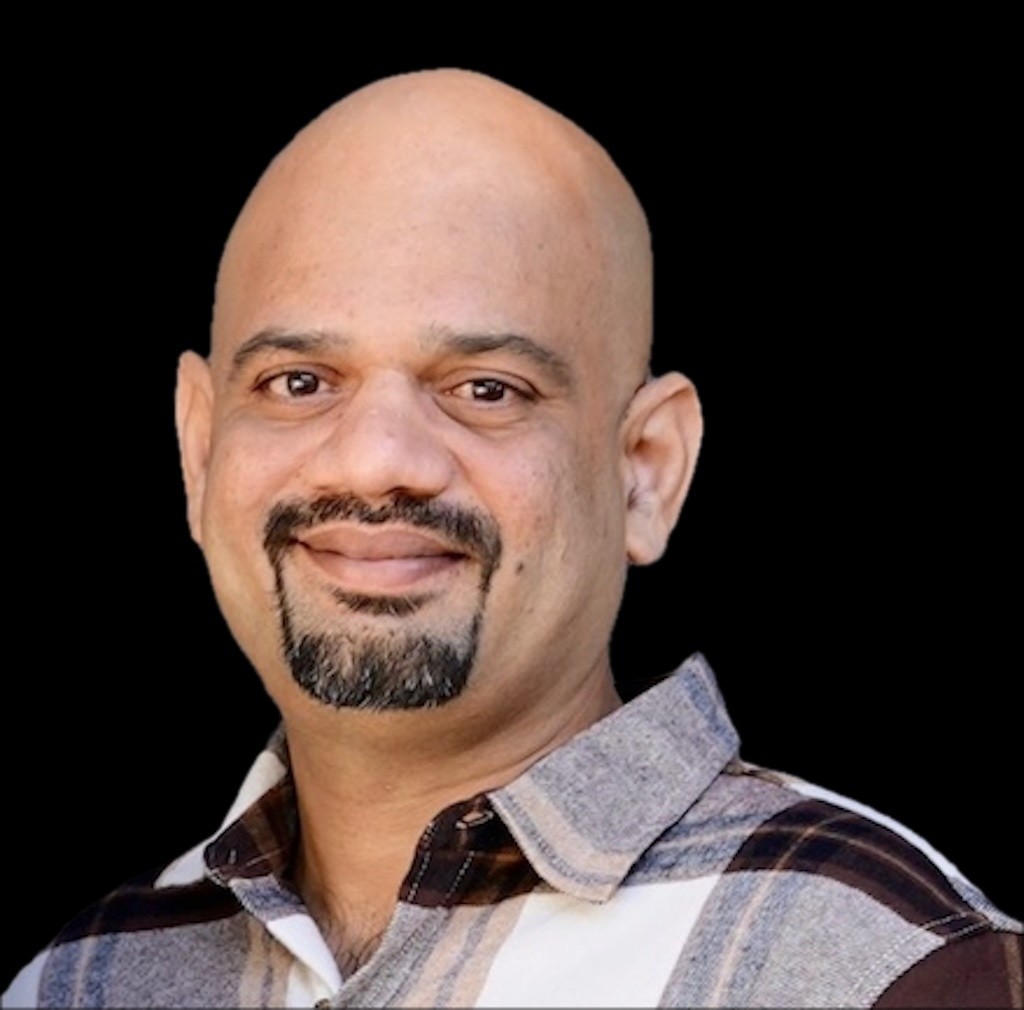 Chakravarthy Nagarajan é arquiteto principal de soluções especializado em aprendizado de máquina. Em sua função atual, ele ajuda os clientes a resolver problemas comerciais complexos e reais usando aprendizado de máquina e soluções generativas de IA. Ele se concentra na personalização de modelos, ajudando as empresas a perceberem o verdadeiro potencial dos LLMs com o poder da personalização.
Khadija Mahmoud
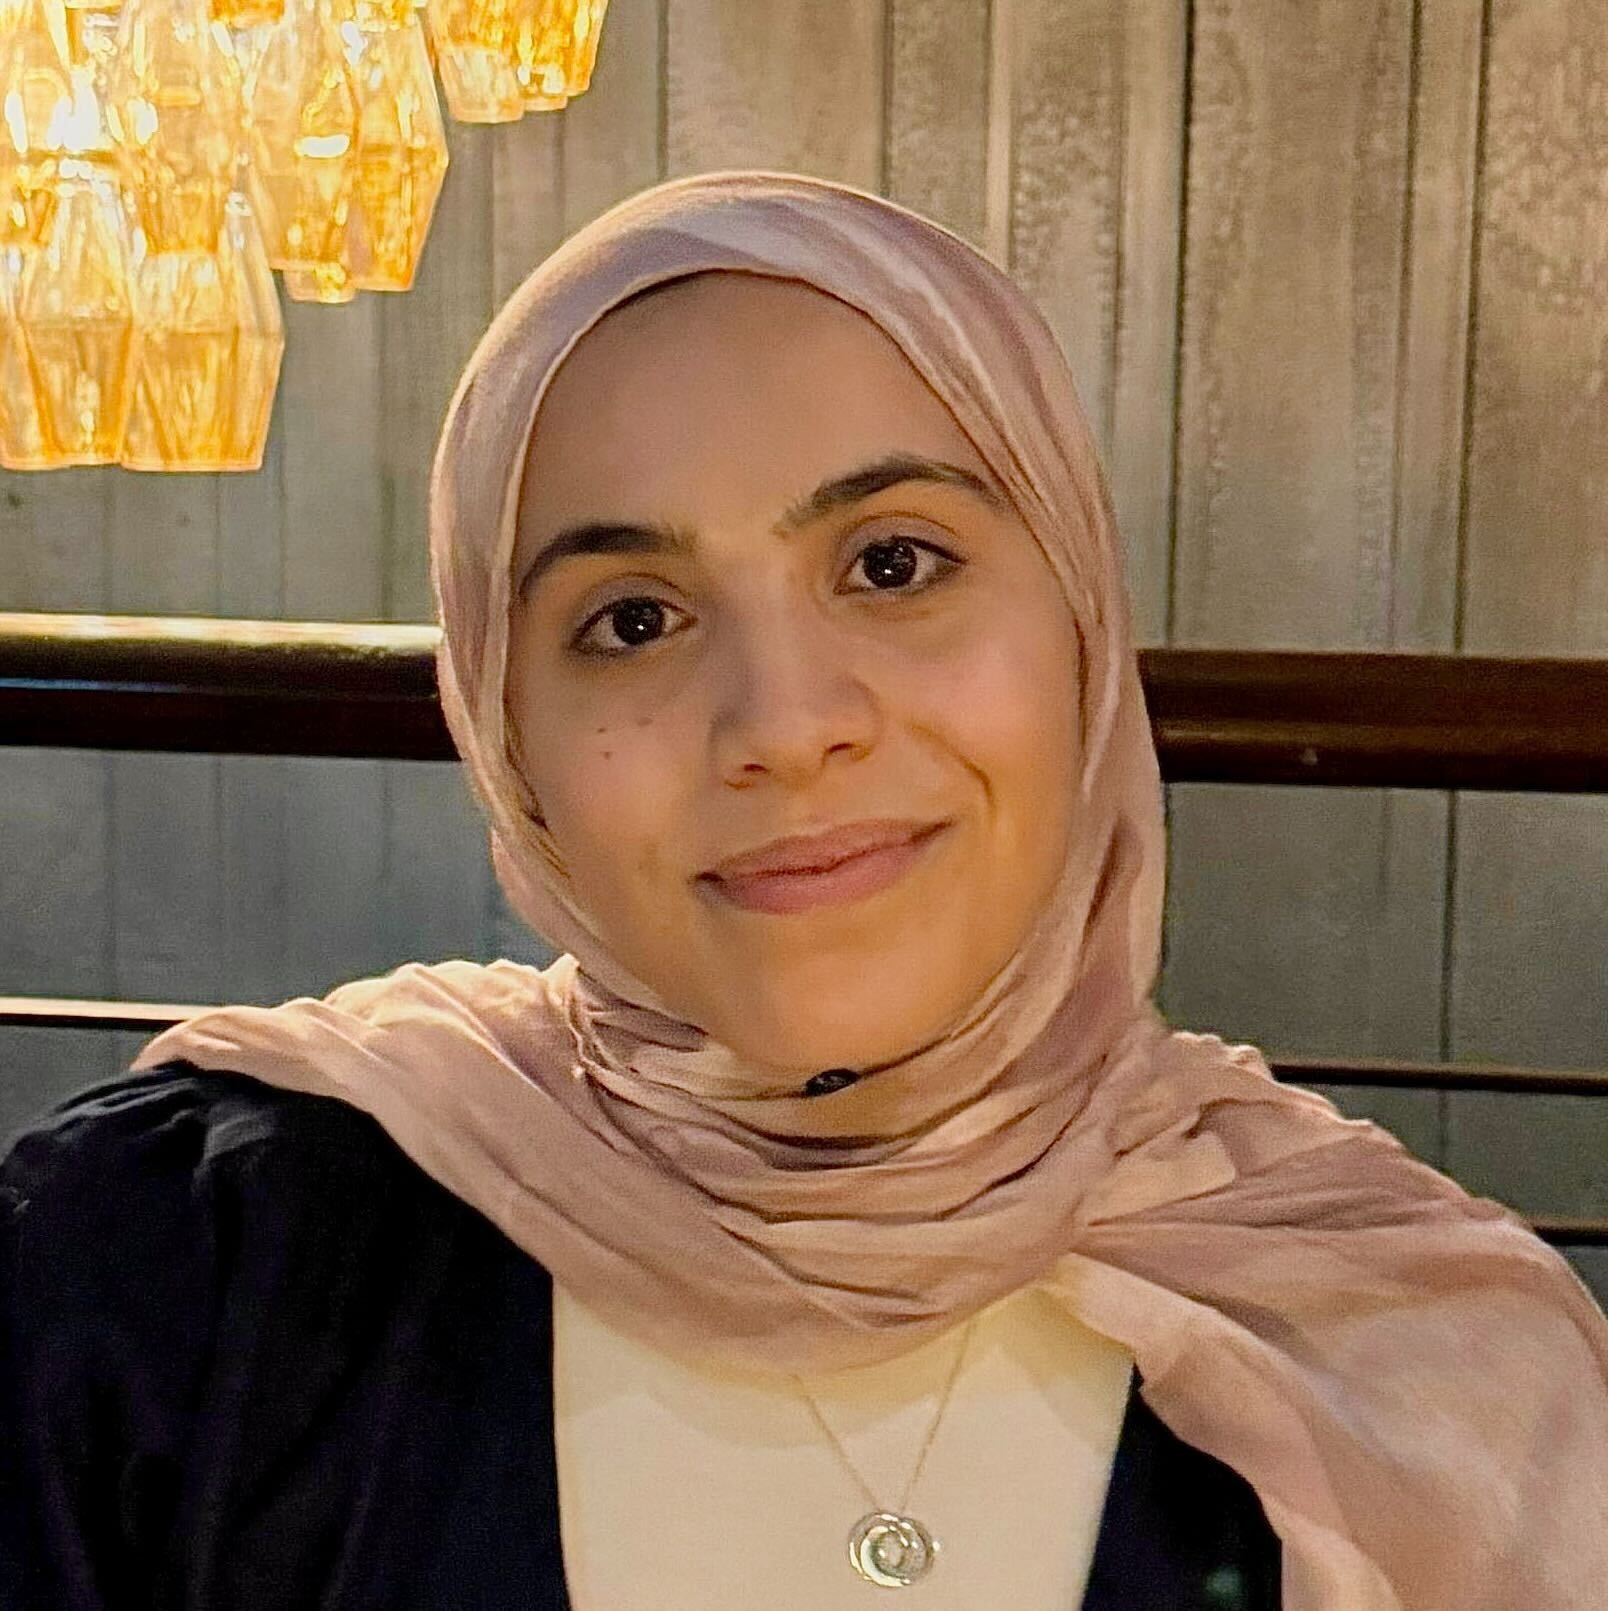 Khadija Mahmoud, MD, é cientista clínica em IA aplicada na Anterior, trabalhando em conjuntos de dados clínicos, benchmarking e avaliação de modelos em sistemas de saúde do mundo real. Sua pesquisa se concentra no raciocínio clínico, no preconceito e na justiça em IA e na implantação segura do aprendizado de máquina na área da saúde, com trabalhos publicados em periódicos revisados por pares. Ela tem mestrado em Inteligência Artificial em Saúde e MD pelo Imperial College London.
Anuj Iravane
 Anuj Iravane lidera a IA na Anterior, onde trabalha na interseção entre pesquisa e produção para criar agentes confiáveis, aderentes às políticas e de autoaperfeiçoamento para o raciocínio clínico. Antes da Anterior, ele trabalhou em sistemas de recomendação na Amazon. Ele é bacharel em Ciência da Computação pela Northwestern University. Além da IA, ele é produtor e diretor no ecossistema de cinema independente da Índia.
Mais maneiras de crescer na AWS
Você encontrou o que procurava hoje?
Ajude a melhorar a qualidade do conteúdo em nossas páginas