Anterior reduziert die Zeit für klinische Untersuchungen mit Amazon Bedrock und Llama um 75 %
ein Beitrag von Harshvardhan Chunawala, Chakravarthy Nagarajan, Khadija Mahmoud, Anuj Iravane | 22. April 2026
Wir verwandeln Hunderte von Seiten in umsetzbare klinische Erkenntnisse
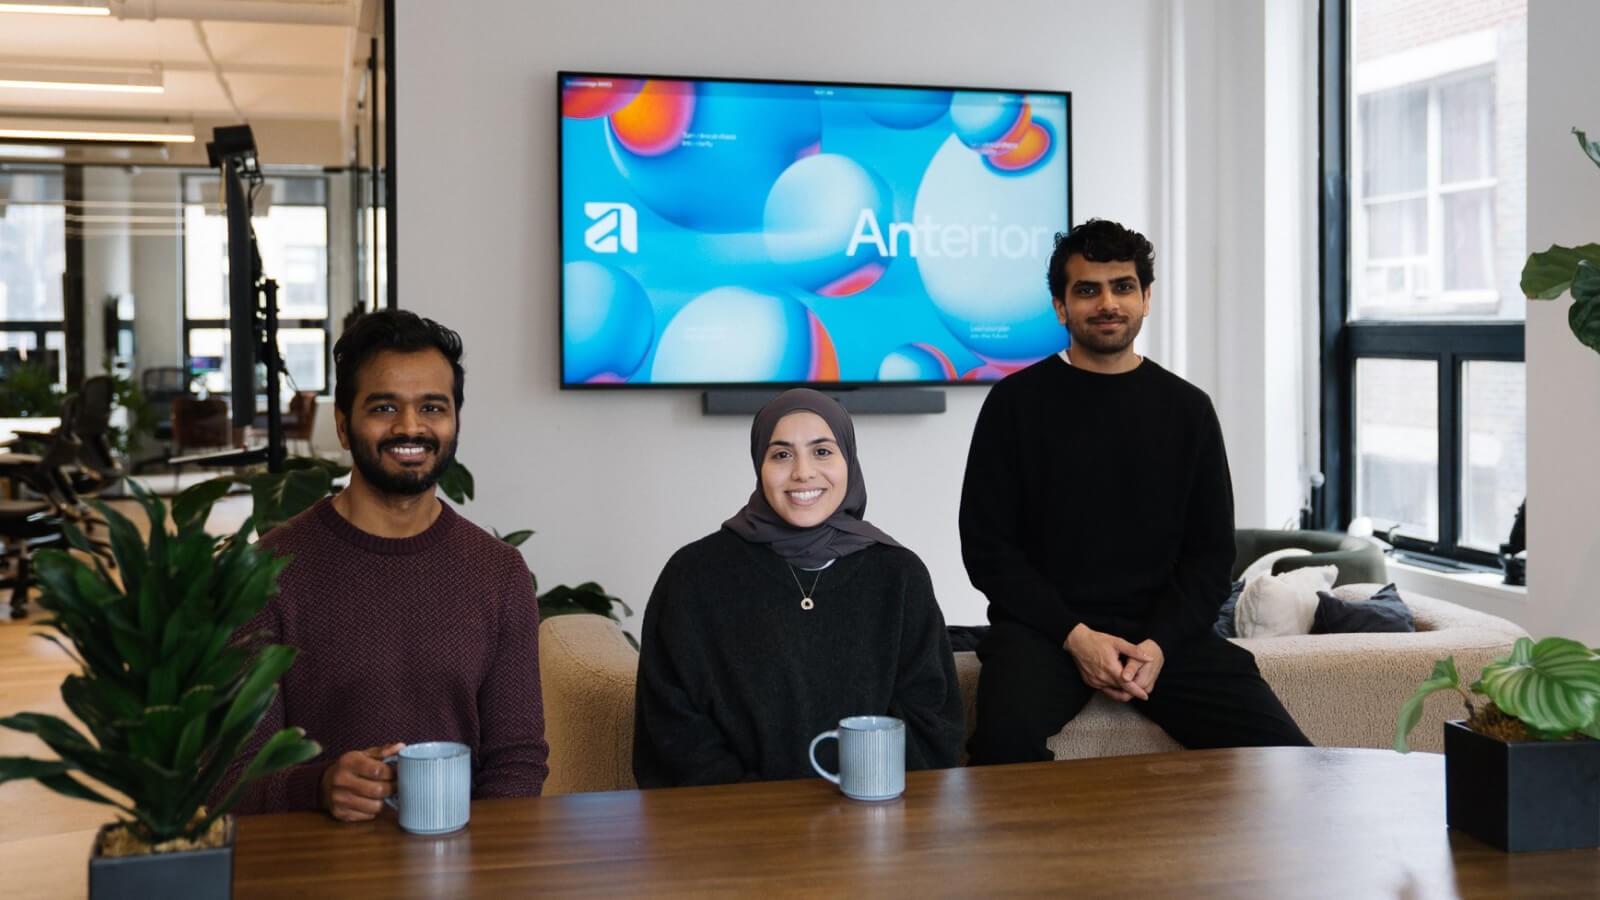
Anterior, ein von Ärzten geführtes KI-Unternehmen, das Automatisierungslösungen für Kostenträger im Gesundheitswesen (Versicherungsunternehmen) entwickelt, hat sich zum Ziel gesetzt, eines der schwierigsten Datenprobleme im Gesundheitswesen zu lösen: die Identifizierung und Strukturierung klinischer Dokumente, die oft als Hunderte von Seiten unstrukturierter Aufzeichnungen vorliegen. Nach der Implementierung der Llama-Modelle von Meta auf Amazon Bedrock zur Unterstützung der Dokumentenidentifizierung in den Amazon Web Services (AWS)-Umgebungen der Kunden erreichte Anterior eine Leistung auf Produktionsniveau und erfüllte gleichzeitig die strengen Anforderungen an die Daten-Governance im Gesundheitswesen. Mit diesem Ansatz lieferte Anterior eine vollständige Dokumentenextraktion, verbesserte die Genauigkeit der Metadaten und ermöglichte eine nachgelagerte Automatisierung, die die manuelle klinische Überprüfung um 75 % reduziert.
Bewältigung der Herausforderung der Dokumentenidentifizierung im Gesundheitswesen
Die Verwaltungskosten des Gesundheitswesens in den Vereinigten Staaten übersteigen in einer 5-Billionen-Dollar-Industrie jährlich 950 Milliarden US-Dollar. Ein Großteil dieser Belastung ist auf die Workflows zur klinischen Überprüfung innerhalb der Krankenversicherungen zurückzuführen, bei denen Ärzte und Krankenschwestern große Pakete von Krankenakten manuell überprüfen, um Behandlungen zu genehmigen, den Versicherungsschutz zu überprüfen und die Patientenversorgung zu verwalten. Anterior ist ein von Klinikern geführtes KI-Unternehmen, das sich auf die Automatisierung dieser Arbeitsabläufe für Kostenträger im Gesundheitswesen konzentriert, Organisationen, die an der Schnittstelle zwischen Anbietern und Patienten sitzen.
Im Mittelpunkt dieser Arbeitsabläufe steht eine Aufgabe, die täuschend einfach klingt: Bevor KI über einen klinischen Fall nachdenken kann, muss sie verstehen, worum es sich handelt. Die Identifizierung von Dokumenten ist die Voraussetzung für alle nachgelagerten Automatisierungen. Anterior muss jedes eingehende klinische Paket in seine einzelnen Dokumente unterteilen, identifizieren, wo jedes beginnt und endet, und strukturierte Metadaten wie Dokumenttyp, Titel, Autor und Erstellungsdatum extrahieren. Erst dann kann die klinische Automatisierung vorangetrieben werden, unabhängig davon, ob es darum geht, einen MRT-Bericht im Rahmen einer vorherigen Zulassungsprüfung an den richtigen Schritt weiterzuleiten, einem Arzt aktuelle Bilddaten zur Verfügung zu stellen oder zu überprüfen, ob die Dokumentation eine empfohlene Behandlungsmethode unterstützt. Klinische Pakete können jedoch Hunderte von Seiten lang sein und als Faxe, gescannte PDFs und zusammengeführte Dateien mit mehreren Dokumenten ankommen. Sie können Bildgebung, Tabellen, Formulare und sogar handschriftliche Notizen auf eine Weise kombinieren, die herkömmliche KI- und ML-Ansätze im Produktionsmaßstab seit langem nur schwer zuverlässig handhaben.
Es steht viel auf dem Spiel, wenn das schief geht. „Selbst kleine Fehler bei der Identifizierung von Dokumenten können nachgelagerte Auswirkungen haben, wenn man klinische Entscheidungen auf unvollständige oder falsche Informationen stützt“, sagte Khadija Mahmoud, MD, klinische Wissenschaftlerin bei Anterior. Eine falsch identifizierte Dokumentengrenze könnte bedeuten, dass klinische Informationen aus dem falschen Teil einer Patientenakte auftauchen, während eine fehlende Seite zu einer Compliance-Lücke führen könnte. Jedes Modell, das in der Lage ist, Dokumente in Produktionsqualität zu identifizieren, muss außerdem strenge Anforderungen an die Datenverwaltung im Gesundheitswesen erfüllen. Viele der größten Kunden von Anterior verlangen, dass die gesamte KI-Verarbeitung, einschließlich LLM-Inferenz zu geschützten Gesundheitsinformationen (PHI), vollständig in ihrer AWS-Umgebung erfolgt, wodurch externe APIs oder Infrastrukturen von Drittanbietern inakzeptabel sind.
Entwicklung einer skalierbaren Pipeline für die klinische Automatisierung
Anterior implementierte einen Workflow zur Dokumentenidentifizierung, der auf Meta-Llama-Modellen basiert, die in Amazon Bedrock ausgeführt werden. Diese Architektur verarbeitet komplexe klinische Dokumentenpakete in der AWS-Umgebung eines Kunden von Anfang bis Ende, sodass Patientendaten diese Grenze nie verlassen. Der Workflow arbeitet als zweistufige Pipeline. In der ersten Phase werden große klinische PDF-Dateien mithilfe optischer Zeichenerkennung (OCR) und layoutbezogener Analyse verarbeitet. Jede Seite wird in strukturierte Textextrakte umgewandelt, wobei Seitenverweise und eindeutige Identifikatoren erhalten bleiben. In der zweiten Phase analysiert ein Sprachmodell diese geparsten Extrakte, um die Dokumentgrenzen zu bestimmen, den Dokumenttyp zu klassifizieren und Metadaten wie Titel, Autor, Erstellungsdatum und eine klinische Beschreibung zu extrahieren. In dieser Phase erledigen Llama-Modelle auf Amazon Bedrock die Arbeit.
Anterior bewertete Llama 4 Maverick 17B und Llama 4 Scout 17B anhand eines proprietären multimodalen Modells auf Grenzskala unter Verwendung identischer Eingabeaufforderungen, Datensätze und Bewertungskriterien. Die Evaluierung wurde vollständig innerhalb der AWS-Infrastruktur durchgeführt und die Produktionsbereitschaft in Bezug auf Genauigkeit, Vollständigkeit, Konsistenz und Latenz gemessen. Die Datensätze wurden mithilfe der synthetischen Datenpipeline von Anterior generiert und von klinischen Wissenschaftlern kuratiert, um die Komplexität der realen Welt widerzuspiegeln: mehrdeutige Formatierungen, Pakete mit mehreren Dokumenten und Randfälle. Llama war aus mehreren Gründen ein starker Kandidat: Es unterstützt multimodale Eingaben (was der inhärent multimodalen Natur klinischer Daten entspricht), ermöglicht effiziente Inferenzen für Workloads mit hohem Durchsatz und bietet ein großes Kontextfenster, in dem lange klinische Pakete bequem verarbeitet werden können. Es gehört auch zu den am besten einstellbaren Modellen mit offenem Gewicht, sodass Anterior das Modellverhalten anhand von Aufforderungen und Einschränkungen auf Systemebene anpassen und kleinere, spezialisierte Modelle untersuchen kann, die auf spezifische klinische Aufgaben zugeschnitten sind, anstatt sich ausschließlich auf Grenzmodelle zu verlassen.
Durch den Betrieb von Llama auf Amazon Bedrock konnte sich das Team aus Klinikern und Ingenieuren des Unternehmens auf die Lösung des klinischen Problems konzentrieren, anstatt die Infrastruktur zu verwalten. Bedrock bietet eine einheitliche Oberfläche für die Bewertung und Bereitstellung von Foundation-Modellen bei gleichzeitiger direkter Integration in AWS-Umgebungen. „Viele große Krankenversicherungen, mit denen wir zusammenarbeiten, stellen dieselbe Frage: Können wir KI auf PHI in unserer AWS-Umgebung ausführen? Mit den von Bedrock gehosteten Llama-Modellen können wir Ja sagen, ohne Kompromisse bei der Leistung einzugehen,“ sagte Anuj Iravane, Leiter angewandter KI bei Anterior. Bedrock bewahrt auch die Flexibilität: Anterior kann zusätzliche Modelle evaluieren oder maßgeschneiderte Versionen bereitstellen, wenn sich die klinischen Anforderungen ändern, ohne die Architektur neu erstellen zu müssen.
Beschleunigung klinischer Entscheidungen und betrieblicher Effizienz
Sowohl Llama 4 Maverick 17B als auch Llama 4 Scout 17B lieferten eine produktionsreife Leistung bei der Identifizierung klinischer Dokumente in einem Datensatz von klinisch kuratierten, synthetischen klinischen Fällen. Die Modelle entsprachen einem Modell im Grenzbereich mit Hunderten von Milliarden von Parametern und liefen gleichzeitig effizienter, obwohl 17B aktive Parameter in größeren Modellarchitekturen verwendet wurden. Sie erreichten eine vollständige Seitenabdeckung, was bedeutet, dass jede Seite in einem klinischen Paket genau einmal zugewiesen wurde, ohne dass Inhalte verloren gingen oder dupliziert wurden. Die Ergebnisse waren besonders stark bei der Metadatenextraktion. Bei der Identifizierung wichtiger Informationen wie Autorenschaft und Beschreibungen von Dokumenten entsprachen die Llama-Modelle der Frontier-Baseline oder übertrafen sie. Die Genauigkeit der Autorenidentifikation erreichte bis zu 97 %, verglichen mit 93,5 % beim Frontier-Modell, und die Genauigkeit der Beschreibung erreichte 98,4 %. „Wir waren beeindruckt“, sagte Iravane. „Llama-Modelle auf Bedrock entsprachen zu einem Bruchteil der Kosten unseren Grenzbasiswerten – und bei der Metadatenextraktion übertrafen sie diese sogar. Man braucht nicht das größte Modell, um die schwierigsten Probleme des Gesundheitswesens zu lösen.“
Die Latenz zwischen den Modellen war vergleichbar, aber die Effizienzvorteile kleinerer Llama-Modelle, die auf Bedrock laufen, summieren sich im großem Maßstab. Wenn das Dokumentenvolumen wächst, kann Anterior mehr Fälle pro Recheneinheit zu geringeren Kosten pro Dokument verarbeiten, ohne an Genauigkeit einzubüßen. Die nachgelagerten Auswirkungen auf die Arbeitsabläufe im Gesundheitswesen sind erheblich. Bei der Prüfung der Vorabgenehmigung reduziert die Anterior-Plattform den Zeitaufwand für die manuelle klinische Überprüfung um 75 % und gewährleistet gleichzeitig eine klinische Genauigkeit von 99,24 %. Ein Fallbeispiel von KLAS Research ergab, dass das System die Wartezeiten der Patienten auf die Zulassung einer Krebsbehandlung von Tagen oder Wochen auf nur 155 Sekunden reduzierte. Für eine regionale Gesundheitsorganisation, die rund eine Million Krankenversicherungen betreut, bedeuten diese Verbesserungen jährliche Betriebseinsparungen in Höhe von etwa 30 Millionen USD. Ein schnelleres Verständnis von Dokumenten bedeutet letztlich schnellere klinische Entscheidungen und einen schnelleren Zugang zur Versorgung für Patienten.
Anterior ging innerhalb von sechs Wochen von der ersten Integration zur Bereitstellung über. Llama-Modelle sind jetzt Teil des Workflows zur Identifizierung von Produktionsdokumenten des Unternehmens und bedienen mehrere Unternehmenskunden. Die Ergebnisse bestätigten auch einen umfassenderen architektonischen Ansatz: Kleinere Modelle mit offenem Gewicht, die auf Amazon Bedrock gehostet werden, können mit Allzweckmodellen im Frontier-Maßstab für alle Arbeitsabläufe im Gesundheitswesen konkurrieren. „Ein Großteil des US-Gesundheitswesens basiert auf AWS“, sagte Iravane. „Der Nachweis, dass die Llama-Modelle auf Bedrock mit Frontier-Leistung mithalten können, bedeutet, dass unsere Kunden schneller bereitstellen, die Kosten besser kontrollieren und den Sicherheitsstatus aufrechterhalten können, den sie benötigen.“
Harshvardhan Chunawala
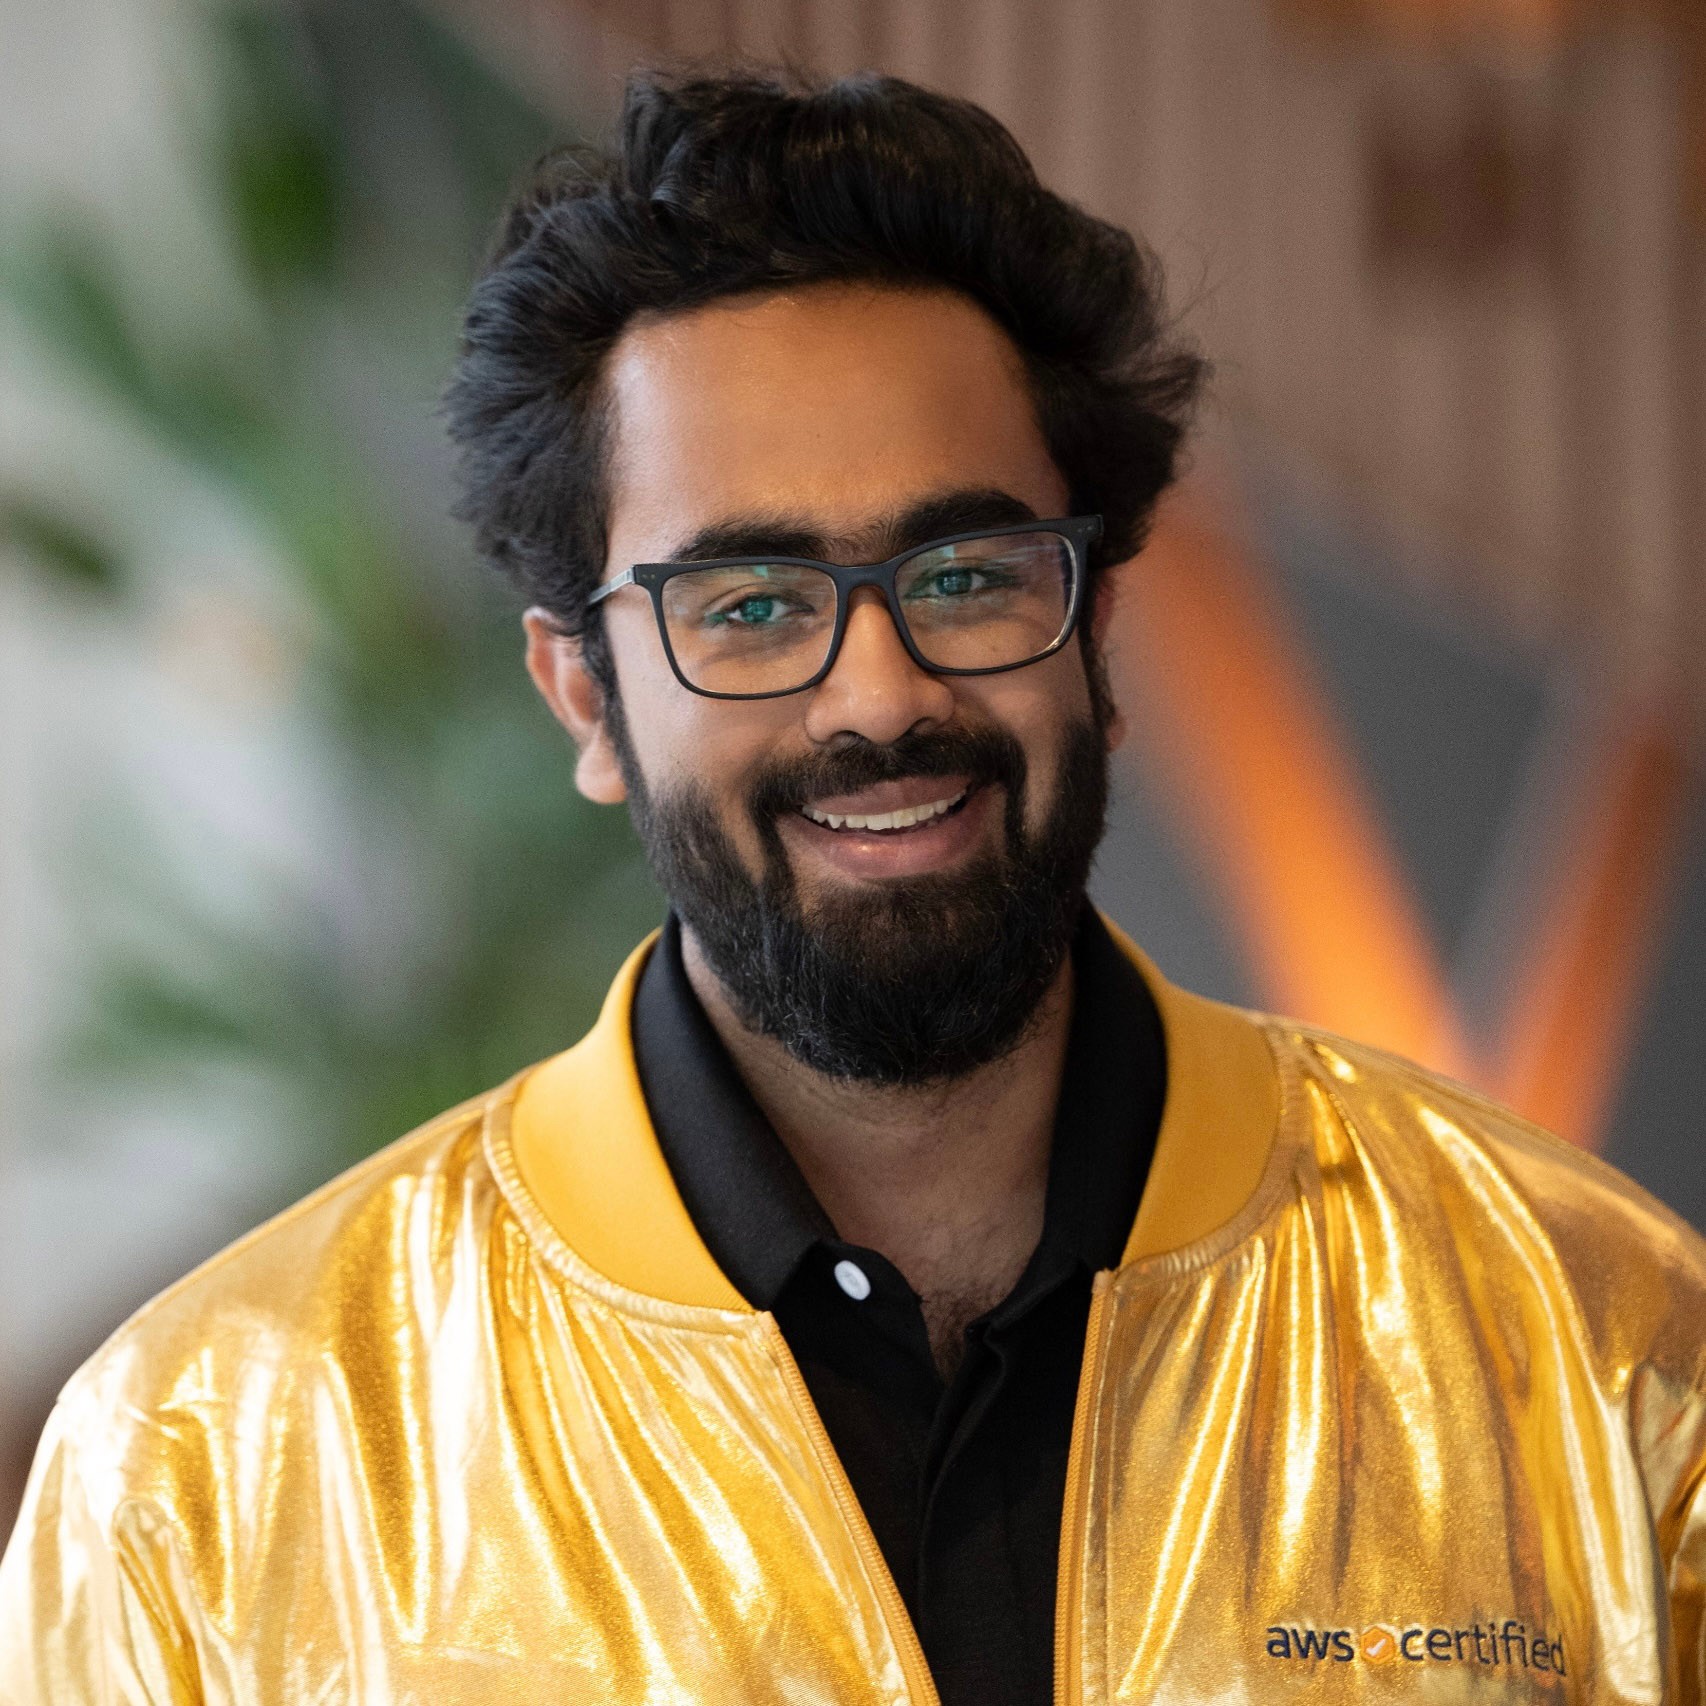 Harshvardhan Chunawala ist Solutions Architect bei Amazon Web Services und autorisierter AWS Academy Educator sowie Inhaber der AWS Golden Jacket. Er arbeitet weltweit mit Startup-Gründern und Führungskräften auf der ganzen Welt zusammen, um branchenübergreifend eine skalierbare, sichere Cloud-Infrastruktur in AWS zu entwickeln. Bei AWS ist er als TFC-Mitglied in den Bereichen Aerospace, AI/ML, Security, Education und ISV tätig. Er arbeitet in mehreren Amazon-Teams zusammen, darunter Amazon Leo, Amazon Security und AWS Agentic AI, um erstklassige Cloud-Funktionen für Satelliten-, Sicherheits- und vertrauenswürdige agentenbasierte KI-Services zu gestalten und bereitzustellen. Als weltweit anerkannter Technologe und Experte für Cloud-Sicherheit ist Harshvardhan Mitglied der Gastfakultät und forscht an der Carnegie Mellon University (CMU), wo er die nächste Generation von Cloud-Fachleuten und Unternehmern betreut. Harshvardhan war als Leiter der Weltraummissionstechnik und Missionsbetreiber an der CMU für Amerikas erste Mondmission seit Apollo 17 tätig. Außerhalb der Arbeit geht Harshvardhan seiner Liebe zum Himmel durch Fallschirmspringen nach und ist auch Hobbypilot.
Chakravarthy Nagarajan
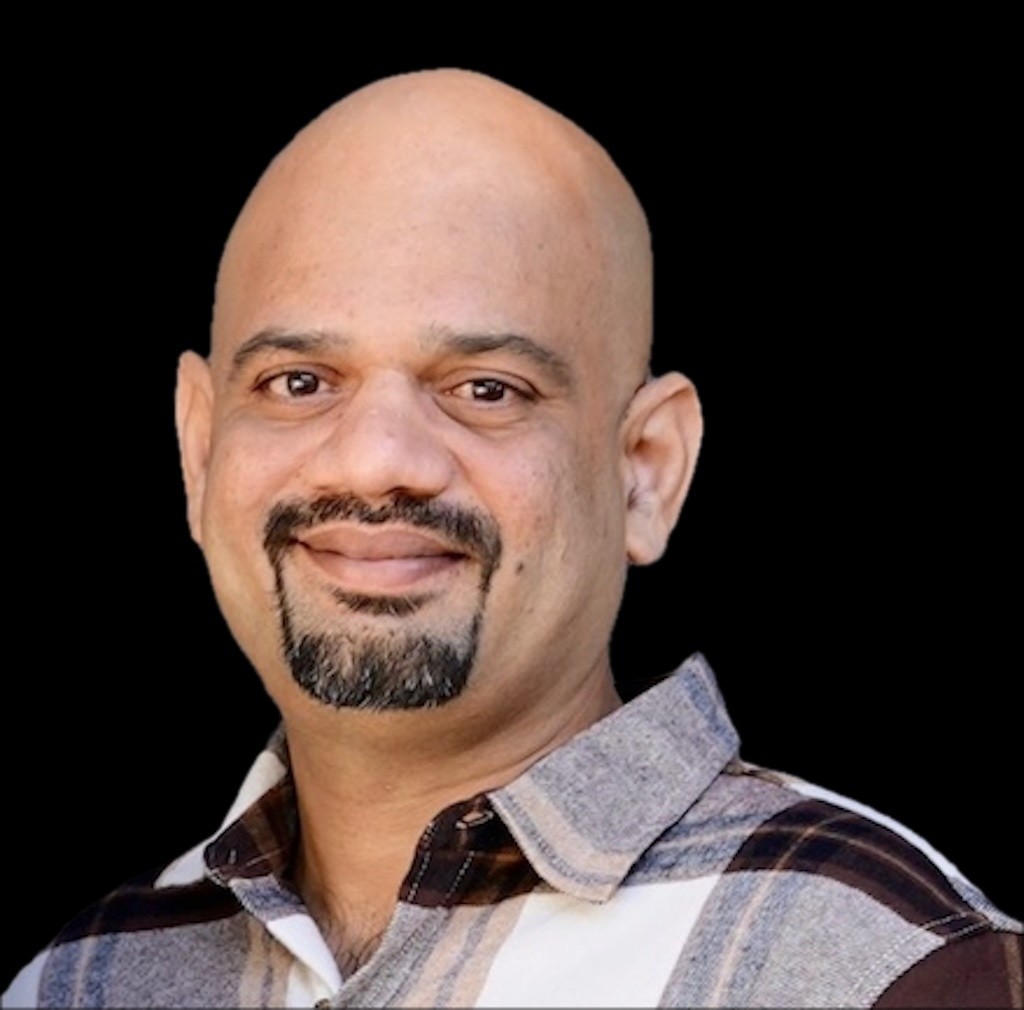 Chakravarthy Nagarajan ist Principal Solutions Architect, der sich auf Machine Learning spezialisiert hat. In seiner aktuellen Position hilft er Kunden, reale, komplexe Geschäftsprobleme mithilfe von Machine Learning und generativen KI-Lösungen zu überwinden. Er konzentriert sich auf die Modellanpassung und hilft Unternehmen dabei, das wahre Potenzial von LLMs mithilfe von Anpassungsmöglichkeiten auszuschöpfen.
Khadija Mahmoud
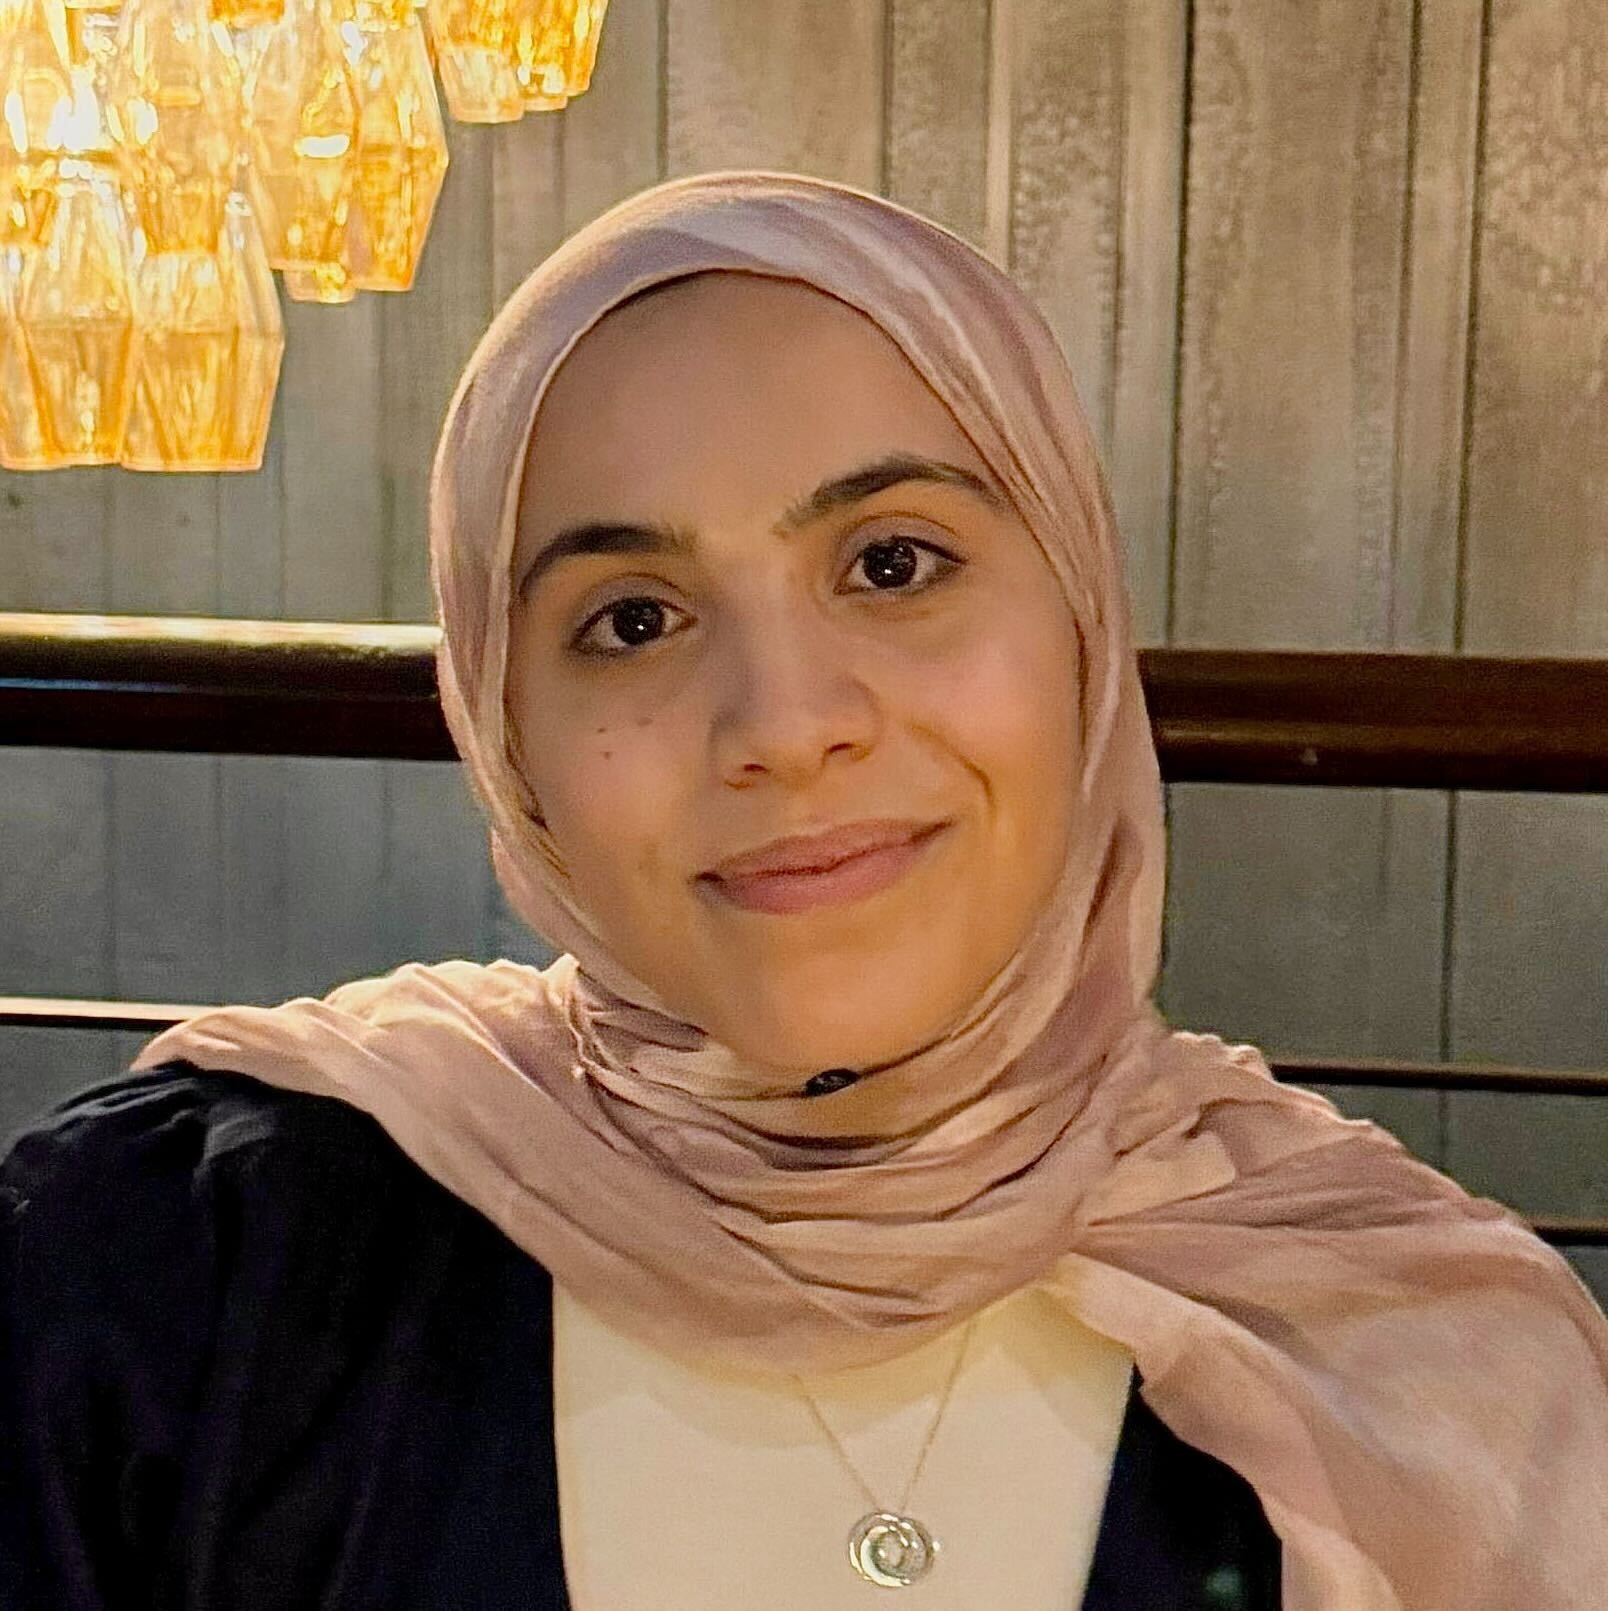 Khadija Mahmoud, MD, ist klinische Wissenschaftlerin für angewandte KI bei Anterior. Sie arbeitet an klinischen Datensätzen, Benchmarking und Modellbewertung in realen Gesundheitssystemen. Ihre Forschung konzentriert sich auf klinisches Reasoning, Vorurteile und Fairness in der KI sowie den sicheren Einsatz von Machine Learning im Gesundheitswesen. Ihre Arbeiten wurden in Fachzeitschriften veröffentlicht. Sie hat einen MSc in künstlicher Intelligenz im Gesundheitswesen und einen MD vom Imperial College London.
Anuj Iravane
 Anuj Iravane leitet KI bei Anterior, wo er an der Schnittstelle von Forschung und Produktion arbeitet, um zuverlässige, richtlinienkonforme und sich selbst verbessernde Agenten für klinisches Reasoning zu entwickeln. Vor Anterior arbeitete er an Empfehlungssystemen bei Amazon. Er hat einen BS in Informatik von der Northwestern University. Neben KI ist er Produzent und Regisseur im unabhängigen Kinoökosystem Indiens.
Mehr Möglichkeiten, in AWS zu wachsen
Haben Sie die gewünschten Informationen gefunden?
Ihr Feedback hilft uns, die Qualität der Inhalte auf unseren Seiten zu verbessern