Anterior mengurangi waktu tinjauan klinis hingga 75% dengan Amazon Bedrock dan Llama
oleh Harshvardhan Chunawala, Chakravarthy Nagarajan, Khadija Mahmoud, Anuj Iravane | 22 April 2026
Mengubah ratusan halaman menjadi wawasan klinis yang dapat ditindaklanjuti
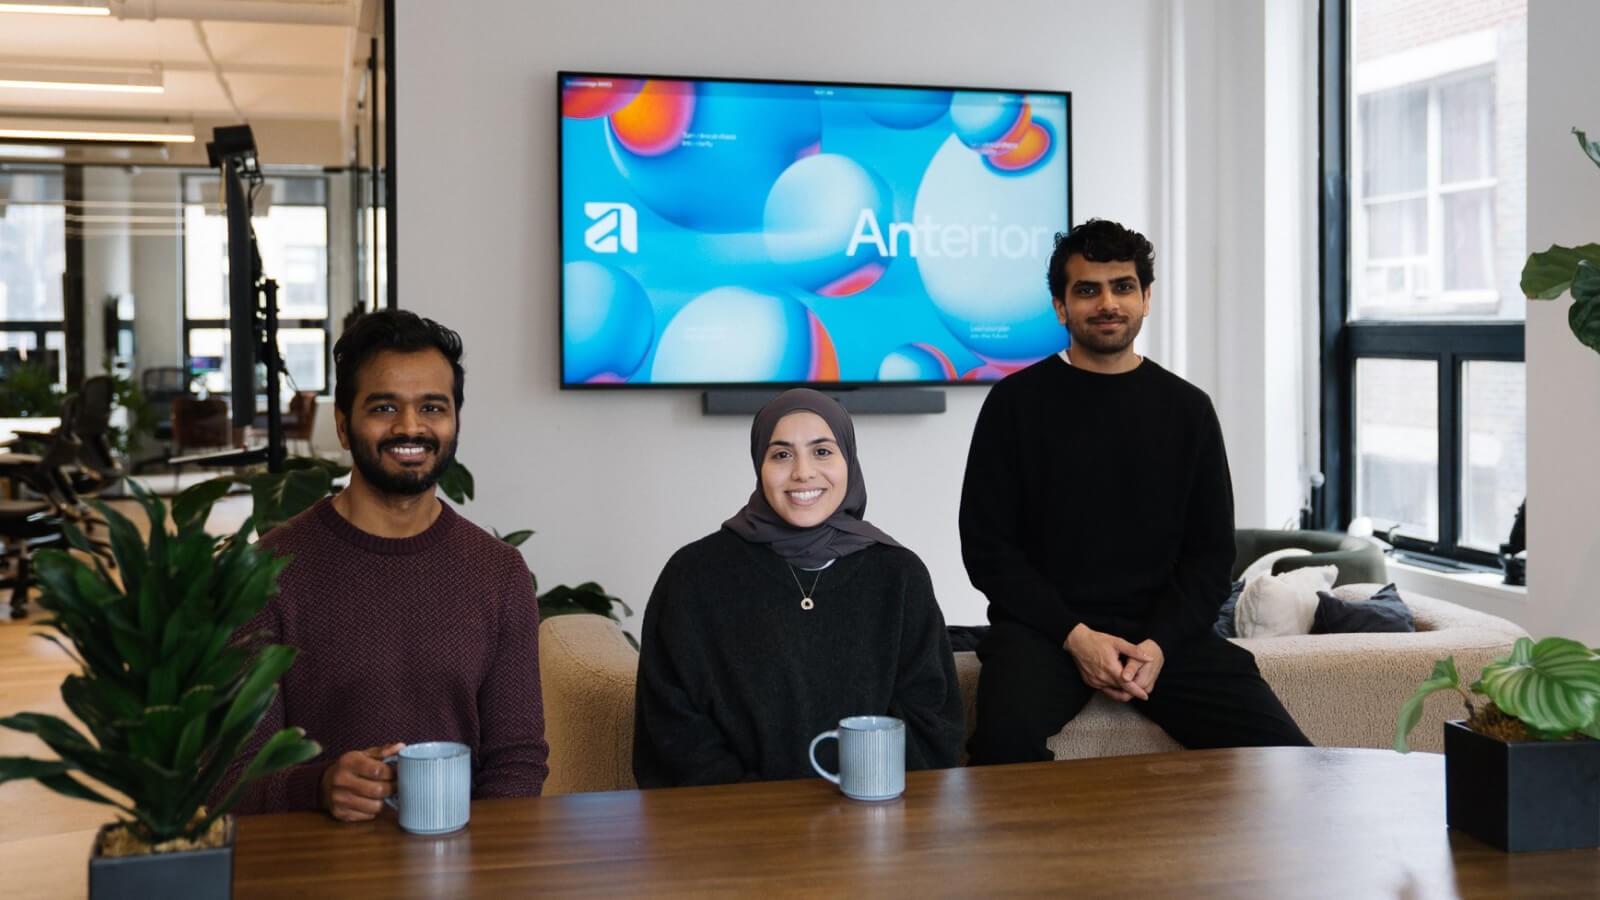
Anterior, perusahaan AI yang dipimpin oleh dokter yang membangun otomatisasi untuk pembayar layanan kesehatan (perusahaan asuransi), bertujuan untuk memecahkan salah satu masalah data layanan kesehatan yang paling sulit: mengidentifikasi dan menyusun dokumen klinis yang sering tiba dalam ratusan halaman catatan tidak terstruktur. Setelah menerapkan model Llama dari Meta di Amazon Bedrock untuk memperkuat identifikasi dokumen dalam lingkungan Amazon Web Services (AWS) pelanggan, Anterior mencapai kinerja tingkat produksi sekaligus memenuhi persyaratan tata kelola data layanan kesehatan yang ketat. Dengan menggunakan pendekatan ini, Anterior menghadirkan ekstraksi dokumen lengkap, meningkatkan akurasi metadata, dan mengaktifkan otomatisasi hilir yang mengurangi tinjauan klinis manual hingga 75 persen.
Mengatasi tantangan identifikasi dokumen layanan kesehatan
Biaya administrasi layanan kesehatan di Amerika Serikat melebihi $950 miliar per tahun dalam industri senilai $5 triliun. Sebagian besar beban ini berasal dari alur kerja tinjauan klinis di dalam rencana kesehatan, yakni saat dokter dan perawat secara manual meninjau paket besar berisi catatan medis untuk menyetujui perawatan, memverifikasi cakupan, dan mengelola perawatan pasien. Anterior adalah perusahaan AI yang dipimpin oleh dokter yang berfokus pada otomatisasi alur kerja ini untuk para pembayar layanan kesehatan, organisasi yang bergerak di antara penyedia dan pasien.
Di pusat alur kerja ini adalah tugas yang terdengar sangat sederhana: sebelum AI dapat menalar kasus klinis, ia harus memahami apa yang dilihatnya. Identifikasi dokumen adalah prasyarat untuk semua otomatisasi hilir. Anterior harus mengelompokkan setiap paket klinis yang datang ke dalam dokumen konstituennya, mengidentifikasi tiap awalan dan akhirannya, serta mengekstrak metadata terstruktur termasuk jenis dokumen, judul, penulis, dan tanggal pembuatan. Hanya setelah itu otomatisasi klinis dapat dilanjutkan, baik itu mengarahkan laporan MRI ke langkah yang tepat dalam tinjauan otorisasi sebelumnya, menampilkan pencitraan terbaru untuk dokter, atau memverifikasi bahwa dokumentasi mendukung perawatan yang direkomendasikan. Namun, paket klinis dapat berisi ratusan halaman dan tiba sebagai faks, PDF yang dipindai, dan file gabungan beberapa dokumen. Dokumen ini mungkin menggabungkan gambar, tabel, formulir, bahkan catatan tulisan tangan dengan cara yang selama ini sulit ditangani secara andal oleh pendekatan AI dan ML tradisional pada skala produksi.
Kesalahan dalam proses ini dapat berakibat serius. “Bahkan kesalahan kecil dalam identifikasi dokumen dapat mengalir ke hilir, karena Anda mendasarkan keputusan klinis pada informasi yang tidak lengkap atau salah,” kata Khadija Mahmoud, MD, clinician scientist di Anterior. Batas dokumen yang salah diidentifikasi dapat berarti memunculkan informasi klinis dari bagian yang salah dalam catatan pasien, sementara halaman yang terlewat dapat menciptakan kesenjangan kepatuhan. Setiap model yang mampu menangani identifikasi dokumen tingkat produksi juga harus memenuhi persyaratan tata kelola data layanan kesehatan yang ketat. Banyak pelanggan terbesar Anterior mengharuskan semua pemrosesan AI, termasuk inferensi LLM pada Informasi Kesehatan Terlindungi (PHI), terjadi sepenuhnya dalam lingkungan AWS mereka, sehingga API eksternal atau infrastruktur pihak ketiga tidak dapat diterima.
Membangun pipeline yang dapat diskalakan untuk otomatisasi klinis
Anterior menerapkan alur kerja identifikasi dokumen yang didukung oleh model Meta Llama yang berjalan di Amazon Bedrock. Arsitektur ini memproses paket dokumen klinis yang kompleks dari ujung ke ujung dalam lingkungan AWS pelanggan, sehingga data pasien tidak pernah meninggalkan batas tersebut. Alur kerja ini beroperasi sebagai pipeline dua tahap. Pada tahap pertama, PDF klinis besar diproses menggunakan pengenalan karakter optik (OCR) dan penguraian tata letak. Setiap halaman diubah menjadi ekstrak teks terstruktur sambil mempertahankan referensi halaman dan pengidentifikasi unik. Pada tahap kedua, model bahasa menganalisis ekstrak yang diurai ini untuk menentukan batas dokumen, mengklasifikasikan jenis dokumen, dan mengekstrak metadata seperti judul, penulis, tanggal pembuatan, dan deskripsi klinis. Ini adalah tahap ketika model Llama di Amazon Bedrock melakukan pekerjaannya.
Anterior mengevaluasi Llama 4 Maverick 17B dan Llama 4 Scout 17B dengan membandingkannya terhadap model multimodal eksklusif skala terdepan menggunakan prompt, set data, dan kriteria evaluasi yang identik. Evaluasi berjalan sepenuhnya dalam infrastruktur AWS dan mengukur kesiapan produksi berdasarkan akurasi, kelengkapan, konsistensi, dan latensi. Set data dihasilkan melalui pipeline data sintetis Anterior dan dikurasi oleh ilmuwan klinisi untuk mencerminkan kompleksitas dunia nyata: pemformatan ambigu, paket multi-dokumen, dan kasus edge. Llama adalah kandidat yang kuat karena beberapa alasan: ia mendukung input multimodal (yang selaras dengan sifat multimodal inheren dari data klinis), memungkinkan inferensi yang efisien untuk beban kerja throughput tinggi, dan menawarkan jendela konteks besar yang dengan mudah menangani paket klinis yang panjang. Model ini juga merupakan salah satu model bobot terbuka yang paling dapat disetel yang tersedia, memungkinkan Anterior untuk menyesuaikan perilaku model melalui prompt dan kendala tingkat sistem serta mengeksplorasi model khusus yang lebih kecil yang disesuaikan dengan tugas klinis tertentu daripada hanya mengandalkan model skala terdepan.
Menjalankan Llama di Amazon Bedrock memungkinkan tim dokter dan rekayasawan perusahaan untuk fokus pada pemecahan masalah klinis daripada mengelola infrastruktur. Bedrock menyediakan antarmuka terpadu untuk mengevaluasi dan menerapkan model dasar sambil berintegrasi secara langsung dengan lingkungan AWS. “Banyak rencana kesehatan utama yang kami kerjakan mengajukan pertanyaan yang sama: 'Bisakah kami menjalankan AI di PHI di dalam lingkungan AWS kami?' Model Llama yang dihosting Bedrock memungkinkan kami untuk mengatakan ya tanpa mengorbankan kinerja,” kata Anuj Iravane, Applied AI Lead di Anterior. Bedrock juga mempertahankan fleksibilitas: Anterior dapat mengevaluasi model tambahan atau menerapkan versi khusus yang disempurnakan sesuai perkembangan persyaratan klinis tanpa perlu membangun kembali arsitekturnya.
Mempercepat keputusan klinis dan efisiensi operasional
Di seluruh set data kasus klinis sintetis yang dikurasi oleh dokter, baik Llama 4 Maverick 17B dan Llama 4 Scout 17B menghadirkan kinerja tingkat produksi untuk identifikasi dokumen klinis. Model tersebut mencocokkan model skala terdepan dengan ratusan miliar parameter sambil berjalan lebih efisien, meskipun menggunakan parameter aktif 17B dalam arsitektur model yang lebih besar. Model ini mencapai cakupan halaman lengkap, yang berarti setiap halaman dalam paket klinis ditetapkan tepat sekali tanpa ada konten yang terlewat atau diduplikasi. Hasilnya sangat akurat dalam ekstraksi metadata. Model Llama cocok atau melampaui acuan dasar terdepan saat mengidentifikasi informasi kunci seperti kepengarangan dan deskripsi dokumen. Akurasi identifikasi penulis mencapai 97 persen, dibandingkan dengan 93,5 persen saat menggunakan model terdepan, sementara ketepatan deskripsi mencapai 98,4 persen. “Kami terkesan,” kata Iravane. “Model Llama di Bedrock menyamai acuan dasar terdepan kami dengan biaya yang jauh lebih murah—dan dalam ekstraksi metadata, model ini bahkan mengunggulinya. Anda tidak perlu model terbesar untuk memecahkan masalah layanan kesehatan yang paling sulit.”
Latensi lintas model sebanding, tetapi keunggulan efisiensi dari model Llama yang lebih kecil yang berjalan di Bedrock makin terasa ketika digunakan dalam skala besar. Seiring bertambahnya volume dokumen, Anterior dapat memproses lebih banyak kasus per unit komputasi dengan biaya per dokumen yang lebih rendah tanpa mengorbankan akurasi. Dampak hilir pada alur kerja layanan kesehatan sangat signifikan. Dalam tinjauan otorisasi sebelumnya, platform Anterior mengurangi waktu tinjauan klinis manual sebesar 75 persen sambil mempertahankan akurasi klinis sebesar 99,24 persen. Sebuah studi kasus KLAS Research menemukan bahwa sistem ini mengurangi waktu tunggu pasien untuk persetujuan perawatan kanker dari hari atau minggu menjadi hanya 155 detik. Untuk organisasi layanan kesehatan regional yang melayani sekitar satu juta jiwa penerima layanan, peningkatan ini setara dengan penghematan sebesar $30 juta dalam operasional tahunan. Pemahaman dokumen yang lebih cepat pada akhirnya berarti keputusan klinis yang lebih cepat dan akses yang lebih cepat ke perawatan untuk pasien.
Anterior beralih dari integrasi awal ke deployment dalam enam minggu. Model Llama sekarang menjadi bagian dari alur kerja identifikasi dokumen produksi perusahaan yang melayani beberapa pelanggan perusahaan. Hasilnya juga memvalidasi pendekatan arsitektural yang lebih luas: bahwa model bobot terbuka yang lebih kecil yang dihosting di Amazon Bedrock dapat bersaing dengan model tujuan umum berskala terdepan di seluruh alur kerja layanan kesehatan. “Sebagian besar layanan kesehatan AS berjalan di AWS,” kata Iravane. “Ini membuktikan bahwa model Llama di Bedrock dapat menyamai kinerja terdepan, yang juga berarti pelanggan kami dapat melakukan deployment lebih cepat, mengontrol biaya dengan lebih baik, dan mempertahankan postur keamanan yang mereka butuhkan.”
Harshvardhan Chunawala
 Harshvardhan Chunawala adalah seorang Arsitek Solusi di Amazon Web Services dan Pendidik Resmi di AWS Academy, serta pemegang Jaket Emas AWS. Ia bekerja sama dengan pendiri perusahaan rintisan dan eksekutif C-suite secara global untuk merancang infrastruktur cloud di AWS yang dapat diskalakan dan aman di seluruh industri. Di AWS, ia menjabat sebagai anggota TFC di Aerospace, AI/ML, Security, Education, dan ISV. Ia berkolaborasi dengan berbagai tim Amazon, termasuk di antaranya, Amazon Leo, Amazon Security, dan AWS Agentic AI, untuk membentuk dan menghadirkan kemampuan cloud terdepan di seluruh satelit, keamanan, dan layanan AI agentik yang tepercaya. Seorang teknolog dan pakar keamanan cloud yang diakui secara global, Harshvardhan adalah Dosen Tamu dan peneliti di Carnegie Mellon University (CMU), membimbing generasi profesional dan pengusaha cloud berikutnya. Harshvardhan menjabat sebagai Engineering Lead Misi Luar Angkasa dan Operator Misi di CMU untuk misi bulan pertama Amerika sejak Apollo 17. Di luar pekerjaan, Harshvardhan menyalurkan kecintaannya pada angkasa melalui terjun payung dan menerbangkan pesawat.
Chakravarthy Nagarajan
 Chakravarthy Nagarajan adalah seorang Principal Solutions Architect yang berspesialisasi di machine learning. Dalam perannya saat ini, ia membantu pelanggan memecahkan masalah bisnis dunia nyata yang kompleks menggunakan machine learning dan solusi AI generatif. Ia berfokus pada kustomisasi model, membantu perusahaan menyadari potensi sesungguhnya dari LLM melalui kekuatan kustomisasi.
Khadija Mahmoud
 Khadija Mahmoud, MD adalah seorang Clinical Scientist dalam AI terapan di Anterior, yang bekerja dengan set data klinis, pembandingan, dan evaluasi model di seluruh sistem layanan kesehatan dunia nyata. Penelitiannya berfokus pada penalaran klinis, bias dan keadilan dalam AI, serta deployment machine learning yang aman dalam sektor layanan kesehatan, dengan karya yang telah diterbitkan dalam jurnal peer-reviewed. Ia memegang gelar MSc untuk Kecerdasan Buatan (AI) dalam Layanan Kesehatan dan gelar MD dari Imperial College London.
Anuj Iravane
 Anuj Iravane memimpin AI di Anterior, dengan fokus pada persimpangan antara penelitian dan produksi untuk membangun agen yang andal, patuh pada kebijakan, dan mampu belajar secara mandiri untuk penalaran klinis. Sebelum Anterior, ia bekerja di sistem pemberi rekomendasi di Amazon. Ia meraih gelar BS dalam Ilmu Komputer dari Northwestern University. Di luar AI, ia adalah seorang produser dan sutradara di ekosistem sinema independen India.
Apakah Anda Menemukan Apa yang Anda Cari Sekarang?
Beri tahu kami agar kami dapat meningkatkan kualitas konten di halaman kami