Anterior réduit le temps d’examen clinique de 75 % avec Amazon Bedrock et Llama
par Harshvardhan Chunawala, Chakravarthy Nagarajan, Khadija Mahmoud, Anuj Iravane | 22 avril 2026
- Transformation de centaines de pages en informations cliniques exploitables
- Réponse au défi de l’identification des documents dans le secteur de la santé
- Création d’un pipeline d’automatisation clinique conçu pour la mise à l’échelle
- Accélération des décisions cliniques et de l’efficacité opérationnelle
Transformation de centaines de pages en informations cliniques exploitables
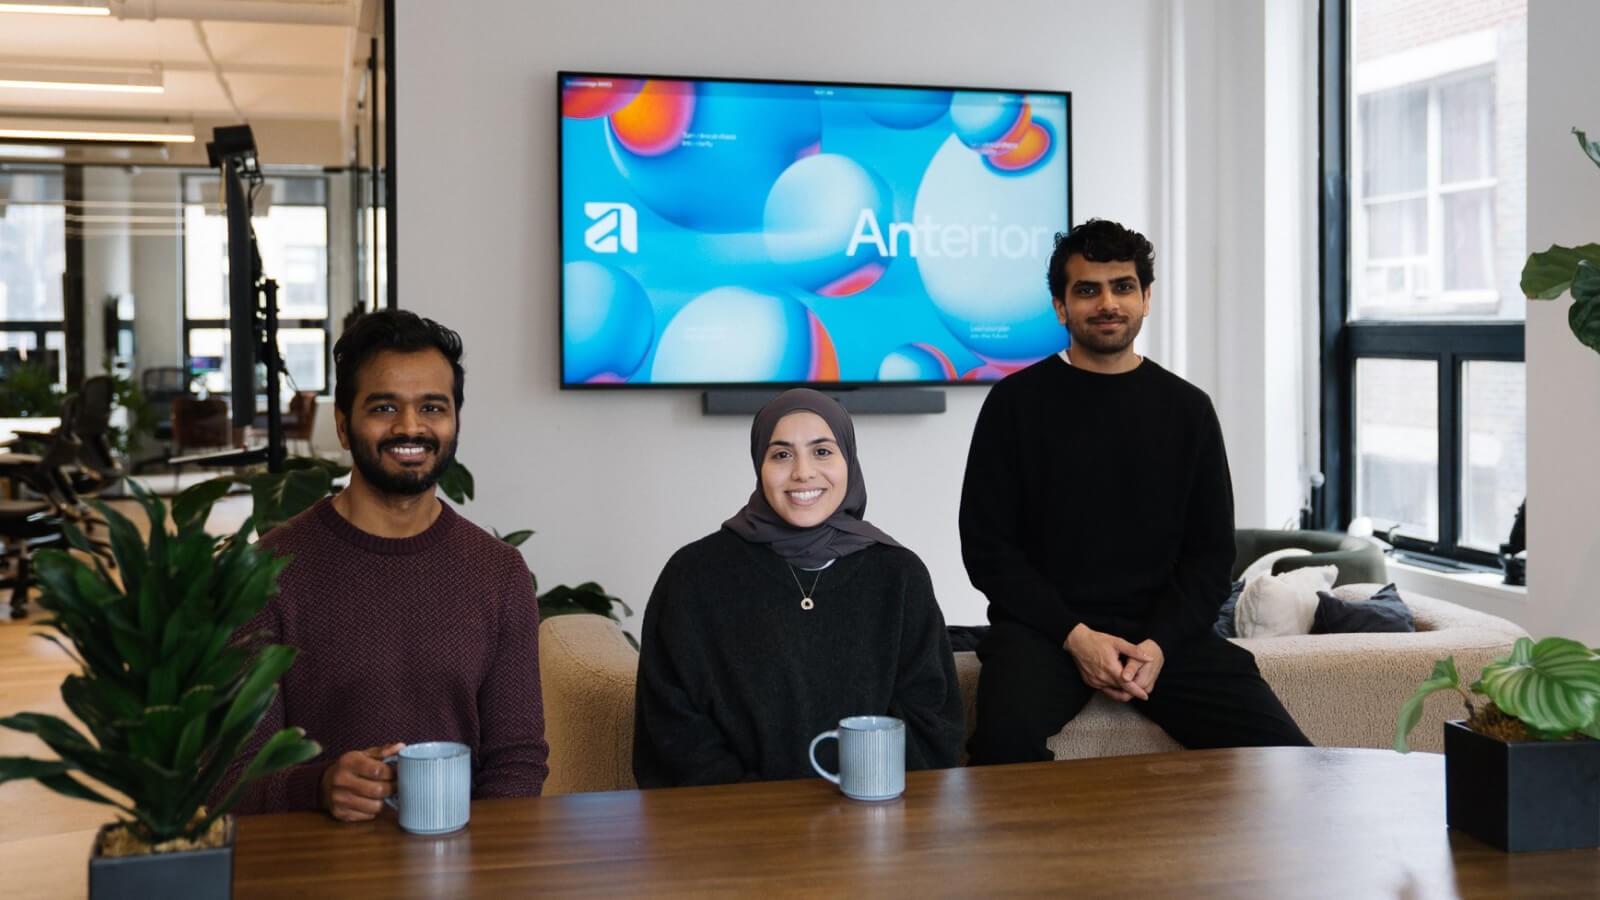
Anterior, une entreprise d’IA dirigée par des cliniciens qui développe l’automatisation pour les payeurs du secteur de la santé (compagnies d’assurance), a entrepris de résoudre l’un des problèmes de données les plus difficiles du secteur : identifier et structurer des documents cliniques qui arrivent souvent sous la forme de centaines de pages de dossiers non structurés. Après avoir mis en œuvre des modèles Llama de Meta sur Amazon Bedrock afin d’alimenter l’identification des documents dans les environnements Amazon Web Services (AWS) des clients, Anterior a obtenu des performances de niveau production tout en répondant à des exigences strictes de gouvernance des données de santé. Grâce à cette approche, Anterior a assuré une extraction complète des documents, amélioré la précision des métadonnées et permis une automatisation en aval qui réduit de 75 % les examens cliniques manuels.
Réponse au défi de l’identification des documents dans le secteur de la santé
Les coûts administratifs de la santé aux États-Unis dépassent 950 milliards d’USD par an dans un secteur de 5 000 milliards d’USD. Cette charge provient en grande partie des flux de travail d’examen clinique au sein des régimes d’assurance santé, où médecins et infirmiers examinent manuellement de gros dossiers médicaux afin d’approuver les traitements, de vérifier la couverture et de gérer les soins aux patients. Anterior est une entreprise d’IA dirigée par des cliniciens qui automatise ces flux de travail pour les payeurs du secteur de la santé, c’est-à-dire les organisations situées à l’intersection des prestataires et des patients.
Au cœur de ces flux de travail se trouve une tâche d’une simplicité trompeuse : avant de pouvoir raisonner sur un cas clinique, l’IA doit comprendre ce qu’elle examine. L’identification des documents est le prérequis de toute automatisation en aval. Anterior doit segmenter chaque dossier clinique entrant en ses documents constitutifs, identifier où chacun commence et se termine, puis extraire des métadonnées structurées, notamment le type de document, le titre, l’auteur et la date de création. Ce n’est qu’ensuite que l’automatisation clinique peut se poursuivre, qu’il s’agisse d’acheminer un rapport d’IRM vers la bonne étape d’un examen d’autorisation préalable, de faire ressortir une imagerie récente pour un clinicien ou de vérifier que la documentation justifie un parcours de soins recommandé. Cependant, les dossiers cliniques peuvent compter des centaines de pages et arriver sous forme de fax, de PDF numérisés et de fichiers multidocuments fusionnés. Ils peuvent combiner imagerie, tableaux, formulaires et même notes manuscrites d’une manière que les approches traditionnelles de l’IA et du ML ont longtemps eu du mal à gérer de façon fiable à l’échelle de la production.
Les conséquences d’une erreur sont importantes. « Même de petites erreurs dans l’identification des documents peuvent se répercuter en aval, car vous fondez vos décisions cliniques sur des informations incomplètes ou incorrectes », a déclaré Khadija Mahmoud, MD, médecin-chercheuse chez Anterior. Une limite de document mal identifiée peut faire remonter des informations cliniques provenant de la mauvaise partie du dossier d’un patient, tandis qu’une page omise peut créer une faille de conformité. Tout modèle capable de gérer l’identification de documents de niveau production doit également répondre à des exigences strictes de gouvernance des données de santé. Bon nombre des plus grands clients d’Anterior exigent que tout le traitement de l’IA, y compris l’inférence LLM sur des informations de santé protégées (PHI), s’effectue entièrement dans leur environnement AWS, ce qui rend inacceptables les API externes ou les infrastructures tierces.
Création d’un pipeline d’automatisation clinique conçu pour la mise à l’échelle
Anterior a mis en œuvre un flux de travail d’identification de documents alimenté par des modèles Meta Llama exécutés sur Amazon Bedrock. Cette architecture traite de bout en bout des dossiers documentaires cliniques complexes dans l’environnement AWS d’un client, afin que les données des patients ne quittent jamais ce périmètre. Le flux de travail fonctionne comme un pipeline en deux étapes. Dans la première étape, les PDF cliniques volumineux sont traités par reconnaissance optique de caractères (OCR) et analyse tenant compte de la mise en page. Chaque page est convertie en extraits de texte structurés tout en conservant les références de page et les identifiants uniques. Dans la deuxième étape, un modèle de langage analyse ces extraits analysés afin de déterminer les limites des documents, de classer le type de document et d’extraire des métadonnées comme le titre, l’auteur, la date de création et une description clinique. C’est à cette étape que les modèles Llama sur Amazon Bedrock interviennent.
Anterior a évalué Llama 4 Maverick 17B et Llama 4 Scout 17B par rapport à un modèle multimodal propriétaire de type modèle frontière, avec des invites, des jeux de données et des critères d’évaluation identiques. L’évaluation s’est déroulée entièrement au sein de l’infrastructure AWS et a mesuré le degré de préparation à la production selon la précision, l’exhaustivité, la cohérence et la latence. Les jeux de données ont été générés par le pipeline de données synthétiques d’Anterior et sélectionnés par des cliniciens-chercheurs afin de refléter la complexité du monde réel : mise en forme ambiguë, dossiers multidocuments et cas limites. Llama était un candidat solide pour plusieurs raisons : il prend en charge les entrées multimodales, ce qui correspond à la nature intrinsèquement multimodale des données cliniques ; il permet une inférence efficace pour les charges de travail à haut débit ; et il offre une grande fenêtre de contexte qui gère aisément les dossiers cliniques volumineux. Il fait également partie des modèles à poids ouverts les plus faciles à ajuster, ce qui permet à Anterior d’adapter le comportement du modèle au moyen d’invites et de contraintes au niveau du système, et d’explorer de plus petits modèles spécialisés, optimisés pour des tâches cliniques précises, plutôt que de s’appuyer uniquement sur des modèles de type modèle frontière.
L’exécution de Llama sur Amazon Bedrock a permis à l’équipe de cliniciens et d’ingénieurs de l’entreprise de se concentrer sur la résolution du problème clinique plutôt que sur la gestion de l’infrastructure. Bedrock fournit une interface unifiée pour évaluer et déployer des modèles de fondation, tout en s’intégrant directement aux environnements AWS. « De nombreux grands régimes d’assurance santé avec lesquels nous travaillons posent la même question : "Pouvons-nous exécuter l’IA sur des informations de santé protégées (PHI) dans notre environnement AWS ?" Les modèles Llama hébergés sur Bedrock nous permettent de répondre oui sans compromettre les performances », a déclaré Anuj Iravane, responsable de l’IA appliquée chez Anterior. Bedrock préserve également la flexibilité : Anterior peut évaluer d’autres modèles ou déployer des versions personnalisées peaufinées à mesure que les exigences cliniques évoluent, sans reconstruire son architecture.
Accélération des décisions cliniques et de l’efficacité opérationnelle
Sur un jeu de données de cas cliniques synthétiques préparés par des cliniciens, Llama 4 Maverick 17B et Llama 4 Scout 17B ont tous deux fourni des performances de niveau production pour l’identification de documents cliniques. Ces modèles ont égalé un modèle frontière comportant des centaines de milliards de paramètres tout en s’exécutant plus efficacement, malgré l’utilisation de 17 milliards de paramètres actifs (17B) au sein d’architectures de modèles plus vastes. Ils ont assuré une couverture complète des pages, ce qui signifie que chaque page d’un dossier clinique a été attribuée exactement une fois, sans contenu omis ni dupliqué. Les résultats ont été particulièrement solides en extraction de métadonnées. Les modèles Llama ont égalé ou dépassé le modèle frontière de référence dans l’identification d’informations clés comme l’auteur des documents et leurs descriptions. La précision de l’identification des auteurs a atteint 97 %, contre 93,5 % pour le modèle frontière, tandis que la fidélité des descriptions a atteint 98,4 %. « Nous avons été impressionnés », a déclaré Anuj Iravane. « Les modèles Llama sur Bedrock ont égalé notre modèle frontière de référence pour une fraction du coût et, dans l’extraction de métadonnées, ils l’ont même surpassé. Vous n’avez pas besoin du plus grand modèle pour résoudre les problèmes les plus difficiles du secteur de la santé. »
La latence était comparable entre les modèles, mais les gains d’efficacité des modèles Llama plus petits exécutés sur Bedrock se cumulent à grande échelle. À mesure que les volumes de documents augmentent, Anterior peut traiter davantage de cas par unité de calcul, avec un coût par document inférieur et sans sacrifier la précision. L’impact en aval sur les flux de travail du secteur de la santé est considérable. Dans l’examen des autorisations préalables, la plateforme Anterior réduit de 75 % le temps d’examen clinique manuel tout en conservant une précision clinique de 99,24 %. Une étude de cas de KLAS Research a montré que le système réduisait les délais d’attente des patients pour l’approbation des soins contre le cancer, de plusieurs jours ou semaines à seulement 155 secondes. Pour une organisation régionale de santé couvrant environ un million de personnes, ces améliorations représentent environ 30 millions d’USD d’économies opérationnelles annuelles. Une compréhension plus rapide des documents se traduit, au bout du compte, par des décisions cliniques accélérées et un accès plus rapide aux soins pour les patients.
Anterior est passée de l’intégration initiale au déploiement en six semaines. Les modèles Llama font désormais partie du flux de travail d’identification de documents en production de l’entreprise, au service de plusieurs clients grands comptes. Les résultats ont également validé une approche architecturale plus large : de petits modèles à poids ouverts (« open-weight ») hébergés sur Amazon Bedrock peuvent rivaliser avec des modèles frontières généralistes dans les flux de travail du secteur de la santé. « Une grande partie du système de santé américain repose sur AWS », a déclaré Anuj Iravane. « Prouver que les modèles Llama sur Bedrock peuvent atteindre les performances des modèles frontières signifie que nos clients peuvent déployer plus vite, mieux maîtriser les coûts et maintenir le niveau de sécurité requis. »
Harshvardhan Chunawala
 Harshvardhan Chunawala est architecte de solutions chez Amazon Web Services, formateur agréé par AWS Academy et titulaire de l’AWS Golden Jacket. Il travaille avec des fondateurs de start-ups et des cadres dirigeants du monde entier pour concevoir, dans différents secteurs, des infrastructures cloud sécurisées et adaptées à la mise à l’échelle sur AWS. Chez AWS, il est membre du groupe technique de terrain (TFC) dédié à l’aérospatiale, l’IA/ML, la sécurité, l’éducation et les ISV. Il collabore avec plusieurs équipes Amazon, notamment Amazon Leo, Amazon Security et l’équipe de l’IA agentique AWS, afin de concevoir et de fournir des capacités cloud frontières dans les services satellites, de sécurité et d’IA agentique fiable. Technologue reconnu dans le monde entier et expert en sécurité cloud, Harshvardhan Chunawala est enseignant invité et chercheur à l’université Carnegie Mellon (CMU), où il accompagne la prochaine génération de professionnels du cloud et d’entrepreneurs. Harshvardhan Chunawala a été responsable de l’ingénierie de mission spatiale et opérateur de mission à la CMU pour la première mission lunaire américaine depuis Apollo 17. En dehors du travail, Harshvardhan Chunawala cultive son amour du ciel en pratiquant le parachutisme et en pilotant des avions.
Chakravarthy Nagarajan
 Chakravarthy Nagarajan est architecte de solutions principal spécialisé dans le machine learning. Dans ses fonctions actuelles, il aide les clients à résoudre des problèmes métier complexes et concrets à l’aide de solutions de machine learning et d’IA générative. Il se concentre sur la personnalisation des modèles et aide les entreprises à exploiter le véritable potentiel des LLM grâce à cette personnalisation.
Khadija Mahmoud
 Khadija Mahmoud, MD, est médecin-chercheuse en IA appliquée chez Anterior. Elle travaille sur des jeux de données cliniques, l’analyse comparative et l’évaluation de modèles dans des systèmes de santé réels. Ses recherches portent sur le raisonnement clinique, les biais et l’équité en IA, ainsi que sur le déploiement sûr du machine learning dans le secteur de la santé. Ses travaux ont été publiés dans des revues à comité de lecture. Elle est titulaire d’une maîtrise en intelligence artificielle appliquée à la santé et d’un doctorat en médecine de l’Imperial College London.
Anuj Iravane
 Anuj Iravane dirige l’IA chez Anterior, où il travaille à l’intersection de la recherche et de la production pour créer des agents fiables, conformes aux politiques et capables de s’améliorer d’eux-mêmes pour le raisonnement clinique. Avant Anterior, il a travaillé sur des systèmes de recommandation chez Amazon. Il est titulaire d’une licence en informatique de Northwestern University. Au-delà de l’IA, il est producteur et réalisateur dans l’écosystème du cinéma indépendant indien.
Autres moyens de développer votre activité sur AWS
Avez-vous trouvé les informations que vous recherchiez ?
Faites-nous part de vos commentaires afin que nous puissions améliorer le contenu de nos pages