Anterior reduce el tiempo de revisión clínica en un 75 % con Amazon Bedrock y Llama
de Harshvardhan Chunawala, Chakravarthy Nagarajan, Khadija Mahmoud, Anuj Iravane | 22 de abril de 2026
Conversión de cientos de páginas en información clínica práctica
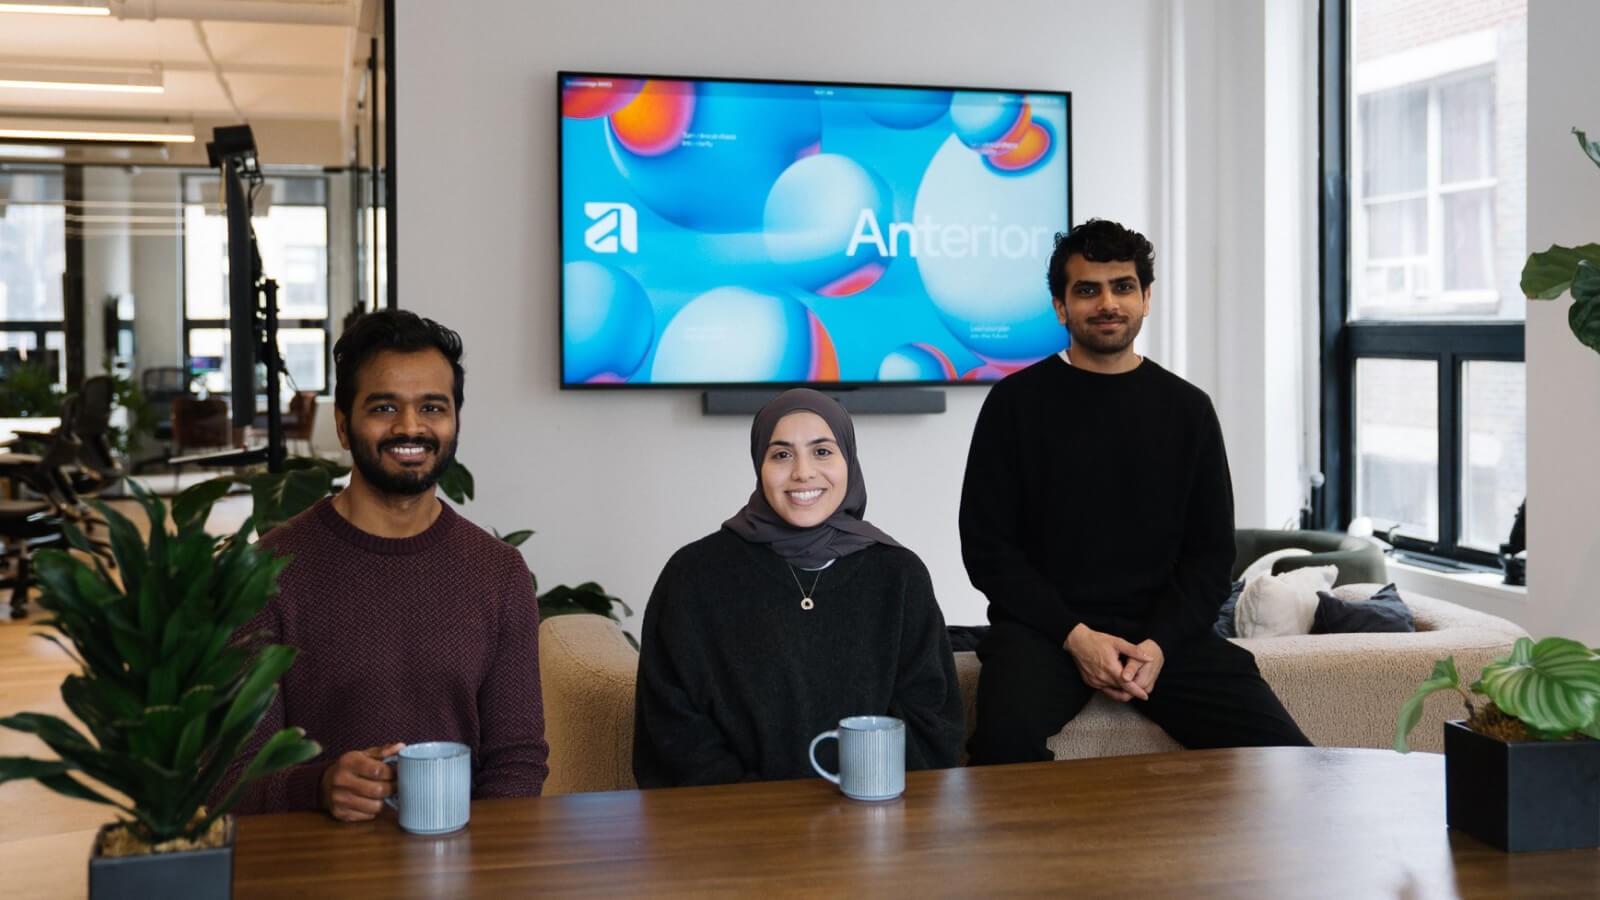
Anterior, una empresa de IA dirigida por médicos que desarrolla la automatización para los pagadores de la atención médica (compañías de seguros), se propuso resolver uno de los problemas de datos más difíciles de la atención médica: identificar y estructurar los documentos clínicos que a menudo llegan como cientos de páginas de registros no estructurados. Tras implementar los modelos Llama de Meta en Amazon Bedrock para impulsar la identificación de documentos en los entornos de Amazon Web Services (AWS) de los clientes, Anterior logró un rendimiento de nivel de producción y, al mismo tiempo, cumplió con los estrictos requisitos de gobernanza de datos del sector de la atención médica. Con este enfoque, Anterior logró una extracción completa de documentos, mejoró la precisión de los metadatos y permitió la automatización posterior que reduce la revisión clínica manual en un 75 %.
Abordar el desafío de identificación de documentos de la atención médica
Los costos administrativos de la atención médica en Estados Unidos superan los 950 000 millones de dólares al año en un sector de 5 billones de dólares. Gran parte de esta carga proviene de los flujos de trabajo de revisión clínica dentro de los planes de salud, en los que los médicos y las enfermeras revisan manualmente grandes paquetes de historias clínicas para aprobar los tratamientos, verificar la cobertura y administrar la atención de los pacientes. Anterior es una empresa de IA dirigida por médicos que se centra en automatizar estos flujos de trabajo para los pagadores de atención médica, las organizaciones que se encuentran en la intersección entre los proveedores y los pacientes.
En el centro de estos flujos de trabajo hay una tarea que parece engañosamente simple: antes de que la IA pueda razonar sobre un caso clínico, debe entender lo que está buscando. La identificación de documentos es el requisito previo para toda la automatización posterior. Anterior debe segmentar cada paquete clínico entrante en sus documentos constitutivos, identificar dónde comienza y termina cada uno y extraer los metadatos estructurados, incluidos el tipo de documento, el título, el autor y la fecha de creación. Solo entonces podrá continuar la automatización clínica, ya sea encaminando un informe de resonancia magnética al paso correcto en una revisión de autorización previa, revelando imágenes recientes para un médico o verificando que la documentación respalde el tratamiento recomendado. Sin embargo, los paquetes clínicos pueden tener cientos de páginas y llegar como faxes, archivos PDF escaneados y archivos de varios documentos combinados. Pueden combinar imágenes, tablas, formularios e incluso notas manuscritas de formas en las que los enfoques tradicionales de IA y ML han tenido dificultades durante mucho tiempo para gestionar de forma fiable a escala de producción.
Si se equivoca, el peligro es inconmensurable. “Incluso los pequeños errores en la identificación de los documentos pueden ir en cascada, porque las decisiones clínicas se basan en información incompleta o incorrecta”, dijo la Dra. Khadija Mahmoud, científica clínica de Anterior. Un límite de documentos mal identificado podría significar que aparezca información clínica de la parte incorrecta de la historia clínica de un paciente, mientras que una página descartada podría crear una brecha de cumplimiento. Cualquier modelo capaz de gestionar la identificación de documentos a nivel de producción también debe cumplir con estrictos requisitos de gobernanza de datos de atención médica. Muchos de los principales clientes de Anterior exigen que todo el procesamiento de la IA, incluida la inferencia de LLM sobre la información médica protegida (PHI), se realice completamente dentro de su entorno de AWS, lo que hace que las API externas o la infraestructura de terceros sean inaceptables.
Creación de una canalización escalable para la automatización clínica
Anterior implementó un flujo de trabajo de identificación de documentos basado en modelos de Meta Llama que se ejecutan en Amazon Bedrock. Esta arquitectura procesa paquetes complejos de documentos clínicos de principio a fin en el entorno de AWS del cliente, de modo que los datos de los pacientes nunca sobrepasan ese límite. El flujo de trabajo funciona como una canalización en dos etapas. En la primera etapa, los archivos PDF clínicos de gran tamaño se procesan mediante el reconocimiento óptico de caracteres (OCR) y el análisis basado en el diseño. Cada página se convierte en extractos de texto estructurados y, al mismo tiempo, conserva las referencias de página y los identificadores únicos. En la segunda etapa, un modelo de lenguaje analiza estos extractos analizados para determinar los límites del documento, clasificar el tipo de documento y extraer metadatos como el título, el autor, la fecha de creación y una descripción clínica. En esta etapa es donde las modelos Llama en Amazon Bedrock hacen el trabajo.
Anterior evaluó el modelo Llama 4 Maverick 17B y el modelo Llama 4 Scout 17B comparándolos con un modelo multimodal patentado a escala de frontera utilizando prompts, conjuntos de datos y criterios de evaluación idénticos. La evaluación se llevó a cabo íntegramente en la infraestructura de AWS y midió la preparación de la producción en función de la precisión, la integridad, la coherencia y la latencia. Los conjuntos de datos se generaron a través de la canalización de datos sintéticos de Anterior y fueron seleccionados por científicos clínicos para reflejar la complejidad del mundo real: formatos ambiguos, paquetes de varios documentos y casos extremos. Llama era un buen candidato por varias razones: admite entradas multimodales (lo que se alinea con la naturaleza intrínsecamente multimodal de los datos clínicos), permite una inferencia eficiente para cargas de trabajo de alto rendimiento y ofrece una gran ventana de contexto que gestiona cómodamente los paquetes clínicos de gran tamaño. También es uno de los modelos de peso abierto más ajustables disponibles, lo que permite a Anterior adaptar el comportamiento del modelo a través de restricciones a nivel de sistema y de prompts y explorar modelos más pequeños y especializados adaptados a tareas clínicas específicas, en lugar de confiar únicamente en modelos a escala de frontera.
La ejecución de Llama en Amazon Bedrock permitió al equipo de médicos e ingenieros de la empresa centrarse en resolver el problema clínico en lugar de en administrar la infraestructura. Bedrock proporciona una interfaz unificada para evaluar e implementar modelos fundacionales y, al mismo tiempo, integrarse directamente con los entornos de AWS. “Muchos de los principales planes de salud con los que trabajamos se hacen la misma pregunta: ‘¿Podemos ejecutar la IA en la PHI dentro de nuestro entorno de AWS?’ Los modelos Llama alojados en Bedrock nos permiten decir que sí sin comprometer el rendimiento”, afirma Anuj Iravane, director de IA Aplicada de Anterior. Bedrock también preserva la flexibilidad: Anterior puede evaluar modelos adicionales o implementar versiones personalizadas y refinadas a medida que evolucionan los requisitos clínicos sin tener que volver a crear la arquitectura.
Aceleración de las decisiones clínicas y la eficiencia operativa
En un conjunto de datos de casos clínicos sintéticos seleccionados por médicos, tanto el Llama 4 Maverick 17B como el Llama 4 Scout 17B ofrecieron un rendimiento de nivel de producción para la identificación de documentos clínicos. Los modelos coincidieron con un modelo a escala de frontera con cientos de miles de millones de parámetros y, al mismo tiempo, se ejecutaron de manera más eficiente, a pesar de utilizar 17 000 millones de parámetros activos en arquitecturas de modelos más grandes. Lograron una cobertura completa de páginas, lo que significa que cada página de un paquete clínico se asignó exactamente una vez sin contenido omitido o duplicado. Los resultados fueron particularmente buenos en la extracción de metadatos. Los modelos Llama igualaron o superaron la línea de referencia de frontera al identificar información clave, como la autoría y las descripciones de los documentos. La precisión en la identificación de los autores alcanzó el 97 %, en comparación con el 93,5 % del modelo de frontera, mientras que la fidelidad de la descripción alcanzó el 98,4 %. “Quedamos impresionados”, dijo Iravane. “Los modelos Llama en Bedrock igualaron nuestra línea de referencia de frontera en una fracción del costo, y en la extracción de metadatos, lo superaron. No se necesita el modelo más grande para resolver los problemas más difíciles de la atención médica”.
La latencia entre los modelos era comparable, pero las ventajas de eficiencia de los modelos Llama más pequeños que se ejecutan en Bedrock se combinan a gran escala. A medida que aumentan los volúmenes de documentos, Anterior puede procesar más casos por unidad de computación a un costo menor por documento sin sacrificar la precisión. El impacto posterior en los flujos de trabajo de atención médica es significativo. En la revisión con autorización previa, la plataforma Anterior reduce el tiempo de revisión clínica manual en un 75 % y mantiene una precisión clínica del 99,24 %. Un caso práctico de KLAS Research descubrió que el sistema redujo los tiempos de espera de los pacientes para recibir la aprobación de la atención oncológica de días o semanas a solo 155 segundos. Para una organización de atención médica regional que presta servicios a alrededor de un millón de personas cubiertas, estas mejoras se traducen en aproximadamente 30 millones de dólares en ahorros operativos anuales. Una comprensión más rápida de los documentos significa, en última instancia, decisiones clínicas más rápidas y un acceso más rápido a la atención para los pacientes.
Anterior pasó de la integración inicial a la implementación en seis semanas. Los modelos Llama ahora forman parte del flujo de trabajo de identificación de documentos de producción de la empresa que atiende a múltiples clientes empresariales. Los resultados también validaron un enfoque de arquitectura más amplio: que los modelos más pequeños de peso abierto alojados en Amazon Bedrock pueden competir con los modelos de uso general a gran escala en todos los flujos de trabajo de atención médica. “Gran parte de la atención médica de EE. UU. depende de AWS”, afirma Iravane. “Demostrar que los modelos Llama en Bedrock pueden igualar el rendimiento de la vanguardia significa que nuestros clientes pueden realizar implementaciones más rápido, controlar mejor los costos y mantener la postura de seguridad que necesitan”.
Harshvardhan Chunawala
 Harshvardhan Chunawala es arquitecto de soluciones en Amazon Web Services y profesor autorizado de AWS Academy, además de ser titular de una AWS Golden Jacket. Se asocia con fundadores de startups y ejecutivos de alto nivel de todo el mundo para diseñar una infraestructura en la nube segura y escalable en AWS en todos los sectores. En AWS, es miembro del TFC de Aerospace, IA/ML, Security, Education e ISV. Colabora en varios equipos de Amazon, como Amazon Leo, Seguridad de Amazon e IA agéntica de AWS, entre otros, para dar forma y ofrecer capacidades en la nube de vanguardia a través de servicios satelitales, de seguridad y de IA agéntica de confianza. Harshvardhan, tecnólogo reconocido a nivel mundial y experto en seguridad en la nube, es profesor visitante e investiga en la Universidad Carnegie Mellon (CMU), donde asesora a la próxima generación de profesionales y emprendedores en la nube. Harshvardhan actuó como jefe de ingeniería de misiones espaciales y operador de misión en la CMU para la primera misión lunar de los Estados Unidos desde el Apolo 17. Fuera del trabajo, Harshvardhan persigue su amor por los cielos haciendo paracaidismo y pilotando aviones.
Chakravarthy Nagarajan
 Chakravarthy Nagarajan es un arquitecto principal de soluciones especializado en machine learning. En su rol actual, ayuda a los clientes a resolver problemas empresariales complejos del mundo real mediante soluciones de machine learning e IA generativa. Se centra en la personalización de modelos, ayudando a las empresas a aprovechar el verdadero potencial de los LLM con el poder de la personalización.
Khadija Mahmoud
 La Dra. Khadija Mahmoud es científica clínica especializada en IA aplicada en Anterior y trabaja en conjuntos de datos clínicos, evaluaciones comparativas y evaluación de modelos en sistemas de salud del mundo real. Su investigación se centra en el razonamiento clínico, el sesgo y la equidad en la IA, y la implementación segura del machine learning en la atención médica, con trabajos publicados en revistas revisadas por pares. Tiene un máster en Inteligencia Artificial en Salud y un doctorado en Medicina por el Imperial College de Londres.
Anuj Iravane
 Anuj Iravane dirige la IA en Anterior, donde trabaja en la intersección de la investigación y la producción para crear agentes de confianza que cumplan con las políticas y que se mejoren a sí mismos para el razonamiento clínico. Antes de Anterior, trabajó en sistemas de recomendación en Amazon. Tiene una licenciatura en Ciencias Informáticas de la Universidad del Noroeste. Más allá de la IA, es productor y director en el ecosistema de cine independiente de la India.
Más formas de crecer en AWS
¿Encontró lo que buscaba hoy?
Ayúdenos a mejorar la calidad del contenido de nuestras páginas compartiendo sus comentarios