Anterior riduce i tempi di revisione clinica del 75% con Amazon Bedrock e Llama
di Harshvardhan Chunawala, Chakravarthy Nagarajan, Khadija Mahmoud, Anuj Iravane | 22 aprile 2026
Trasformare centinaia di pagine in approfondimenti clinici utilizzabili
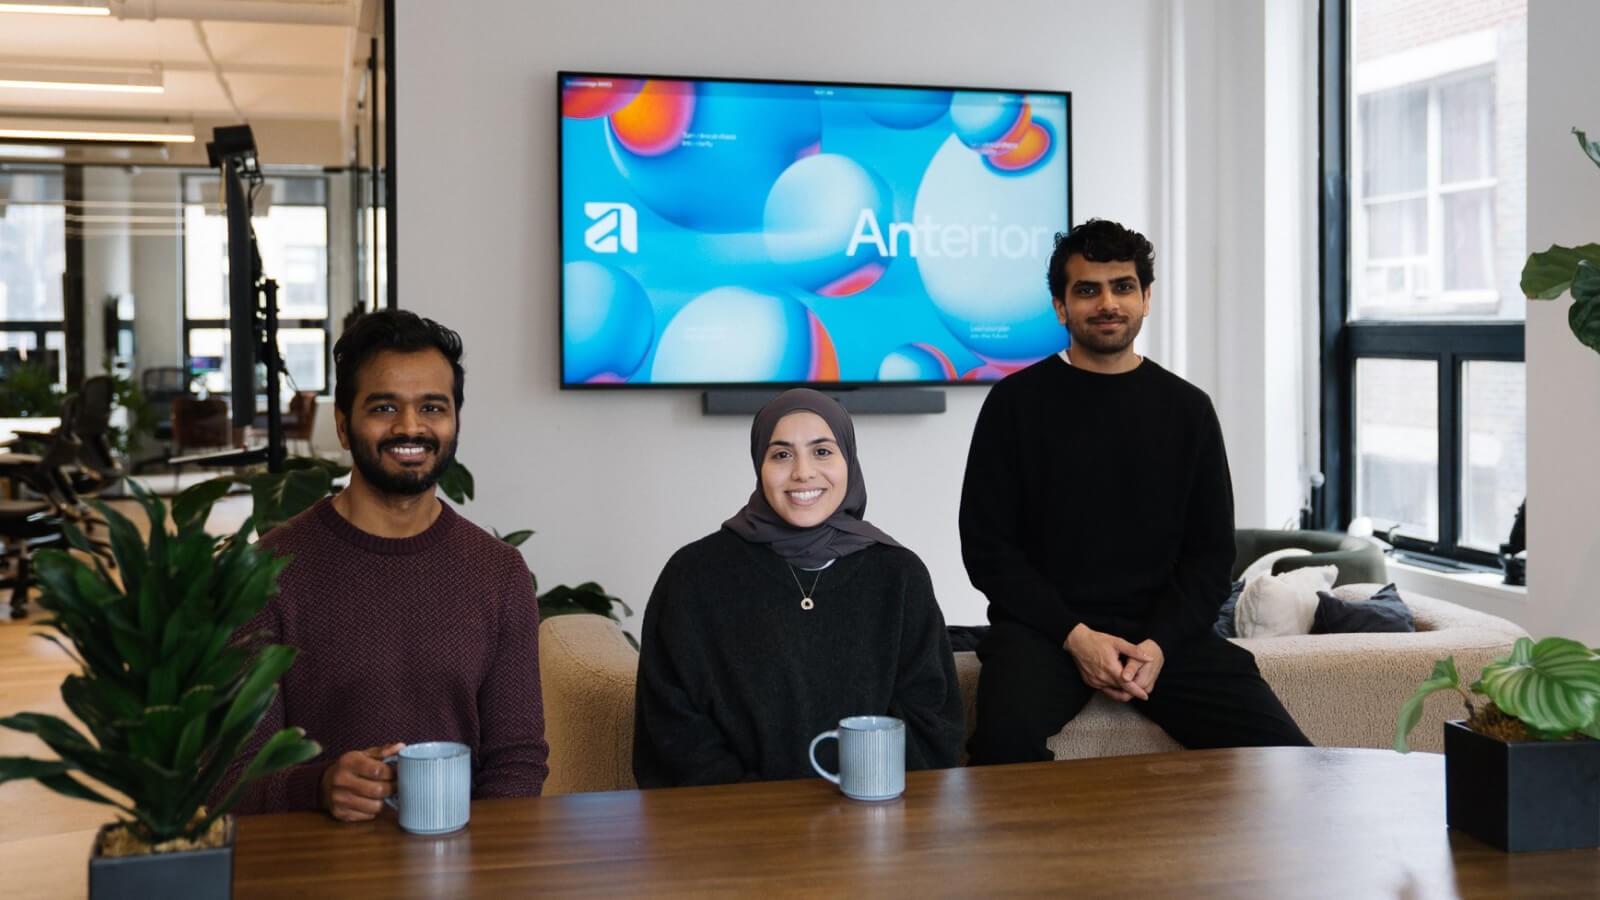
Anterior, una società di intelligenza artificiale guidata da medici che costruisce l'automazione per i pagatori sanitari (compagnie assicurative), si è posta l'obiettivo di risolvere uno dei problemi di dati più difficili del settore sanitario: identificare e strutturare i documenti clinici che spesso arrivano sotto forma di centinaia di pagine di record non strutturati. Dopo aver implementato i modelli Llama di Meta su Amazon Bedrock per potenziare l'identificazione dei documenti negli ambienti Amazon Web Services (AWS) dei clienti, Anterior ha raggiunto prestazioni di livello di produzione soddisfacendo al contempo rigorosi requisiti di governance dei dati sanitari. Utilizzando questo approccio, Anterior ha fornito l'estrazione completa dei documenti, una maggiore precisione dei metadati e ha consentito l'automazione a valle che riduce la revisione clinica manuale del 75%.
Affrontare la sfida dell'identificazione dei documenti nel settore sanitario
I costi amministrativi dell'assistenza sanitaria negli Stati Uniti superano i 950 miliardi di dollari all'anno in un settore da 5 trilioni di dollari. Gran parte di questo onere deriva dai flussi di lavoro di revisione clinica all'interno dei piani sanitari, in cui medici e infermieri esaminano manualmente grandi pacchetti di cartelle cliniche per approvare i trattamenti, verificare la copertura e gestire l'assistenza ai pazienti. Anterior è una società di intelligenza artificiale guidata da medici focalizzata sull'automazione di questi flussi di lavoro per i pagatori sanitari, organizzazioni che si trovano all'incrocio tra fornitori e pazienti.
Al centro di questi flussi di lavoro c'è un compito che sembra ingannevolmente semplice: prima che l'IA possa ragionare su un caso clinico, deve capire di cosa si tratta. L'identificazione dei documenti è il prerequisito per tutta l'automazione a valle. Anterior deve segmentare ogni pacchetto clinico in arrivo nei suoi documenti costitutivi, identificare dove inizia e finisce ciascuno ed estrarre metadati strutturati tra cui tipo di documento, titolo, autore e data di creazione. Solo allora l'automazione clinica può procedere, sia che si tratti di indirizzare un referto RM nella fase corretta di una revisione preventiva dell'autorizzazione, di far emergere immagini recenti per un medico o di verificare che la documentazione supporti un corso di cura consigliato. Tuttavia, i pacchetti clinici possono essere lunghi centinaia di pagine e arrivare come fax, PDF scansionati e file composti da più documenti uniti. Possono combinare immagini, tabelle, moduli e persino note scritte a mano in modi che i tradizionali approcci AI e ML hanno faticato a gestire in modo affidabile su scala di produzione.
La posta in gioco nel sbagliare è alta. «Anche piccoli errori nell'identificazione dei documenti possono verificarsi a cascata, perché si basano le decisioni cliniche su informazioni incomplete o errate», ha affermato Khadija Mahmoud, MD, scienziata clinica presso Anterior. Un confine del documento identificato erroneamente potrebbe comportare l'emergere di informazioni cliniche dalla parte sbagliata della cartella clinica di un paziente, mentre una pagina eliminata potrebbe creare un divario di conformità. Qualsiasi modello in grado di gestire l'identificazione dei documenti di livello di produzione deve inoltre soddisfare severi requisiti di governance dei dati sanitari. Molti dei maggiori clienti di Anterior richiedono che tutte le elaborazioni AI, inclusa l'inferenza LLM sulle informazioni sanitarie protette (PHI), avvengano interamente all'interno del loro ambiente AWS, rendendo inaccettabili le API esterne o l'infrastruttura di terze parti.
Creazione di una pipeline scalabile per l'automazione clinica
Anterior ha implementato un flusso di lavoro di identificazione dei documenti basato sui modelli Meta Llama in esecuzione su Amazon Bedrock. Questa architettura elabora complessi pacchetti di documenti clinici end-to-end all'interno dell'ambiente AWS di un cliente, in modo che i dati dei pazienti non escano mai da quel limite. Il flusso di lavoro funziona come una pipeline in due fasi. Nella prima fase, i PDF clinici di grandi dimensioni vengono elaborati utilizzando il riconoscimento ottico dei caratteri (OCR) e l'analisi basata sul layout. Ogni pagina viene convertita in estratti di testo strutturato preservando i riferimenti di pagina e gli identificatori univoci. Nella seconda fase, un modello linguistico analizza questi estratti analizzati per determinare i confini del documento, classificare il tipo di documento ed estrarre metadati come titolo, autore, data di creazione e una descrizione clinica. Questa fase è dove i modelli Llama su Amazon Bedrock fanno il lavoro.
Anterior ha valutato Llama 4 Maverick 17B e Llama 4 Scout 17B rispetto a un modello multimodale proprietario su scala di frontiera utilizzando prompt, set di dati e criteri di valutazione identici. La valutazione è stata eseguita interamente all'interno dell'infrastruttura AWS e ha misurato la preparazione alla produzione in termini di precisione, completezza, coerenza e latenza. I set di dati sono stati generati attraverso la pipeline di dati sintetici di Anterior e curati da scienziati clinici per riflettere la complessità del mondo reale: formattazione ambigua, pacchetti con più documenti e casi limite. Llama era un candidato valido per diversi motivi: supporta input multimodali (in linea con la natura intrinsecamente multimodale dei dati clinici), consente un'inferenza efficiente per carichi di lavoro ad alto rendimento e offre un'ampia finestra di contesto che gestisce comodamente lunghi pacchetti clinici. È anche tra i modelli a peso aperto più regolabili disponibili, consentendo a Anterior di personalizzare il comportamento del modello attraverso vincoli di richiesta e a livello di sistema ed esplorare modelli più piccoli e specializzati adattati a compiti clinici specifici anziché affidarsi esclusivamente a modelli su scala di frontiera.
L'esecuzione di Llama su Amazon Bedrock ha consentito al team di medici e ingegneri dell'azienda di concentrarsi sulla risoluzione del problema clinico piuttosto che sulla gestione dell'infrastruttura. Bedrock fornisce un'interfaccia unificata per la valutazione e la distribuzione di modelli di base integrandosi direttamente con gli ambienti AWS. «Molti dei principali piani sanitari con cui collaboriamo pongono la stessa domanda: 'Possiamo eseguire l'IA su PHI all'interno del nostro ambiente AWS? ' I modelli Llama ospitati da Bedrock ci consentono di dire sì senza compromettere le prestazioni», ha affermato Anuj Iravane, responsabile dell'intelligenza artificiale applicata presso Anterior. Bedrock preserva anche la flessibilità: Anterior può valutare modelli aggiuntivi o implementare versioni personalizzate ottimizzate man mano che i requisiti clinici si evolvono senza ricostruire la sua architettura.
Accelerazione delle decisioni cliniche e dell'efficienza operativa
Attraverso un set di dati di casi clinici sintetici curati dal medico, sia Llama 4 Maverick 17B che Llama 4 Scout 17B hanno fornito prestazioni di livello di produzione per l'identificazione dei documenti clinici. I modelli hanno abbinato un modello su scala di frontiera con centinaia di miliardi di parametri funzionando in modo più efficiente, nonostante l'utilizzo di 17 miliardi di parametri attivi all'interno di architetture di modelli più grandi. Hanno raggiunto una copertura completa delle pagine, il che significa che ogni pagina di un pacchetto clinico è stata assegnata esattamente una volta senza contenuti eliminati o duplicati. I risultati sono stati particolarmente forti nell'estrazione dei metadati. I modelli Llama corrispondevano o superavano la linea di base di frontiera nell'identificazione di informazioni chiave come la paternità e le descrizioni dei documenti. L'accuratezza dell'identificazione dell'autore ha raggiunto il 97%, rispetto al 93,5% del modello di frontiera, mentre la fedeltà della descrizione ha raggiunto il 98,4%. «Siamo rimasti colpiti», ha detto Iravane. «I modelli Llama su Bedrock corrispondevano alla nostra linea di base di frontiera a una frazione del costo e, nell'estrazione dei metadati, l'hanno effettivamente superata. Non è necessario il modello più grande per risolvere i problemi più difficili dell'assistenza sanitaria».
La latenza tra i modelli era paragonabile, ma i vantaggi in termini di efficienza dei modelli Llama più piccoli eseguiti su Bedrock erano composti su larga scala. Man mano che il volume dei documenti aumenta, Anterior è in grado di elaborare più casi per unità di calcolo a un costo inferiore per documento senza sacrificare la precisione. L'impatto a valle sui flussi di lavoro sanitari è significativo. Nella revisione preventiva dell'autorizzazione, la piattaforma Anterior riduce i tempi di revisione clinica manuale del 75% mantenendo un'accuratezza clinica del 99,24%. Un case study di KLAS Research ha rilevato che il sistema ha ridotto i tempi di attesa dei pazienti per l'approvazione delle cure oncologiche da giorni o settimane a soli 155 secondi. Per un'organizzazione sanitaria regionale che serve circa un milione di vite coperte, questi miglioramenti si traducono in circa 30 milioni di dollari di risparmi operativi annuali. Una comprensione più rapida dei documenti significa in definitiva decisioni cliniche più rapide e un accesso più rapido alle cure per i pazienti.
Anterior è passato dall'integrazione iniziale all'implementazione in sei settimane. I modelli Llama fanno ora parte del flusso di lavoro di identificazione dei documenti di produzione dell'azienda che serve più clienti aziendali. I risultati hanno inoltre convalidato un approccio architetturale più ampio: i modelli open weight più piccoli ospitati su Amazon Bedrock possono competere con i modelli generici su scala di frontiera nei flussi di lavoro sanitari. «Gran parte dell'assistenza sanitaria statunitense vive su AWS», ha affermato Iravane. «Dimostrare che i modelli Llama su Bedrock sono all'altezza delle prestazioni di frontiera significa che i nostri clienti possono implementare più rapidamente, controllare meglio i costi e mantenere il livello di sicurezza di cui hanno bisogno».
Harshvardhan Chunawala
 Harshvardhan Chunawala è Solutions Architect presso Amazon Web Services e docente autorizzato di AWS Academy, nonché titolare di AWS Golden Jacket. Collabora con fondatori di startup e dirigenti di C-suite a livello globale per progettare un'infrastruttura cloud scalabile e sicura su AWS in tutti i settori. In AWS, è membro TFC di Aerospace, AI/ML, Security, Education e ISV. Collabora con diversi team Amazon, tra cui Amazon Leo, Amazon Security e AWS Agentic AI, tra gli altri, per modellare e fornire funzionalità cloud di frontiera attraverso servizi di intelligenza artificiale agentica satellitari, di sicurezza e affidabili. Tecnologo ed esperto di sicurezza del cloud riconosciuto a livello mondiale, Harshvardhan è membro della Facoltà in visita e svolge attività di ricerca presso la Carnegie Mellon University (CMU), facendo da mentore alla prossima generazione di professionisti e imprenditori del cloud. Harshvardhan è stato Space Mission Engineering Lead e Mission Operator presso il CMU per la prima missione lunare americana dopo l'Apollo 17. Al di fuori del lavoro, Harshvardhan persegue il suo amore per i cieli attraverso il paracadutismo e il volo di aerei.
Chakravarthy Nagarajan
 Chakravarthy Nagarajan è un Principal Solutions Architect specializzato in machine learning. Nel suo ruolo attuale, aiuta i clienti a risolvere problemi aziendali complessi e reali utilizzando soluzioni di machine learning e intelligenza artificiale generativa. Si concentra sulla personalizzazione dei modelli, aiutando le aziende a realizzare il vero potenziale degli LLM con il potere della personalizzazione.
Khadija Mahmoud
 Khadija Mahmoud, MD, è una scienziata clinica in intelligenza artificiale applicata presso Anterior, che lavora su set di dati clinici, benchmarking e valutazione dei modelli nei sistemi sanitari del mondo reale. La sua ricerca si concentra sul ragionamento clinico, sui pregiudizi e sull'equità nell'intelligenza artificiale e sull'implementazione sicura dell'apprendimento automatico nell'assistenza sanitaria, con lavori pubblicati su riviste peer-reviewed. Ha conseguito un Master in Intelligenza Artificiale nel settore sanitario e un MD presso l'Imperial College di Londra.
Anuj Iravane
 Anuj Iravane dirige l'intelligenza artificiale presso Anterior, dove lavora all'incrocio tra ricerca e produzione per creare agenti affidabili, aderenti alle politiche e che si migliorano automaticamente per il ragionamento clinico. Prima di Anterior, ha lavorato su sistemi di raccomandazione presso Amazon. Ha conseguito una laurea in Informatica presso la Northwestern University. Oltre all'intelligenza artificiale, è produttore e regista dell'ecosistema cinematografico indipendente indiano.
Altri modi per crescere su AWS
Hai trovato quello che cercavi?
Condividi il tuo feedback, così possiamo migliorare la qualità dei nostri contenuti.