AnteriorはAmazon BedrockとLlamaで臨床レビュー時間を 75% 短縮しました
著ハーシュヴァルダン・チュナワラ、チャクラヴァルシー・ナガラジャン、ハディージャ・マフムード、アヌジ・イラヴァネ | 2026年4月22日
何百ページものページを実用的な臨床インサイトに変える
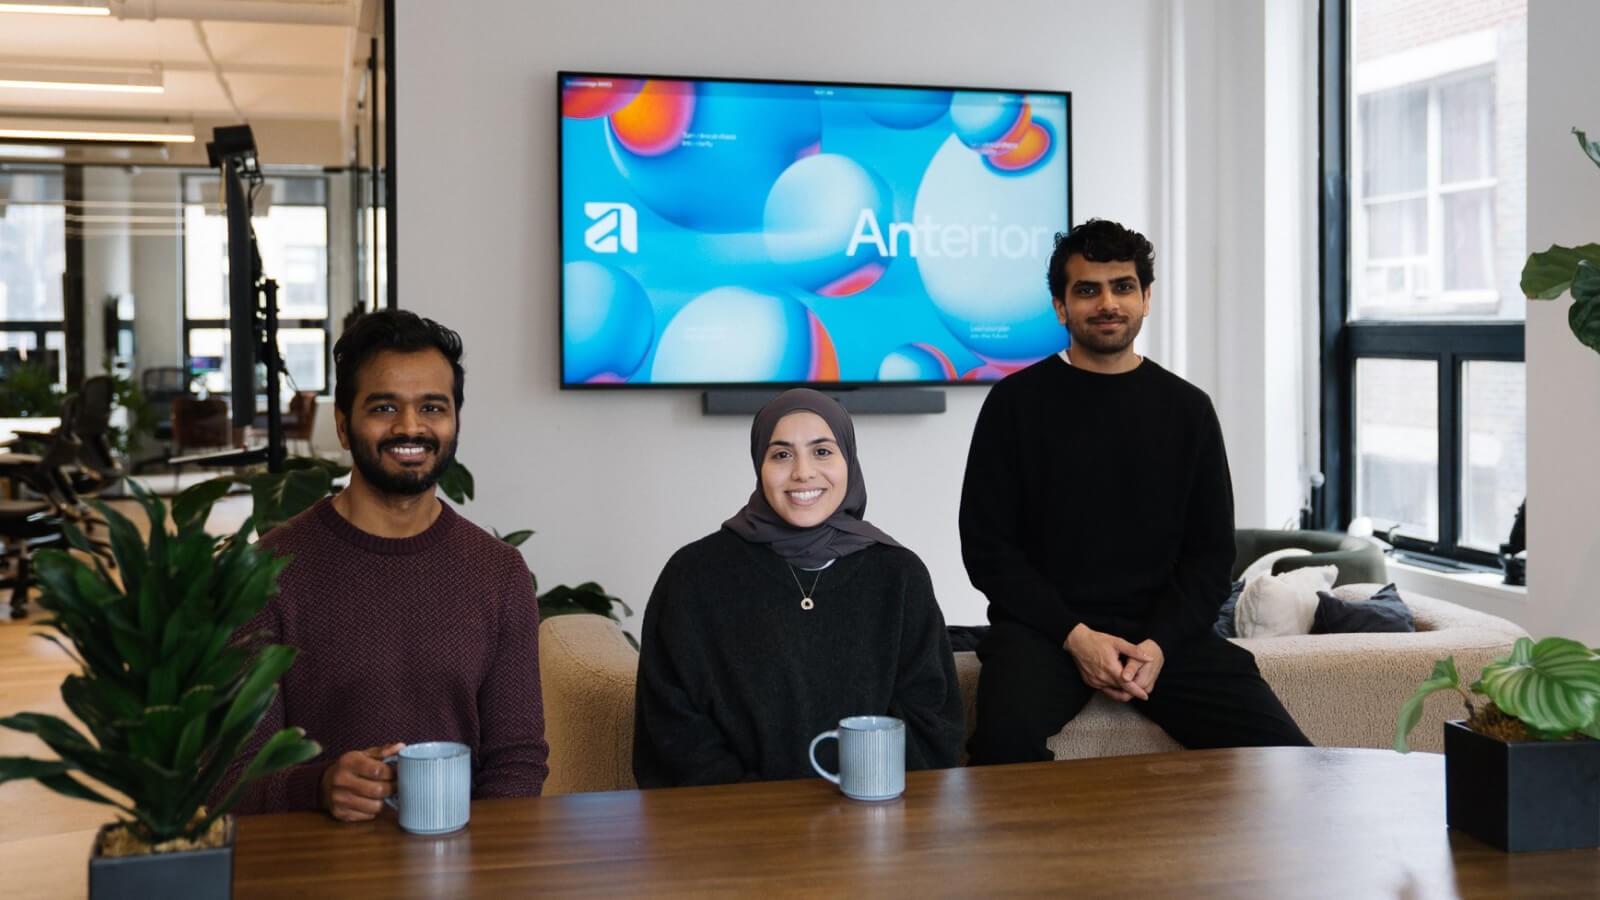
Anterior は、医療費支払者(保険会社)向けにオートメーションを構築する臨床医主導の AI 企業で、医療で最も難しいデータ問題の 1 つを解決しようと試みました。それは、数百ページにも及ぶ非構造化記録として届くことが多い臨床文書の識別と構造化です。顧客のアマゾンウェブサービス(AWS)環境内での文書識別を強化するために、 Meta on Amazon BedrockのLlamaモデルを実装した結果、Anteriorは厳格な医療データガバナンス要件を満たしながら、プロダクショングレードのパフォーマンスを実現しました。このアプローチにより、Anteriorは完全な文書抽出、メタデータの精度の向上、ダウンストリームの自動化を実現し、手作業による臨床レビューを 75% 削減しました。
医療機関の文書識別の課題への対処
米国の医療管理費は、5兆ドル規模の産業で年間9,500億ドルを超えています。この負担の多くは、医療プラン内の臨床レビューワークフローによるものです。このワークフローでは、医師や看護師が大量の医療記録を手作業で確認して、治療の承認、補償範囲の検証、患者ケアの管理を行います。Anteriorは臨床医主導のAI企業で、医療従事者、つまり医療提供者と患者が交差する組織を対象に、これらのワークフローを自動化することに重点を置いています。
これらのワークフローの中心にあるのは、一見単純そうに聞こえるタスクです。AIが臨床事例について推論する前に、何を見ているのかを理解する必要があります。文書識別は、すべてのダウンストリーム自動化の前提条件です。Anteriorは、受信する各臨床パケットを構成文書に分割し、それぞれの開始点と終了点を特定し、文書タイプ、タイトル、作成者、作成日などの構造化されたメタデータを抽出する必要があります。そうして初めて、MRIレポートを事前の承認審査の正しいステップにルーティングしたり、臨床医に最新の画像を提供したり、文書が推奨治療方針をサポートしていることを確認したりするなど、臨床の自動化を進めることができます。ただし、臨床パケットは数百ページの長さで、ファックス、スキャンされたPDF、および結合されたマルチドキュメントファイルとして届く場合があります。従来のAIや機械学習のアプローチでは、生産規模での確実な処理が長い間困難であった方法で、画像、表、フォーム、さらには手書きのメモを組み合わせることもあります。
これを間違えることの危険性は高いです。Anteriorの臨床医科学者であるKhadija Mahmoud医学博士は、「不完全または不正確な情報に基づいて臨床上の意思決定を行っているため、文書の識別における小さな誤りでも下流に連鎖する可能性があります」と述べています。文書の境界を誤って特定すると、患者記録の間違った部分から臨床情報が明らかになり、ページをドロップするとコンプライアンスギャップが生じる可能性があります。プロダクショングレードの文書識別を処理できるモデルはすべて、厳格な医療データガバナンス要件を満たす必要もあります。Anterior の大手顧客の多くは、保護対象医療情報 (PHI) に関する LLM 推論を含むすべての AI 処理をすべて自社の AWS 環境内で行うことを求めているため、外部の API やサードパーティのインフラストラクチャは受け入れられません。
臨床自動化のためのスケーラブルなパイプラインの構築
Anteriorは、Amazon Bedrockで実行されているメタラマモデルを利用したドキュメント識別ワークフローを実装しました。このアーキテクチャは、複雑な臨床文書パケットをお客様の AWS 環境内でエンドツーエンドで処理するため、患者データがその境界を離れることはありません。このワークフローは 2 段階のパイプラインとして動作します。第1段階では、大きな臨床用PDFが光学式文字認識(OCR)とレイアウト対応解析を使用して処理されます。各ページは、ページ参照と一意の識別子を保持したまま、構造化されたテキスト抽出に変換されます。第2段階では、言語モデルがこれらの解析された抽出物を分析して、文書の境界を決定し、文書タイプを分類し、タイトル、著者、作成日、臨床説明などのメタデータを抽出します。このステージでは、Amazon Bedrockのラマモデルが作業を行います。
Anteriorは、同一のプロンプト、データセット、および評価基準を使用して、Llama 4 Maverick 17BとLlama 4 Scout 17Bをフロンティアスケールの独自のマルチモーダルモデルと照合して評価しました。評価は完全に AWS インフラストラクチャ内で行われ、正確性、完全性、一貫性、レイテンシーに関する本番環境の準備状況を測定しました。データセットはAnteriorの合成データパイプラインを通じて生成され、あいまいなフォーマット、マルチドキュメントパケット、エッジケースなど、現実世界の複雑さを反映するように臨床医の科学者によってキュレーションされました。Llamaが有力候補だった理由はいくつかあります。マルチモーダルインプットをサポートしている(これは臨床データに本質的にマルチモーダルな性質がある)、ハイスループットワークロードの効率的な推論を可能にする、長い臨床パケットを快適に処理できる大きなコンテキストウィンドウを提供することなどです。また、Anteriorは市販されている中で最も調整可能なオープンウェイトモデルの1つでもあります。これにより、Anteriorはプロンプトやシステムレベルの制約を通じてモデルの動作を調整し、フロンティアスケールのモデルだけに頼るのではなく、特定の臨床タスクに合わせて調整された小規模で特殊なモデルを探索できます。
Amazon BedrockでLlamaを実行することで、同社の臨床医とエンジニアのチームは、インフラストラクチャの管理ではなく、臨床問題の解決に集中できるようになりました。Bedrockは、AWS環境と直接統合しながら、基盤モデルを評価およびデプロイするための統一されたインターフェイスを提供します。「私たちが協力している多くの主要な医療保険は同じ質問をしています。『AWS 環境内の PHI で AI を実行できますか?' BedrockがホストするLlamaモデルでは、パフォーマンスを犠牲にすることなく「はい」と言えるようになりました」と、Anteriorの応用AI責任者であるAnuj Iravane氏は述べています。Bedrockは柔軟性も維持します。Anteriorは、アーキテクチャを再構築することなく、臨床要件の変化に応じて追加のモデルを評価したり、カスタムの微調整バージョンを導入したりできます。
臨床上の意思決定と業務効率の促進
臨床医が精選した合成臨床症例のデータセット全体で、ラマ4マーベリック17Bとラマ4スカウト17Bの両方が、臨床文書同定のためのプロダクショングレードのパフォーマンスを提供しました。これらのモデルは、大規模なモデルアーキテクチャで17Bのアクティブパラメータを使用しているにもかかわらず、より効率的に実行しながら、数千億のパラメータを持つフロンティアスケールのモデルと一致していました。これにより、完全なページカバレッジを実現しました。つまり、クリニカルパケットの各ページが 1 回だけ割り当てられ、コンテンツがドロップされたり重複したりすることはありませんでした。結果は特にメタデータ抽出で好調でした。Llamaモデルは、文書の作成者や説明などの重要な情報を特定する際に、フロンティアの基準と一致するか、それを上回りました。著者の識別精度は、フロンティアモデルの93.5%と比較して97%にも達し、記述の忠実度は98.4%に達しました。「感銘を受けました」とイラバネは言いました。「BedrockのLlamaモデルは、わずかなコストで私たちの最前線のベースラインと一致していました。メタデータ抽出では、実際にはそれを上回っていました。医療の最も困難な問題を解決するのに、最大規模のモデルは必要ありません。」
レイテンシーはモデル間で同等でしたが、Bedrock Compoundで大規模に実行する小型のLlamaモデルの効率上の利点がありました。文書量が増えるにつれて、Anterior は精度を犠牲にすることなく、1 文書あたりのコストを下げながら、計算単位あたりの処理件数を増やすことができます。医療ワークフローへのダウンストリームの影響は大きいです。事前の承認審査では、Anterior プラットフォームは 99.24% の臨床精度を維持しながら、手動による臨床審査時間を 75% 短縮します。KLAS Researchのケーススタディによると、このシステムにより、がん治療承認のための患者の待ち時間が数日または数週間からわずか155秒に短縮されました。約100万人の被保険者にサービスを提供している地域の医療機関にとって、これらの改善は年間約3,000万ドルの運営費の節約につながります。文書をより早く理解することは、最終的にはより迅速な臨床上の意思決定と患者のケアへのより迅速なアクセスにつながります。
Anteriorは、6週間で初期統合から導入に移行しました。Llamaモデルは現在、同社の製造文書識別ワークフローの一部となっており、複数の企業顧客にサービスを提供しています。この結果では、Amazon Bedrockでホストされている小規模なオープンウェイトモデルが、医療ワークフロー全体で最先端スケールの汎用モデルと競合できるという、より広範なアーキテクチャアプローチも検証されました。「米国の医療機関の多くは AWS を利用しています」と Iravane 氏は言います。「BedrockのLlamaモデルが最先端のパフォーマンスに匹敵することを証明できれば、お客様はより迅速に導入し、コストをより適切に管理し、必要なセキュリティ体制を維持できるようになります。」
ハーシュヴァルダン・チュナワラ
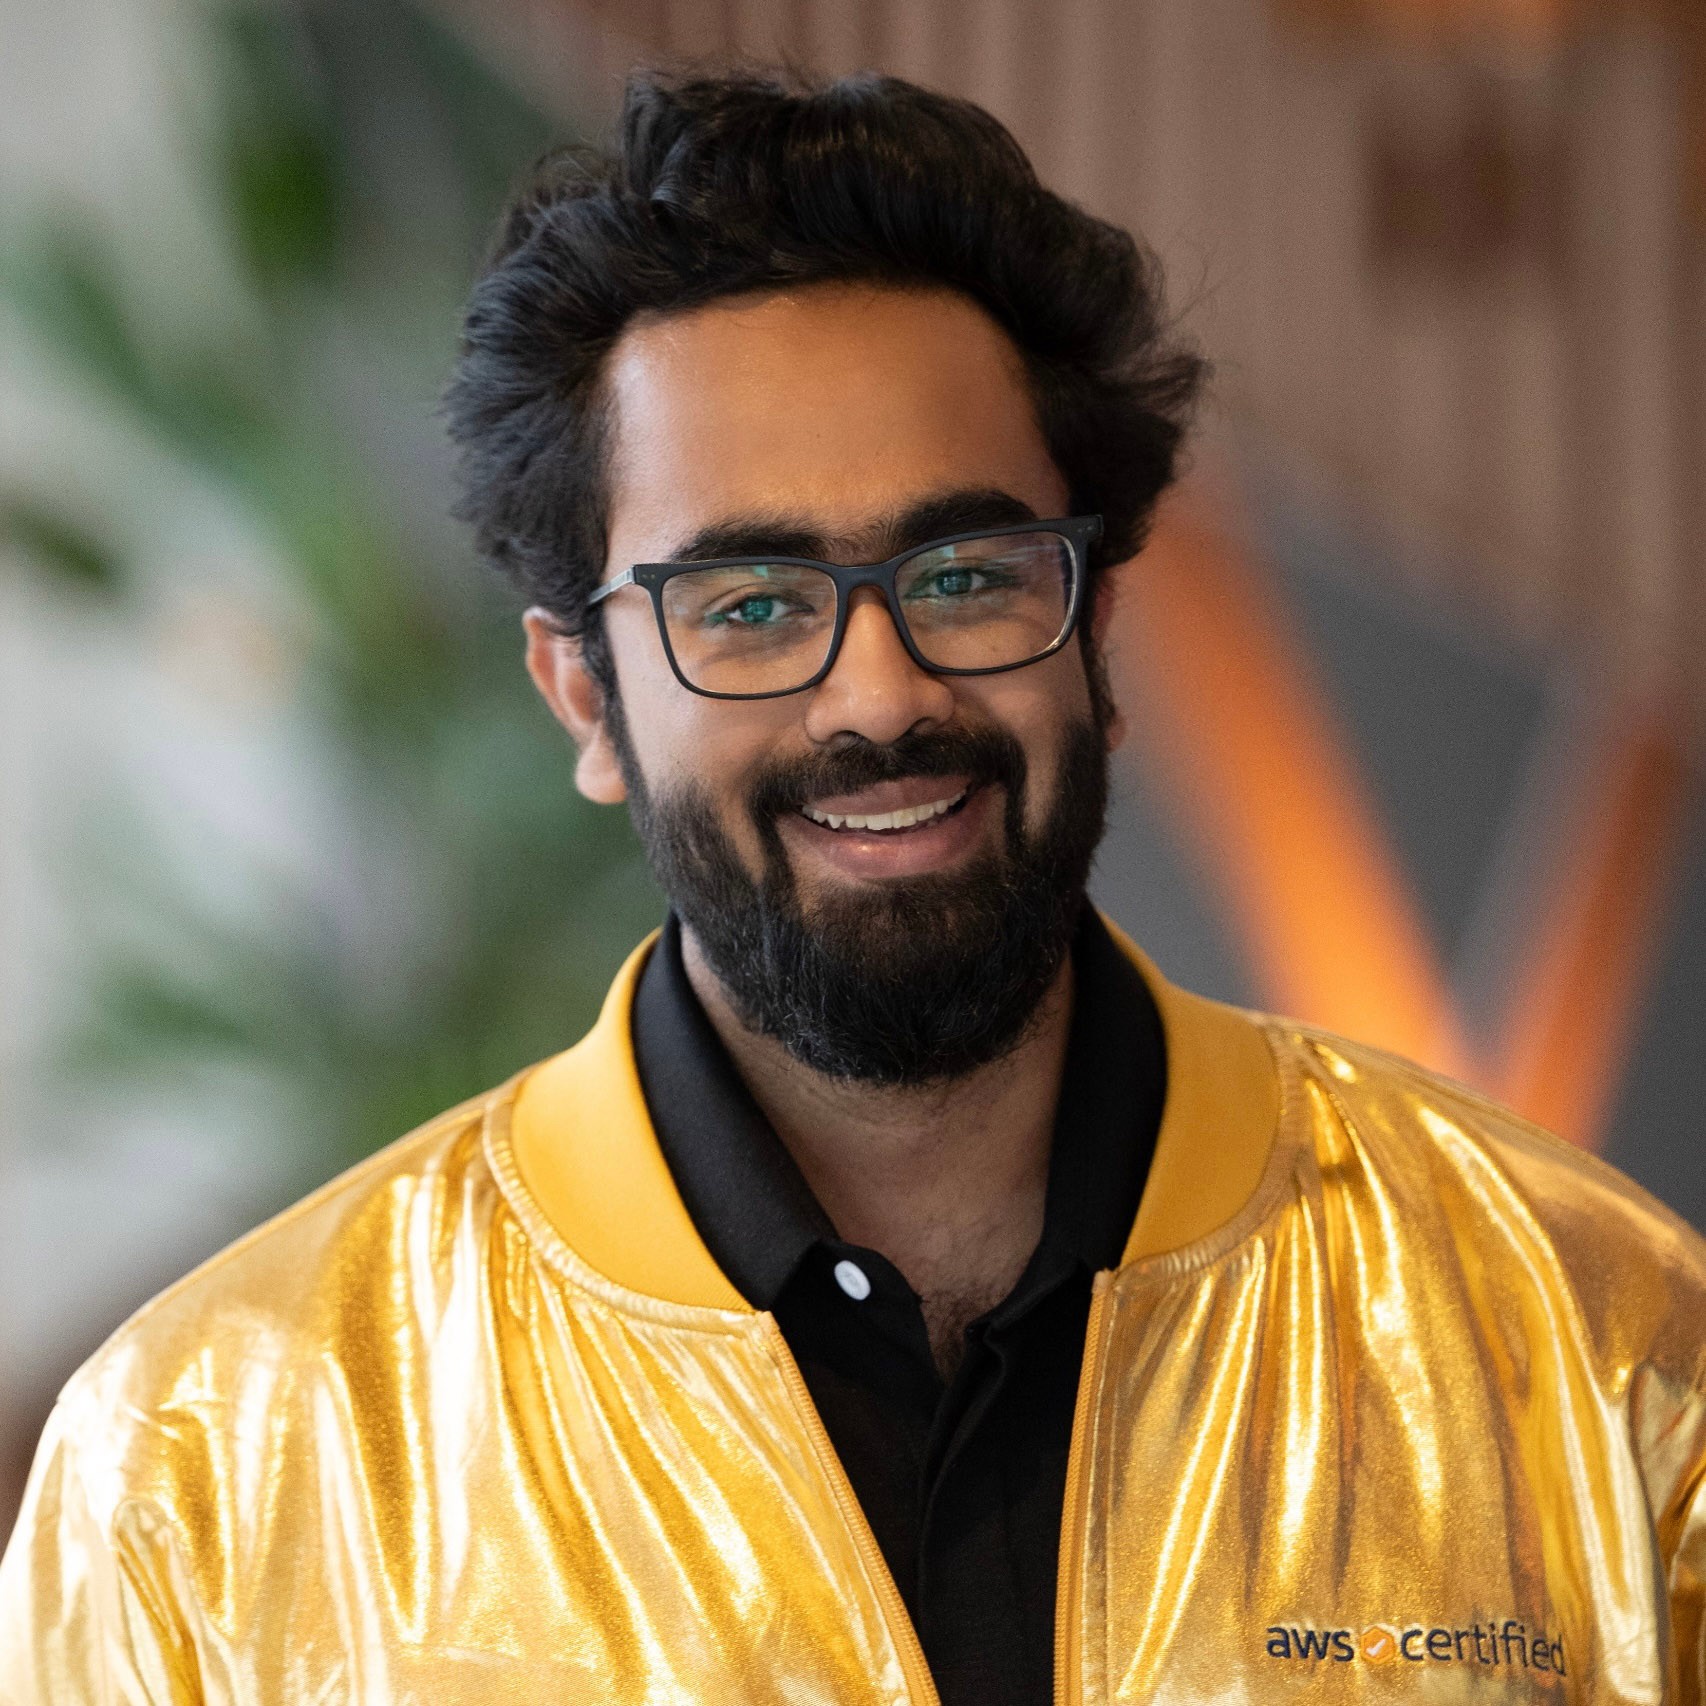 Harshvardhan Chunawala は、アマゾンウェブサービスのソリューションアーキテクトであり、AWS アカデミー認定教育者であり、AWS ゴールデンジャケットホルダーでもあります。彼は世界中のスタートアップの創設者や経営幹部と提携して、業界を問わず AWS 上でスケーラブルで安全なクラウドインフラストラクチャを構築しています。AWS では、航空宇宙、AI/ML、セキュリティ、教育、ISV の TFC メンバーを務めています。Amazon Leo、Amazon Security、AWS Agentic AI など複数の Amazon チームと協力して、衛星、セキュリティ、信頼できるエージェント AI サービス全体でフロンティアクラウド機能を構築し、提供しています。世界的に認められたテクノロジストであり、クラウドセキュリティの専門家でもあるハーシュヴァルダンは、カーネギーメロン大学(CMU)の客員教員兼研究員であり、次世代のクラウド専門家や起業家を指導しています。Harshvardhanは、アポロ17号以来のアメリカ初の月面ミッションで、CMUで宇宙ミッションエンジニアリングのリーダー兼ミッションオペレーターを務めました。仕事以外では、ハーシュヴァルダンはスカイダイビングや飛行機の飛行を通して空への愛情を追求しています。
チャクラヴァーシー・ナガラジャン
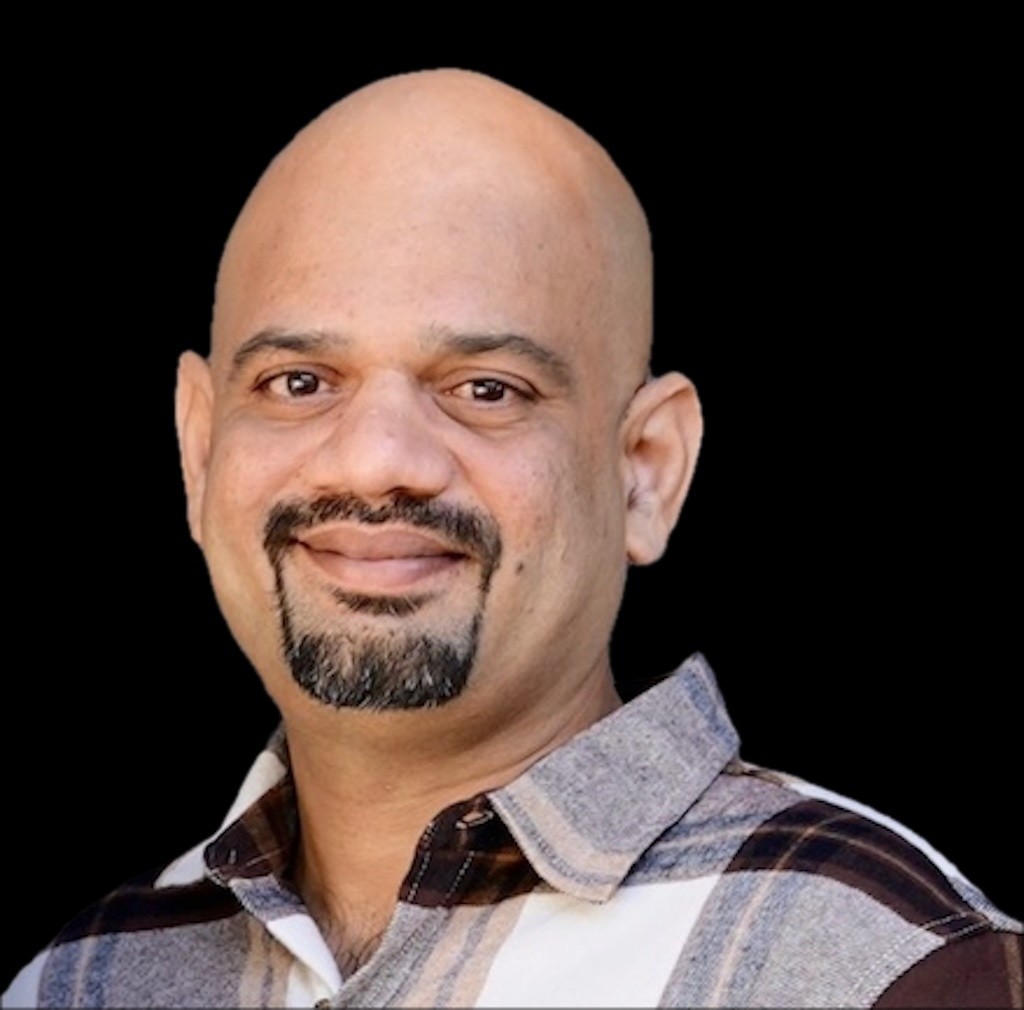 チャクラヴァーシー・ナガラジャンは、機械学習を専門とするプリンシパル・ソリューションズ・アーキテクトです。現在の役職では、機械学習とジェネレーティブAIソリューションを使用して、顧客が現実世界の複雑なビジネス問題を解決できるよう支援しています。彼はモデルのカスタマイズに注力し、企業がカスタマイズの力でLLMの真の可能性を実現できるよう支援しています。
ハディージャ・マフムード
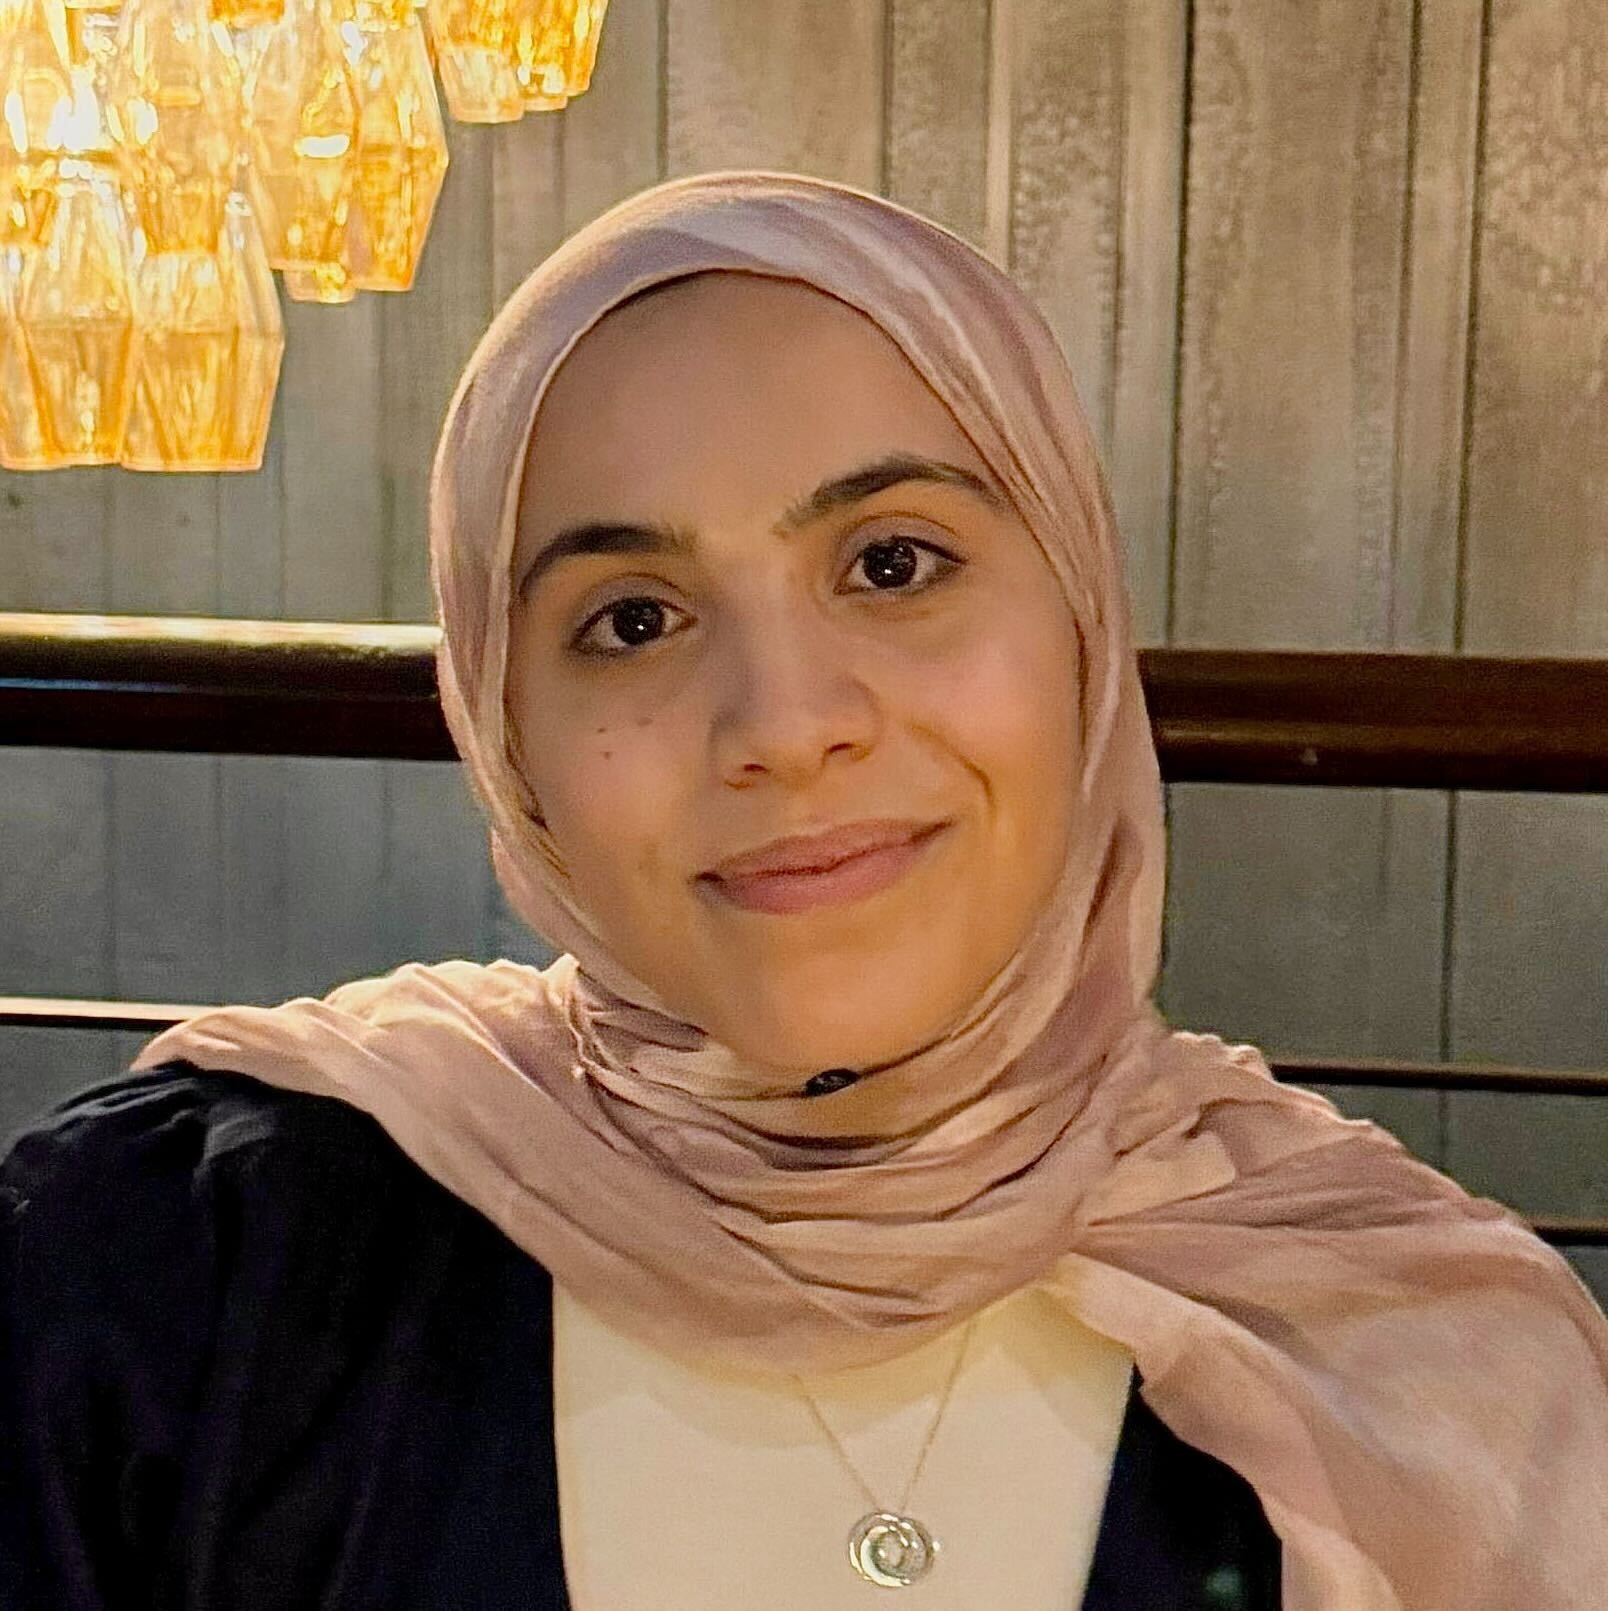 医学博士のKhadija Mahmoudは、Anteriorの応用AIの臨床医科学者であり、実際の医療システム全体で臨床データセット、ベンチマーキング、モデル評価に取り組んでいます。彼女の研究は、臨床的推論、AIにおける偏見と公平性、ヘルスケアにおける機械学習の安全な導入に焦点を当てており、その研究は査読付きジャーナルに掲載されています。彼女はヘルスケアの人工知能の修士号とインペリアル・カレッジ・ロンドンの医学博士号を取得しています。
アヌジ・イラバネ
 Anuj IravaneはAnteriorでAIを率い、研究と生産の交差点で働いており、信頼性が高く、ポリシーに準拠した、臨床的推論のための自己改善型の薬剤の開発に取り組んでいます。Anteriorに入社する前は、Amazonでレコメンダーシステムの開発に携わっていました。ノースウェスタン大学でコンピューターサイエンスの学士号を取得しています。AI以外にも、インドのインディペンデント映画エコシステムのプロデューサー兼ディレクターでもあります。
今日お探しの情報は見つかりましたか?
ページコンテンツの品質向上のため、皆さまのご意見をお寄せください