什么是人工智能中的缩放定律?
什么是 AI 中的缩放定律?
人工智能(AI)中的缩放定律是指描述 AI 系统在架构规模发生变化时,其性能与资源需求如何受到影响的一系列规则。在统计学中,“幂律”是指两个数据点之间的一种函数关系,其中一个数据点的变化会导致另一个数据点发生相对且成比例的变化——即一个量随另一个量的变化而呈现出数学幂函数关系。AI 中的缩放定律旨在识别并确立 AI 环境下的这类可预测关系。它们将模型参数、训练数据、计算资源等AI相关要素纳入考量,并建立起这些要素之间的数学关系。神经缩放定律是缩放定律在人工智能领域应用时的另一种称谓。
为什么缩放定律在 AI 研究中很重要?
神经缩放定律是一个新兴的研究领域,AI 公司在对其深度学习系统应用严谨的实证方法后,发布相关论文并揭示其中的规律。缩放定律为 AI 的研发工作带来了可预测性。数据科学家可以预先计算项目成本,并在一定程度上估算性能表现。他们还可以进行测试,以验证计划中的投入能否带来预期的回报。我们将在下文介绍其优势。
降低 AI 研究风险
训练参数量达数百万甚至数十亿的大型模型成本高昂,耗资可达数百万美元。缩放定律有助于研究人员更准确地估算训练数据量、模型规模、所需计算资源、项目周期及潜在成本。他们可以预先判断相关投入能否带来所需的收益。
选择最佳模型
许多组织倾向于使用现有的基础模型,而不是从头开始训练新模型。鉴于市面上的模型种类繁多,缩放定律有助于针对特定任务做出最佳选择。例如,较小模型的部署选项更多、成本更低且数据处理速度更快,但准确度可能相对较低。缩放定律的数学基础有助于 AI 团队做出更明智的决策。
优化模型训练
团队可以利用缩放定律中的数学方程,为大型语言模型制定最优的训练配置方案。例如,在某些场景下,即使是大规模模型,也可能仅需相对较小的数据集即可达到最佳性能。存在一个特定的阈值,一旦超过该阈值,继续投入训练所带来的收益便不足以抵消其成本。缩放定律有助于识别此类阈值,并最大化训练过程的效率。
缩放定律涉及哪些主要参数?
神经缩放定律揭示了一组神经网络的参数之间的关系。通常,可以用四个参数来表征神经网络模型(或算法):
- 模型规模
- 训练数据集规模
- 训练后的性能
- 训练成本
这四个变量中的每一个都可以精确地定义为一个实数。神经缩放定律通过经验证实,这四个参数之间存在统计学规律,并可用数学方程来描述。要理解神经缩放定律,首先必须理解这四个关键参数。
模型规模
模型规模是指模型包含的参数数量。参数代表了模型在训练过程中建立的神经连接。在生成式人工智能和基础模型(FM)的语境下,参数是指模型内部可训练的权重和偏置。它们体现了模型执行自然语言处理任务的能力。例如,参数可以衡量大语言模型生成人类语言的能力,或者衡量生成式图像模型根据文本提示创建精确图像的能力。
训练数据集规模
训练数据集规模通过用于训练模型的数据点数量来量化。初始数据集或预训练数据集固然重要,但大多数现代组织正转向调整基础模型,以利用内部数据开发定制化应用。这种定制或微调数据集的规模更为关键,因为它关系到组织能否理解并准备好其 AI 应用所需的数据。研究发现,少量的优质数据足以进行微调,而增加数据量并不能提升性能。
训练后的性能
评估神经语言模型性能的依据是其针对给定的未知输入,准确预测或生成输出的能力。常见的模型性能指标包括准确率、精确率、与其他模型竞赛时的 Elo 评级,以及人类评估者的偏好度。通过增加训练数据规模、扩大模型规模以及采用其他算法优化方法,可以提升模型性能。
训练成本
训练成本的衡量标准是模型训练所需的时间和计算资源。它受到模型规模、训练数据规模、模型复杂度、训练数据复杂度等多种因素的影响。然而,训练数据集与训练成本之间的关系并非线性。例如,鉴于人工智能模型的训练方式,将训练数据量增加一倍并不一定意味着训练成本也会翻倍。
缩放定律确立了哪些指导原则?
实证结果和已发表的 AI 研究为指导 AI 发展及实现通用人工智能提供了参考依据。我们在下文列出了一些调查发现。然而,该领域发展迅速,情况随时可能发生变化。
性能和模型规模
随着语言模型参数数量的增加,其在各类任务上的性能通常会随之提升。这包括对上下文理解能力增强、文本生成准确性提高,以及从较少样本中学习的能力提升。不过,也存在“收益递减”的现象。这意味着,向模型新增的每一个参数对模型整体性能提升的贡献都会比前一个参数更小。
例如,2020 年初,研究机构侧重于模型规模,构建了参数量约为 1750 亿的 GPT-3 和 BLOOM 等语言模型,而 MT-NLG 的训练参数量更是高达 5300 亿。然而,2022年的观察结果表明,当时模型参数量与训练数据集规模之间的计算资源分配并不理想。较新的经验性缩放定律表明,使用更多数据训练的较小模型,其性能有可能超越大型模型。例如,参数量为 700 亿的 Chinchilla 模型,其性能就被证实优于许多规模更大的模型。
训练数据和模型规模
要有效训练大型模型,需要海量的数据。此外,它们还需要呈指数级增长的计算资源,导致成本和能耗不断攀升。训练超大规模模型也给优化过程带来了新的挑战。要在避免过拟合或训练不稳定等问题的前提下找到高效训练这些模型所需的最佳设置与技术变得愈发困难。尽管如此,值得注意的是,大型模型具有更高的样本效率,只需较短的训练时间即可达到更高的性能。
性能和模型架构
模型架构是指模型的具体设计与结构——例如神经网络中神经元的选择、组织与连接方式(如层数、层间连接),以及模型的其他结构性特征。深度学习缩放定律的研究发现,模型架构对模型性能的影响相对较小。模型性能在很大程度上取决于模型参数量、训练数据集规模以及训练所消耗的计算资源总量。
唯一的例外情况是架构本身成为瓶颈的场景。不过,在合理范围内,性能受其他架构超参数(如模型层数、每层神经元数量等)的影响极小。
选择合适的模型
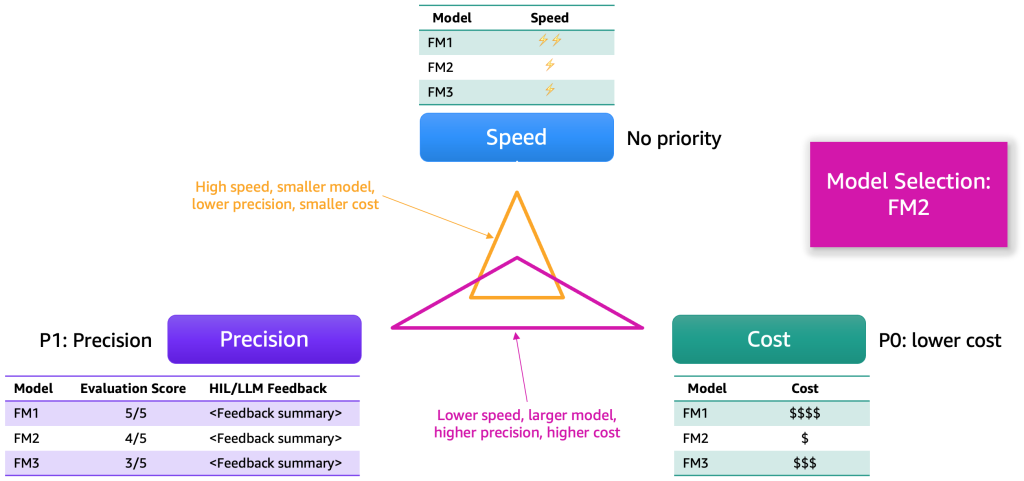
在针对特定应用场景微调基础模型时,务必注意这些模型会占用物理存储空间。例如,较小的模型可以在单个 GPU 上运行,而较大的模型则可能需要在两个或更多 GPU 上运行。随着加速器和 GPU 数量的增加,模型精度会提高,但推理(或运行)时间和运营成本也会随之增加。相比之下,较小的模型提供了更多的部署选择,成本更低,且推理速度更快。不过,它们的输出准确度可能会降低。AI 团队需要根据业务需求,在准确度与成本/时间之间做出权衡。
建立缩放定律面临哪些挑战?
尽管缩放定律提供了一些指导原则,但也存在一些矛盾之处。
线性缩放定律
缩放定律似乎在模型规模、数据规模和计算预算方面呈现出数学上的线性关系。这显得有些矛盾,因为语言(这些模型的核心应用领域)本身就具有一定程度的不可预测性或复杂性。随着模型规模的扩大,人们预期它们会逐渐逼近一个极限:能够捕捉到语言的大部分复杂性,但无法完全穷尽。然而,如果缩放定律呈线性关系,模型就会持续改进,而不会逼近语言理解的理论极限。考虑到语言固有的复杂性和不可预测性,这种现象似乎有悖常理。
过拟合
过拟合是指模型对训练数据的学习“过头”,连同噪声和异常值一并学习,从而损害了其对新数据的泛化能力。例如,一个仅在猫的图片上训练的模型将无法识别狗。缩放定律的研究表明,即使模型仅对训练数据进行了一次完整遍历(即不重复使用数据),仍可能发生过拟合。这一发现有些出人意料,因为在较小规模下,过拟合通常更容易伴随着大量的训练和数据重复使用而发生。
计算效率不一致
缩放定律在训练所需计算量与模型性能之间的关系上表现出不一致。缩放方程中的某些数学指数存在显著差异,这表明利用计算资源提升模型性能的效率并不恒定,且会随条件或约束的变化而发生剧烈波动。这与“计算效率遵循稳定且可预测的缩放定律”这一观点相矛盾。
AWS 如何帮助您开展 AI 工作?
AWS 提供全面的人工智能(AI)服务、基础设施和实施资源,可在您采用 AI 的每个阶段为您提供帮助。借助 AWS 上的 AI,改善客户体验、实现更快更好的决策并优化业务流程。例如,您可以使用:
- Amazon Bedrock,通过专有数据选择、自定义、训练和部署业界领先的基础模型。
- Amazon CodeWhisperer,根据您的注释和现有代码,在 IDE 中实时生成代码建议——从代码片段到完整函数,一应俱全。
- Amazon Q,以快速获取针对紧迫问题的相关解答,解决难题并生成内容。您还可以利用公司信息存储库、代码和企业系统中的数据与专业知识来采取行动。
- Amazon SageMaker JumpStart,通过在机器学习中心构建、训练和部署基础模型加速 AI 开发。
立即创建免费账户,开始在 AWS 上使用 AI。
Browse all cloud computing concepts
Browse all cloud computing concepts content here:
Did you find what you were looking for today?
Let us know so we can improve the quality of the content on our pages