O blog da AWS
Memória para agentes de IA: escolhendo onde persistir, quem persiste e como recuperar
Por Neuton Assis, Enterprise Solutions Architect, AWS AGS.
Construir agentes que lembram de seus usuários pode parecer, na superfície, um problema simples: basta guardar a conversa e devolvê-la no próximo turno. Na prática, qualquer um que tenha colocado um agente em produção sabe que essa abordagem simples falha rápido, o contexto cresce sem controle, dados críticos se perdem entre sessões e a recuperação de informação se torna imprecisa. O Amazon Bedrock AgentCore Memory resolve boa parte do trabalho pesado de armazenamento, extração e consolidação, mas ele não elimina as decisões de design que continuam sob responsabilidade de quem constrói o agente. Este post trata exatamente dessas decisões, organizando-as em torno de três perguntas que costumam ser confundidas em uma só: onde persistir cada tipo de dado, quem deve ser responsável por persistir, e como recuperar a informação certa no momento certo. Essa postagem se apoia no AgentCore Memory integrado ao framework Strands Agents: as três perguntas são respondidas primariamente com ele. Para um caso específico, dados cujo valor está nas relações entre entidades, veremos como complementar o AgentCore Memory com um grafo de conhecimento no Amazon Neptune.
Por que memória de agente é um problema de engenharia de contexto
Vale separar dois conceitos que o AgentCore Memory oferece. A memória de curto prazo guarda o histórico bruto da conversa, cada mensagem, cada chamada de ferramenta, organizados por ator e sessão. A memória de longo prazo guarda insights estruturados, extraídos da conversa por modelos de linguagem de forma assíncrona, segundo estratégias configuráveis: até a publicação desta postagem estavam disponíveis as estratégias nativa semântica, preferências, resumo e episódica, além da possibilidade de criar estratégias customizadas (nativo com possibilidade de customização ou autogerenciado).
Na integração com o Strands Agents, essas capacidades chegam por dois caminhos. O AgentCore Memory Session Manager se acopla ao ciclo de vida do agente: ele permite persistir cada turno na memória de curto prazo automaticamente e, no início de cada turno, fazer uma busca semântica nas memórias de longo prazo e incorporar o resultado no contexto. A alternativa é tratar a memória como ferramenta, o agente decide, por conta própria, quando consultar ou gravar.
A questão é que nenhum desses caminhos é universalmente correto. A escolha depende da natureza do dado e das consequências de perdê-lo. É isso que faz da memória um problema de engenharia de contexto, e não de configuração.
Onde persistir: nem todo dado pertence ao mesmo lugar
A primeira decisão é classificar o dado pela força das relações que ele carrega.
Dados usados apenas como contexto, sem exigência de relação direta, tendem a pertencer ao AgentCore Memory. Quando a informação enriquece a conversa mas não precisa ser navegada como um grafo, a Custom Strategy do AgentCore Memory é a mais recomendada. Aqui, namespaces servem para separar grandes grupos temáticos quando necessário, e a fragmentação eventual é tolerável, porque o uso é contextual.
Dados com correlação forte e direta tendem a pertencer a um grafo. Para ilustrar, imagine um agente de detecção de fraude em que se acumulam entidades como conta, transação, comerciante e padrão de fraude. O valor está justamente nas relações: uma transação é suspeita porque a conta tem certo perfil de risco e o comerciante está associado a um padrão conhecido. Registros planos de memória, espalhados por namespaces, dificilmente reconstroem essa cadeia de forma confiável, a informação fica fragmentada. Para esses casos, um banco de grafos como o Amazon Neptune é o armazenamento adequado, e o AgentCore Memory passa a funcionar como camada conversacional, não como fonte de verdade do domínio.
Para continuidade conversacional, o que importa é o histórico recente. Em canais como o WhatsApp, em que a relação com a pessoa é uma única conversa contínua, independentemente do intervalo entre as interações ou de quantas já aconteceram, o essencial é que o agente não responda como se fosse a primeira vez. Resgatar as últimas interações (por exemplo, os dois últimos turnos ou as quatro últimas mensagens) ao processar a primeira mensagem de cada nova sessão restabelece essa continuidade de forma eficaz e com contexto reduzido.
Quem persiste: por que a sessão é mais confiável que o agente
Há uma intuição natural de delegar a gravação ao próprio agente. Afinal, ele entende o domínio pelo system prompt e parece o candidato ideal para decidir o que vale a pena lembrar. Uma estratégia genérica de extração talvez não reconheça que o prompt de usuário “paciente relata dor torácica com início há 72 horas” é um dado clínico crítico, mas o agente, devidamente instruído, reconheceria.
O problema está no horizonte de visão de cada abordagem. Quando o agente grava por meio de uma ferramenta, ele decide com base apenas no histórico disponível naquele instante. Ele aciona essa gravação algumas vezes ao longo da conversa, sempre sobre um recorte parcial. Se o usuário interromper a conversa, se a sessão expirar antes da próxima decisão de gravar, ou se o dado crítico aparecer depois da última gravação, a informação se perde. Em saúde, jurídico ou finanças, esse tipo de perda pode ser considerado inaceitável.
A sessão, por outro lado, tem visão sobre a conversa inteira. O Session Manager persiste cada turno e dispara a extração assíncrona considerando todo o material acumulado, não recortes. A consolidação do AgentCore Memory recupera as memórias semanticamente próximas no mesmo namespace, envia ao modelo com um prompt de consolidação e decide entre adicionar, atualizar ou ignorar, usando a data de atualização mais recente como um dos sinais para resolver conflitos. Esse olhar consolidado sobre a sessão completa é precisamente o que falta à gravação acionada pelo agente.
Por isso, para garantir que dados relevantes sejam efetivamente persistidos, a sessão é o mecanismo mais confiável, desde que a estratégia de extração saiba o que procurar.
Quem persiste: por que a sessão é mais confiável que o agente
Há uma intuição natural de delegar a gravação ao próprio agente. Afinal, ele entende o domínio pelo system prompt e parece o candidato ideal para decidir o que vale a pena lembrar. Uma estratégia genérica de extração talvez não reconheça que o prompt de usuário “transação de R$ 12.000 no cartão corporativo às 3h da manhã em comerciante novo” é um dado crítico de risco, mas o agente, devidamente instruído, reconheceria.
O problema está no horizonte de visão de cada abordagem. Quando o agente grava por meio de uma ferramenta, ele decide com base apenas no histórico disponível naquele instante. Ele aciona essa gravação algumas vezes ao longo da conversa, sempre sobre um recorte parcial. Se o usuário interromper a conversa, se a sessão expirar antes da próxima decisão de gravar, ou se o dado crítico aparecer depois da última gravação, a informação se perde. Em finanças, jurídico ou compliance, esse tipo de perda pode ser considerado inaceitável.
A sessão, por outro lado, tem visão sobre a conversa inteira. O Session Manager persiste cada turno e dispara a extração assíncrona considerando todo o material acumulado, não recortes. A consolidação do AgentCore Memory recupera as memórias semanticamente próximas no mesmo namespace, envia ao modelo com um prompt de consolidação e decide entre adicionar, atualizar ou ignorar, usando a data de atualização mais recente como um dos sinais para resolver conflitos. Esse olhar consolidado sobre a sessão completa é precisamente o que falta à gravação acionada pelo agente.
Por isso, para aumentar a confiabilidade que dados relevantes sejam efetivamente persistidos, a sessão é o mecanismo mais confiável, desde que a estratégia de extração saiba o que procurar.
Tornando a extração consciente do domínio
A peça que conecta uma sessão confiável à captura efetiva de dados críticos é a Custom Strategy do AgentCore Memory. As estratégias internas, como semântica, preferências, resumo e episódica, cobrem casos comuns, mas o AgentCore Memory permite sobrescrever o prompt de extração para focar no que importa em cada domínio.
O exemplo a seguir configura uma estratégia que trata dados de transações como entidades de risco, e não como texto genérico:
from bedrock_agentcore.memory import MemoryClient
from bedrock_agentcore.memory.integrations.strands.config import AgentCoreMemoryConfig
from bedrock_agentcore.memory.integrations.strands.session_manager import AgentCoreMemorySessionManager

memory_client = MemoryClient(region_name="us-east-1")

FRAUD_EXTRACTION_PROMPT = """
Você extrai dados de risco de fraude de uma conversa de análise transacional.
Registre, quando presentes, como itens estruturados:
valor, horário, localização, comerciante, frequência,
padrões de uso e histórico de alertas anteriores.
Trate qualquer dado transacional anômalo como relevante para retenção,
mesmo que não seja uma preferência nem um fato genérico.
"""

memory = memory_client.create_memory_and_wait(
    name="deteccao_fraude",
    strategies=[{
        "customMemoryStrategy": {
            "name": "analise_transacional",
            "namespaces": ["/conta/{actorId}/transacoes/"],
            "configuration": {
                "extraction": {
                    "appendToPrompt": FRAUD_EXTRACTION_PROMPT,
                    "modelId": "global.anthropic.claude-haiku-4-5-20251001-v1:0"
                }
            }
        }
    }]
)

config = AgentCoreMemoryConfig(
    memory_id=memory.get("id"),
    session_id="sessao-001",
    actor_id="conta-7891"
)
session_manager = AgentCoreMemorySessionManager(config, region_name="us-east-1")
Como recuperar memória: do prompt determinístico ao agêntico
Aqui aparece a limitação mais sutil da abordagem automática. A recuperação embutida no Session Manager dispara uma busca semântica baseada na mensagem atual do usuário. É o equivalente a um Retrieval Augmented Generation (RAG)[CI2] literal: embedding da pergunta, busca por similaridade, injeção no contexto. Funciona quando a mensagem é autossuficiente, mas falha quando o sentido depende do que foi dito antes.
Se o usuário pergunta “e sobre aquilo que conversamos?”, a busca por essa frase genérica não recupera nada útil. Se a conversa evoluiu por vários turnos e a intenção real está distribuída no histórico, a busca pela última mensagem não a captura.
A solução é o RAG de memória agêntico: dar ao agente uma ferramenta de busca e instruí-lo a formular a consulta considerando o histórico acumulado da sessão, e não apenas o último turno. O agente passa a raciocinar sobre o que buscar, reformulando a consulta e consultando mais de um namespace quando o tema exige.
from strands import Agent, tool
from strands.models import BedrockModel

@tool
def buscar_memoria(consulta: str, namespace: str) -> str:
    """
    Recupera memórias relevantes. Formule a 'consulta' considerando
    o histórico da conversa atual, não apenas a última mensagem do usuário.
    """
    resultados = memory_client.retrieve_memories(
        memory_id=memory.get("id"),
        namespace=namespace,
        query=consulta
    )
    return "\n".join(
        r["content"]["text"]
        for r in resultados.get("memoryRecordSummaries", [])
    )

agent = Agent(
    model=BedrockModel(model_id="global.anthropic.claude-haiku-4-5-20251001-v1:0"),
    system_prompt="""
    Você é um agente de análise de fraude.
    Quando a mensagem do usuário exigir contexto histórico, use buscar_memoria,
    formulando a consulta a partir de TODO o histórico da sessão.
    Para temas de risco transacional, consulte os namespaces de transações, preferências
    e dados de domínio, somando os resultados.
    """,
    tools=[buscar_memoria],
    session_manager=session_manager  # persiste turnos na STM; retrieval automático complementa a busca agêntica
)
Um ponto importante: as estratégias não competem entre si na recuperação, elas se somam. Cada uma delas extrai e disponibiliza aspectos de interesse específico sobre conversas anteriores. Por exemplo, a memória semântica traz situações em que conversas similares ocorreram; a memória de preferências traz o que o usuário gosta. Quando as estratégias necessárias coexistem, a recuperação ideal as combina no momento da consulta, em vez de depender de uma só.
Amazon Neptune como memória de domínio com grafos
A seção sobre onde persistir mencionou que dados com correlação forte tendem a pertencer a um grafo. Vale aprofundar essa ideia com exemplos concretos, pois na prática é aqui que muitos construtores de agentes enfrentam dúvidas: quando exatamente o AgentCore Memory não é o bastante sozinho e por que um banco de grafos se torna complementar?
O sinal mais claro é quando a resposta correta depende de percorrer relações entre entidades, não apenas de recuperar trechos de texto por similaridade semântica. Considere um agente financeiro que precisa verificar se um fundo de investimento é elegível para um cliente: a elegibilidade depende do perfil de risco do cliente, do segmento do fundo, da jurisdição regulatória e de eventuais restrições contratuais. Cada uma dessas dimensões é um nó conectado por arestas tipadas. Uma busca vetorial no AgentCore Memory pode recuperar o fato “cliente tem perfil conservador”, mas não navega a cadeia completa até a conclusão “fundo X é inelegível porque exige perfil arrojado e jurisdição internacional”. O grafo faz essa travessia em uma única consulta.
Uma alternativa recomendada para esse cenário que discutimos anteriormente é usar o Amazon Neptune como fonte de verdade do domínio e o AgentCore Memory como camada conversacional. O agente consulta o grafo via ferramenta quando precisa de respostas que envolvem relações, e o AgentCore Memory continua cuidando de tudo que é contexto de sessão, como preferências, resumos e fatos simples.
Implementação com Strands Agents e Neptune
O exemplo a seguir mostra como criar uma ferramenta customizada no Strands Agents que consulta um grafo no Amazon Neptune usando openCypher, uma linguagem declarativa de consulta para grafos de propriedade, executada via SDK Python da AWS (Boto3). A ferramenta recebe uma consulta openCypher e a executa no Neptune, retornando o resultado ao agente:
import boto3
import json
from botocore.config import Config
from strands import Agent, tool

# --- Configuração do Amazon Neptune Database ---
NEPTUNE_ENDPOINT = "https://<seu-cluster>.neptune.amazonaws.com:8182"

neptune_client = boto3.client(
    "neptunedata",
    endpoint_url=NEPTUNE_ENDPOINT,
    config=Config(read_timeout=None, retries={"total_max_attempts": 1})
)

@tool
def verificar_risco_fraude(transacao_id: str, conta_id: str) -> str:
    """Verifica se uma transação apresenta risco de fraude para uma conta,
    considerando todos os padrões registrados no grafo.

    Args:
        transacao_id: Identificador da transação a verificar.
        conta_id: Identificador da conta no grafo.

    Returns:
        Resultado da verificação com justificativa baseada no grafo.
    """
    query = f"""
    MATCH (c:Conta {{id: '{conta_id}'}})-[:REALIZOU]->(t:Transacao {{id: '{transacao_id}'}})
          -[:REALIZADA_EM]->(com:Comerciante)-[:ASSOCIADO_A]->(pf:PadraoFraude)
    RETURN c.titular AS titular, t.valor AS valor,
           com.nome AS comerciante,
           pf.descricao AS padrao_fraude, pf.severidade AS severidade
    """
    response = neptune_client.execute_open_cypher_query(
        openCypherQuery=query
    )
    resultados = response["results"]
    if resultados:
        return json.dumps({"fraude_detectada": True, "detalhes": resultados},
                          indent=2, ensure_ascii=False)
    return json.dumps({"fraude_detectada": False,
                       "mensagem": f"Transação {transacao_id} sem padrões de fraude associados."},
                      ensure_ascii=False)

from bedrock_agentcore.memory.integrations.strands.config import AgentCoreMemoryConfig
from bedrock_agentcore.memory.integrations.strands.session_manager import AgentCoreMemorySessionManager

config = AgentCoreMemoryConfig(
    memory_id="<seu-memory-id>",
    session_id="sessao-fraude-001",
    actor_id="analista-456"
)
session_manager = AgentCoreMemorySessionManager(config, region_name="us-east-1")

agente_fraude = Agent(
    model="us.anthropic.claude-sonnet-4-20250514-v1:0",
    system_prompt="""Você é um analista de fraude. Use verificar_risco_fraude para checar padrões de fraude antes de qualquer aprovação de transação.
O AgentCore Memory armazena o contexto conversacional; o grafo Neptune é a fonte de verdade para dados de domínio.""",
    tools=[verificar_risco_fraude],
    session_manager=session_manager  # persiste turnos; retrieval automático complementa
)

agente_fraude("A transação TXN-2024-11583 da conta CTA-2024-0891 é legítima?")
A ferramenta verificar_risco_fraude ilustra o ponto central: ela percorre a cadeia conta → transação → comerciante → padrão de fraude em uma única consulta Cypher, algo que seria impraticável com busca semântica no AgentCore Memory.
Modelagem do grafo para memória de domínio
O modelo de dados segue um padrão simples, mas expressivo para o domínio de fraude. Entidades como Conta, Transação, Comerciante e PadraoFraude são nós, enquanto REALIZOU, REALIZADA_EM, ASSOCIADO_A e OPERA_EM são arestas tipadas que carregam metadados:
# --- Populando o grafo (setup inicial via openCypher) ---
setup_queries = [
    """CREATE (c:Conta {id: 'CTA-2024-0891', titular: 'Carlos Mendes', segmento: 'PJ'})""",

    """MATCH (c:Conta {id: 'CTA-2024-0891'})
    CREATE (t:Transacao {id: 'TXN-2024-11583', valor: 12000, horario: '03:17', data: '2024-11-15'})
    CREATE (c)-[:REALIZOU {canal: 'online'}]->(t)""",

    """MATCH (t:Transacao {id: 'TXN-2024-11583'})
    CREATE (com:Comerciante {nome: 'AnyCompany XYZ', categoria: 'exchange_cripto', pais: 'MT'})
    CREATE (t)-[:REALIZADA_EM]->(com)
    CREATE (pf:PadraoFraude {descricao: 'Transferência de alto valor em horário atípico para exchange de criptomoedas',
        severidade: 'alta',
        fonte: 'Modelo de detecção v3.2'
    })
    CREATE (com)-[:ASSOCIADO_A]->(pf)""",
    """MATCH (c:Conta {id: 'CTA-2024-0891'})
    CREATE (com2:Comerciante {nome: 'AnyCompany, categoria: 'varejo', pais: 'BR'})
    CREATE (com2)-[:OPERA_EM {frequencia: 'regular'}]->(c)"""
]

for query in setup_queries:
    neptune_client.execute_open_cypher_query(openCypherQuery=query)
Imagem ilustrativa da modelagem:
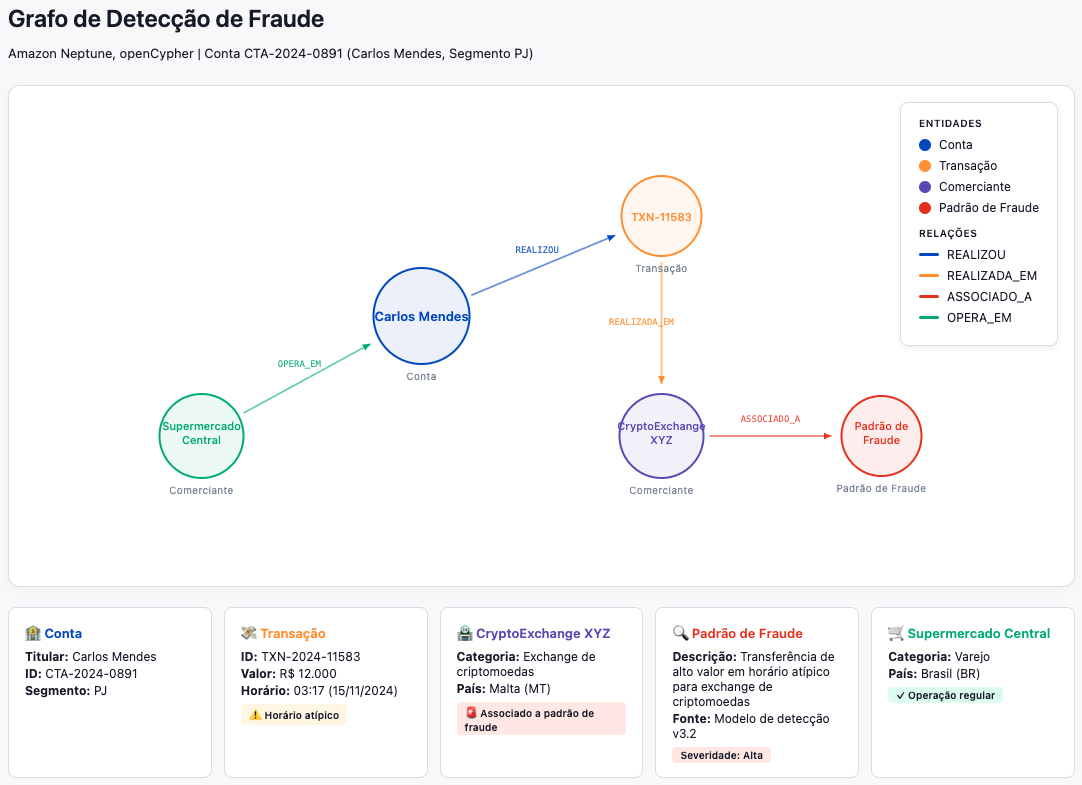
Exemplo de grafo para detecção de fraude
A força do grafo está em permitir consultas transitivas: “quais transações desta conta estão associadas a comerciantes com padrões de fraude conhecidos?” se resolve em uma travessia, enquanto no AgentCore Memory exigiria múltiplas buscas semânticas com risco de perda de contexto entre elas.
Recomendações práticas
Para orientar a decisão, a heurística é direta: se a resposta exige percorrer relações tipadas entre entidades de domínio, use Neptune. Se a resposta depende de contexto conversacional, preferências ou fatos simples do usuário, use AgentCore Memory. E para agentes que precisam de ambos, como o exemplo de fraude acima, combine as duas camadas, cada uma fazendo o que faz melhor.
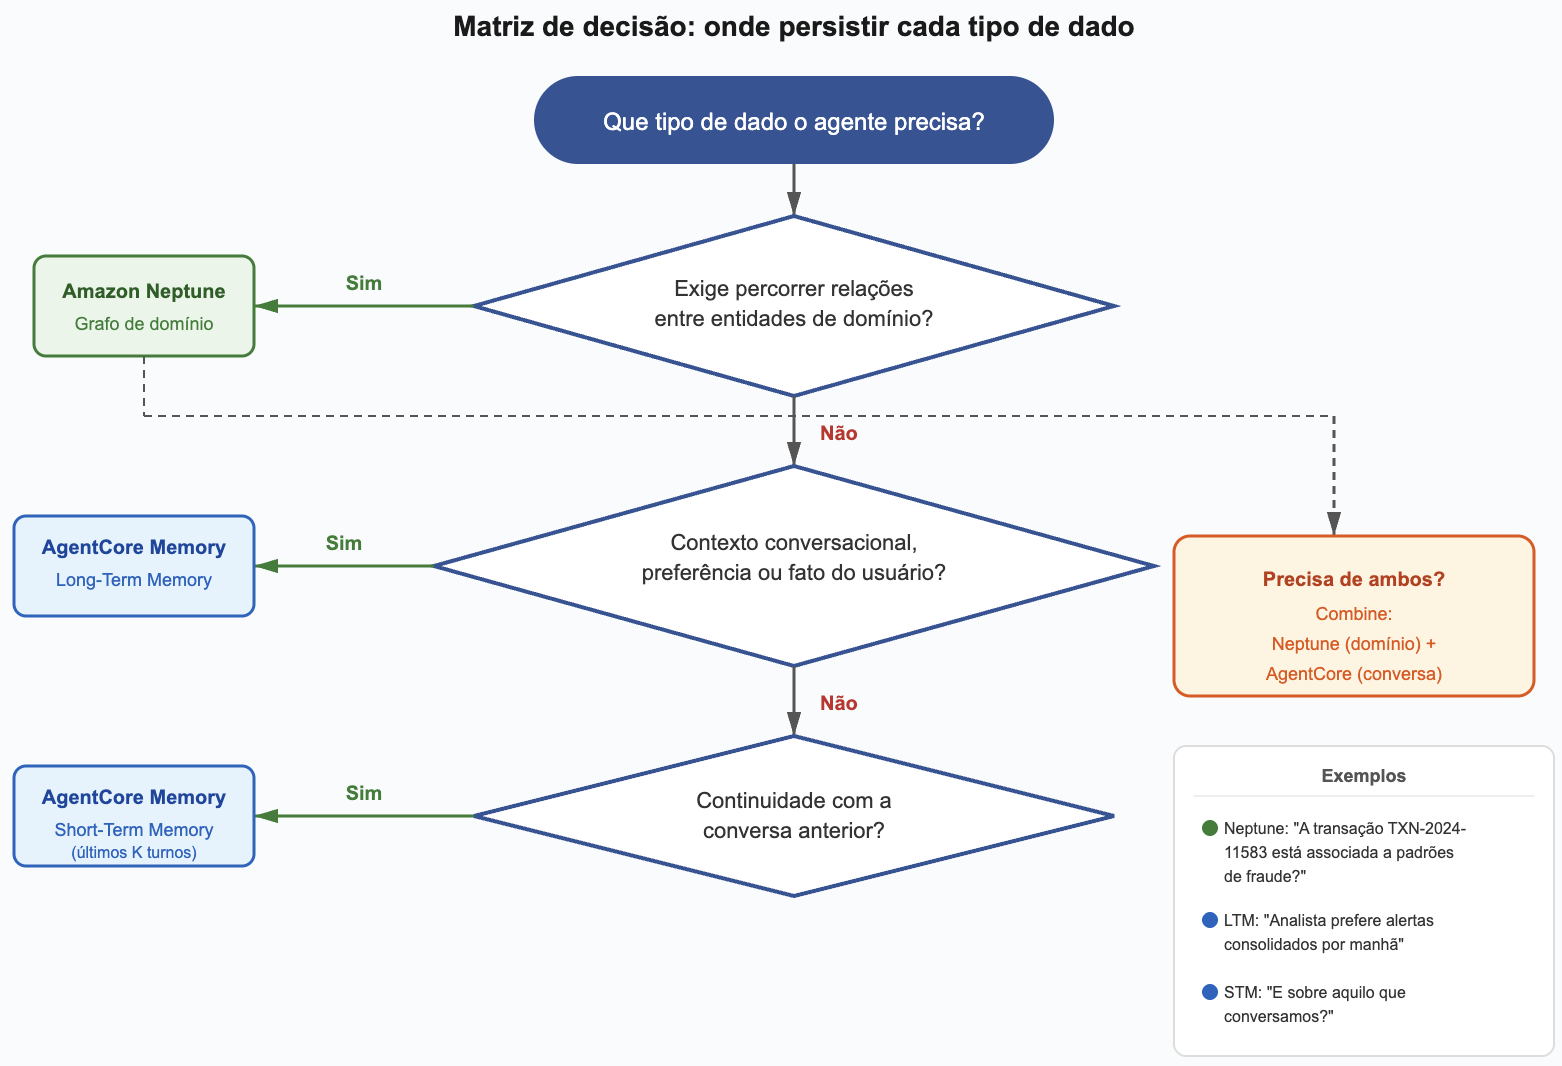
Fluxograma de decisão: onde persistir cada tipo de dado
A seguir, as recomendações consolidadas, separadas por tópico.
Classifique o dado antes de escolher o armazenamento:
- Em contexto sem relação direta, use o AgentCore Memory com Custom Strategy e namespaces temáticos.
- Correlação forte, use grafo (como o Amazon Neptune).
- Para continuidade conversacional, resgate os últimos N turnos.
Deixe a sessão persistir, não somente o agente:
- O Session Manager oferece visão completa da conversa e extração consolidada, reduzindo o risco de perda por abandono ou expiração.
- Reserve a gravação via ferramenta para casos em que o agente realmente precisa de controle explícito sobre um registro pontual.
Torne a extração consciente do domínio:
- Use a Custom Strategy para instruir o modelo de extração sobre o que é crítico no seu contexto.
- Não confie somente em uma estratégia genérica para reconhecer relevância específica.
Recupere com RAG agêntico e em camadas:
- Dê ao agente uma ferramenta de busca e instrua-o a formular consultas a partir do histórico da sessão.
- Some as estratégias disponíveis, como semântica, preferências e customizada, na recuperação.
Comportamento esperado e o que ainda está em aberto
A consolidação do AgentCore Memory é assíncrona e não determinística; ela tende a funcionar melhor para atualizações de um mesmo fato, como uma mudança de orçamento ou de endereço, do que para combinar dados complementares de domínios distintos. Quando necessário, o agrupamento de registros por afinidade ao longo de várias sessões é melhor resolvido em um banco de dados de grafo. Padrões manuais de modificação/escrita via ferramenta estão sujeitos a condições de corrida sob execução concorrente, já que não há atualização atômica condicional. Para esses cenários, externalizar a fonte de verdade do domínio para um grafo continua sendo a escolha mais segura.
Conclusão
Memória de agente não se resume a salvar histórico: é decidir com critério onde cada dado vive, quem o persiste e como ele é recuperado. As três respostas que emergiram são claras. Dados correlacionados pertencem a um banco de dados de grafo, como o Amazon Neptune, enquanto dados contextuais ficam bem no AgentCore Memory com Custom Strategy. A sessão é mais confiável que o agente para persistir, porque enxerga a conversa inteira e consolida o que importa. E o RAG agêntico, somando-se às estratégias disponíveis, supera a recuperação literal ao formular consultas a partir do contexto acumulado. Tratar memória como decisão arquitetural deliberada é o que separa um agente que apenas guarda conversas de um que realmente entende seus usuários ao longo do tempo.
Para colocar esses conceitos em prática, o workshop de memória do AgentCore oferece um roteiro hands-on que percorre desde a configuração inicial até estratégias customizadas de extração. Para entender em profundidade como cada estratégia funciona e quais parâmetros ajustar ao seu domínio, consulte a documentação de estratégias de memória do Amazon Bedrock AgentCore.
Autor
 |
Neuton Assis é Arquiteto de Soluções na AWS para o segmento de Enterprise e membro da comunidade de AI/ML, com foco em Agentic AI. Antes disso, trabalhou por mais de 10 anos na arquitetura e desenvolvimento de softwares voltados para automação, auditoria de sistemas e gestão de identidade e acesso. Atualmente ajuda clientes da AWS, brasileiros e multinacionais, a implementarem arquiteturas de agentes de IA seguras, escaláveis e confiáveis. |