亚马逊AWS官方博客
当 Agent 的记忆变成垃圾场:多轮对话 Agent 的 AgentCore Memory 使用实践
摘要:记忆系统不会自动变好,它只会忠实地放大你喂给它的东西。本文结合 AgentCore Memory 的组件原理,讲多轮对话 Agent 在写入治理、跨用户经验共享和检索触发上的实践。
目录
一、引言
设想一个多轮对话型任务 Agent,日常处理查询、预约、取消、改期、兑换和 FAQ 等请求。接入 AgentCore Memory 后,启用了三种内置策略:semantic(事实)、user_preference(偏好)和 episodic(情景经验)。
上线几个月后,记忆系统出现了三个症状。
(1)长期记忆里堆满了写入时就已经过期的信息。 从生产 Memory 里随手拉出几条 semantic 记录:
“45 个服务单位”在下一次预约后就不对了,“5 天 13 小时”在写入的那一刻就开始过期。更糟的是,这些快照会和实时接口返回的数据打架。
(2)检索时好时坏。 同一个问题,有时能召回关键偏好,有时 top_k 被噪音全部占满。
(3)episodic 记忆名存实亡。 episode 里的“执行过程”不可信,团队只好在检索侧把它一刀切过滤掉:抽取费照付,读的时候全扔。
三个症状指向同一条主线:记忆系统的质量 = 喂进抽取管道的是什么 × 什么时候去读。 AgentCore Memory 是一个被动系统:它不挂钩你的 Agent 运行时,也不拦截工具调用,只能看到你通过 CreateEvent / IngestData 显式发给它的内容。
二、先想清楚:什么值得记
我们给“值得记”定了一个统一口径,叫三过滤测试:
| 过滤器 | 问题 | 反例 |
| 保质期 | 一个月后还成立吗? | “活动还剩 5 天截止” |
| 真相源 | 系统能实时查到吗?能查到就不记 | 余额、状态、配额 |
| 行为改变 | 下次知道这条,会改变回复吗? | “用户上传了一张截图” |
这类场景的特殊性在于:大部分业务数据都有实时接口作为真相源。 把余额、状态存进记忆不只是浪费,而且有害,模型可能拿过期快照去回答用户。所以系统提示词和记忆工具的 description 里都写明:记忆中的余额、时间等数据一律以实时接口为准。
值得记的内容只有两类:一是用户的稳定信息,比如时区、沟通语言、偏好的对象和时段、长期意向;二是任务执行经验,也就是什么调用链成功了、在哪一步失败、后来怎么修正。后者是 episodic 的职责,也是最有价值的部分。
三、AgentCore Memory 组件全景
在讲治理之前,先把 AgentCore Memory 的组件和数据流讲清楚。后面所有的设计取舍,都建立在对这些组件行为的准确理解上。
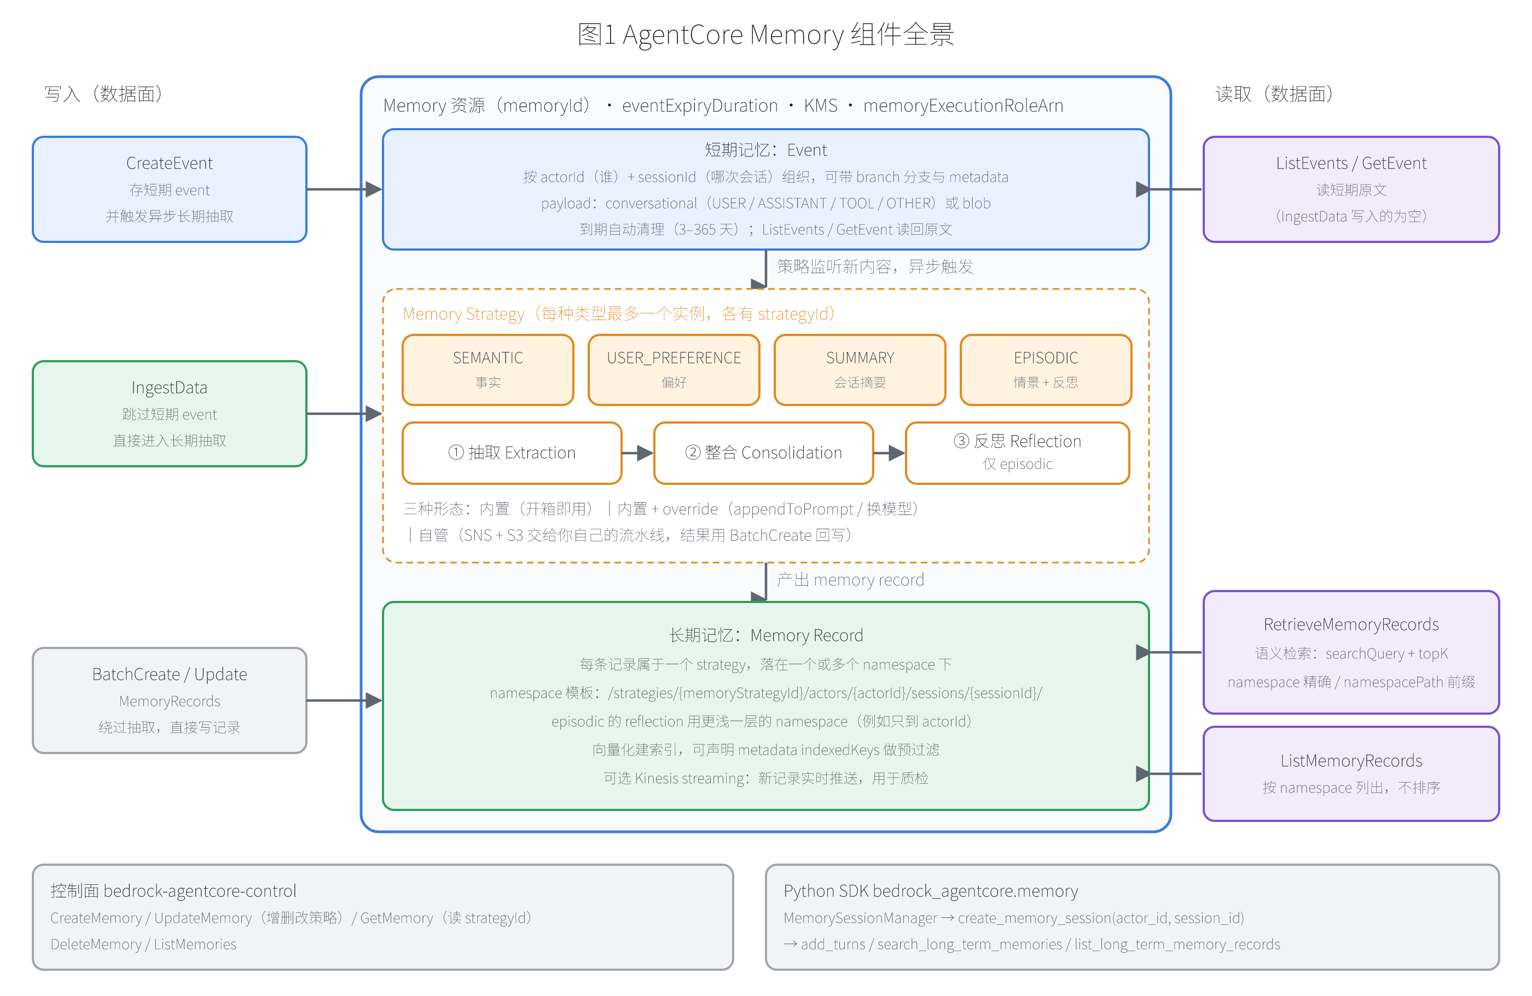
[图 1:AgentCore Memory 组件全景] |
3.1 核心概念与两层记忆
| 概念 | 含义 |
| Memory 资源 | 顶层容器,由 memoryId 标识;配置短期记忆保留期(3–365 天)、KMS 密钥、override 策略使用的执行角色 |
| actor / session | “记忆属于谁” / “来自哪次会话”。actor 可以是终端用户,也可以是一个合成的逻辑身份 |
| event(短期记忆) | 原样保存的对话内容,角色为 USER / ASSISTANT / TOOL / OTHER,到期自动清理 |
| strategy | 长期记忆的加工规则,每种类型在一个 Memory 里最多一个实例,创建后获得动态的 strategyId |
| namespace | 长期记录的存放路径,由模板生成,支持 {memoryStrategyId} {actorId} {sessionId} 占位符 |
| memory record(长期记忆) | 策略加工出的结构化记录,跨 session 持久存在,通过语义检索读取 |
从原始内容到长期记录,要经过一条由策略驱动的异步流水线:抽取(Extraction)→ 整合(Consolidation)→ 反思(Reflection,仅 episodic)。每一步都是一次 LLM 调用,写入后要过一段时间才能检索到。它只能看到你喂进去的内容:喂进去的垃圾不仅会变成垃圾记忆,还要为此付抽取费。
3.2 四种策略与三种形态
| 策略 | 产出 | 典型用途 |
| SEMANTIC | 事实型陈述 | 用户画像、领域知识 |
| USER_PREFERENCE | 偏好型陈述 | 个性化推荐、默认值消歧 |
| SUMMARY | 会话摘要 | 长会话压缩 |
| EPISODIC | episode(situation / intent / assessment / justification / reflection)+ 跨 episode 归纳的经验法则 | 任务经验、失败恢复 |
每种策略有三种使用形态:内置(prompt、模型、schema 全托管);内置 + override(保留内置流水线,用 appendToPrompt 给各步追加业务指令,可换模型);自管(服务端只负责按条件触发并把内容投递到你的 S3/SNS,加工后用 BatchCreateMemoryRecords 写回)。本文的改造全部基于内置策略,第九章会讨论下一步切到 override。
3.3 namespace:隔离与共享的唯一抓手
写入侧,namespace 由策略配置里的模板生成,在建库时一次定型:
ctl = boto3.client("bedrock-agentcore-control")
ctl.update_memory(memoryId=memory_id, memoryStrategies={"addMemoryStrategies": [
    {"userPreferenceMemoryStrategy": {
        "name": "preferences",
        "namespaces": ["/strategies/{memoryStrategyId}/actors/{actorId}/"]}},
    {"episodicMemoryStrategy": {
        "name": "episodes",
        "namespaces": ["/strategies/{memoryStrategyId}/actors/{actorId}/sessions/{sessionId}/"],
        "reflectionConfiguration": {          # reflection 写在哪一层,就在哪一层归纳
            "namespaces": ["/strategies/{memoryStrategyId}/actors/{actorId}/"]}}},
]})
episode 总是从单个 session 中产生;reflection 的 namespace 必须与 episode 同一模式,但可以更浅。写到 actor 层,就只在同一个 actor 的 episode 之间归纳;写到 strategy 层才会跨 actor 归纳,官方文档也提醒这要考虑隐私影响。这是第五章共享 actor 方案的出发点。
读取侧,RetrieveMemoryRecords 支持 namespace 精确匹配和 namespacePath 前缀匹配。前缀锚定到 /strategies/{id}/actors/{actorId},可以跨 session 读同一用户的全部记录;前缀只到 /strategies/{id},就会读到所有用户的数据。
3.4 API 地图
| 平面 | API | 用途 |
| 控制面 | CreateMemory / UpdateMemory / GetMemory | 建库、增改策略、读取 strategyId |
| 数据面 · 写 | CreateEvent | 存短期 event 并触发异步抽取;extractionMode=SKIP 可跳过抽取 |
| 数据面 · 写 | IngestData | 不存短期 event,直接进入长期抽取 |
| 数据面 · 写 | BatchCreate / Update / Delete MemoryRecords | 绕过抽取,直接维护长期记录 |
| 数据面 · 读 | RetrieveMemoryRecords / ListMemoryRecords | 语义检索 / 按 namespace 枚举 |
| 数据面 · 读 | ListEvents / GetEvent | 读回短期原文 |
Python SDK bedrock_agentcore.memory 在数据面之上封装了会话对象:MemorySessionManager(...).create_memory_session(actor_id, session_id) 提供 add_turns(CreateEvent)和 search_long_term_memories(RetrieveMemoryRecords)。SDK 尚未封装的 IngestData 直接用 boto3 调用。
四、整体集成方案
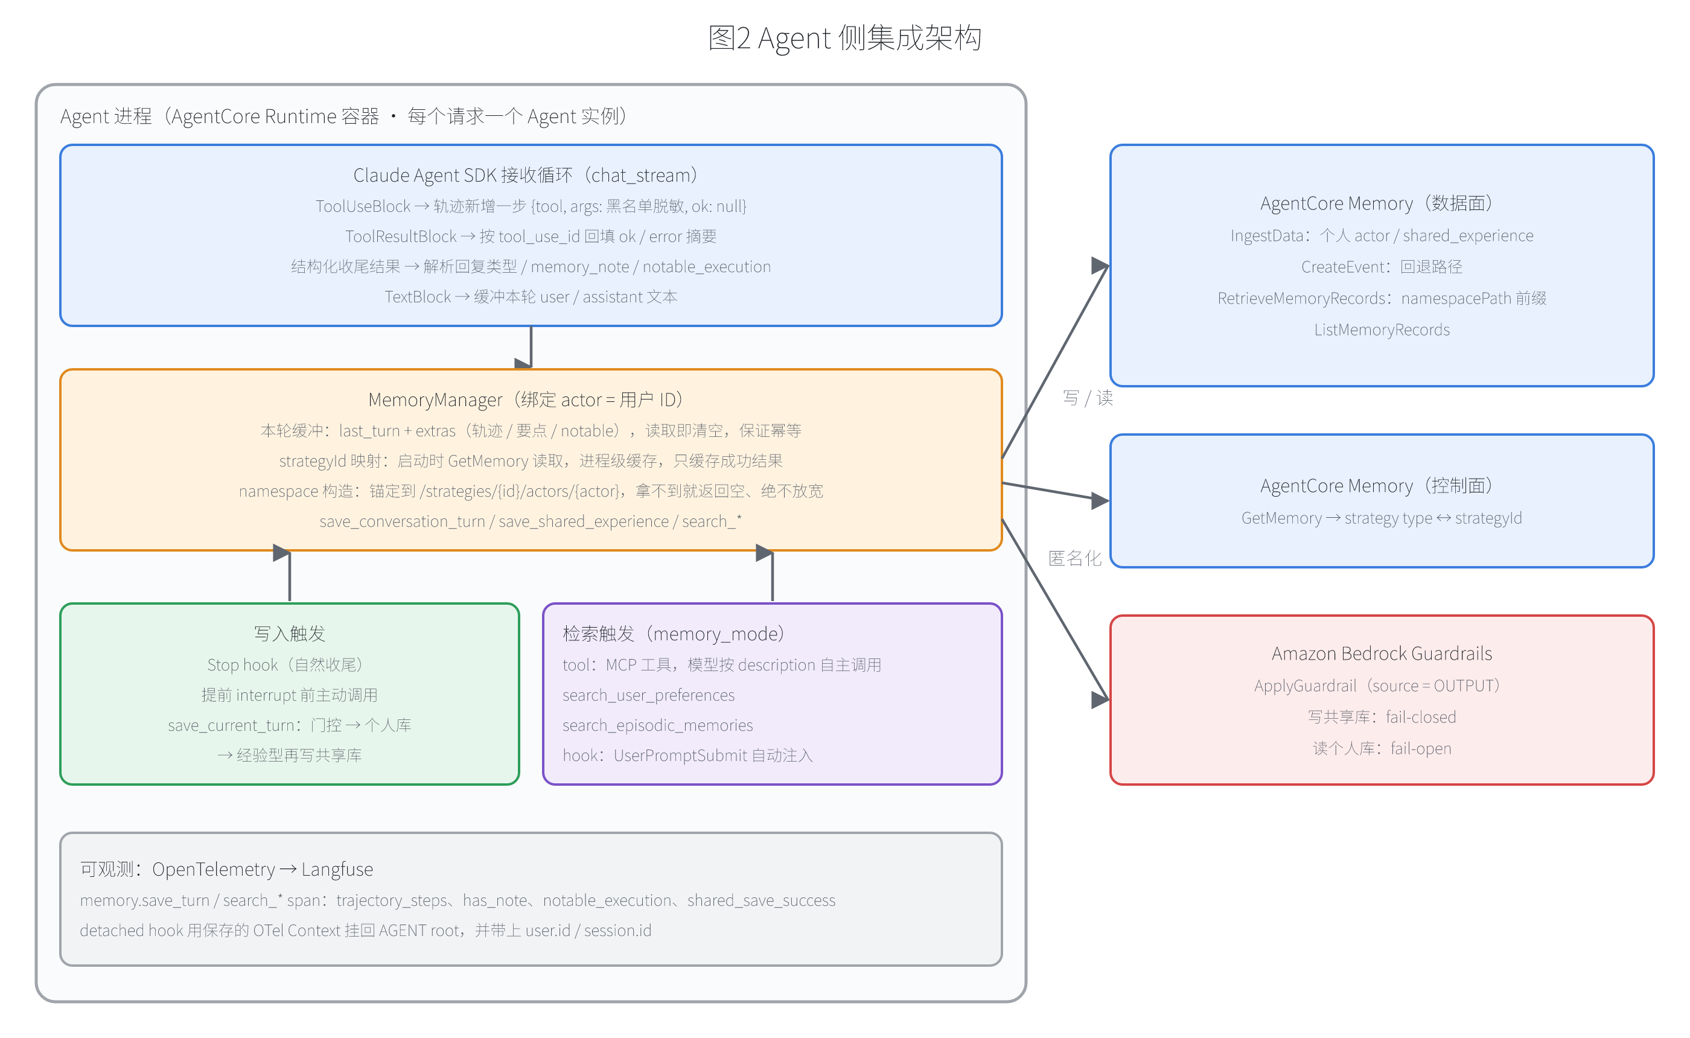
[图 2:Agent 侧集成架构] |
Agent 基于 Claude Agent SDK 实现,部署在 AgentCore Runtime 上,每个请求创建一个 Agent 实例,并按用户 ID 绑定一个 MemoryManager。MemoryManager 初始化时做两件事:建立 SDK 会话对象;通过控制面 GetMemory 读出各策略的 strategyId,后面拼 namespace 全靠它:
mgr = MemorySessionManager(memory_id=MEMORY_ID, region_name=REGION)
session = mgr.create_memory_session(actor_id=user_id, session_id=session_id)

memory = ctl.get_memory(memoryId=MEMORY_ID)["memory"]
strategy_ids = {s["type"]: s["strategyId"] for s in memory.get("strategies", [])}
# 进程级缓存,只缓存成功结果;拿不到时检索降级为空,而不是放宽前缀
一轮对话里,记忆相关的执行顺序如下:
- 模型推理,需要时调用
search_user_preferences/search_episodic_memories两个记忆工具(以 MCP 工具注册)读取记忆; - 每次业务工具调用,接收循环记录一步轨迹,并在工具结果回来时回填成败;
- 模型以结构化结果收尾,接收循环解析出回复类型和记忆相关字段(见关卡一、二),写入 MemoryManager 的本轮缓冲;
- 回复确认送达后触发保存:先过门控,通过后用 IngestData 写个人库;经验型轮次再匿名化写一份到共享经验库;
- AgentCore 异步执行抽取、整合与反思,产出长期记录,供后续轮次检索。
接下来三章分别讲写入、共享和检索三个环节的设计与关键实现。
五、写入侧治理:四道关卡
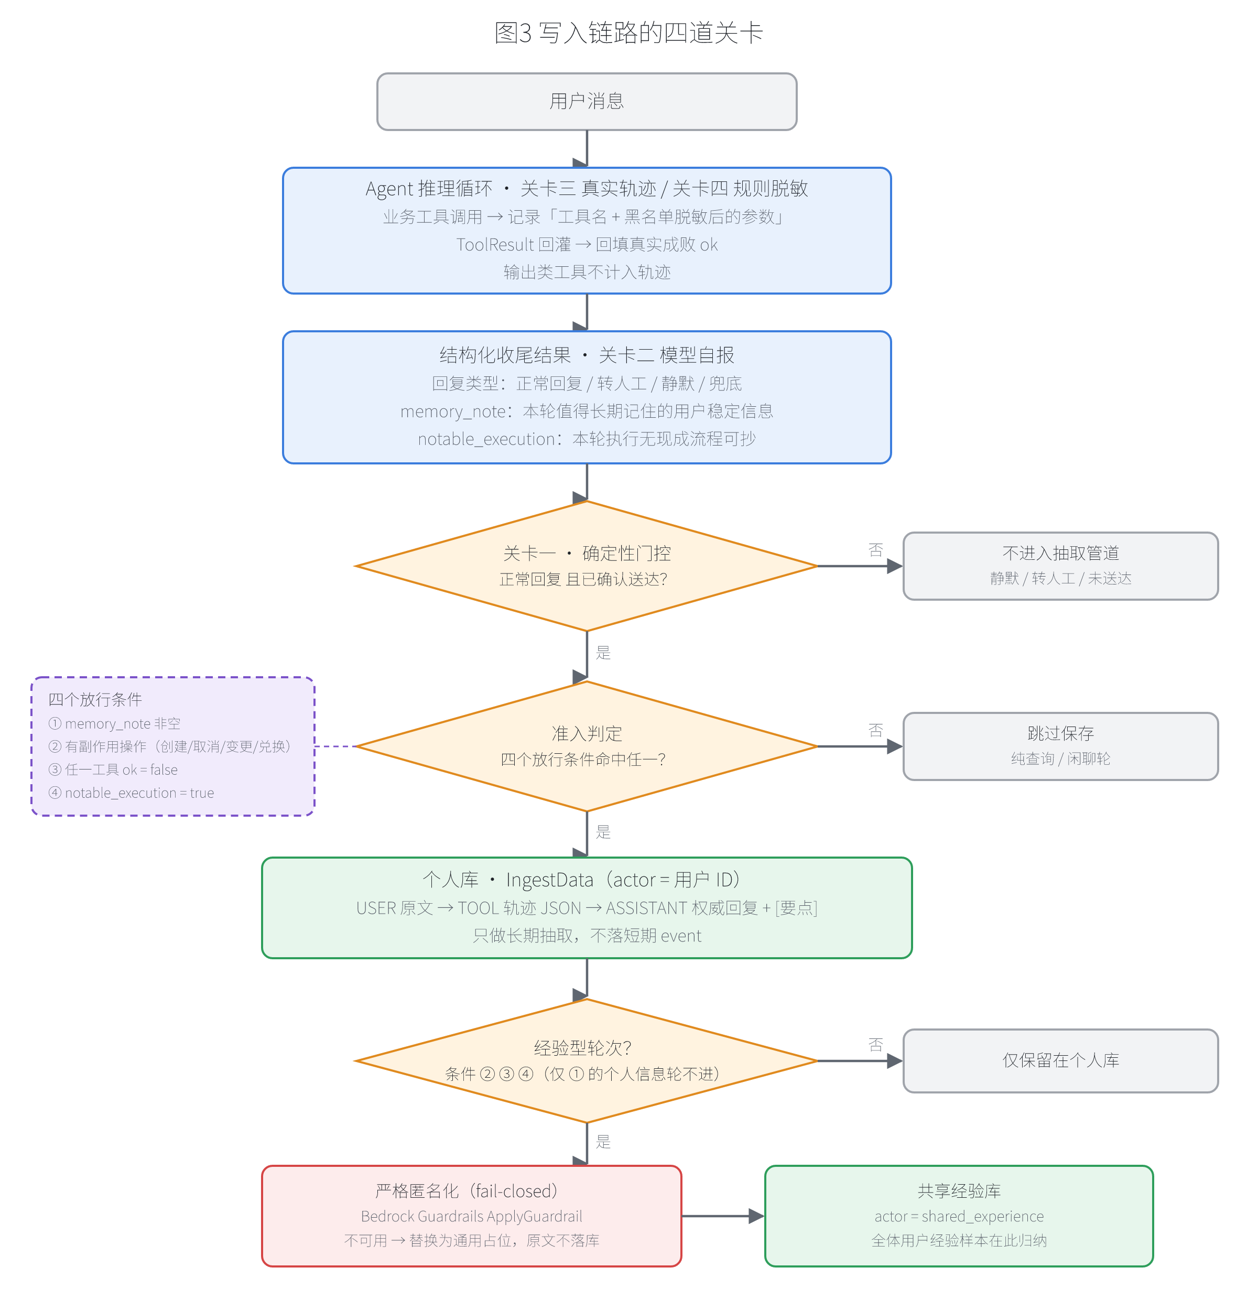
[图 3:写入链路的四道关卡] |
5.1 关卡一:确定性门控
Agent 每轮以一个结构化结果收尾(可以是一个专门的输出工具,也可以直接用 structured output),其中的回复类型区分了正常回复、转人工、静默和兜底几种情况。旧实现会无条件保存每一轮;改造后,只有正常回复且确认送达的轮次才有资格进入抽取管道。这一步完全由规则判断,从源头掐断了一批垃圾,也省下了对应的抽取费用。
5.2 关卡二:让模型自报
规则能判断“发生了什么”,判断不了“有没有长期价值”。所以我们在这个结构化结果里加了两个可选字段:
memory_note:本轮值得长期记住的用户稳定信息,相当于三过滤测试的“模型版”。它会附在回复末尾,作为抽取管道的聚焦提示;
notable_execution:本轮执行值得作为经验。用来捕捉两类只有模型自己知道的情况:没有 Skill 指引、自己摸索完成的多步任务;以及一度以为办不成、最后却办成了的任务。
这里有个坑:判断口径要写“有没有现成流程可抄”,不要写“难不难”。 最初的 description 写的是“完成复杂任务时置 true”。端到端测试中,模型为一个涉及多个关联对象的请求串行调用 4 个查询工具,汇总对比了多项状态数据,回复质量很好,但 notable_execution 却是 false,因为模型觉得这件事“不复杂”。我们把口径改成“本轮未加载 Skill 且自行编排了 ≥2 个业务工具”,这是模型可以对照检查的事实。补上汇总对比类正例后,同一场景复测,模型正确地自报了 true。
5.3 关卡三:把真实工具轨迹喂给 episodic
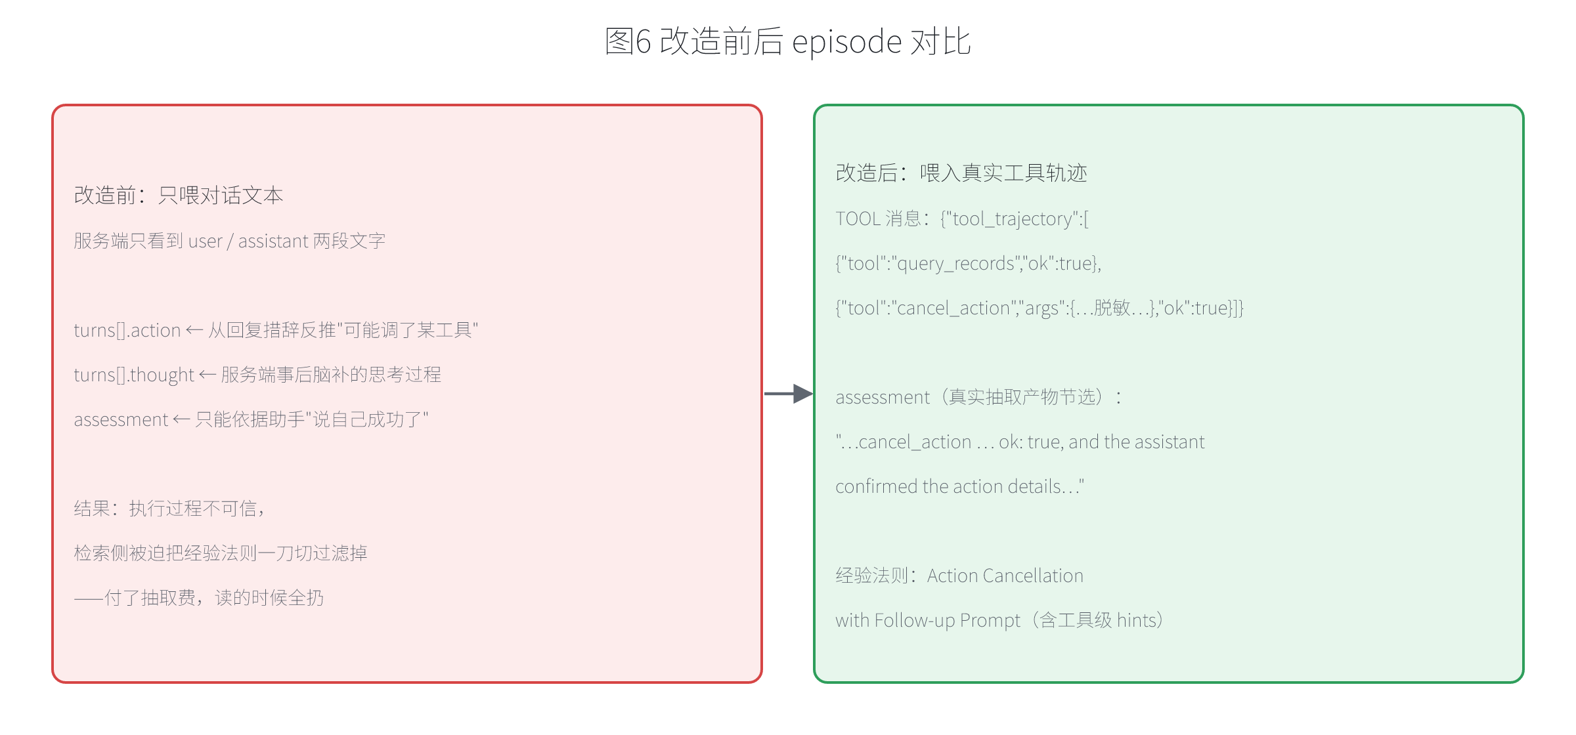
这一步解决“episodic 名存实亡”的根因。episodic 策略会把交互抽取成 episode(situation / intent / assessment / justification / reflection),并在后台跨 episode 做 reflection,归纳经验法则。问题是旧实现只喂了 user 和 assistant 两段文本,服务端看不到实际调了哪些工具、每一步是成是败,只能从回复措辞里事后反推。
官方文档对此说得很直接:“including TOOL results will yield optimal results”。TOOL 结果要你自己放进去,不放它就看不到。于是我们在 Agent 的接收循环里采集每次业务工具调用,包括工具名、脱敏参数,以及从工具结果回灌消息中解析出的真实成败 ok,再以 TOOL 角色随对话一起写入:
采集在 Claude Agent SDK 的接收循环里完成:ToolUseBlock 出现时记一步,对应的 ToolResultBlock 回来时按 tool_use_id 回填真实成败。如果收尾的结构化结果也是用工具承载的,这类输出工具不属于业务动作,要排除在轨迹之外:
for block in message.content:
    if isinstance(block, ToolUseBlock):
        name = block.name.split("__")[-1]                # 去掉 mcp__server__ 前缀
        if name in OUTPUT_TOOLS:                          # 输出类工具不算业务动作
            continue
        step = {"tool": name, "args": sanitize(block.input), "ok": None}
        trajectory.append(step)
        pending[block.id] = step
    elif isinstance(block, ToolResultBlock) and block.tool_use_id in pending:
        # is_error 或业务返回的 success 字段;解析不出就保持 None,不误标
        pending.pop(block.tool_use_id)["ok"] = parse_status(block)
另一个认知修正是:成败判断交给 AgentCore,不要自己造。 episode 的 assessment 本来就是服务端对“是否满足了用户意图”的评估。我们需要做的只是给它判断依据,也就是真实轨迹。
5.4 关卡四:脱敏用规则,不用模型
轨迹参数里有用户 ID、姓名、手机号和图片 URL。我们用键名黑名单 + 截断 来处理:键名含 id / name / url / token / phone / image / query 的参数一律丢弃,值超过 60 字符就截断。
理由是:合规过滤要求零方差、可单测。 由此也得到整个设计的分层原则:能用规则的绝不用模型(回复类型门控、副作用工具清单、脱敏黑名单);只有“复杂”“意外”“值得记”这类主观状态,才交给模型自报。
四道关卡最终收敛成十几行准入逻辑:
_SIDE_EFFECT_TOOLS = frozenset({"create_action", "cancel_action",
                                "update_action", "redeem_action"})

def _turn_worth_saving(tool_trajectory, memory_note, notable_execution=False) -> bool:
    if memory_note or notable_execution:              # ① 模型提炼了要点 / ④ 模型自报
        return True
    for step in tool_trajectory:
        if step.get("tool") in _SIDE_EFFECT_TOOLS:    # ② 发生了副作用操作
            return True
        if step.get("ok") is False:                   # ③ 工具失败:失败-修正链价值最高
            return True
    return False                                      # 纯查询 / 闲聊:不进抽取管道
通过门控的轮次用 IngestData 写入个人库,USER / TOOL / ASSISTANT 三段按顺序放进同一次调用。这条路径不存短期 event,直接进入长期抽取:
client = boto3.client("bedrock-agentcore")
client.ingest_data(
    memoryId=memory_id, actorId=user_id, sessionId=session_id,
    contentTimestamp=datetime.now(timezone.utc),
    source={"inline": {"payload": [
        {"conversational": {"content": {"text": text}, "role": role}}
        for role, text in messages            # USER → TOOL → ASSISTANT
    ]}},
)
六、跨用户经验共享:共享 actor 模式
我们的目标是:一个用户踩过的坑,另一个用户不必再踩,episodic 应该是一个全局经验库。
团队原以为已经实现了共享,因为检索时用了很宽的 namespace 前缀,能读到所有用户的 episode。但配置里 reflection 的 namespace 是 /strategies/{memoryStrategyId}/actors/{actorId}/,这是 actor 级的。也就是说,跨 episode 的经验归纳从未跨过用户边界:宽前缀只是把各家各自归纳的结果拼在一起读,而且读到的是带个人信息的原始 episode,还有跨租户泄露风险。
我们比较了三个方案:
| 方案 | 问题 |
| a. reflection 改成 strategy 级 | 每种策略只能有一个实例,替换要删旧建新,存量受影响;归纳输入仍带 PII |
| b. 宽前缀检索 + 读时遮蔽 | 共享只做了一半,PII 已经落库,只能靠读侧补救 |
| c. 共享 actor | 零资源变更、写入即干净、reflection 在该 actor 内天然全局归纳 |
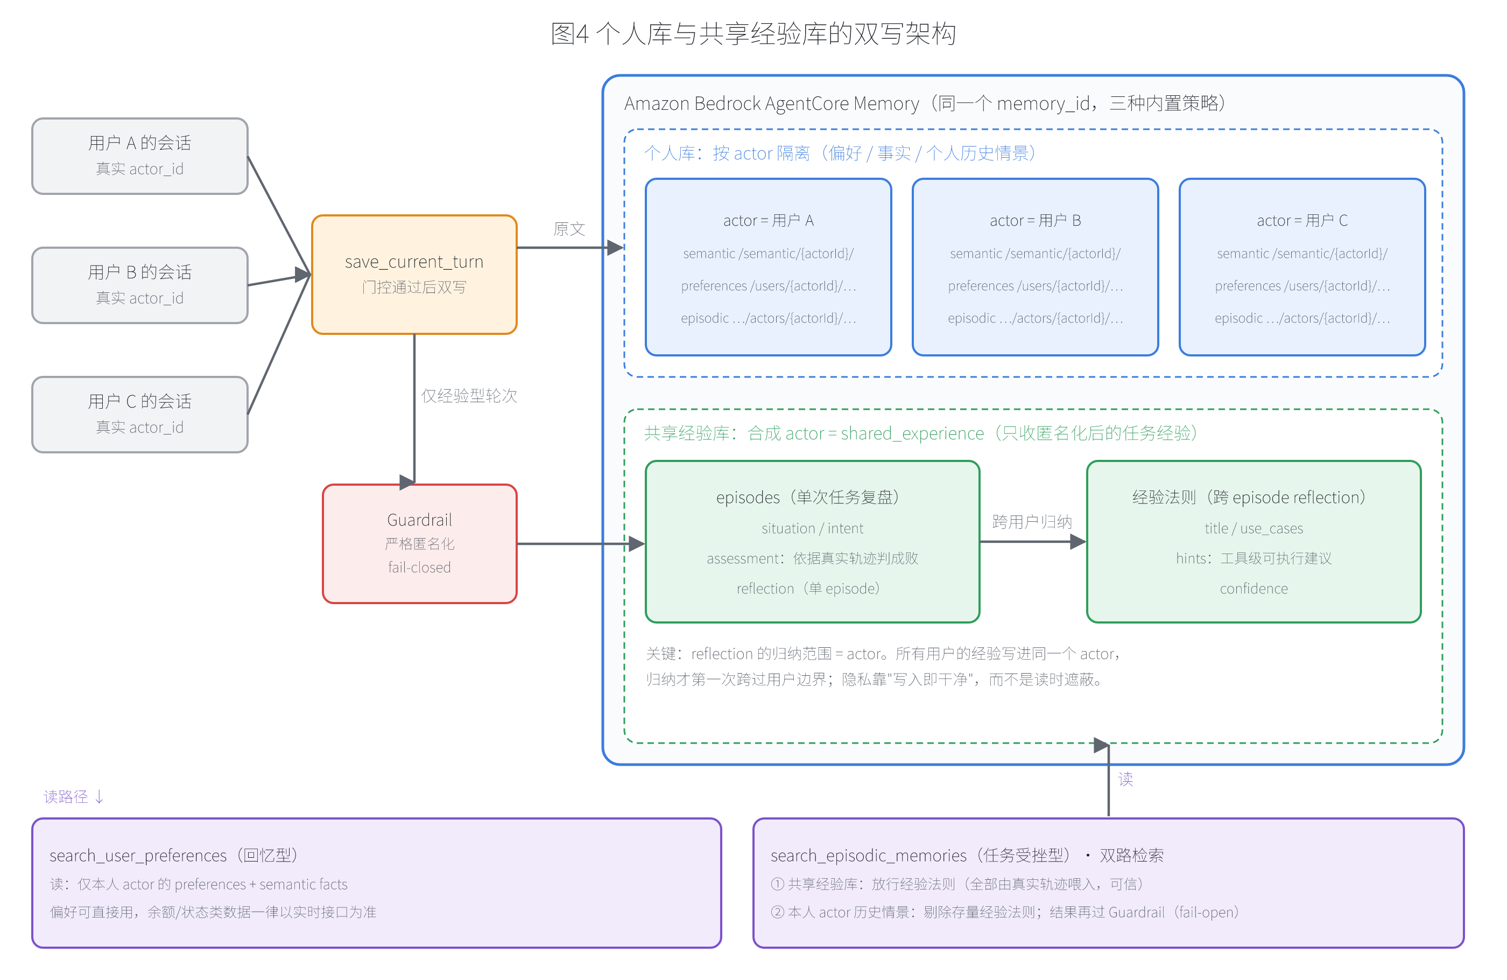
最终选了 c:合成一个 actorId = shared_experience,把匿名化后的“经验型”轮次(副作用操作 / 工具失败 / notable)额外写一份进去。只有 memory_note 的轮次属于个人信息,只进个人库。
[图 4:个人库与共享经验库的双写架构] |
匿名化是有方向的。 写共享库时采用 fail-closed:Guardrail 未配置或调用失败时,原文替换为通用占位,绝不落库,因为一旦落库就跨用户可见。读个人库时采用 fail-open:Guardrail 失败时返回原文,因为 namespace 已经隔离,可用性优先。Guardrail 配置了 NAME / PHONE / EMAIL / ADDRESS 的匿名化(ANONYMIZE 而非 BLOCK),另外加了一条 13–19 位数字 ID 正则。共享库的隐私因此由三层组成:轨迹黑名单 + 写入 fail-closed 匿名化 + 读取 fail-open 兜底。
写共享库和写个人库是同一个 IngestData 调用,只是 actorId 换成 shared_experience,并在写入前做严格匿名化。拿不到安全文本时用占位符替代用户原话,工具轨迹照常写入:
def anonymize_strict(text: str) -> str | None:
    try:
        resp = bedrock_runtime.apply_guardrail(
            guardrailIdentifier=GUARDRAIL_ID, guardrailVersion=GUARDRAIL_VERSION,
            source="OUTPUT", content=[{"text": {"text": text}}])
        if resp["action"] == "GUARDRAIL_INTERVENED":
            outputs = resp.get("outputs") or []
            return outputs[0]["text"] if outputs else None
        return text
    except Exception:
        return None                    # fail-closed:拿不到安全文本就不用原文

user_text = anonymize_strict(user) or "[经验样本] 用户提出了一个业务请求(原文已略去,见工具轨迹)"
七、检索侧:什么时候去查记忆
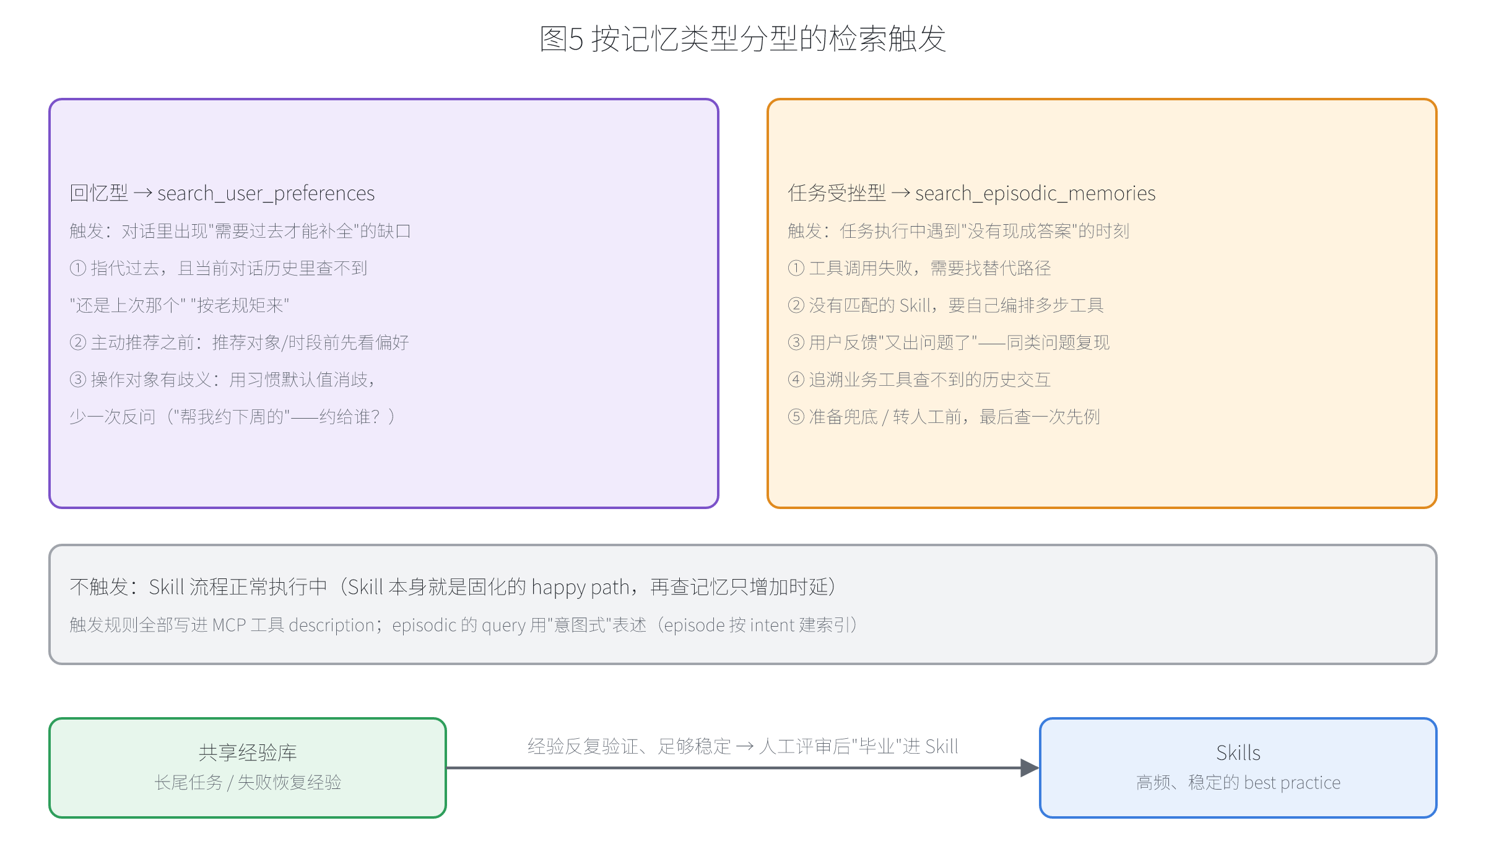
常见的两种做法都不理想:每轮都查会增加时延,召回的内容大多和当前问题无关;全凭模型悟性,description 只写一句“需要时调用”,结果时查时不查。我们的做法是按记忆类型分型,把触发条件写成模型能对照检查的场景。
[图 5:按记忆类型分型的检索触发] |
偏好与事实走回忆型触发(search_user_preferences,同时返回 preference 和 semantic facts),适用于三种情况:指代过去而当前对话里查不到;主动推荐之前;操作对象有歧义时,用习惯默认值消歧,少一次反问。
经验走任务受挫型触发。 一个关键认知:用户不会说“请参考你之前的经验”,所以 episodic 不能靠“上次”“之前”这类词触发。它的使用场景是任务做到一半卡住了。因此 search_episodic_memories 的 description 里列了五个时机:
第 ⑤ 条的性价比最高:模型本来就打算放弃了,最坏结果是照样兜底,最好的情况是把一次放弃变成一次成功。意图式 query 也很关键,因为 episode 是按 intent 建索引的。
检索实现上有两个要点。 两个检索工具以 MCP 工具注册给 Agent,内部调用 RetrieveMemoryRecords(SDK 的 search_long_term_memories)。第一,namespace 前缀必须锚定到 actor 层,strategyId 从 GetMemory 动态读取,任何一个要素缺失都宁可读空,绝不退回宽前缀。第二,episodic 做双路召回:共享经验库放行经验法则,个人库只取情景记录(存量的个人法则来自稀薄的对话文本,可信度不足);由于过滤会占掉候选位,先多取再截断:
def actor_ns(strategy_type, actor_id):
    sid = strategy_ids.get(strategy_type)          # 来自 GetMemory,不硬编码
    return f"/strategies/{sid}/actors/{actor_id}" if sid and actor_id else None

def search_episodic(query, top_k=3):
    results = []
    for actor, allow_rules in ((SHARED_ACTOR, True), (user_id, False)):
        ns = actor_ns("EPISODIC", actor)
        if not ns:
            continue                               # 宁可读空,不放宽前缀
        hits = session.search_long_term_memories(
            query=query, namespace_path=ns, top_k=min(top_k * 4, 20))
        kept = [slim(h, allow_rules) for h in hits]  # 剔除个人法则、去掉冗余的 turns
        results += [k for k in kept if k][:top_k]
    return results
和 Skill 的分工。 我们的判断是:Skills 里的流程本身就是做一件事情的 best practice,再让它去查记忆有一点多余,而且会增加时延。所以我们没有在 Skill 里插入“先查记忆”的步骤,触发规则全部写在工具 description 里。Skill 管高频、稳定的 happy path;共享经验库管长尾任务和失败恢复。同类经验反复验证、足够稳定后,经人工评审“毕业”进入 Skill。
八、工程细节
- IngestData 还是 CreateEvent。 CreateEvent 会先存短期 event 再异步抽取;IngestData 直接进入长期记忆抽取,不存短期 event。我们的对话原文已经由业务侧(Java + Redis)保存,AgentCore 里的 raw event 从没被读回过,所以选了 IngestData,并保留了回退到 CreateEvent 的路径。有两个坑:一是 Runtime 执行角色要显式授权
bedrock-agentcore:IngestData,否则会一直静默回退;二是需要 botocore ≥ 1.43.98,boto3 和 botocore 要一起锁版本。如果只想让某几条消息不抽取,可以用 CreateEvent 的extractionMode=SKIP。 - Guardrail 要在中文场景实测。 内置策略说明中提到抽取时默认忽略 PII,但存量记录里仍然出现了用户姓名和昵称。实测下来,Guardrail 对中文全名、手机号、邮箱识别稳定,但“姓 + 称谓”(如“王先生”)会漏检,需要补一条正则。结论是纵深防御必不可少,每一层都应该假设其他层会漏。
- 可观测。 我们在 Langfuse 的
memory.save_turnspan 上记录了trajectory_steps / has_note / notable_execution / shared_save_success,可以直接统计门控放行率和模型自报率,再对照人工抽检判断是漏报还是误报。进一步可以接入 Kinesis record streaming,实时质检新生成的记忆记录。 - 保存时机:Stop hook 不是唯一入口,且不能 fire-and-forget。 如果 Agent 拿到最终结果后调用
client.interrupt()提前结束,SDK 走中断分支,不会派发 Stop hook,必须在 interrupt 前主动保存;本轮缓冲“读取即清空”,避免重复写入。保存还必须 await 完成(同步 boto3 调用放进asyncio.to_thread),丢给后台 task 会在请求收尾时被取消,日志里看不出任何异常。 - 权限要配全。 Runtime 执行角色除了 CreateEvent / IngestData / RetrieveMemoryRecords,还需要控制面的
GetMemory。缺了它拿不到 strategyId,所有检索都会静默返回空。
九、端到端验证:闭环长什么样
我们设计了一个 4 轮对话测试,使用真实 Bedrock 模型和真实 AgentCore Memory,业务接口用 mock:
| 轮次 | 场景 | 预期 | 结果 |
| 1 | 寒暄 | 跳过保存 | ✅ |
| 2 | 纯查询状态 | 跳过保存 | ✅ |
| 3 | 取消一次预约 | 双写,共享库姓名被匿名化 | ✅ 姓名 → {NAME} |
| 4 | 多对象状态汇总 | 模型自报 notable | ❌ → 改口径后 ✅ |
此外还确认了两点:IngestData 下该 session 的短期 event 数为 0;轨迹中的 ID 类参数全部被丢弃。
最重要的结果在抽取产物里。 共享库生成的 episode,其 assessment 直接引用了真实轨迹:“…cancel_action … ok: true, and the assistant confirmed the action details…”。成败判断有了依据,不再靠脑补。随后,reflection 在共享 actor 下归纳出一条带工具级建议的经验法则:
这条法则不含任何个人信息,内容是“用哪个工具、参数怎么取、下一步做什么”,正是我们想要的经验。
[图 6:改造前后 episode 对比] |
验证的边界也要如实说明:业务返回值来自 mock;模型行为结论基于 Claude Sonnet,自报类行为与模型强相关,换模型需要单独回归。此外测试暴露出门控管不到的问题:semantic 策略在副作用操作轮仍会抽出“用户取消了 X 月 X 日的预约”这类时效性事实,只能在抽取环节内部解决。
十、下一步:让抽取按业务口径工作
门控决定哪些轮次进入管道,管不到进入之后抽什么。AgentCore 支持 built-in with overrides 策略:保留内置 pipeline 和输出 schema,通过 appendToPrompt 追加抽取、整合、反思指令(需要配置 memoryExecutionRoleArn)。semantic 的追加指令示例:
episodic 方面要求“行动序列与 assessment 以 TOOL 消息中的 tool_trajectory 为准”,reflection 方面要求“给出工具级可执行建议”。这样,三过滤测试同时落在模型自报、代码门控和服务端抽取三个层面。
对应的策略配置如下(以 semantic 为例,需要在 Memory 上配置 memoryExecutionRoleArn;episodic 用 episodicOverride,多一个 reflection 步骤):
{"customMemoryStrategy": {
    "name": "facts_v2",
    "namespaces": ["/strategies/{memoryStrategyId}/actors/{actorId}/"],
    "configuration": {"semanticOverride": {
        "extraction":    {"appendToPrompt": EXTRACTION_RULES,    "modelId": MODEL_ID},
        "consolidation": {"appendToPrompt": CONSOLIDATION_RULES, "modelId": MODEL_ID},
    }}}}
由于每种策略只能有一个实例,切换到 override 需要新建策略并迁移存量,建议先在测试 Memory 上验证。
其他可以继续做的事:用 metadata indexedKeys 做检索预过滤;测试与生产使用不同的 Memory;用 IAM condition key 把 namespace 隔离从代码约定升级为权限硬隔离;在评测集中加入“应检索 / 应写 note / 应标 notable”的标注。
十一、总结:多轮对话 Agent 的 Memory 实践清单
- 先定口径再写代码:用三过滤测试统一”什么值得记”。
- 有实时接口的数据不进记忆,提示词里明确记忆数据不可直接引用。
- 只保存真正说出口的回复,按回复类型做确定性门控。
- 纯查询和闲聊不进抽取管道,放行条件要明确。
- 主观判断交给模型自报,并改写成可检查的事实。
- episodic 必须喂真实工具轨迹,成败判断交给 assessment。
- 脱敏用规则,不用模型。
- 跨用户经验用共享 actor:reflection 的归纳范围等于 actor。
- 匿名化有方向:写共享库 fail-closed,读个人库 fail-open。
- 检索按类型分型,规则写进工具 description,不往 Skill 里插。
- namespace 锚定到 actor 层,拿不到 strategyId 时宁可读空,也不放宽前缀。
这次改造用到的新功能并不多,真正起作用的是两件事:想清楚喂进去什么,想清楚什么时候读出来。 记忆系统不会自动变好,它只会忠实地放大你喂给它的东西。
➡️ 下一步行动:
相关产品:
- Amazon Bedrock — 用于构建生成式人工智能应用程序和代理的端到端平台
- Amazon Bedrock AgentCore — 加快代理投入生产的速度
- Amazon Batch — 完全托管式批处理
- Amazon S3 — 适用于 AI、分析和存档的几乎无限的安全对象存储
- Amazon SNS — 发布/订阅和推送通知
相关文章:
- 让 Agent拥有「跨终端长期记忆」——基于 Amazon Bedrock AgentCore Memory 的实践
- 存之有序,治之有矩——Agent 记忆系统的工程实践与演进
- 用 Amazon DynamoDB 构建无需双写的 Agent Memory 与语义检索
- Amazon Bedrock AgentCore 数据持久化文件系统:Session Storage 和 Amazon EFS / S3 Files
十二、参考资料
以下为本文涉及的官方文档与参考资料:
- Amazon Bedrock AgentCore Memory — Get started(Memory strategies / Episodic / Built-in with overrides)
- AgentCore Memory — Episodic memory strategy(Namespaces / How to best retrieve episodes)
- AgentCore Memory — Ingest content into long-term memory(IngestData)
- AgentCore Memory — Store short-term memory(CreateEvent)
- AWS Well-Architected Agentic AI Lens — AGENTSUS02-BP01 Optimize context management and memory utilization
- AWS 博客 — Organizing agents’ memory at scale: Namespace design patterns in AgentCore Memory
- Amazon Bedrock Guardrails — Remove sensitive information with sensitive information filters
*前述特定亚马逊云科技生成式人工智能相关的服务目前在亚马逊云科技海外区域可用。亚马逊云科技中国区域相关云服务由西云数据和光环新网运营,具体信息以中国区域官网为准。
本篇作者
AWS 架构师中心:云端创新的引领者探索 AWS 架构师中心,获取经实战验证的最佳实践与架构指南,助您高效构建安全、可靠的云上应用
|
 |