什么是图像分割?
什么是图像分割?
图像分割是将数字图像划分为标记像素组的过程,用于对象检测、图像处理和其他计算机视觉任务。组织拥有大量的图像数据集合,例如单张图像、视频序列、多个摄像头的视图或三维数据。图像分割技术将图像的复杂视觉数据解析为特定形状的分段,以识别对象边界和背景区域。它们自动化图像分析和分类,以支持许多 AI 用例,例如医学图像诊断、机械维护和自动驾驶车辆。
图像分割有哪些应用?
图像分割使机器能够理解图像 – 场景、对象以及图像的含义。例如,您可以使用图像分割来
-
识别医学图像分析中人眼可能忽略的异常。
-
根据场景中的特定对象更改图像。
-
注意感兴趣的地方,特别是当它们与卫星图像中的自然景观不一致时。
它也在自动驾驶汽车中有应用。您可以通过确定针对视觉场景中的哪些内容(例如交通信号灯、行人、限速标志等)需要进行制动、转向或加速,来安全地在道路上导航。
图像分割的工作原理?
图像分割通过处理图像来定义两个或多个部分,显示不同区域之间的边界。区域是包含背景信息和前景对象的独特图像区域。例如,人或汽车等对象是与背景元素(如田野或没有清晰边界的一群人)明显分离的、定义明确的形状。
在分割过程中,区域根据以下标准被分类为分段:
-
视觉相似性 – 包括颜色、纹理或与其他相似像素的邻近度
-
语义特征,例如对象类型(如车辆、动物)
-
图像场景,例如糖果店或公园。
图像中的每个像素都被标记以表示其所属的分段。
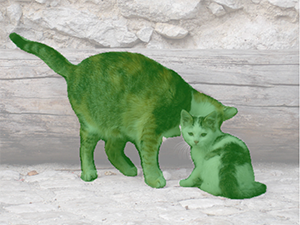
掩蔽
每个分段(尤其是代表对象的分段)都覆盖有一个掩码,将其与图像的其余部分隔离。此掩码是一个二值矩阵,用于标识图像中哪些像素属于该对象(标记为 '1'),哪些不属于(标记为 '0')。这使其他算法能够获取图像分割输出,并精确地对特定区域应用标记或编辑操作,同时保持对象完整并与其环境分离。彩色叠加层可以在视觉上表示掩码。
传统图像分割技术
在机器学习和人工智能取得当前进展的几十年前,数据科学家就已经在使用传统的图像分割技术。这些技术使用更原始的数字图像处理方法,其结果准确性较低。但是,它们有时可以比现代方法更快地给出结果,并且对于单对象图像仍然是可行的选择。相关概述如下。
阈值处理
阈值处理基于阈值生成图像的二值图。评分高于阈值的像素设置为 1,其余设置为 0。
边缘检测
基于边缘的分割检测通过像素亮度的变化来查找对象的边缘。
分水岭
分水岭对图像进行灰度化,并基于映射中的变化确定区域。
基于区域的分割
该技术在图像内使用种子像素,其中像素会扩展以捕获相似像素以进行分割。
基于聚类的分割
聚类算法使用无监督学习(例如 K-means 聚类),基于像素之间的相似特征将像素聚类到不同的 K 类中。
深度学习图像分割技术
我们在下面介绍一些常用方法。
全卷积网络
全卷积网络在由视觉数据馈入的编码器神经网络中具有一系列卷积层。编码器处理输入图像,以提取有用信息并将其浓缩为代表输入各个方面的特征图。它识别分段并对数据进行下采样以消除模糊性。下采样会减少输入图像的空间维度(宽度和高度)。然后,数据通过解码器层进行处理以添加分割标签。
U-Net
U-Net 通过添加直接连接编码器和解码器层的跳跃连接推动了该领域的发展。这些连接减少了下采样时的损失,从而获得更准确的分割水平。U-Net 通过将来自更深层的高级、语义丰富的特征与来自早期层的详细空间信息相结合,可以更好地定位和描绘对象边界。
其他先进的技术
更先进的深度学习图像分割架构类型包括:
-
Mask R-CNN,可识别对象、其边界框和精确像素掩码
-
Transformer,基于转换器模型,类似于自然语言处理架构
-
其他模型,例如 DeepLab、SegNet 等
这些技术的细节超出了本文的范围。
深度学习图像分割的类型有哪些?
深度学习图像分割可分为三大类。
语义分割
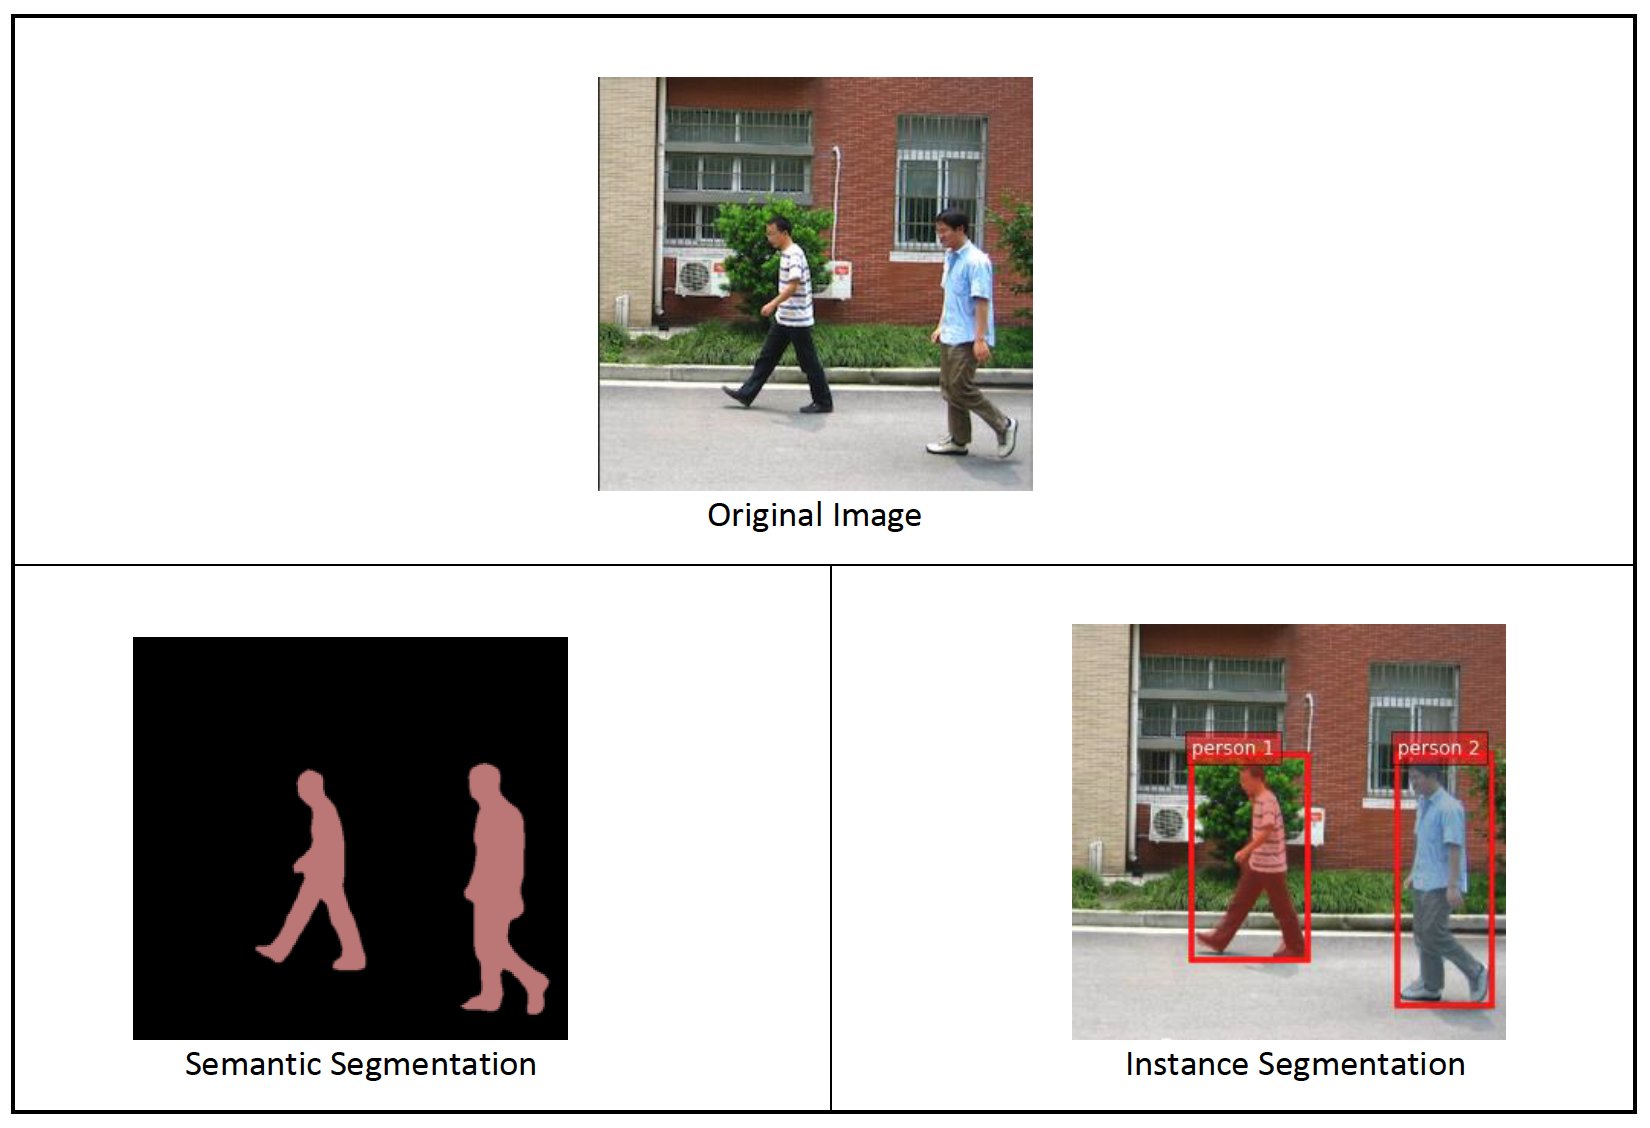
语义分割是一种通过在相同颜色掩码中标记相同语义类别的像素来定义图像中不同对象类别或感兴趣区域的方法。例如,田野场景可能有草地、远处的两棵树、一个人和天空。其中的每一个都将逐像素以不同的颜色着色,以实现图像的完整基于像素的分割。
在语义分割中,除了这些颜色映射的部分之外,没有提供更多上下文;它只是将整个图像分割成这些新的颜色组。对象和背景之间也没有区别;两者都同等报告。
实例分割
实例分割关注的是通过挑选出所有内容来分割图像,即使某些事物部分遮挡了同一类别的其他事物。语义分割为图像的每个像素标记类别,而不考虑对象实例;而实例分割则分别识别特定对象的每个实例。例如,语义分割将人群视为一个整体,而实例分割则围绕不同的人绘制边界。实例分割与对象检测的不同之处在于,它不仅仅给出边界框近似值;它给出场景内所有元素的基于像素的分割边界。
全景分割
全景分割整合了语义分割和实例分割的方面。它使用特征金字塔网络(FPN)并行执行语义分割和实例分割,以捕获多个尺度的特征。每个不同的对象实例通常被赋予唯一标识符,而相似对象(例如所有汽车)共享相同的类别标签,但按实例区分。
图像分割、对象检测和图像分类之间有什么区别?
图像分割、对象检测和图像分类都是计算机视觉活动中涉及的特定图像处理技术。
-
图像分割通过生成基于像素的掩码来显示图像中的不同焦点区域。
-
对象检测识别并标记图像中的对象(例如猫、沙发、人)
-
图像分类对整张图像进行标记(例如,客厅)
这三种图像处理技术告诉机器关于图像的一切。当机器处理和使用这些数据时,它可以像人类一样基于图像做出决策。
AWS 如何支持图像分割?
Amazon SageMaker 是一项全托管服务,它汇集了丰富的工具,能够为各类应用场景提供高性能、低成本的机器学习能力。SageMaker JumpStart 针对多种问题类型提供预训练的开源模型,助您快速上手机器学习。使用 JumpStart API,您可以快速微调并部署来自 MXNet 的已训练图像分割模型。
SageMaker Ground Truth 提供一套最全面的“人机回环”功能,使您能够在机器学习生命周期中利用人类反馈的力量来提高模型的准确性和相关性。您可以使用语义分割标记作业,让人类工作者将图像中的像素分类为预定义标签或类别。Ground Truth 支持单类和多类语义分割标记作业。
某些标记作业任务包含具有许多需要分割的对象的图像。Ground Truth 提供自动分割工具,该工具使用机器学习模型以最少的工作者输入自动分割单个对象。工作者可以查看和完善自动分割的输出,以减少分割时间并提高准确性。
对于寻求完全托管服务的客户,Amazon Rekognition 可帮助您将计算机视觉 API 添加到应用程序中,免除了构建机器学习模型相关的时间和成本。您无需担心图像分割算法,因为您可以在几秒钟内分析数百万张图像和视频。它包括适用于每种计算机视觉应用场景的功能,从内容审核和人脸搜索到视频片段检测和自定义标签。
立即创建免费账户,开始在 AWS 上使用图像分割和计算机视觉。
Browse all cloud computing concepts
Browse all cloud computing concepts content here:
Did you find what you were looking for today?
Let us know so we can improve the quality of the content on our pages