Blog de Amazon Web Services (AWS)
AWS Security Incident Response: El viaje del cliente hacia la aceleración del ciclo de vida de respuesta a incidentes
Jason Hurst, Senior Incident Responder and the Knowledge Manager for AWS CIRT; Christopher Rae, Principal Worldwide Security Specialist at AWS and Nooms Charania, Sr. PMT – ES at AWS Global Services Security.
1 de agosto de 2024: Esta publicación fue republicada para eliminar referencias incorrectas a AWS WAF y Shield.
Introducción
Las organizaciones enfrentan desafíos crecientes en la construcción y mantenimiento de programas efectivos de respuesta a incidentes de seguridad. Estudios de IBM y Morning Consult muestran que los equipos de seguridad enfrentan dos desafíos principales: más del 50 por ciento de las alertas de seguridad no son atendidas debido a limitaciones de recursos y fatiga de alertas, mientras que los falsos positivos consumen el 30 por ciento del tiempo de investigación, retrasando las respuestas a amenazas verdaderamente positivas.
Según el Reporte de Costo de una brecha de Datos 2024 de IBM, las organizaciones ahora toman un promedio de 258 días para identificar y contener eventos de seguridad. El reporte también revela que casi la mitad de los equipos SOC reportan tiempos de detección y respuesta incrementados en los últimos dos años, con el 80 por ciento indicando que la investigación manual de amenazas impacta significativamente sus tiempos de respuesta.
A pesar de estos desafíos, según el Reporte de Referencia de Servicios de Seguridad 2024 de IBM, las organizaciones con capacidades maduras de respuesta a incidentes demuestran una reducción del 50 por ciento en el tiempo medio de resolución (MTTR) y logran ahorros de costos de hasta 58 por ciento por incidente. Estas mejoras son impulsadas por la adopción de flujos de trabajo automatizados, herramientas integradas y procesos de comunicación optimizados que aceleran la detección y contención de amenazas.
En esta publicación, le guiamos a través de un escenario del mundo real para mostrar cómo AWS Security Incident Response puede generar beneficios inmediatos acelerando cada paso de tu ciclo de vida de respuesta a incidentes, cómo se integra con otros servicios nativos de AWS como Amazon GuardDuty, AWS Security Hub y AWS Systems Manager, y cómo integrar hallazgos de detección de amenazas de terceros para inclusión en tus capacidades automatizadas de monitoreo, triage y contención.
Cómo puede ayudar AWS Security Incident Response
AWS Security Incident Response es un servicio de Tier 1 que se lanzó en diciembre de 2024. El servicio es una solución de respuesta a incidentes de seguridad nativa de AWS, construida específicamente para clientes que puede usarse como una experiencia de “mejor-juntos” con otros servicios de AWS en las áreas de detección y respuesta (GuardDuty y Security Hub), y gestión y gobernanza (Systems Manager). AWS Security Incident Response también está integrado con el ecosistema de Partners de AWS mediante un programa de especialización (Partner Specialization program) específico del servicio. Información más detallada está disponible en la documentación de AWS Security Incident Response.
AWS Security Incident Response complementa los servicios existentes mejorando tu postura de seguridad a través de capacidades optimizadas de gestión de incidentes antes, durante y después de eventos de seguridad.
Desafíos clave
AWS Security Incident Response aborda tres desafíos comunes:
- Fatiga de alertas: Puede reducir la fatiga de alertas y acelerar las investigaciones de seguridad a través de monitoreo automatizado y triage inteligente, reduciendo falsos positivos y ayudando a prevenir el agotamiento del equipo de seguridad.
- Acceso fragmentado y comunicaciones: Al simplificar la gestión de permisos de AWS Management Console y unificar las comunicaciones del equipo de respuesta a incidentes, puede resolver problemas de acceso fragmentado.
- Falta de habilidades de seguridad en la nube: Puede cubrir los gaps de habilidades de seguridad en la nube en sus equipos, al proporcionar acceso 24/7 a expertos en seguridad de AWS que brindan soporte en incidentes como compromiso de credenciales, exfiltración de datos y ransomware. AWS Security Incident Response permite a los equipos de seguridad manejar los desafíos de seguridad inmediatos mientras mantienen el enfoque en la preparación estratégica a largo plazo y las mejoras operativas.
Integración del servicio
AWS Security Incident Response complementa e integra con servicios de seguridad de AWS para proporcionar capacidades integrales de respuesta a incidentes. El servicio funciona perfectamente con:
- Servicios de detección: GuardDuty, Security Hub.
- Herramientas de gestión: Systems Manager.
- Soluciones de terceros: A través de integraciones de Security Hub y el programa de Especialización de Partners de AWS Security Incident Response.
Esta integración le ayuda a desarrollar capacidades eficientes de respuesta a incidentes que pueden minimizar el tiempo, el costo y el impacto de los eventos de seguridad a lo largo del recorrido en la nube de su organización, al mismo tiempo que ayuda a reducir las inversiones en personal adicional, capacitación y mantenimiento de herramientas.
Capacidades distintivas
El servicio AWS Security Incident Response ofrece:
- Conocimiento experto del Equipo de ingenieros de Respuesta a Incidentes de AWS (SIRe).
- Herramientas a través de APIs y la consola.
- Procesos optimizados para manejar incidentes de seguridad.
Prerrequisitos
Antes de implementar las capacidades descritas en esta publicación, asegúrese de haber:
- Configurado los permisos apropiados de AWS Identity and Access Management (IAM).
- Establecido los contactos del equipo de respuesta a incidentes.
- Configurado los canales de notificación.
- (OPCIONAL) Habilitado GuardDuty en sus cuentas y Regiones de AWS.
- (OPCIONAL) Habilitado SecurityHub en sus cuentas y Regiones.
- (OPCIONAL) Desplegado los AWS CloudFormation StackSets requeridos para acciones automatizadas.
Estos prerrequisitos ayudan a asegurar que puede hacer uso de detección automatizada, triaje y capacidades de respuesta del servicio.
El servicio provee capacidades automatizadas de monitoreo y análisis dentro de la infraestructura del mismo, habilitando triage automático de findings de GuardDuty y Security Hub.
Para acciones de contención automatizadas en sus cuentas de AWS, usted debe primero desplegar el CloudFormation Stackset y configurar los permisos de IAM apropiados. Esto le ayuda a asegurarse de que usted mantiene control total sobre las acciones automatizadas tomadas en su ambiente, mientras que se beneficia de las capacidades de detección del servicio. Esta automatización puede ser personalizada basada en variables que usted establece, como rangos CIDR conocidos (rangos específicos de IPs que definen su red) e IPs y usted puede implementar suppresion rules en GuardDuty para ayudar a reducir falsos positivos y el volumen de alertas. Como resultado, el servicio puede ayudar como una potente extensión de sus programas y herramientas de respuesta a incidentes de seguridad.
Configurando AWS Security Incident Response
Su administrador de nube, con permisos AWSSecurityIncidentResponseFullAccess, ha establecido el equipo de respuesta a incidentes en el servicio. El servicio notifica a individuos, sus partners o proveedor de servicios de seguridad gestionados (MSSP), y otros contactos agregados al equipo, apoyando una escalación rápida para alertar a las partes requeridas y responder al evento.
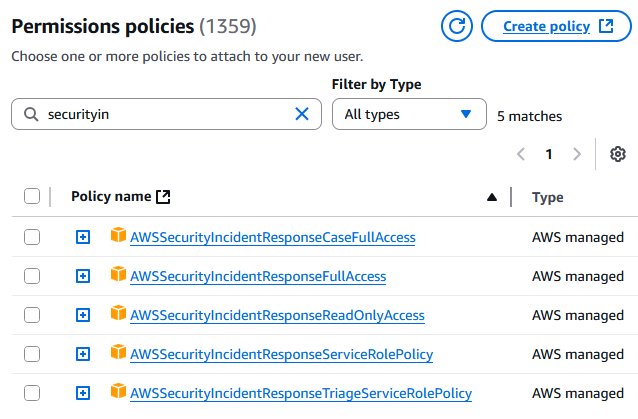
Como mejor práctica, su equipo establece privilegios mínimos para acceder y gestionar información dentro de los casos de AWS Security Incident Response. Esto ayuda a asegurar que los miembros del equipo tengan niveles de acceso apropiados a detalles de casos, hallazgos y datos de investigación mientras mantienen los requisitos de seguridad y cumplimiento. AWS Security Incident Response provee múltiples acciones API, como CreateCaseComment (para agregar comentarios a un caso) y GetCase (para obtener la metadata de un caso), que limitan quién y qué acciones pueden ser ejecutadas en distintos casos. Para ambientes de desarrollo y testing, AWS prove políticas basadas en roles que usted puede usar tal como AWSSecurityIncidentResponseCaseFullAccess y AWSSecurityIncidentResponseReadOnlyAccess para control de acceso basado en roles (como muestra la Figura 1). Para ambientes de producción, recomendamos crear políticas IAM personalizadas siguiendo el principio de privilegio mínimo basado en sus requisitos de seguridad.
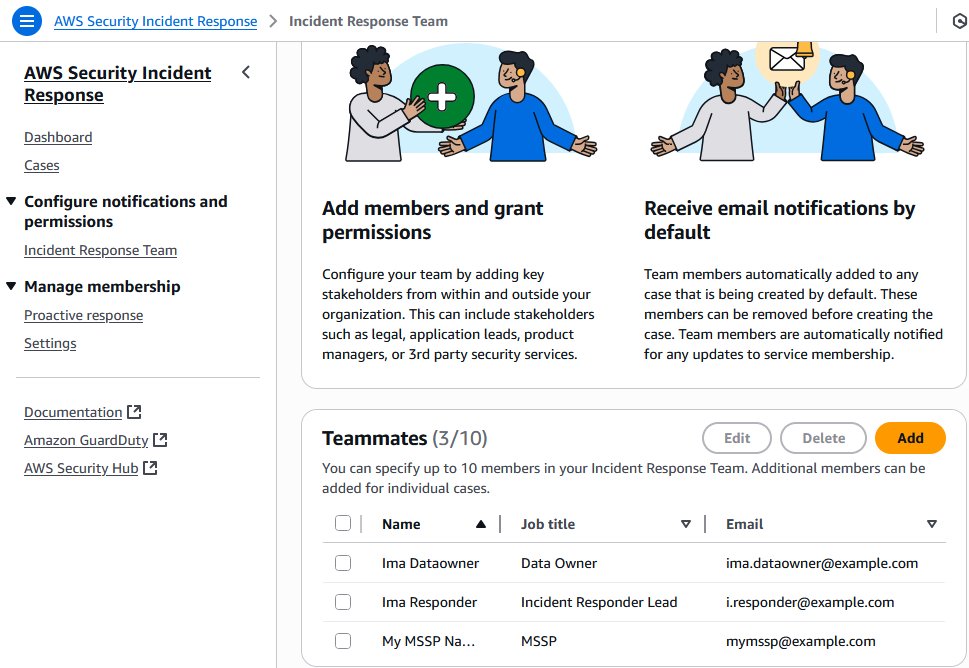
Continuando su configuración de AWS Security Incident Response service, su equipo de seguridad revisa las listas de distribución de mail para notificaciones del servicio, como se muestra en la Figura. Ha desarrollado items en su backlog para sacar provecho de la integración con Amazon EventBridge hacia pager duty, Jira, y otros servicios en el futuro para mecanismos adicionales de notificaciones.
Detectando y respondiendo a actividad sospechosa
A las 2:00 AM, días después de que AWS Security Incident Response ha sido configurado, el servicio detecta una combinación de actividades sospechosas a través de hallazgos de GuardDuty, incluyendo comportamiento anómalo de usuario IAM (como se muestra en la Figura 3) llamadas API inusuales desde direcciones IP desconocidas, y un aumento de creaciones de instancias de Amazon Amazon Elastic Compute Cloud (Amazon EC2) que se desvían de la línea base normal de tu cuenta. Este patrón de actividades coincide con comportamientos de amenazas monitoreadas por GuardDuty Extended Threat Detection. Sin el servicio, los equipos de seguridad necesitarían analizar y correlacionar manualmente estos hallazgos separados en cuentas y regiones. En cambio, el servicio automáticamente identifica el patrón de actividades sospechosas.
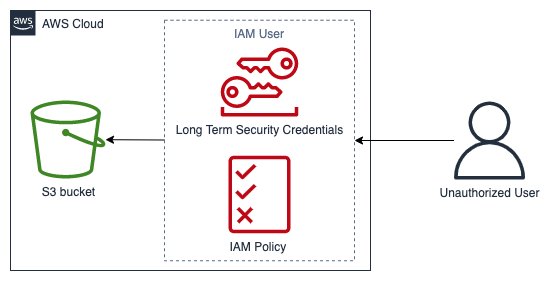
Una de las conductas anómalas es un aumento de creación de instancias EC2 no reconocido, completadas, con SSH keys (credenciales seguras utilizadas para acceso remoto) y configuraciones de security groups (reglas de firewall que controla el tráfico de red) permitiendo conectividad con internet. Usando este escenario de ejemplo, recorramos cómo las capacidades de monitoreo automatizado, triage y contención del servicio, gestión de acceso, acciones API para integraciones personalizadas, herramientas de colaboración y expertos de seguridad de AWS 24/7 trabajan juntos para ayudarle a navegar los desafíos de respuesta a incidentes de seguridad a través de su ambiente AWS.
Cronología de Respuesta a Incidentes
Detección (02:00-02:25) – Alertas de GuardDuty (02:00-02:15) – Análisis automatizado (02:15-02:25)
Investigación (02:25-03:00) – Creación de caso (02:25-02:30) – Notificación del equipo (02:30-02:35) – Evaluación inicial (02:35-03:00)
Respuesta (03:00-04:15) – Participación de AWS SIRe (03:00-03:30) – Etiquetado de recursos (03:30-03:45) – Acciones de contención (03:45-04:15)
Resolución (04:15-06:00) – Eliminación de amenazas (04:15-04:45) – Restauración del servicio (04:45-05:30) – Documentación (05:30-06:00)
Con la detección inicial completa, la próxima fase se enfoca en centralizer y analizar los hallazgos de seguridad para comprender el alcance complete del incidente.
Centralizando hallazgos de seguridad: Un enfoque sistemático
GuardDuty comienza a generar hallazgos en tus Regiones habilitadas.
Nota: GuardDuty debe estar habilitado en sus cuentas y regiones. Para instrucciones de configuración, vea la documentación de GuardDuty.
Debido a que AWS Security Incident Response está integrado con GuardDuty, estos hallazgos se envían automáticamente al servicio para procesamiento interno, análisis y auto-triage sin esfuerzo manual. Las capacidades de triage de alertas y respuesta proactiva del servicio analiza múltiples factores, incluyendo la actividad histórica de base de su cuenta, tipos específicos de hallazgos de GuardDuty, y patrones de correlación entre cuentas. En este caso, identificó actividad de creación de instancias EC2 anómalas que desvió significativamente de los patrones normales de su ambiente.
Cuando el servicio identifica un verdadero positivo, se abre automáticamente un caso de AWS Security Incident Response (vea la Figura 4), resultando en una notificación al equipo de respuesta a incidentes que configuró anteriormente. Un beneficio central es cómo el servicio correlaciona eventos dispares—conectando las creaciones de instancias con las modificaciones de grupos de seguridad—para pintar una imagen completa del evento potencial de seguridad.
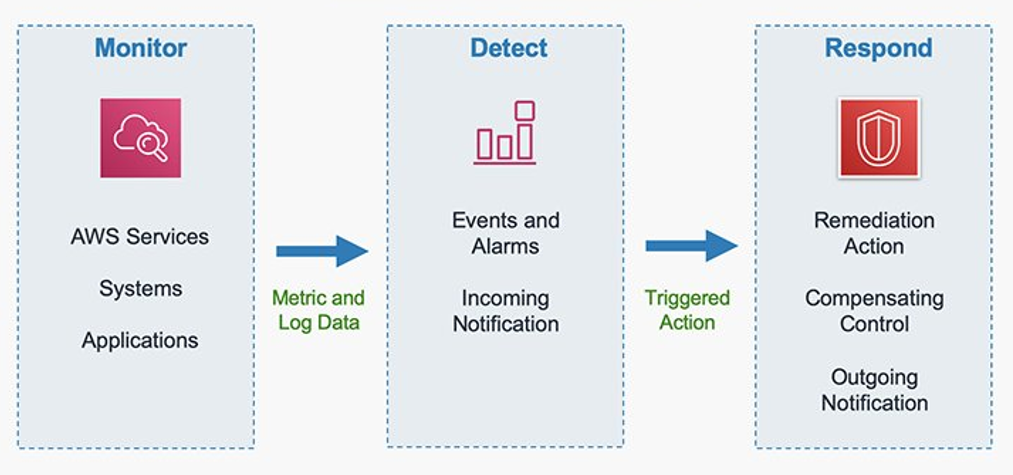
Este monitoreo y análisis proactivo, como se documenta en sus reportes mensuales del servicio, demuestra beneficios tangibles al reducir la fatiga de alertas y proporcionar capacidades de triage inteligente a los equipos SOC todos los días. Las capacidades de análisis y correlación automatizadas del servicio establecen el escenario para una respuesta rápida cuando ocurren eventos de seguridad, lo que significa que su equipo puede enfocarse en iniciativas estratégicas de seguridad en lugar de pasar tiempo investigando manualmente las alertas. La característica del servicio le ayuda a mantener una seguridad sólida de dos maneras:
- Monitoreo integral a través de las Regiones configuradas.
- Integración con herramientas de seguridad de terceros. Este enfoque automatizado reduce el tiempo, costo e impacto de los eventos de seguridad.
A medida que la investigación progresa desde la detección inicial hasta el análisis detallado, la integración con GuardDuty proporciona información crucial sobre los patrones de amenazas.
De detección a acción: La historia de integración con GuardDuty
Mientras su equipo de seguridad responde a los mecanismos de detección interna, AWS Security Incident Response procesa los hallazgos de seguridad en tres pasos clave:
- Analiza las alertas de GuardDuty para identificar amenazas de seguridad genuinas.
- Usando GuardDuty Extended Threat Detection, correlaciona eventos relacionados para identificar patrones de amenazas.
- Rastrea la secuencia de amenazas, desde acciones iniciales (eliminar registros o crear accesos no autorizados) hasta intentos de robo de datos potenciales.
Para este evento, la secuencia comenzó con la eliminación de logs de CloudTrail, seguida por la creación de claves de acceso no autorizadas. A medida que la amenaza progresó, el servicio identificó patrones sospechosos de acceso a objetos de Amazon Simple Storage Service (Amazon S3) e intentos potenciales de exfiltración de datos, junto con técnicas sofisticadas de evasión y mecanismos de persistencia. Cada una de estas señales se mapea directamente a tácticas, técnicas y procedimientos (TTPs) específicos de MITRE ATT&CK®, revelando la naturaleza sistemática de una amenaza potencial de ransomware. Para un mapeo detallado de los hallazgos de AWS Security Incident Response a los marcos MITRE ATT&CK®, consulte Mapping AWS security services to MITRE frameworks for threat detection and mitigation.
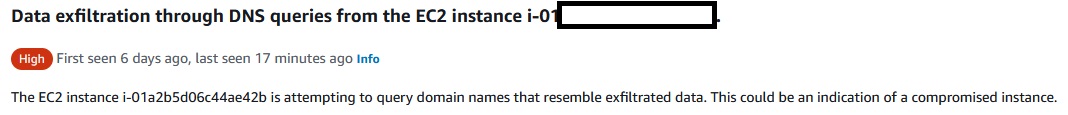
El servicio asiste en la correlación y análisis, evaluando patrones como la eliminación de trails de CloudTrail, creación de nuevas claves de acceso y acciones sospechosas dirigidas a objetos S3. Cuando las capacidades de inteligencia artificial y aprendizaje automático (AI/ML) de GuardDuty detectan estos patrones preocupantes durante períodos de tiempo, el servicio automáticamente eleva la situación creando un caso de AWS Security Incident Response en su nombre, trayendo recursos adicionales y atención enfocada a la situación. El equipo de respuesta a incidentes definido en los pasos anteriores es entonces notificado por correo electrónico u otros métodos (mostrado en la Figura 5) de que un nuevo evento clasificado ha sido creado y para comenzar sus investigaciones.
Los beneficios incluyen que el servicio coordina la comunicación a través de sus cuentas afectadas. En lugar de lidiar con múltiples alertas e intentar determinar el alcance del incidente potencial de ransomware, GuardDuty Extended Threat Detection proporciona una vista integral de la secuencia de amenazas, mientras que el caso de AWS Security Incident Response ofrece un canal único y coherente para el triage de estas señales y proporciona coordinación mientras su equipo global se conecta para unirse al esfuerzo de respuesta.
Figura 5: Mensaje de alerta de incidentes
Ejemplos adicionales e información adicional están disponibles en Introducing Amazon GuardDuty Extended Threat Detection: AI/ML attack sequence identification for enhanced cloud security.
Nota: Por brevedad, los detalles del flujo de trabajo de Security Hub han sido omitidos porque reflejan los procesos de monitoreo y escalación descritos anteriormente para GuardDuty. Ambos servicios se integran estrechamente y comparten patrones operacionales similares, con los hallazgos de GuardDuty siendo enviados a Security Hub dentro de cinco minutos de la detección. Security Hub mejora la cobertura de seguridad agregando hallazgos de múltiples servicios de AWS y partners de terceros.
Con los patrones de amenazas identificados, su equipo se mueve a la siguiente fase—involucrando a AWS SIRe para experiencia especializada y capacidades avanzadas de investigación.
Asociándose con AWS SIRe a través del caso de respuesta a incidentes
Su equipo continúa investigando el evento y descubre que necesitan asistencia adicional. Un usuario autorizado en tu cuenta abre un caso soportado por el servicio para solicitar asistencia de AWS. El caso de AWS Security Incident Response establece un canal de comunicación directo con AWS SIRe con una escalación de un clic del caso dentro de la consola, proporcionando acceso inmediato a experiencia especializada.
Tras la escalación del caso, AWS SIRe se involucra a través del caso de respuesta a incidentes con un marco de tiempo de reconocimiento de 15 minutos, trayendo sus herramientas avanzadas y conocimiento especializado para analizar patrones a través de sus cuentas. Esta colaboración entrega:
- Colaboración en tiempo real a través de llamadas de video de puente de conferencia.
- Análisis avanzado de artefactos y reconocimiento de patrones.
- Orientación técnica para investigación y contención.
- Recomendaciones para mejorar la postura de seguridad.
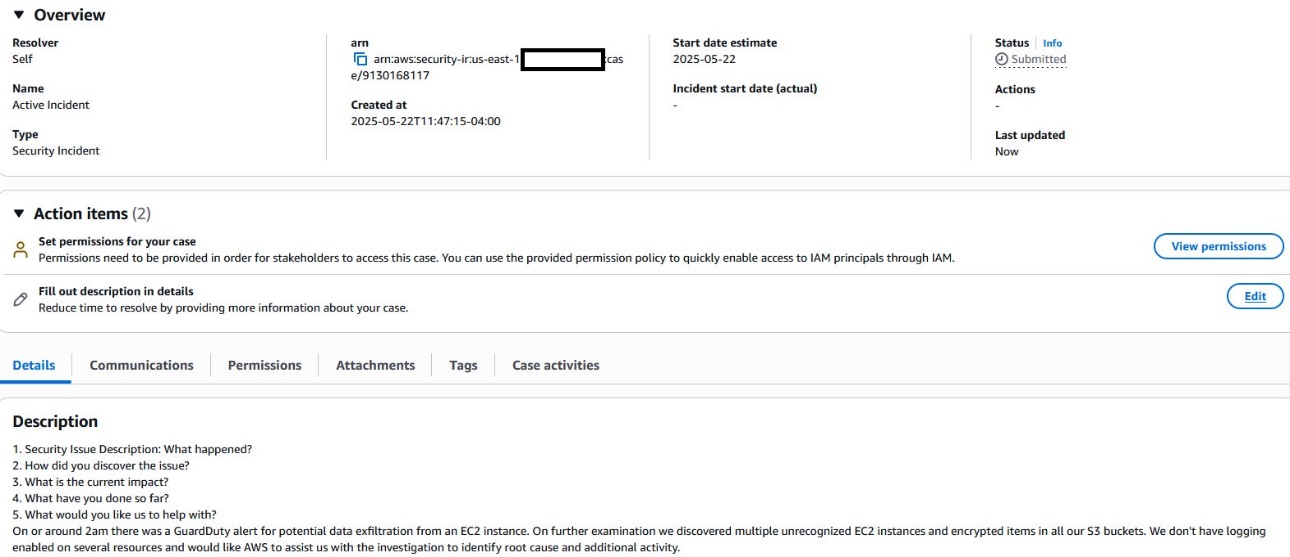
La Figura 6 es un ejemplo de cómo esto aparecería en su cuenta, con el resolutor establecido en Self para un caso auto-gestionado.
Volviendo al escenario, descubre que múltiples cuentas tienen registro insuficiente habilitado—lo que limita los datos de investigación disponibles. Mientras que AWS SIRe puede proporcionar información adicional a través de herramientas especializadas, mantener un registro integral a través de sus cuentas sigue siendo crucial para la visibilidad de seguridad, requisitos de cumplimiento e investigaciones exhaustivas de incidentes. Las capacidades de AWS SIRe complementan—pero no reemplazan—las prácticas apropiadas de registro. Esta capacidad proporciona una comprensión del alcance del incidente, ya que ven patrones y actividades que de otro modo serían invisibles para usted.
La colaboración comienza con AWS SIRe analizando su ambiente mediante sus herramientas, buscando patrones anómalos más allá de lo que ve en sus registros inmediatos. A través del caso de respuesta a incidentes, le ayudan a comprender el alcance de su situación:
- Comunicando sus hallazgos.
- Recomendando rutas adicionales de investigación.
- Compartiendo análisis mostrando patrones similares de creación de instancias EC2 de otros ambientes.
AWS SIRe usa el caso de respuesta a incidentes para establecer una llamada puente, reuniéndose con su equipo para colaboración en tiempo real. Durante estas llamadas, AWS SIRe comparte su análisis continuo de artefactos y datos de servicio, ayudándole a comprender qué sucedió, por qué sucedió y cómo prevenir problemas similares en el futuro. También proporcionan orientación sobre la implementación de registro apropiado a través de sus cuentas para mejorar su postura de seguridad futura.
Gestionando el incidente a través de etiquetado inteligente
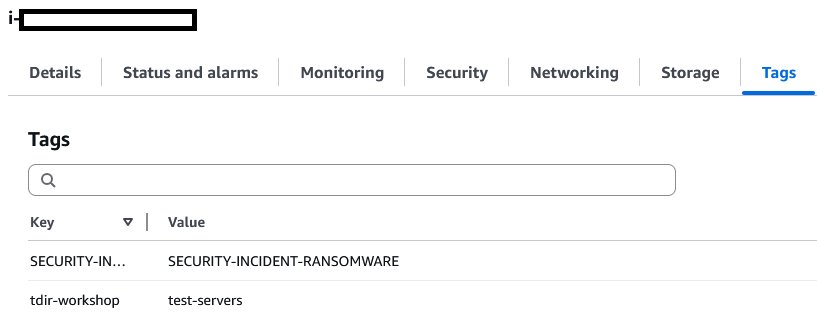
Mientras AWS SIRe comienza su análisis, tu equipo implementa etiquetado de recursos en tiempo real usando el ID del caso de incidente. Este enfoque sistemático de etiquetado resulta crucial para rastrear y gestionar las instancias EC2 sospechosas a través de tus cuentas. Al usar etiquetas, puedes implementar rápidamente políticas de aislamiento y rastrear costos mientras mantienes documentación clara de recursos afectados durante toda la investigación.
Su enfoque basado en etiquetas ayuda a rastrear recursos afectados para implementar políticas de aislamiento. Usó las etiquetas de ID de caso de incidente para identificar rápidamente recursos conectados al incidente, que usa para aplicar controles de acceso dirigidos y medidas de contención. Las etiquetas también le ayudan a rastrear costos asociados con el incidente, dando a su equipo de finanzas visibilidad precisa del impacto financiero del evento.
Trabajando junto con el servicio AWS Security Incident Response, encuentra que usar el ID de caso de incidente como su clave de etiqueta principal (mostrado en la Figura 7) creó una forma consistente de correlacionar recursos a través de cuentas afectadas. Esto resulta especialmente útil al coordinar con AWS SIRe, porque puede dirigirlos rápidamente a recursos específicos que requieren investigación. Incluso después de la contención, estas etiquetas continúan proporcionando valor al apoyar su análisis post-incidente y ayudarle a implementar controles de seguridad dirigidos basados en lo que aprende del incidente.
Opciones de contención automatizada a través de integración con Systems Manager
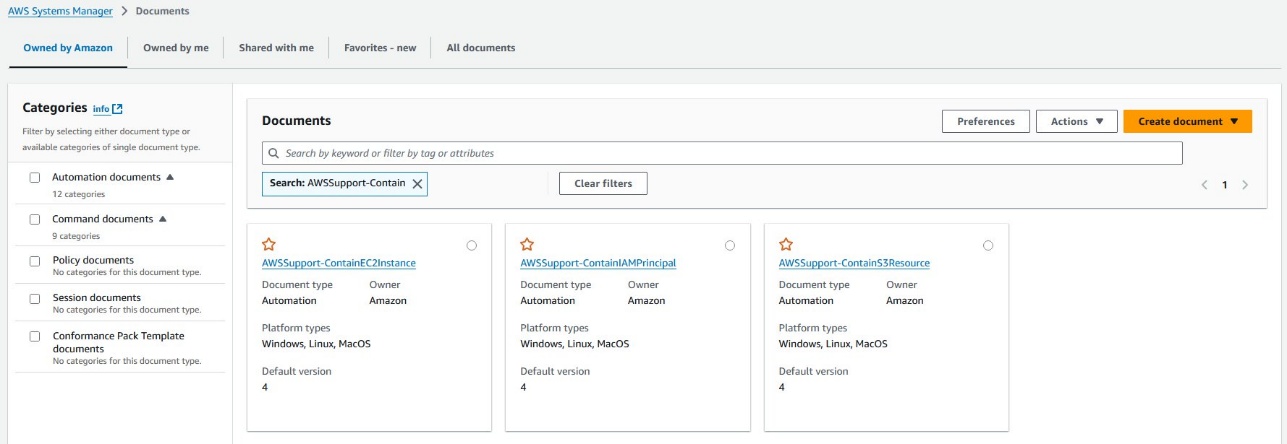
Mientras trabaja con AWS SIRe para entender el alcance del incidente, también puede usar Systems Manager para ayudar a contener automáticamente las amenazas. Su equipo previamente desplegó los CloudFormation StackSets requeridos a través de tu organización, habilitando acciones de contención de Amazon EC2 a través de Systems Manager.
El proceso de configuración requirió desplegar CloudFormation StackSets con roles IAM específicos y configuraciones de Systems Manager a través de sus cuentas. Esta infraestructura permite al servicio AWS Security Incident Response realizar acciones de contención en su nombre. Estas acciones pueden ser revertidas si es necesario—similar a usar una función de deshacer—para que pueda restaurar sistemas a su estado anterior.
Cuando está autorizado a través de tus CloudFormation StackSets pre-desplegados, el servicio AWS Security Incident Response puede solicitar a Systems Manager implementar medidas de contención.
El proceso de contención ocurre en tres pasos:
- Aislar: Remover instancias comprometidas de grupos de seguridad
- Preservar: Crear copias de respaldo (snapshots) de sistemas afectados
- Investigar: Recopilar información del sistema usando Systems Manager
Estas acciones pueden ser revertidas si es necesario, apoyando decisiones de contención para cargas de trabajo legítimas.
Las capacidades de automatización ayudan a optimizar los procedimientos de contención a través de múltiples instancias, reduciendo el tiempo tomado para contener recursos impactados. El servicio mantiene registros detallados de cada acción en el caso de respuesta a incidentes, proporcionando a su equipo visibilidad clara de los esfuerzos de contención.
A través de esta capacidad de respuesta, combinada con la orientación de AWS SIRE, puede contener la propagación del incidente en minutos en lugar de horas. La integración con Systems Manager proporciona una forma confiable de implementar acciones de contención mientras preserva evidencia para investigación (mostrado en la Figura 8).
Resolución y lecciones aprendidas
Mientras el incidente se mueve hacia la resolución, tu equipo trabaja a través de un proceso sistemático para verificar la contención, aliviar amenazas y restaurar servicios. Trabajando junto con AWS SIRe a través del caso de AWS Security Incident Response, implementa un enfoque estructurado para asegurarse de que los recursos afectados estén asegurados y las operaciones normales puedan reanudarse de manera segura. Las acciones de resolución inmediata caen en tres categorías principales:
Confirmación de contención a través de verificación de Systems Manager
- Verificar que las modificaciones de grupos de seguridad estén en su lugar
- Confirmar el aislamiento de red de instancias afectadas
- Validar que las acciones de contención automatizadas fueron exitosas
- Revisar los registros de Systems Manager para la finalización de acciones de contención
Verificación de alivio de amenazas a través de recursos afectados
- Analizar hallazgos de GuardDuty para confirmar que no hay nueva actividad sospechosa
- Revisar recursos etiquetados para contención completa
- Verificar la terminación de intentos de acceso no autorizados
- Confirmar la eliminación de mecanismos de persistencia
- Verificar la eliminación de acceso IAM no autorizado
Restauración del servicio y normalización del control de acceso
- Restaurar el acceso de carga de trabajo legítima basado en líneas base verificadas
- Implementar configuraciones actualizadas de grupos de seguridad
- Restablecer credenciales IAM afectadas y claves de acceso
- Restablecer la conectividad de red normal para recursos limpios verificados
- Actualizar etiquetas de recursos para reflejar el estado post-incidente
Documentación y reportes
Mientras se avanza hacia la resolución del incidente, el servicio AWS Security Incident Response compila una cronología integral del incidente. Esta documentación acelera tu proceso de reportes, ayudándote a generar rápidamente reportes requeridos para ejecutivos, reguladores y proveedores de seguros cibernéticos—todo desde dentro del caso de respuesta a incidentes.
El caso de respuesta a incidentes captura la cronología completa de eventos, comenzando con GuardDuty Extended Threat Detection identificando las secuencias de amenazas iniciales. Cada paso de la respuesta a incidentes está documentado, desde el momento en que se detectaron las creaciones sospechosas de instancias EC2, a través de las tácticas MITRE ATT&CK® observadas, hasta las acciones de contención implementadas a través de la integración con Systems Manager, y finalmente hasta los pasos de resolución que resultaron efectivos.
Mejoras a largo plazo: A través de este proceso colaborativo de revisión post-incidente, su equipo:
- Implementa registro mejorado basado en recomendaciones de AWS SIRE
- Actualiza controles de seguridad para ayudar a prevenir incidentes similares
- Mejora procesos de respuesta a incidentes basados en lecciones aprendidas
- Fortalece su postura de seguridad a través de mejoras dirigidas
Conclusión
Este ejemplo ilustra cómo el servicio AWS Security Incident Response puede mejorar las operaciones de seguridad a través de capacidades automatizadas de detección, triage, contención, acceso y respuesta coordinada. La integración del servicio con AWS Security Hub y Amazon GuardDuty proporciona manejo eficiente de eventos de seguridad, mientras que la escalación opcional al AWS SIRe puede proporcionar experiencia valiosa y herramientas especializadas para ayudar a acelerar cada etapa de tu ciclo de vida de respuesta a incidentes y fortalecer tu postura de seguridad.
El servicio AWS Security Incident Response sirve como un componente crítico de una estrategia integral de operaciones de seguridad, entregando beneficios medibles a través de:
- Monitoreo continuo de amenazas para correlación automatizada y aprendizaje automático
- Tiempos de respuesta a incidentes reducidos
- Capacidades de investigación mejoradas
- Contención optimizada y rápida
- Documentación integral de incidentes y pistas de auditoría
- Ahorros de costos de hasta 58 por ciento por incidente
Para prepararte, responder y recuperarte de incidentes de seguridad más rápido y eficientemente hoy, visita AWS Security Incident Response o contacta a tu equipo de cuenta de AWS para programar una discusión.
Recursos adicionales
Aquí hay algunos recursos adicionales de AWS que tus equipos pueden usar para mejorar aún más tus capacidades de respuesta a incidentes de seguridad:
Antes de un evento:
- AWS Customer Playbook Framework: Marcos de respuesta públicamente disponibles
- Assisted Log Enabler: Una herramienta que asiste a los clientes a habilitar logs
Durante un evento:
- Athena Security Analytics Bootstrap: Una herramienta para configuración rápida de Amazon Athena
Antes o después de un evento:
Traducción del blog original AWS Security Incident Response: The customer’s journey to accelerating the incident response lifecycle.
Autores
 |
Jason Hurst is a Senior Incident Responder and the Knowledge Manager for AWS CIRT. He is passionate about developing others, teaching part-time at a local technical college. Jason has three dogs that entertain him in his spare time. |
 |
Christopher Rae is a Principal Worldwide Security Specialist at AWS, where he drives worldwide business development strategy and implementation to accelerate and scale adoption of AWS security solutions. He is passionate about the intersection of cybersecurity and emerging technologies, with 20+ years of experience in strategic leadership roles delivering security products and services to media, entertainment, and telecommunications customers globally. |
 |
Nooms Charania is a Sr. PMT – ES at AWS Global Services Security, with an MBA from Yale and engineering background from USC. He specializes in technical product management and previously interned with AWS during his MBA program. |
Traductor
 |
Javier Sánchez Navarro es especialista y evangelista de Seguridad en AWS Enterprise Support, enfocado en respuesta a incidentes y estrategia de seguridad. En su rol actual, ayuda a los clientes a evolucionar sus estrategias y a operar de forma eficiente, resiliente y segura en la nube. Es speaker en foros de la industria como SegurInfo y Ekoparty. Javier lleva más de 4 años en AWS y suma más de 15 años en ciberseguridad en distintos roles. Tradujo este artículo al español. |