Amazon Web Services ブログ
100 万回の評価から得られた教訓
本記事は、2026 年 11 月 17 日に Mac Merritt が公開した「Lessons learned from one million evaluations」を翻訳したものです。
コーディングエージェントの評価は、多くの場合、固定されたタスク群を二値の合格率でスコアリングする形で始まります。タスク群は、一般に公開されているものから選ばれます。この方法がうまく機能する場面もありますが、評価として役に立たなくなる問題がいくつか起こり得ます。1 つ目は、エージェントやモデルが改善するにつれて、固定されたタスク群での合格率が上昇することです。残った合格率の差は、エージェントやモデルの性能だけでなく、ベンチマーク自体のノイズによって生じていることもよくあります。これをベンチマークの飽和と呼んでいます。飽和すると、ベンチマークは本来測りたいシグナルを測れなくなります。最近、Kiro に新しいモデルを追加した際に、この状況に直面しました。Terminal Bench 2.1 での合格率は想定どおりでした。Terminal Bench 2.1 が飽和に近づいていることは把握していましたが、大きなリグレッションのリスクであれば、合格率でまだ測れると考えていました。その後、社内のテストユーザーから、新しいモデルの使用感は他のモデルより悪いという声が寄せられ始めました。詳しく調べると、合格率は妥当だったにもかかわらず、一部のツールで呼び出しの 40% が失敗していました。他のモデルでは問題なく動いていたツールの説明が、新しいモデルでは無効な入力でツールを呼び出す原因になっていたのです。
この件は 2 つ目の問題につながります。合格か不合格かというシグナルだけでは、十分でない可能性があります。このケースでは、モデルが試行を繰り返して正しいリクエストの送り方を見つけられたため、合格率には影響しませんでした。しかし、その試行錯誤の間にトークンが消費され、レイテンシーが増え、顧客にとっての全体的な価値は低下しました。顧客の体験は、Kiro がタスクをやり遂げられたかどうかだけでは決まりません。この点が 3 つ目の問題につながります。評価が現実の顧客の体験を代表していない可能性がある、ということです。顧客には、Kiro が高い品質基準でタスクを素早くやり遂げられるという確信が必要です。それを測るには、実際の顧客の体験を反映したベンチマークを実行していることと、その体験に影響し得るすべてのシグナルを追跡していることを確認する必要があります。Kiro では、顧客のために製品を改善する過程で何百万回もの評価を実行してきました。その中で、これらの問題のすべてに遭遇しました。
この記事では、私たちが学んだことと、顧客にとって重要なことを測るために Kiro の評価スイートを現在どのように運用しているかを紹介します。
課題
評価は、エージェント開発に欠かせません。変更に対してモデルがどう応答するかを推論することはできますが、確実に予測することはできません。プロンプト、ツールの説明、あるいはモデル自体に小さな変更を加えるだけで、誰も予想しなかった形で挙動が変わることがあります。確実に知る唯一の方法は、実際のモデルに対して実行することです。だからこそ、経験豊富なエンジニアやサイエンティストでさえ、何がエージェントの性能を高め、何が性能を損なうかについて意見が分かれることがよくあります。たとえば、サブエージェントをいつ、どのように使うか、AGENTS.md ファイルに何を書くべきか、ツールの数はいくつから多すぎるのか、どのような種類のメモリーが有益または有害か、スキルとカスタム MCP ツールのどちらにより重点を置くか、といった点です。そのため、どのトレードオフが顧客の役に立つかを判断できる、信頼できる結果を出す評価が必要です。
多くの評価は、合格か不合格かを判定する固定のシナリオ群です。シナリオは、入手しやすさや人気を理由に選ばれており、必ずしも顧客にとっての価値を明確に反映しているわけではありません。この方式は 3 つの問題を引き起こす可能性があります。1 つ目は、固定のベンチマークが飽和し得ることです。この場合、リグレッションがあってもエージェントはベンチマークを解けてしまいます。そのため、何を改善すべきかについて意味のあるシグナルを見つけにくくなります。2 つ目は、合格か不合格かという粗い採点では、エージェントがタスクをどのように解いたかがわからず、顧客にとって重要なシグナルが隠れてしまうことです。顧客が気にするのは、コスト、Kiro がタスクを実行するのにかかる時間、そしてテスト要件を満たしたかどうかだけにとどまらないコードの品質です。合格というシグナルだけでは、これらの詳細がわかりません。3 つ目は、ベンチマーク自体が顧客にとって重要なシグナルを測定できていない可能性があることです。Terminal Bench は非常に複雑なタスクを完了するエージェントの能力を測定します。一方で、対象とするユースケースに含まれないシグナルは重視されず、十分に反映されません。たとえば、さまざまなプログラミング言語、DevOps のユースケース、コードの理解などです。これらのユースケースは Terminal Bench の中心ではありませんが、Kiro の顧客にとっては重要です。
アプローチ
評価手法を成熟させるには、評価が顧客のユースケースをどの程度反映しているかを測定し、改善するための仕組みを構築する必要がありました。
- 静的なセットから動的なベンチマークへ。目標は、開発者による Kiro の使われ方に合ったシナリオで構成されるベンチマークスイートです。その方法の 1 つとして、Amazon 社内の Kiro ユーザーの利用状況を、集約したカテゴリーで測定しています。利用状況を 20 以上のタスクカテゴリー、25 以上のドメイン、プログラミング言語、セッションあたりのプロンプト数でグループ化し、ベンチマークのシナリオにも同じカテゴリーのラベルを付けています。そして、これらのカテゴリーを 3 つのソースからのシナリオで埋めていきます。自分たちで書いたシナリオ、Amazon の他のチームからのシナリオ、公開ベンチマークです。実際の利用状況と比べてカテゴリー内のシナリオが少ない場合は追加します。こうしたギャップは、どのベンチマークに注力すべきかの優先順位付けにも役立ちます。その結果、利用状況や機能の進化に合わせて定期的に更新する、バージョン管理されたベンチマークスイートができあがります。
- 合格か不合格かから、段階的な判定へ。すべてのベンチマークで、3 つの粒度のレイヤーを追跡しています。合格か不合格かは最初に見る指標で、パフォーマンスの総合的な目安になります。次に、各ベンチマーク実行から、顧客にとって重要だとわかっている出力シグナルを追跡します。最も単純なものはレイテンシーとトークン使用量ですが、場合によっては、コードの複雑さや生成された成果物のサイズの測定値を含めることもあります。最後に、ベンチマークの実行履歴を LLM-as-judge で評価します。対象は、決定論的に測定するのが難しい一方で顧客にとっては重要なシグナルで、たとえばコードの品質や応答のトーンです。これらの領域のいずれかで改善の機会やリグレッションを見つけたら、ベンチマークの詳細な実行履歴を確認します。その指標が想定より悪い理由と、Kiro を改善するための選択肢を把握するためです。ベンチマークの最大の価値の 1 つは、改善案を再テストして、対象としている課題にどれが最も効果的かを判断できる点にあります。
- ライブシグナルで信頼性を築く。静的なベンチマークから動的なベンチマークへ移行する際に使うシグナルは、ベンチマークを顧客のユースケースに近づけるのに役立ちます。それでも、測定している次元の外にある理由で、顧客のペインポイントを見逃す可能性があります。ベンチマークがカテゴリー、ドメイン、言語、タスクの長さ(horizon)の点で顧客と一致していても、顧客の体験を反映していないことがあります。理由としては、ベンチマークが飽和している、カテゴリーの粒度が十分に細かくなかった、シナリオ自体に関連するその他の要因がある、などが考えられます。どのシナリオを実行するかに加えて、ベンチマークをどのように実行するかによっても、顧客のペインポイントを見逃すリスクがあります。モデルの選択、思考レベル、ツールの選択、クライアントの設定などはすべてエージェントの品質に影響します。顧客がこれらを評価では見落としかねない方法で設定している可能性があります。私たちの選定プロセスにより、顧客の体験を代表する可能性が高いベンチマークに焦点を当てられます。しかし最終的には、実際の顧客の体験が信頼できる情報源です。ジェフ・ベゾスはかつて “When the data and the anecdotes disagree, the anecdotes are usually right.”(データと逸話が食い違っているときは、たいてい逸話のほうが正しい)と述べました。ライブシグナルで信頼性を築く背景には、この考え方があります。アンケートや集約した満足度評価のデータと、ユーザーとの対話から得た逸話を使います。社外の顧客へのアンケートや対話も使い、社内ユーザーが同様の体験をしていることを確認します。これにより、評価システム自体を継続的に評価し、データが実際の顧客のシグナルと一致していることを確かめられます。
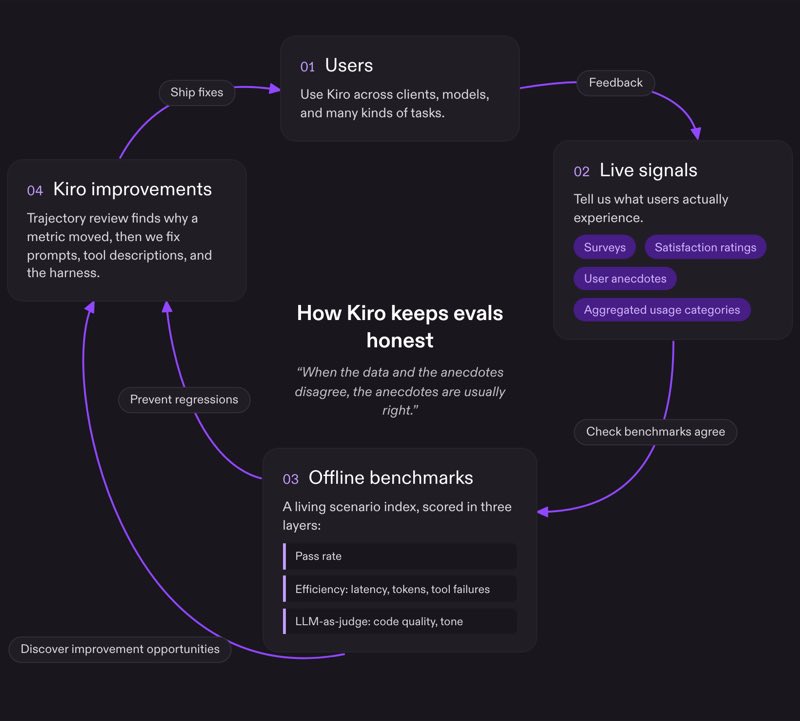
Kiro の評価サイクルを 4 つのステップで示したフローチャート。ユーザーがフィードバックを提供し、ライブシグナルがアンケートと評価を通じてデータを収集し、オフラインベンチマークが 3 つのレイヤーでパフォーマンスを測定し、Kiro の改善が得られた知見に基づいて問題を修正する。
実際の測定
そのモデルのローンチで教訓を得たあと、より体系的なアプローチを適用しました。Kiro を多数のベンチマークのシナリオにわたって測定しました。汚染のリスクを避けるための複数のプライベートベンチマーク、Terminal Bench 4.0、Deep SWE、SWE Marathon などが含まれます。ツールの失敗率、トークン効率、レイテンシーに関する詳細な指標にも注意を払いました。ツールの失敗率のデータは、前述したツールの説明に一貫性がないという問題の解決に役立ちました。効率に関するデータと、より網羅的になった評価セットをもとに、数十件の変更を加えました。これらの変更は機能を改善し、Kiro のハーネスのバグを修正し、顧客のコスト削減に直結する形で効率を高めました。
得られた教訓と今後の研究
利用状況のカテゴリーに合わせたスイートがあっても、適切なシナリオをそこに取り込むのは困難です。成功に見えるシグナルが誤解を招くこともあります。たとえば最近、社内のプルリクエストをベンチマークのシナリオとして検討しました。そのプルリクエストはマージされ、ユーザーはエージェントに 5 つ星を付けていたため、成功したタスクの理想的な例に見えました。ところが、リポジトリの履歴を確認すると、次のコミットで、そのプルリクエストが混入させたバグが修正されていました。これを追加していたら、ベンチマークはバグのあるコードを正解として扱っていたことになります。今後の研究では、ベンチマークのキュレーションをスケールさせることに注力します。5 つ星が付いたのに取り消されたこのプルリクエストのようなシナリオを検出しながら、スイートを更新し続けるためです。
現在のプロセスには、評価中の Kiro の設定による制約もあります。評価は、モデルの選択と Kiro クライアントについて、顧客の使い方に合わせて実行しています。今後の研究では、MCP サーバー、ステアリングファイル、詳細なスキル、コメントが大量に書かれたコードベースといった複雑な顧客の設定で、Kiro がどのように動作するかを調査します。
試してみる、さらに読む
Kiro を試すことができます。この背景にある詳細な手法については、LLM-judge のルーブリック、A/B のセットアップ、測定結果を含め、「継続的なプロンプト評価: LLM ジャッジとライブシグナルを使って Kiro エージェントの品質を高める方法」をお読みください。エージェントが時間とともに本当に改善しているのかという、より大きな問いについては、「AI コーディングエージェントは本当に良くなっているのか?」をお読みください。
翻訳は Solutions Architect の吉村が担当いたしました。