Amazon Web Services ブログ
週 1,000 件の PR でもソフトウェアファクトリーを安定させる方法
本記事は 2026 年 10 月 26 日に公開された Zejiang (Joe) Guo、Bolin Chen、Zezhen Xu による “Keeping a software factory stable at 1,000 PRs a week” を翻訳したものです。
前回の記事では、3 人のエンジニアとエージェントのクルーが 1 週間で 1,000 件のプルリクエストをマージした経緯を紹介しました。これに対して最も多く寄せられた質問は、1,000 件ものマージで全体が壊れないようにするにはどうしているのか、というものでした。しかし、私たちはもっと良い問いがあると考えています。人間は、自分がマージしたすべての PR に責任を持てるのでしょうか。その中には、自分で書いておらず、1 行ずつ読んでもいないコードも含まれます。技術リーダーからそのうちの 1 件について尋ねられたとき、自信を持って説明できるでしょうか。
エージェントはコードの変更を数分で書けるので、速度を出すのは簡単です。難しいのは、その速度で高い品質基準を保つことです。人間がすべての行を読まなくても、それぞれの変更が正しく、安全で、マージする価値があると確認できなければならないからです。
確信はどこから生まれるのか
AI が登場する前から、確信はレビューですべての if/else を読んで承認することだけから生まれていたわけではありません。手動のレビューは必要でしたが、それだけでは不十分でした。そのあとには数多くのテストが続き、たいていは誰かが実環境またはシミュレーション環境で変更を手で動かしていました。確信の源になっていたのはテストです。
ただし、人間によるテストだけでも十分ではありません。人が試せるのは少数のケース、通常はハッピーパスか明らかなエッジケースに限られます。私たち 3 人のエンジニアのうち 1 人は、以前に本番サービスを運用していました。そのサービスでは、入念に手動でテストしたあとでも、すべての変更をリリースパイプラインの自動テストにも通していました。この例から、AI が登場する前から、人間は高い確信を得るために自動テストの仕組みに頼っていたことがわかります。
そのため、「人間は AI が書いたコードにどう責任を持てるのか」という問いは、別の問いに変わります。自分で読むよりも信頼できるほど強力な自動テストとチェックを、どのように構築するか、という問いです。人間にはすべての変更を読めませんが、パイプラインならすべての変更を、毎回、同じ方法でテストできます。そのため、Kiro Crew チームは時間の約 20% を、より多くの作業を自動化するためのインフラに費やしています。
これは「PR を知っている」ことの意味も変えます。誰かから PR 番号を渡されても、私たちは差分を暗唱しません。Crew に尋ねると、1 分で平易な言葉の要約が返ってきます。要約は、コード、スクリーンショットや動画やデータといったテストの証拠、そしてレビュー記録に基づいています。レビュー記録とは、CI(継続的インテグレーション)がすべてのプルリクエストに書き込む記録です。すべてのレビュアーの指摘、それぞれをどう修正したか、または証拠を添えてどう回答したか、すべてのチェック結果、そして最終的な準備完了の判定が含まれます。この記録は、すべての変更が同じレビュー、テスト、ゲートを通過したことを示します。私たちが責任を持つのは、この記録です。
こうして、品質は CI/CD とテストの問題になります。私たちはテストカバレッジを 90% 超に引き上げ、100% の達成を目指しています。テストスイートでのリグレッションを防ぐ仕組みを入れ、さらにエージェントが実際のアプリをユーザーと同じように操作するエージェント型テストも追加しました。
ここに至るまで
品質は、コーディング速度の向上と並行して 5 つの段階を経て高まりました。システム全体を最初から計画していたわけではありません。どの段階も、品質の向上と自動化の拡大という同じ 2 つの目標に向かうもので、1 つの問題を解決すると次の問題が見えてくることがほとんどでした。どの段階もまだ完成しておらず、毎週改善を続けています。実際のコードベースでコーディングエージェントを運用する場合、同じ壁に同じ順番で突き当たる可能性が高いでしょう。
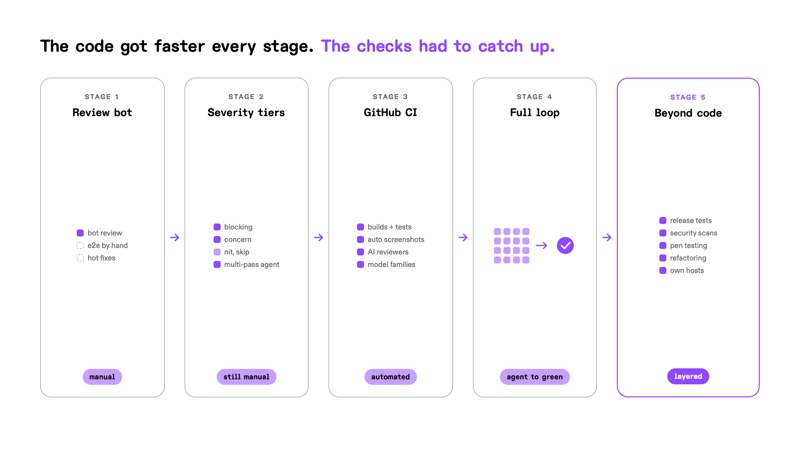
図 1: 各段階で、コードの高速化に歩調を合わせるようチェックを追加した。
段階に入る前: 人間によるレビュー
3 月上旬、チームは基本的なコードレビューの仕組みを整え、すべての変更を手作業でレビューしようとしました。この方法は 1 日も続きませんでした。当時の Kiro Crew はまだサイドプロジェクトで、変更の数ははるかに少なかったのですが、それでも人間によるレビューでは手に負えませんでした。このため、レビューを自動化せざるを得なくなりました。
ステージ 1: 自動化されたレビュアー、人間によるパイプライン
Kiro Crew は、すべての変更に対して自動レビューボットを実行する社内のビルド・レビューシステム上でスタートしました。そこで、AI のコメントは優先度にかかわらず、マージ前にすべて解決しなければならないという厳格なルールを追加しました。このルールは品質を高めそうに聞こえましたが、実際には作業の妨げになり、すぐに 3 つの問題が生じました。
- 実際のエンドツーエンドテストがない。パイプラインには Kiro Crew のエンドツーエンドテストがなく、プロダクトを実際に使う工程もなかったため、すべてのコメントを解決したあとでも、変更によってアプリが壊れる可能性がありました。人間がすべてを手動でテストし、証拠としてスクリーンショットを添付する必要があり、すり抜けた不具合はホットフィックスとして戻ってきました。
- コメントがラウンドごとに届く。5 件のコメントを修正してプッシュすると、手を加えていないコードに対して新たに 4 件のコメントが付き、さらに 3 件が続きます。すべてのコメントを解決する必要があるため、小さな変更でもやり取りに丸 1 日かかることがありました。さらに、追加のチェックやコードパスのように、修正のたびに新しいコードが加わることが多く、それ自体にもコメントが付きました。小さな修正が、誰も想定していなかったほど大きな変更に膨らむこともありました。
- レビュアーを制御しにくい。独自のルールは追加できましたが、ルールが発動したかどうか、その理由、見逃した理由を確認できませんでした。こうしたフィードバックがなければ、繰り返し遭遇する問題に合わせてレビュアーを調整できませんでした。
私たちの学びです。厳格なルールが役に立つのは、レビュアーが網羅的で調整可能なフィードバックを返す場合に限られます。変更を実際のプロダクトでエンドツーエンドにテストすることも必要です。この 2 つがなければ、レビューは空回りするだけで、本物のバグはそれでもユーザーに届いてしまいます。
ステージ 2: 重大度のティアと 2 人目のレビュアー
最初に、コメントを重大度でティア分けしました。ブロッキングの指摘と本物の懸念は、同じ PR で修正する必要があります。軽微なコメントやスタイルの nit は、今後の PR に向けたフォローアップの課題にします。これにより各 PR が小さく保たれ、レビューは目の前の変更に集中できます。
ティア分けは基準を下げているように見えかねず、修正のたびに新しいコメントが付くループも止められません。そこで、既存のボットとは別に、独自のレビューエージェントも追加しました。このエージェントは変更を複数のパスでスキャンし、各パスには前のパスで見つかった内容を飛ばすよう指示します。目的は、本物のコメントを 1 回のラウンドですべて出し切り、コントリビューターが何度もではなく 1 回の修正で済むようにすることです。この段階でレビューを丁寧に読み込んだことで、驚いた点もありました。AI レビュアーは、人間の読み手が通常は見つけられないような、より深い問題を見つけていたのです。この発見を踏まえて、コードを 1 行ずつ手動でレビューするのをやめると決めました。
追加した AI レビュアーは役に立ちましたが、修正の各ラウンドを動かすのは依然として人間でした。ローカルで動く Crew はレビューコメントに基づいて実際の修正を行えますが、オンラインのレビューのために更新したコードをプッシュするのは人間で、その後しばらく待って新しいコメントをローカルの Crew に持ち帰り、次の修正に進みます。この過程は複数のラウンドに及び、長い時間がかかります。何回かループを繰り返したあとで、この面倒な手順を理由にコントリビューションをやめてしまう人もいました。このギャップを埋めるために、誰でもテストと、オンラインと同じ AI レビューをローカルで実行できる組み込みスキルを提供しました。これにより、PR を送る前に、ローカルマシン上で必要なコメントを受け取ってすばやく修正できます。
私たちの学びです。厳格なレビューは良いソフトウェアを作る助けになりますが、人間が動かす長いループはコントリビューターを遠ざけかねません。解決策は自動化ですが、その自動化を実行するための CI がまだありませんでした。
ステージ 3: オープンソース化、本格的な CI、多数のレビュアー
Kiro Crew を GitHub に移したことで、オープンソースプロジェクトとして強力な CI/CD のサポートを得られました。すべてのプルリクエストに対して、ビルド、ユニットテスト、エンドツーエンドテストが自動的に実行されるようになりました。Kiro Crew に組み込まれたテストポッドは、更新されたコードを分離された環境で実行し、関連する機能のスクリーンショットや動画を撮影して、プルリクエストに添付します。以前はエンジニアの午後を丸ごと費やしていた作業が、すべての変更で自動的に実行されます。CI が自動化されたので、はるかに充実したチェックを追加できるようになりました。
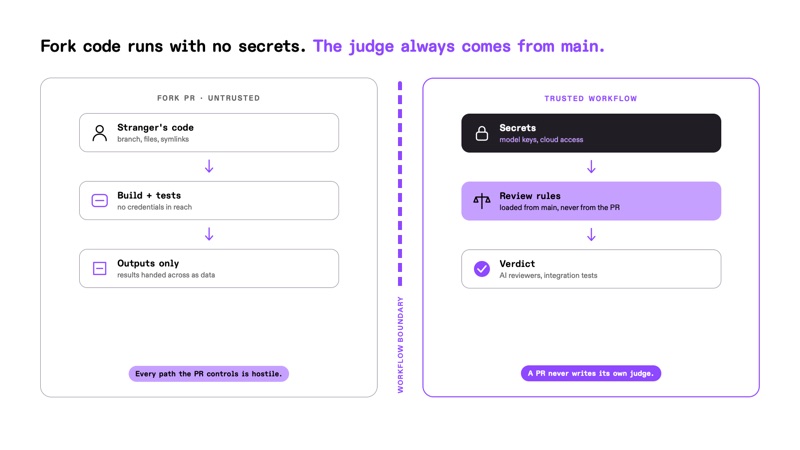
図 2: 信頼されないフォークのコードと、信頼されたレビューワークフローは、境界を挟んで反対側で実行される。
役割の異なるレビュアー。1 人の AI レビュアーがすべてを見るだけでは、十分に深く掘り下げられません。そこで、役割ごとにレビューを分けました。設計レビュアーは、変更がアーキテクチャに適合しているか、はるかにシンプルな解決策がないかを問います。第一原理レビュアーは、変更が根本原因を修正しているか、ユーザーが本当に必要としているかを問います。UX レビュアーは、ユーザーに見える変更を評価します。コードは、異なるモデルファミリーのレビュアーによってもスキャンされます。あるモデルが同じファミリーのコードをレビューすると、盲点を共有してしまうからです。
完全なテストセット。ユニットテスト、統合テスト、フロントエンドテスト、デスクトップのパッケージング、バンドルサイズの予算、カバレッジの下限、エンドツーエンドテストは、それぞれ異なる種類の障害を検出します。エージェントが最も間違えやすいのは統合の部分です。個々の変更を単体で見ると、どれも正しく見えるからです。
ブロッキングの単一の定義。ブロッキングの指摘には、具体的な場所、引用した証拠、発生条件、結果が必要です。レビュアーが何がどのように壊れるのかを説明できない場合、その指摘は参考意見として扱います。具体的には、設計上の懸念は、one-way door、つまり後から元に戻せない選択を示すものでない限り、参考意見です。元に戻せる選択であれば、後でリファクタリングするのも簡単なので、そのリスクは受け入れます。
私たちの学びです。自動化によって、人間にはとてもできない量のチェックが可能になります。しかしチェックが増えると、人間が読んで対応しなければならない結果も増え、人間がボトルネックになりました。
ステージ 4: ループを閉じる
ステージ 3 では、コード修正の各ラウンドを依然として人間が動かしていました。ラウンドごとに、エンジニアがどの CI ステップが失敗したかを確認し、AI レビューの提案を含む CI の失敗内容を Crew にコピーして、問題の修正を依頼します。私たちは AI の提案を、信頼しなければならないものとしてではなく、ローカルでより深く分析するための入力として扱っています。Kiro Crew は提案をコードと照らして確認し、テストを実行し、次のラウンドで CI が修正を再度チェックします。各修正の裏にあるこうした追加の作業と比べると、人間がすべての判断を下しても付加価値はほとんどありませんでした。
そこで、プルリクエストがグリーンになるまでループを回す組み込みスキル prepare-pr を提供しました。このスキルには、読み取るべき明確なシグナルが 1 つ必要でした。すべてのプルリクエストで 80 件以上のチェックをスキャンするのはコストがかかるからです。そこで、すべての CI/CD アクションの結果を 1 つの判定にまとめる PR Readiness チェックを 1 つ追加しました。この判定は、まだ赤いものがないというだけでなく、期待されるすべての CI/CD アクションが実行されて成功したことを意味していなければなりません。新しいプルリクエストでは、「失敗しているチェックがない」と「まだ何も実行されていない」が同じに見えるからです。
prepare-pr はその判定を読み取り、失敗している CI/CD アクションとレビューの指摘を取得して、本物の問題を修正し、そうでないものには証拠を添えて返信し、再びプッシュします。CI が新しいリビジョンをチェックし、ループがその結果を読み取ります。判定がグリーンになるとスキルは停止し、同じ判定が、プルリクエストの準備ができたことを人間に伝えます。人間とエージェントは、「完了」について 1 つの定義を共有しています。
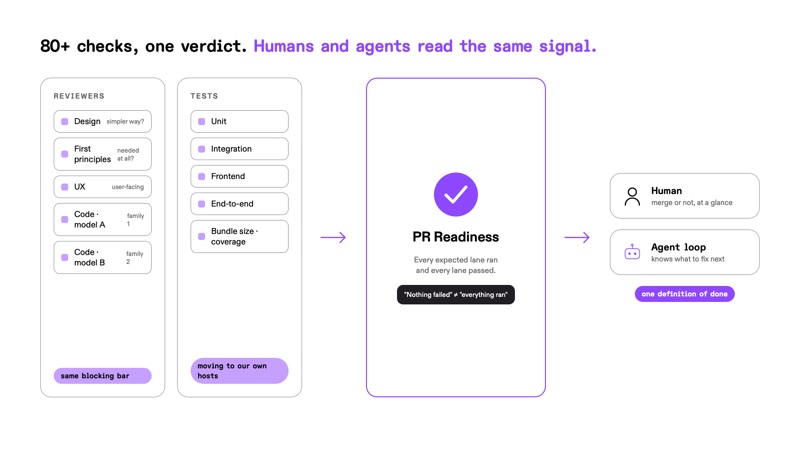
図 3: すべてのレビュアーとテストが、1 つの PR Readiness 判定に集約される。
エージェントがプルリクエストを自動的にグリーンにするようになると、PR の数が多い場合には、承認ボタンを押す作業に時間がかかるようになりました。この手順を自動化するために、まず各プルリクエストをティアで分類します。単純なティアの PR は自動的に承認されてマージされ、それ以外については、AI が人間向けのレビュー提案の下書きを作成します。人間のレビューを速くするために、エージェントはプルリクエストの説明文を書き、実際のコードの変更に合わせて毎回書き直します。説明文には固定のテンプレート、わかりやすい言葉、さらには変更に関連する図も使うので、人間は数秒でプルリクエストを理解できます。説明文がコードと厳密に一致していることを検証する CI チェックもあります。
私たちの学びです。チェックと修正が 1 つのシグナルを共有すれば、エージェントがループを回せるようになり、人間は必要な判断だけを下せば済みます。ただし、このループにも固有の問題があります。主に、過剰なエンジニアリングと、行き過ぎたセキュリティ修正です。この 2 つについては、最後のステージのあとで取り上げます。
ステージ 5: マージ後のこと
私たちのコードレビューは、それでも一部のバグを見逃します。そのため、コードのマージは最後のステップではありません。全体的な品質は、通常、1 つのプルリクエストに含まれるコードだけで決まるものではありません。
リリースゲート
各リリースの前に、ビルドしたプロダクトに対して、エージェント型テストを含む追加のテストを実行します。エージェントが実際のアプリをインストールし、セッションの開始、タスクの実行、メモリの利用、ジョブのスケジュールといったコアフローを操作します。ユニットテストは特定の機能が動作することを確認し、エージェント型テストはプロダクトの中核となる手順がユーザーの期待どおりに動作し続けていることを確認します。
マージ後のセキュリティ
マージされたコードは複数の層で継続的にチェックされるので、1 つの層をすり抜けた問題が長く残ることはありません。
- マージされたコードが必要なレビューを経ており、コアのセキュリティルールに従っているかを、1 時間ごとに確認するコンプライアンスチェック。
- 社内のセキュリティエージェントによる日次スキャン。他の社内サービスと同様に、私たちのオープンソースコードベースにも適用されます。
- ツールに対して実際の操作を実行し、セキュリティのガードレールの突破を試みて、修正すべき問題を見つける常時稼働のセキュリティボット。
- 外部からの報告を迅速な対応で受け付ける、マネージドのセキュリティ受信箱。
定期的なリファクタリング
変更が速いと、大きなファイル、重複したロジック、デッドコードといった粗が残ります。人間とエージェントの両方がコードベースを変更しやすい状態を保つため、定期的にリファクタリングしています。また、定期的にリファクタリングしておくと、最新のモデルでより良いコードを書けます。
チェック自体のスケーリング
すべてのプルリクエストに数十の自動チェックがあり、1 日に 100 件のプルリクエストが出ると、GitHub のレート制限と自社のリソース上限に達しました。この問題を緩和するために、CI アクションをグループに分け、グループごとに実行しています。たとえば、現在は高速なゲートが先に軽いチェックを実行し、低速なチェックは高速なゲートを通過してから開始します。また、レビューを AWS CodeCommit に、一部のテストワークロードを自社のホストに移し、上限を自社のハードウェアで決められるようにしました。
開発プロセス
コードを書くのが簡単なら、機能に「はい」と言うのも簡単です。しかし、あまりに多くの機能を一度にマージすると、気づかないうちに予期しない競合が起きやすくなります。コードを書くコストが低いと、チームが正しい作り方に集中せず、技術的に凝った解決策に引き寄せられることもあります。この問題に対処するため、すべての機能リクエストは、誰かが作り始める前に分類されるようになりました。単純な変更はそのまま作り、中程度の機能は 1 ページの設計書が必要で、複雑なものはチーム全体でのレビューが必要です。
私たちの学びです。マージ前にすべてのチェックを通過することと、長期にわたって健全であり続けることは同じではありません。品質には、プロダクトのコードに対して実行され続けるチェックが必要です。どの機能を作るかを決めるプロセスも必要です。最も高くつくバグは、ユーザーが必要としない機能から生まれるものだからです。
乗り越える必要があった 2 つの重大な問題
過剰なエンジニアリング
過剰なエンジニアリングは、レビューと修正のループが自律的に回り始めると、無駄の最大の原因になります。レビュアーがエッジケースを指摘すると、エージェントは仕組みを追加します。次のレビューで、その新しい仕組みのエッジケースが指摘されると、エージェントはさらに別の仕組みを追加します。5 ラウンドを経ると、10 行の修正が、必要のなかった小さなサブシステムに変わっています。
そこで、prepare-pr スキルと CI の両方に振り返りを追加しました。同じ領域で何ラウンドか繰り返すと、ループは自身の履歴を振り返ります。何が変わったのか、レビュアーが何を言ったのか、そして変更が収束せずに拡大していないか、という点です。そのうえで、停止、リバート、よりシンプルな方法のいずれかを推奨します。最初の一手は、多くの場合、不要になった仕組みを取り除くことで、残りの指摘も減っていきます。
提案された修正が適切な規模かどうかも、すべてチェックします。指摘が正しくても、求めすぎている場合があります。修正は、プルリクエストの説明に書かれた問題を解決する直接的なコード変更にとどめ、それより大きなものはフォローアップにします。唯一の例外は、到達可能なクラッシュ、セキュリティホール、データ損失で、これらは常に修正します。
しかし、振り返りは新たな問題も生みました。コーディング戦略をどう変えるかを決めるのに人間の操作が必要になったのです。戦略の推奨内容は、たいてい明確であるにもかかわらずです。人間の入力を増やすことが、より高品質なコードを得る最善の方法に思えるかもしれませんが、質問のたびに自動化は止まります。この問題に対処するため、2 つ目のエージェントであるコンダクターが、振り返りの推奨内容を読み、最初の判断を自分で下します。コンダクターが決められない場合にのみ、人間が呼び出されます。
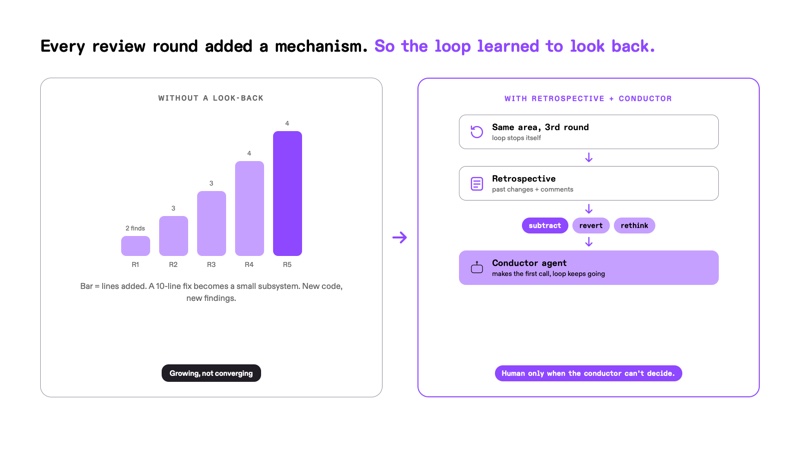
図 4: 振り返りとコンダクターエージェントにより、レビューのループが修正をサブシステムに肥大化させるのを防ぐ。
セキュリティに関する考慮事項
AI はセキュリティに熱心です。1 つの本物の指摘を受けると、3 層の防御、新しい設定フラグ、そして一度も実行されない検証ステップを追加します。追加はどれも壊れる可能性のある新しいコードであり、次のレビューのラウンドで指摘される新たな対象にもなります。以下は、私たちの開発中に見つかった興味深い 2 つの事例です。
- 通常の作業をブロックするサンドボックス。レビューのラウンドごとに、エージェントのサンドボックスが少しずつ厳しくなりました。個々の変更は単独では妥当に見えましたが、合わさると、ビルドの実行やプロジェクトファイルの読み取りといった通常のタスクが失敗するようになりました。プロダクトは書類上は安全になりましたが、実際には使えなくなったのです。
- すでに勝利した攻撃者への対策。典型的なセキュリティの提案に、実行ファイルを専用のフォルダーにコピーしてロックダウンし、マシン上の攻撃者に差し替えられないようにする、というものがあります。この対策はコピー、権限チェック、更新パスを追加しますが、そのどれもが壊れる可能性があり、守れるのはきわめてまれなケースだけです。
そこで、私たちのセキュリティ修正は単純なルールに従っています。ユーザーが実際に到達できる問題を、最小限のコード変更で修正する、というものです。
今日から適用できること
以下は私たちのチームで効果があった提案ですが、コードベースはそれぞれ異なるため、自分のプロダクトで機能するように調整してください。
- レビューコメントをティア分けする。「すべてのコメントを解決する」は厳格に聞こえますが、空回りを生むことが多くあります。
- すべてのコメントを 1 回のラウンドで求める。時間はかかっても網羅的なレビュアーのほうが、指摘をラウンドごとに小出しにするレビュアーよりコストが低くなります。
- レビュアーを役割とモデルで分ける。問いやモデルファミリーが異なれば、見つかる問題も異なります。
- チェックを 1 つの準備完了フラグにまとめる。このフラグは「まだ失敗したものはない」ではなく、「すべて実行されて成功した」を意味します。
- 部分だけでなく、プロダクト全体をテストする。リリース前に、実際のフローを操作するステップを少なくとも 1 つ入れます。
- エージェントのループに振り返りを組み込む。2 つ目のエージェントに最初の判断を任せれば、一時停止のたびに人間が必要になることはありません。
- セキュリティ修正は妥当な範囲にとどめる。厳格なチェックで実際の問題を明らかにし、修正は小さく直接的なものにします。
Kiro Crew はオープンソースです。ここで説明したワークフロー、レビューのプロンプト、prepare-pr スキルは、すべて GitHub のリポジトリにあります。Crew を試して、実際の動作を確認してください。
翻訳は Solutions Architect の吉村が担当いたしました。