Lambda Durable Functions で、途中で落ちても続く SAGA を書く
2026-11-04 | Author : 三浦 一樹 (AWS Community Hero)
はじめに
札幌在住の AWS Community Hero の三浦です。
2025 年 12 月に AWS Lambda Durable Functions (以下、Durable Functions) が登場しました。長く走る処理を、途中でチェックポイントしながらふつうのコードとして書ける仕組みです。
以前、SAGA パターン (途中で失敗したら、それまでに済ませた処理を取り消していくやり方) を AWS Step Functions で実装したことがあり、同じものを Durable Functions で書くとどうなるのかなーと気になっていました。そこで、少し込み入った例で実際に手を動かしてみることにします。
題材は、2 日間開催の野外フェスの有料ライブ配信です。開演当日の朝から配信リソースを押さえ、視聴ページを公開し、外部の配信先にも「配信します」と連絡して準備を進めます。ところが落雷を伴う激しい雨が続き、開演の直前に中止が決まった、という場面を考えます。半ば作り物の設定ですが、Durable Functions の挙動を見るための前提として置いています。
中止が決まったら、まずは当日に済ませた準備を巻き戻します。配信先へ中止を連絡し、視聴ページを閉じ、押さえたリソースを解放します。
こうした「成功した操作を逆順に打ち消していく」流れが、SAGA パターンです。
この処理は、ふつうの Lambda 関数だと少し書きにくいです。準備を済ませてから開演の判断まで何時間も待つ必要がありますし、巻き戻しの途中で関数が落ちたら、どこまで済んだのかを自分で覚えておく必要があります。
Durable Functions なら、待っているあいだは関数を止めておけて、落ちても続きから進められます。
この記事では、この巻き戻しを Durable Functions で書いて、巻き戻しの途中でわざと関数を落としてみます。確かめるのは次の 3 つです。
- 本当に続きから進むのか
- 中止連絡が二重に飛ばないのか
- 補償そのものが失敗したときに、中止を中止のまま扱えるのか
実際に ap-northeast-1 で動かして確認しましたが、同じことを AWS を使わないローカルテストでも数秒で確かめられるようにしてあります。
サンプル一式は GitHub リポジトリ に置いてあります。
本記事は AWS Community Hero 個人としての検証と見解であり、AWS の公式見解やサービス推奨ではありません。
ご注意
本記事で紹介する AWS サービスを起動する際には、料金がかかります。builders.flash メールメンバー特典の、クラウドレシピ向けクレジットコードプレゼントの入手をお勧めします。また、試し終えたら忘れずに後片付けをしていただくようお勧めします。
builders.flash メールメンバー登録
builders.flash メールメンバー登録で、毎月の最新アップデート情報とともに、AWS を無料でお試しいただけるクレジットコードを受け取ることができます。
SAGA と Durable Functions のしくみ
複数のサービスにまたがる処理を、全部成功か全部取り消しにしたい場面はよくあります。ただ、サービスをまたぐと、1 つのデータベースのトランザクションのようにまとめて取り消すことはできません。
今回の外部の配信先も他社のシステムです。「配信します」の連絡は、届いた時点で向こうの番組表や告知に反映されてしまうので、こちらの都合で無かったことにはできず、後から「中止します」と連絡して打ち消すしかありません。
SAGA は、こうした操作の一つひとつに、後から打ち消す操作 (補償) をペアで用意しておいて、長く続く処理を組み立てる考え方です (1987 年の Garcia-Molina & Salem の論文が出どころです)。用意した補償は、途中で中止や失敗が起きたときに、成功済みのぶんだけを逆順に実行していきます。
逆に、ある地点を越えたら戻さずにやり切る、という境目もあって、これをピボットと呼びます。
今回は、正常系の最後のステップの「配信開始」がピボットです。
リソース確保から公開までの流れ
Durable Functions では、ハンドラを SDK の withDurableExecution で包み、副作用のある処理を context.step で区切って書きます。 この記事では、処理の 1 単位をステップ、SDK の context.step を指すときは step と書き分けます。
export const handler = withDurableExecution(async (event, context) => {
  const slot = await context.step("reserve", async () => reserve(event.id));
  await context.wait("cool_down", { seconds: 60 });  // このあいだ、関数は止まっている
  await context.step("open", async () => open(event.id, slot));
});
ふつうの Lambda 関数との違いは、1 回の実行 (durable execution。以下、実行) が、1 回の Lambda 呼び出し (以下、invocation) で終わるとは限らないところです。
- チェックポイント : context.step が成功すると、その結果が保存されます。
- リプレイ : wait やコールバック待ちで一時停止したあとや、途中で落ちたあとは、新しい invocation でハンドラが先頭から実行し直されます。完了済みの step は本体を実行せず、保存した結果をそのまま返すので、処理は実質的に続きから進みます。
- 長く待てる : 実行全体のタイムアウトは invocation の 15 分とは別に設定でき、非同期で起動すれば 1 年まで延ばせます。待っているあいだは関数が止まっているので、(オンデマンドの関数なら) 実行時間の課金はありません (Durable Functions の操作の数や、保存するデータには別に課金されます)。
この仕組みから、書き方のルールが 2 つ出てきます。
- step の外側のコードはリプレイのたびにもう一度走るので、毎回同じ順で同じ結果になるように書き、副作用は step の中に閉じ込めます。
- step は既定で at-least-once (最低 1 回は実行される。SDK の設定名は AtLeastOncePerRetry) です。副作用を起こしたあと、結果を保存する前に落ちると、再開後に step の本体がもう一度実行され得ます。
今回の中止シナリオ
サンプルでは、開演当日の朝に公演日ごとに 1 つ Durable Functions の実行を起動します。実行は当日の準備を済ませたあと、開演まで主催者の判断を待ちます。中止が決まると、その判断がこの待っている実行にコールバックで届きます。
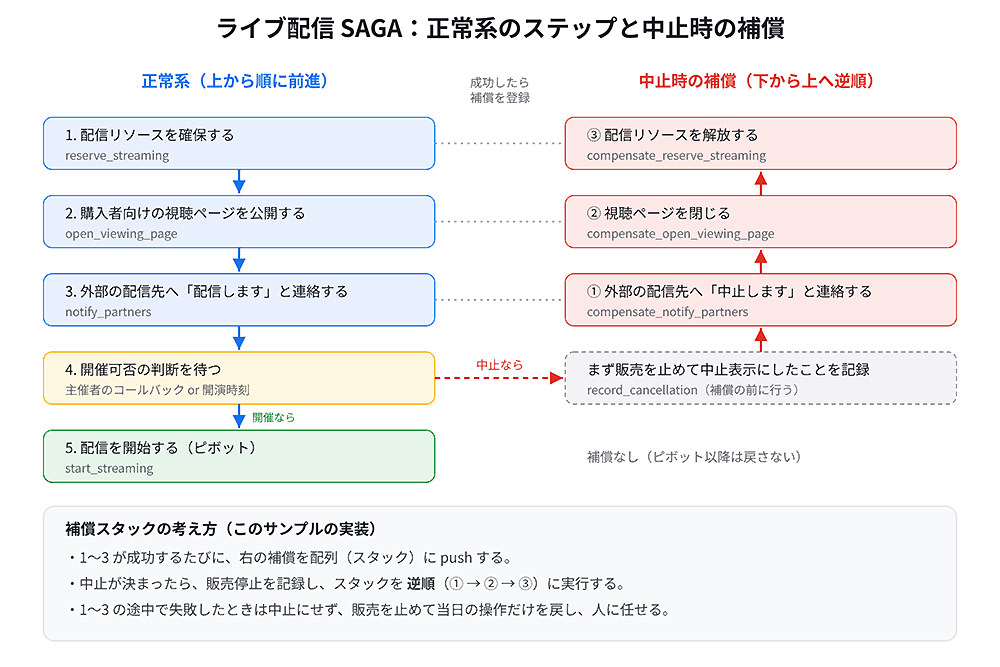
補償の実行順序
補償は丸数字の順 (①→②→③。表では下の行から上へ)、つまり正常系の逆順に実行します。
|
正常系のステップ
|
中止時の補償 (逆順に実行)
|
|---|---|
|
1. 配信リソースを確保する (reserve_streaming)
|
③ 配信リソースを解放する |
|
2. 購入者向けの視聴ページを公開する (open_viewing_page)
|
② 視聴ページを閉じる |
|
3. 外部の配信先へ「配信します」と連絡する (notify_partners)
|
① 外部の配信先へ「中止します」と連絡する |
|
4. 開催可否の判断を待つ (主催者のコールバックか開演時刻)
|
なし (ここで中止が決まる) |
|
5. 配信を開始する (start_streaming)
|
なし (ピボットなので戻さない) |
巻き戻しを行うポイント
巻き戻しに入るきっかけは 2 通りあります。1 つは主催者が中止を決めたとき (以下、中止のとき) で、もう 1 つは当日の準備 (確保・公開・連絡) が失敗したとき (以下、準備の失敗のとき) です。
どちらも巻き戻しの前に、前の週から受け付けている配信チケットの販売を止めます。中止のときは、販売ページを中止の表示に切り替えます (record_cancellation)。
準備の失敗のときは販売を止めるだけにして (record_abort)、中止にするかどうかの判断は人に任せます。補償の動きはどちらも同じなので、このあと落として確かめるのは「中止のとき」です (準備の失敗との分かれ目は、実験 3 でもう一度出てきます)。
補償を配列に push して、逆順に実行する
Durable Functions で書くときの肝は、正常系ステップが成功するたびに、補償をただの配列に push しておくところです。 オーケストレータ (src/durable/orchestrator.ts) の骨格を、エラー注入やログ用のコードを省いて抜き出すと次のようになります。
export const handler = withDurableExecution(async (event: SagaInput, context: DurableContext) => {
  const { eventId } = event;
  const compensations: CompensationEntry[] = []; // 補償スタック(ただの配列)
  let compensable = true;                        // まだ補償に入ってよい段階か

  try {
    // 正常系 1〜3:step が成功したら、対応する補償を積む
    await context.step("reserve_streaming", () => resources.reserve(eventId));
    compensations.push({ step: "reserve_streaming", label: "配信リソースを解放", params: { eventId } });

    await context.step("open_viewing_page", () => viewingPage.open(eventId));
    compensations.push({ step: "open_viewing_page", label: "視聴ページを閉じる", params: { eventId } });

    await context.step("notify_partners", () => partners.notifyStreamInfo(eventId));
    compensations.push({ step: "notify_partners", label: "外部配信先へ中止連絡", params: { eventId } });

    // 正常系 4:主催者のコールバック(waitForCallback)と開演時刻(wait)を
    // context.parallel で競わせ、"go" か "cancel" を決める(本題ではないので省略。下の本文を参照)
    const verdict: "go" | "cancel" = /* 省略 */;

    if (verdict === "cancel") {
      compensable = false;
      await context.step("record_cancellation", () => sales.stopAndShowCancelled(eventId));
      await runCompensations(context, event, compensations); // 当日の操作を逆順に打ち消す
      return { outcome: "cancelled_and_compensated" };
    }

    // 正常系 5:ピボット。ここから先は戻さない
    compensable = false;
    await context.step("start_streaming", () => resources.start(eventId));
    return { outcome: "streamed" };
  } catch (err) {
    if (!compensable) throw err; // 補償中・ピボット後の失敗は、補償し直さずに実行を失敗させる
    // 準備の失敗:販売を止め、当日の操作だけを戻して人に判断を任せる
    await context.step("record_abort", () => sales.stop(eventId));
    await runCompensations(context, event, compensations);
    return { outcome: "rolled_back_for_review" };
  }
});判断待ちの部分は、waitForCallback (外からのコールバックを待つ) と context.wait (開演時刻まで待つ) を context.parallel で競わせ、先に返ってきたほうで「開催」か「中止」かを決めています (開演時刻が先に来れば、そのまま開催です)。本題ではないので省略しましたが、実際のコードは src/durable/orchestrator.ts にあります。
このコードのポイントは 3 つです。
- 補償は「成功してから」積む : push を step の直後に書いているので、配列に入っているのは成功したステップの補償だけです。たとえば notify_partners で失敗したときは、配列には先頭の 2 つしか入っていないので、視聴ページを閉じて配信リソースを解放するだけで済みます。
- 補償の前に販売を止める : 中止なら record_cancellation、準備の失敗なら record_abort で、まず新しい購入を受け付けないようにしてから巻き戻します。
- 補償をやり直さないための目印 (compensable) : 補償に入る前に compensable を false にしておきます。補償の途中で失敗して catch に入っても、補償を最初から回し直さずに実行を失敗させ、人手に渡します。ピボットのあとの失敗も同じ扱いです。
補償の実行
補償のほうは、積んだ配列を後ろから取り出して、それぞれを step として実行するだけです (抜粋)。
async function runCompensations(context: DurableContext, event: SagaInput, compensations: CompensationEntry[]) {
  const { eventId } = event;
  // 積んだ順の逆(LIFO:後から積んだものを先に取り出す)に実行する
  for (const entry of [...compensations].reverse()) {
    switch (entry.step) {
      case "notify_partners": // 3. の補償:外部の配信先へ中止を連絡
        await context.step("compensate_notify_partners", () => partners.notifyCancellation(eventId));
        break;
      case "open_viewing_page": // 2. の補償:視聴ページを閉じる
        await context.step("compensate_open_viewing_page", () => viewingPage.close(eventId));
        break;
      case "reserve_streaming": // 1. の補償:配信リソースを解放
        await context.step("compensate_reserve_streaming", () => resources.release(eventId));
        break;
    }
  }
}
配列は消えるのに復元できる理由
では、この配列はどこに保存されていて、開演までの何時間かのあいだに関数が止まったり落ちたりしても読み込めるのでしょうか。
答えは、配列そのものはどこにも保存されていない、です。ハンドラの中の変数として Lambda のメモリ上にあるだけで、その invocation が終われば消えます。
なお、ハンドラの外に置くと、使い回された Lambda の実行環境に前の中身が残ってしまうので、配列は必ずハンドラの中で作ります。保存されているのは各 step の結果 (チェックポイント) のほうです。これは Lambda が実行ごとに管理するので、自分でテーブルを用意する必要はありません。再開すると、ハンドラは先頭から実行し直されます。完了済みの step は保存された結果を返し、その直後の push がもう一度実行されるので、配列は同じ中身で組み立て直されます。
補償スタックを Amazon DynamoDB などに別途保存しておかなくてよいのは、このおかげです。UUID のように毎回値が変わるものも、step の中で作れば結果として保存されるので、リプレイでは同じ値が返ります (step の外で作ると、リプレイのたびに別の値になります) 。
ただし、この組み立て直しが成り立つには、次の 2 点に気をつけます。
- 待てる長さは実行タイムアウトで決まる : タイムアウトに当たると補償の途中でも打ち切られるので、実行タイムアウトは、判断待ちの長さに補償の所要時間を足した値にしておきます。このサンプルは判断待ちを最長 10 時間、実行タイムアウトを 12 時間にしています。
- 同じコードで再開する : 待っているあいだに、push の順や条件を変えたコードで再開すると、配列の中身が変わってしまいます。関数はバージョンかエイリアスに固定して呼び、step の外では現在時刻や乱数を使わないようにします。
補償の途中でわざと落としてみる
前の節で書いた「配列はリプレイで組み立て直される」を、巻き戻しの途中で実際に関数を落として確かめてみます。落とす場所は、「今回の中止シナリオ」の図の右列で最初に実行される補償、外部の配信先へ「中止します」と連絡するところ (図の ①) です。以下、これを中止連絡と呼びます。
外へ 1 回だけ送りたい連絡なので、二重に飛ぶかどうかがいちばん気になるところです (防ぎ方は実験 2 で見ます)。この 1 つの補償の中でどの瞬間に落ちたかで、再開後の挙動は 3 通りに分かれます。
中止連絡の補償
前の節の `runCompensations` から、中止連絡の補償のところだけを抜き出すと次のようになります。 A / B /C は、この step の中と外の、落ちる位置です。
// runCompensations の抜粋(中止連絡の補償だけを取り出して簡略化)
// ← A:ここで落ちると、まだ何も送っていない
await context.step("compensate_notify_partners", async () => {
  await partners.notifyCancellation(eventId); // 中止連絡を送り、冪等キーに「送信済み」を書く
  // ← B:ここで落ちると、連絡は届いたのに step の結果はまだ保存されていない
});                                           // step を抜けると、結果が保存される(チェックポイント)
// ← C:ここで落ちると、中止連絡の結果は保存済み。次の「視聴ページを閉じる」に進む前
中止連絡で落ちた場所ごとの再開後の挙動の変化
- A : 中止連絡を送る前に落ちた。まだ何も起きていないので、再開後にふつうに実行されるだけです。
- B:中止連絡を送ったあと、step が結果を保存する前に落ちた。中止連絡の step は未完了のままなので、再開後に本体がもう一度走ります (at-least-once)。
- C : step が結果を保存したあと、次の「視聴ページを閉じる」に進む前に落ちた。中止連絡の step は完了済みなので、再開後はリプレイで保存結果が使われ、「視聴ページを閉じる」から進みます。
A は試すまでもないので、残りの B と C を、図の右側の C から逆にたどります。何も繰り返されない C のほうが、リプレイで続きから進む仕組みが素直に見えるからです (C を実験 1、B を実験 2 とします)。
実験 3 は「落ちる」のではなく、補償が例外で失敗する別のケースです。
サンプルには、この B と C で落とすための入力を用意してあります。どちらも「最初の 1 回だけ」process.exit(1) で invocation を落とし、Durable Functions が別の invocation で再開するところまで流します。
中止時の補償チェーンのうち「中止連絡」を拡大し、その中のどこで落ちるかで再開後の挙動が A / B / C に分かれることを示した図
実験 1 : 補償と補償のあいだで落ちた場合 (C)
中止連絡を送り終えて step の結果も保存し、次の「視聴ページを閉じる」に進む直前で落とします。図の C の位置です。 うまくいっていれば、再開後は中止連絡を送り直さずに、「視聴ページを閉じる」から続きが進むはずです。 サンプルでは、入力に crashBetweenCompensations を指定すると、この位置で 1 回だけ落ちるようにしてあります。 実機で起動したときの入力は次のとおりです。
{
  "eventId": "exp1-1791885300",
  "eventName": "HSF",
  "cancel": true,
  "fault": { "crashBetweenCompensations": "notify_partners" }
}
fault が落とす位置の指定で、notify_partners の補償 (中止連絡) が終わった直後に落ちます。cancel は、このデモで中止の判断を送ることを示す指定です (判断そのものは、実行が判断待ちで止まったあとにコールバックで送ります)。
ap-northeast-1 で流すと、実行は 3 回の invocation に分かれて完走しました。
- 1 回目 : 開催可否の判断待ちで一時停止した
- 2 回目 : 中止を受けて補償に入り、中止連絡のあとで落ちた
- 3 回目 : 再開して、残りの補償を済ませた
get-durable-execution の実行
get-durable-execution で取った実行の結果 (抜粋) は次のとおりで、補償は中止連絡、視聴ページ、配信リソースの順に済んでいます。
{
  "Status": "SUCCEEDED",
  "Result": {
    "outcome": "cancelled_and_compensated",
    "compensatedSteps": ["notify_partners", "open_viewing_page", "reserve_streaming"]
  }
}
実行結果
各処理の本体が実際に走った回数は次のとおりで、どれも 1 回でした。
|
処理
|
本体が走った回数
|
|---|---|
|
正常系 1 ~ 3 (確保・公開・連絡)
|
各 1 |
|
補償 : 中止連絡 (落ちる直前に完了)
|
1 |
|
補償 : 視聴ページを閉じる・解放 (再開後に実行)
|
各 1 |
再開した 3 回目の invocation でも、ハンドラは先頭から実行し直されています。
それでも中止連絡は送り直されず、補償は「視聴ページを閉じる」から進みました。
配列の再構成
配列が組み立て直されたことは、ログでも確かめられます。 補償に入るたびに配列の中身を 1 行のログに出しているので、落ちる前と再開後の 2 行を並べました。 requestId (invocation ごとに違う値で、先頭だけ表示) は別々なのに、stack の中身は同じです。
requestId 67c077fc  {"type":"compensation_stack","stack":["reserve_streaming","open_viewing_page","notify_partners"]}
(ここで落ちる)
requestId 0887b221  {"type":"compensation_stack","stack":["reserve_streaming","open_viewing_page","notify_partners"]}
前の節で書いたとおり、完了済みの step の直後の push がリプレイでもう一度実行されて、配列が組み立て直されたわけです。
実験 2 : 補償の中で落ちた場合 (B)
今度は、中止連絡を送った直後、step が結果を保存する前に落とします。図の B の位置です。
step はまだ完了していないので、再開後に中止連絡の本体がもう一度走ります。何も手を打たなければ、配信先には「中止します」が 2 回届くことになります。
サンプルでは、中止連絡に冪等キー (<eventId>#cancellation) を付けていて、送る前に「送信済み」の記録があればもう送りません。このキーは入力から決まるのでそのまま使えますが、呼び出しごとに一意な ID を求める API なら、前の節で触れたとおり UUID を step の中で作って渡します。
入力に crashAfterCompensationSideEffect を指定するとこの位置で落ち、disableIdempotency を足すと冪等キーを使わずに送ります。
中止連絡の回数を比較
両方を実機で流して、中止連絡が届いた回数を比べました (invocation の括弧内は、落ちて異常終了した回数です)。
|
条件
|
invocation (うち異常終了)
|
中止連絡が届いた回数
|
|---|---|---|
|
冪等キーあり (通常)
|
3 (1) |
1 |
|
冪等キーなし (disableIdempotency)
|
3 (1) |
2 |
冪等キーがあると、もう一度走った本体は「送信済み」を見て、送らずに終わりました。冪等キーがないと、そのまま 2 回目が送られました。Durable Functions のチェックポイントや再開は便利ですが、B のタイミングで本体が再実行されること自体は防いでくれません。step が at-least-once である以上、外へ 1 回だけ送りたい処理は、副作用側の冪等キーで守る必要があります。
一方で、視聴ページを閉じる・リソースを解放する、といった補償は状態の上書きなので、もう一度走っても結果は同じで、冪等キーまでは要りません。
実験 3 : 補償そのものが失敗した場合 (例外)
最後は、落ちるのではなく、補償が例外で失敗するケースです。A / B / C とは別の話で、「視聴ページを閉じる」補償が何度やっても失敗する、という場面を考えます。このサンプルの補償の step は、1 秒おきに合計 3 回まで試すように設定しているので、その 3 回を使い切ると、例外は catch に入ります。
ここで心配なのは、catch が「準備の失敗」と同じ扱いになって、中止の表示を消したり、補償を最初からやり直したりしてしまうことです。
それを止めるのが、前の節のコードに入れていた compensable です。
補償中の失敗は再試行しない
関係するところだけを抜き出すと、次のようになります。
// 前の節の骨格から抜粋
if (verdict === "cancel") {
  compensable = false;                                    // ここから先は補償中
  await context.step("record_cancellation", () => sales.stopAndShowCancelled(eventId));
  await runCompensations(context, event, compensations);  // ← この中で失敗すると catch へ
}
// ...
} catch (err) {
  if (!compensable) throw err;  // 補償中の失敗なら、ここで実行を失敗させて終わる
  // ここから下は「準備の失敗」用:販売を止めて、補償を最初から回す
  await context.step("record_abort", () => sales.stop(eventId));
  await runCompensations(context, event, compensations);
}
中止が決まった時点で compensable を false にしているので、補償の途中で失敗して catch に来ても、最初の if でそのまま実行を失敗させ、その下の「準備の失敗」用の処理には進みません。
入力に failCompensation を指定して「視聴ページを閉じる」を毎回失敗させ、ローカルテストで流すと、実行は失敗で終わり、販売ページの中止表示はそのまま残りました。閉じられなかった視聴ページと、まだ解放していない配信リソースは、人が引き取ります。
では、compensable をわざと無視するとどうなるか。
disableCompensableGuard を足してローカルテストで流すと、catch の最初の if を素通りして、「準備の失敗」用の処理に進みました。
販売の状態は中止表示のない「停止」で上書きされ、補償も最初の中止連絡から回し直しになって、同じ「視聴ページを閉じる」でまた失敗して終わりました。回し直しで中止連絡の本体はもう一度走りましたが、配信先に届いたのは 1 回だけで、これは実験 2 の冪等キーが効いたからです。
compensable が守っているのは「中止を中止のまま扱う」こと、冪等キーが守っているのは「同じ連絡を二度送らない」ことで、役割が別です。
ローカルで確認する方法
ここまでの 3 つの実験は、手元でも試すことができます。AWS の公式のテストランナー (@aws/durable-execution-sdk-js-testing の LocalDurableTestRunner) を使い、AWS なしで流せるようにしてあります (test/saga-compensation.test.ts)。オーケストレータをそのまま本物のリプレイに乗せて流し、DynamoDB はインメモリに差し替えています。
ただ、ローカルのランナーでは process.exit で落ちた invocation からの再開までは再現できませんでした。
そこでローカルでは、実験 1 の invocation の区切りを開催可否のコールバック待ちで、実験 2 の本体の再実行を step のリトライで作っています。実際にクラッシュさせての確認は、上の実機の結果 (実験 1・2) です。
テスト実行
実験 1〜3 とその対照は、次のとおり通ります。
$ npm test
...
ok 1 - 実験1: 補償スタックは保存していないのに、別の invocation で同じ中身に組み立て直される
ok 2 - 実験2: 補償の本体が再実行されても、冪等キーがあれば中止連絡は 1 回
ok 3 - 実験2 対照: 冪等キーなし(disableIdempotency)だと、本体の再実行で中止連絡が二重になる
ok 4 - 実験3: 補償の途中で失敗したら、補償をやり直さずに実行を失敗させる(compensable の目印)
ok 5 - 実験3 対照: 目印を無視すると、中止が『準備の失敗』扱いになって補償をやり直し、中止表示が消える
# pass 5
# fail 0
実機で動かすときの注意
Durable Functions の関数は、Lambda コンソールでタイプが「永続」(英語表示では Durable) と表示され、「永続実行」タブ (英語表示では Durable executions) で実行タイムアウトや保持期間、実行一覧を確認できます。
この関数は修飾子 (バージョン、エイリアス、$LATEST のいずれか) をつけて呼ぶ必要があります。ただし $LATEST で起動した実行は、一時停止中にコードが差し替わると新しいコードで再開してしまい、リプレイの前提が崩れて非決定性のエラーになり得るので、本番ではバージョンかエイリアスに固定します。
また、同期呼び出し (RequestResponse) で呼び出し側が結果を待てるのは最長 15 分 (関数や実行のタイムアウトがそれより短ければ、その長さ) なので、実行タイムアウトが 12 時間のこのサンプルは、非同期の Event で起動して get-durable-execution で結果を取るようにしています。
参考 : AWS Step Functions で書く場合
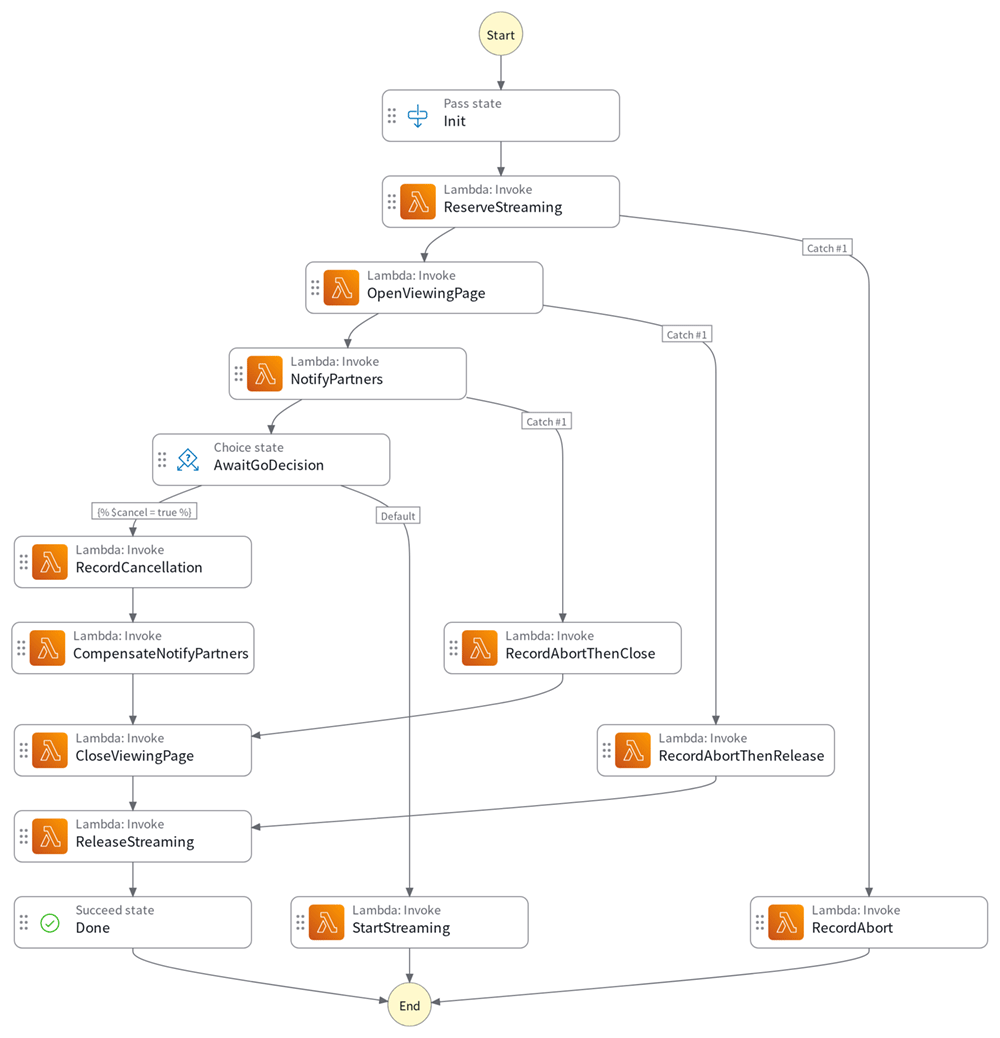
冒頭のとおり、SAGA は以前 Step Functions で書いたことがあるので、同じ中止から補償までを Step Functions でも書いてサンプルに入れてあります (lib/sfn-saga.ts。判断待ちのコールバックは省いています)。
Durable Functions では補償を配列に push して逆順に回すだけでしたが、Step Functions では、どこで失敗したら補償チェーンのどこに合流するかを、Catch の線として 1 本ずつ宣言します。コードで見通しよく書くか、宣言的に書いてグラフで追えるようにするか、という違いだと思います。
使い分けは、AWS 公式の Durable functions or Step Functions が判断軸を示してくれています。
動かし方
まずはローカルで、補償の 3 つの実験をすぐに再現できます。
git clone https://github.com/miura-bd/saga-durable-functions.git
cd saga-durable-functions

npm ci
npm test        # 補償の 3 つの実験と、その対照を含むローカルテスト(AWS 不要)
テストが 5 件とも pass になれば成功です。
実機でクラッシュ再開まで動かす手順 (デプロイ・中止シナリオの実行・結果の確認・後片付け) は、リポジトリの ハンズオン手順 にまとめてあります。実機は Lambda や DynamoDB の利用料がかかるので、まずはローカルから試してみていただくのがおすすめです。
本番の処理にする前に
今回のサンプルはオーケストレーションの書き方を見せるためのもので、モックは DynamoDB 上の状態を更新するだけです。
実際の外部サービスに連絡を送るなら、冪等キーを置く台帳や、結果が分からないときに送り直さずに照会する経路、「ワークフローの成功」と「業務の完了」を分けて持つことなどが、サンプルの外で必要になります。
考え方とチェックリストは、本番にする前のメモ に置いてあります。
まとめ
SAGA の補償は「成功済みを逆順に打ち消す」という考え方でした。Durable Functions なら、補償を配列に push して逆順に回すだけで書けて、巻き戻しの途中で落ちても、配列はリプレイで組み立て直され、完了済みの補償は飛ばして続きから進んでくれます。補償と補償のあいだで本当に落としてみた実機でも、済んだ処理は 1 回ずつしか走らず、続きの補償から進んでいました。
ただし、step は at-least-once なので、副作用を起こした直後に落ちれば、その本体はもう一度走ります。中止連絡のように繰り返すと害がある処理は、冪等キーで守っておく必要があります。補償の途中で失敗したときに、中止を中止のまま扱う compensable も、冪等キーとは別に要ります。
判断の軸はシンプルで、「落ちたあとにその処理をもう一度実行して、副作用が増えないか」を考えます。増えないなら Durable Functions の再開に任せられて、増えるなら冪等キーで受けるようにします。
まずは GitHub リポジトリ のサンプルで、補償の実験を`npm test で流してみて、そこから自分の補償ロジックに置き換えて、「自分ならどこで落ちても大丈夫にするか」を試していただけたらと思います。
「落ちても大丈夫」は、落ちない前提ではなく、落ちたらやり直せる形にしておくことで手に入るのだなと、今回あらためて実感しました。私が各地のコミュニティで多くの人のアウトプットから学ばせてもらったように、この記事が Lambda Durable Functions を試す取っ掛かりとして、誰かのヒントになれば幸いです。
筆者プロフィール
三浦 一樹 (@miu_crescent)
AWS Community Hero / 株式会社ヘプタゴン メディア事業 統括責任者
1986 年生まれ。2012 年東京工業大学卒業後、北海道テレビ放送に入社。放送の基幹システムや電源設備の保守管理を行う技術部門を経て、2015 年からデータ放送コンテンツの開発、アクセスログ解析などに従事。2017 年 5 月、AWS Summit 2017 のメディア業界シンポジウムに参加したことをきっかけに、放送×クラウドの可能性に開眼。各地のコミュニティに参加するようになる。2020 年 3 月、コミュニティ活動への貢献が認められ、「AWS Samurai 2019」に認定。2023 年 9 月、「AWS Community Hero」に選出。2024 年 11 月、株式会社ヘプタゴンに入社。現在はメディア事業の統括責任者を務める。札幌在住。