AWS 기술 블로그
Pennylane을 활용한 Amazon Braket에서의 maxcut 문제의 해결 (1부) – Max-Cut 개념 및 QAOA 구현
지난 블로그 시리즈에서는 Amazon Braket으로 양자-고전 하이브리드 알고리즘을 실행하는 기본적인 방법을 소개했습니다.
이번 블로그 시리즈에서는 Max-Cut problem(최대 절단 문제)를 해결하기 위해 PennyLane으로 구현한 QAOA(Quantum Approximate Optimization Algorithm, 양자 근사 최적화 알고리즘)를 Amazon Braket Hybrid Jobs에서 실행하는 방법을 두 편으로 나누어 소개합니다. Max-Cut 문제는 네트워크를 두 그룹으로 나눠 연결을 최대화하는 최적화 문제로, 실생활에서는 물류 경로 최적화, 전력망 분할, VLSI 회로 설계, 소셜 네트워크 커뮤니티 분리, 금융 사기 탐지 등 다양한 분야에 적용할 수 있습니다. 이번 1부에서는 Max-Cut 문제와 QAOA의 개념을 살펴본 뒤, 그래프 생성부터 해밀토니언, 양자 회로, 비용 함수 최적화, 디바이스 선택까지 QAOA를 구현한 maxcut_qaoa 모듈의 코드를 단계별로 설명합니다. 이어지는 2부에서는 이 코드를 로컬 시뮬레이터, 하이브리드 잡의 임베디드 시뮬레이터, 온디맨드 시뮬레이터(SV1)라는 세 가지 방식으로 실행하며 그 차이를 비교합니다. 참고로 이 블로그의 코드는 Amazon Braket 예제 노트북 “Using PennyLane with Braket Hybrid Jobs”(GitHub의 amazon-braket-examples 저장소)과 Amazon Braket 개발자 가이드의 QAOA 예제를 바탕으로 재구성한 것입니다. 이 글의 코드는 Amazon Braket 노트북 인스턴스의 conda_braket 커널(PennyLane 0.45.1, Amazon Braket SDK 1.127.0)에서 실행이 정상 동작함을 확인했습니다.
이 블로그 시리즈의 구성은 다음과 같습니다.
- PennyLane을 활용한 Amazon Braket에서의 maxcut 문제의 해결 (1부): Max-Cut 개념 및 QAOA 구현
- PennyLane을 활용한 Amazon Braket에서의 maxcut 문제의 해결 (2부): 세 가지 실행 방식 비교
Max-Cut 문제의 정의
Max-Cut 문제란, 그림1과 같이 주어진 무방향 그래프에서 정점(노드) 집합을 두 부분 집합 S와 Sc로 나누었을 때, 두 집합 사이를 연결하는 간선(즉, 절단되는 간선, cut)의 개수 또는 가중치 합이 최대가 되도록 하는 분할을 찾는 최적화 문제입니다.
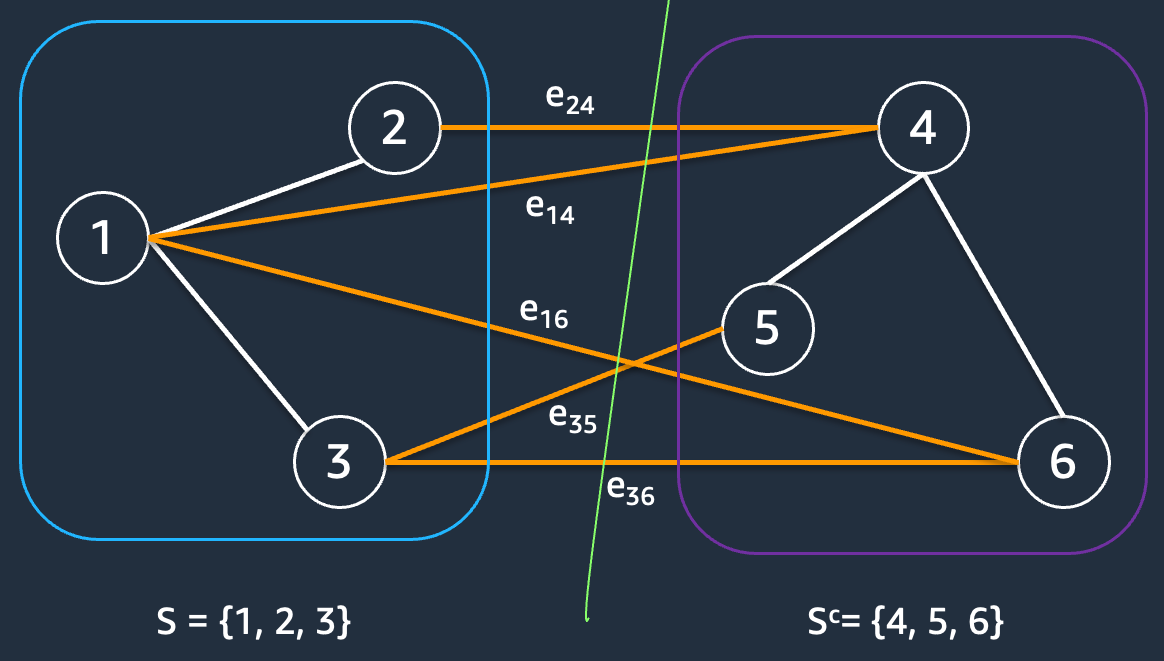
<그림1. 주어진 그래프에서 Max-Cut 문제>
먼저 집합 S는 정점 집합 V의 부분 집합입니다. 예를 들어 그림1에서는 S = {1, 2, 3} ⊂ V 입니다. 다음으로 컷(cut)은 S와 그 여집합 Sc를 잇는 간선들의 가중치 합으로 정의됩니다. 그림1에서 두 집합을 가로지르는 간선은 {(2, 4), (1, 4), (1, 6), (3, 5), (3, 6)} 이므로, 집합 S에 대한 컷은 다음과 같이 계산됩니다.
- cut(S) = e24 + e14 + e16 + e35 + e36
Max-Cut 문제의 목적은 이 컷을 최대로 만드는 집합 S를 찾는 것입니다. 이 문제를 수식으로 표현하기 위해 다음과 같이 변수 x를 정의합니다.
- xi: 노드 i가 집합 S에 속하는지를 나타내는 변수(속하면 +1, 속하지 않으면 -1)
이렇게 정의하면 xi와 xj가 서로 다른 집합에 있을 때 xixj = -1, 같은 집합에 있을 때 xixj = +1이 됩니다. 예를 들어 그림1에서 x5x4 = +1이고, x5x1 = -1입니다.
이제 이 최적화 문제는 다음과 같이 수식으로 나타낼 수 있습니다.
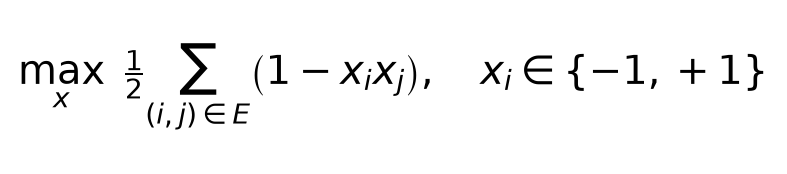
여기서 (i,j)∈E는, 그래프의 모든 간선(즉, 두 정점 i와 j를 연결하는 모든 쌍)을 의미합니다. 즉, 합산 기호 ∑(i,j)∈E는 그래프 내 모든 간선에 대해 해당 식을 적용하라는 뜻입니다. 예를 들어, 위의 그림1에서 간선의 값이 모두 1이라면 cut(S) = ½[(1+1) + (1+1) + (1+1) + (1+1) + (1+1)] = 5가 됩니다.
Max-Cut 문제는 고전 컴퓨터로도 정확한 해를 구하는 것이 이론적으로는 가능합니다. 가능한 모든 분할을 하나씩 시도하면서 각 경우의 간선 가중치 합을 계산하고, 그 값이 가장 큰 분할을 고르면 됩니다. 이러한 방법을 브루트 포스(무차별 대입) 방식이라고 부릅니다.
하지만 그래프의 정점 수가 많아질수록 가능한 분할의 수는 기하급수적으로 늘어납니다. 예를 들어 정점이 30개만 되어도 230개, 약 10억 7천만 가지가 넘는 분할이 존재하므로, 이를 모두 계산하는 것은 현실적으로 불가능합니다. 실제로 Max-Cut은 NP-hard 문제로 알려져 있어, 정점 수가 많아질 때 정확한 해를 다항 시간 안에 찾는 알고리즘은 아직 발견되지 않았습니다.
따라서 정확한 해는 작은 그래프에서만 구할 수 있고, 큰 그래프에서는 근사 알고리즘(예: Goemans-Williamson 알고리즘)이나 QAOA와 같은 양자-고전 하이브리드 알고리즘으로 최적에 가까운 해를 찾는 것이 일반적입니다.
하이브리드 양자 알고리즘, QAOA
QAOA는 Max-Cut과 같은 조합 최적화 문제를 풀기 위한 양자 알고리즘입니다. 정확한 답을 보장하지는 않지만, 최적해에 가까운 근사해를 구할 수 있습니다. QAOA는 양자 컴퓨터와 고전 컴퓨터를 함께 사용하는 하이브리드 방식으로, 양자 회로가 계산한 결과를 고전 컴퓨터가 받아 회로의 파라미터를 반복적으로 조정하며 해를 개선합니다. 현재의 양자 컴퓨터(NISQ)는 큐비트 수가 제한적이고 오류가 많지만, QAOA는 회로가 비교적 얕아 이런 환경에서도 실행할 수 있는 실용적인 알고리즘으로 주목받고 있습니다.
문제 해결을 위한 그래프의 생성
아래 코드는 Python의 NetworkX 라이브러리로 노드 5개, 간선 6개의 무작위 그래프를 생성하고 시각화합니다.
먼저 그래프 분석에 널리 쓰이는 NetworkX 패키지를 불러옵니다. 노드 수(num_nodes)를 5, 간선 수(num_edges)를 6으로 설정합니다. 마지막으로 시드 값(seed)을 고정하는데, 시드를 고정하면 실행할 때마다 항상 같은 그래프가 재현됩니다. 값 자체는 무엇이든 상관없으며, 여기서는 1985를 사용했습니다.
nx.gnm_random_graph 함수는 지정한 노드 수, 간선 수, 시드 값으로 무작위 그래프를 생성합니다. nx.spring_layout은 그림을 그릴 때 각 노드를 놓을 위치를 계산하고, nx.draw는 노드 번호를 표시하며 그래프를 그립니다(node_size는 노드의 크기입니다).
이 코드를 실행하면 그림2와 같은 그래프가 생성됩니다. 이 그래프가 이 글에서 Max-Cut 문제를 풀 대상입니다. 노드가 5개이므로 뒤에서 큐비트도 5개를 사용하게 됩니다.
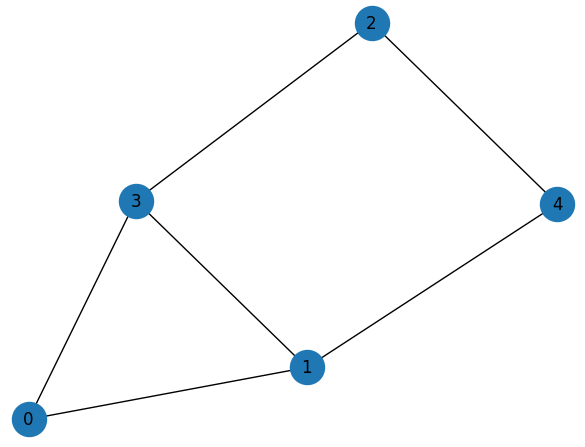
<그림2. 5개의 노드와 6개의 간선으로 만든 무작위 그래프>
다음 코드는 생성한 그래프를 인접 리스트(adjacency list) 형식의 파일로 저장합니다. 이 파일은 뒤에서 하이브리드 잡의 입력 데이터로 사용됩니다.
input_file_path 변수에 파일 이름 “graph.adjlist”를 지정한 뒤, NetworkX의 write_adjlist 함수로 graph 객체를 그 파일에 저장합니다. 인접 리스트는 각 노드와 그 노드에 연결된 이웃 노드들을 한 줄씩 텍스트로 기록하는 형식으로, 저장된 파일의 내용은 표1과 같습니다. 무방향 그래프의 간선은 한 번만 기록되므로, 앞줄에서 이미 나온 연결은 뒤 노드의 줄에서 생략됩니다.
| 줄 예시 | 의미 |
|---|---|
| 0 3 1 | 0번 노드와 3번, 1번 노드가 연결됨 |
| 1 3 4 | 1번 노드와 3번, 4번 노드가 연결됨 |
| 2 3 4 | 2번 노드와 3번, 4번 노드가 연결됨 |
| 3 | 3번 노드의 간선(0, 1, 2와 연결)은 앞줄에 이미 기록되어 여기서는 생략됨 |
| 4 | 4번 노드의 간선(1, 2와 연결)은 앞줄에 이미 기록되어 여기서는 생략됨 |
<표1. graph.adjlist에 저장된 그래프의 인접 리스트 구성>
QAOA 알고리즘
이제 Max-Cut 문제를 푸는 QAOA 알고리즘을 코드와 함께 살펴보겠습니다. 이 글에서는 이 코드를 maxcut_qaoa로 지칭하며, 뒤의 실행 단계에서 같은 이름이 다시 등장합니다.
아래 코드는 먼저 필요한 모듈을 불러옵니다.
양자 회로와 수치 연산을 위해 PennyLane(별칭 qml)과 pennylane.numpy를, 하이브리드 잡으로 실행할 때 비용 함수 값 등의 지표를 기록하기 위해 Amazon Braket의 log_metric을 임포트합니다.
maxcut_qaoa 코드는 크게 run_qaoa 함수와 get_device_instance 함수로 구성됩니다.
run_qaoa 함수는 Max-Cut 문제를 위한 QAOA 알고리즘 본체로, 다음 네 단계를 수행합니다.
- 입력받은 그래프로 비용 해밀토니언과 믹서 해밀토니언 생성
- 양자 회로 구성과 비용 함수 정의
- 고전 옵티마이저를 이용한 파라미터 최적화
- 최적화된 회로에서 각 비트 문자열의 확률 계산
각 단계를 차례로 살펴보겠습니다.
해밀토니언의 생성
QAOA에서 해밀토니언(Hamiltonian)은 풀고자 하는 문제를 양자 컴퓨터가 처리할 수 있는 형태로 옮겨 주는 “번역기”에 해당합니다. 본래 해밀토니언은 물리학에서 어떤 시스템의 에너지를 나타내는 수학적 연산자입니다. QAOA는 이 개념을 차용하여, 문제의 각 후보 해(양자 상태)에 “에너지”라는 이름의 점수를 부여하는 데 사용합니다. 규칙은 단 하나입니다. 에너지가 낮을수록 좋은 해입니다. 따라서 QAOA가 수행하는 일은 결국 “에너지가 가장 낮은 상태를 찾는 것”이며, 그 상태가 곧 우리가 구하려는 최적의 해입니다.
Max-Cut 문제에 이 규칙을 적용해 보겠습니다. Max-Cut의 목표는 그래프의 노드를 두 그룹으로 나눌 때, 두 그룹 사이를 가로지르는 간선(절단되는 간선)의 수가 최대가 되도록 하는 것입니다. 따라서 에너지는 간선 하나하나를 기준으로 부여하면 됩니다.
- 간선의 양 끝 노드가 서로 다른 그룹에 속하면 그 간선은 절단된 것이므로, 에너지를 1만큼 낮춥니다(바람직한 경우).
- 양 끝 노드가 같은 그룹에 속하면 그 간선은 절단되지 않았으므로, 에너지에 변화가 없습니다.
이렇게 모든 간선에 대해 합산하면, 전체 에너지는 “절단된 간선 수에 음의 부호를 붙인 값”이 됩니다. 예를 들어 그림2의 그래프(노드 5개, 간선 6개)에서 어떤 분할이 간선 5개를 절단하면 에너지는 -5, 3개만 절단하면 -3입니다. 간선을 많이 절단하는 좋은 분할일수록 에너지가 더 낮아지므로, 에너지를 최소화하는 것은 곧 컷을 최대화하는 것과 동일합니다. 다음편에서 최적화 결과의 비용(cost)이 -4, -4.25처럼 음수로 나타나고 그 절댓값이 평균 컷 크기에 해당하는 이유가 바로 여기에 있습니다.
비유하자면, 해밀토니언은 QAOA의 “채점표”입니다. 학급을 두 팀으로 나누는 상황을 생각해 보겠습니다. 서로 친한 두 학생(간선으로 연결된 두 노드)이 다른 팀에 배정될 때마다 1점씩 감점하는 규칙을 정하면, 점수가 가장 낮은 팀 구성이 곧 “친구 관계를 가장 많이 가른” 구성이 됩니다. Max-Cut은 바로 이러한 구성을 찾는 문제이며, 해밀토니언은 이 채점 규칙을 양자 컴퓨터가 해석할 수 있는 형태로 기술한 것입니다.
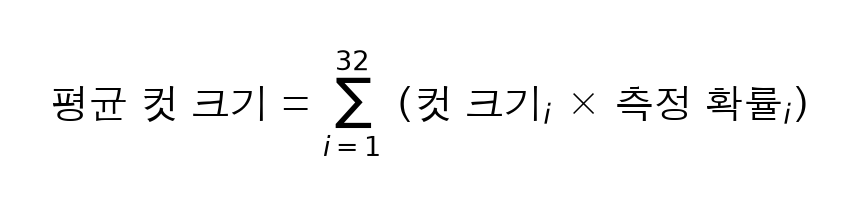
한 가지 유의할 점은, 양자 컴퓨터가 가능한 모든 분할을 한 번의 연산으로 비교하여 에너지가 가장 낮은 분할을 즉시 알려 주는 것은 아니라는 사실입니다. 양자 회로를 한 번 실행(shot)하고 측정하면 결과로 하나의 분할이 얻어집니다. 예를 들어 노드가 5개라면 00011처럼 5자리 비트 문자열이 나오며, 0인 노드와 1인 노드가 각각 한 그룹을 이룹니다. 초기에는 32가지(25) 분할이 거의 같은 확률로 나타납니다. 아직 회로가 어떤 분할이 좋은지 반영하지 못한 상태이기 때문입니다.
QAOA의 궁극적인 목적은 분명합니다. 가능한 모든 분할 가운데 최적의 분할(에너지가 가장 낮은 분할, 즉 절단되는 간선의 수가 가장 많은 분할)이 측정에서 가장 높은 확률로 나오도록, 확률 분포를 그쪽으로 기울이는 것입니다. 노드 개수가 5개면 32가지, 노드 개수가 17개면 약 13만 가지 분할이 있는데, 그중 최적의 분할이 가장 자주 관측되도록 만드는 것이 목표입니다.
그런데 QAOA는 최적의 분할을 직접 겨냥할 수 없습니다. 어느 분할이 최적인지 모르는 상태에서 출발하기 때문입니다. 대신 “측정 결과의 에너지 평균을 낮춘다”는 우회 전략을 사용합니다. 여기서 에너지 평균이란, 회로를 여러 번(예: 1000번) 측정해서 나온 분할들의 에너지를 모두 더해 측정 횟수로 나눈 값입니다. 예를 들어 1000번 중 컷 5인 분할(에너지 -5)이 400번, 컷 4(에너지 -4)가 350번, 컷 3(에너지 -3)이 250번 나왔다면 에너지 평균은 -4.15입니다. 이 값은 현재의 확률 분포가 전체적으로 얼마나 좋은 분할 쪽에 몰려 있는지를 숫자 하나로 요약해 줍니다. 평균을 낮추려면 좋은 분할의 확률을 키우고 나쁜 분할의 확률을 줄이는 것 외에는 방법이 없으므로, 평균을 계속 낮추다 보면 결과적으로 최적의 분할의 확률이 가장 커지는 방향으로 분포가 이동합니다.
이 전략을 실행하기 위해 양자 컴퓨터와 고전 컴퓨터가 역할을 나눕니다. 양자 컴퓨터는 고전 컴퓨터로부터 파라미터(γ, β)를 전달받아 회로를 실행하고, 여러 번 측정(앞선 예처럼 1000번)하여 각 분할이 몇 번 관측되었는지를 반환합니다. 고전 컴퓨터는 이 측정 결과로 에너지 평균을 계산한 뒤, 그 평균이 더 낮아질 것으로 예상되는 새 파라미터를 산출하여 다시 양자 컴퓨터에 입력합니다. 요약하면 양자 컴퓨터는 “주어진 파라미터로 분할의 표본을 생성하는 역할”, 고전 컴퓨터는 “그 표본의 에너지 평균을 보고 다음 파라미터를 결정하는 역할”을 담당합니다.
이 과정을 반복하면 에너지 평균이 점차 낮아지고, 그만큼 좋은 분할이 관측될 확률이 커집니다. 최종적으로 측정 결과의 분포에서 가장 자주 관측되는 분할이 QAOA가 찾은 해가 됩니다. 뒤에서 살펴볼 코드에서 이 에너지 평균에 해당하는 것이 비용 함수(cost_function)의 값이며, 최적화 과정에서 비용이 -4, -4.25처럼 낮아지는 것이 바로 이 평균이 낮아지는 모습입니다.
QAOA 알고리즘은 비용 해밀토니언과 믹서(탐색) 해밀토니언, 두 가지를 번갈아 사용합니다. 비용 해밀토니언은 좋은 분할에 표시를 남기고, 믹서 해밀토니언은 여러 분할 사이를 이동시키는 역할을 합니다.
- 비용 해밀토니언
- 목적: 문제의 조건을 에너지로 변환합니다.
- 동작: 현재 분할이 문제의 목표(간선을 최대한 많이 절단)에 얼마나 부합하는지를 에너지로 평가합니다. 앞 절에서 설명한 채점표가 바로 비용 해밀토니언입니다.
- 수식: 앞선 목적함수 C(x) = ½ ∑(i,j)∈E (1 − xixj), xi ∈ {−1, +1} 는 컷의 크기(절단된 간선 수)를 나타냅니다. 비용 해밀토니언은 여기에 음의 부호를 붙인 HC = −C 입니다.
- 정리: 목적함수 C(x)는 컷의 크기이므로 값이 클수록 좋은 분할이고, 비용 해밀토니언 HC 는 여기에 음의 부호를 붙인 것이므로 값이 낮을수록 좋은 분할입니다. 앞 절의 “에너지 = 절단된 간선 수의 음수”와 같은 내용입니다. 에너지 평균이 낮아진다는 것은 곧 평균 컷이 커진다는 뜻으로, 앞의 예에서 에너지 평균 -4.15는 평균 컷 4.15에 해당하며 이 값이 -4.5로 낮아지면 평균 컷은 4.5로 커집니다. QAOA는 파라미터를 조정해 이 에너지 평균을 최소화하며, 그것이 곧 컷을 최대화하는 과정입니다.
- 믹서 해밀토니언
- 목적: 새로운 해를 탐색하기 위해 양자 상태를 혼합합니다.
- 동작: 각 큐비트의 값을 0에서 1로, 1에서 0으로 전환하는(비트 반전) 연산으로, 현재 분할에서 다른 분할로 이동하는 힘을 제공합니다. 미로 찾기를 예로 들면, 출발점 부근에만 머물고 미로 전체를 탐색하지 않으면 실제 출구(최적의 해)를 찾지 못한 채 멈추게 됩니다. 믹서 해밀토니언이 없으면 QAOA도 특정 분할 부근에만 머물게 되며, 믹서가 있어야 한 지점에 갇히지 않고 더 좋은 해를 찾을 확률이 높아집니다.
- 수식: HM = ∑i Xi, Xi: i번째 큐비트의 파울리 X 연산자(0과 1을 뒤바꾸는 연산)
그림3은 QAOA의 기본 구조를 보여주는 양자 회로도입니다. 양자 컴퓨터 입문자를 위해 각 부분을 쉽게 설명하면 다음과 같습니다. 이 알고리즘의 핵심은 두 가지 해밀토니언(HC, HM)과 이들을 조절하는 파라미터(γ, β)에 있습니다. γ는 비용 해밀토니언에, β는 믹서 해밀토니언에 적용되는 파라미터입니다.
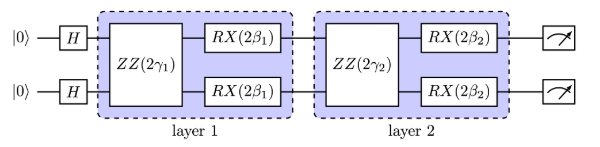
<그림3. 큐비트 2개, 레이어 2개(p=2)를 가정한 QAOA 회로>
먼저, 두 개의 큐비트가 모두 0 상태에서 시작합니다. 각 큐비트에 Hadamard 게이트(H)를 적용하면, 두 큐비트는 0과 1이 동시에 존재하는 ‘중첩 상태’가 됩니다. 이 상태는 가능한 모든 분할이 같은 확률로 포함된 출발점으로, 앞에서 언급한 “초기에는 모든 분할이 거의 같은 확률로 나타나는” 상태가 바로 이것입니다. 문제에 따라 필요한 큐비트의 수는 달라지며, 예를 들어 노드 개수가 5개라면 큐비트도 5개가 필요합니다.
그 다음에는 QAOA의 핵심 과정이 두 번 반복됩니다. 각 반복 과정을 ‘레이어’라고 부르는데, 그림에서는 layer 1과 layer 2가 있습니다. 각 레이어에서는 두 가지 중요한 연산이 이루어집니다.
첫 번째 연산인 ZZ(2γ)는 비용 해밀토니언을 회로로 구현한 게이트로, 그래프에서 간선으로 이어진 두 노드에 대응하는 두 큐비트마다 하나씩 적용됩니다. (비용 해밀토니언 자체는 하나이며, 간선마다 대응하는 ZZ 게이트가 하나씩 들어가는 것입니다.) 즉 한 레이어 안의 ZZ 개수는 그래프의 간선 개수와 같습니다. 그림 3의 예제는 두 노드가 하나의 간선으로 연결된 가장 단순한 그래프(●—●)를 가정합니다. 노드가 2개라도 두 노드가 연결되지 않으면 간선은 0개일 수 있지만, 자를 간선이 없으면 Max-Cut 문제가 성립하지 않으므로 여기서는 두 노드를 간선 하나로 연결한 경우를 예로 든 것입니다. 그래서 간선이 1개뿐이라 각 레이어에 ZZ도 하나만 있습니다. 회로 전체에는 ZZ가 두 번 나타나지만, 이는 간선이 2개여서가 아니라 레이어가 2개여서 같은 연산이 반복되기 때문입니다. 이 ZZ 연산은 두 큐비트의 값이 같은지 다른지에 따라 각 조합에 서로 다른 ‘표시(위상)’를 부여합니다. 채점기가 각 조합에 점수를 매겨 두는 것과 같습니다. 예를 들어,
- 0번째 큐비트 = 0, 1번째 큐비트 = 1 (서로 다른 그룹, 간선이 절단됨) → “좋은 조합”이라는 표시를 부여합니다
- 0번째 큐비트 = 0, 1번째 큐비트 = 0 (같은 그룹) → “나쁜 조합”이라는 표시를 부여합니다
- 0번째 큐비트 = 1, 1번째 큐비트 = 1 (같은 그룹) → “나쁜 조합”이라는 표시를 부여합니다
- 0번째 큐비트 = 1, 1번째 큐비트 = 0 (서로 다른 그룹, 간선이 절단됨) → “좋은 조합”이라는 표시를 부여합니다
즉, 이 연산은 어느 두 노드가 연결되어 있는지(그래프 구조)를 반영하여, 우리가 풀고자 하는 문제의 조건을 양자 회로에 내재화합니다. 단, 이 단계에서 좋은 조합이 바로 선택되는 것은 아니며 표시만 부여됩니다. 두 번째 연산인 RX(2β)는 믹서 해밀토니언에 해당하는 회전 연산으로, 각 큐비트의 상태를 변화시켜 새로운 분할을 탐색하게 합니다. 이때 앞 단계에서 부여된 표시가 작용하여, 좋은 조합이 측정될 확률은 커지고 나쁜 조합의 확률은 작아지는 방향으로 상태가 변화합니다. 여기서 확률이 변하는 원리는 좋은 조합과 나쁜 조합에 부여된 위상이 서로 간섭(interference)을 일으키기 때문이며, 이러한 확률 집중은 한 번의 연산으로 완성되지 않고 레이어를 여러 번 반복하고 파라미터를 조정하는 과정을 거쳐 서서히 이루어집니다. 두 연산의 효과는 각각 파라미터 γ와 β에 따라 달라지며, 이 값을 적절히 결정하는 것이 고전 컴퓨터의 역할입니다.
두 레이어를 모두 거친 뒤 마지막으로 큐비트를 측정하면 하나의 분할(비트 문자열)이 얻어집니다. 이 실행과 측정을 여러 번 반복(예를 들면 1000번)해 얻은 분포로부터 에너지 평균을 계산하고, 고전 컴퓨터는 그 값을 낮추는 방향으로 파라미터를 조정합니다. 이 조정을 언제까지 반복할지는 고전 옵티마이저가 정하는데, 정해진 횟수만큼만 반복하거나 값이 더 이상 낮아지지 않고 수렴하면 멈추는 등 여러 방식이 있습니다. 이 블로그의 코드는 정해진 반복 횟수(n_iterations)만큼 반복하는 방식을 사용합니다. 그림3은 설명을 위한 가장 간단한 형태이며, 실제로는 레이어 수를 2개 이상으로 늘릴 수 있습니다.
정리하면, 이 회로는 큐비트를 중첩 상태로 준비한 뒤, 문제의 조건을 반영하는 연산(ZZ)과 새로운 해를 탐색하는 연산(RX)을 레이어 수만큼 반복하고, 마지막에 측정해 결과를 얻는 구조입니다.
QAOA의 ‘레이어’는 양자 회로에서 같은 구조의 블록을 여러 번 반복하는 것을 의미합니다. 즉, 비용 해밀토니언(ZZ)과 믹서 해밀토니언(RX)을 한 번씩 적용하는 과정을 한 단위로 보고, 이 단위를 여러 번 반복하는 구조입니다. 레이어를 여러 번 쌓는 이유는 ‘위상 부여’와 ‘상태 혼합’을 반복할수록 좋은 분할의 확률을 더 크게 높일 수 있기 때문입니다. 게임에서 기회를 여러 번 부여하면 점차 더 좋은 점수를 얻을 수 있는 것과 유사합니다. QAOA에서는 이 레이어의 개수(p)를 조절할 수 있으며, 레이어가 많을수록 더 정교하게 해를 탐색할 수 있습니다.
그러나 레이어가 많아질수록 양자 회로는 복잡해지며, 두 가지 문제가 생깁니다. 첫째, 레이어가 늘어나면 조정해야 할 파라미터(γ, β)도 함께 늘어납니다. 이에 따라 한 번의 최적화에 드는 계산량이 커질 뿐 아니라, 파라미터 공간의 차원이 높아져 지역 최솟값이 많아지고 좋은 값을 찾기가 더 어려워집니다. 둘째, 회로 실행 시간이 길어지므로 실제 양자 하드웨어에서는 잡음과 오류가 누적되어 결과가 부정확해질 위험이 커집니다. 즉, 레이어를 많이 쌓으면 더 좋은 해를 찾을 가능성은 높아지지만, 계산이 복잡해지고 하드웨어 오류에 취약해지는 단점이 있습니다.
표2처럼 p=3이면 고전 컴퓨터는 감마 3개와 베타 3개, 총 6개의 파라미터를 양자 회로에 전달합니다. 각 레이어는 자신만의 감마와 베타 값을 사용하며, 고전 컴퓨터는 이 6개 값을 하나의 벡터로 관리하면서 최적화 루프를 돌며 계속 갱신합니다.
| 레이어 수(p) | 필요한 파라미터 | 총 개수 |
|---|---|---|
| 1 | γ1, β1 | 2 |
| 2 | γ1, β1, γ2, β2 | 4 |
| 3 | γ1, β1, γ2, β2, γ3, β3 | 6 |
<표2. 레이어 개수에 비례하는 파라미터의 개수>
이러한 QAOA 레이어는 run_qaoa 함수 안에서 아래와 같이 정의되며, PennyLane이 제공하는 cost_layer와 mixer_layer 함수를 그대로 사용합니다.
전체 양자 회로의 정의(구현)
아래 circuit(parameters) 함수는 앞에서 정의한 레이어를 이용해 QAOA 양자 회로 전체를 구성합니다.
이 함수는 먼저 그래프의 노드 수(num_nodes)만큼 큐비트를 사용하고, 각 큐비트에 Hadamard 게이트를 적용해 모든 큐비트를 중첩 상태로 만듭니다. 그림3에서 설명한 것처럼, 이 단계에서 가능한 모든 분할이 같은 확률로 포함된 출발 상태가 만들어집니다.
이어서 qml.layer 함수로 앞에서 정의한 qaoa_layer를 p번 반복해 적용합니다. 한 레이어는 비용 해밀토니언(ZZ)과 믹서 해밀토니언(RX) 연산으로 구성되며, 레이어마다 서로 다른 감마(parameters[0])와 베타(parameters[1]) 값이 적용됩니다. 이 값들이 고전 컴퓨터가 최적화 과정에서 조정하는 대상입니다. qml.layer는 PennyLane에 내장된 함수로, 주어진 연산 블록을 지정한 횟수만큼 반복 적용해 주는 역할을 합니다. 따라서 코드에서 별도로 정의하지 않고 바로 사용할 수 있으며, 자세한 내용은 PennyLane 공식 문서에서 확인할 수 있습니다.
정리하면 이 함수는 모든 큐비트를 중첩 상태로 만든 뒤 그 위에 QAOA 레이어를 p개 쌓는, 그림3의 회로를 코드로 옮긴 것입니다.
비용 함수의 정의
비용 함수(cost_function)는 주어진 파라미터로 양자 회로를 실행하고, 그 결과가 얼마나 좋은지를 하나의 숫자로 평가하는 함수입니다. 앞 절에서 설명한 “에너지 평균”을 계산하는 함수가 바로 이것입니다.
이 함수는 입력받은 파라미터로 앞에서 정의한 circuit을 실행한 뒤, 비용 해밀토니언(cost_h)의 기댓값을 계산해 반환합니다. 기댓값은 회로가 만들어 내는 분할들의 에너지 평균에 해당하므로, 이 값이 낮을수록 좋은 분할이 더 자주 나오는 상태라는 뜻입니다.
고전 컴퓨터의 옵티마이저는 파라미터를 조금씩 바꾸면서 이 함수를 반복 호출하고, 반환값이 낮아지는 방향을 찾아갑니다. 즉, cost_function은 QAOA에서 현재 파라미터의 품질을 평가하는 기준입니다.
비용 함수의 최적화 과정
최적화를 시작하려면 먼저 파라미터 감마(γ)와 베타(β)의 초기값이 필요합니다. np.random.seed(42)는 난수 생성의 시작점을 고정해 실행할 때마다 같은 초기값이 나오도록 합니다. 42는 임의로 정한 숫자입니다.
np.random.uniform(size=[2, p])는 0과 1 사이의 값을 균등하게 뽑아 2행 p열의 배열을 만듭니다. 첫 행이 감마, 둘째 행이 베타이며, 각 행의 길이는 레이어 수 p와 같습니다(그림4는 p=2인 경우입니다). 여기에 0.01을 곱해 작은 값으로 시작하는 이유는, 초기 파라미터가 크면 최적화가 불안정해질 수 있기 때문입니다. requires_grad=True는 이 배열을 PennyLane이 기울기를 계산할 수 있는 형태로 만들어 줍니다. 여기서 기울기(gradient)란 파라미터를 조금 바꿨을 때 에너지 값이 어느 방향으로 얼마나 변하는지를 나타내는 값으로, 옵티마이저는 이 기울기를 이용해 에너지가 낮아지는 쪽으로 파라미터를 조정합니다. 즉 requires_grad=True는 이 파라미터가 고정된 상수가 아니라 학습을 통해 갱신할 대상임을 PennyLane에 알려 주는 표시이며, 이 표시가 있어야 PennyLane이 자동 미분으로 기울기를 구해 줍니다.
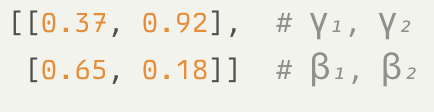
<그림4. 2개의 레이어를 갖는 QAOA 회로에서의 초기화된 파라미터(γ, β)>
이렇게 만든 초기 파라미터를 바탕으로 PennyLane의 경사 하강법(Gradient Descent) 옵티마이저로 최적화를 시작합니다. 옵티마이저는 매 반복마다 비용 함수를 평가하고, 그 값이 낮아지는 방향으로 파라미터를 step_size(학습률)만큼 이동시킵니다.
step_and_cost는 현재 파라미터의 비용을 계산하고 파라미터를 한 걸음 갱신하는 일을 한 번에 수행합니다. 여기서 ‘한 걸음(step)’이란 기울기가 가리키는 방향으로 파라미터를 조금씩 이동하는 것으로, 이 호출을 반복 횟수만큼 되풀이하며 파라미터를 점차 개선합니다. 이때 함께 반환되는 비용(코드의 cost_before)은 갱신하기 직전의 파라미터로 계산한 값이므로, 방금 갱신된 새 파라미터의 비용이 아니라는 점에 유의합니다. 반복마다 비용 값을 log_metric으로 기록하기 때문에, 하이브리드 잡으로 실행하면 Amazon Braket 콘솔에서 최적화가 진행되는 모습을 그래프로 확인할 수 있습니다. 그림5는 이 반복 과정에서 고전 컴퓨터와 양자 회로가 데이터를 주고받는 구조를 보여줍니다.
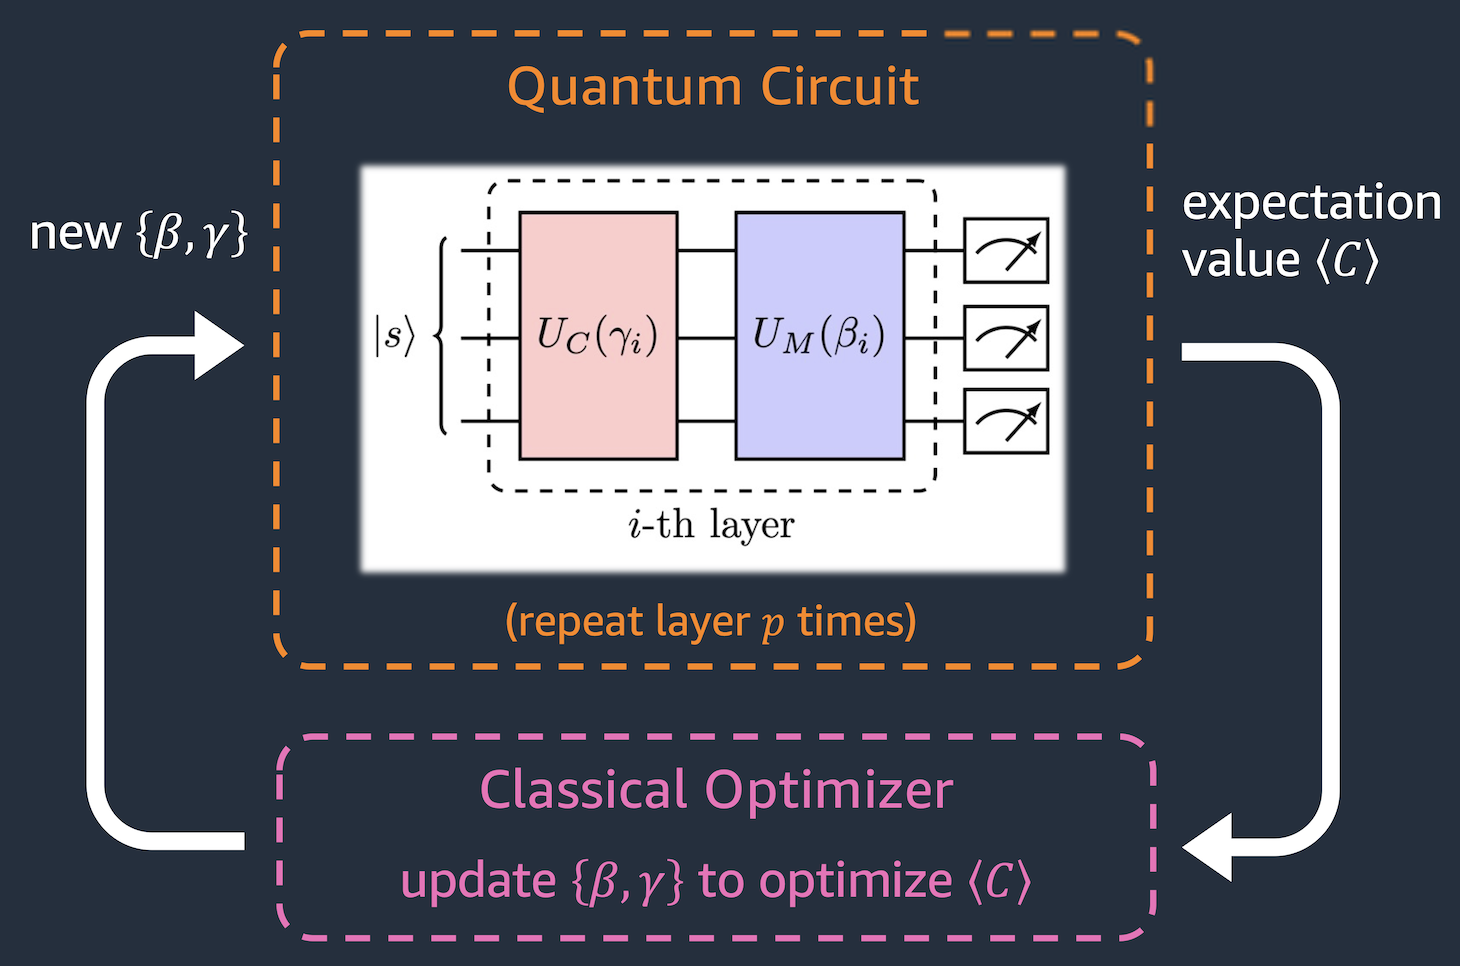
<그림5. QAOA를 이용한 하이브리드 연산 원리>
최적화가 끝나면 찾은 최종 파라미터로 두 가지를 확인합니다. 첫째, 그 파라미터로 비용 함수를 한 번 더 평가하면 앞에서 설명한 ‘에너지 평균’의 최종값이 나옵니다. 이는 하나의 숫자로, 알고리즘이 얼마나 좋은 해에 도달했는지를 나타내는 품질 지표입니다. 둘째, 같은 파라미터로 회로를 실행해 각 비트 문자열(분할)의 확률 분포를 구하면, 실제로 어떤 분할이 자주 관측되는지를 확인할 수 있습니다. 즉 에너지 평균이 ‘해의 품질을 하나의 점수로 요약한 값’이라면, 확률 분포는 ‘어떤 분할이 유력한 후보인지’를 보여 주는 값입니다.
정리하면 이 코드는 양자 회로 실행과 고전 최적화를 번갈아 수행하는 하이브리드 양자-고전 최적화 루프입니다. 여러 번의 실험(양자 회로 실행)과 결과 분석(비용 계산)을 반복하면서 점차 최적의 레시피(파라미터)를 찾아가는 요리 실험에 비유할 수 있습니다.
이 절차를 3단계로 정리하면 다음과 같습니다.
- 양자 회로 실행: 현재 γ/β로 회로를 실행 → 비용 계산
- 옵티마이저 작동: 계산된 비용으로 γ/β 조정
- 반복: 새로운 γ/β로 다시 양자 회로 실행 → 최적 해 찾을 때까지 반복
비트 문자열의 계산
최적화가 끝나면 최적화된 파라미터로 양자 회로를 다시 실행합니다. 이번에는 에너지 평균(기댓값)이 아니라, 각 비트 문자열(예: ‘00011’)이 측정될 확률을 구합니다. @qml.qnode(device)는 PennyLane에서 함수 안의 회로를 지정한 디바이스(device)에서 실행하도록 연결하는 데코레이터입니다.
sampled_probs 함수는 최적화된 파라미터로 회로를 실행한 뒤, qml.probs()로 가능한 모든 비트 문자열의 측정 확률을 반환합니다.
이어서 큐비트 수(num_nodes)에 맞는 모든 비트 문자열을 생성해 확률과 짝지어 딕셔너리로 만듭니다. 큐비트가 3개라면 ‘000’부터 ‘111’까지 8가지, 이 글의 그래프처럼 5개라면 32가지 비트 문자열이 만들어집니다. 각 비트 문자열이 하나의 분할이므로, 이 딕셔너리가 곧 “어떤 분할이 어느 확률로 나오는가”를 담은 최종 결과입니다.
get_device_instance 함수
get_device_instance 함수는 양자 회로를 실행할 디바이스를 준비합니다. 디바이스는 로컬 시뮬레이터일 수도 있고, Amazon Braket의 온디맨드 시뮬레이터나 실제 양자 하드웨어(QPU)일 수도 있습니다.
이 함수는 디바이스를 구분하는 식별자 device_arn을 입력받습니다. 값이 “local:”로 시작하면(예: “local:pennylane/lightning.qubit”) 알고리즘 코드와 같은 컴퓨터에서 동작하는 PennyLane 로컬 시뮬레이터를 의미하며, 이 경우 PennyLane 디바이스를 이름으로 직접 불러옵니다.
그렇지 않으면 Amazon Braket의 온디맨드 시뮬레이터나 QPU의 ARN으로 간주하고, PennyLane-Braket 플러그인의 “braket.aws.qubit” 디바이스를 통해 클라우드에서 회로를 실행하도록 설정합니다.
그 외 인자로 큐비트 수(n_wires), 측정 횟수(n_shots), 그리고 Braket 디바이스에 동시에 제출할 수 있는 최대 태스크 수(max_parallel)를 지정할 수 있습니다. 이때 n_shots를 지정하지 않으면(None) 로컬 시뮬레이터는 측정을 샘플링하지 않고 기댓값을 정확히 계산하며, 값을 주면 그 횟수만큼 측정을 반복해 표본으로 추정합니다. 실제 QPU나 온디맨드 시뮬레이터에서는 측정이 본질적으로 확률적이므로 보통 이 측정 횟수를 지정합니다.
디바이스를 준비한 뒤에는 선택된 디바이스 이름, 큐비트 수, 측정 횟수를 출력하고 디바이스 객체를 반환합니다.
이렇게 디바이스 선택을 함수 하나로 분리해 두면, device_arn 문자열 한 줄만 바꿔서 로컬 시뮬레이터, 클라우드 시뮬레이터, 실제 QPU를 번갈아 사용할 수 있습니다. 2부에서 실행 환경을 바꿀 때 이 점을 활용합니다.
맺음말
이번 1부에서는 Max-Cut 문제가 무엇인지, 그리고 QAOA가 이 문제를 어떻게 풀어 가는지를 살펴보았습니다. 핵심은 세 가지입니다. 첫째, Max-Cut의 목적함수를 비용 해밀토니언으로 바꾸면 “컷을 최대화하는 문제”가 “에너지를 최소화하는 문제”로 바뀝니다. 둘째, QAOA 회로는 비용 레이어와 믹서 레이어를 p번 반복하는 구조이며, 각 레이어의 파라미터 γ, β를 고전 옵티마이저가 조정합니다. 셋째, 비용 함수가 반환하는 기댓값은 측정 확률로 가중한 평균 컷 크기의 음수이므로, 이 값이 낮아질수록 좋은 분할이 더 자주 관측됩니다.
코드 측면에서는 그래프 생성(graph.adjlist), 해밀토니언 구성, 양자 회로와 비용 함수 정의, 경사 하강법 최적화, 비트 문자열 확률 계산, 그리고 디바이스를 선택하는 get_device_instance까지 maxcut_qaoa 모듈의 구성 요소를 하나씩 확인했습니다. 특히 디바이스 선택을 함수 하나로 분리해 둔 덕분에 device_arn 한 줄만 바꾸면 같은 코드를 로컬 시뮬레이터, 클라우드 시뮬레이터, 실제 QPU에서 그대로 실행할 수 있습니다.
2부에서는 바로 이 점을 활용해 같은 코드를 세 가지 방식으로 실행합니다. 하이브리드 잡을 사용하지 않는 로컬 실행, Amazon Braket 하이브리드 잡과 임베디드 시뮬레이터, 그리고 하이브리드 잡과 온디맨드 시뮬레이터(SV1)입니다. 각 방식에서 고전 계산과 양자 계산이 어디에서 수행되고, 콘솔에서 무엇을 확인할 수 있으며, 과금과 지연 특성이 어떻게 달라지는지 비교해 보겠습니다.