O blog da AWS
Como o Nubank processa 1 trilhão de logs diariamente na AWS
Por Beca Maia, Gerente de Engenharia no Nubank; Otavio Valadares, Lead Software Engineer do Nubank; Diego Rocha, Arquiteto de Soluções Sênior na AWS; Renata Balthazar, Senior Customer Solutions Manager na AWS; Danilo Gouveia, Principal Technical Account Manager na AWS e Edgar Costa Filho, Arquiteto de Soluções Sênior ns AWS.
Sobre o Nubank
O Nubank atende a mais de 140 milhões de clientes, guiado por uma missão de combater a complexidade e empoderar pessoas. A empresa vem liderando uma transformação no setor por meio de produtos inovadores e serviços focados nos clientes.
Tecnologia proprietária e dados em escala impulsionam a plataforma digital do Nubank, construída para promover acesso, avanço financeiro e transparência. O modelo de negócios prospera graças à satisfação do cliente e a custos mais baixos, alimentando uma roda (flywheel) de crescimento e rentabilidade.
O desafio
Conforme o Nubank cresceu rapidamente de 2019 a 2023, a infraestrutura de logs existente começou a mostrar sinais de sobrecarga. A empresa processava aproximadamente 55 TB de logs por dia em 2021, com uma taxa de crescimento de quase 100% ano a ano. Esse crescimento exponencial gerou desafios:
Dependência com fornecedor externo
A arquitetura anterior do Nubank dependia de uma solução de logging de terceiros. Cada aplicação enviava logs diretamente para a plataforma do fornecedor usando forwarders proprietários. Múltiplas fontes internas enviavam dados diretamente para a API do fornecedor sem camada de controle intermediária. Essa dependência criou riscos operacionais:
- Sem portabilidade: Alertas, dashboards e todos os dados armazenados existiam exclusivamente no ambiente do fornecedor, tornando qualquer migração praticamente inviável.
- Sem soberania digital de dados: A equipe não tinha como filtrar, agregar, rotear ou aplicar lógica de negócio sobre os dados recebidos antes que saíssem da infraestrutura.
- Vendor lock-in: Trocar de solução exigia reescrever integrações em milhares de microsserviços.
- Extensibilidade limitada: Qualquer novo requisito de processamento dependia das capacidades e do roadmap do fornecedor.
- Falta de observabilidade: mais de 40% dos logs se perdiam entre a origem e o destino, deixando pontos cegos críticos durante incidentes.
Custos Imprevisíveis e Crescentes
O Nubank não tinha previsibilidade em relação aos custos, tornando impossível planejar gastos de forma eficaz. Esse custo se tornou um dos maiores componentes de custo no orçamento de infraestrutura, tornando a plataforma insustentável a longo prazo.
Processos de Ingestão e Consulta Acoplados
A arquitetura existente não separava as cargas de trabalho de ingestão das de consulta. Alta carga durante a ingestão impactava diretamente a performance de consultas, e vice-versa. Esse acoplamento dificultava a otimização de qualquer processo independentemente e levava a uma experiência degradada durante períodos de pico de tráfego.
Solução: Construindo o Alexandria
Diante desses desafios, o Nubank tomou a decisão estratégica de construir uma plataforma interna de logs. A equipe a nomeou Alexandria, em referência à antiga Biblioteca de Alexandria, uma metáfora adequada para um sistema projetado para coletar, preservar e fornecer acesso a vastas quantidades de informação. O Nubank dividiu este projeto em dois componentes principais para torná-lo mais gerenciável.
Streaming: Ingestão e processamento
A primeira prioridade foi construir uma plataforma robusta de ingestão. Isso permitiu à equipe iniciar a migração sem interromper significativamente a experiência do desenvolvedor, além de possibilitar a coleta de métricas sobre seus dados para apoiar melhores decisões durante o desenvolvimento da plataforma de armazenamento. Um dos desafios enfrentados pela equipe era como transferir uma grande quantidade de dados na nuvem de forma confiável, respeitando os requisitos de custos.
Diagrama de arquitetura parcial
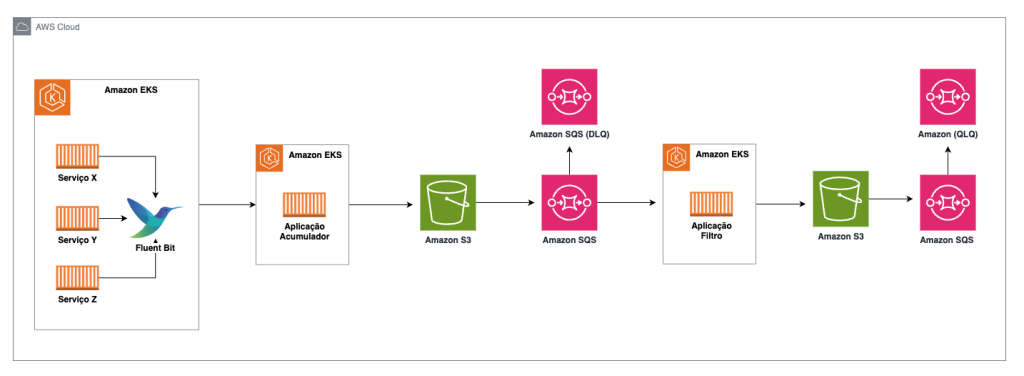
A solução foi construir um protocolo de micro-batches de dados usando Amazon Simple Storage Service (Amazon S3) e Amazon Simple Queue Service (Amazon SQS) em toda a plataforma. Além do Amazon Elastic Kubernetes Service (Amazon EKS), que é o serviço padrão de execução de microsserviços do Nubank. O Amazon EKS fornece a orquestração de contêineres com integração com o IAM para controle de acesso granular e isolamento de workloads via namespaces. Sobre essa base, o Nubank instala e opera projetos de código aberto do ecossistema da Cloud Native Computing Foundation (CNCF), como o Karpenter para escalabilidade elástica, essencial para absorver picos de ingestão, e o Fluent Bit para coleta e roteamento de logs.
O Amazon S3 fornece armazenamento durável e escalável para os micro-batches, enquanto o Amazon SQS desacopla os estágios do pipeline, permitindo que cada componente escale de forma independente e absorva picos de tráfego com mecanismos para evitar perda de dados. Ambos os serviços seguem um modelo de pagamento sob demanda, em que o custo cresce proporcionalmente ao uso real, volume armazenado no S3 e número de requisições no SQS.
Como funciona o pipeline de ingestão
Cada aplicação rodando nos nós do Amazon EKS gera dados de log continuamente. Um DaemonSet Fluent Bit coleta esses dados, acumula por alguns segundos e os encaminha para o Serviço Acumulador.
Serviço Acumulador: O ponto de entrada da plataforma. Recebe micro-batches de dados, faz upload para o Amazon S3 e notifica uma fila Amazon SQS sobre a criação de cada arquivo. Em 2025, esse componente sustentou picos de até 55 GB por segundo.
Serviço de Filtro: Baixa os chunks de dados do S3, aplica regras de negócio para filtragem, executa enriquecimentos e coleta métricas operacionais. Desenvolvido internamente pela equipe, foi projetado para extensibilidade: adicionar novas regras ou métricas exige mudanças mínimas.
Alexandria: Armazenamento e consulta
Com a ingestão resolvida, o próximo desafio era armazenar e consultar mais de um petabyte de logs gerados diariamente de forma confiável e econômica. O Nubank escolheu o Amazon S3 como camada de armazenamento central. O S3 é projetado para oferecer 11 noves de durabilidade (99,999999999%), um requisito crítico para uma plataforma de serviços financeiros que opera em múltiplas jurisdições e precisa garantir retenção de dados compatível com exigências regulatórias e de auditoria em cada país, além de um modelo de custo sob demanda, proporcional ao volume armazenado e ao número de operações realizadas.
O Nubank selecionou o Apache Parquet como formato de armazenamento de dados. Esta decisão foi motivada pelo armazenamento colunar do Parquet, que oferece alto desempenho nas consultas e permite armazenamento econômico devido à taxa de compressão em torno de 95%.
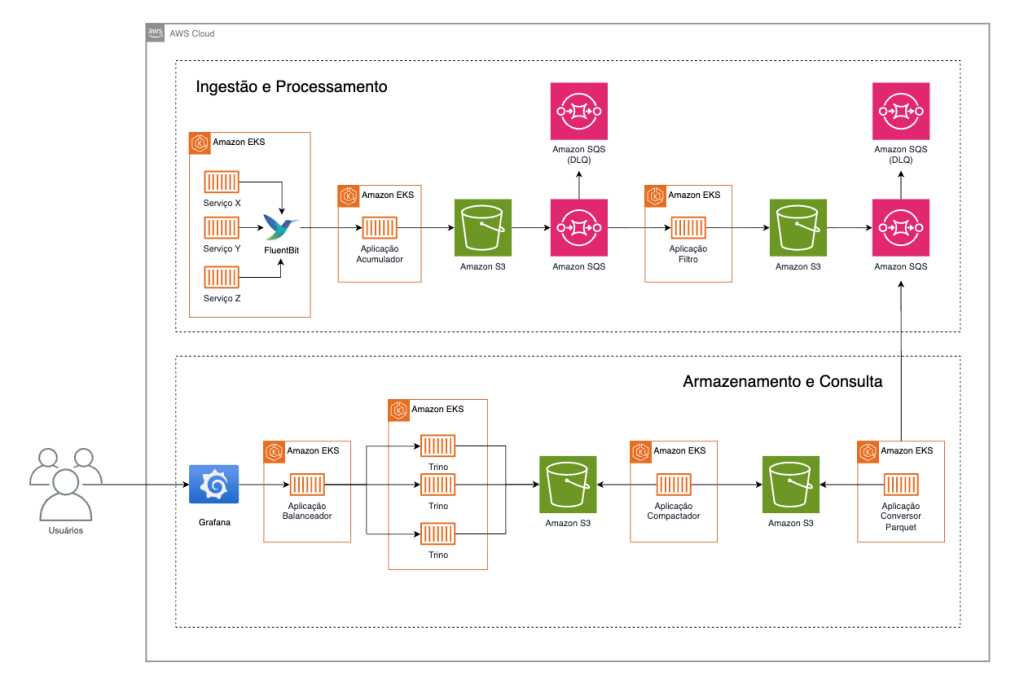
Conversão para Parquet: O Nubank criou uma solução interna que converte os dados recebidos da plataforma de ingestão para o formato colunar Apache Parquet e os armazena no S3.
Compactação contínua: A ingestão em quase tempo real (latência abaixo de 1 minuto) gerava mais de 500 mil arquivos pequenos por segundo nos horários de pico. Essa fragmentação degradava a performance de busca, já que o motor de consulta precisava abrir e processar cada arquivo individualmente. Para resolver isso, o Nubank desenvolveu um serviço de compactação contínua que consolida arquivos pequenos em blocos maiores e otimizados para leitura.
Com todos os dados no Amazon S3, a equipe selecionou o Trino como motor de consulta por alguns motivos:
- Particionamento nativo: Segmenta dados por nome de serviço e data, direcionando consultas apenas aos subconjuntos relevantes. Resultado: tempos de resposta menores e menor consumo de recursos.
- Leitura direta do S3: Consulta dados onde já estão armazenados, sem necessidade de banco de dados intermediário.
- Interface SQL: Engenheiros usam uma linguagem que já conhecem, reduzindo a curva de aprendizado e acelerando a adoção.
- Escalabilidade horizontal: A arquitetura distribuída do Trino cresce junto com o volume de dados, sem redesenho.
Padronização de logs
Para facilitar consultas e análises, o Nubank implementou um esquema padronizado de logs em 99% de seus microsserviços. O formato padrão inclui:
- Timestamp: O momento em que o log foi gerado.
- Body: A mensagem bruta do log.
- Service: O microsserviço que produziu o log.
- Type: O tipo do log (ex.: ERROR, INFO)
- Level: O nível de severidade.
- CID: ID de correlação para rastrear requisições entre serviços.
Essa padronização simplifica a consulta de logs. Um engenheiro investigando um incidente escreve, por exemplo:
SELECT * FROM nu.logs
WHERE
   service = 'my-service'
   AND type = 'ERROR'
   AND date = DATE '2025-09-25'
ORDER BY time DESC
Note que service e type são campos do esquema padronizado, enquanto date é uma coluna de partição derivada do Timestamp original. Essa separação é intencional: o campo date existe especificamente para otimizar o particionamento no S3.
Quando a consulta filtra por serviço e data, o Trino aproveita o particionamento para escanear apenas o prefixo relevante no S3, ignorando todo o restante. Menos dados lidos, resposta mais rápida.
Experiência do usuário: O Nubank construiu um plugin customizado do Grafana como interface de consulta, centralizando logs e métricas em uma única ferramenta. Para eliminar a verbosidade do SQL, a equipe desenvolveu uma Domain-Specific Language (DSL) que simplifica consultas comuns.
Diagrama de arquitetura final completa
Resultados
Desde meados de 2024, o Alexandria tem sido a plataforma padrão para armazenamento e consulta de logs no Nubank. Os resultados superaram as expectativas em múltiplas dimensões:
- Redução de 50% nos custos: O modelo de custos agora é previsível e diretamente vinculado ao uso real do Nubank, permitindo melhor planejamento financeiro.
- 1 trilhão de logs por dia: O Alexandria ingere mais de 1 trilhão de linhas de log diariamente.
- 1 petabyte ingerido diariamente: A plataforma processa um petabyte de dados brutos de log todos os dias.
- 55 GB/s de throughput de pico: Durante horários de pico, o sistema lida com taxas de ingestão de até 55 GB por segundo.
- 45 petabytes armazenados: Com um período de retenção de 45 dias, o Alexandria mantém 45 PB de dados pesquisáveis.
- 14.000 consultas diárias: Engenheiros realizam aproximadamente 14.000 buscas de log por dia.
- 150 petabytes escaneados diariamente: Essas consultas coletivamente varrem 150 PB de dados.
- Latência de ingestão abaixo de 1 minuto: A arquitetura escala elasticamente com a demanda, absorvendo variações significativas de tráfego sem degradação.
Conclusão
Escala muda as regras do jogo. Quando o volume de logs cresce 100% ao ano e ultrapassa um petabyte diário, soluções genéricas de mercado podem deixar de atender. O Alexandria prova que, nessa escala, construir internamente se torna um caminho viável, mas para seguir essa abordagem alguns pré-requisitos organizacionais e técnicos são importantes: volume de logs que justifique o investimento em plataforma própria, equipe dedicada de engenharia de plataforma e requisitos regulatórios que exijam soberania digital e controle total sobre os dados.
Alguns insights dessa jornada:
- Desacoplar ingestão de consulta é o que viabiliza escala previsível. Ao usar Amazon S3 como camada de persistência e Amazon SQS como barramento entre estágios, o Nubank eliminou a contenção entre workloads, permitindo que cada componente escale de forma independente, sem degradação mútua.
- Serviços gerenciados reduzem complexidade operacional, não controle. O Amazon EKS, S3 e SQS fornecem a infraestrutura elástica e durável, enquanto o Nubank mantém total controle sobre lógica de filtragem, enriquecimento, formato de dados e motor de consulta. Ciclos de melhoria levam dias, não meses.
- Formato de dados é decisão de arquitetura, não detalhe de implementação. A escolha de Apache Parquet com compactação contínua transformou um petabyte diário em 45 PB armazenados com retenção de 45 dias, uma taxa de compressão de 95% que viabiliza economicamente manter petabytes pesquisáveis.
- O que vem a seguir: O Alexandria evolui em duas frentes — expansão para novas Regiões da AWS com políticas de retenção adaptadas a cada jurisdição, e investigação de incidentes assistida por IA correlacionando logs, métricas e traces numa única narrativa de observabilidade.
O Alexandria mostra como serviços gerenciados da AWS, combinados com decisões de arquitetura como desacoplamento de estágios, formato colunar e escalabilidade elástica, transformam um petabyte diário de logs em dados pesquisáveis a custo previsível. Para aplicar padrões semelhantes na sua própria arquitetura, explore os recursos a seguir:
- Acione pipelines automaticamente quando novos objetos chegarem ao S3 — configure notificações de eventos do Amazon S3 para o Amazon SQS e elimine polling desnecessário entre estágios de ingestão.
- Evite perda de mensagens em filas de processamento — implemente filas de mensagens mortas (DLQ) do Amazon SQS para isolar e diagnosticar falhas sem bloquear o fluxo principal.
- Escale nós do cluster sob demanda — adote o Karpenter no Amazon EKS para provisionar instâncias EC2 em menos de um minuto, ajustando capacidade automaticamente aos picos de ingestão.
- Colete e roteie logs de contêineres com baixo overhead — implante o Fluent Bit como DaemonSet no Amazon EKS para capturar logs de todos os pods e encaminhá-los ao destino de armazenamento escolhido.
Sobre os Autores
 |
Beca Maia é Gerente de Engenharia no Nubank, com mais de 10 anos de experiência em engenharia de plataformas, DevOps, SRE e observabilidade. Atualmente, trabalha na área de Core Banking do Nubank, contribuindo para plataformas de missão crítica que dão suporte às operações financeiras e integrações com redes externas. Anteriormente, liderou a base de observabilidade do Nubank, supervisionando plataformas de registro e rastreamento em larga escala e a experiência de observabilidade interna utilizada por milhares de engenheiros. Apaixonada por automação, infraestrutura como código e sistemas de nuvem escaláveis, Beca é motivada pela construção de plataformas resilientes e por ajudar pessoas e equipes a prosperarem. |
 |
Otavio Valadares é Lead Software Engineer e trabalha na equipe de confiabilidade do Nubank há mais de cinco anos. É um líder técnico especializado no desenvolvimento de aplicações altamente escaláveis. Seu foco é projetar ferramentas que gerenciem com eficiência os enormes fluxos de dados de observabilidade do banco, contribuindo para a infraestrutura de observabilidade da equipe, que garante o bom funcionamento de toda a extensa infraestrutura do banco. Fora do trabalho, Otavio gosta de videogames e esportes. |
 |
Diego Rocha é Arquiteto de Soluções Sênior na AWS, auxiliando clientes a projetar arquiteturas em nuvem escaláveis, resilientes e com custos otimizados, além de impulsionar a adoção de IA Generativa. Ele possui experiência em infraestrutura, DevOps e código aberto (Open Source), com foco em Kubernetes e cloud-native. |
 |
Renata Balthazar é Senior Customer Solutions Manager na AWS, onde ela trabalha em parceria com uma das maiores instituições financeiras da América Latina em suas transformações para a nuvem. Ela traz consigo vasta experiência em orientar as partes interessadas em iniciativas complexas, desde a modernização até a inovação impulsionada por IA, gerando resultados de negócios mensuráveis. |
 |
Danilo Gouveia é Principal Technical Account Manager na AWS, baseado em São Paulo, Brasil. Com mais de uma década de experiência na Amazon, ele auxilia equipes executivas dos maiores clientes de serviços financeiros da América Latina, atuando na interseção de arquitetura em nuvem, estratégia de IA generativa e engenharia de resiliência em hiperescala. |
 |
Edgar Costa Filho é Arquiteto de Soluções Sênior com foco em Fundações e Contêineres, incluindo expertise na integração do Amazon EKS com ferramentas como Crossplane, Terraform e GitOps. Em seu papel, Edgar se dedica a ajudar os clientes a alcançar seus objetivos de negócios implementando as melhores práticas em design e gestão de infraestrutura em nuvem. |