O blog da AWS
Melhorando a latência de funções Lambda com largura de banda de rede escalável
Por Rahul Shandilya, James Ngai e Sahil Bhimjiani, na Amazon Web Services.
O AWS Lambda agora oferece suporte a largura de banda de rede escalável para funções configuradas com 2.048 MB de memória ou mais, executadas fora de uma virtual private cloud (VPC). Anteriormente, a taxa de transferência de rede sustentada era limitada a 625 Mbps, independentemente da configuração de memória da sua função. Agora, a taxa de transferência sustentada escala proporcionalmente de 625 Mbps em configurações abaixo de 2.048 MB até 3.000 Mbps em 10.240 MB, aumentando a taxa na qual os dados se movem para dentro e fora do seu ambiente de execução.
Nesta publicação, você aprenderá a aplicar esse novo recurso a workloads de processamento de dados sensíveis à latência, ajudando a reduzir os tempos de execução das funções e os custos por invocação, além de melhorar a experiência do usuário final por meio da redução da latência. Você também percorrerá uma implementação implantável que demonstra as melhorias de desempenho que esse recurso viabiliza.
Processamento de dados sensível à latência
Aplicações de processamento de dados sensíveis à latência são workloads de processamento de dados que precisam ser concluídas em um período de tempo definido. Elas frequentemente enfrentam padrões de tráfego intermitentes e ad hoc, ao mesmo tempo em que precisam baixar gigabytes ou até terabytes de dados de um data store, processá-los em um ambiente de computação e retornar um resultado a um usuário final que está aguardando.
O processamento de dados sensível à latência é frequentemente altamente paralelizável. Os dados podem ser divididos em partes menores, com cada parte sendo processada individualmente antes de serem combinadas para obter um resultado.
Esses workloads podem ser encontrados em vários setores e verticais. Exemplos incluem:
- Mecanismos de consulta de logs – Um usuário final inicia uma busca sob demanda em terabytes de dados de log e espera resultados em segundos.
- Subscrição de seguros – Um cliente em potencial envia uma solicitação, disparando a avaliação em tempo real de dados históricos de sinistros e risco. O processo de subscrição determina quais coberturas e prêmios oferecer ao cliente em potencial.
- Pipelines de ETL financeiro – Um anúncio econômico dispara um pico inesperado de dados de mercado que precisam ser ingeridos, transformados e disponibilizados para sistemas de negociação downstream antes do próximo tick do mercado.
- Plataformas de genômica – Um clínico solicita um exame diagnóstico, exigindo que gigabytes de dados de sequenciamento de DNA ou RNA passem por um pipeline de bioinformática e sejam comparados a um genoma de referência enquanto o paciente aguarda os resultados.
Esses workloads são desafiadores de construir em clusters de computação tradicionais. Sua natureza instável e imprevisível o força a escolher entre subprovisionar a computação para otimizar custos (correndo o risco de não atender ao SLA) ou superprovisionar e pagar por capacidade ociosa.
Por que o Lambda se encaixa no processamento de dados sensível à latência
O Lambda elimina esse trade-off. Em vez de provisionar previamente um cluster de computação, o Lambda escala a capacidade de computação em resposta às solicitações recebidas, ajustando o poder de processamento a padrões de tráfego imprevisíveis. Como o processamento de dados sensível à latência é altamente paralelizável, a capacidade do Lambda de escalar rapidamente ambientes de execução o torna uma opção natural. Você pode distribuir a carga entre milhares de funções simultâneas para processar dados em paralelo, pagando apenas pela computação que utiliza.
No entanto, à medida que o volume de dados e os requisitos de desempenho aumentam, a largura de banda de rede para dentro e fora do ambiente de computação pode se tornar o fator limitante na minimização da latência do workload.
A largura de banda de rede escalável resolve diretamente essa limitação ao elevar o teto de taxa de transferência de rede por ambiente, melhorando a taxa na qual os dados podem ser transferidos para dentro e fora do ambiente de execução. Cada ambiente de execução agora pode alcançar até 3.000 Mbps de taxa de transferência sustentada quando configurado com 10.240 MB de memória, um aumento de 4,8x em relação ao teto anterior de 625 Mbps. Combinado com a capacidade do Lambda de escalar na taxa de 1.000 ambientes de execução a cada 10 segundos, você pode baixar mais de 3 TB de dados em menos de 10 segundos.
Novo comportamento de taxa de transferência de rede para funções Lambda
A largura de banda de rede escalável se aplica tanto ao tráfego de entrada quanto ao de saída de um ambiente de execução para funções fora de uma VPC. Para funções configuradas com 2 GB de memória ou mais, a largura de banda de rede escala em incrementos de aproximadamente 280 Mbps para cada 1 GB adicional de memória alocado.
A tabela a seguir mostra a largura de banda sustentada máxima disponível para cada ambiente de execução em cada configuração de memória.
| Configuração de Memória | Largura de Banda Sustentada Máxima |
| Menos de 2.048 MB | 625 Mbps |
| 2.048 MB | 765 Mbps |
| 3.072 MB | 1.044 Mbps |
| 4.096 MB | 1.324 Mbps |
| 5.120 MB | 1.603 Mbps |
| 6.144 MB | 1.883 Mbps |
| 7.168 MB | 2.162 Mbps |
| 8.192 MB | 2.441 Mbps |
| 9.216 MB | 2.721 Mbps |
| 10.240 MB | 3.000 Mbps (aumento de 4,8x) |
Tabela 1. Largura de banda de rede sustentada do Lambda por configuração de memória. A largura de banda escala em ~280 Mbps por GB adicional de memória acima de 2 GB.
Na seção a seguir, você aprenderá como a largura de banda de rede escalável melhora a latência do usuário final por meio da construção de um pipeline de ETL que demonstra isso. Você pode encontrar o código-fonte no repositório do GitHub.
Visão geral da solução
Considere uma plataforma de análise SaaS na qual os usuários enviam consultas ad hoc a um data store. A aplicação precisa extrair os dados relevantes, aplicar um filtro ou transformação e retornar um resultado agregado enquanto o usuário aguarda. Neste exemplo, o resultado precisa ser retornado em 8 segundos ou menos.
O diagrama a seguir ilustra a arquitetura da solução.
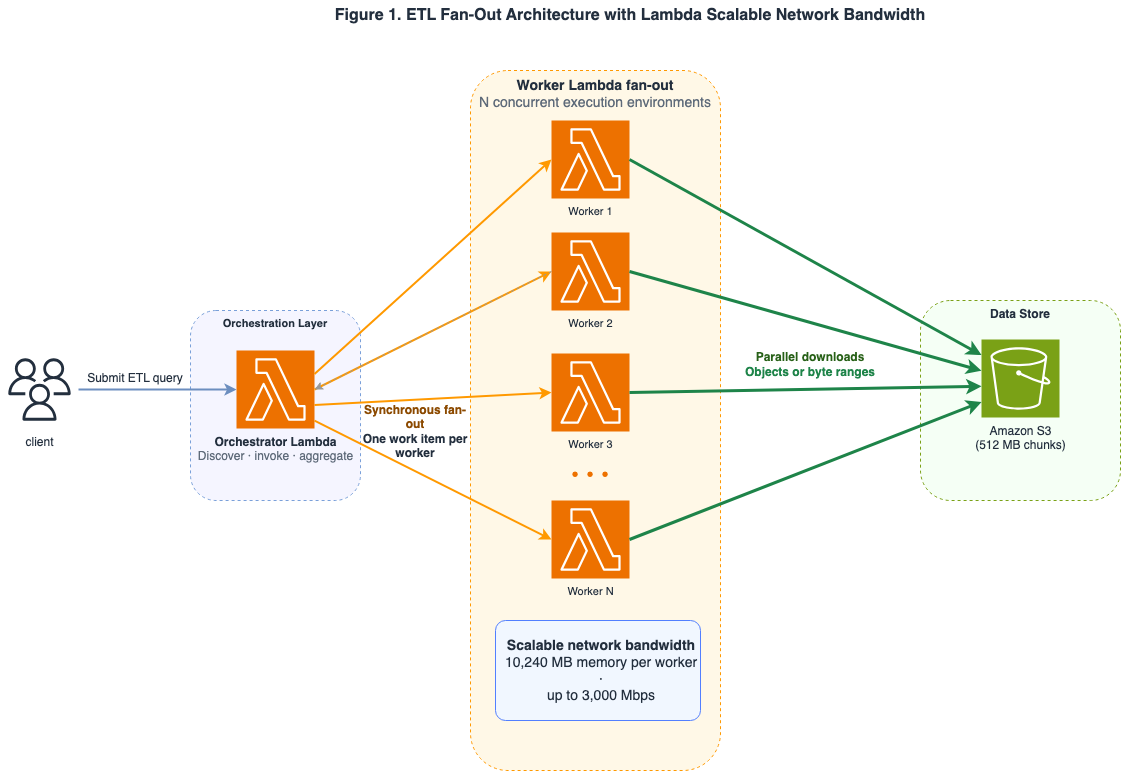
Figura 1. Padrão de fan-out de ETL: uma função orquestradora do Lambda distribui trabalho para múltiplas funções worker do Lambda que leem do Amazon S3 em paralelo, com indicações de escalonamento de largura de banda por nível de memória.
Um cliente inicia uma consulta ad hoc chamando a função orquestradora do Lambda por meio da API do Lambda. A função orquestradora determina como dividir o trabalho. Para processar os dados em paralelo, a função orquestradora usa um ThreadPoolExecutor para emitir solicitações de invocação síncronas para a função worker do Lambda, distribuindo o worker em múltiplos ambientes de execução simultaneamente.
Cada função worker do Lambda é configurada com 10.240 MB de memória, portanto, tem acesso a até 3.000 Mbps de taxa de transferência de rede sustentada. Após o processamento dos dados, o resultado agregado é retornado ao cliente.
Pré-requisitos
Antes de iniciar o processo de implantação, certifique-se de ter concluído as seguintes etapas:
- Instale a AWS SAM CLI em seu computador e confirme que está executando o Python 3.12 ou posterior.
- Tenha as credenciais da sua conta da AWS prontas.
- Envie uma solicitação ao AWS Service Quotas para ativar a largura de banda de rede escalável para suas funções Lambda. Essa cota está listada em Network bandwidth per execution environment.
Clone o código-fonte do repositório do GitHub e implante a aplicação em sua conta da AWS. A criação do dataset de teste de 10 GB e a execução do benchmark podem gerar cobranças em sua conta da AWS.
Depois que a stack do AWS CloudFormation for implantada, anote o DataBucketName e o nome da função orquestradora a partir das saídas da stack para usar nos comandos subsequentes.
Para simular dados que o usuário final possa consultar, o repositório do GitHub tem um script que cria 10 GB de dados sintéticos e os carrega no seu bucket do S3.
Modo 1: Processamento de dados pré-particionados
No Modo 1, os 10 GB de dados sintéticos são pré-particionados. Dados pré-particionados são normalmente produzidos de forma incremental por várias fontes ao longo de um período de tempo, o que pode ser o caso de dados de IoT ou logs de acesso. O comando a seguir cria 10 GB de dados divididos em 20 partições de 512 MB cada.
Ativar a largura de banda de rede escalável não, por si só, torna seus downloads mais rápidos. Uma única solicitação de download abre apenas uma conexão com o Amazon S3, e uma conexão não move dados rápido o suficiente para preencher toda a largura de banda agora disponível para sua função Lambda. Para realmente usar toda a sua largura de banda de rede alocada, o ambiente de execução precisa buscar os dados por várias conexões simultaneamente. Ele faz isso preferindo o cliente de transferência AWS Common Runtime (CRT), um mecanismo de download de alto desempenho integrado ao Boto3. Quando o worker chama download_fileobj, o cliente CRT automaticamente divide o objeto de 512 MB em partes menores e as baixa em paralelo por meio de múltiplas solicitações ao Amazon S3. Esses downloads paralelos são o que permite que um único worker Lambda aproveite toda a sua largura de banda de rede.
O comando a seguir executa o benchmark nos dados pré-particionados.
Modo 2: Processamento de objetos grandes únicos
O Modo 2 gera 10 GB de dados em um único objeto grande. Esse arranjo é mais comum quando os dados são produzidos ou entregues como uma única unidade completa, como backups de banco de dados ou datasets genômicos. O comando a seguir cria 10 GB de dados em um único objeto grande.
No Modo 1, a preferência pelo CRT se aplica aos métodos de transferência gerenciados do Boto3, como download_file e download_fileobj. O Modo 2 adota uma abordagem diferente. Cada worker lê um intervalo de bytes específico de um único objeto grande usando get_object. A configuração de preferência pelo CRT não tem efeito nessas chamadas. Em vez disso, você pode controlar a simultaneidade ajustando explicitamente o número de workers do Lambda e usando um ThreadPoolExecutor limitado para emitir múltiplas solicitações de intervalo de bytes simultaneamente.
Quando você executa o comando a seguir, o orquestrador pega o objeto grande único e o divide em intervalos de bytes consecutivos de 512 MB cada. Cada um dos intervalos individuais é então processado por um ambiente de execução worker do Lambda em paralelo.
O benchmark relata a duração em tempo real (wall-clock), a duração observada pelo cliente, a taxa de transferência agregada entre workers, as contagens de conclusão dos workers e a conformidade com o alvo. Ao comparar configurações de memória, mantenha o código, o dataset, a região da AWS, a contagem de partições, a política de aquecimento e a contagem de medições idênticos. Você deve executar o benchmark várias vezes em sua conta, pois o posicionamento, os cold starts, a simultaneidade, o comportamento do S3 e a reutilização do ambiente de execução podem afetar os resultados.
Resultados
Para comparar resultados, executamos o benchmark usando uma configuração de referência (baseline) na qual a função worker do Lambda é configurada com apenas 1.024 MB de memória, bem abaixo do limite de 2.048 MB necessário para que a largura de banda de rede escalável entre em vigor. A configuração de 1.024 MB limita a taxa de transferência de rede ao teto sustentado anterior de 625 Mbps.
Em nossa execução de teste de referência, um worker baixou e processou uma única partição de 512 MB com um tempo de download de 6,61 segundos a uma taxa de transferência de 649,8 Mbps (no p50). A taxa de transferência de 649,8 Mbps excede o teto de 625 Mbps porque o Lambda é capaz de picos na taxa de transferência de rede por um curto período de tempo. Em vinte consultas de fan-out medidas, a consulta completa de 10 GB foi concluída com um tempo real (wall-clock) de 7,113 segundos no p50. Isso se encaixa dentro do SLA de 8 segundos, mas deixa muito pouca margem.
Para executar nosso benchmark de largura de banda de rede escalável, reimplantamos nossa função worker do Lambda com uma configuração de memória de 10.240 MB e executamos novamente a aplicação. Com uma configuração de memória de 10.240 MB, cada ambiente de execução agora pode acessar até 3.000 Mbps de taxa de transferência sustentada. Downloads diretos de 512 MB alcançaram um tempo de download de 1,70 segundo e uma taxa de transferência de 2.521,3 Mbps (ambos no p50). A consulta completa de 10 GB foi concluída com um tempo real (wall-clock) de 2,640 segundos no p50. Isso é 2,69 vezes mais rápido, ou 62,9% menos latência mediana, do que a configuração de 1.024 MB.
A Tabela 2 resume as medições diretas de worker e de fan-out de ponta a ponta para o mesmo dataset de 10 GB e o padrão de orquestração de 20 × 512 MB. A taxa de transferência agregada é a taxa total de transferência de dados entre todos os vinte ambientes de execução criados para executar o benchmark.
| Configuração de Memória | Tempo de download e taxa de transferência de uma única partição de 512 MB (p50) | Tempo real (wall time) de fan-out de 10 GB (p50) | Taxa de transferência agregada p50 |
| Nível de referência de 1.024 MB (625 Mbps sustentado) | 6,61s / 649,8 Mbps | 7,113s | 12,08 Gbps |
| Nível escalável de 10.240 MB (até 3.000 Mbps) | 1,70s / 2.521,3 Mbps | 2,640s | 32,54 Gbps |
Tabela 2. Desempenho medido do nível de referência de 1.024 MB e do nível de largura de banda escalável de 10.240 MB para uma consulta de ETL fan-out de 10 GB.
Usando a largura de banda de rede escalável, a margem de SLA do cliente melhorou em quase 5 segundos. A função Lambda agora pode lidar com partições maiores dentro da mesma janela de SLA, reduzindo custos e ainda permanecendo confortavelmente dentro do SLA do cliente.
Limpeza
Para limpar os recursos criados para o teste de benchmark, execute os seguintes comandos:
Práticas recomendadas
Depois que a largura de banda de rede escalável for ativada para sua conta da AWS, as práticas a seguir ajudam você a obter o máximo proveito dela.
Perfilamento e planejamento
- Teste antes de ajustar. Nem toda função é limitada pela rede. Antes de aumentar a memória, faça o perfilamento (profiling) da sua função para confirmar que a E/S de rede é a principal contribuinte para a duração da invocação, e não a CPU ou a lógica da aplicação. Use o Amazon CloudWatch Lambda Insights para inspecionar
rx_bytes,tx_bytese a duração. Funções em que a E/S de rede domina o tempo de invocação são candidatas ideais para ajuste. - Projete para paralelismo. Divida seus dados em blocos paralelizáveis que possam ser processados de forma independente em um padrão de fan-out entre múltiplos ambientes de execução. Você pode usar leituras por intervalo de bytes do Amazon S3 para dividir arquivos grandes em partições baixáveis independentemente. Para detalhes de implementação, consulte Downloading an object with part numbers no Guia do Usuário do Amazon S3.
- Execute o AWS Lambda Power Tuning. O Lambda Power Tuning é uma máquina de estados que ajuda você a otimizar suas funções Lambda em termos de custo e desempenho. Use o Power Tuning para percorrer configurações de memória de 1.024 MB a 10.240 MB e identificar o ponto ideal de custo versus latência para seu workload.
Implementação
- Verifique os limites upstream e downstream. Verifique os limites de taxa de transferência de suas fontes de dados. Por exemplo, uma função Lambda executando a 3.000 Mbps pode exceder a capacidade de taxa de transferência de um único prefixo do S3, que suporta até 5.500 solicitações GET por segundo. Quando isso ocorre, você verá erros HTTP 503 (Slow Down) nos logs da sua aplicação. Distribua seus objetos do S3 em vários prefixos para paralelizar as leituras e evitar limitação por prefixo.
- Equilibre largura de banda e CPU. O Lambda aloca CPU proporcionalmente à memória. Por exemplo, em uma configuração de memória de 1,7 GB, você recebe 1 vCPU alocada, enquanto uma configuração de memória de 10 GB recebe até 6 vCPU. Se sua função processa dados em threads paralelas, os níveis de memória mais altos oferecem tanto mais largura de banda de rede quanto mais CPU para processá-los. Use o módulo concurrent.futures em Python ou worker_threads no
Node.jspara processar dados em threads paralelas e maximizar tanto a utilização de CPU quanto de rede. - Ative o Amazon S3 CRT para o Boto3. Se sua função usa o runtime Python, inicialize seu cliente do Amazon S3 com
preferred_transfer_client: 'crt'para maximizar a taxa de transferência por conexão única. O AWS Common Runtime paraleliza automaticamente as solicitações entre múltiplas conexões TCP, o que é importante porque conexões TCP individuais têm um teto de taxa de transferência. - Use o SnapStart para workloads JVM. Se você usa o Lambda SnapStart para funções Java, a largura de banda de rede escalável reduz a latência do hook
afterRestore. A atividade de rede que ocorre durante a restauração da função, como o pré-aquecimento de conexões ou o pré-carregamento de dados de configuração, pode ser concluída mais rapidamente.
Conclusão
A largura de banda de rede escalável eleva o teto de taxa de transferência sustentada por ambiente do AWS Lambda de 625 Mbps para 3.000 Mbps, reduzindo diretamente a latência de ponta a ponta para workloads intensivos em dados. Combinada com a taxa de escalonamento do Lambda, agora você pode mover terabytes de dados em segundos, sem provisionar ou gerenciar infraestrutura.
Para começar, solicite o aumento da cota Network bandwidth per execution environment por meio do AWS Service Quotas e implante a aplicação de exemplo do repositório do GitHub para ver a melhoria de primeira mão.
Este conteúdo foi traduzido a partir da publicação original do blog, que pode ser encontrada aqui.
Biografia do Autores
 |
Rahul Shandilya é Solutions Architect na Amazon Web Services. |
 |
James Ngai é Senior Product Manager – Tech na Amazon Web Services. |
 |
Sahil Bhimjiani é Solutions Architect na Amazon Web Services.
|
Biografia do tradutores
 |
Daniel Abib é Arquiteto de Soluções Sênior e Especialista em Amazon Bedrock na AWS, com mais de 25 anos trabalhando com gerenciamento de projetos, arquiteturas de soluções escaláveis, desenvolvimento de sistemas e CI/CD, microsserviços, arquitetura Serverless & Containers e especialização em Machine Learning. Ele trabalha apoiando Startups, ajudando-os em sua jornada para a nuvem. https://www.linkedin.com/in/danielabib/ |
 |
Nicolas Tarzia é Senior Technical Account Manager na AWS, com mais de 13 anos de experiência, com ampla experiência em arquitetura cloud, engenharia e design de software. Atualmente está habilitando empresas do ramo de ISV (Independent Software Vendors) simplificando a operação na nuvem e otimizando os custos em cloud. Sua área de interesse são tecnologias serverless. https://www.linkedin.com/in/nicolastarzia |