亚马逊AWS官方博客
Apache Iceberg on AWS:设计能力和性能实测
摘要:Iceberg 构建湖仓的优势和性能测试。测试环境说明:EMR on EKS 7.13.0(Spark 3.5.6-amzn-2、Iceberg 1.10.0-amzn-1、JDK 17.0.19),节点规格 r7g.4xlarge,测试执行至 2026-08-31。测试时间取值均为中位数,3 次取中间值。第三、四部分可独立阅读;第二部分依赖第一部分对元数据裁剪机制的介绍。
目录
一、第一章 Iceberg 表相对纯 Parquet 表的设计优势与适用场景
Iceberg 底层支持多种存储格式(Parquet / ORC / Avro);本文的对比是 Iceberg 表格式 vs Hive(Glue Catalog) 表格式,两者跑在同一批 Parquet 文件上,延迟差距来自查询规划阶段(planning,即引擎在真正读数据之前确定要扫哪些文件的过程),不来自数据文件内部的编码格式(Parquet 的编码与压缩)。
1.1 Hive 表格式的根本问题
表信息存在两个地方:分区列表在 metastore,分区内的文件在文件系统。两处各自可独立变化,跨系统无事务。Iceberg 官方在 Reliability 页面里把这个问题说得很清楚:”This makes atomic changes to a table’s contents impossible”。下面每一项,我们通过实际的场景例子来说明这个问题同时给出 Iceberg 是如何解决的。
Iceberg 的元数据树盖在文件格式之上,形成四层结构:
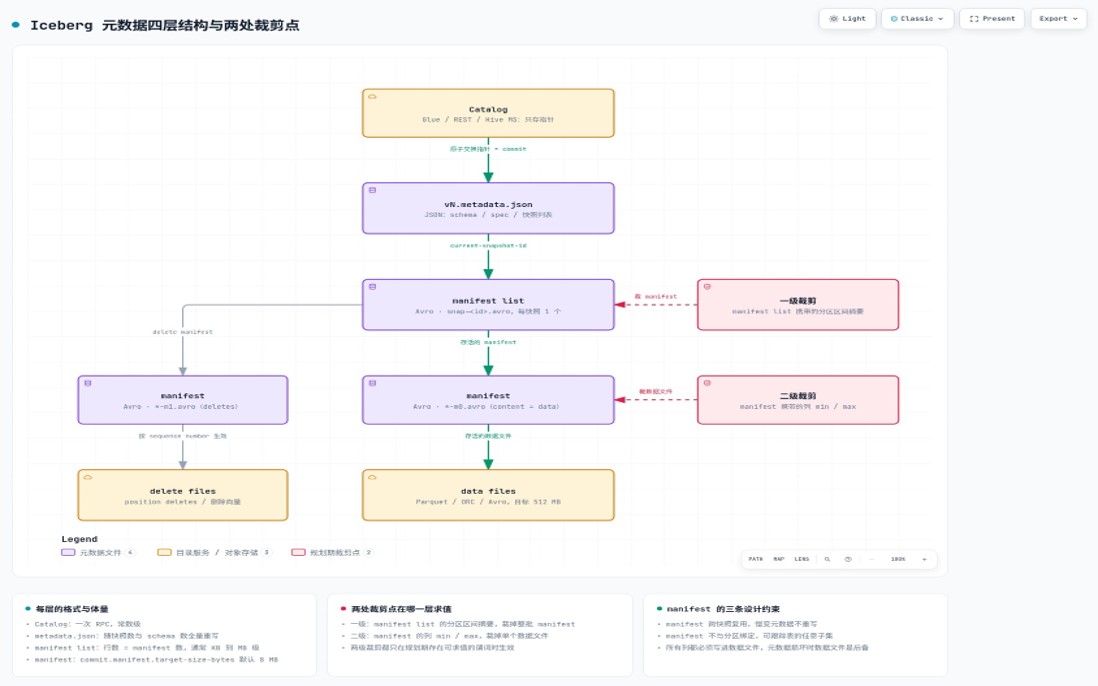
[图 1:Iceberg 元数据四层结构与两处裁剪点] |
图 1 加粗实线为一次查询规划必经的引用链,虚线为 delete 分支。catalog 只保存「当前 metadata 文件是哪一个」这一个可变状态,commit 就是原子交换这个指针。一级过滤排除整批 manifest,二级过滤排除单个数据文件;两级都只在规划期存在可求值的谓词时生效
当前实测:411 GiB、1,823 分区的 store_sales 表,metadata 体积 0.58 MiB,规划任何查询需 4 次网络往返。
1.2 ACID 与快照隔离
1.2.1 场景
一张按小时分区的事件表,摄入作业每小时追加数据,BI 看板与下游汇总作业同时在读。这个问题在 LinkedIn 的 Kafka→HDFS 摄入管道里也出现过:下游作业无法判断上游这一小时的数据有没有写完,读早了就会拿到不完整的分区。他们的做法是让下游固定等一段时间再开始读,只能靠预估的等待时间推测上游是否写完——”to ensure read/write isolation, downstream pipelines artificially introduce latency in their flows to ensure all data for a given hourly partition is complete”。这个等待时间必须按最坏情况设定,而正常情况下上游早就写完了,这段等待时间是白等的。
第二类情境是覆盖写。财务对账、维表全量刷新、迟到数据修正都要走 INSERT OVERWRITE。Hive 表上这个动作先删旧文件再写新文件,有一段时间下游读到的是不完整数据;作业中途失败时,表停在残缺状态,没有原子回滚动作可用。Salesforce Data Cloud 把这一条列为重构的直接动因:早期数据湖 “lacked several critical functions like schema enforcement, partition evolution, ACID semantics, and ability to revert changes”,问题从数据层扩散到依赖它的服务层之后才触发了迁移。
1.2.2 Iceberg 的做法
commit = 原子替换 catalog 里的一个指针,指向新的 metadata.json。这个操作要么完全生效,要么完全不生效。读取端在 load table metadata 时确定快照,之后不受并发写影响,直到主动 refresh——快照隔离靠不可变文件实现,不靠锁,读写之间不产生锁竞争,BI 查询不会因 ETL 写入而阻塞。
1.2.3 时间旅行 / 回滚
同一个机制赋予了另一项能力:CALL system.rollback_to_snapshot('db.table', <snapshot_id>)。错误数据的恢复不再是重跑管道,而是切换一个元数据指针。保留期由 history.expire.max-snapshot-age-ms(默认 5 天)控制;给关键时间点打 tag(CREATE TAG <tag_name>)可以把指定快照从全局过期策略里豁免。
1.3 行级 UPDATE / DELETE
场景 A:合规删除
GDPR 第 17(1) 条赋予数据主体要求删除个人数据的权利,第 12(3) 条规定响应时限为收到请求后一个月(情形复杂时可再延两个月,但延期本身须在一个月内告知)。
一家在欧盟和加州都有用户的公司,用户历史数据按天分区散布在两年的每一个分区里。单次删除请求命中数百个分区,每个分区里只有几十行目标数据。请求是持续到达的日常流量,不是偶发事件。
在 Glue + Parquet 表(即 Hive 表格式)上,可执行的动作只有两种:重写整个分区(读出、过滤、INSERT OVERWRITE 写回),或重写整张表。重写字节量由「命中分区数 × 分区平均字节」决定,与真正要删的那几十行无关。写入窗口需要排到低峰期——一个月的法定时限里真正可用的执行窗口只有若干个夜间批次,而请求是持续到达的。
Iceberg 提供两种更新数据的方式,写放大差异很大:
- MoR(Merge on Read):只写一个记录「哪些行被删了」的 delete file(v3 为 deletion vector),写放大字节 ≈
变更行数 × delete 记录字节;读侧在查询时合并,写侧几乎为零。 - CoW(Copy on Write):重写命中的数据文件,写放大字节 =
命中文件数 × 文件平均字节;收益取决于数据聚簇质量——按user_id排序过的表只命中个别文件,随机分布的表接近全表。
判断应选哪条路径的指标:SELECT count(*) FROM (SELECT DISTINCT _file FROM t WHERE <删除谓词>)。命中文件数决定了 CoW 的代价,与删除的行数占比无直接关系。
Iceberg V3 表格式的删除向量(deletion vector,DV)不等于物理擦除:deletion vector 是逻辑删除,目标行的字节仍完整留在 Parquet 文件里,不构成 GDPR 第 17 条意义上的 “erasure”。物理擦除仍需 rewrite_data_files + expire_snapshots + remove_orphan_files 三步走完。DV 优化的是响应速度,不是擦除动作本身。
场景 B:CDC 入湖
业务库(Aurora PostgreSQL / MySQL)里的订单表状态持续更新:状态从 received 变成 shipped 再变成 returned,行会被删。分析侧要的是「当前状态」,不是「变更流水」。如果目标表只能追加,「当前状态」这件事就被推给了每一个下游消费者,每个消费者都要自己回放变更日志。
Hive 表上唯一可用的 upsert 形态是分区级覆盖:把变更批与目标分区读出来做合并,再 INSERT OVERWRITE 整个分区。对按时间分区、变更集中在近期分区的表尚可接受;对用户表、商品表这类实体表,一次批量属性更新会命中几乎所有分区,重写字节量与变更行数不成比例。这个场景也是上述 Iceberg 提供的数据更新的方式可以解决的。
1.4 隐藏分区与 BI 生成 SQL 的场景
BI 工具按语义层建模生成 SQL。语义层里有一个字段叫「订单时间」,映射到表的 event_time 列;分析师拖一个「上周」的筛选,工具生成的谓词落在 event_time 上。而 Hive 表的物理分区列是另一个列——一个由写入方物化出来的 event_date(或 dt,或 year/month/day 三列)。这两个列的对应关系没有记录在表定义里,只靠建表约定维持。
Iceberg 官方在 Partitioning 页面里明确说明了这个问题:”Hive must be given partition values. In the logs example, it doesn’t know the relationship between event_time and event_date.” 后果是:”If the event_date filter were missing, Hive would scan through every file in the table because it doesn’t know that the event_time column is related to the event_date column.” 责任归属也写得清楚:”Users that don’t understand a table’s physical layout get needlessly slow queries — Hive can’t translate filters automatically.”
还有一个问题是:Hive 不校验分区值的语义。官方举的例子是分区值格式写成 2018-12-01 而正确格式是 20181201,此时查询返回静默错误,不报错。BI 工具生成的日期字面量格式由驱动与方言决定,不由分析师决定。
Iceberg 的机制
分区值由 Iceberg 从列值经 transform(day、hour、month、bucket、truncate 等)推导,推导关系存在 partition spec 里。读取时,谓词 event_time >= X 经 inclusive projection 自动转换成分区谓词 ts_day >= day(X),无需用户感知分区列。消费方不可见 event_date,也不需要知道。遇到无法解析的 transform 时不做裁剪,宁可全扫也不返回错误结果。
分区演进:改分区策略在 Hive 表上是「建新表 + 全量重写 + 改所有查询」的迁移项目。Iceberg 侧是一行 DDL:ALTER TABLE t SET PARTITION SPEC (hour(event_time)),纯元数据操作,不重写任何文件,老数据继续用旧 spec 裁剪,新数据用新 spec。Hive 侧成本 = 全表字节 ÷ 吞吐 × 节点小时单价;Iceberg 侧成本 = 0。
1.5 多引擎并发访问
场景
一份数据被多个引擎同时读写是今天数据湖的默认架构。Salesforce Data Cloud 把这件事作为首要设计属性:”This design allows Salesforce to leverage different processing engines, such as Spark, Hyper and Trino, while storing data in a common format, Apache Iceberg. This decoupling provides the flexibility to scale and innovate, using the right engine for the right workload.”
在没有统一表格式时,多引擎共享同一份数据有三种常见做法,各有代价:
- 每个目的地一条管道:管道数量随消费方线性增长,各条管道口径独立演化,最终各数仓的同一指标对不上。
- 把数据复制进每个仓库:存储副本数 = 消费方数量,各副本新鲜度各自演化。
- 各引擎各自注册外部表指向同一 S3 前缀:最危险的一种。两个引擎用不同 catalog 指向同一前缀,各自提交时会覆盖对方的元数据——这是数据损坏,不是性能问题。
Iceberg 的 commit 模型在这里有一条必要前提:并发写需要冲突检测。Iceberg 的乐观并发靠原子交换元数据指针,失败方基于新状态重写元数据树并重试。重试是否安全,取决于提交时会校验当前元数据指针是否仍是读取时那一个:一致才提交,不一致就重新读取再试。一次 compaction 可以提交当且仅当它要重写的源文件仍然存在于当前快照里。
Catalog 选型问题:HadoopCatalog 依赖 S3 上不存在的原子 rename,多进程并发提交会产生同一版本号,造成数据丢失。Glue VersionId 乐观 CAS 自 Iceberg 0.14.0(2022-07-16,PR #4166)起成为 GlueCatalog 的默认提交路径,不再需要 DynamoDB 锁表;Iceberg 1.0.0 删除的是 glue 包下已废弃的 DynamoLockManager 别名类,org.apache.iceberg.aws.dynamodb.DynamoDbLockManager 至今仍在,服务对象是 HadoopCatalog / HadoopTables。
1.6 其余能力
Schema 演进 Hive 按列名追踪列,按位置追踪列各有缺陷。按名字追踪:删列后重用同名新列,老数据的值会被新列「继承」(un-delete)。按位置追踪(convertMetastoreParquet=false):中间加列时后续列位置编号向前移一位,静默错位,不报错。Spark 默认 convertMetastoreParquet=true,走原生 Parquet reader 按列名读——末尾或中间加可空列在 Hive 侧同样是纯元数据操作,无需重写数据;真正危险的操作是 rename 与类型变更。Iceberg 换了追踪方式:每列在建表时分配一个 field ID,永不复用;rename 只改元数据里的名字,field ID 不变,因此 rename 既不会导致老数据读错,也不会与新旧引擎的行为绑定。
| 变更 | Hive(按名字读) | Iceberg |
| 末尾/中间加可空列 | 无需重写数据(按列名读) | 仅改元数据(按 field ID) |
| 删列后重用同名 | 静默把老数据当新列读出 | field ID 不同,老数据按规则回退为 null |
| 改列名 | 按名字的路径读不到;按位置的路径读错 | 纯元数据,field ID 不变 |
int→long 类型加宽 |
行为取决于引擎与 reader | spec 白名单合法,保证正确 |
convertMetastoreParquet=false + 中间加列 |
静默错位 | 不适用 |
分支与标签(Write-Audit-Publish) WAP 模式由 Netflix 提出(write.wap.enabled=true,写入打到 audit 分支,审计通过后 CALL system.fast_forward('db.table', 'main', 'audit') 原子合并进主线),目的是保证数据质量校验发生在数据对下游可见之前,校验未通过就不发布。AWS 在 2024-12-09 的 Big Data 博客《Build Write-Audit-Publish pattern with Apache Iceberg branching and AWS Glue Data Quality》里给出了结合 Glue Data Quality 的完整参考实现(Glue Studio notebook + Spark + EvaluateDataQuality + fast_forward)。
增量读 Iceberg 按快照区间读(start-snapshot-id / end-snapshot-id)把「上次跑到哪」从数据里的时间值变成表历史里的一个 ID,与迟到数据无关。官方限制(截至 Iceberg 1.11.0):增量读只取 append 操作产生的数据,不支持 replace / overwrite / delete;Spark SQL 语法不支持增量读,只能通过 DataFrame 的 start-snapshot-id / end-snapshot-id 读选项使用。
元数据表<table>.snapshots / .files / .manifests / .partitions / .history / .refs 等均可直接 SQL 查询。「优化器返回 Successful 但什么都没做」在运维上无法从作业状态区分,只能查快照是否新增——这是元数据表解决的典型问题,S3 aws s3 ls 给不出这个答案。
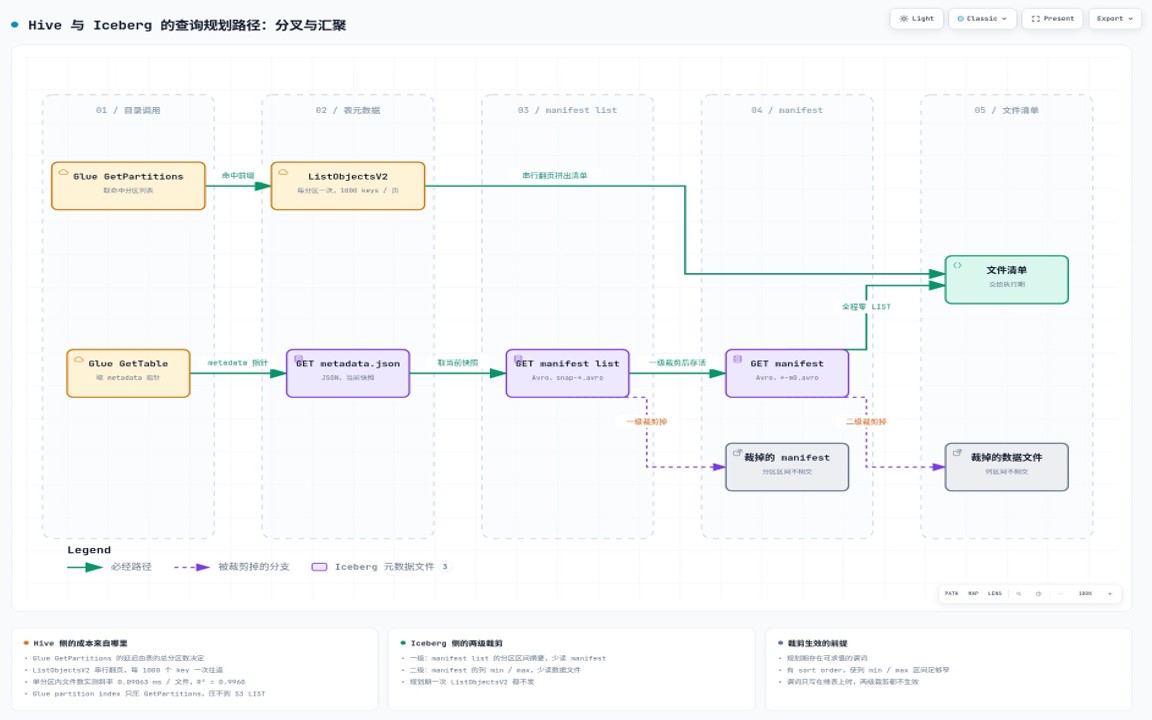
[图 2:Hive 与 Iceberg 的查询规划路径] |
图 2 加粗实线为必经路径,虚线为被裁剪掉的分支(不产生任何请求)。两条路径产出同一份文件清单,差别在于 Hive 侧的代价随命中分区数与分区内文件数线性增长(S3 LIST 串行翻页),Iceberg 侧只随一级裁剪后存活的 manifest 数变化。Glue partition index 只能减少 GetPartitions 调用,无法作用于 S3 LIST
二、第二章 实测性能:TPC-DS 3TB 查询测试,及 Iceberg 为何在这个场景没有表现出更好的性能
2.1 测试结果
TPC-DS 3TB,21 条查询(按形态等距采样,不按结果挑),执行期中位数之和:
Hive Parquet 2,050.8 s < Iceberg 2,294.2 s(+11.9%) < S3 Tables 2,313.9 s(+12.8%)
Iceberg 仅在 5/21 条更快,分别是 q82(0.78×)、q88(0.87×)、q37(0.88×)、q93(0.92×)、q4(1.00×)。规律清晰:表现更好的都是扫描量最大的查询(q82/q88/q37 各扫 294–393 GiB),表现更差的都是扫描量最小的(q1/q32/q20 各扫 10–17 GiB)。
规划期:Iceberg 73.64 s,比 Hive 55.25 s 慢 33.3%。S3 Tables 规划期最快,46.69 s(Iceberg REST 的 LoadTable 一次往返带回 metadata,而原生 GlueCatalog 需要 GetTable + S3 读 metadata.json 两次)。
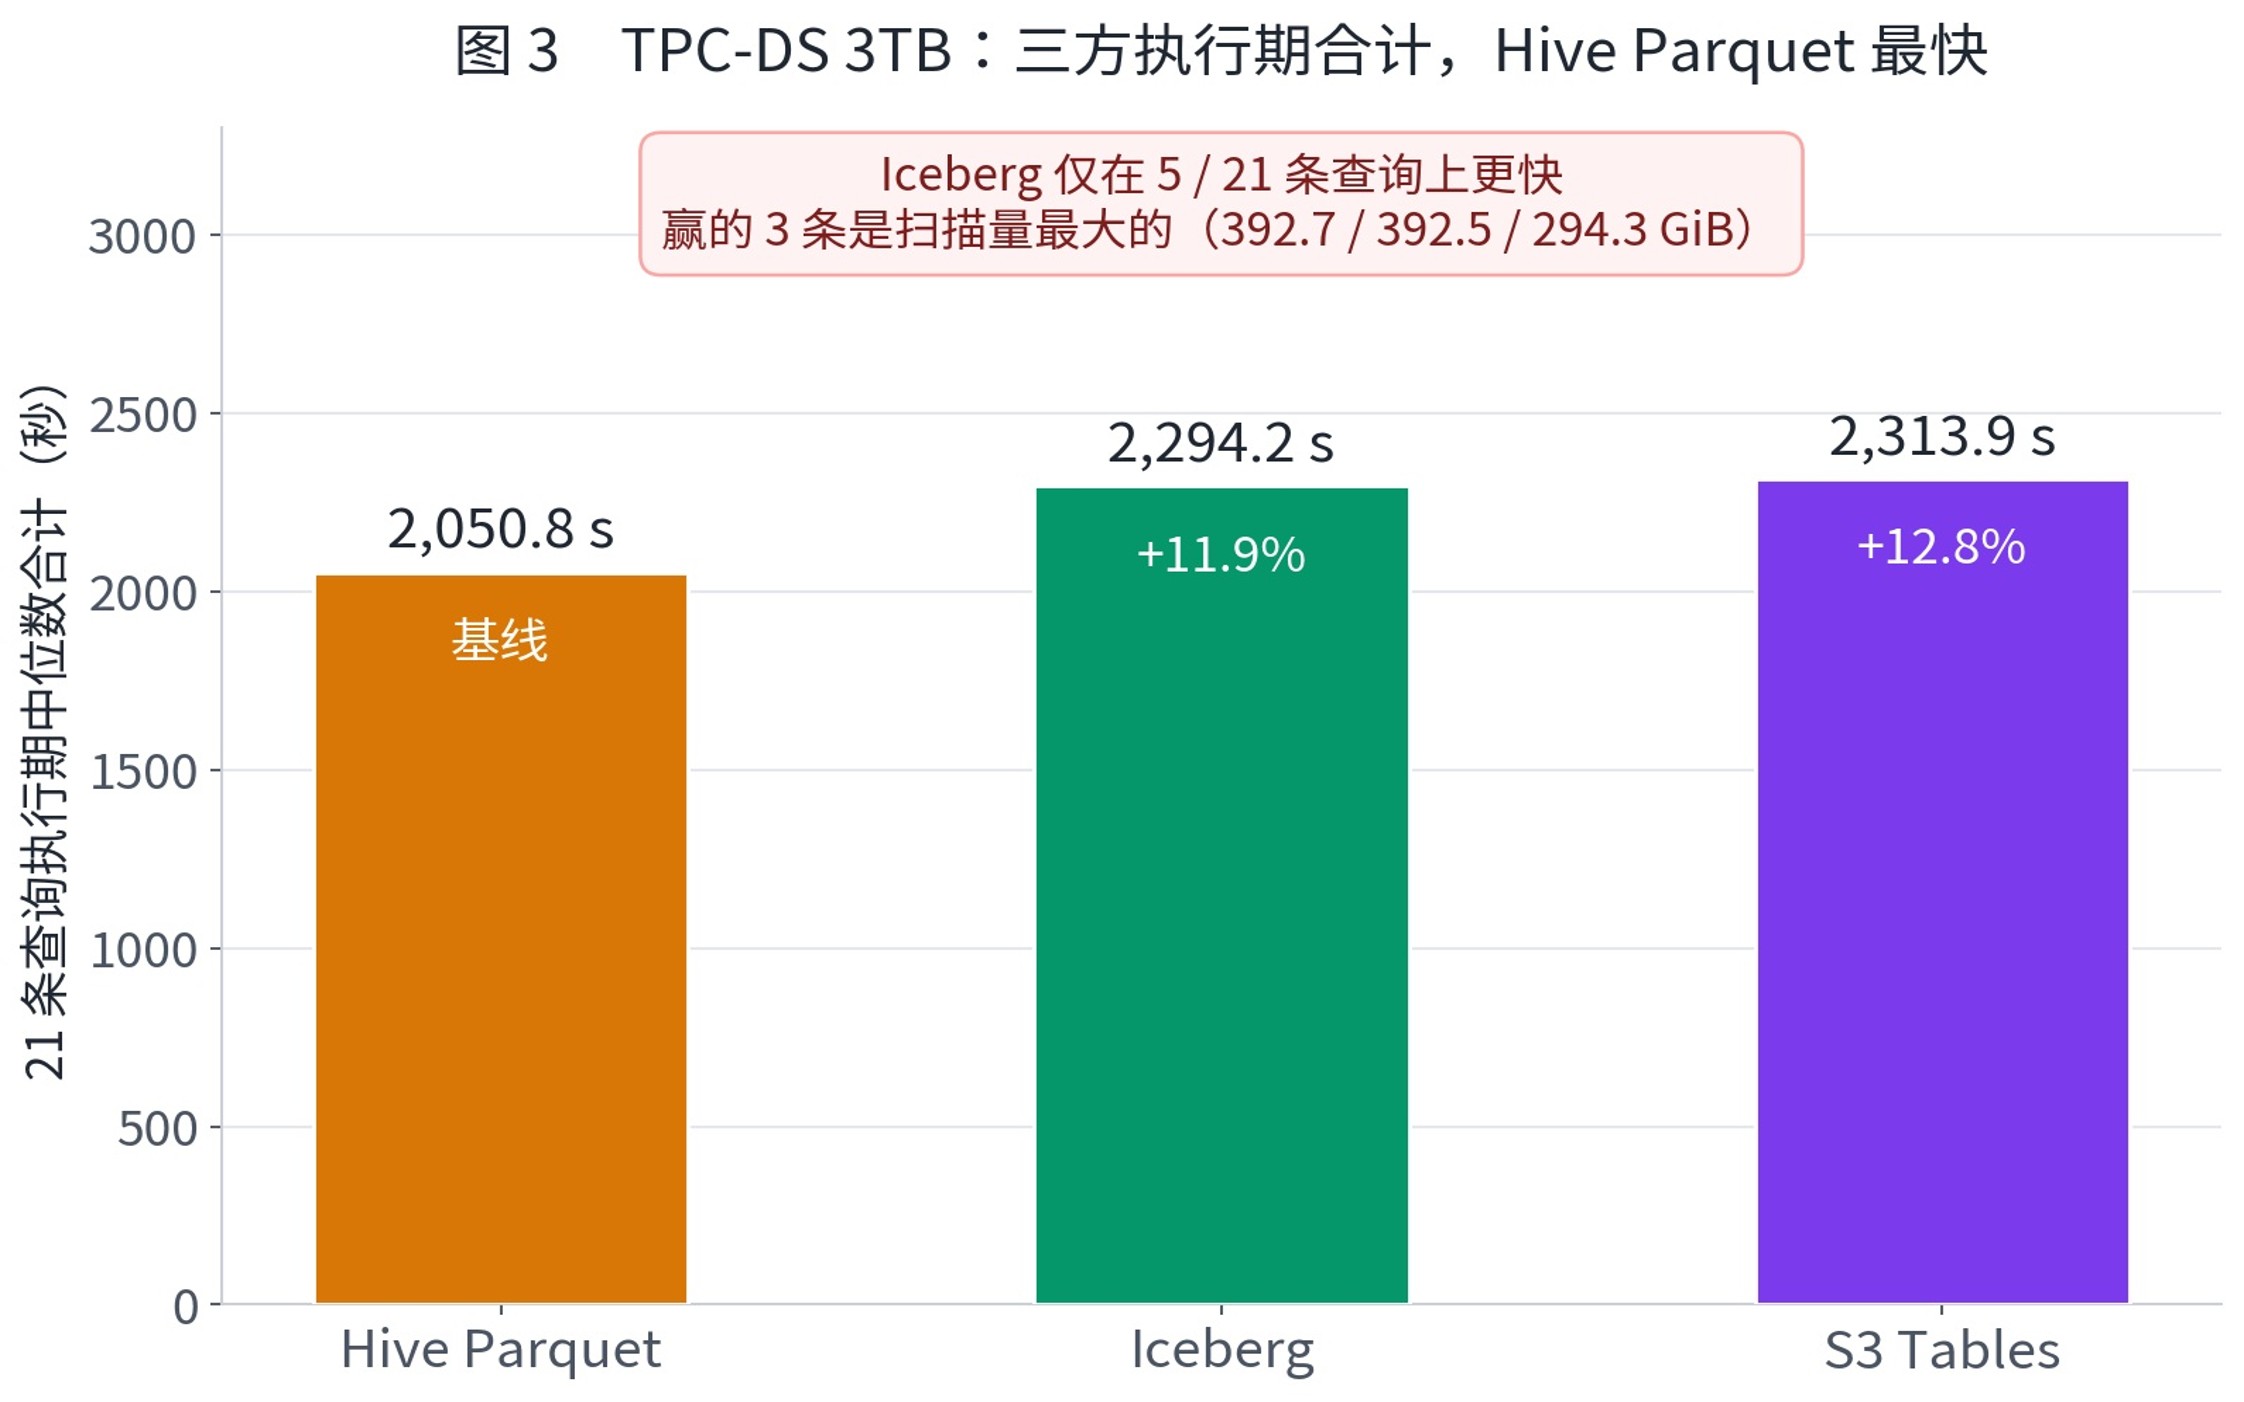
[图 3:TPC-DS 3TB 三方执行期合计] |
图 3 21 条查询执行期中位数之和,同一集群、同一份 3TB 数据、同为 snappy。其中 q4 / q14b / q24b / q93 四条因单格 300 s 预算只做 1 次测量,是单次观测而非中位数。规划期另计:Iceberg 73.64 s、Hive 55.25 s、S3 Tables 46.69 s
2.2 元数据裁剪的三个前提全部缺失
Iceberg 相对 Hive 的规划期优势依赖三个前提,在这份数据集和这批查询上,三个前提全部不成立。
前提一:规划期存在可求值的谓词
对 103 条 TPC-DS 查询逐条审计(含 CASE 算术与 UNION ALL 外层 join 的辨别):对 7 个分区列写静态字面量谓词的 = 0 条,写子查询谓词的也 = 0 条。7 个分区列的 209 次出现分布为:JOIN 键 164 次、算术表达式 32 次、仅在 SELECT 投影 13 次,没有一次是 WHERE 中的静态过滤。
过滤确实发生了,但靠的是动态分区裁剪(DPP):谓词落在 date_dim.d_year 等维表列上,通过 ss_sold_date_sk = d_date_sk 在运行期传导到事实表。DPP 的裁剪发生在 join 规划之后,与 AQE / broadcast 构建时间纠缠,无法把差值干净归因到规划期元数据层。Iceberg 在 DPP 下仍有一项优势——经 Iceberg 的运行期过滤接口可以重跑 manifest 加列界裁剪、裁到文件级,而 Hive DPP 只能裁到目录级——但这是执行期优势,与本节讨论的规划期路径无关。
前提二:sort order 存在,使列界统计有效
实测读取该表的 metadata.json:"sort-orders": [{"order-id": 0, "fields": []}],即表没有 sort order。未排序时,每个数据文件的列区间接近全域——实测精确值是 99.9997%(1,000 文件 / 200 分区的受控实验量出)。区间覆盖 99.9997% 全域时,manifest 里的 lower_bounds / upper_bounds 对任何谓词都无法跳过任何文件。skippedDataFiles 在全部查询上精确为 0,不是「小」,是「零」——每个文件的区间覆盖几乎全域,由文件数直接决定,没有例外。
前提三:每分区文件数远大于 1
tpcds_ice_3t.store_sales:1,866 个当前快照引用的数据文件,1,824 个分区,比值 1.02。每分区约 1 个文件时,DPP 裁到文件级与裁到目录级等价,Iceberg 的细粒度优势为零。
三个前提全部缺失,Iceberg 元数据裁剪收益为零,规划期开销仍在:规划期增加了 33.3% 的开销,来自 manifest list + manifest 的读取往返,而这些往返在本负载下没有换回任何过滤收益。
2.3 额外说明
「谓词落在维表、事实表只出 join 键、ETL 干净每分区一个文件」——这是 BI 查询最常见的形态。它达不到 Iceberg 规划期优势的三个前提,不是因为数据集设计得特别,而是因为真实 BI 负载本就是这个形状。Iceberg 更快」不能作为默认结论。 它在哪些条件下更快,成本节省又来自哪里,第三部分展开。
三、第三章 Iceberg 在什么条件下更快,以及成本节省来自哪里
3.1 分区规模:命中分区数决定 Hive 的 LIST 成本
在 N=100,000 分区的表上,静态分区谓词,5 档命中分区数,规划期中位数(ms):
| 命中分区数 | Hive 无索引 | Hive 有索引 | Iceberg | 有索引 / Iceberg |
| 1 | 4,310 | 611 | 563 | 1.09×(基本打平) |
| 100 | 4,950 | 1,672 | 402 | 4.16× |
| 1,000 | 6,198 | 3,248 | 449 | 7.23× |
| 10,000 | 19,758 | 18,601 | 441 | 42.2× |
| 100,000 | 129,213 | 138,295(比无索引更慢) | 582 | 237.6× |
基线公平性:点查 1.09× 接近打平。命中 1 个分区时,Hive 有索引 611 ms vs Iceberg 563 ms,比值 1.09×,这一档(命中 1 个分区时)Iceberg 没有优势。引用分区规划的大倍数时必须同时给出这一档数据。
宽扫描时建索引只增加开销,不带来收益:索引路径要按 key range 扫 100,000 个 index item 再回捞分区,比朴素全量分页慢 1.96 倍(boto3 直接调 GetPartitions 的独立测量结果)。Spark 侧表现为 129,213 ms → 138,295 ms(0.93×)。
索引真正有效的证据:纯 Glue API 侧取 1 个分区,无索引 18.6 s → 有索引 0.55 s,34.2×。AWS 官方博客《Improve Amazon Athena query performance using AWS Glue Data Catalog partition indexes》(2021-11-19)在 367,920 分区的表上测到 Athena 的 QueryPlanningTimeInMillis 从 44,451 ms 降到 384 ms(115×);该文自己给出的 35× 是端到端总耗时口径(45.2 s → 1.6 s),两个倍数是不同口径。索引能消除的是「Glue 服务端加载全表分区再过滤」这一项固定底座(无索引时不管命中几个分区都要翻 201 页,有索引只翻 4 页),无法减少每命中一个分区产生的 S3 LIST。
机制:每命中一个分区,Hive 对该分区目录做一次 S3 LIST 操作,这一项不经过 Glue,任何 metastore 侧索引都无法影响它。实测边际成本:无索引 1.249 ms/分区,有索引 1.377 ms/分区——索引没有降低每个分区的固定开销。Hive 规划成本正确的模型是三项:O(表总分区数)(无索引时的固定底座,建索引后塌陷)+ O(命中分区数 × S3 LIST RTT)(索引无效)+ O(命中文件数)。
Iceberg 规划期零次 S3 LIST,文件路径已经写在 manifest 里。命中 100,000 个分区时,只读了 10 个 manifest 中的 1–2 个(其余 8–9 个被 manifest list 的分区值范围跳过),耗时 402–582 ms,与命中 1 个分区时完全相同。
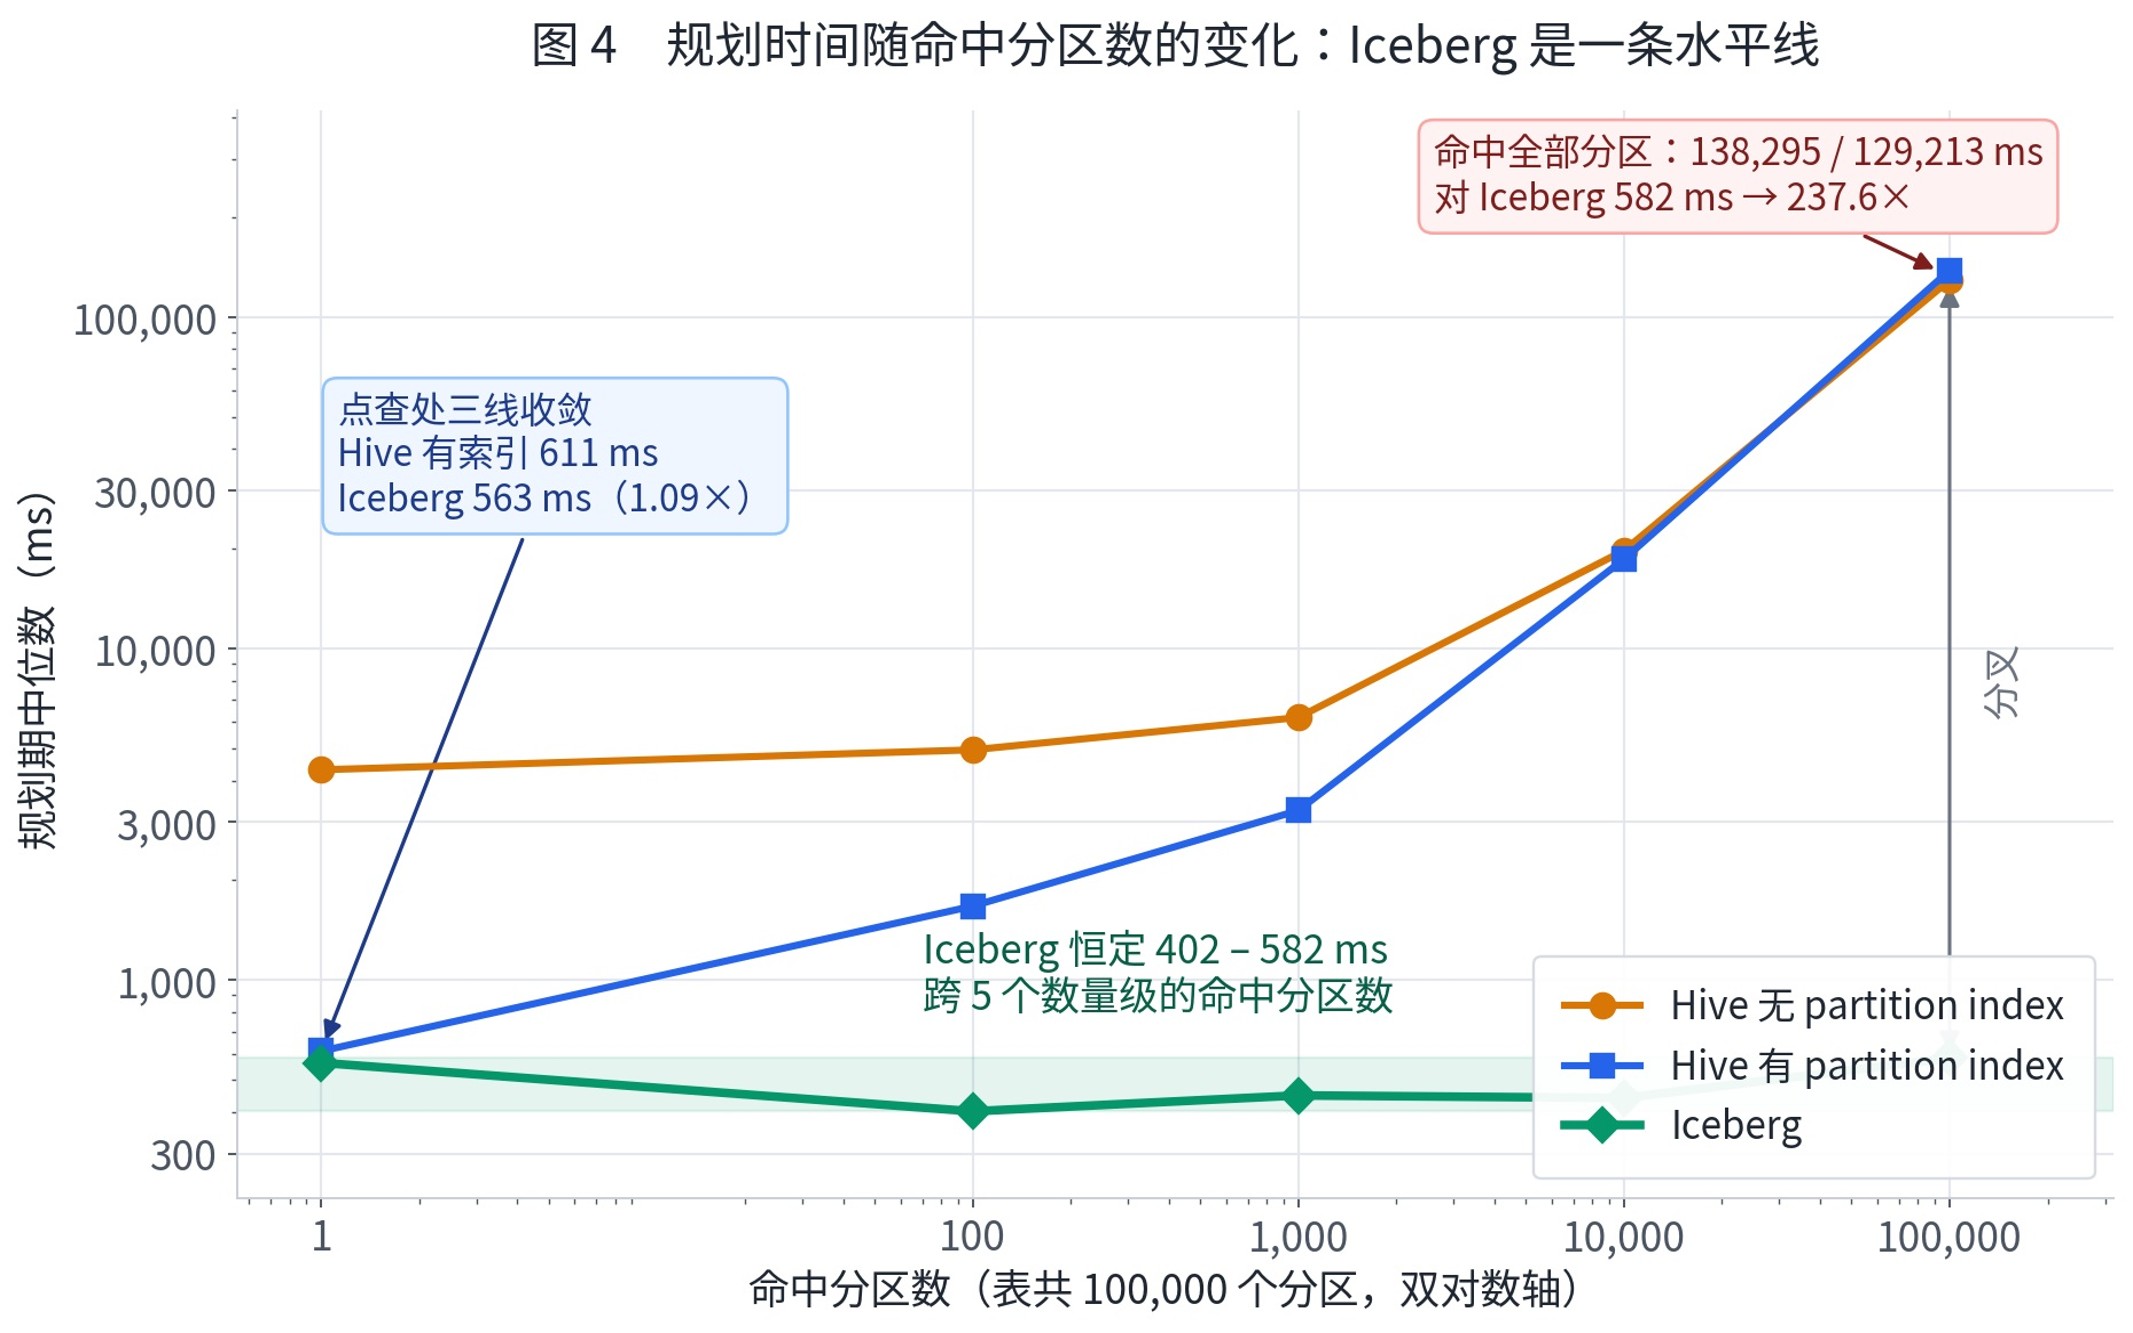
[图 4:规划时间随命中分区数的变化] |
图 4 N=100,000 分区,静态分区谓词,规划期中位数(3 次测量取中位,warm-up 已丢弃)。Iceberg 在五个数量级上保持水平;点查处三条曲线收敛,Hive 建 partition index 后与 Iceberg 基本持平(611 vs 563 ms)。右端 Hive 有索引反而比无索引更慢,因为索引在接近全表的 range 上会有额外开销
3.2 单分区内文件数:S3 LIST 串行分页
当分区数固定(只有 1 个分区),改变单分区内的文件数,规划期中位数(ms):
| 分区内文件数 | Hive | Iceberg(as-added) | Hive / Iceberg |
| 1,000 | 591 | 180 | 3.28× |
| 10,000 | 1,273 | 233 | 5.46× |
| 50,000 | 5,446 | 238 | 22.88× |
| 100,000 | 9,428 | 335 | 28.14× |
Hive 侧 optimization 阶段几乎等于全部规划时间(占比 98.6%–100.0%),说明开销全在文件列举上。线性拟合:plan_ms ≈ 0.09063 × 文件数 + 536.7,R²=0.9960。斜率 0.09063 ms/文件 = 每次 S3 LIST RTT 90.6 ms,与 S3 LIST 单次往返几十到一百毫秒的量级完全吻合。S3 LIST 每次最多返回 1,000 个 key,且必须串行翻页(下一次调用必须带上上一次返回的 ContinuationToken),100,000 个文件需要 100 次串行 RTT。
Iceberg 侧:同样的文件路径信息写在 491 KB 的 manifest 文件里,一次 GET 拉完;100,000 条记录比 1,000 条慢不了多少(180 ms → 335 ms,1.86 倍),因为是顺序读二进制 Avro,不是串行网络往返。
manifest 碎片化:manifest 数多时 Iceberg 可以并行读,合并成 1 个反而更慢。100,000 文件档:16 个 manifest 335 ms < 35 个 376 ms < 1 个 408 ms。真正影响 Iceberg 规划性能的是「每个 manifest 只含很少文件」的极端形态(例如上千次小批量 append 各自提交一个 manifest),而不是数量多本身。
执行期不包含在这个优势里。同一批小文件,10,000 文件档 Hive 执行期 8,754 ms vs Iceberg 26,998 ms——Iceberg 给每个 3.81 KB 的文件分配了一个 split,Hive 用 openCostInBytes=4 MiB 把小文件合并了。Iceberg 不自动解决小文件的执行期问题。 小文件需要 compaction 才能在执行期获益,这是规划期优势的前提条件。
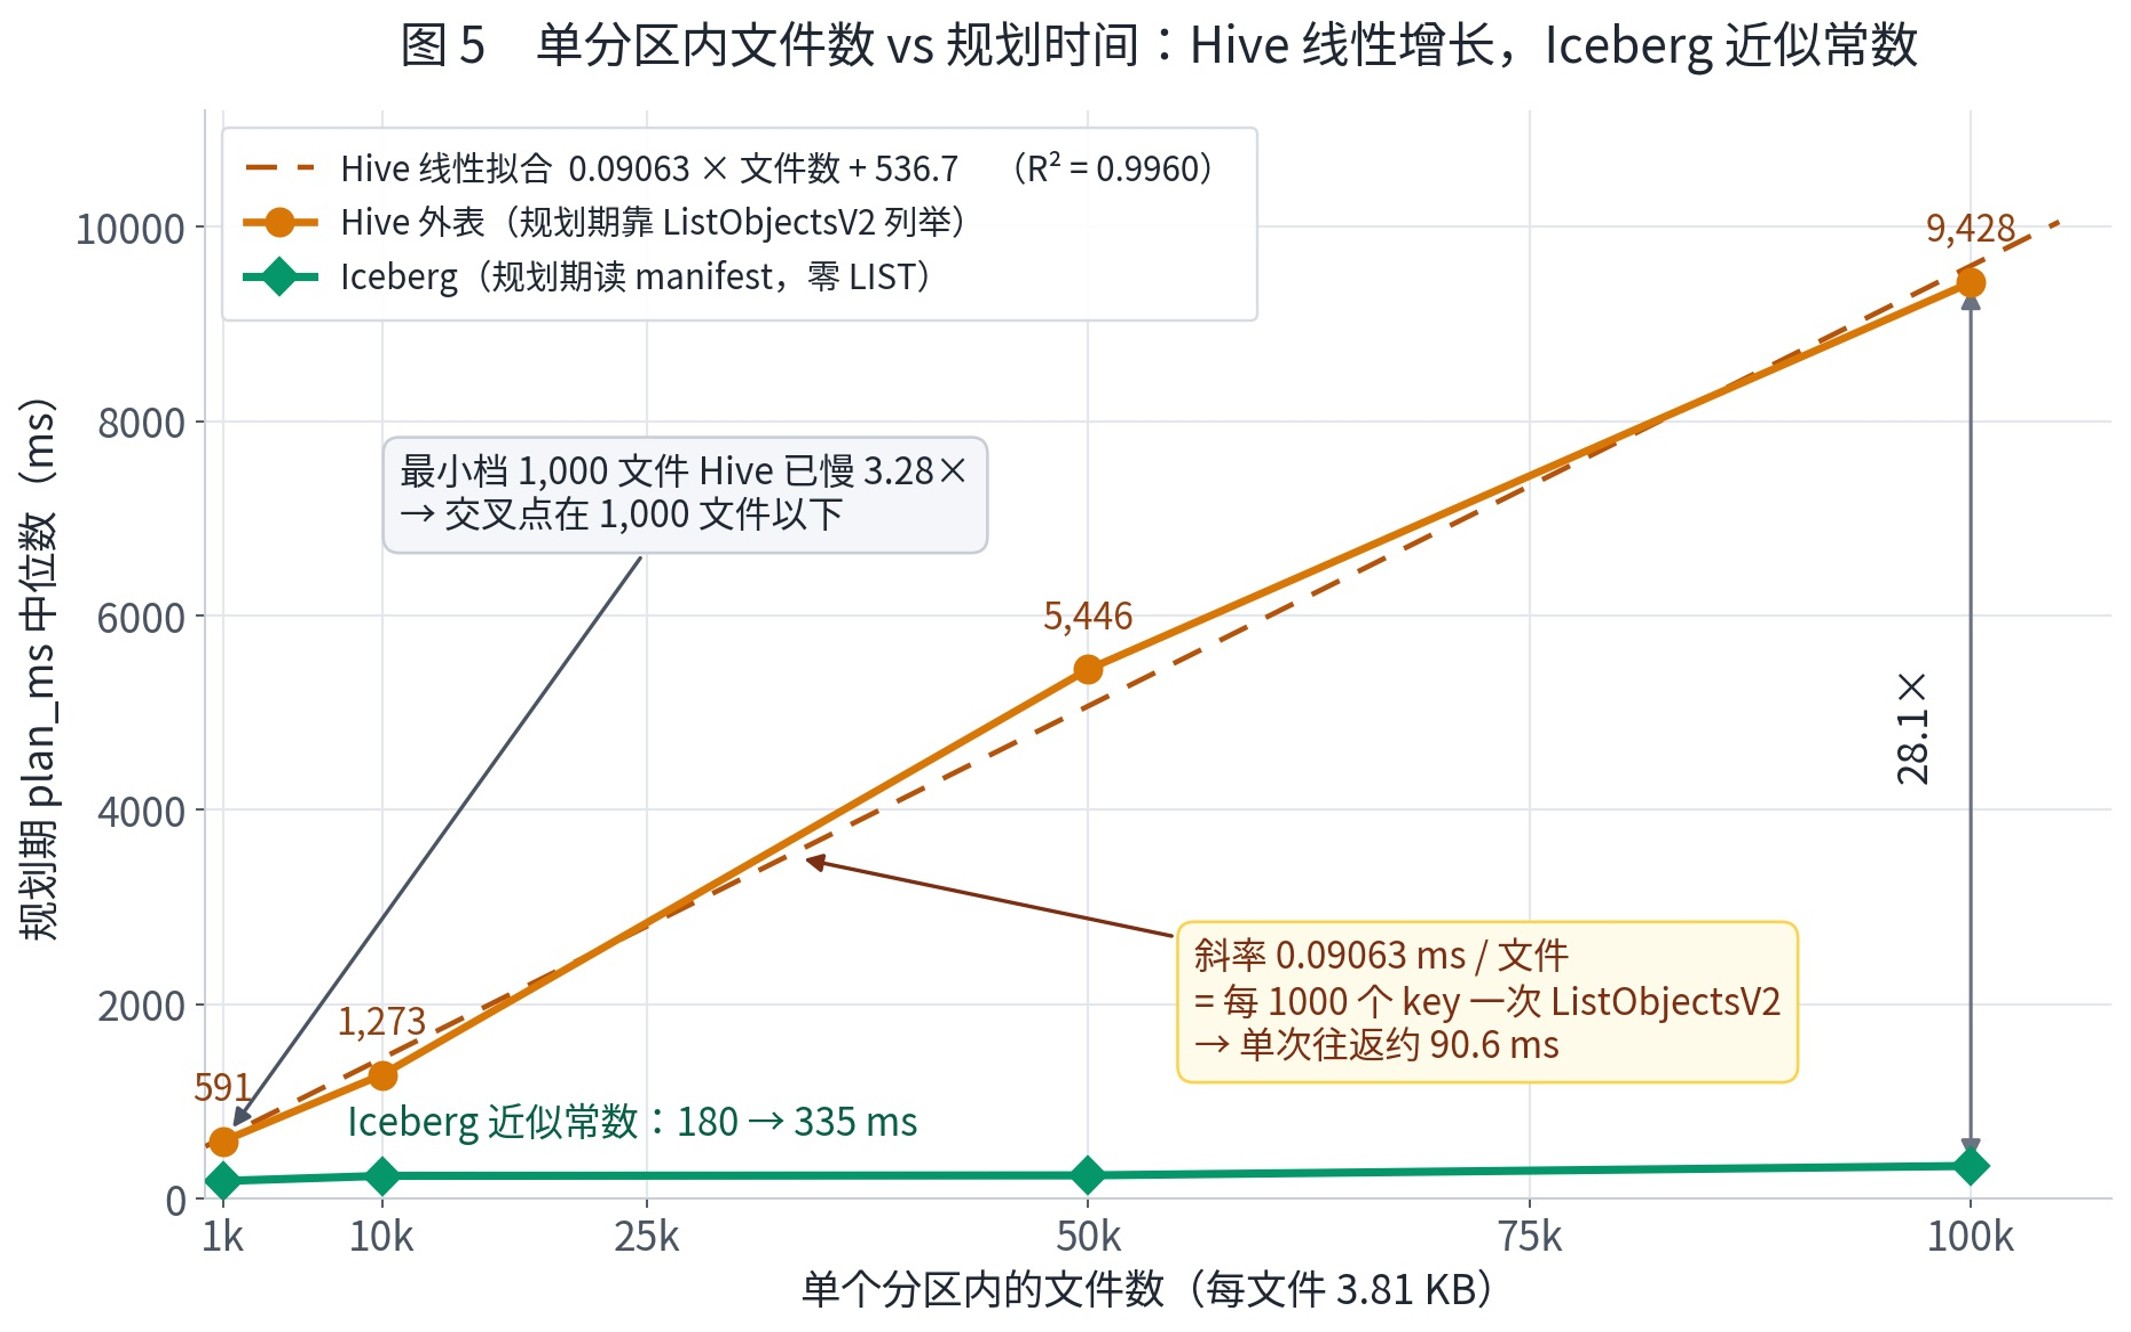
[图 5:单分区内文件数 vs 规划时间] |
图 5 单个分区、每文件 3.81 KB,plan_ms 中位数(3 次测量)。Hive 侧近似线性,截距 536.7 ms 是 Glue GetPartitions 加 Spark 自身规划的固定开销。这一优势只在规划期成立:同一批小文件的执行期 Iceberg 反而更慢(10,000 文件档 Hive 8,754 ms vs Iceberg 26,998 ms),因为 Iceberg 默认给每个小文件一个 split 而 Hive 用 openCostInBytes 合并了
3.3 按排序键裁剪文件:减少的是元数据往返,不是扫描字节
两张表,文件数(1,000/1,000)、每分区文件数(5/5)、平均文件大小(103.8/103.9 MB)三项全部对齐,唯一变量是 sort order:
| 对照组 | 每个文件在 c0 列的 min/max 区间宽度 ÷ 全域 |
| 未排序(Iceberg,无 sort order) | 99.9997% |
已排序(Iceberg,WRITE ORDERED BY c0) |
20.0000% |
未排序时区间覆盖 99.9997% 全域,min/max 对任何谓词都无法跳过任何文件——这由文件数直接决定,不是「效果小」,是「精确为零」。排序后,每分区 5 个文件把全域均匀切成 5 段,区间宽度降到 20.0000%(= 1/每分区文件数)。
结果:skippedDataFiles 0 → 800/1000,规划期选中字节 −79.0%,执行期 4.7–5.1 倍。
基线公平性检查:同一份已排序数据上,Hive 也在裁剪,在执行期用 Parquet row group 统计。在单列谓词查询上:已排序(Iceberg)扫描行数 149,616,770(全表的 19.9%),已排序(Hive Parquet,同一排序键)扫描行数 77,183,373(全表的 10.3%),Hive 反而更少,因为 row group 比文件更细。4 条 c0 谓词查询执行期合计:Iceberg 12,746 ms vs Hive 16,415 ms,比值 1.29×,而不是 4.7×。
结论:排序 Iceberg 省掉的是「打开那 800 个文件」的元数据 I/O 与 S3 请求(−79.0%),不是数据字节本身。 在执行期,Hive 用 Parquet footer 里的 row group 统计同样完成了相当程度的过滤,只是发生的时机更晚(文件已经打开了)。
排序只对排序列有效:同一张已排序表,谓词换到未参与排序的 c5 列,skippedDataFiles 立刻归零,执行期 29.8 s,比未排序表的 24.6 s 还慢 21%。WRITE ORDERED BY 是一个「按查询谓词选列」的决策,不是「打开就变快」的开关。多列谓词需要多列排序或 Z-order,但这会稀释每一列的区间收窄程度。
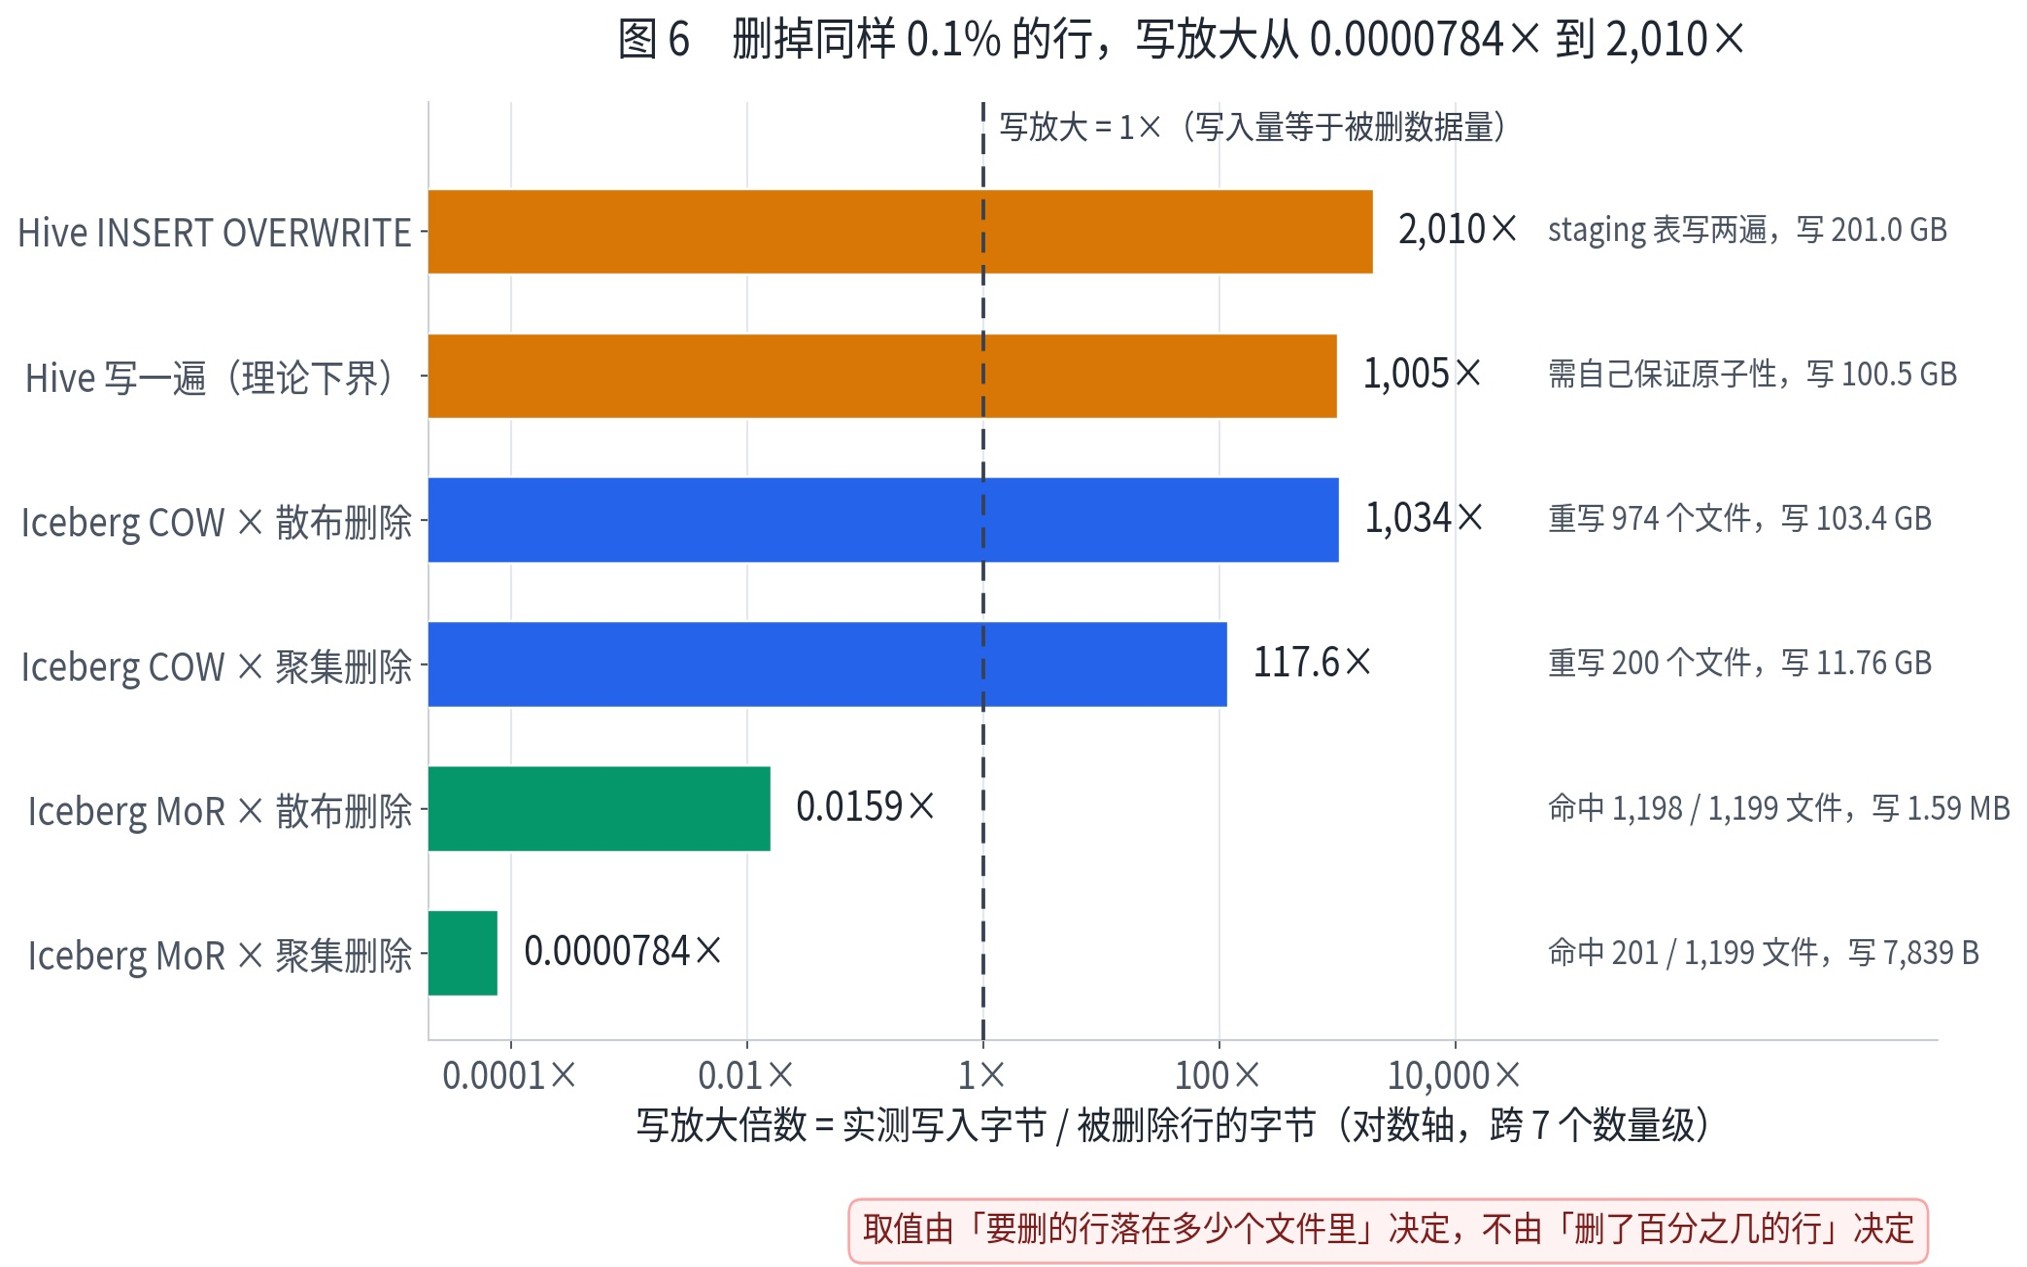
[图 6:行级删除的写放大] |
图 6 同一张 1,199 文件、7.28 亿行的表,删掉 0.1% 的行(72.86 万行),format-version 3 + 删除向量。取值由「要删的行落在多少个文件里」决定,不由「删了百分之几的行」决定:聚集形态命中 201 / 1,199 个文件,散布形态命中 1,198 / 1,199 个文件,于是 copy-on-write 在散布形态下完全没有优势(1,034× vs Hive 下界 1,005×)。命中文件数可以直接量出来:SELECT count(*) FROM (SELECT DISTINCT _file FROM t WHERE <谓词>)。Hive 的 1,005× 是理论下界,一条 SQL 做不到,实践典型值是 staging 写法的 2,010×
3.4 元数据即可回答的查询
Iceberg 的每个 manifest entry 里存着该数据文件的 record_count 与每列的 lower_bounds / upper_bounds。对应地,SELECT count(*) 把当前快照所有 manifest entry 的 record_count 求和即可,一个数据文件都不用打开。
实测(1,199 个文件,728,791,000 行,93.7 GiB):
| 查询 | Iceberg(下推开启) | Hive | 比值 |
SELECT count(*) |
397 ms | 2,337 ms | 5.89× |
SELECT min(k), max(k)(有序列) |
8,594 ms | 2,292 ms | 0.27×(Iceberg 慢 3.75 倍) |
SELECT min(c0), max(c0)(随机列) |
11,561 ms | 2,082 ms | 0.18×(Iceberg 慢 5.55 倍) |
Iceberg count(*) 的物理计划是 LocalTableScan,规划期选中字节 0,扫描节点输出行数为 1——连读取器都没起。
min/max 下推在本轮实测中没有发生。 Iceberg 侧的物理计划仍是 BatchScan + 全表 7.28 亿行,比 Hive 慢 3.75–5.55 倍。开关不是原因:spark.sql.iceberg.aggregate-push-down.enabled 默认为 true、实测读回 true,同一开关让 count(*) 走了下推;列统计形态也不是原因(文件间有序的 k 与几乎完全重叠的 c0 结果一致)。Hive 侧之所以只用 2.0–2.3 s,是因为 EMR 7.13 存在一项列式聚合优化,把 count/min/max 压到了 Parquet 读取路径里:扫描节点的 numOutputRows 为 1,199(= 文件数)而不是 7.28 亿。
7.8 KB 的删除向量使 count(*) 从 411 ms 退化为 2,381 ms(5.79×),且物理计划里没有任何提示——LocalTableScan 变回了 HashAggregate → BatchScan。201 个 DV 文件,实际 blob 仅 7,839 字节,就已经让元数据下推失效。在有 delete file 或 DV 的表上不能假设 count(*) 走快路径。
3.5 行级删除的写放大
实测六条路径,删除对象:95.34 MiB 的数据(散布 = 目标行随机分布在所有文件里;聚集 = 目标行集中在少数文件里):
| 路径 | 实测写放大 | 实测写入字节 | 实际耗时 |
Hive INSERT OVERWRITE(staging,写两遍,实践典型值) |
2,010× | 200,951,403,559 B | 643.56 s |
| Hive(写一遍,理论下界,需自己保证原子性) | 1,005× | 100,475,705,668 B | 422.55 s |
| Iceberg CoW × 散布删除 | 1,034× | 103,401,448,752 B | 342.69 s |
| Iceberg CoW × 聚集删除 | 117.6× | 11,759,730,204 B | 37.75 s |
| Iceberg MoR × 散布删除 | 0.0159× | 1,589,704 B | 11.38 s |
| Iceberg MoR × 聚集删除 | 0.0000784× | 7,839 B | 3.25 s |
CoW × 散布没有优势:目标行散布时命中 1,198 / 1,199 个文件(99.9%),CoW 写放大 1,034×,比 Hive 理论下界 1,005× 还差 2.8%。CoW 的价值完全由「要删的行落在多少个文件里」决定,不由删的行数占比决定。
MoR × 聚集的极端情况:删 95.34 MiB 的数据只写了 7,839 字节,字节比 12,816,000:1,实际耗时 3.25 s vs Hive 下界 422.55 s(130:1)。读侧代价:全表扫描 11,217 ms → 11,406 ms,多了 1.7%。
S3 API 请求的相关数据:INSERT OVERWRITE 发出 1,199 次 BATCH.DELETE.OBJECT + 200 次 POST.MULTI_OBJECT_DELETE + 200 次 DELETE.OBJECT,物理删除旧文件。Iceberg 两条路径的 DELETE 计数都是 0——旧快照的文件由 expire_snapshots 统一清理,不在写入时删除,因此 Iceberg 的失败更安全(没有中途删了旧文件但没写完新文件的残缺状态)。
3.6 成本节省的归属
以上几个场景测得的优势,归结起来是同一件事:省的是 S3 请求与元数据往返,不是扫描字节。
下推的 count(*) 发出 23.3 次请求/run,Hive(Parquet footer 缓存已热)发出 1,209 次请求/run(−98.1%)。这 1,186 次节省的是 footer 读的 GET 请求,而不是数据字节——Hive 侧也用了 footer 的行组统计在执行期过滤字节,只是在已经打开文件之后才做这件事。
对于文件大小:本轮测试从 100.9 MB Compaction 合并到 503.8 MB,执行期只快 8.7%(Spark 把大文件切成 128 MiB 的 split,两侧 task 数只差 25%)。文件大小的痛点在 1–10 MB 量级,100 MB 起点上 Compaction 的执行期收益有限。
zstd vs snappy:同一份 3TB TPC-DS 数据,文件数几乎相同,zstd 落盘小 23.6%(分表范围 23.0%–26.9%),这是真实的扫描字节节省,独立于表格式。
四、第四章 AWS 对 Iceberg 的全面支持与 S3 Tables 托管运维
4.1 Glue Data Catalog 四位一体
Glue Data Catalog 同时承担四个职责:
- Iceberg 原生 catalog 后端(
org.apache.iceberg.aws.glue.GlueCatalog,Apache Iceberg 官方仓库aws模块,不是私有分支)。乐观并发靠UpdateTable+VersionIdCAS,不需要 DynamoDB 锁表(glue.DynamoLockManager别名类在 Iceberg 1.0.0 被删除,Glue 侧自 0.14.0 起默认走VersionIdCAS)。 - Iceberg REST Catalog 服务端(
https://glue.<region>.amazonaws.com/iceberg,2024-12-03 上线)。任何实现了 Iceberg REST 规范的引擎——Trino、DuckDB、ClickHouse、跑在其他云上的 Spark——都能直接接入,无需安装iceberg-aws包。 - 联邦目录(可联邦 Hive Metastore / Redshift / Snowflake / Unity Catalog)。
- Lake Formation 细粒度权限控制。
三条 catalog 接入路径的配置示例:
4.2 引擎覆盖面
| 引擎 | Iceberg 版本 | format-version 3 | 写入 DML |
| EMR 7.13(Spark 3.5.6-amzn-2) | 1.10.0-amzn-1 | ✅ 读写(≥ 7.12 起) | INSERT / UPDATE / DELETE / MERGE |
| Athena engine v3 | 1.4.2 | ❌ Cannot read unsupported version 3 |
INSERT / UPDATE / DELETE |
| Redshift | — | ✅ 读写(2026-08-31 起) | INSERT / UPDATE / DELETE / MERGE |
| Glue ETL 5.x | 1.10.0 | ✅ | INSERT / UPDATE / DELETE / MERGE |
Redshift format-version 3 需要 Graviton 架构的预置集群或 Serverless;v3 表不支持 struct / list / map / variant 等复杂类型及 geometry / binary / uuid / time / timestamp_ns 等标量类型;v3 不可降级回 v2;建表时未指定 format-version 时默认建出 v2 表。
4.3 摄入侧的支持
Firehose 支持按记录内容路由到不同 Iceberg/S3 Tables 表
Firehose 支持通过 JQ 表达式从每条记录的内容中提取目标表名,把同一条流里的不同消息路由到不同的 Iceberg 表。otfMetadata 字段携带 operation(insert/update/delete)与目标表名,Firehose 按配置的唯一键在目标表上执行行级操作。
Amazon MSK Data Delivery 内置 inline compaction
MSK 可以直接配置把 Kafka 流数据直接写成 Iceberg/S3 Tables 表,摄入侧内置 inline compaction,尽可能较少「小文件从流式摄入产生、需要一个独立作业来合并」这个运维环节。
AWS 自身用 Iceberg 交付元数据
S3 Metadata(元数据查询服务,以 managed Iceberg 表的形态暴露对象元数据)和 Storage Lens 指标表,都是托管 Iceberg 表, AWS 把按需自己的服务构建在 Iceberg 上。
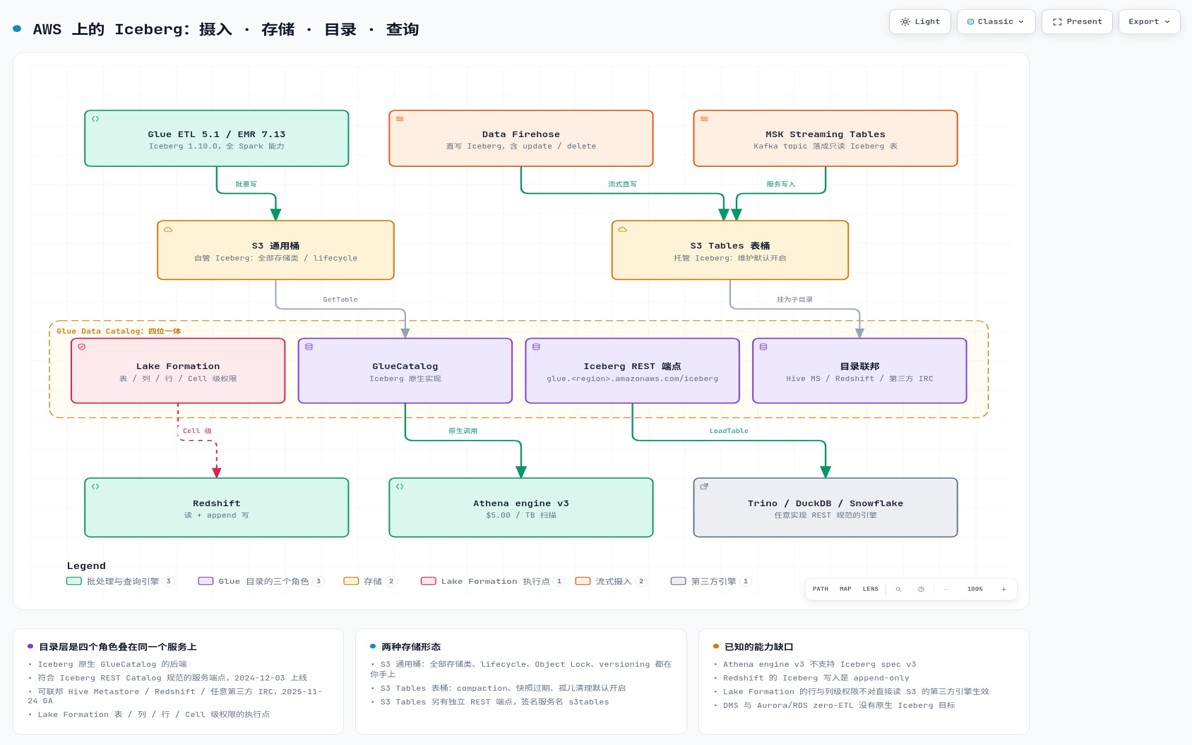
[图 7:AWS 上的 Iceberg 生态] |
注意上图,写入测都支持 S3 Tables 和标准 S3 Iceberg,连线只是示意。虚线框内的四个节点是同一个 Glue Data Catalog 承担的四个角色,不是四个服务。REST 端点上线日期 2024-12-03(Glue 5.0 同期),任意第三方 Iceberg REST catalog 的联邦 2025-11-24 GA。S3 Tables 另有独立 REST 端点,签名服务名是 s3tables 而非 glue;两条路径都能访问同一批表
4.4 S3 Tables 托管运维
零配置默认值(本次 24 张表实测)
所有 24 张表直接 GET metadata.json 确认 format-version=3,零配置即有自动运维:
| 配置项 | 默认值 |
targetFileSizeMB |
512 |
strategy |
auto |
minSnapshotsToKeep |
1 |
maxSnapshotAgeHours |
120(5 天) |
桶级 unreferencedDays |
3 天 |
桶级 nonCurrentDays |
10 天 |
strategy=auto 的实际含义:有 sort order 就执行 sort,没有就执行 binpack。当前测试的表 sort-orders 为空,auto 的实际策略是 binpack。开了 auto 不等于有数据聚簇——聚簇需要先在表属性里定义 sort order。
Successful 不等于执行了合并
24 张表的 compaction 运行结果全是 Successful,但 metadata 全部停在 00001-*.metadata.json——binpack 判断平均文件大小(236 MB)已在合理范围内。确认 compaction 是否真的执行了合并,要看 metadataLocation 的版本号是否变化,或快照数是否新增,不能看作业状态。
S3 Tables 的 TPS 优势机制
通用桶每个前缀的 PUT 限制 3,500/s、GET 限制 5,500/s,多张表共享上层前缀时相互竞争。S3 Tables 给每张表一个独立内部桶(底层桶名形如 <uuid>--table-s3),表之间物理上不共享前缀,彻底消除跨表前缀竞争。官方公布的性能提升数字是 3x 查询性能、10x TPS(2024-12-03 AWS News Blog)。同批 AWS Storage 博客(2024-12-04)相关测试性能是:3TB TPC-DS 数据集切成 1 MB 文件、取 8 条 IO 密集型查询,总执行时间 2.26x,单条最高 3.22x,1 MB 对象相比 512 MB 对象需要多 8.5 倍读请求;对比对象是通用桶里未做 compaction 的 Iceberg 表。
需要注意的运维细节
- S3 Tables 存储类建表时确定,之后无法修改。
- 经 S3 Tables 的 Iceberg REST 端点提交的 Spark CTAS 不可用(
Malformed request: Stage-create is currently not supported.),需拆成CREATE TABLE(列定义写全)+INSERT INTO两步;走 Glue 路径的 Athena CTAS 可用,但每条语句最多 100 个「分区 + bucket 组合」,且失败后残留的表只能用aws s3tables delete-table删。 - Iceberg 的 commit 重试默认为 4 次(
commit.retry.num-retries=4)、总超时 30 分钟;托管 compaction 与用户写入在乐观并发下会冲突,建议写入 pipeline 自己也带重试逻辑。 - 表上存在任何用户自定义 branch 或 tag 时,快照管理对整表失败(快照既不过期也不清理);把
history.expire.max-snapshot-age-ms或history.expire.min-snapshots-to-keep设成表属性会触发同一后果。可用aws s3tables get-table-maintenance-job-status确认FAILED与原因。
Iceberg CDC 实时更新场景下的写入与查询性能是另一个独立的话题,本文没有展开。多表并行写入时的并发冲突特征、Compaction 运行节奏与查询性能之间的平衡点、以及 Iceberg V3 在 CDC 场景下删除向量的实际表现,将在下一篇专门介绍。
五、相关链接
➡️ 下一步行动:
相关产品:
- Amazon S3 — 适用于 AI、分析和存档的几乎无限的安全对象存储
- Amazon Glue — 简单、可扩展的无服务器数据集成
- Amazon Athena — 使用 SQL 在 S3 中查询数据
- Amazon EMR — 轻松运行大数据框架
- Amazon MSK — 完全托管式 Apache Kafka 服务
相关文章:
- 在AWS EMR Core节点部署Flink Client的实战指南
- AWS Glue 6.0 现已发布,价格降低 30%,并全面支持 Apache Iceberg v3
- S3 Tables 实战:两种方案,把 MySQL 数据实时”搬”进 S3 Tables
- Amazon Redshift 推出带有集成数据湖查询引擎的基于 AWS Graviton 的 RG 实例
- 使用 Amazon S3 Tables 优化数据湖:从Hudi 迁移到托管 Iceberg
*前述特定亚马逊云科技生成式人工智能相关的服务目前在亚马逊云科技海外区域可用。亚马逊云科技中国区域相关云服务由西云数据和光环新网运营,具体信息以中国区域官网为准。
本篇作者
AWS 架构师中心:云端创新的引领者探索 AWS 架构师中心,获取经实战验证的最佳实践与架构指南,助您高效构建安全、可靠的云上应用
|
 |