摘要:借助亚马逊云科技云 Bedrock 以及相关 AI 服务,构建基于 LLM 的药品与医疗器械说明书多版本迭代对比与统计系统
一、方案背景
医药行业是全球监管最为严格的行业之一。药品与医疗器械的说明书(Instructions for Use,简称 IFU)作为产品注册审批和上市后监管的核心文件,承载着产品安全性、有效性、适应症、禁忌症、用法用量等关键信息,直接关系到患者用药安全和临床使用规范。在中国,国家药品监督管理局(NMPA)对药品和医疗器械说明书的内容、格式和变更管理有着极为严格的要求。任何说明书内容的修订都必须经过严格的注册审评流程,确保每一次变更都有据可查、有迹可循。
随着药品和医疗器械产品生命周期的推进,说明书会因为多种原因进行迭代更新:新的临床研究数据发现了额外的不良反应、适应症范围的扩展或缩减、生产工艺的变更导致辅料成分调整、监管政策的更新要求增补特定警示信息、国际协调标准的同步等。对于大型跨国医疗器械企业而言,其产品线横跨影像诊断、患者监护、呼吸治疗、心血管介入等众多领域,涉及的说明书数量庞大,每年需要处理的版本迭代更新工作量极为繁重。
当前,企业的注册部门和医学写作团队长期面临一个核心痛点:每次说明书完成版本迭代后,写作人员必须逐字逐句地手动比对新旧版本之间的差异,并将所有变更内容整理成结构化的对比统计表,用于提交监管注册审评。
这一人工比对流程的问题是多方面的。首先是效率极低。一份医疗器械说明书通常包含数十页甚至上百页的专业内容,涵盖文字描述、技术参数表格、操作流程图、警示标识图片等多种元素。人工逐页比对一份说明书的两个版本,往往需要数小时甚至数天的时间。当多个产品线同时进行说明书更新时,写作团队面临的工作压力倍增,严重影响产品注册上市的进度。其次是准确性难以保证。人工视觉比较天然存在注意力衰减的问题,面对大段相似的专业文本,写作人员极易遗漏细微但关键的变更——比如一个数值的小数位变化、一个医学术语的替换、一个警示级别的提升。这些看似微小的遗漏,在监管审计中可能引发严重的合规问题。再者是格式多样性带来的挑战。说明书不仅包含纯文本段落,还大量嵌入了表格(如技术规格表、兼容性列表)、图片(如操作示意图、标签图样)、以及结构化的编号条款。这些多模态内容的版本差异识别,对人工比对构成了额外的难度。传统的文本比对工具(如 Word 的修订模式)在处理复杂表格和图片差异时表现欠佳。
近年来,大语言模型技术的快速发展为文档智能处理领域带来了革命性的突破。以 Claude 系列模型为代表的新一代 AI 技术,展现出了卓越的长文本理解、语义分析、跨段落推理和结构化信息提取能力。这些技术能力恰好匹配说明书版本对比场景的核心需求:理解医学专业语境、识别语义层面的差异(而非仅仅是字面文本的不同)、保留文档结构信息、生成规范化的输出。
基于上述背景,本项目旨在构建一套基于 AWS Bedrock 平台大语言模型的药品与医疗器械说明书多版本迭代对比与统计系统。系统的核心能力包括:自动解析 PDF 格式的说明书文档,利用智能分块和向量检索技术精准匹配新旧版本的对应章节,通过大模型进行深度语义对比分析,最终自动生成包含”条款””注册审评说明书(旧版)””修订说明书(新版)”和”变更内容”四列的结构化对比统计表,并支持导出为规范化的 Word 文档。
本方案的成功实施将为企业带来直接的业务价值:显著缩短说明书版本对比的工作周期、大幅降低人为遗漏风险、提升注册申报材料的质量和规范性、释放医学写作团队的专业产能,使其能够聚焦于更具创造性的写作工作。同时,作为一个通用的文档智能对比解决方案,其技术架构和能力同样适用于健康与生命科学行业的其他客户,具备广泛的商业化推广前景。
二、方案构建
2.1 实现流程
本系统的核心业务逻辑围绕”文档输入—智能解析—语义匹配—差异对比—结构化输出”五个关键环节展开,形成一条完整的自动化处理流水线。
用户通过前端界面上传两份 PDF 格式的说明书文档,分别对应同一产品的旧版本(注册审评版)和新版本(修订版)。系统接收文件后,首先通过 MD5 哈希校验判断该文档是否曾经被处理过。若缓存中已存在对应的解析结果,则直接复用,避免重复计算;若为首次上传,则进入文档解析流程。
在文档解析阶段,系统将 PDF 文档转换为结构化的 Markdown 格式。转换过程中,系统会识别文档中的文字段落、表格结构和图片元素,并为图片内容生成位置标记,确保后续对比和输出环节能够准确还原图片的原始位置。解析完成后,文档内容被交由分块处理模块进行智能分块。分块策略基于文档的章节结构和语义边界,将长文档拆分为若干语义完整的内容块,每个块携带原文内容、所属章节信息、版本标识以及对应的向量表示。
语义匹配是整个流程的关键技术环节。系统将旧版本文档的所有内容块存入向量检索引擎,构建起一个支持关键词匹配和向量检索的混合索引。随后,以新版本的各章节内容块作为查询条件,在旧版本索引中检索语义最相近的对应段落。这一混合检索策略的优势在于:即使新旧版本之间的章节标题发生了调整、段落顺序进行了重排、或者表述方式有了较大变化,系统仍然能够通过语义相似性准确找到对应关系。检索结果经过二次排序模型的精排,进一步提升匹配精度。
完成段落级别的匹配后,系统将每一对匹配的新旧段落块送入大语言模型进行深度语义对比。大模型凭借其对医学专业术语和监管文本语境的理解能力,逐对分析内容差异,判断是否存在实质性变更,并对变更的性质和内容进行精确描述。对比结果以 XML 格式输出,其中保留了图片位置信息和段落结构标记,确保后续文档生成时能够完整还原原始版面布局。
XML 差异结果经过专用解析器的处理,被转换为结构化的差异列表。每一条差异记录包含四个维度的信息:变更所属的条款编号、旧版本中的原文内容、新版本中的修订内容、以及对变更点的摘要说明。这一结构化数据直接对应监管审评所要求的对比统计表格式。
在最终的文档输出环节,系统将结构化差异列表渲染为规范的 Word 文档。渲染过程中,系统会将 Markdown 中的图片位置标记替换为实际的图片文件,生成包含真实图片的专业对比报告。输出文档采用四列表格形式,清晰展示每一处变更的上下文和具体内容,可直接用于注册申报材料的提交。
整个处理流程通过双层缓存机制实现性能优化:PDF 转换层面的缓存避免了同一文档的重复解析,对比结果层面的缓存避免了相同段落对的重复比对调用。这一设计在保证处理结果完整性和准确性的同时,显著降低了系统的响应时间和模型调用成本,支撑业务团队高效、反复地进行版本对比工作。
2.2 方案架构
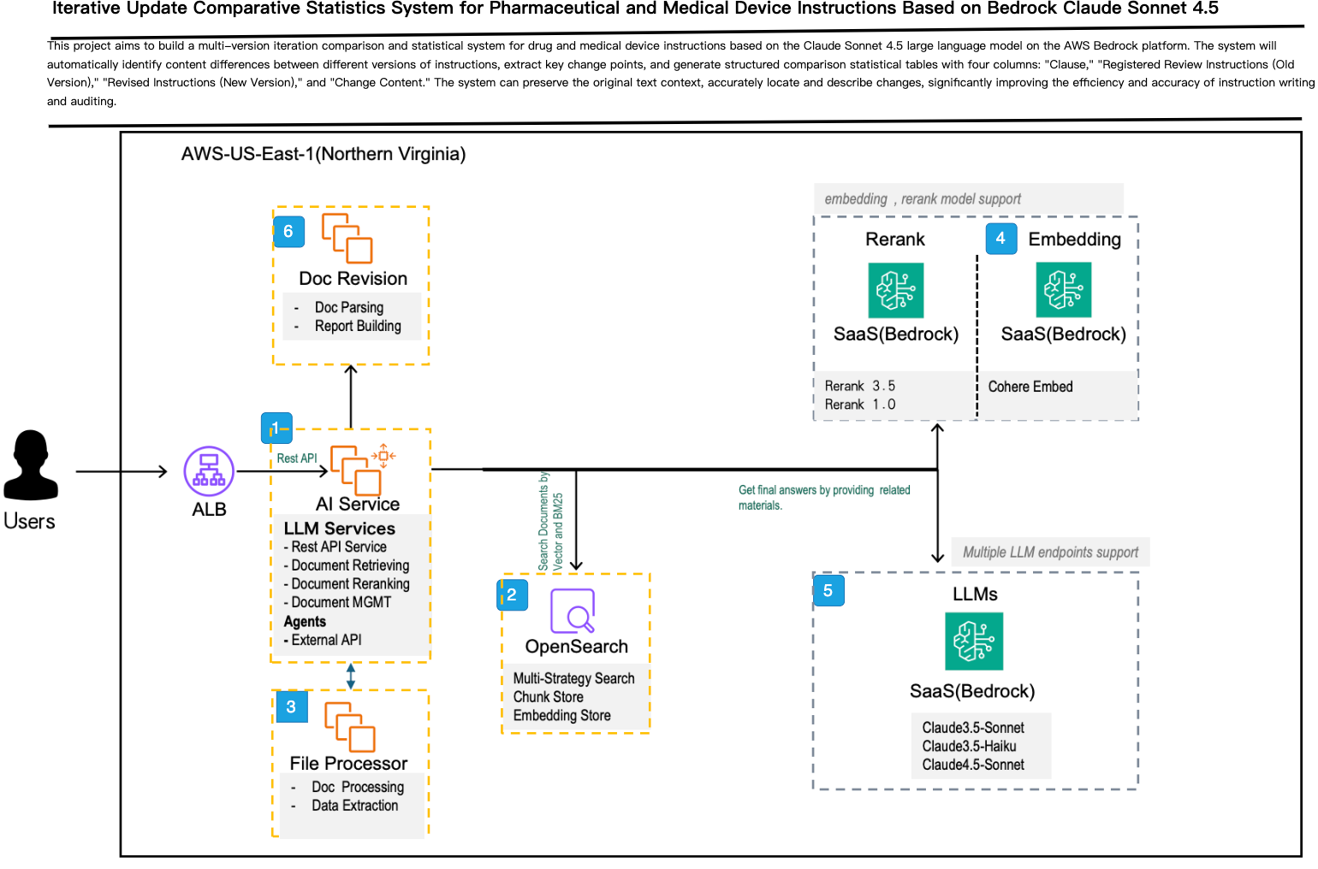
[图 1 – 内容生成平台高可用部署架构] |
AWS 架构说明
- 此架构旨在通过 AWS 基础设施和 AI 服务部署 AI 文档辅助应用程序,从而能够自动处理药品和器械说明书的版本比较和统计。
- 使用的主要 AWS 服务包括 Amazon ECS、S3 和 Bedrock。
- 主应用程序部署在 Amazon ECS 上,此实例仅供公司内部业务用户访问。
- 段落匹配库存放于托管的 Amazon OpenSearch。OpenSearch 作为智能检索引擎,存储经 File Processor 分块处理的说明书文档,每个块包含原文、章节信息、版本标识和 Embedding 向量。处理较大文档版本比对时,系统以新版本章节为查询,通过关键词匹配和向量检索的混合策略在旧版本中找到对应章节,即使标题或表述变化也能准确匹配。
- 文本的 Embedding 和 Reranking 直接调用 AWS Bedrock 提供的托管模型。
- 大型语言模型基于 Bedrock 使用 Claude 4.5 Sonnet 模型。
2.3 关键技术实现代码
系统差异对比的核心在于精心设计的大模型提示词(Prompt)。
该提示词严格区分”格式差异”与”实质性内容差异”,指导模型仅输出真正的内容变更,从而保证注册审评所需的对比结果精准可靠。以下为说明书差异对比提示词的核心内容:
prompt:
# 说明书差异对比提示词
# 使用位置: process/md_diff_compare.py -> compare_whole_document()
instruction_diff_prompt: |
您是一个说明书差异对比专家。我们会给您提供两个版本的说明书文档(Markdown 格式),您需要找出所有的**实质性内容变更**。
** 超级重要 - 必须严格遵守 **
**对比方法(必须按此步骤执行):**
1. **第一步:格式清理**
- 将文档 A 的所有 Markdown 标记去掉,得到纯文本 A
- 将文档 B 的所有 Markdown 标记去掉,得到纯文本 B
- 例如:`# 标题` → `标题`,`## 标题` → `标题`,`**文字**` → `文字`
2. **第二步:纯文本对比**
- 只对比纯文本 A 和纯文本 B
- 逐字检查差异
3. **第三步:判断是否输出**
- 纯文本相同 → **不输出**(这是格式差异)
- 纯文本不同 → **输出**(这是内容差异)
**示例说明:**
- `# 使用说明` vs `## 使用说明` → 去掉#后都是`使用说明` → **不输出**
- `**警告**` vs `警告` → 去掉**后都是`警告` → **不输出**
- `使用说明` vs `使用方法` → 纯文本不同 → **输出**
**重要原则 - 区分格式差异和内容差异**:
**禁止输出的差异类型**(纯格式变化,不是实质性差异):
1. **格式标记的增删**:
- 加粗标记:`**文字**` vs `文字`
- 斜体标记:`*文字*` vs `文字`
- 下划线、删除线等格式标记
- **空格调整**:
- 空格数量变化
- 空格位置变化
- 空格的增加或删除
- **完全忽略所有空格差异**
3. **页码引用变化**(如"见 32 页"改为"见 31 页")
4. **锚点链接、HTML 标签的增删**(如 <span id="xxx"></span>)
5. **章节标题层级变化**(# vs ## vs ### vs ####,标题文字相同)
6. **换行、缩进的变化**(文字内容相同)
7. **列表格式变化**(有序 vs 无序,列表内容相同)
8. **目录的变化**(目录本身不对比)
9. **页眉、页脚、页码本身**
**必须输出的差异类型**(实质性内容变化):
1. **文字内容的增删改**(非常重要,必须全部识别):
- **单个字的变化**(如"使用"改为"使明","的"改为"地")
- **词语替换**(如"使用"改为"应用","患者"改为"受试者")
- **语序调整**(如"请勿使用"改为"使用请勿")
- **标点符号的实质性变化**(如"。"改为"!",","改为";")
- **助词、连词的增删**(如"的"、"了"、"和"、"或"的增删)
- **量词、单位的变化**(如"个"改为"只","次"改为"回")
- **句子的增加或删除**
- **段落的增加或删除**
- **任何导致语义或语气变化的文字调整**
2. **数值、数据的变化**:
- 数字变化(如"100mg"改为"200mg","3 次"改为"2 次")
- 百分比变化(如"50%"改为"60%")
- 时间、日期的变化(如"2 小时"改为"3 小时")
- 范围的变化(如"1-3 次"改为"2-4 次")
3. **关键信息的变更**:
- 警告内容的改变
- 注意事项的改变
- 使用说明的改变
- 技术参数的改变
- 适应症、禁忌症的改变
**判断标准(严格模式)**:
- 去掉所有格式标记后,逐字对比纯文本内容
- **只要有任何一个字不同 → 就是差异,必须输出**
- **只有完全相同(包括标点符号)→ 才不是差异**
- 特别注意:
* "患者"和"受试者"虽然含义相近,但用词不同,**必须输出**
* "使用"和"应用"虽然含义相近,但用词不同,**必须输出**
* "的"和"地"虽然都是助词,但不同,**必须输出**
* 任何细微的表述差异都要识别
说明:以上提示词经过多轮优化,确保模型聚焦实质性内容变更,避免格式噪声干扰监管审评。
除提示词设计外,系统的自动化处理流水线由三个关键环节的核心代码支撑:PDF 转换(PDF → Markdown 并保留图片)、Bedrock 大模型调用(发起深度语义对比推理)、以及置信度分析(相似度打分用于段落对齐与差异高亮)。数据流为:PDF →转 Markdown→ 切块 →相似度对齐→Bedrock 判差异→置信度评估→ 导出 评估结果。以下为三个环节的关键实现代码。
① PDF 转换
使用 marker-pdf 模型将 PDF 转换为 Markdown 并提取图片,通过 MD5 哈希缓存避免同一文档重复解析。
# =============================================================================
# 1. PDF 转换(PDF -> Markdown,保留图片)
#    来源:Phase1/process/pdf_to_md_with_images.py
#    核心:用 marker-pdf 模型把 PDF 转成 Markdown 并提取图片,带 MD5 缓存
# =============================================================================
# 全局模型缓存(避免每次都重新加载 10-30 秒的模型)
_MODEL_DICT = None
_CONVERTER = None
CACHE_DIR = Path(".cache/pdf_to_md")
def get_pdf_hash(pdf_file):
    """计算 PDF 的 MD5,用作缓存 key(同一份 PDF 不重复解析)。"""
    hash_md5 = hashlib.md5()
    with open(pdf_file, "rb") as f:
        for chunk in iter(lambda: f.read(4096), b""):
            hash_md5.update(chunk)
    return hash_md5.hexdigest()
def convert_pdf_to_md_with_images(pdf_file, output_dir=None, use_cache=True):
    """
    将 PDF 转换为 Markdown,保留图片位置信息。
    Returns:
        dict: {'markdown', 'images', 'image_paths', 'metadata', 'output_dir', ...}
    """
    global _MODEL_DICT, _CONVERTER
    pdf_path = Path(pdf_file)
    if not pdf_path.exists():
        raise FileNotFoundError(f"PDF 文件不存在: {pdf_file}")
    # ——缓存命中则直接返回(此处省略缓存图片重存的细节,见原文件)——
    if use_cache:
        cache_path = CACHE_DIR / f"{pdf_path.stem}_{get_pdf_hash(pdf_file)}.pkl"
        if cache_path.exists():
            with open(cache_path, "rb") as f:
                result = pickle.load(f)
            result["from_cache"] = True
            logger.info("✓ 使用缓存结果,跳过 PDF 转换")
            return result
    if output_dir is None:
        output_dir = pdf_path.parent / f"{pdf_path.stem}_images"
    output_dir = Path(output_dir)
    output_dir.mkdir(parents=True, exist_ok=True)
    # ——关键:调用 marker-pdf 做转换(首次加载模型较慢,之后复用)——
    from marker.converters.pdf import PdfConverter
    from marker.models import create_model_dict
    if _MODEL_DICT is None:
        logger.info("首次加载 marker-pdf 模型(这可能需要 10-30 秒)...")
        _MODEL_DICT = create_model_dict()
    if _CONVERTER is None:
        _CONVERTER = PdfConverter(artifact_dict=_MODEL_DICT)
    rendered = _CONVERTER(str(pdf_file))          # <-- 实际转换发生处
    markdown_text = rendered.markdown
    images = rendered.images
    # 把提取出的图片落盘,并记录 id -> 路径 的映射
    image_paths = {}
    for img_id, img_data in images.items():
        img_filename = img_id if "." in img_id else f"{img_id}.png"
        img_path = output_dir / img_filename
        img_data.save(img_path)
        image_paths[img_id] = str(img_path)
    metadata = {
        "pages": len(rendered.pages) if hasattr(rendered, "pages") else 0,
        "has_images": len(images) > 0,
        "image_count": len(images),
    }
    result = {
        "markdown": markdown_text,
        "images": images,
        "image_paths": image_paths,
        "metadata": metadata,
        "output_dir": str(output_dir),
        "from_cache": False,
    }
    if use_cache:
        CACHE_DIR.mkdir(parents=True, exist_ok=True)
        cache_path = CACHE_DIR / f"{pdf_path.stem}_{get_pdf_hash(pdf_file)}.pkl"
        with open(cache_path, "wb") as f:
            pickle.dump(result, f)
    return result
② Bedrock 大模型调用
初始化 bedrock-runtime 客户端并发起推理,同时兼容 Claude 与 DeepSeek 两种请求/响应格式,配有指数退避重试机制。
# =============================================================================
# 2. Bedrock 调用
#    来源:Phase1/llms/aws_claude.py
#    核心:初始化 bedrock-runtime 客户端 + invoke_model_bedrock() 发起推理
#          同时兼容 Claude 与 Amazon Nova 两种请求/响应格式,带重试
# =============================================================================
# —— 配置从 config.yaml 读取(此处给出等价默认值,实际以配置为准)——
# USE_BEDROCK        = config['model']['use_bedrock']
# BEDROCK_AWS_REGION = config['model']['bedrock_region']       (默认 us-east-1)
# BEDROCK_MODEL_ID   = config['model']['bedrock_model']
# BEDROCK_PROFILE    = config['model']['bedrock_profile']
BEDROCK_AWS_REGION = "us-east-1"
BEDROCK_MODEL_ID = "anthropic.claude-3-5-sonnet-20240620-v1:0"
BEDROCK_PROFILE = None
# 初始化 Bedrock 客户端(配置更长的超时与重试)
_boto_cfg = boto3.session.Config(
    read_timeout=600,      # 10 分钟读取超时
    connect_timeout=120,   # 2 分钟连接超时
    retries={"max_attempts": 5},
)
if BEDROCK_PROFILE:
    _session = boto3.Session(profile_name=BEDROCK_PROFILE)
    bedrock_client = _session.client(
        "bedrock-runtime", region_name=BEDROCK_AWS_REGION, config=_boto_cfg)
else:
    bedrock_client = boto3.client(
        "bedrock-runtime", region_name=BEDROCK_AWS_REGION, config=_boto_cfg)
@retry(
    stop=stop_after_attempt(8),
    wait=wait_exponential(multiplier=2, min=5, max=120),
    retry=retry_if_exception_type((Exception,)),
    before_sleep=before_sleep_log(logger, logging.WARNING),
)
def invoke_model_bedrock(system_prompt, messages, max_tokens=4096):
    """
    使用 AWS Bedrock 调用模型(支持 Claude 和 Amazon Nova)。
    这是整个项目里真正“调大模型”的地方。
    """
    if "anthropic.claude" in BEDROCK_MODEL_ID:
        # Claude 请求体格式
        body = {
            "anthropic_version": "bedrock-2023-05-31",
            "max_tokens": max_tokens,
            "temperature": 0,
            "system": system_prompt,
            "messages": messages,
        }
    elif "amazon.nova" in BEDROCK_MODEL_ID:
        # Amazon Nova 请求体格式:把 system 合并进 user 消息
        if system_prompt:
            nova_messages = [{
                "role": "user",
                "content": [{"text": f"System: {system_prompt}\n\nUser: {messages[0]['content']}"}],
            }]
        else:
            nova_messages = [{"role": "user", "content": [{"text": messages[0]["content"]}]}]
        body = {
            "messages": nova_messages,
            "inferenceConfig": {"maxTokens": max_tokens, "temperature": 0},
        }
    else:
        raise ValueError(f"Unsupported model: {BEDROCK_MODEL_ID}")
    response = bedrock_client.invoke_model(          # <-- 实际调用发生处
        modelId=BEDROCK_MODEL_ID, body=json.dumps(body))
    response_body = json.loads(response["body"].read())
    # 按模型类型解析响应文本
    if "anthropic.claude" in BEDROCK_MODEL_ID:
        return response_body["content"][0]["text"]
    elif "amazon.nova" in BEDROCK_MODEL_ID:
        return response_body["output"]["message"]["content"][0]["text"]
def user_message(content):
    """把字符串包装成 Bedrock messages 结构。"""
    return [{"role": "user", "content": content}]
③ 置信度分析(相似度打分)
分两层实现:块级用 Jaccard 相似度判断新旧段落是否为同一块以完成对齐;字符级用 difflib 计算相似度比率,低于阈值(默认 0.3)则跳过逐字高亮,避免满屏红绿误报。
# =============================================================================
# 3. 置信度分析(相似度打分)—— 分两层
#    3a. 文本块相似度:Phase1/process/md_diff_compare.py
#        用 Jaccard 相似度判断“变更前/后段落是否是同一块”,用于对齐
#    3b. 差异高亮阈值:Phase1/process/diff_result_export_with_images.py
#        用 difflib 字符级相似度,低于阈值(默认 0.3)则判为“差异过大不高亮”
# =============================================================================
def calculate_similarity(text1, text2):
    """
    计算两个文本的相似度(Jaccard:共同词汇占比)。
    返回 0~1,越大越可能是同一段内容。
    """
    if not text1 or not text2:
        return 0.0
    words1 = set(text1.lower().split())
    words2 = set(text2.lower().split())
    if not words1 or not words2:
        return 0.0
    intersection = len(words1 & words2)
    union = len(words1 | words2)
    return intersection / union if union > 0 else 0.0
def align_chunks_by_similarity(chunks_before, chunks_after, titles_before, titles_after):
    """
    基于相似度把变更前/后的块两两对齐(节选自 align_chunks 的“相似度匹配”一遍)。
    综合分 = 标题相似度*0.7 + 内容相似度*0.3;超过阈值 0.5 才认为匹配。
    """
    aligned_pairs = []
    used_before, used_after = set(), set()
    for i in range(len(chunks_before)):
        if i in used_before:
            continue
        best_match = -1
        best_similarity = 0.5  # 阈值:低于 0.5 不认为是同一块
        for j in range(len(chunks_after)):
            if j in used_after:
                continue
            title_sim = calculate_similarity(titles_before[i], titles_after[j])
            content_sim = calculate_similarity(chunks_before[i][:500], chunks_after[j][:500])
            similarity = title_sim * 0.7 + content_sim * 0.3   # <-- 置信度综合分
            if similarity > best_similarity:
                best_similarity = similarity
                best_match = j
        if best_match >= 0:
            aligned_pairs.append((i, best_match, "modified"))
            used_before.add(i)
            used_after.add(best_match)
            logger.info(f"≈ 相似匹配: 块{i+1} <-> 块{best_match+1} (相似度: {best_similarity:.2f})")
    return aligned_pairs
# ---- 3b. 字符级相似度阈值控制高亮(diff_result_export_with_images.py)-----
def load_diff_highlight_config():
    """从 config.yaml 读取相似度阈值(diff_highlight.similarity_threshold,默认 0.3)。"""
    try:
        import yaml
        config_path = Path(__file__).parent / "config" / "config.yaml"
        with open(config_path, "r", encoding="utf-8") as f:
            config = yaml.safe_load(f)
            return config.get("diff_highlight", {}).get("similarity_threshold", 0.3)
    except Exception as e:
        logger.warning(f"无法加载差异高亮配置,使用默认值 0.3: {e}")
        return 0.3
def should_highlight(text, other_text, similarity_threshold=0.3):
    """
    判断两段文本是否值得做“字符级差异高亮”。
    用 difflib.SequenceMatcher 算相似度比率,低于阈值说明差异太大,
    直接显示原文而不做逐字高亮(避免满屏红绿的误报)。
    Returns:
        (bool 是否高亮, float 相似度比率)
    """
    if not text or not other_text:
        return True, 0.0  # 只有一侧有内容 = 纯新增/删除,整体高亮
    matcher = difflib.SequenceMatcher(None, text, other_text)
    similarity_ratio = matcher.ratio()               # <-- 置信度:字符级相似度
    if similarity_ratio < similarity_threshold:
        logger.info(f"文本相似度 {similarity_ratio:.2%} 低于阈值 "
                    f"{similarity_threshold:.0%},跳过高亮")
        return False, similarity_ratio
    # 高于阈值时,用 matcher.get_opcodes() 逐段标红(删除)/标绿(新增)
    # 具体渲染见原文件 highlight_text_diff()
    return True, similarity_ratio
三、功能展示
3.1 主要功能点 1 · 文档上传与对比发起
文档上传界面支持分别上传变更前和变更后的说明书 PDF 文件,上传后显示文件名及大小,用户可随时删除重新选择;勾选”使用缓存”选项可缓存 PDF 解析结果,加快重复对比速度;确认文件无误后点击”开始对比”按钮即可发起差异分析。
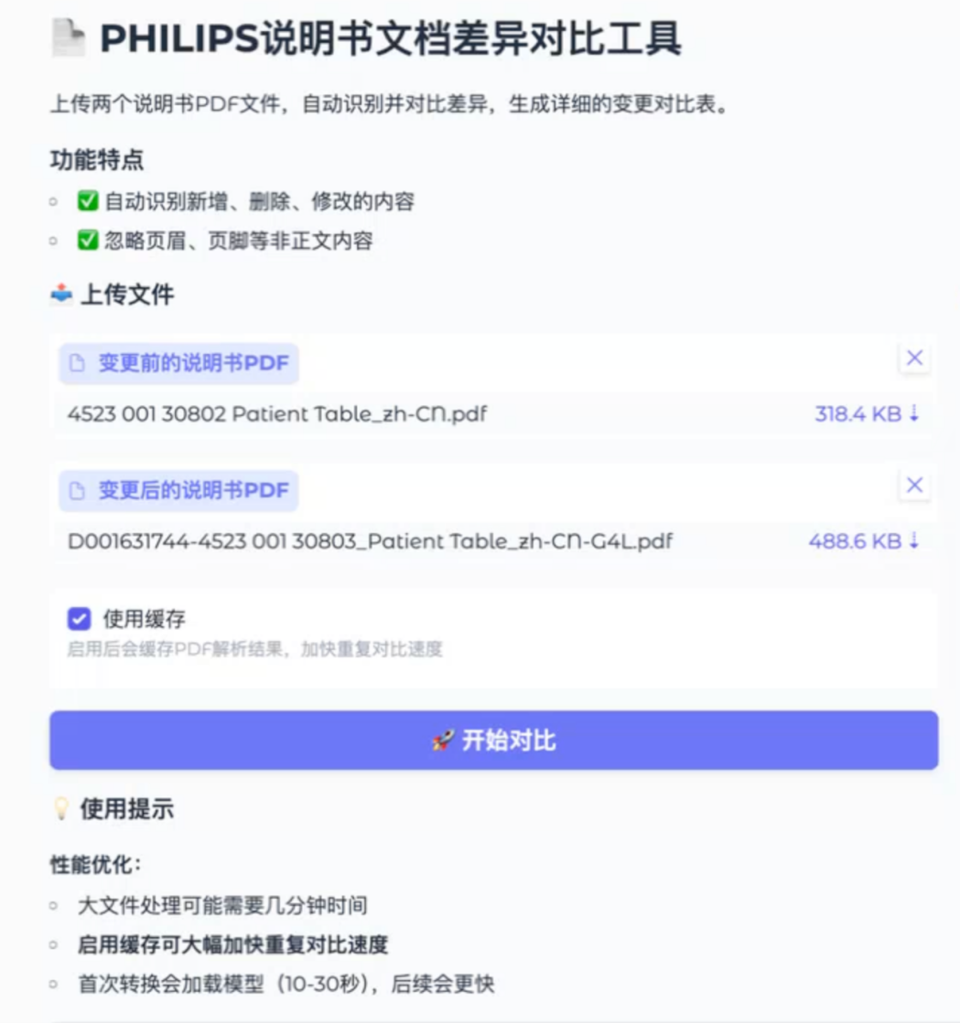
[图 2 – 说明书 PDF 文档上传界面] |
3.2 主要功能点 2 · 对比结果统计与预览
对比完成后,系统展示统计信息(包括新增、删除、修改的条目数量),并以表格形式预览前 20 条差异记录,每条记录包含变更类型、变更位置、变更前内容、变更后内容及变更说明,用户可点击下方按钮下载完整对比结果。
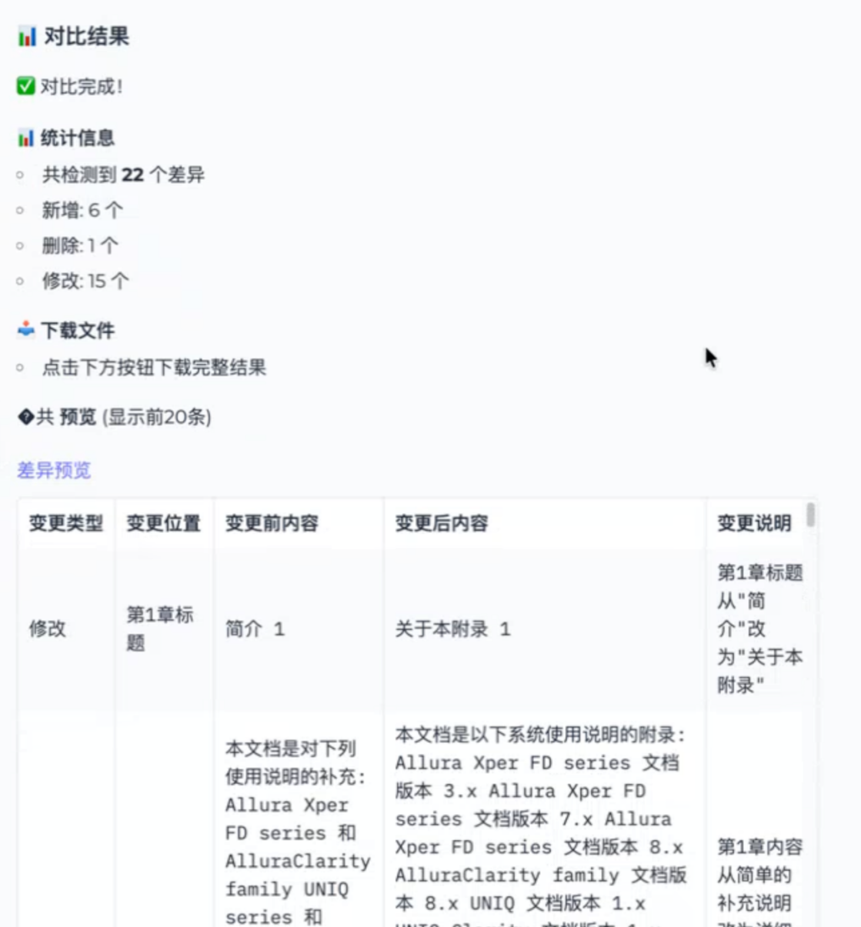
[图 3 – 对比结果统计与差异预览] |
3.3 主要功能点 3 · Word 报告导出
对比结果支持导出为 Word 文档,生成标准格式的”说明书变更对比表”,包含序号、变更位置、第一个说明书原文、第二个说明书原文及变更内容描述,变更内容以醒目颜色标注,便于存档审批和法规提交。
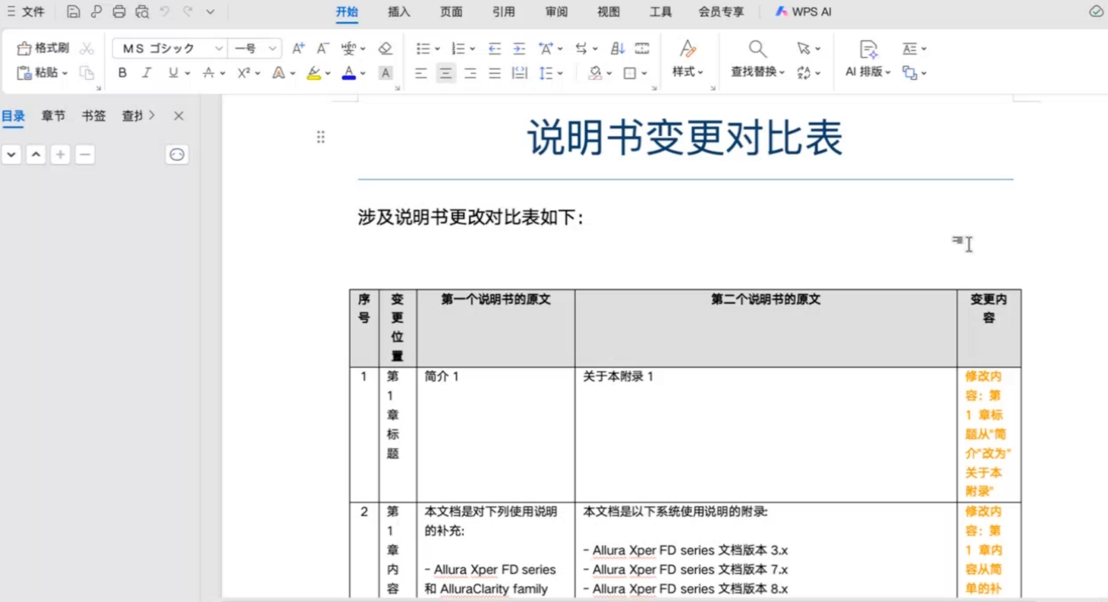
[图 4 – 导出的标准格式说明书变更对比表] |
四、参考资源
相关 AWS 官方文档
➡️ 下一步行动:
相关产品:
相关文章:
五、伙伴介绍
上海华讯网络系统有限公司(简称”华讯网络”),可信赖的新 IT 综合服务商,专注于为您提供基于新 IT 架构的智慧解决方案和全生命周期的智慧服务,让新 IT 为您创造更多价值。华讯网络以云计算、大数据、SDN 引领创新,通过基础网络、信息安全、协作通信、联络中心、IT 服务管理等领域的专业技术,结合卓越的 IT 综合服务能力,为客户提供定制化的新 IT 解决方案与全生命周期的新 IT 服务。
公司拥有多年的系统集成和专业服务行业经验,在金融、电信、互联网、制造、零售、政府、能源、交通、教育、医疗等领域具备广泛的客户基础,业务和服务网络遍及整个中国大陆、中国香港及北美地区,自 2000 年成立以来公司业务始终保持高速稳定的增长。公司拥有领先的专业技术和权威的资质认证。公司总部设在中国上海,在北京、深圳、广州、成都、武汉、南京、杭州等多个城市设有分公司和办事处。
*前述特定亚马逊云科技生成式人工智能相关的服务目前在亚马逊云科技海外区域可用。亚马逊云科技中国区域相关云服务由西云数据和光环新网运营,具体信息以中国区域官网为准。
本篇作者
AWS 架构师中心:云端创新的引领者
探索 AWS 架构师中心,获取经实战验证的最佳实践与架构指南,助您高效构建安全、可靠的云上应用
|
 |