亚马逊AWS官方博客
在亚马逊云科技 VPC 中构建 QoS 网络限速功能
摘要:本文基于 Transit Gateway Connect、FRR 与 Linux TC,在 VPC 中构建主备式 QoS VNF,实现对 VPC 出口流量的集中分级限速,以保证实时推理等高优先级业务的带宽。
前言
QoS(Quality of Service)的一个典型场景是:一条带宽固定的专线同时承载多种业务。以 AI 应用为例:
- 实时模型推理:在线业务调用推理服务,请求和响应都对时延敏感,需要高优先级,在链路拥塞时也要有带宽保证。
- 离线推理、数据备份:批量推理任务、模型和数据的同步与备份,流量大但对时延不敏感,属于低优先级,可以使用剩余带宽。
如果没有流量分级,一次大规模的数据备份就可能占满专线,拖慢实时推理的响应。QoS 正是为此而生:对流量分类,再按优先级调度,保证高优先级业务的最低带宽,同时允许空闲带宽被其他业务借用。
本文介绍一种用 EC2 实例作为网络虚拟功能(VNF,Virtual Network Function)的方案:借助 Transit Gateway(TGW)的 Connect 挂载,将 VPC 之间的流量引到 VNF 上,由 VNF 使用 Linux TC 做分类和调度,再送回 TGW。VNF 使用 FRR 通过 BGP 与 TGW 交换路由,并部署两台 VNF 实现主备,保证同一时刻只有一台 VNF 承载流量,使调度策略保持集中。
选型建议:如果您的需求是流量检测、防火墙等“旁路式”或“串接式”的安全类网络设备,建议先评估 Gateway Load Balancer(GWLB)。本文方案面向的是 GWLB 不适用的场景:需要通过路由(BGP)而非负载均衡把流量引到设备上,并且需要全局统一的带宽调度。
一、方案设计
1.1 整体架构
我们的演示环境中使用三个 VPC,通过同一个 TGW 互联:
- net-vpc(10.0.0.0/16):专门放置两台 VNF,作为 TGW Connect 的传输 VPC。
- server-vpc(10.20.0.0/16):放置模拟的服务器(Server)。
- client-vpc(172.31.0.0/16):放置模拟的客户端(Client)。
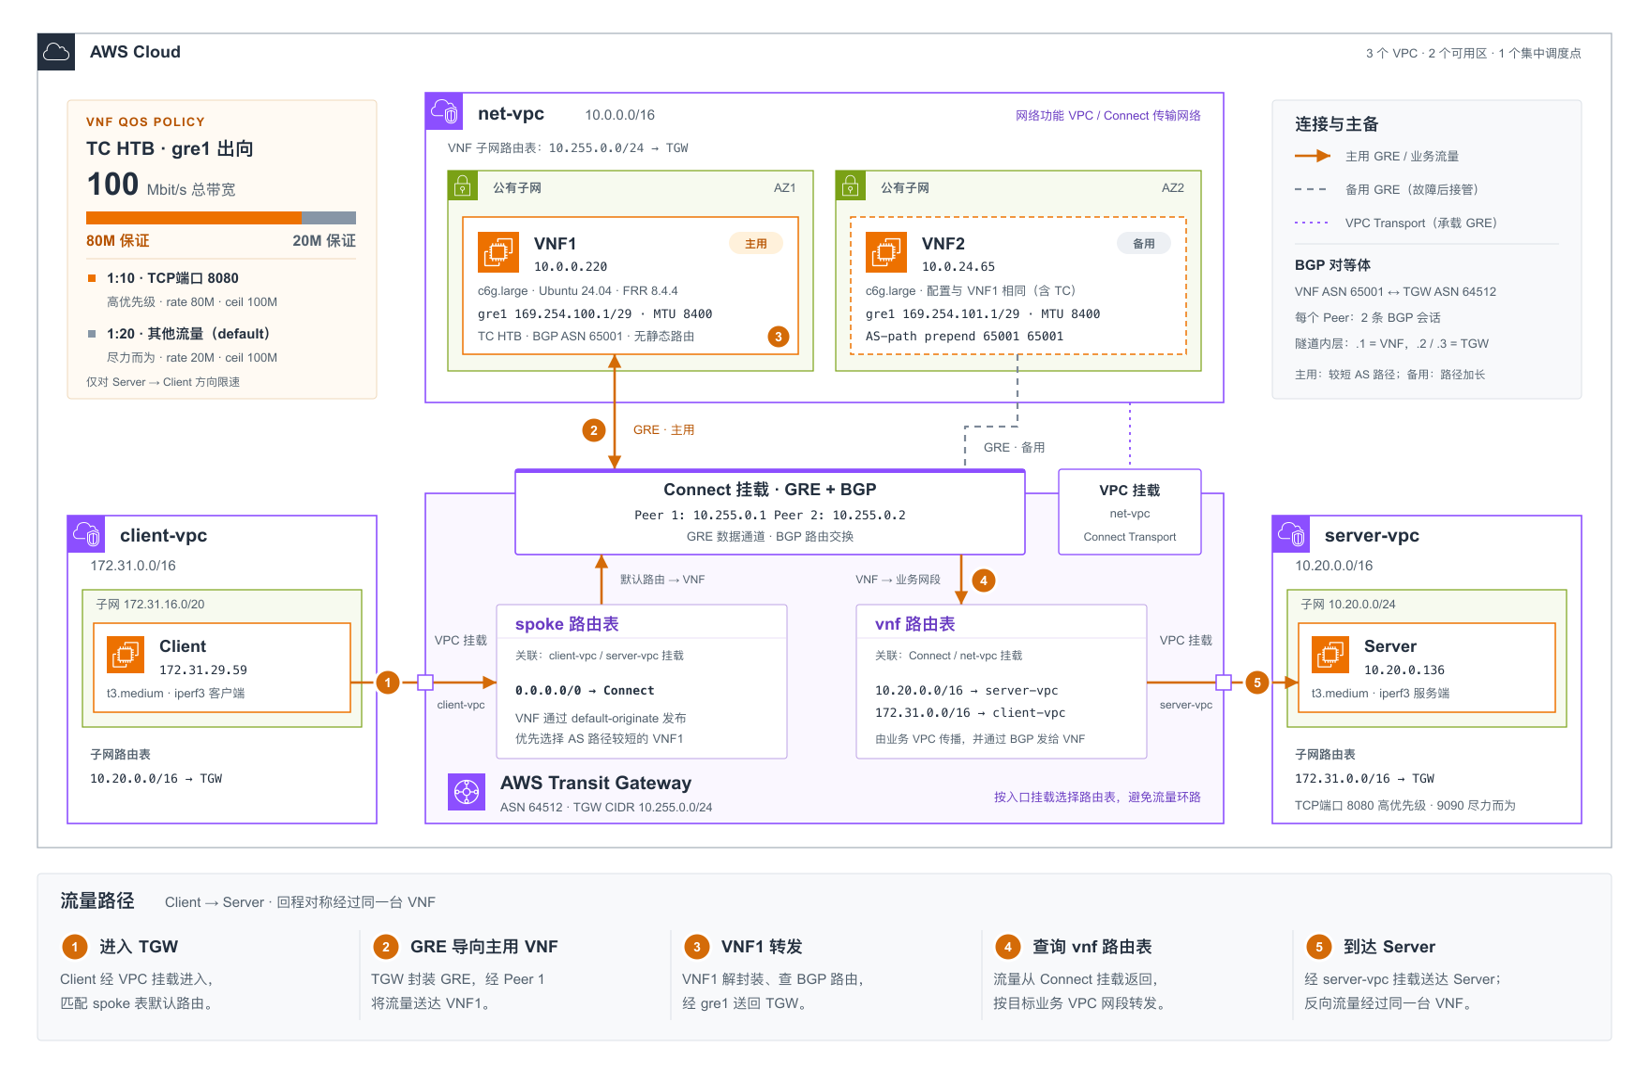
[图 1:方案架构与流量路径] |
图中编号 1~5 为 Client → Server 方向的流量路径:Client 的流量经 TGW 的 spoke 路由表,匹配 VNF 发布的默认路由,被引导到 Connect 挂载,经 GRE 隧道到达 VNF1;VNF1 解封装后经 GRE 送回 TGW,再由 vnf 路由表送往 server-vpc 中的 Server。
反方向(Server → Client)的路径对称,经过同一台 VNF。VNF 只对 Server → Client 方向(去往 client-vpc,即模拟的专线对端)做限速和调度:在专线场景中,每一端通常只负责本端发往专线的方向,反方向由对端的设备负责。
1.2 TGW Connect 挂载简介
TGW Connect 挂载是 TGW 为 SD-WAN 等虚拟设备提供的接入方式,它基于一个已有的 VPC 挂载(称为 Transport,传输挂载),在其上建立:
- GRE 隧道:设备与 TGW 之间的数据通道。GRE 的外层地址,一端是设备的 VPC 内 IP,另一端是 TGW 的地址(从创建 TGW 时指定的 TGW CIDR 块中分配)。
- BGP 会话:运行在 GRE 隧道的内层地址(169.254.x.x/29)之上,用于交换路由。
一个 Connect 挂载最多可以创建 4 个 Connect 对端(Connect Peer,即 GRE 隧道),本文用两个,分别对应 VNF1 和 VNF2。
⚠️ 每个 Connect 对端有两个 BGP 会话。对于 Connect 对端指定的内层 CIDR(本文为 169.254.100.0/29),设备侧使用 .1,TGW 侧使用 .2 和 .3 两个地址,设备需要与这两个地址各建立一个 BGP 会话。两个会话终结在 AWS 侧不同的基础设施上,提供路由平面的冗余。AWS 强烈建议两个会话都配置:只配置一个会话时,AWS 侧的例行维护可能造成短暂的连接中断。
TGW Connect 的 BGP 还有几点要求和限制(详见 AWS 文档):
- 使用 eBGP 时,必须配置 TTL 为 2 的 ebgp-multihop。
- TGW 默认的 BGP keepalive 为 10 秒,hold time 为 30 秒。
1.3 两张 TGW 路由表,避免流量环路
这是本方案最关键的设计点。
VNF 完成调度后,需要把解封装后的 IP 包重新送回 TGW。如果 TGW 里只有一张路由表,那么这个包重新进入 TGW 时会再次匹配到“指向 VNF”的路由,造成环路。解决办法是按“入口”区分路由表:
| TGW 路由表 | 关联(Association) | 路由来源(Propagation) | 表中的路由 | 作用 |
| spoke 表 | server-vpc、client-vpc 的 VPC 挂载 | Connect 挂载(VNF 通过 BGP 发布) | 0.0.0.0/0 → Connect | 从业务 VPC 进入的流量,下一跳是 VNF |
| vnf 表 | Connect 挂载、net-vpc 的 VPC 挂载 | server-vpc、client-vpc 的 VPC 挂载 | 两个业务 VPC 的网段 | 从 VNF 回来的流量,直接送到目的 VPC |
原则:从业务 VPC 进来的流量去 VNF,从 VNF 回来的流量去业务 VPC。
对应到 VNF 上,BGP 承担两个方向的工作:
- 吸引流量:VNF 向 TGW 发布一条默认路由(default-originate),进入 spoke 表。业务 VPC 送进 TGW 的流量,都会匹配到这条路由,被送往 VNF。
- 转发回 TGW:TGW 把 vnf 表中的内容(server-vpc 和 client-vpc 的网段)通过 BGP 发布给 VNF。VNF 把这两条路由安装到内核,下一跳是 TGW 在隧道内的地址,于是解封装后的包会经 gre1 回到 TGW,由 vnf 表送到最终目的地。
为什么发布的是默认路由,而不是两个业务 VPC 的网段?因为 VNF 从 TGW 学到的路由带有 TGW 的 AS 号 64512,如果原样发布回 TGW,会被 eBGP 的 AS 路径环路检测丢弃。默认路由由 VNF 自己产生,不存在这个问题。哪些流量真正进入 TGW,则由各业务 VPC 子网路由表中指向 TGW 的路由决定。
⚠️ net-vpc 的网段不能传播到 vnf 表。vnf 表中的路由会被 VNF 学到并安装到内核。如果其中包含 net-vpc 自己的网段,VNF 访问本 VPC 的流量也会被引入隧道。同理,vnf 表中也不应出现默认路由,否则 VNF 自身访问互联网的流量(包括 SSH 管理的回程)会被引入隧道,GRE 隧道本身也会失效。本文为了简化,没有在 VNF 上对入向路由做过滤,接受了这一风险;生产环境中可以用 prefix-list 只接受预期的网段。
1.4 Linux TC 与调度方法简介
TC(Traffic Control)是 iproute2 工具集中的 tc 命令,用于配置 Linux 内核的流量控制子系统。它有三个基本概念:
- qdisc(排队规则,Queueing Discipline):挂在网卡上,决定数据包如何排队、何时发出。每块网卡都有一个根 qdisc。例如在本文的 Ubuntu 24.04 实例上,ens5 默认的根 qdisc 是 mq(多队列),每个队列下面各挂一个 fq_codel。
- class(类):只有“分类型”(classful)qdisc 才有类。类可以逐级嵌套形成树,每个类都可以有自己的带宽参数,叶子类下面还可以再挂一个 qdisc。
- filter(过滤器):决定数据包进入哪个类。可以按 IP 五元组匹配(u32、flower),也可以按防火墙标记(fw,配合 iptables/nftables 打标记)、DSCP 等匹配。
TC 的整形和调度作用在网卡的出向。入向只能做简单的监管(policing,超出速率直接丢弃);要对入向做调度,通常需要先把流量重定向到 IFB 虚拟网卡上,再在它的出向做调度。
常见的调度方法可以大致分为以下几类:
| 调度方法 | 典型 qdisc | 特点 |
| 先进先出 | pfifo、bfifo | 不区分流量,最简单 |
| 单速率整形 | tbf | 令牌桶,把整体速率限制在指定值,不区分类别 |
| 严格优先级(SP) | prio | 高优先级队列有包时总是先发;低优先级流量在拥塞时可能被“饿死” |
| 加权公平(WFQ / DRR) | drr、qfq、ets | 按权重分配带宽,所有类别都能获得一定的份额 |
| 带保证与借用的分层整形 | htb | 每个类有保证速率(rate)和上限(ceil),空闲带宽可以按优先级借用 |
| 服务曲线 | hfsc | 把带宽与时延分开描述,适合同时需要带宽保证和低时延的场景 |
| 公平排队 / 主动队列管理(AQM) | fq_codel、fq、sfq、cake | 在流之间公平调度,控制排队时延(缓解 bufferbloat);cake 还集成了整形功能 |
本文的选择是:根 qdisc 用 HTB 实现“保证 + 借用”,每个叶子类下面挂 fq_codel,使同一类别内的多条流公平共享带宽并控制时延,用 u32 过滤器按目的网段和端口分类。这只是满足本文需求的一种组合。根据业务需要,也可以选择 HFSC(对时延有严格要求)、PRIO(严格优先级)、CAKE,或者按 DSCP、防火墙标记、eBPF 分类等其他方式。这些方式本文不展开介绍,文末讨论中会简要提及按 DSCP 分类的做法。
1.5 QoS 设计
我们用端口号来模拟前言中的两类业务:TCP 端口 8080 代表实时推理(高优先级),其他端口(实验中用 9090)代表离线推理、数据备份等尽力而为的流量。调度使用 Linux TC 的 HTB(Hierarchical Token Bucket):
- 链路总带宽:100 Mbit/s
- 高优先级(端口 8080):保证 80 Mbit/s,空闲时最多可借用到 100 Mbit/s
- 尽力而为(其他所有流量):保证 20 Mbit/s,空闲时同样可借用到 100 Mbit/s
- 限速方向:只对 Server → Client 方向(去往 client-vpc)限速,Client → Server 方向不限速
调度挂在 VNF 的 gre1 出向方向上。所有穿过 VNF 的数据(无论哪个方向)在送回 TGW 时都要从 gre1 发出,所以这是一个天然的汇聚点,也避开了前面提到的入向调度的限制。也正因为两个方向都从 gre1 发出,需要用目的网段区分方向:去往 client-vpc 的流量进入 100M 的限速分支,其余流量(Client → Server 方向以及 BGP)进入不限速的默认类。
1.6 FRR 简介
FRR(FRRouting)是一个开源的 IP 路由协议套件,它支持 BGP、OSPFv2/v3、IS-IS、RIP、PIM、BFD、VRRP 等协议,被广泛用于网络设备、数据中心和云上的虚拟路由器。
FRR 采用多进程架构:
- zebra:核心进程,管理接口信息和路由表(RIB),并通过 netlink 把最优路由安装到 Linux 内核。
- 协议进程:每个协议一个进程,例如 bgpd、ospfd、staticd(静态路由),在 /etc/frr/daemons 中按需启用。
- vtysh:统一的命令行,语法与传统网络设备相近,可以在线查看状态、修改配置;持久化配置保存在 /etc/frr/frr.conf。
本文用到其中两个部分:bgpd 与 TGW 建立 BGP 会话,发布默认路由并学习业务 VPC 的网段;zebra 把学到的路由安装到内核,供数据面转发使用。
1.7 主备设计
两台 VNF 都向 TGW 发布默认路由。VNF2 在发布时对 AS 路径加长(set as-path prepend 65001 65001),TGW 对相同前缀会选择 AS 路径较短的路由,因此正常情况下只有 VNF1 承载流量;VNF1 故障后,TGW 会收敛到 VNF2。
⚠️ 如果两台 VNF 发布的路由 AS 路径相同,TGW 会在两台 VNF 之间做 ECMP 负载分担,这正是本方案要避免的(见文末讨论)。3.4 节中会看到,对 default-originate 产生的默认路由加长 AS 路径需要使用专门的写法。
二、实验环境与版本说明
| 组件 | 规格 |
| VNF1 / VNF2 | c6g.large(Graviton),Ubuntu 24.04 LTS arm64,分别位于 net-vpc 两个可用区的公有子网 |
| Server | t3.medium,Amazon Linux 2023,位于 server-vpc 的子网 10.20.0.0/24(可用区 1) |
| Client | t3.medium,Amazon Linux 2023,位于 client-vpc 的子网 172.31.16.0/20(可用区 1) |
| FRR | 8.4.4-1.1ubuntu6.7(Ubuntu 24.04 软件源自带,并固定版本) |
| TGW | ASN 64512,TGW CIDR 10.255.0.0/24 |
| VNF BGP ASN | 65001 |
⚠️ 固定 FRR 版本:FRR 的配置语法在不同版本之间存在差异(例如 eBGP 默认要求配置路由策略、部分命令在新版本中被重命名或废弃),直接安装最新版本,配置文件可能无法在其他版本上复用。本文使用的是 Ubuntu 24.04 软件源中的 8.4.4,并通过 apt-mark hold 固定,以保证配置可重复。
⚠️ 前提:本文假设 net-vpc、server-vpc 和 client-vpc 三个 VPC 已经存在,并且各自有挂载了 Internet 网关的公有子网(实验中用于安装软件和 SSH 管理;业务流量走私有地址和 TGW)。net-vpc 需要在两个可用区各有一个子网,用于放置两台 VNF。
下文命令中的资源 ID 用 shell 变量表示(例如 $TGW),请替换为您自己环境中的值。
三、配置流程
整体步骤:
- 创建安全组和实例
- 创建 Transit Gateway 和挂载
- 创建 Connect 对端
- 在 VNF 上安装并配置 GRE 和 FRR
- 验证 BGP 会话
- 调整 TGW 路由表(spoke / vnf 两张表)
- 配置 VPC 路由
- 在 VNF 上配置 TC
- 验证
3.1 创建安全组和实例
1. 创建安全组
VNF 的安全组只有两条规则,关键的一条是协议号 47(GRE):GRE 报文由 TGW 地址(来自 TGW CIDR 10.255.0.0/24)发往 VNF,必须放行。Client 和 Server 之间的业务流量封装在 GRE 中,不会以原始形式到达 VNF 的网卡,因此不需要在 VNF 的安全组中放行业务网段。实验中,VNF 的安全组只保留这两条规则,业务流量正常。
2. 启动实例
VNF 使用 Ubuntu 24.04 arm64 的官方 AMI(通过 SSM 参数获取),Server 和 Client 使用 Amazon Linux 2023:
⚠️ 说明:本文的实验中,各实例的私有地址为:VNF1 10.0.0.220、VNF2 10.0.24.65、Server 10.20.0.136、Client 172.31.29.59。后文的命令使用这些值,请替换成您的实际地址。
在 Server 和 Client 上安装 iperf3:
3.2 创建 Transit Gateway 和挂载
1. 创建 TGW
创建时通过 TransitGatewayCidrBlocks 指定 TGW CIDR 块。它必须与所有 VPC 的 CIDR 不重叠,后面 GRE 隧道的 TGW 侧地址从这里分配:
这里保留了默认路由表的自动关联和自动传播:之后创建的挂载都会自动关联到默认路由表,并把路由传播进去。3.6 节会在此基础上调整。
2. 为三个 VPC 创建 VPC 挂载
net-vpc 的挂载同时作为 Connect 的 Transport,子网选择两台 VNF 所在的两个子网。server-vpc 和 client-vpc 的挂载各选择一个与实例同在可用区 1 的子网:
3. 创建 Connect 挂载
等 net-vpc 的 VPC 挂载状态变为 available 后:
4. 为 VNF 所在子网添加指向 TGW CIDR 的路由
VNF 发出的 GRE 报文的目的地址是 TGW 地址(10.255.0.x),这个地址不在任何 VPC 内,需要在 net-vpc 中 VNF 所在子网的路由表里,把 TGW CIDR 指向 TGW:
⚠️ 缺少这条路由时,VNF 无法与 TGW 通信,Connect 对端会一直处于 pending,BGP 会话停留在 Connect 状态。
3.3 创建 Connect 对端
每台 VNF 对应一个 Connect 对端,包含:VNF 的 VPC 内 IP(Peer Address)、TGW 地址(从 TGW CIDR 中选)、BGP 内层 CIDR、VNF 的 ASN。
查看各对端的 BGP 地址:
在 VNF 上完成 3.4 节的配置后,输出如下:
可以看到每个对端上,VNF 使用 .1,TGW 使用 .2 和 .3。
⚠️ 注意:内层 CIDR 需要是 169.254.0.0/16 范围内的 /29,并且不能使用 AWS 保留的网段,请参考官方文档。每个 Connect 对端使用独立的内层 CIDR。
3.4 在 VNF 上安装并配置 GRE 和 FRR
以下步骤在两台 VNF 上执行,除了主机名、地址和 AS 路径加长之外完全相同。
1. 安装并固定 FRR 版本
输出:
hi 中的 h 表示该包已被锁定(hold),apt upgrade 不会再升级它。
2. 开启 IP 转发,关闭反向路径过滤和 ICMP 重定向
- ⚠️ 关闭 rp_filter 是必要的:从 gre1 进来的包,源地址的“最佳回程路径”可能不是 gre1,严格的反向路径过滤会把这些包丢掉。
- 关闭 ICMP 重定向:VNF 的流量从 gre1 进、又从 gre1 出,Linux 在某些情况下会认为“发送方本可以直接到达目的地”,于是向发送方发出 ICMP 重定向。我们在测试过程中观察到过 Client 的 ping 收到来自 VNF 的 Redirect Host 报文。包本身仍然会被正常转发,客户端也会忽略这类报文,但作为路由设备,应当关闭这一行为。内核只要 all 或接口自身任一项为 1 就会发送重定向,所以 all 和 default 都设为 0;gre1 在 sysctl 生效之后才创建,会继承 default 的值(实测删除并重建 gre1 后,其 send_redirects 和 rp_filter 均为 0)。
3. 用 netplan 创建 GRE 隧道
Ubuntu 24.04 使用 netplan + systemd-networkd 管理网络,我们用声明式配置来持久化 gre1。
VNF1 的 /etc/netplan/60-gre1.yaml(VNF2 请把 local 换为 10.0.24.65、remote 换为 10.255.0.2、地址换为 169.254.101.1/29):
然后应用配置并查看隧道状态:
输出:
配置说明:
- ⚠️ optional: true 不能省略。gre1 上只有 169.254.x.x 地址,systemd-networkd 把它视为链路本地地址,接口状态会一直停留在 degraded。不标记 optional 时,netplan 会让 systemd-networkd-wait-online 等待 gre1 变为 routable,这永远不会发生。实测开机会卡在 wait-online 上 2 分钟,然后超时失败。标记之后,wait-online 只等待 ens5,开机耗时恢复到 7 秒左右。
- rp_filter 无需单独设置:第 2 步中的 net.ipv4.conf.default.rp_filter = 0 在开机早期生效,早于 networkd 创建 gre1,所以 gre1 会自动继承 0。
- gre1 的 MTU 设置为 8400:TGW 支持的 MTU 上限为 8500 字节,GRE 封装另需 24 字节开销,8400 留有余量。
4. 禁止 systemd-networkd 清除 FRR 的路由
systemd-networkd 默认会在启动或重新配置时清除“外来”路由,也就是不是由它自己配置的路由。FRR 安装到内核的路由正属于这一类:
5. 配置 FRR
先在 /etc/frr/daemons 里启用 bgpd:
VNF1 的 /etc/frr/frr.conf:
配置说明:
- peer-group TGW:TGW 侧的两个 BGP 地址(.2 和 .3)共用一组参数,保证两个会话的配置完全一致。
- ebgp-multihop 2:TGW Connect 对 eBGP 的要求(见 1.2 节)。
- timers 3 9:keepalive 3 秒,hold time 9 秒。BGP 会使用双方提议中较小的 hold time。不配置时会协商为 TGW 默认的 30 秒;配置后实测协商结果为 9 秒,会话稳定。TGW Connect 不支持 BFD,缩短 hold time 是加快故障切换的主要手段(效果见 3.9 节第 6 步)。
- default-originate route-map TGW-DEFAULT:向 TGW 发布默认路由,把业务 VPC 之间的流量吸引到 VNF。根据 FRR 文档,这里的 route-map 同时作为发布条件:BGP 表中存在与之匹配的路由时才发布默认路由。TGW-DEFAULT 没有 match 条件,因此只要 VNF 从 TGW 学到了路由,就会发布默认路由。
- TGW-IN 全部接受:TGW 发布的是 vnf 表中的内容,也就是 server-vpc 和 client-vpc 的网段。VNF 把它们安装到内核,用于把解封装后的包送回 gre1。关于不过滤入向路由的风险,见 1.3 节。
- TGW-OUT 全部拒绝:VNF 只需要发布默认路由。如果不拒绝,VNF 会把从 TGW 的一个会话学到的路由,再从另一个会话发回给 TGW(TGW 会因 AS 路径环路丢弃它们)。
- FRR 8.x 在 traditional 配置模板下默认启用 bgp ebgp-requires-policy,要求 eBGP 邻居同时配置入向和出向的路由策略,所以这里即使不修改属性也要有 route-map。
VNF2 的差异:hostname vnf2、router-id 10.0.24.65、两个邻居 169.254.101.2 和 169.254.101.3,以及:
⚠️ AS 路径加长必须写在 default-originate 的 route-map 里。default-originate 产生的默认路由不经过出向的 route-map TGW-OUT。我们最初把 set as-path prepend 写在出向 route-map 中,通过 debug bgp updates out 查看实际发出的 UPDATE,发现默认路由的 AS 路径为空(发送时只带上本端 ASN),没有被加长。这样两台 VNF 发布的默认路由 AS 路径相同,TGW 会在两者之间做 ECMP。改为 default-originate route-map 之后,VNF2 发出的默认路由才带上了加长的 AS 路径(见 3.5 节)。
应用配置:
3.5 验证 BGP 会话
等待 TGW 与 VNF 建立会话(在添加了前面的 TGW CIDR 路由后,通常一分钟内完成)。下面的输出是完成 3.6 节 TGW 路由表配置之后的状态:
输出:
两个会话都已建立:每个会话收到 2 条路由(PfxRcd),发出 1 条路由(PfxSnt,即默认路由)。查看学到的路由:
输出:
两个业务 VPC 的网段都从 .2 和 .3 两个会话学到。内核中的路由经 gre1 指向这两个地址:
输出:
VNF 自己的默认路由仍然经 ens5 指向 VPC 路由器,因此通过 IGW 对 VNF 的 SSH 管理不受影响。确认协商后的计时器和默认路由的发布状态:
输出:
VNF2 的默认路由带着 65001 65001 发出(发送时本端 ASN 还会再添加一次),比 VNF1 的长,所以 TGW 首选 VNF1。
3.6 配置 TGW 路由表
按 1.3 节的设计,把默认路由表作为 spoke 表,再新建一张 vnf 表。由于创建 TGW 时开启了自动关联和自动传播,所有挂载此时都关联在默认路由表上,并把路由传播了进去,需要逐一调整:
确认两张表的内容:
输出:
3.7 配置 VPC 路由
业务 VPC 只把对端 VPC 的网段指向 TGW,各自的默认路由仍然指向自己的 IGW。net-vpc 中指向 TGW 的只有 3.2 节第 4 步的 TGW CIDR 路由。
3.8 在 VNF 上配置 TC
两台 VNF 使用相同的脚本,这样主备切换后调度策略保持不变。
输出:
配置要点:
- rate 是保证值,ceil 是上限:1:10 保证 80M,1:20 保证 20M,二者都可以借用对方未用完的带宽,最高到 100M。prio 决定借用空闲带宽时谁优先。
- 只对去往 client-vpc 的流量分类:目的地址属于 client-vpc、且源或目的端口为 8080 的流量进入 1:10,其余去往 client-vpc 的流量进入 1:20。端口同时匹配 sport 和 dport,所以无论 8080 是 Server 的服务端口还是 Client 的服务端口,都进入高优先级类。
- default 30:其余流量(Client → Server 方向,以及 VNF 与 TGW 之间的 BGP)进入 1:30。它与 1:1 平级,速率设为 10 Gbit/s,实际上不限速,也不占用 1:1 的 100M。
3.9 验证
1. 确认流量经过 VNF1
在两台 VNF 的 gre1 上观察流量:业务流量只出现在 VNF1 上,VNF2 上没有,说明 AS 路径较短的 VNF1 是首选。
⚠️ 收敛需要时间:修改 BGP 配置或重启 FRR 之后,TGW 完成路由切换通常需要 20~30 秒。请等路由收敛后再做验证。
2. 在 Server 上启动两个 iperf3 服务端(8080 为高优先级,9090 为尽力而为)
2. 只有尽力而为流量时:可以借用全部带宽
在 Client 上执行。-R 让 Server 向 Client 发送数据,也就是限速的 Server → Client 方向:
输出:
3. 只有高优先级流量时:同样可以用满链路
输出:
4. 两种流量同时到来:按 80 / 20 分配
在 Client 上同时发起两个 iperf3 测试(持续 20 秒):
输出:
| 场景(Server → Client,限速方向) | 8080(高优先级) | 9090(尽力而为) |
| 仅尽力而为 | – | 98.7 Mbit/s |
| 仅高优先级 | 99.4 Mbit/s | – |
| 同时竞争 | 79.5 Mbit/s | 19.9 Mbit/s |
反方向(Client → Server)不限速。去掉 -R 重复测试,单条 9090 流量约 4.4 Gbit/s;8080 与 9090 同时发送时各约 2.5 Gbit/s,远超 100M,说明这个方向的流量进入了不限速的 1:30:
输出:
两条流合计约 4.9 Gbps,接近单个 Connect 对端 5 Gbps 的上限(见文末讨论),并不代表该方向没有上限;此外测试时长较短,VNF 处于网络带宽突发状态。
5. 主备切换
我们在 VNF1 上执行 sudo ip link set gre1 down,模拟数据面的静默故障。这种方式不会主动关闭 BGP 会话,TGW 只能依靠 BGP hold time 发现故障。本次测试中,hold time 为 9 秒(timers 3 9)时,从故障发生到流量由 VNF2 接管约 25 秒。中断时间长于 hold time,多出的部分是 TGW 侧的路由收敛,无法通过 VNF 的配置继续缩短。
6. 恢复与回切
在 VNF1 上执行 sudo ip link set gre1 up 后,BGP 会话重新建立,一分钟内流量回切到 VNF1(AS 路径较短者优先)。回切时 VNF1 已经学到了路由,可以立即转发,不会造成中断(见第 8 步)。
7. 计划内维护:用 AS 路径加长排空流量
计划内维护(升级软件、修改配置、重启实例)时,可以先主动把流量从主用 VNF 上排空。
直接关闭主用 VNF 的 BGP 会话(neighbor TGW shutdown)会造成约 25 秒的中断:VNF 转发回 gre1 所依赖的正是从 TGW 学到的 BGP 路由,会话一关闭,这些路由立即消失;而 TGW 切换到 VNF2 需要约 20 秒,在此期间送到 VNF1 的流量无法被转发。
推荐的做法是保持会话不变,只在 VNF1 上临时加长默认路由的 AS 路径(在 route-map TGW-DEFAULT 中执行 set as-path prepend 65001 65001 65001 65001,再执行 clear bgp * soft out),使其比 VNF2 的更长。TGW 会把流量切到 VNF2,而 VNF1 的会话和路由保持不变,可以继续转发切换期间到达的流量。维护结束后执行 no set as-path prepend 即可恢复;由于这条配置只存在于运行时,重启 FRR 或重启实例后 VNF1 也会自动恢复为主用。我们在持续发送流量的情况下,依次完成了排空、重启 VNF1、自动回切,整个过程没有中断。
五、总结与讨论
本文介绍了在 VPC 中用 EC2 实现 QoS VNF 的一种方式:VNF 部署在独立的 net-vpc 中,TGW Connect 把业务 VPC 之间的流量通过 GRE 引导到 VNF;FRR 通过 BGP 向 TGW 发布默认路由,并从 TGW 学习业务 VPC 的网段用于转发,整个方案不需要静态路由;TC 的 HTB 在 gre1 上完成分类和调度。两张 TGW 路由表(spoke / vnf)保证了流量“进 VNF、出 VNF”而不会环路。实验中,在限速的 Server → Client 方向,100M 链路上 8080 的高优先级流量在竞争时获得 79.5M,尽力而为流量获得 19.9M,空闲时二者都可借用满带宽;反方向不受限速。
以下是一些值得进一步讨论的问题。
- 主备而非负载分担。本文刻意让只有一台 VNF 承载流量,因为调度器需要看到全部流量才能保证全局的 80/20。如果两台 VNF 发布的默认路由 AS 路径相同,TGW 会做 ECMP,两台 VNF 各自调度,总的保证带宽会变成各自的和,无法再体现全局约束。
- 吞吐上限:每个 TGW Connect 对端(GRE 隧道)最高支持 5 Gbps 带宽和 300,000 pps,且均不可调整。本方案同一时刻只有一台 VNF、即一条 GRE 隧道承载流量,因此整体吞吐上限约为 5 Gbps;如果报文较小,pps 限制会更早成为瓶颈(例如 1500 字节报文时约 3.6 Gbps)。VNF 实例自身的网络带宽也是上限:本文使用的 c6g.large 基线带宽为 0.75 Gbps(突发可达 10 Gbps),生产环境应按持续带宽选择实例规格。
- 另一种实现:分类在终端节点完成,调度仍然集中。本文在 VNF 上按端口分类,分类和调度都集中在 VNF 上。另一种做法是把分类放到终端节点:应用或主机在发送时为报文打上 DSCP 标记,例如把实时推理流量标为 EF(DSCP 46)。标记可以由应用通过套接字选项设置,也可以在主机上用 nftables 设置(如 ip dscp set ef)。VNF 上的 TC 改为按 DSCP 匹配(如 u32 match ip dsfield 0xb8 0xfc),HTB 的整形和调度仍然集中在 VNF 上。这样做的好处是:业务识别规则由最了解业务的一方维护,VNF 不需要了解端口、地址等细节,新增业务时也不必修改 VNF 的配置。需要注意的是,VNF 需要信任终端节点的标记,必要时应对来自不可信来源的流量重新标记;同时需要确认 DSCP 在整条路径上不被修改。
- 默认路由的影响范围。spoke 表中只有一条默认路由,所有关联到 spoke 表的 VPC 之间的流量都会经过 VNF。哪些流量真正进入 TGW,由各业务 VPC 的子网路由表决定。如果只想让部分流量经过 VNF,可以在 spoke 表中为其他目的地添加更具体的路由,直接指向对应的 VPC 挂载。
- VPC – TGW – DX 场景。从路由模型上看,Direct Connect 网关通过 Transit VIF 挂载到 TGW 后,同样可以作为一个 spoke:DX 网关挂载关联到 spoke 表,并把本地网段传播到 vnf 表,VNF 就能学到这些网段,对来自专线的流量做同样的调度。需要额外注意:DX 网关向本地发布的网段由其允许前缀(Allowed Prefixes)决定,并且 Transit VIF 的 MTU 上限为 8500。这一场景我们没有在本次实验中验证,请在实际使用前自行测试。
- 与 GWLB 的选择。如果设备只需要做检测、过滤,并且不依赖 BGP 路由引流,GWLB 通常是更简单的选择,它提供了自动的健康检查和扩展。本文方案适用于需要路由引流、需要全局调度的场景。
➡️ 下一步行动:
相关产品:
- Amazon VPC — 隔离云网络
- Amazon Connect — AI 客户体验解决方案
- Amazon EC2 — 安全且可调整大小的计算容量
相关文章:
- 基于Direct Connect和Transit Gateway实现全球视频会议双中心组网方案—中国出海企业全球视频会议网络架构设计与落地实践
- 上海博卡携手 Amazon Connect Customer 与 Amazon Bedrock AgentCore,4 周上线多语言 AI 预约客服
- AWS DevOps Agent 实战:云网络故障自主调查与修复建议
六、注
注 1:清理
实验结束后请按创建的逆序删除资源:Connect 对端 → Connect 挂载 → 三个 VPC 挂载(等待状态变为 deleted)→ TGW 路由表 → TGW,以及实例、安全组,并删除 VPC 路由表中添加的条目(net-vpc 中的 10.255.0.0/24、client-vpc 中的 10.20.0.0/16、server-vpc 中的 172.31.0.0/16)。
七、参考链接
- FRR 8.4 BGP 文档:default-originate、bgp ebgp-requires-policy 等配置
- tc(8)、tc-htb(8)、tc-fq_codel(8):Linux 流量控制、HTB 与 fq_codel
- iperf3:本文用于带宽测试的工具
- AWS Transit Gateway Quota:TGW 带宽限制说明
*前述特定亚马逊云科技生成式人工智能相关的服务目前在亚马逊云科技海外区域可用。亚马逊云科技中国区域相关云服务由西云数据和光环新网运营,具体信息以中国区域官网为准。
本篇作者
AWS 架构师中心:云端创新的引领者探索 AWS 架构师中心,获取经实战验证的最佳实践与架构指南,助您高效构建安全、可靠的云上应用
|
 |