亚马逊AWS官方博客
小红书推荐系统的Agentic实践:针对推荐模型自迭代的Harness设计与实现
摘要:亚马逊云科技人工智能应用实验室与小红书引擎架构部模型工程团队合作共创,针对推荐模型自迭代提出了一套 Research Agent 方案。我们在 ADLC(Agent Development Lifecycle)框架下开展了 Agent 的设计与开发过程,创新性的提出了 Wide-and-Deep 探索策略,同时进行了相应的多智能体划分和上下文管理设计与实现。
目录
一、背景
随着 LLM 能力的飞速发展,使用“AI 研究员”角色的 Research Agent 对 AI 模型进行自动改进与优化吸引了大量的关注。例如,针对来自 Kaggle 的数十个机器学习任务[1],Meta 提出的 AIRA(AI Research Agents)[2]在接近半数的任务上取得了奖牌;Karpathy 通过 AutoResearch[3]对 LLM 训练进行近百轮的长程迭代并持续取得了改进;Anthropic 使用 AARs(Automated Alignment Researchers)[4]对 LLM 进行后训练以减少对齐失败问题,效果超越了人类专家基线。这些方法所取得的成绩引出了一个自然的问题:在真实的搜推业务场景中,我们是否可以使用 Research Agent 实现针对推荐模型的自迭代?因此,亚马逊云科技人工智能应用实验室与小红书引擎架构部模型工程团队合作共创,对这个问题进行了深入探索。
二、问题与挑战
相对于现有工作,我们认为使用 Research Agent 实现针对推荐模型的自迭代具有以下挑战:
1. 探索空间大:在过去十年间,推荐模型从经典的 DCN、DLRM 等模型发展至现代的 HSTU、RankMixer 等模型,推荐模型的架构方案仍在持续演进。除推荐模型本身的模型结构外,与业务相关联的数据处理方法、特征工程、训练目标设计等因素也直接影响最终效果,这进一步增加了问题的复杂性。因此,推荐模型的优化是一个系统性工程,它有着巨大的探索空间。作为对比,主流 Benchmark 如 MLE-bench[1]中大多数任务为中-低难度,AIRA 使用了随机森林、LSTM 或 ResNet 等模型来解决这些问题,其优化难度低于推荐模型。
2. 训练成本高:在真实业务场景中,推荐模型的单次训练可能需要消耗数十甚至数百小时的 GPU 时长,这与现有工作所关注的模型的训练成本也存在明显差异:AIRA 解决机器学习任务的训练耗时大多为几分钟至十几分钟,AutoResearch 中设置的 LLM 训练耗时上限为 5 分钟,AARs 中 LLM 后训练耗时为 30 分钟。更高的训练成本使得 Agent 在研究过程中的无效尝试将带来更大的损失,同时,这也意味着在固定的训练预算下可供 Agent 尝试的次数也会更少。
以上挑战要求 Research Agent 以更加智能的方式开展研究,单一方向探索或遍历全部方向等朴素思路可能难以取得良好表现。
三、智能体开发生命周期
如图 1 所示,我们在 ADLC(Agent Development Lifecycle)框架[8]下进行了针对推荐模型自迭代的 Research Agent 设计与开发。
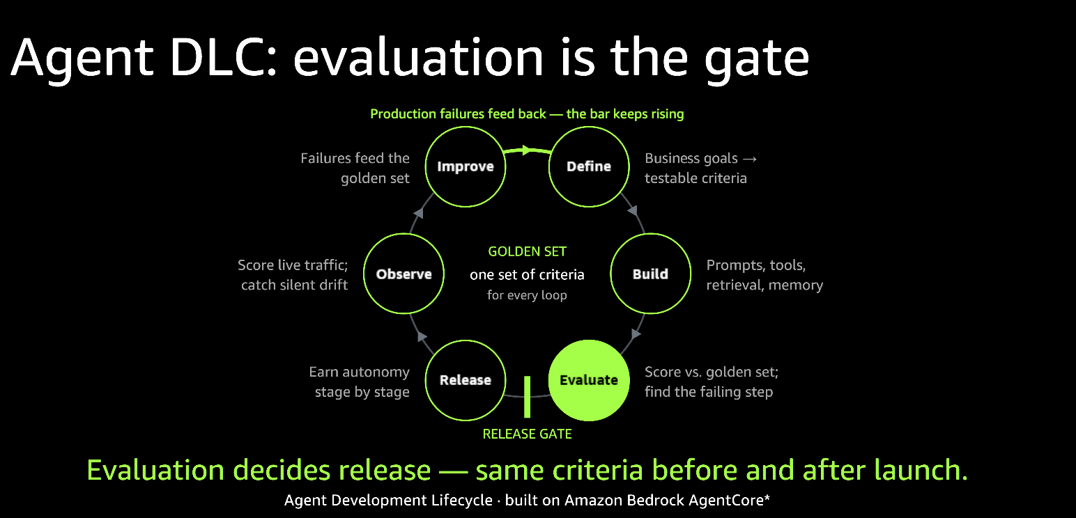
[图 1:ADLC(Agent Development Lifecycle):为智能体量身设计的开发生命周期] |
3.1 飞轮起点的选择
ADLC 是一个持续运转的飞轮,在真正让飞轮循环运转起来之前,我们应该选择一个更高的飞轮起点。一种朴素的思路是直接开始设计和开发 Agent 所需的全套 Harness 组件,然而这种方式是低效的,一个不合理的初始设计将可能误导后续的飞轮优化流程。相对于直接开发专用的 Research Agent,我们选择使用通用的强 Agent 作为基线起点,这帮助我们大幅缩短了初版开发时间。具体而言,我们选择了支持按设定目标持续优化的通用 Agent 作为基线,要求 Agent 在规定时间内尽可能提高目标推荐模型在点击预测任务上的 AUC 指标。我们使用 UniRank[9]实现的 RankMixer[5]模型作为目标推荐模型,遵循该代码库的设定在 KuaiRand[6]数据集上进行模型训练与评估。在初步尝试中我们观察到:
- 给定 200 GPU·h 模型训练时长预算,在不进行任何人类介入的条件下,基线 Agent 将 RankMixer 的 AUC 指标提升了 1.33pp,这初步证明了对推荐模型进行 Agentic 自迭代的可行性;
- 在人类提供已验证有效的改进思路条件下(如:“为 token 混合支路出口加一个乘性门”), 在多次实验中基线 Agent 始终可以正确的完成相应代码修改并取得收益,这证明了基线 Agent 的代码开发能力将不是系统瓶颈;
然而通过对 Agent 轨迹的进一步分析,我们也观察到了基线 Agent 存在的以下不足和缺陷:
- 难以实现持久改进:尽管我们提供了 200GPU·h 的训练时长预算,我们观察到基线 Agent 在最初的 30%时间中就已拿到了 76%的总收益,后段研究的效率极低。
- 研究方向快速收敛:通过对基线 Agent 所尝试的改进方法进行分类,我们发现它将 86%的训练时长预算押注在同一方向反复修改,尽管该方向在一开始有显著收益,但后续继续投入的边际收益迅速降低。我们认为,研究方向快速收敛是其难以实现持久改进的主要原因之一。
- 外部文献利用较差:在实验中我们预先检索下载了 50 篇相关论文,通过提示词指明了相应位置供基线 Agent 参考,然而我们观察到在它进行的所有工具调用中,真正读取论文的操作只发生了 30 次,占全部工具调用的 2.7%,并且这些操作全部发生在开始研究的前 9 小时中。我们认为,外部文献利用较差是其研究方向快速收敛的主要原因之一。
以上洞察帮助我们快速明确了模型能做到什么、不能做到什么,指导了后续优化的方向。
3.2 评估体系设计
在 ADLC 框架下,评估是一切的起点。对于 Research Agent,目标模型的评估指标变化量是 Agent 的天然评估指标,例如,对于推荐模型我们可以使用 AUC 指标的变化量(即上文中的ΔAUC=+1.33pp)作为评估 Agent 好坏的标准。然而,仅使用以上指标作为唯一标准,它无法完整反映“AI 研究员”的可靠性、研究深度和资源利用效率,也无法告诉我们“AI 研究员”与“人类研究员”的具体行为差异。根据 ADLC 的评估方法论,我们从评估粒度和证据权重两个支柱出发设计了以下评估体系:
| 评估粒度 证据权重 |
白盒 | 玻璃盒 | 黑盒 |
| 机械可验证 | 论文工具使用次数 数据集分析次数 |
主任务ΔAUC 辅助任务ΔAUC |
|
| 半客观 | 探索多样性 | ||
| 主观 | 探索决策正确率 |
这些评估指标的具体含义如下:
3.2.1 黑盒指标
- 主任务ΔAUC:在实验中,我们将点击预测任务设定为主任务, Research Agent 对 RankMixer 模型进行迭代改进后,最终在该任务中取得的 AUC 增量是评估 Agent 好坏的主要标准。主任务ΔAUC 是机械可验证指标,通过代码规则进行计算。
- 辅助任务ΔAUC:在实验中,RankMixer 模型进行了多任务训练,除点击预测任务外还同时完成关注/点赞/评论/转发/长观看的预测,这些任务作为辅助任务,其 AUC 变化量同样作为 Research Agent 的评估指标之一,我们要求 Agent 对目标模型的迭代改进最终不能导致辅助任务ΔAUC 指标发生明显下降。辅助任务ΔAUC 是机械可验证指标,通过代码规则进行计算。
3.2.2 玻璃盒指标
- 探索多样性:对 Agent 轨迹中尝试过/取得收益的改进方法进行分类,统计类别数量,探索多样性过低代表了 Agent 行为可能偏离预期。探索多样性是半客观指标,我们通过 LLM 实现改进方法的分类(LLM-as-a-Judge)。
- 论文工具使用次数: 统计 Agent 轨迹中调用论文工具的总次数,及其中阅读过的不同论文数量,论文工具使用次数过低代表了 Agent 行为可能偏离预期。论文工具使用次数是机械可验证指标,通过代码规则进行计算。
- 数据集分析次数:统计 Agent 轨迹中调用工具对数据集进行分析的次数,具体而言我们将数据集路径出现于任意工具调用参数中视为一次对数据集的分析,数据集分析次数过低代表了 Agent 行为可能偏离预期。数据集分析次数是机械可验证指标,通过代码规则进行计算。
- 探索决策正确率:在后续将要介绍的 Harness 设计中,Agent 会需要进行两类重要决策:a. 本轮探索应选择 Deep branch 还是 Wide branch,b. 某个提案是否值得继续探索。我们人工判断 Agent 轨迹中所有出现的以上两类决策与人类决策是否一致,统计相应准确率,因此,探索决策正确率是一个主观指标。探索决策正确率过低表明了“AI 研究员”与“人类研究员”行为差异过大。
四、Harness 设计与实现
这一章将介绍我们最终的 Harness 方案,包含了我们对 Agent 探索模式的设计,多智能体的划分以及上下文管理方法。
4.1 探索模式设计
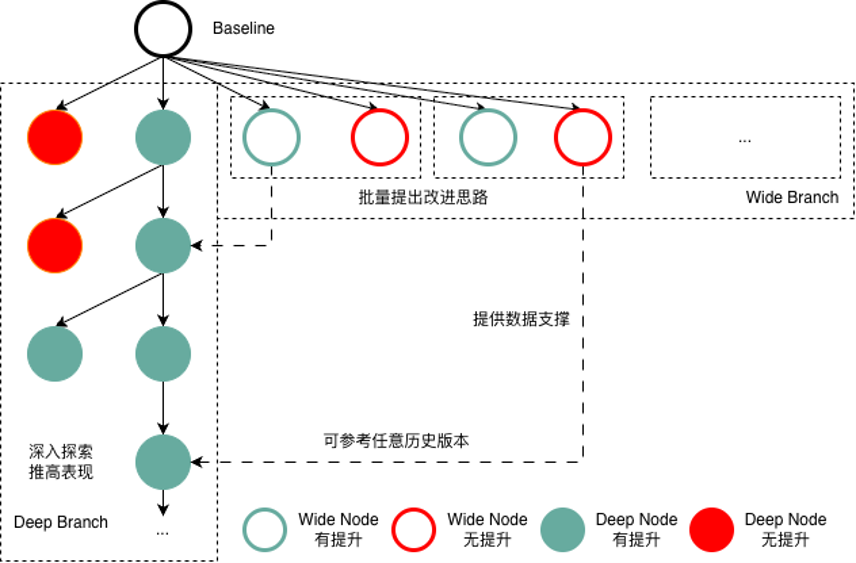
[图 2:Wide-and-Deep 探索策略] |
在前文中我们已验证 Agent 的代码开发能力不是系统瓶颈,因此,关键问题在于如何使得 Agent 可以高效找到有效改进思路,换言之,即如何设计 Agent 的探索模式。这个问题一般被视为基于树[10]或基于图[2]的搜索问题,在探索过程中,Agent 需要作出的一项关键决策是:下一轮研究应基于哪个历史模型版本继续探索。 现有工作通常依赖于预先定义的启发式规则,如使用模型版本对应的评估指标[10]或 UCT 分数[10]等作为依据进行选择。
然而,我们认为这些预定义的规则并不能很好的反映人类研究员的真实行为。因此,如图 2 所示,我们提出了 Wide-and-Deep 探索策略。在这个策略中,我们给予了 Agent 更多自主决策的空间,而非基于任何特定的分数进行强制选择。具体而言,我们将 Agent 的探索过程中的行为划分为两类,分别名为 Wide Branch 和 Deep Branch,其定义如下:
- Wide Branch: 目标是对多个改进思路进行批量尝试,并通过减少训练步数来节省训练成本,以此初步验证改进思路的可行性,为后续探索过程中的各项决策提供数据支撑;这类探索固定以最初基线版本作为父节点,因为我们假设有效改进思路应具备足够的泛化性,在任何合理版本的模型上都应呈现正向趋势。
- Deep Branch: 目标是进一步推高当前最佳模型的表现,此外没有任何显式约束。Agent 可以基于任何版本的模型继续完善某个改进思路,也可以融合多个版本的改进思路来取得更好的表现。这种融合不仅包含了对历史版本中有效改进方法的组合,也可以是参考没有取得提升的历史版本获取反事实来帮助后续改进。
我们提出的策略要求 Agent 首先根据研究现状决定本轮研究进入哪个分支(Wide Branch 或 Deep Branch),再根据该分支的目标完成相应探索工作。对于分支选择的决策,我们设计了四种参考指标:(1) 最近数个版本模型的复盘结论,相应改进思路是否值得继续探索(具体定义见下一节),(2)最近数个版本模型中是否出现了新的最佳模型,及相应的模型指标增量,(3)历史所有版本的探索多样性,(4)上一次选择进入 Wide Branch 的时间。我们要求 Agent 根据这四种参考指标进行决策,但没有设置任何规则或阈值来硬性约束 Agent 的行为。我们认为这种 Wide-and-Deep 探索策略可以更充分的发挥基座模型本身的智能,从而更加灵活的处理研究过程中遇到的不同情况。同时 Wide Branch 和 Deep Branch 的设计也更好的平衡了面对巨大探索空间时的探索广度与深度,增强了 Agent 的探索效率。
多智能体划分
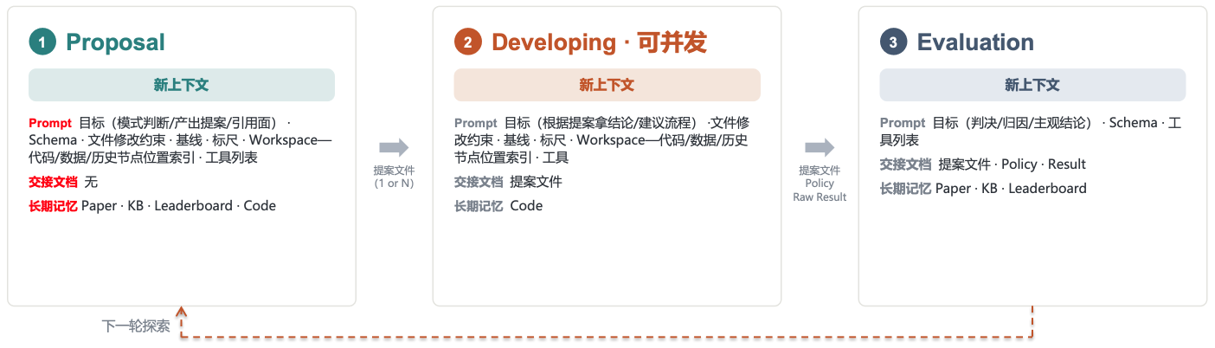
[图 3:多智能体的划分及上下文管理方案] |
尽管如前文的基线 Agent 一样,使用单个 Agent 进行数百小时的长程研究在理论上是可行的,在实践中我们认为对于一个更加合理的系统架构,应根据任务特点把一个大 Agent 拆分为多个职责单一的 Agent,多 Agent 保持解耦以便于进行系统迭代。我们的拆分方案参考了 AgentX[11]的思路,但对于各个 Agent 具体职责的定义有所不同。如图 3 所示,对于 Research Agent,探索的轮次是第一层自然的拆分点,每一轮探索我们可以使用一组新的 Agent 完成任务,下一轮的 Agent 无需继承上一轮 Agent 的上下文,必要的信息由上一轮 Agent 写入长期记忆来进行传递。在某一轮的探索中,我们则采用顺序模式进行第二层拆分,将一轮探索拆分为了三个顺序完成的任务:Proposal,Developing 和 Evaluation,这三个任务分别由三个对应的 Agent 来完成,它们之间通过交接文档来传递必要的信息。具体而言,这三个 Agent 的职责定义如下:
- Proposal Agent:总体目标是提出合理的改进思路,产出相应提案。具体而言,它首先需要决定本轮探索选择 Wide Branch 还是 Deep Branch,随后再实现不同分支的目标:对于 Wide Branch,我们要求其产出至少 8 个提案;对于 Deep Branch,我们要求其产出 1 个提案。我们提示 Agent 可以对论文、代码、数据集、历史实验结果四个维度进行分析来提出改进思路,但具体过程由 Agent 完全自主决定。
- Developing Agent:总体目标是根据提案进行相应代码实现,产出与提案相符的实验结果。具体而言,我们参考了 AgentX[11]的设计,要求 Agent 根据提案设计归因链机制和相应可观测变量,形成相应 Policy 文件,随后完成代码实现,并进行静态代码验证和专家代码评估;通过验证和评估后,再开展模型训练。注意这并不是一个静态的工作流,我们设计了相应工具,由 Agent 自主操作工具完成该流程。在 Proposal Agent 产出多个提案时,我们将并发启动多个 Developing Agent 独立处理这些提案。
- Evaluation Agent:总体目标是对训练完成的模型进行评估,并产出相应实验结论。具体而言,我们将需要产出的实验结论分为以下两类:(1) 客观结论,包含了推荐模型各个预测任务的 AUC 指标,以及根据可观测变量判定对归因链机制作出的判定结果,客观结论由 Agent 操作我们提供的相应工具进行产出;(2)主观结论,由 Agent 根据客观结论对原始提案进行反思,并判断该改进方向是否值得继续探索。
4.2 上下文管理
对于以上三个 Agent,我们需要分别提供与其职责相匹配的上下文,使其能够履行相应职责,本节将介绍我们的上下文管理机制。我们将上下文分为以下三类:
- 提示词:提示词是我们最初提供给 Agent 的上下文,它说明了 Agent 的职责、预期的行为模式和应产出的结果。
- 交接文档:在一轮探索中,Agent 从前序 Agent 处取得必要的交接文档。交接文档仅在本轮探索中使用,其结构比较简单,通常是单个文本文件形式。交接文档除了用于在 Agent 之间传递必要信息外,也用于增强系统的可观测性。例如,对于我们设计的评估指标“探索决策正确率”,我们需要结合 Proposal Agent 产出的提案文件中的相应字段进行评估。
- 长期记忆:长期记忆包含了所有跨越多轮探索后仍然可能用到的信息,由 Agent 在完成其职责的过程中按需查询或修改。其结构通常比较复杂,需要通过相应工具实现增删查改操作。具体而言我们设计了以下四类长期记忆:(1) Paper:与改进目标模型相关的参考文献,(2)KB:历史探索形成的知识库,包含了每一轮探索的实验结论,(3)Leaderboard:记录当前最佳模型的版本及历史变化情况,(4)Code:我们将代码库也作为一种长期记忆进行管理,通过 git 工具对其进行操作。
如图 3 所示,我们按照最小必要原则为每个 Agent 设计了其所需的每类上下文。这种上下文管理方式帮助 Agent 拥有更清晰的指令、更简洁的工具集、更聚焦的任务逻辑。
五、实验结果
我们采用了与前文基线测试相同的实验设置,以 RankMixer 作为目标模型,在 KuaiRand 数据集上进行模型训练与评估,模型训练使用 g6.2xlarge 实例,我们使用了 Amazon Bedrock 提供的基座模型,按照上述方案构建 Research Agent。图 4 展示了主要实验结果,可以看到我们提出的 Research Agent 方案在仅使用基线方案 40%的 GPU 训练时长预算的条件下,实现了 1.88pp 的 AUC 增量,AUC 增量较基线 Agent 方案提高了约 41%。在 Research Agent 提交的最佳模型中,它使用了 4 类不同的改进思路,这相对于基线 Agent 单方向探索在探索多样性指标上有显著提升,我们认为这是我们提出的方案能提高效率研究的直接原因。此外,我们在轨迹中观察到 Agent 的论文工具使用次数为 50 次、总计阅读了 25 篇不同论文,数据集分析次数为 162 次,这也验证了在我们设计的探索策略下,Agent 表现出了更为广泛的探索行为。
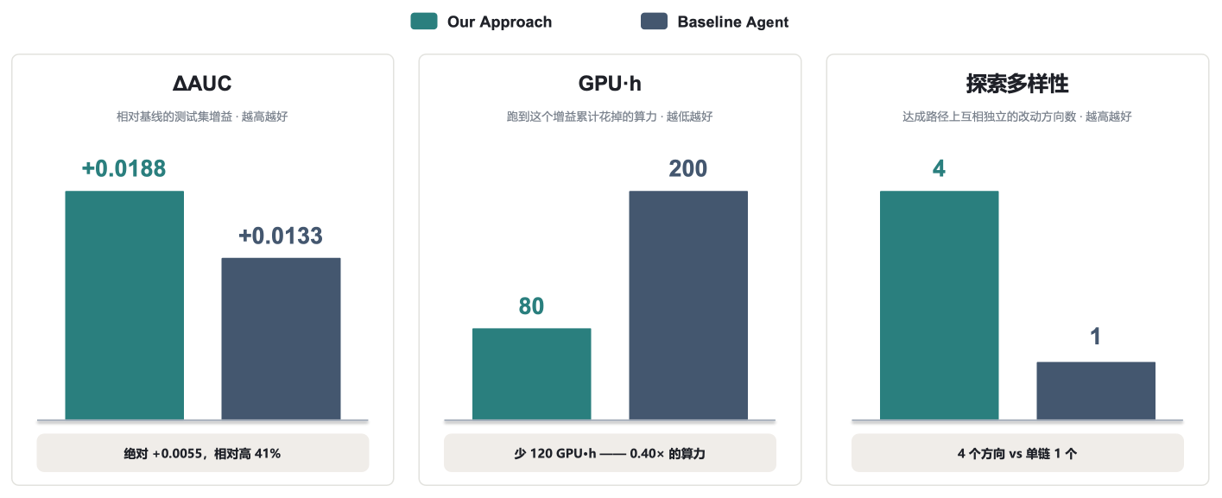
[图 4:主要实验结果] |
我们通过轨迹进一步分析了 Research Agent 的具体探索过程。如图 5 所示,Agent 很好的实现了我们提出的 wide-and-deep 探索策略,在两个分支都进行了充分探索。在这个过程中,Research Agent 保持了良好的探索多样性,持续刷新了最佳模型表现,解决了基线 Agent 难以实现持久改进的问题。
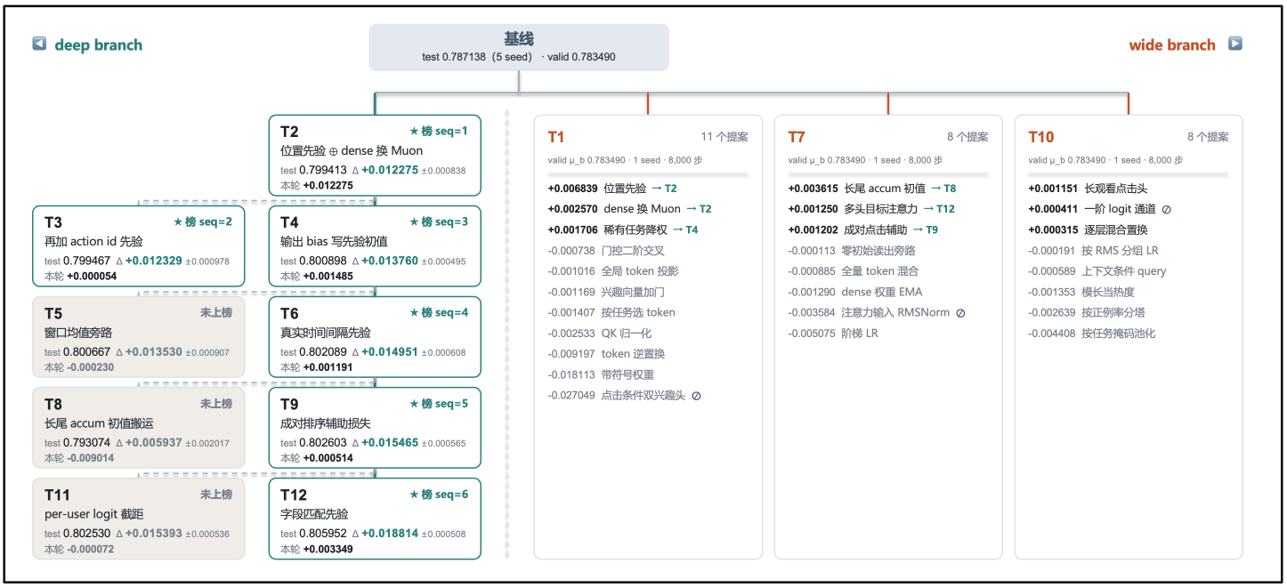
[图 5:研究轨迹展示] |
六、总结
本文介绍了亚马逊云科技人工智能应用实验室与小红书引擎架构部模型工程团队合作共创,针对推荐模型自迭代提出的 Research Agent 方案。我们在 ADLC(Agent Development Lifecycle)框架下开展了 Agent 的设计与开发过程,分享了关于如何选择飞轮起点和如何进行评估体系设计的最佳实践。在我们设计的最终方案中,创新性的提出了 Wide-and-Deep 探索策略,从而更好的平衡了面对巨大探索空间时的探索广度与深度,增强了 Agent 的探索效率。同时也介绍了实现过程中具体的多智能体划分方案和上下文管理方案。最终,我们提出的 Research Agent 方案在仅使用 80 GPU·h 训练时长预算的条件下,实现了 1.88pp 的 AUC 增量,在训练成本和 AUC 增量两个方面都显著优于基线 Agent 方案。
➡️ 下一步行动:
相关产品:
- Amazon Bedrock — 用于构建生成式人工智能应用程序和代理的端到端平台
相关文章:
七、参考文献
[1] Chan, Jun Shern, Neil Chowdhury, Oliver Jaffe, James Aung, Dane Sherburn, Evan Mays, Giulio Starace et al. “Mle-bench: Evaluating machine learning agents on machine learning engineering.” In International Conference on Learning Representations, vol. 2025, pp. 50466-50494. 2025.
[2] Toledo, Edan, Karen Hambardzumyan, Martin Josifoski, Rishi Hazra, Nicolas Baldwin, Alexis Audran-Reiss, Michael Kuchnik et al. “Ai research agents for machine learning: Search, exploration, and generalization in mle-bench.” Advances in Neural Information Processing Systems 38 (2026): 35309-35348.
[3] Karpathy et al. “Autoresearch.”
[4] Yueh-Han, Chen, Jiaxin Wen, and Jan Hendrik Kirchner. “Automated Researchers Can Mitigate Well-characterized Alignment Failures.” arXiv preprint arXiv:2608.28945 (2026).
[5] Zhu, Jie, Zhifang Fan, Xiaoxie Zhu, Yuchen Jiang, Hangyu Wang, Xintian Han, Haoran Ding et al. “Rankmixer: Scaling up ranking models in industrial recommenders.” In Proceedings of the 34th ACM International Conference on Information and Knowledge Management, pp. 6309-6316. 2025.
[6] Gao, Chongming, Shijun Li, Yuan Zhang, Jiawei Chen, Biao Li, Wenqiang Lei, Peng Jiang, and Xiangnan He. “Kuairand: An unbiased sequential recommendation dataset with randomly exposed videos.” In Proceedings of the 31st ACM international conference on information & knowledge management, pp. 3953-3957. 2022.
[7] Zou, Q., Lam, H.H., Zhao, W., Chen, T., Tang, Y., Yu, S., Zhu, Y., Anumasa, S., Zhang, Z., Zhang, T. and Liu, C., 2026. FML-bench: A Controlled Study of AI Research Agent Strategies from the Perspective of Search Dynamics. arXiv preprint arXiv:2605.17373.
[8] Yao, Y., Liu, J., Huang, H., Cai, T. and Mu, D., 2026 企业智能体之旅:为什么评估(Evaluation)是一切的起点
[9] Li, H., Wang, X., Zhang, Z., Zhang, Y., Lin, K. and Zhang, Y., 2026. UniRank: Benchmarking Ranking Models for Unified Sequential Modeling and Feature Interaction. arXiv preprint arXiv:2607.19987.
[10] Jiang, Z., Schmidt, D., Srikanth, D., Xu, D., Kaplan, I., Jacenko, D. and Wu, Y., 2025. Aide: Ai-driven exploration in the space of code. arXiv preprint arXiv:2502.13138.
[11] Lao, C., Pan, F., Ma, G., Li, H., Lin, H., Shi, J., Zhao, K., Gai, K., Zhou, M., Zhou, Q. and Chen, Q., 2026. Agentx: Towards agent-driven self-iteration of industrial recommender systems. arXiv preprint arXiv:2606.26859.
*前述特定亚马逊云科技生成式人工智能相关的服务目前在亚马逊云科技海外区域可用。亚马逊云科技中国区域相关云服务由西云数据和光环新网运营,具体信息以中国区域官网为准。
本篇作者
AWS 架构师中心:云端创新的引领者探索 AWS 架构师中心,获取经实战验证的最佳实践与架构指南,助您高效构建安全、可靠的云上应用
|
 |