AWS 기술 블로그
AI-DLC 기반 GS SHOP 검색·추천 개발 프로세스 고도화 사례
본 블로그는 GS리테일과 AWS가 공동 작성하였습니다.
검색과 추천, 서로 다른 두 과제를 하나의 개발 방법론으로 풀다
온라인 커머스에서 검색과 추천은 고객 경험을 결정하는 핵심 서비스입니다. 고객이 원하는 상품을 빠르게 찾고, 적절한 상품을 제안하기 위해서는 검색 방식과 추천 모델을 지속적으로 개선해야 합니다. 하지만 실제 운영 환경에서는 새로운 기능을 개발하는 것보다 빠르게 검증하고 반복적으로 개선할 수 있는 개발 프로세스를 갖추는 것이 더 어려운 과제가 되곤 합니다.
GS SHOP 검색추천팀 역시 이러한 과제를 안고 있었습니다.
첫 번째는 자연어 기반 상품 검색 품질 개선이었습니다.
“건조한 피부에 좋은 저자극 크림 추천해줘.”
고객에게는 자연스러운 요청이지만, 기존 키워드 기반 검색 시스템에게는 쉽지 않은 질의입니다.
기존 검색 시스템은 BM25 기반 키워드 검색과 임베딩 검색을 결합한 하이브리드 검색 방식을 사용하고 있었지만, “건조 피부에 좋은 저자극 크림”, “모공 축소에 효과적인 세럼”처럼 고객이 자신의 피부 고민이나 사용 목적을 자연어로 표현한 질의에는 원하는 결과를 충분히 제공하지 못했습니다. 상품명 중심의 검색만으로는 고객의 의도를 이해하고 상품의 성분, 효능, 피부 타입, 제형과 같은 상품 속성을 함께 이해하기 어려웠기 때문입니다.
두 번째는 추천 모델 개발 프로세스의 표준화였습니다. 추천 시스템 개발 역시 비슷한 어려움을 가지고 있었습니다.
새로운 추천 모델 아이디어가 떠올라도 실제 성능 개선으로 이어지는지 확인하기 위해서는 데이터 준비, 모델 학습, 평가 환경 구성 등 여러 단계를 거쳐야 합니다. 특히 여러 데이터 사이언티스트가 각자의 방식으로 데이터를 준비하고 모델을 평가하면서 동일한 조건에서 모델을 비교하기 어려웠고, 하나의 가설을 검증하는 데에도 수 시간에서 수 일이 소요되었습니다. 실험 결과를 재현하거나 이전 결과와 비교하는 것도 쉽지 않았습니다.
두 과제는 겉으로는 서로 다른 문제처럼 보였지만 공통점이 있었습니다. 새로운 기능을 만드는 것보다, 실제 운영 환경에서 빠르게 검증하고 반복 개선할 수 있는 개발 프로세스가 필요했다는 점입니다.
특히 두 과제 모두 Amazon Bedrock, Amazon OpenSearch Service, TEI(Text Embeddings Inference), Kubeflow, GS SHOP 내부의 추천 게이트웨이 등 다수 외부 시스템과의 브라운필드 통합이 필요한 복잡한 환경이었습니다. 기존 업무 방식으로는 개별 시스템 연동만으로도 수 주가 소요될 수 있었기에, 체계적인 방법론을 통한 빠른 검증이 절실했습니다.
이를 위해 GS SHOP 검색추천팀은 AI-DLC(AI-Driven Development Life Cycle)를 적용했습니다.
2026년 7월 7일부터 7월 9일까지 3일간 GS SHOP 검색추천팀은 AWS와 함께 AI-DLC Unicorn Gym 워크숍을 진행하며 검색과 추천이라는 두 개의 실제 프로젝트를 대상으로 AI-DLC를 적용하여 요구사항 정의부터 설계, 구현, 테스트, 그리고 실데이터 기반 검증까지 전 과정을 수행했습니다.
검색 파트를 맡은 Team A는 Amazon Bedrock과 Amazon OpenSearch Service를 활용해 자연어 검색 파이프라인을 구축하고 108만 개 상품 데이터를 대상으로 성능을 검증했으며, 추천 파트를 맡은 Team B는 추천 모델 실험 파이프라인을 표준화하여 다양한 후보 모델을 동일한 조건에서 빠르게 비교·평가할 수 있는 구조를 구현했습니다.
이 글에서는 GS SHOP 검색추천팀이 AI-DLC를 실제 프로젝트에 어떻게 적용했는지와, 이를 통해 검색과 추천 개발 프로세스를 어떻게 고도화했는지를 소개합니다.
GS SHOP 검색추천팀과 AI-DLC Unicorn Gym
GS리테일은 GS25, GS더프레시, GS SHOP 등 다양한 유통 서비스를 운영하는 대한민국 대표 리테일 기업입니다. 그중 GS SHOP은 TV홈쇼핑과 디지털 커머스를 결합한 쇼핑 플랫폼으로, 수백만 고객에게 다양한 상품과 서비스를 제공하고 있습니다.
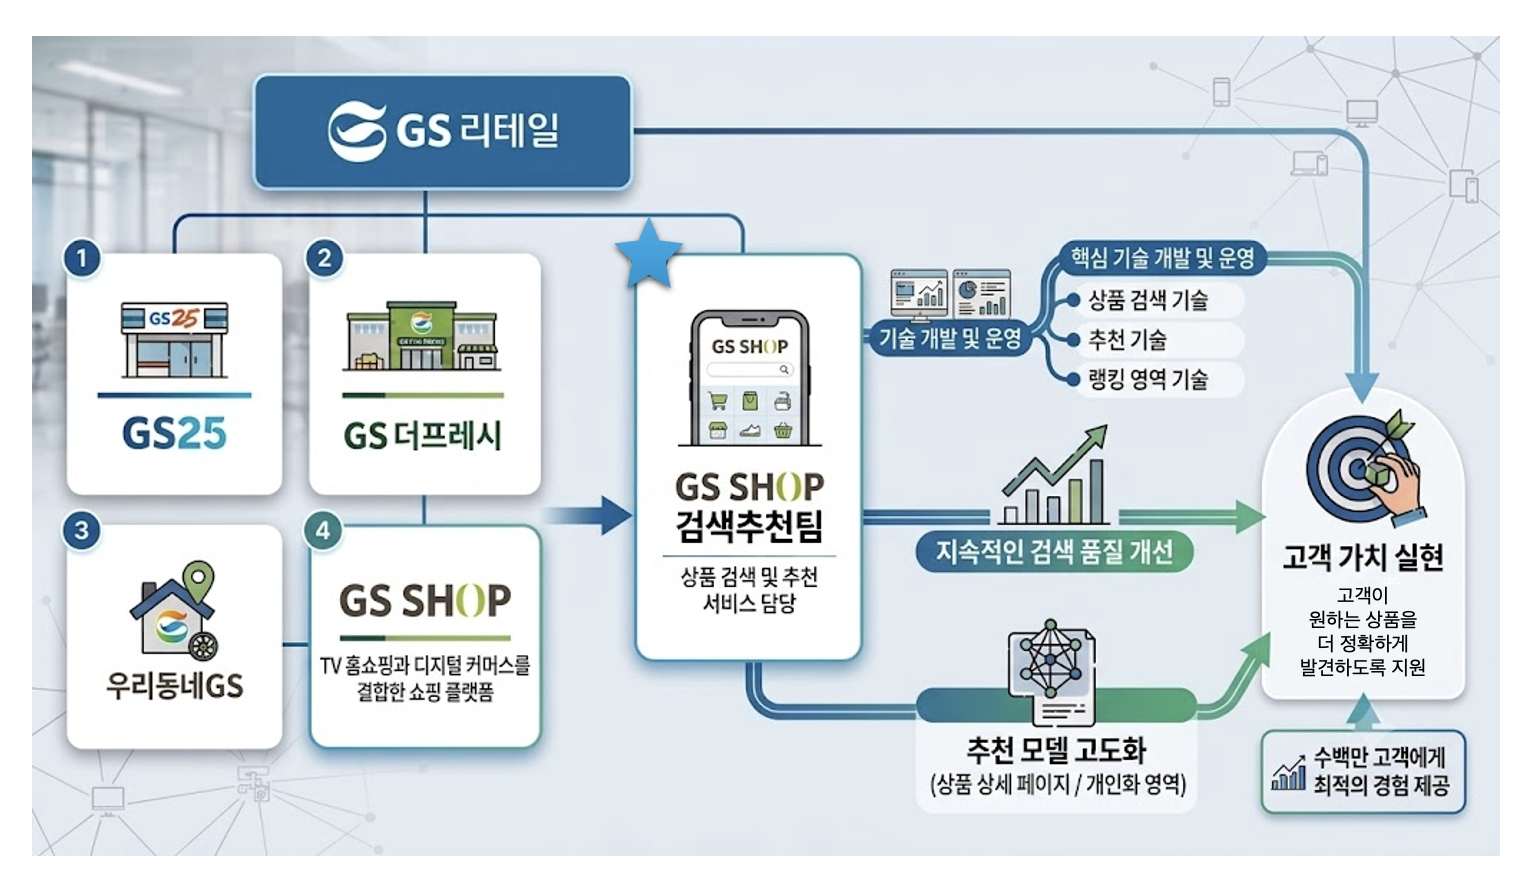
그림 1. GS리테일의 유통 서비스와 GS SHOP 검색추천팀의 역할
이번 프로젝트를 수행한 GS SHOP 검색추천팀은 상품 검색과 추천 서비스를 담당하는 조직입니다. 고객이 원하는 상품을 더 정확하게 발견할 수 있도록 상품 검색, 추천, 랭킹 영역의 기술을 개발하고 운영합니다. 검색 품질을 지속적으로 개선하고, 상품 상세 페이지와 개인화 영역의 추천 모델을 고도화하여 고객이 원하는 상품을 더 정확하게 발견할 수 있도록 지원하고 있습니다.
이번 프로젝트에서 GS SHOP 검색추천팀이 해결하고자 했던 과제는 크게 두 가지였습니다.
과제 1. 고객 의도를 이해하는 자연어 검색
기존 GS SHOP 검색 시스템은 BM25 기반 키워드 검색과 임베딩 검색을 결합한 하이브리드 검색 방식으로 운영되고 있었습니다.
이러한 방식은 상품명이나 브랜드명처럼 명확한 키워드 검색에서는 효과적이었지만,
“건조 피부에 좋은 저자극 크림”
“모공 축소에 효과적인 세럼”
과 같이 고객의 관심사와 사용 목적이 포함된 자연어 질의에서는 한계가 있었습니다.
고객이 원하는 상품을 찾기 위해서는 단순히 검색어를 매칭하는 것이 아니라, 질의 속 의미를 이해하고 상품 속성과 연결하는 과정이 필요했습니다.
과제 2. 반복 가능한 추천 모델 실험 환경 구축
추천 모델 개발 과정에서는 또 다른 문제가 있었습니다.
데이터 사이언티스트마다 데이터 추출 방식과 평가 방법이 달랐기 때문에 모델 간 공정한 비교가 어려웠고, 하나의 가설을 검증하는 데 수 시간에서 수 일이 걸렸습니다.
추천 시스템에서는 새로운 아이디어를 빠르게 시도하고 실패를 확인하는 과정이 중요합니다.
따라서 특정 모델 하나를 만드는 것보다, 다양한 가설을 빠르게 검증할 수 있는 표준화된 실험 환경이 필요했습니다.
AI-DLC를 활용한 개발 프로세스 고도화
AI-DLC(AI-Driven Development Life Cycle)는 요구사항 정의부터 설계, 구현, 품질 검증까지 소프트웨어 개발 전 주기에 AI를 체계적으로 통합하는 AWS의 개발 방법론입니다.
AI-DLC 워크플로우는 크게 세 단계로 구성됩니다.
| 단계 | 핵심 질문 | 주요 활동 |
|---|---|---|
| Inception | 무엇을 만들고 왜 만드는가? | 요구사항 정의, 시스템 설계, 유닛 분해 |
| Construction | 어떻게 구현할 것인가? | 기능 개발, 코드 생성, 테스트 |
| Operation | 어떻게 운영하고 개선할 것인가? | 배포, 모니터링, 지속 개선 |
핵심은 AI가 단순히 코드를 생성하는 도구가 아니라, 개발 프로세스 전체를 함께 구조화하는 파트너로 기능한다는 점입니다. Inception 단계에서 AI가 요구사항을 체계적으로 질문하고, Construction 단계에서 유닛별 설계-구현-테스트 사이클을 반복하며, 각 단계마다 품질 게이트를 통과해야 다음으로 넘어갑니다.
이 흐름을 지탱하는 장치는 세 가지입니다.
- 승인 게이트(Approval Gate): AI가 각 단계 산출물을 제시하면, 사람이 변경 요청이나 다음 단계 진행을 명시적으로 선택해야 넘어갑니다. AI가 앞서가지 못하도록 막는 브레이크입니다.
- audit 로그(audit.md): 모든 사용자 입력과 AI의 결정이 시각과 함께 원문으로 쌓입니다. 왜 그렇게 결정했는지를 나중에 그대로 되짚을 수 있어, 의사결정이 재현 가능해집니다.
- 스티어링(Steering)과 상태 추적: 팀 규칙과 컨벤션을 문서로 고정해 모든 상호작용에 주입하고, 진행 상태(aidlc-state.md)로 지금 어느 단계인지를 항상 파악합니다.
GS SHOP AI-DLC Unicorn Gym에서는 AWS의 AI 개발 도구인 Kiro를 활용했습니다. Kiro는 AI-DLC 방법론을 IDE 수준에서 지원하는 도구로, 요구사항 문서 생성부터 유닛 분해, 코드 생성, 테스트까지의 흐름을 가이드합니다.
AI-DLC Unicorn Gym 진행 과정
워크숍은 사전 준비와 3일간의 실습 과정으로 진행되었습니다.
| 일정 | 주요 내용 |
|---|---|
| 사전 워크숍 | 프로젝트 범위 정의, 요구사항 문서(Vision Document 및 Technical Environment) 작성 |
| Day 1 (Inception) | 요구사항 분석, 유닛 분해, 시스템 설계 |
| Day 2 (Construction) | 유닛 구현, 코드 생성, 테스트 작성 및 품질 검증 |
| Day 3 (Validation) | 실제 데이터 연동, 성능 측정, 결과 검증 및 프레젠테이션 |
워크숍에는 GS SHOP 검색추천팀 내 두 개의 프로젝트 팀과 AI-DLC 워크플로우를 리딩하고 지원하는 AWS Solutions Architect들이 함께 참여했습니다.
- Team A (검색): Amazon Bedrock과 Amazon OpenSearch Service 기반 자연어 검색 파이프라인 구축
- Team B (추천): 추천 모델 실험 프로세스 표준화 및 검증 환경 구축
두 팀은 각각 검색과 추천이라는 서로 다른 목표를 가지고 있었지만, AI-DLC의 동일한 개발 프로세스를 적용하여 요구사항 정의부터 실제 서비스 검증까지 일관된 방식으로 프로젝트를 진행했습니다.
Team A (검색): AI 기반 자연어 검색으로 고객 의도 이해하기
GS SHOP 검색추천팀 Team A의 목표는 명확했습니다.
고객이 상품명을 정확히 입력하지 않아도, 자신의 상황과 목적을 자연스럽게 표현하면 원하는 상품을 찾을 수 있는 검색 경험을 만드는 것이었습니다.
특히 뷰티 카테고리는 상품 속성이 다양하고 고객의 구매 목적이 세분화되어 있어 자연어 기반 검색의 필요성이 높은 영역입니다.
예를 들어 “건조한 피부에 자극이 적은 크림”이라는 질의는 단순한 키워드 조합이 아닙니다. 고객은 제품 유형(크림), 피부 타입(건성), 사용 목적(보습), 구매 조건(저자극)이라는 여러 의미를 함께 전달하고 있습니다.
Team A는 AI-DLC Inception 단계에서 이러한 요구사항을 분석하고, 검색 시스템을 두 개의 독립적인 유닛으로 분리했습니다.
| 유닛 | 역할 |
|---|---|
| Search Core | Query Understanding, Hybrid Search, Reranking을 포함한 검색 파이프라인 |
| Demo & Evaluation | 검색 결과 비교 화면 및 오프라인 평가 환경 |
유닛 단위 설계를 통해 검색 핵심 로직과 평가 환경을 분리하였고, 이러한 유닛 분리는 개발 병렬화를 가능하게 했습니다. 검색 핵심 로직과 평가 환경을 독립적으로 개발하면서도, 명확한 인터페이스를 기반으로 빠르게 통합할 수 있었습니다.
Query Understanding: 자연어 질의를 상품 속성으로 변환
Team A는 Amazon Bedrock에서 제공하는 Claude Haiku 4.5 모델과 Strands Agents를 활용해 고객의 자연어 질의를 분석하는 Query Understanding 모듈을 구현했습니다.
이 모듈은 고객 질의에서 뷰티 상품 검색에 필요한 주요 속성을 추출하며, 주요 추출 대상은 다음과 같습니다.
- 성분
- 효능
- 피부 타입
- 사용감
- 제형
- 고민 유형
- 브랜드
- 제품 유형
- 기타 상품 특성
예를 들어, “건조한 피부에 좋은 저자극 크림 추천해줘”라는 질의는 검색 시스템이 활용할 수 있도록 아래와 같은 구조화된 정보로 변환됩니다.
{
  "product_type": "크림",
  "skin_type": "건성",
  "concern": "건조함",
  "feature": "저자극"
}
이를 통해 검색 시스템은 단순히 질의와 상품명을 비교하는 것이 아니라, 고객 의도와 상품 속성을 함께 고려할 수 있게 됩니다.
또한 상품 데이터 분석을 통해 도출한 폐쇄 어휘(Closed Vocabulary)를 프롬프트에 반영해 속성 추출 정확도를 높였고, 긴 질의나 모델 응답 실패 상황에서는 Claude Sonnet 4.6으로 자동 전환하는 Fallback 구조를 적용해 안정성도 확보했습니다.
Hybrid Search: 키워드와 의미 기반 검색의 결합
Query Understanding 이후에는 Amazon OpenSearch Service 기반 Hybrid Search를 수행합니다.
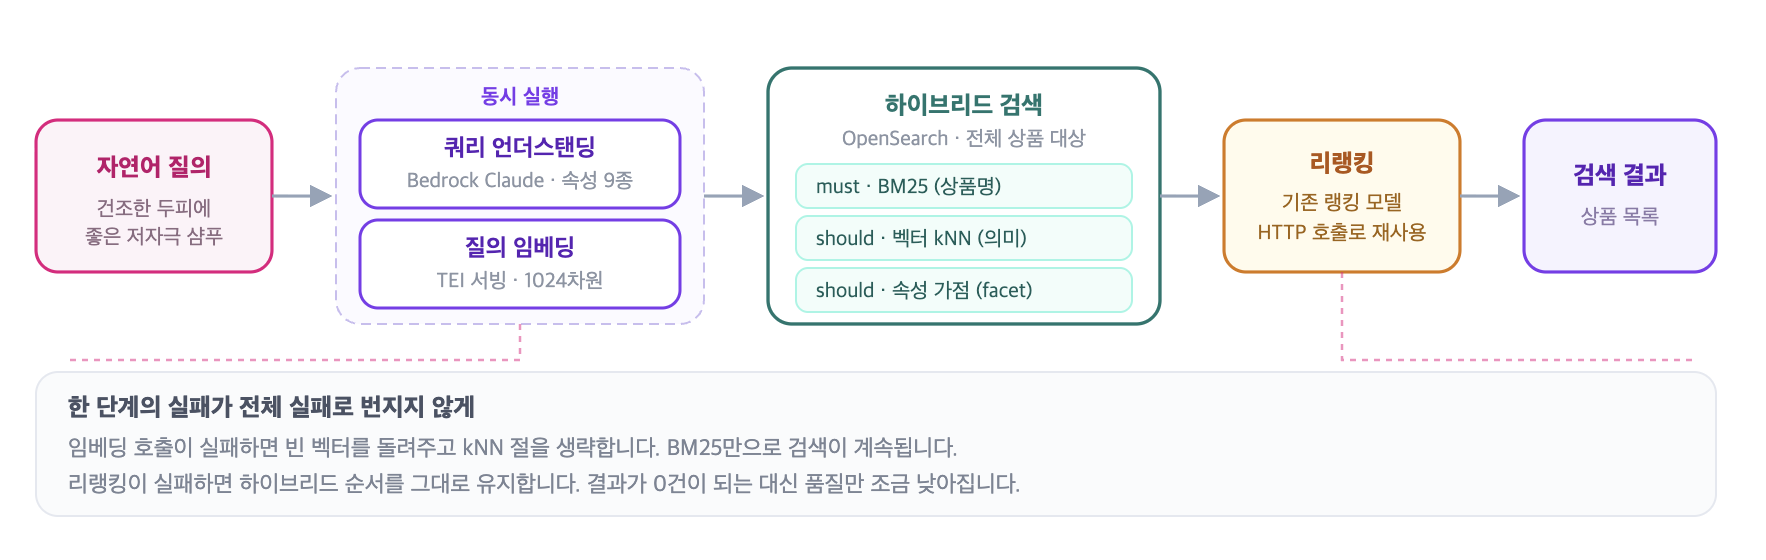
그림 2. 자연어 검색 파이프라인. 쿼리 언더스탠딩과 질의 임베딩이 동시에 실행되고, 하이브리드 검색과 리랭킹을 거쳐 결과를 반환합니다
Hybrid Search는 두 가지 검색 방식을 결합합니다.
- BM25 기반 검색: 상품명, 브랜드명 등 명확한 키워드 검색에 강점을 가집니다.
- Vector Search: 상품 설명과 고객 질의의 의미적 유사성을 기반으로 검색합니다.
Team A는 오픈소스 임베딩 모델(BGE-M3, 1024 차원)을 TEI(Text Embeddings Inference)로 서빙해 질의를 실시간으로 인코딩했습니다.
최종 검색 과정에서는 BM25 결과와 kNN Vector Search 결과를 결합하고, Query Understanding 단계에서 추출한 상품 속성을 활용해 관련 상품의 점수를 조정했습니다.
이를 통해 고객이 표현한 의도와 더 가까운 상품이 검색 결과 상단에 노출될 수 있도록 설계했습니다.
실데이터 기반 검색 품질 검증
AI-DLC의 중요한 특징은 구현 이후 반드시 검증 단계를 거친다는 점입니다.
최초 설정한 품질 지표 기준은 아래와 같았습니다.
| 지표 | 목표 |
|---|---|
| 검색 결과(상위 10건) 내 뷰티 상품 포함률 | 80% 이상 |
| API 응답 시간 (p95) | 3초 이내 |
포함률을 주 지표로 삼은 이유가 있습니다. 검색을 뷰티 카테고리로 미리 좁히지 않고 전체 상품을 대상으로 하기 때문입니다. 실데이터의 경우 색인된 100만여 개 상품 중 뷰티는 2%가 되지 않는데, 뷰티 질의를 받는다면 상위 10건을 뷰티 상품으로 채워야 합니다. 결과에 무엇이 섞여 나오는지가 곧 질의 의도를 얼마나 이해했는지를 보여줍니다. 응답 시간 목표 3초는 질의 이해에 LLM 호출이 들어간 구조를 감안한 상한이었습니다.
Team A는 Day 3 Validation 단계에서 목업 데이터를 넘어 실제 GS SHOP 상품 데이터를 활용해 검색 시스템을 평가했습니다. 검증 환경은 아래와 같습니다.
- Query Understanding: Amazon Bedrock Claude Haiku 4.5 모델
- Embedding: TEI에서 서빙되는 BGE-M3 Embedding 모델
- Search Index: Amazon OpenSearch Service
- Real Data: 108만 개 상품 데이터
- Evaluation: 11,221개 평가 쿼리
검증 결과는 다음과 같습니다.
| 지표 | 결과 |
|---|---|
| 실행 안정성 | 전체 쿼리 무장애 완료 |
| p95 응답 시간 | 2.66초 (리랭킹 제외 기준, 목표 3초 이내 달성) |
| 뷰티 카테고리 포함률 | 53% (하이브리드 단계 58% → 리랭킹 후 53%) |
| 핵심 인사이트 | 리랭킹 단계를 포함률 80% 목표 달성의 핵심 레버로 식별 |
이번 검증에서 가장 의미 있었던 부분은 단순히 성능 목표를 달성했다는 점이 아니었습니다. 11,221개 전체 평가 쿼리를 무장애로 실행하며 성능 목표를 달성한 것도 의미 있지만, 측정을 통해 다음에 무엇을 개선해야 하는지가 데이터로 명확해졌다는 것이 이 스프린트의 핵심 성과였습니다.
성능 목표는 통과했지만 핵심 품질 지표인 뷰티 카테고리 포함률(검색 결과 상위 10건 내 뷰티 상품 포함률)은 목표에 미치지 못했습니다. 눈여겨볼 점은 리랭킹을 거치면 포함률이 오히려 떨어졌다는 것입니다. 판매 지표 기반의 기존 랭킹 모델이 자연어 검색의 관련성 신호와 항상 같은 방향을 보지는 않는다는 뜻이었습니다.
이를 발견할 수 있었던 이유가 있습니다. AI-DLC 과정을 진행하면서 지속적인 과제 명확화를 통해 같은 질의에 대해 기존 키워드 검색과 하이브리드 검색, 그리고 리랭킹까지 적용한 결과를 나란히 놓는 3열 비교 데모를 만들어 두었기 때문입니다. 리랭킹 전후를 따로 보지 않았다면 최종 포함률 53% 라는 숫자만 보고 원인을 짐작하고 있었을 것입니다.
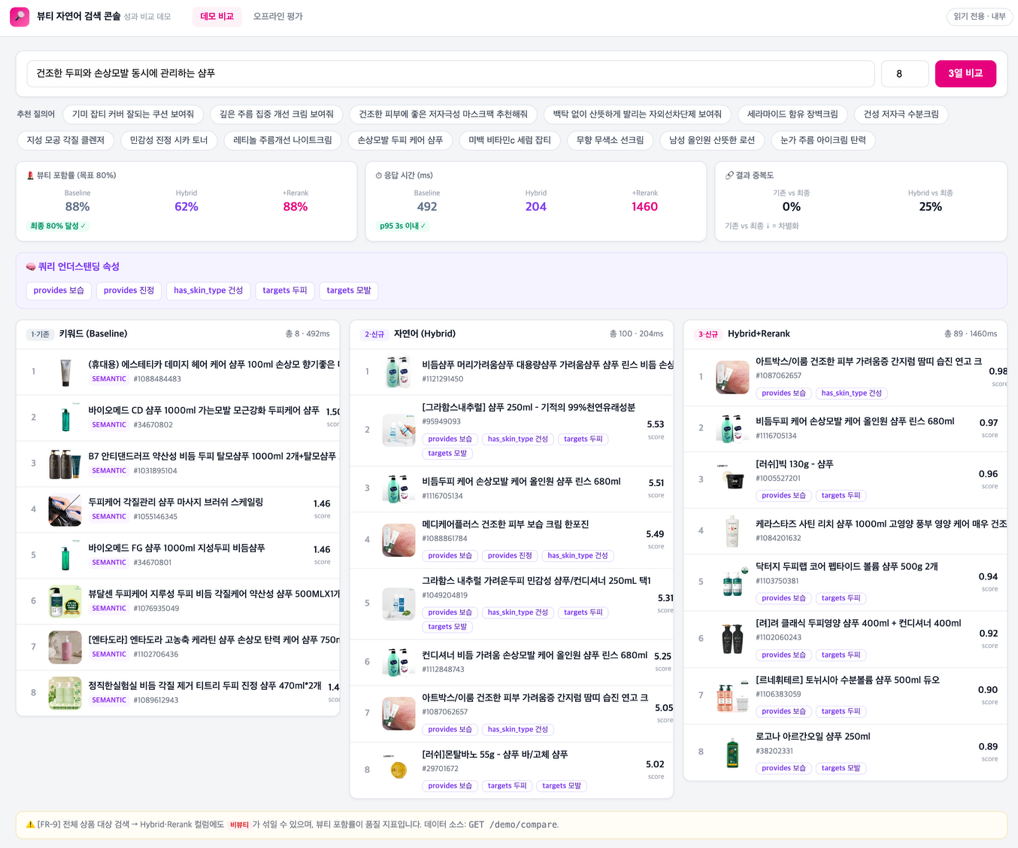
그림 3. 같은 질의에 대한 기존 키워드 검색, 하이브리드 검색, 리랭킹 적용 결과를 나란히 확인하는 3열 비교 데모
결과적으로 현재 검색 품질 개선에서 가장 중요한 영역이 Reranking 정책이라는 점을 확인했고, 이후 개선 방향을 데이터 기반으로 결정할 수 있었습니다.
Team B (추천): 추천 모델 개발을 위한 실험 프로세스 표준화
Team B의 목표는 특정 추천 모델 하나를 개발하는 것이 아니었습니다.
핵심 목표는 새로운 추천 아이디어를 같은 조건에서 등록하고, 비교하고, 다음 행동으로 연결할 수 있는 표준 실험 환경을 만드는 것이었습니다.
기존 추천 모델 개발 과정에서는 데이터 사이언티스트마다 데이터를 추출하고 전처리하는 방식, 평가 지표, 실험 환경이 달랐습니다. 이 때문에 새로운 모델 아이디어가 생겨도 결과 차이가 모델에서 비롯된 것인지, 데이터와 실행 조건에서 비롯된 것인지 구분하기가 어려웠습니다. 또한 하나의 가설을 구현하고 검증하는 데 드는 비용이 커서, 떠오른 여러 아이디어를 충분히 비교해 보기도 쉽지 않았습니다.
Team B는 AI-DLC를 활용해 이 과정을 표준화했습니다. 구현 속도를 높이는 것만으로는 충분하지 않았습니다. 후보가 빠르게 늘어날수록 무엇을 성공으로 볼 지, 결과를 신뢰해도 되는지, 무엇을 다음으로 검증할지 판단하는 기준이 더 중요해졌기 때문입니다.
이를 위해 AI-DLC Inception 단계에서 추천 개발 과정을 세 개의 유닛으로 분해했습니다.
| 유닛 | 역할 | 워크숍 범위 |
|---|---|---|
| U1 | 공유 인터랙션 로그 제공 및 데이터 계약 정의 | 구현·검증 |
| U2 | 오프라인 후보 모델 실험 파이프라인 구축 | 구현·검증 |
| U3 | GS SHOP 추천 게이트웨이 연동 | 후속 확장 |
이번 워크숍에서는 U1과 U2를 중심으로 구현·검증하고, 비교 가능한 후보를 바탕으로 이후 U3를 확장하는 것으로 범위를 설정했습니다. 따라서 이 글의 추천 결과는 오프라인 실험 범위의 결과이며, 실제 서비스의 온라인 성과나 게이트웨이 연동 이후의 운영 결과를 의미하지 않습니다.
데이터 계약 기반 추천 실험 환경 구축
Team B는 먼저 추천 모델 학습과 평가에 필요한 데이터를 표준화했습니다. 검증에는 다음 규모의 실제 데이터를 활용했습니다.
- 7.26M 인터랙션 로그
- 21만 사용자
- 55만 상품
- 14일 데이터
기존에는 모델마다 필요한 데이터를 개별적으로 준비했다면, 새로운 구조에서는 정의된 데이터 계약(Data Contract)을 기반으로 동일한 데이터를 활용할 수 있도록 개선했습니다.
데이터 계약의 목적은 모든 모델 구현을 같게 만드는 데 있지 않습니다. 후보의 구현 방식은 다를 수 있지만, 비교에 사용하는 데이터·기간·결과 형식을 맞춰야 결과의 차이를 해석할 수 있습니다.
“모델은 자유롭게, 평가는 엄격하게.”
이 원칙은 후보의 다양성을 유지하면서도 실험 결과의 비교 가능성을 지키기 위한 기준이었습니다.
CandidateModel 기반 실험 표준화 구조
Team B가 설계한 핵심 구조는 CandidateModel 인터페이스입니다.
기존 방식에서는 새로운 모델을 실험하려면 데이터 처리 코드, 학습 코드, 평가 코드 등 여러 부분을 수정해야 했습니다. 하지만 CandidateModel 계약을 정의하면서 새로운 후보는 해당 인터페이스를 구현해 공통 데이터 계약과 평가 흐름에 등록할 수 있도록 개선했습니다.
즉, 추천 모델 개발은 모델마다 별도의 실험 환경을 만드는 방식에서, CandidateModel만 구현해 공통 시험대에서 비교하는 방식으로 바뀌었습니다.
이번 워크숍에서는 상품 간 행동 유사도, 인기 상품 활용, 후보 순서 재조정 등 여러 후보 아이디어를 이 구조 위에서 비교했습니다.
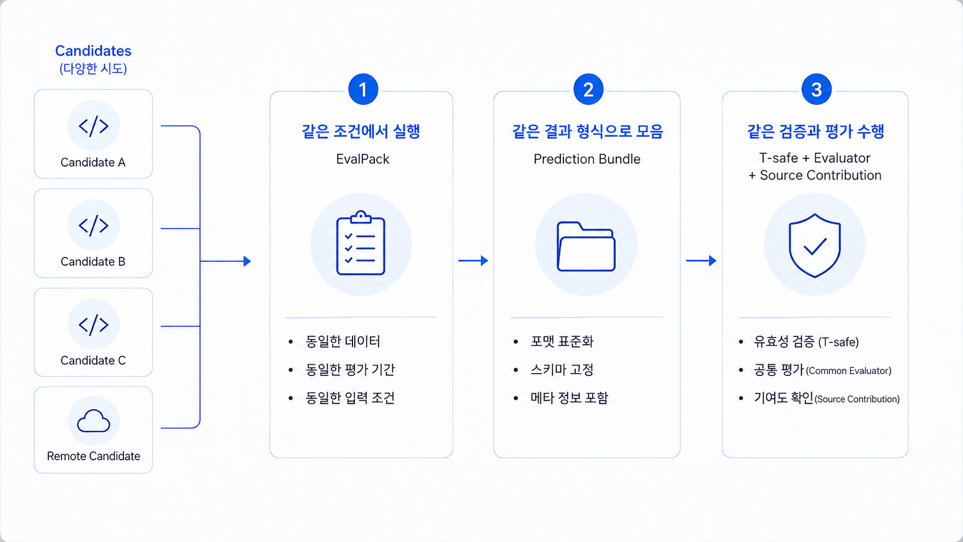
그림 4. 후보 모델을 같은 조건에서 실행하고 같은 형식으로 모아 같은 기준으로 평가하는 실험 표준화 구조
데이터 기반 추천 모델 검증과 평가 기준
표준화된 실험 환경을 구축한 Team B는 후보를 동일한 조건에서 비교하기 위해 평가를 두 단계로 나눴습니다. 먼저 후보군 안에 실제 정답 상품이 충분히 포함됐는지 보는 지표(Recall@200)로 후보를 제대로 모았는지 확인하고, 그 다음 추천한 상품이 고객의 첫 클릭을 기점으로 실제 주문까지 이어졌는지를 보는 GS SHOP 내부 지표(AFV-O)로 그 후보가 실제 구매 행동과 얼마나 연결되는지를 비교했습니다.
이렇게 단계를 나눈 이유는, 결과가 기대에 못 미쳤을 때 그 근본 원인이 후보를 충분히 모으지 못했기 때문인지, 모은 후보가 고객 행동과 연결되지 않았기 때문인지를 구분해야 다음 가설을 세울 수 있기 때문입니다.
Team B는 평가 기준을 고정된 전제로 두지 않았습니다. 어떤 지표로 무엇을 볼 지 정하는 일 자체가 곧 무엇을 다음으로 검증할 지를 정하는 일이었기 때문입니다.
Team B는 단순히 어떤 지표를 쓸 것인가에 대한 선택을 넘어, 실험의 결과를 신뢰하기 위해서는 평가 기준 또한 검증 대상이 되어야 한다는 사실을, 반복 실험 과정에서 함께 확인하였습니다.
결과 신뢰성 검증과 다음 행동 체계화
여러 후보를 빠르게 실행할 수 있게 되자, 평가 기준과 결과의 신뢰성을 확인하는 일이 더 중요해졌습니다. 이 구조가 왜 필요했는지를 가장 잘 보여준 결과가 하나 있었습니다.
상품 간 행동 유사도를 활용하는 실험 중 하나에서 order_NDCG@16 수치가 0.097633이 나왔습니다. 같은 아이디어를 미래 정보가 섞이지 않도록 구현한 결과는 0.012374였습니다. 약 8배 차이였습니다.
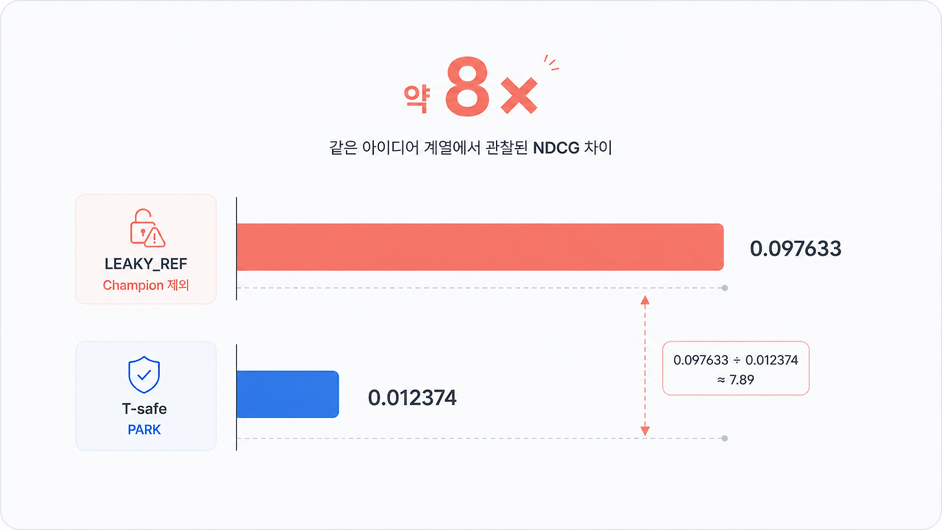
그림 5. 같은 아이디어 계열에서 관찰된 NDCG 차이. 미래 정보가 포함된 결과(LEAKY_REF)와 차단한 결과(T-safe)가 약 8배 차이 납니다
숫자만 보면 고민할 이유가 없어 보였습니다. 하지만 수치가 높은 쪽을 확인해보니 평가 시점 이후의 정보가 포함되어 수치가 높게 측정이 된 것이었습니다. Team B는 이 결과를 실제 후보 판단에서 제외하고 참고 결과(LEAKY_REF)로만 남겼으며, 같은 아이디어를 미래 정보 누출이 없도록 다시 구현하여 그 결과를 실제 비교에 사용했습니다.
높은 수치를 빨리 얻고 그대로 채택하는 것보다, 그 수치가 공정한 조건에서 나온 신뢰할 수 있는 결과인지 먼저 확인하는 일이 중요하다는 걸 경험으로 체득할 수 있었습니다.
Team B는 또한 이 실험 결과를 단순한 점수나 순위로만 남기지 않고 다음 행동으로 연결했습니다. 점수만 남겨두면 며칠 뒤 다시 이 모델들을 어떻게 할지 결정해야 합니다. 그래서 결과 옆에는 점수뿐 아니라 다음 행동도 함께 남기기 시작했습니다.
| 라벨 | 의미 |
|---|---|
| STOP | 현재 목적에서는 추가 검증을 진행하지 않음 |
| PARK | 가능성은 있으나 조건을 보완한 뒤 다시 검증 |
| KEEP_SOURCE | 전체 1위는 아니지만 후보군을 보완하는 역할로 유지 |
이번 실험의 목적에서 기존 후보보다 나아질 가능성을 찾기 어렵다면 STOP, 가능성은 보이지만 데이터나 기간을 넓혀 한 번 더 확인해야 한다면 PARK로 두었습니다. 전체 성능이 가장 높지 않더라도 기존 후보가 놓친 상품을 새롭게 찾아오는 등 후보군 안에서 다른 역할이 있다면 KEEP_SOURCE로 남겼습니다.
결국 이 라벨은 모델의 절대적인 우열을 정하기보다, 현재까지의 결과를 바탕으로 다음 행동을 정리하기 위한 기준에 가까웠습니다. 예를 들어 PARK 라벨이 붙어 있다면 다음 질문은 조금 더 명확해집니다. “이 후보가 좋은가?” 라는 질문 대신 “어떤 조건에서 한 번 더 확인해야 하는가?” 처럼 구체화된 질문을 던질 수 있습니다.
실제로 후보의 순서를 다시 조정하는 모델 5종은 이번 목적에서 더 투자할 근거를 찾지 못해 STOP했습니다. 인기 상품을 활용한 후보는 전체 성능이 가장 높지는 않았지만, 기존 후보군이 놓친 주문 상품을 추가로 찾아오는 기여가 있어 단독 승부보다는 후보군을 보완하는 역할로 KEEP_SOURCE에 남겼습니다. 가장 가능성이 높아 보였던 후보도 바로 채택하지 않고, 더 큰 데이터와 여러 기간에서 안정성을 확인하기 위해 PARK하는 방식으로 작업을 이어 나갔습니다.
40회 이상의 추천 가설 검증과 개선 방향 도출
AI-DLC의 Construction과 Validation 과정을 통해 Team B는 워크숍 참여자 전체 기준으로 40회 이상의 모델 실험을 수행했습니다.
| 항목 | 검증 범위 |
|---|---|
| 실험 횟수 | 40회 이상 |
| 데이터 규모 | 7.26M 인터랙션 로그 |
| 사용자 규모 | 21만 명 |
| 상품 규모 | 55만 개 |
| 검증 범위 | 공통 데이터 계약과 오프라인 평가 환경에서의 후보 비교 |
실험 과정에서 실험 횟수가 늘어나면서 각 실험을 비교하는 비용이 점차 커졌습니다. 주요 지표와 실행 조건, 미래 정보 누출 여부, 기존 방식 대비 변화, 그리고 각 실험에 내린 판단을 한눈에 볼 수 있도록 leaderboard 형태의 대시보드를 만들었습니다. 대시보드가 결과를 대신 판단해주는 것은 아니었습니다. 그보다는 여러 실험을 같은 조건에서 보고 다음 행동을 결정하기 위한 화면 구현이 목적이었습니다. 새로운 후보가 하나 추가될 때마다 이전 결과를 다시 찾고 별도의 표를 만드는 대신, 같은 입력 → 같은 평가 → 같은 비교 → 다음 행동으로 워크플로우가 이어지게 했습니다.
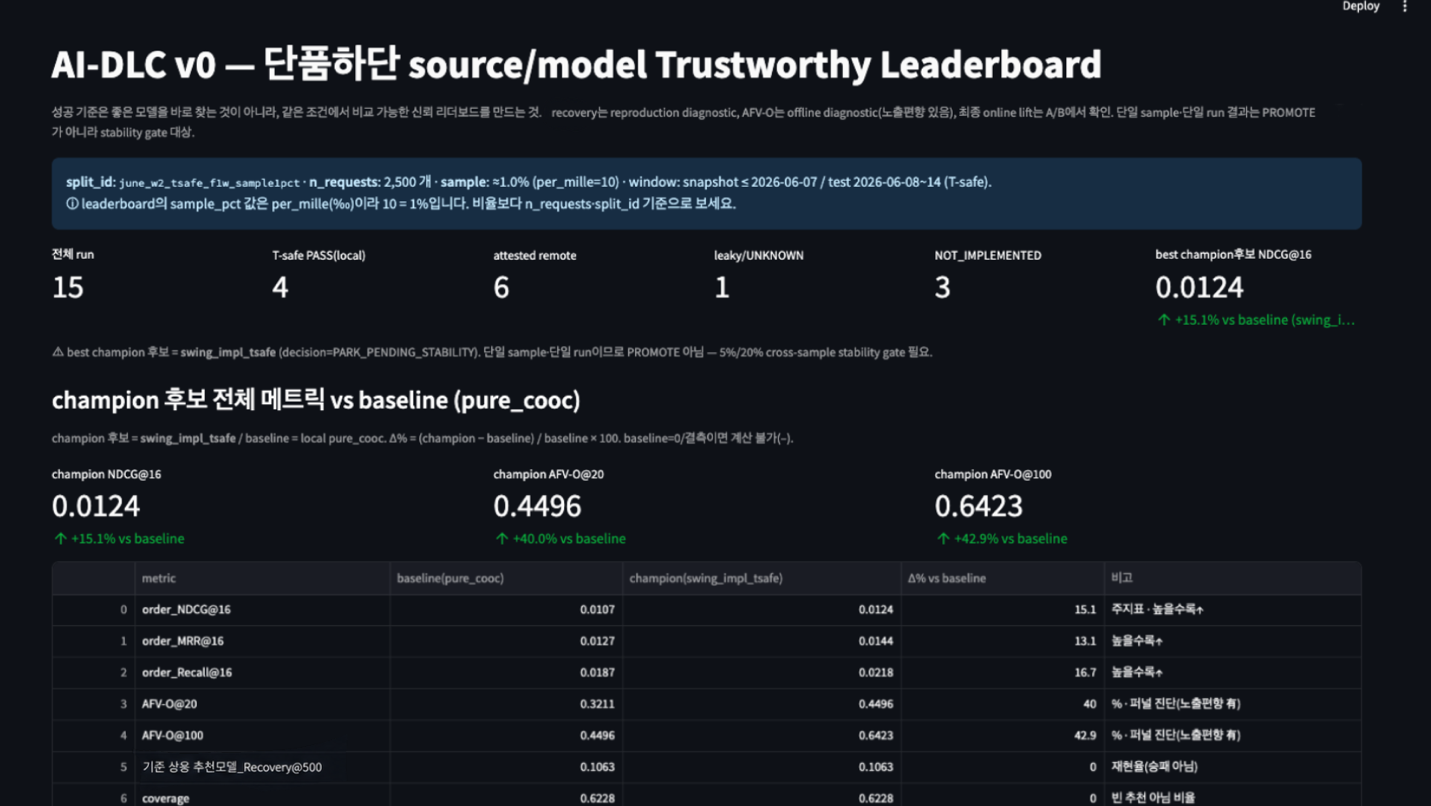
그림 6. 실험 조건과 판정을 한눈에 보는 Trustworthy Leaderboard 대시보드
이번 3일 간의 실험 결과는 하나의 우수한 모델 이름으로 정리되지는 않았습니다. 대신 실험이 나아갈 방향을 정하고, 다른 역할로 남겨 둘 후보와 추가 검증이 필요한 후보를 구분하였습니다. 그로부터 다음 후보가 들어와도 처음부터 평가 조건을 다시 맞추지 않아도 되는 공통 구조를 마련할 수 있었습니다.
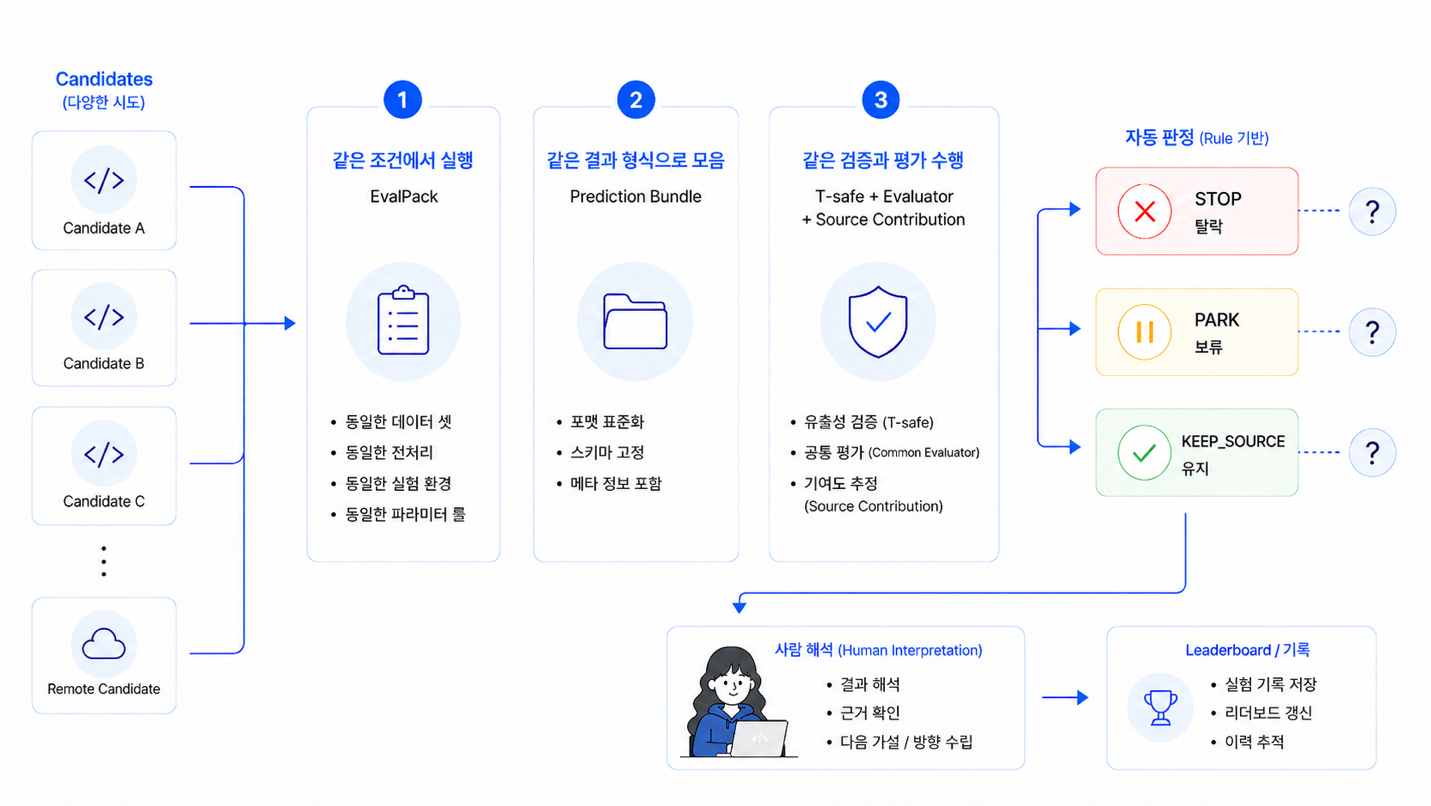
그림 7. 후보 등록부터 자동 판정(STOP, PARK, KEEP_SOURCE)과 사람 해석까지 이어지는 실험 흐름
추천 개발 방식의 변화
Team B 프로젝트의 가장 큰 성과는 특정 모델 하나를 선정했다는 점이 아닙니다. 핵심 성과는 어떤 추천 아이디어라도 공통 평가 조건에서 빠르게 검증하고, 결과의 신뢰성을 확인한 뒤 다음 행동을 결정할 수 있는 환경을 구축했다는 점입니다.
표준화된 파이프라인은 구현과 반복 실행을 지원했습니다. 데이터 사이언티스트의 역할은 아래 판단 영역에 더 선명하게 집중되었습니다.
- 어떤 고객 문제와 연결되는 가설을 먼저 볼 지 결정
- 무엇을 성공으로 볼 지, 평가 기준을 어떻게 보정할 지 결정
- 데이터 누출과 비교 조건의 문제를 확인
- 결과를 STOP, PARK, KEEP_SOURCE로 분류
- 탐색이 원래 목적에서 벗어나지 않도록 중단 또는 방향 전환
이 접근 방식은 결과를 대신 판단하는 흐름이 아니라, 팀이 반복적인 구현 작업에서 확보한 시간을 문제 정의·평가·검증·다음 결정에 사용할 수 있도록 지원했습니다.
프로젝트 결과와 개발 방식의 변화
GS SHOP 검색추천팀은 이번 AI-DLC Unicorn Gym을 통해 검색과 추천이라는 서로 다른 기술 과제에 동일한 개발 흐름을 적용했습니다.
Team A는 자연어 기반 검색 파이프라인을 구축하고 실데이터 검증으로 다음 개선 병목을 확인했습니다. Team B는 추천 후보를 비교하는 실험 환경을 표준화하고, 평가 기준과 결과의 신뢰성을 검증하는 방식을 정립했습니다.
두 프로젝트의 공통 성과는 결과물을 한 번 만드는 데 그치지 않고, 측정 결과를 다음 개선과 의사결정으로 연결하는 구조를 만들었다는 점입니다.
검색과 추천 개발 과정의 변화
| 구분 | Team A: 자연어 검색 | Team B: 추천 모델 실험 |
|---|---|---|
| 목표 | 고객 의도를 이해하는 뷰티 상품 검색 개선 | 추천 후보를 공정하게 비교·검증하는 실험 환경 표준화 |
| 주요 기술 | Amazon Bedrock, Amazon OpenSearch Service, TEI, Strands Agents | 데이터 계약, CandidateModel, 공통 오프라인 평가 흐름 |
| 검증 데이터 | 108만 상품, 11,221개 평가 쿼리 | 7.26M 인터랙션 로그, 21만 사용자, 55만 상품 |
| 핵심 성과 | p95 응답 시간 2.66초, 포함률 53% 달성 | 40회 이상의 모델 실험, 지표 보정과 다음 행동 체계화 |
| 주요 인사이트 | Reranking이 검색 품질 개선의 핵심 개선 영역 | 공통 평가 조건, 지표 보정, 결과 신뢰성 검증의 중요성 |
AI-DLC를 통해 달라진 개발 방식
이번 프로젝트에서 AI-DLC의 핵심 가치는 단순히 개발 시간을 줄이는 데 있지 않았습니다. AI-DLC는 팀이 문제를 정의하고, 이를 작은 단위로 분해하고, 구현 결과를 빠르게 검증하는 개발 흐름을 제공했습니다. 기존 개발 과정에서는 다음과 같은 문제가 반복되었습니다.
- 요구사항이 충분히 구체화되기 전에 구현이 시작됨
- 팀마다 다른 방식으로 실험을 수행함
- 결과 비교와 재현이 어려움
- 한 번의 구현·검증 비용이 커서 여러 가설을 충분히 비교하기 어려움
AI-DLC 적용 이후에는 개발 과정이 다음과 같이 변화했습니다.
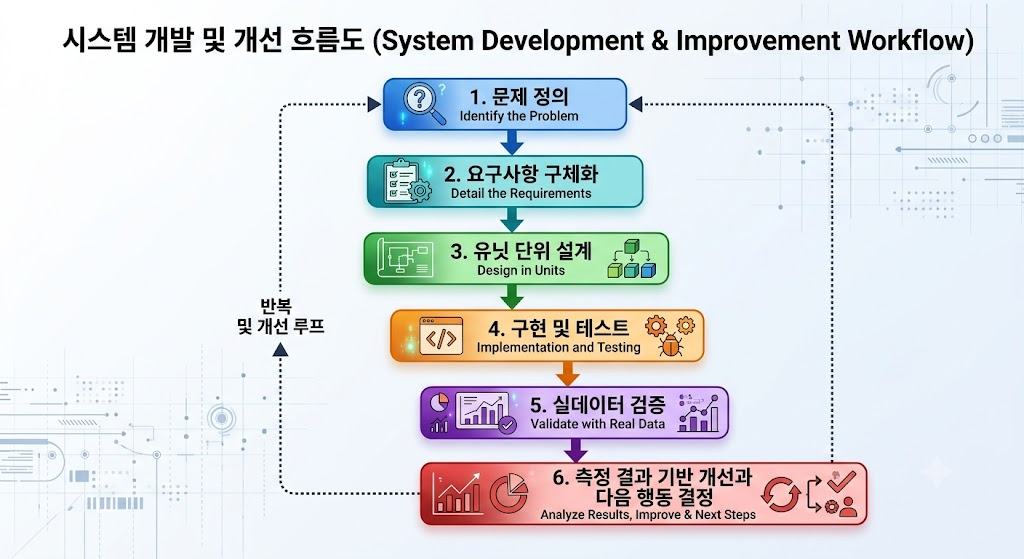
그림 8. AI-DLC 적용 이후의 시스템 개발 및 개선 흐름도
이 과정에서 표준화된 파이프라인은 반복적인 구현과 정리 작업을 지원하는 협업 도구로 활용되었습니다. 다만 문제 정의, 평가 기준, 결과의 신뢰성, 중단과 방향 전환을 결정하는 책임은 팀의 몫으로 남겨 두었습니다.
이 경험은 도구가 빠르게 만든 결과를 팀이 어떻게 평가하고 다음 결정으로 연결하는지가 핵심이라는 점을 보여 줍니다.
운영 적용을 위한 후속 검증 과제
이번 워크숍 결과는 실데이터를 활용한 검증의 출발점입니다. 실제 서비스로 확장하기 전에는 다음을 별도로 확인해야 합니다.
- Team A: Reranking 개선과 서비스 환경에서의 품질·지연 시간 관측 기준
- Team B: U3 추천 게이트웨이 연동, 온라인 검증 기준, 후보·지표·데이터 계약의 변경 이력 관리
- 공통: 데이터 접근 권한, 최소 권한 IAM, 서비스·모델 버전, 비용과 지연 시간 전제, 관측성·롤백 기준
이 항목들은 이번 워크숍에서 이미 달성한 결과에서 나아가, 검증된 실험을 실제 운영 환경으로 확장하기 위한 다음 조건입니다.
마무리: AI-DLC 기반으로 진화하는 GS SHOP 검색·추천 개발 여정
이번 GS SHOP 검색추천팀의 AI-DLC 적용 사례는 체계적인 개발 방법론이 단순한 구현 속도 향상을 넘어, 문제 해결 방식 자체를 변화시킬 수 있음을 보여줍니다.
이번 프로젝트에서 확인한 주요 인사이트는 다음과 같습니다.
실데이터 기반 검증이 가능한 개발 방식
AI-DLC의 구조화된 프로세스를 통해 검색과 추천이라는 복잡한 AI 프로젝트에서도 요구사항 정의부터 실제 데이터 검증까지 일관된 방식으로 진행할 수 있었습니다.
측정 결과가 다음 개발 방향을 결정
검색에서는 Reranking이라는 다음 개선 영역을 확인했고, 추천에서는 평가 기준과 결과 신뢰성을 함께 검증해야 한다는 사실을 확인했습니다. 결과적으로 “무엇을 만들어야 하는가”뿐 아니라 “다음에 무엇을 해야 하는가”까지 데이터 기반으로 결정할 수 있었습니다.
팀 전체의 개발 역량을 확장하는 방법론
AI 시대의 개발에서는 개인의 경험에 의존하기보다, 팀이 반복 가능한 개발 방식을 갖추는 것이 중요합니다. AI-DLC는 요구사항 정의, 설계, 구현, 검증 과정을 하나의 흐름으로 연결해 팀이 더 빠르게 학습하고 개선할 수 있는 기반을 제공합니다. 그 결과 팀은 가설의 선택, 평가 기준의 보정, 결과의 검증, 중단과 방향 전환에 더 집중할 수 있었습니다.
GS SHOP 검색추천팀은 이번 프로젝트 결과를 기반으로 다음 단계의 고도화를 진행하고 있습니다.
Team A는 Reranking 개선을 통해 자연어 검색 품질 향상을 추진하고 있으며, Team B는 검증된 실험 구조를 바탕으로 실제 서비스 적용을 위한 게이트웨이 연동과 온라인 검증을 준비하고 있습니다. 또한 이번 AI-DLC와 Kiro 적용 경험을 바탕으로 GS리테일 내 다양한 조직에서 AI 기반 개발 방식을 확대 적용하는 방안도 검토하고 있습니다.
GS SHOP 검색추천팀에 남은 것은 3일간의 결과물만이 아니었습니다. 문제를 체계적으로 정의하고, 빠르게 실험하고, 그 결과로 다음을 결정하는 흐름이 팀의 일하는 순서로 자리 잡았습니다. AI-DLC가 바꾼 것은 개발 속도가 아니라 개발하는 방식이었습니다.
추가 참고 자료
- GS리테일 AX블로그 – AI-DLC 사례 1(검색): AI-DLC로 3일, 뷰티 자연어 검색을 만드는 여정
- GS리테일 AX블로그 – AI-DLC 사례 2(추천): AI로 코딩은 빨라졌는데, 왜 실험은 여전히 어려웠을까?