AWS 기술 블로그
Amazon MSK Express Broker에서 Kafka 트랜잭션 워크로드를 최적화하는 방법
Amazon MSK Express 브로커는 Kafka 클러스터 운영의 복잡성을 크게 줄입니다. 스토리지를 별도로 프로비저닝하거나 용량을 예측할 필요가 없고, 복제 계수(RF=3)와 최소 ISR(minISR=2)이 고정되어 있어 잘못된 복제 설정으로 인한 문제를 원천적으로 방지할 수 있습니다. KRaft 모드로 생성하면(Kafka 3.9 이상) ZooKeeper 관리 부담도 사라집니다.
사이징도 단순해집니다. 인스턴스 타입별 처리량 기준선 (sustained ingress/egress)이 문서에 숫자로 공개되어 있어, 필요한 처리량을 해당 숫자로 나누면 브로커 대수가 나옵니다. Kafka 트랜잭션을 사용하지 않는 워크로드라면 이 계산은 실제로 성립합니다.
그런데 Kafka 트랜잭션을 사용하는 순간, 이 단순한 공식은 적용되지 않습니다. express.m7g.2xlarge 3대 클러스터(sustained ingress 187.5 MB/s)에서 측정한 결과, 트랜잭션 한 건에 10개 레코드를 담아 커밋하는 워크로드는 120.5 MB/s, 네트워크 기준선의 64%에서 처리량이 멈췄습니다. 그 지점에서 브로커 CPU는 44%, 클라이언트 CPU는 5%였고, 브로커 네트워크 스로틀링도 발생하지 않았습니다. 프로듀서를 48개에서 96개로 두 배 늘려도 처리량은 123.8 → 120.5 MB/s로 늘지 않았습니다. 더 작은 인스턴스에서 레코드를 5개씩 묶는 극단적인 경우에는 sustained 기준선의 18%(일반 전송 실측 대비 12%)밖에 쓰지 못했습니다.
이 글에서는 Kafka 트랜잭션이 브로커에 추가하는 작업을 단계별로 살펴보고, 트랜잭션 워크로드의 처리량 상한을 계산하는 식을 세운 뒤, 그 식의 어느 항이 실제로 워크로드를 제약하는지 판별하는 방법을 설명합니다. 이어서 프로듀서·컨슈머·클러스터 각 계층에서 어떤 순서로 무엇을 조정해야 하는지, 그리고 그 조정을 검증하기 위한 측정 방법을 다룹니다.
이 글의 모든 수치는 특정 조건에서 측정한 값이며 메시지 크기, 파티션 수, 트랜잭션 단위, 클라이언트 구성이 다르면 값은 달라질 수 있습니다. 이 블로그의 목적은 테스트 결과 보다 병목이 어디서 발생하는지를 판별하고 상황에 맞게 최적화 하는 방법을 소개하는데 있습니다.
Kafka 트랜잭션의 보장 범위, 그리고 Express 브로커 특성
트랜잭션은 두 가지를 보장합니다
기본 설정의 Kafka 프로듀서는 at-least-once를 보장합니다. 네트워크 오류로 응답을 받지 못해 재시도하면 같은 레코드가 두 번 기록될 수 있습니다. enable.idempotence=true (Kafka 3.0 이상 기본값) 설정은 프로듀서 세션 안에서 재시도로 인한 중복을 막아 주지만, 트랜잭션은 그보다 더 큰 범위의 두 가지를 보장합니다.
- 여러 파티션·여러 토픽에 걸친 원자적 쓰기. 예를 들어, 주문 이벤트를 orders 와 order-audit 두 토픽에 쓸 때, 둘 다 저장되거나 둘 다 저장되지 않습니다.
- read-process-write (exactly-once semantics) 패턴. 컨슈머 오프셋 커밋을 프로듀서 트랜잭션에 포함시켜( sendOffsetsToTransaction ), 읽고 처리해서 쓰는 파이프라인을 정확히 한 번 수행합니다. Kafka Streams의 processing.guarantee=exactly_once_v2 가 내부적으로 사용하는 방식입니다.
이 보장을 위해 Kafka는 다음 요소를 사용합니다.
| 요소 | 역할 |
|---|---|
| transactional.id | 프로듀서의 논리적 ID. 재시작 후 이전 세션의 미완료 트랜잭션을 정리(fencing)하는 기준입니다. |
| Producer epoch | 같은 transactional.id 의 새 인스턴스가 등장하면 epoch가 올라가고 이전 인스턴스의 쓰기는 거부됩니다. |
| Transaction Coordinator | 트랜잭션 상태를 관리하는 브로커 측 컴포넌트. transactional.id 가 어느 코디네이터에 매핑되는지는 해시로 결정됩니다. |
| __transaction_state | 코디네이터가 트랜잭션 상태를 기록하는 내부 토픽. 기본 50 파티션. 커밋 경로에서 복제 ack 대기가 발생하는 지점입니다. |
| Control record (커밋 마커) | 트랜잭션 종료 시 참여한 모든 데이터 파티션에 기록되는 특수 레코드. 컨슈머가 커밋 여부를 판별하는 근거입니다. |
| isolation.level=read_committed | 컨슈머가 커밋된 트랜잭션만 읽습니다. LSO(Last Stable Offset) 이후는 노출되지 않습니다. |
표1. Kafka 트랜잭션을 구성하는 요소
커밋 경로에는 고정 비용이 발생합니다
성능을 이해하려면 커밋 경로를 단계로 분해해 볼 필요가 있습니다.
- initTransactions() : 코디네이터를 찾고 epoch를 확보합니다. 프로듀서 인스턴스 시작 시 호출됩니다.
- beginTransaction() : 코디네이터와의 통신 없이, 프로듀서 로컬 상태를 “트랜잭션 진행 중”으로 기록 합니다. 이후 send() 로 보내는 레코드들이 이 트랜잭션에 묶입니다.
- AddPartitionsToTxn 호출 : send() 호출 시, 레코드가 새 파티션으로 향할 때 내부적으로 프로듀서가 코디네이터에게 보내는 요청으로, “이 파티션이 현재 트랜잭션에 참여한다”고 등록합니다. 코디네이터는 이를 __transaction_state 에 기록하고 복제 ack를 기다립니다.
- Produce : 데이터 파티션에 기록합니다. 트랜잭션에서는 acks=all 이 강제되므로 여기서도 복제 ack를 기다립니다.
- commitTransaction()
- PREPARE_COMMIT 을 __transaction_state 에 기록 → 복제 ack 대기
- 참여한 모든 데이터 파티션에 control record 기록 → 복제 ack 대기
- COMPLETE_COMMIT 을 __transaction_state 에 기록 → 복제 ack 대기
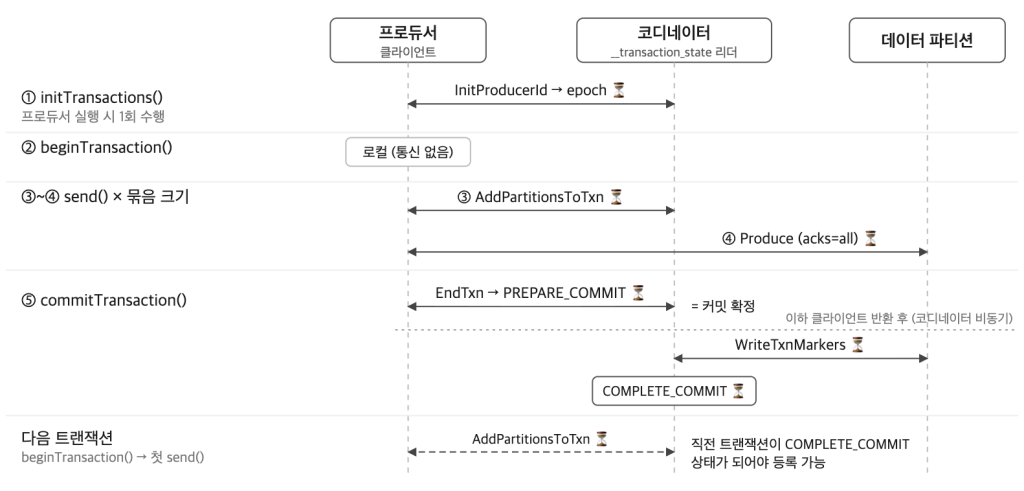

그림1. Kafka 트랜잭션 처리 순서
따라서, 커밋 경로를 이렇게 풀어보면 성능을 결정하는 요소를 확인할 수 있습니다.
첫째, 커밋 경로는 복제왕복을 여러 번 하는 고정 비용입니다. 하나의 트랜잭션에 레코드가 10개 들었든 200개 들었든 왕복 횟수는 같습니다. 그리고 이 지연은 파티션 수를 24개에서 1개로 줄여도, 브로커 크기를 2배로 교체해도 유의미하게 움직이지 않았습니다. 코디네이터가 부하를 받지 않는 구간에서 여러번 테스트를 통한 측정에서 클러스터,메세지 크기,동시성에 따라 약 40~65 ms 범위에 머물렀고, 파티션 수와 브로커를 교체해도 크게 변화가 없었습니다. 즉, 코디네이터 왕복과 __transaction_state 복제 ack 대기로 인한 시간입니다.
| 조건 | 커밋 1회에 걸린 시간 | |
|---|---|---|
| P50 | P99 | |
| 메시지를 24개 파티션에 분산 | 53.1 ms | 57.5 ms |
| 메시지를 1개 파티션에만 집중 | 55.6 ms | 57.2 ms |
| 브로커를 4xlarge 로 교체 | 55.9 ms | 58.9 ms |
표2. 파티션,브로커별 커밋 시간 측정( express.m7g.2xlarge x 3 / 10KiB 메시지/ 프로듀서 1개 )
둘째, commitTransaction() 은 동기 호출입니다. 프로듀서는 커밋이 끝날 때까지 블록됩니다. 고정 비용을 동기로 호출하는 두 요소를 결합하면 프로듀서 하나의 처리량 을 계산해볼 수 있습니다.
프로듀서 1개의 처리량 = 트랜잭션 묶음 크기 ÷ 커밋 지연 시간
아래 테스트 결과를 통해 보다 자세히 확인이 가능합니다.
| 트랜잭션 묶음 크기 | 실측 처리량 | 커밋 지연 p50 | 이론값 (크기÷지연) |
실측/이론 |
|---|---|---|---|---|
| 10건 | 190 rec/s (1.9 MB/s) | 58.5 ms | 171 | 1.11배 |
| 50건 | 746 rec/s (7.6 MB/s) | 67.8 ms | 738 | 1.01배 |
| 200건 | 2,073 rec/s (21.2 MB/s) | 97.8 ms | 2,046 | 1.01배 |
| 트랜잭션 미사용 | 12,216 rec/s (125.1 MB/s) | — | — | — |
표3. 트랜잭션 묶음 별 성능 ( express.m7g.2xlarge x 3 / 10KiB 메시지 / 프로듀서 1개 )
실측이 이론값의 0.97~1.10배 범위에 들어옵니다. 그리고 마지막 행이 이 글의 출발점을 설명합니다. 동일한 프로듀서가 트랜잭션 없이 보낼 때는 102.5 MB/s를 내지만, 10건 묶음 트랜잭션으로 전환하면 2.0 MB/s로 줄어듭니다. 약 50배 차이입니다.
트랜잭션 처리량의 상한 계산
앞 절의 관찰 내용을 통해, 브로커 수를 결정할 수 있는 형태로 정리하면 다음과 같습니다. 트랜잭션 워크로드에서 안정적으로 운영할 수 있는 처리량은 세 가지 값 중 가장 낮은 값으로 정합니다. ( 네트워크 한도는 max quota 까지 처리할 수 있지만, 성능 저하가 발생할 수 있으므로 사이징 기준으로 삼지 않습니다. )
- ① 은 문서 에서 바로 읽을 수 있습니다. 인스턴스 타입별 sustained ingress에 브로커 수를 곱합니다. 트랜잭션을 쓰지 않는 워크로드라면 사실상 이것만 보면 됩니다.
- ② 는 직접 측정해야만 알 수 있습니다. 클러스터가 초당 처리할 수 있는 커밋 수는 문서에 나와 있지 않습니다. 다만 한 번 측정해 두면, 묶음 크기를 바꿨을 때의 처리량을 미리 예측하는 기준점으로 활용할 수 있습니다. commits/s는 두 가지 방법으로 측정할 수 있습니다.
- 방법 A — 클라이언트 계측 : 트랜잭션 프로듀서에서 성공한 commitTransaction() 횟수를 카운트해 경과 시간으로 나눕니다.
- 방법 B — 브로커 JMX : 커밋 1회는 코디네이터로 EndTxn 요청 1회를 보내므로, 브로커의 EndTxn 요청 rate가 곧 클러스터의 commits/s입니다.
- ③ 은 애플리케이션이 결정합니다. 앞 절의 묶음 크기 ÷ 커밋 지연 에 동시 프로듀서 수를 곱한 값입니다.
②와 ③에 묶음 크기가 곱으로 들어간다는 점이 핵심입니다. 묶음을 키우면 두 항이 동시에 커지므로, 어느 지점부터는 ①이 최소값이 됩니다.
테스트를 통해 식 1)을 검증합니다
테스트 환경은 아래와 같습니다.
- 브로커 타입
- Express.m7g.2xlarge x 3
- 버전
- KRaft 3.9.x
- 클라이언트
- c7i.2xlarge x 2 ( EC2 네트워크 baseline 3.125Gbps )
- 토픽
- 파티션 36개, Replication Factor=3
- 메시지
- 10KiB, acks=all, compression=none
| 묶음 크기 |
① 네트워크 (MB/s) |
② 코디네이터 (MB/s) |
제약 | CloudWatch BytesInPerSec 1분 평균(MB/s) |
Sustained 대비 |
|---|---|---|---|---|---|
| 10건 | 187.5 | 120.9 | ② | 123 | 65.6% |
| 25건 | 187.5 | 147.1 | ② | 142.7 | 76.1% |
| 50건 | 187.5 | 172.1 | ② | 164.9 | 88% |
| 100건 | 187.5 | 190.6 | ① | 185 | 98.7% |
| 200건 | 187.5 | 200.9 | ① | 196 | 104.5% |
표4. 트랜잭션 묶음 별 병목
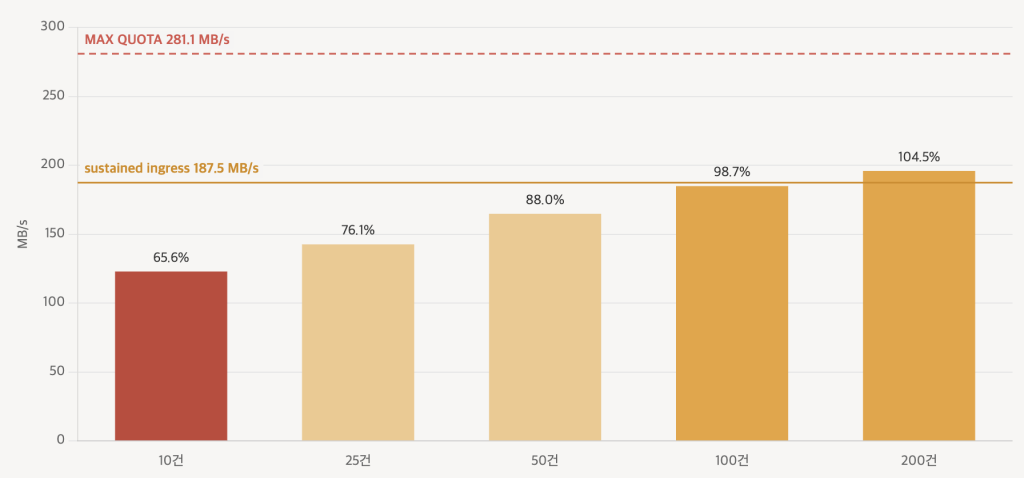

그림 2. 트랜잭션 묶음 크기 별 성능
② 코디네이터 한도는 묶음 크기마다 프로듀서 개수를 2배씩 증가시키며 commits/s 가 더 오르지 않는 지점에서 측정한 값으로 계산했습니다. 따라서, 코디네이터 한도는 CloudWatch Metric 값과 거의 일치합니다. 이 테스트에서 의미가 있는 것은 어느 항을 사이징 기준으로 삼을 것인가 입니다. 묶음 크기가 커질 수록 초당 커밋 수는 줄어들지만, 커밋 하나에 실리는 데이터가 늘어납니다. 따라서, 50건 까지는 네트워크에 여유가 있어도 코디네이터가 처리량을 정하고, 100건 부터는 Sustained 네트워크 기준선이 사이징 상한이 됩니다.
같은 식을 express.m7g.4xlarge × 3(sustained 374.7 MB/s)에서도 측정을 했습니다.
| 인스턴스 | 묶음 크기 | ① 네트워크 (MB/s) |
② 코디네이터 (MB/s) |
제약 | CloudWatch BytesInPerSec 1분 평균 -MB/s (Sustained 대비 %) |
|---|---|---|---|---|---|
| 2xlarge × 3 | 10건 | 187.5 | 120.9 | ② | 123 (65%) |
| 4xlarge × 3 | 10건 | 374.7 | 173.9 | ② | 161.9 (43%) |
| 2xlarge × 3 | 200건 | 187.5 | 200.9 | ① | 196 (104.5%) |
| 4xlarge × 3 | 200건 | 374.7 | 312.3 | ② | 305 (81.4%) |
표5. 인스턴스 / 트랜잭션 묶음 별 병목
묶음이 작은 구간에서는 두 클러스터 모두 ②에 걸리고, 큰 구간에서는 2xlarge 는 ①에 걸렸지만, 4xlarge 는 여전히 ②에 걸립니다. 즉, 트랜잭션 워크로드에서는 네트워크 기준선만 보고 scale up 효과를 예상하면 예측치가 틀릴 수 있으며, 이 차이는 뒤에서 다룰 scale out과 scale up의 선택을 결정합니다.
표 4에서 25건과 50건 행에서 실측이 sustained ingress 대비 77~90%에 머문 점에 주의하십시오. 두 구간에서는 어느 하나의 요소에만 제한되지 않고, ①과 ② 모두 처리량에 영향을 미칩니다. RightSizing 을 위한 블로그 가 이론 한도의 80%를 프로덕션 목표로 권장하는 것과 같은 이유로, 식 1) 은 초기 사이징의 출발점이며 실측으로 보정해야 합니다.
어느 항이 병목인지 진단하세요
식 1) 의 실용적 가치는 사이징 계산보다 진단에 있습니다. 처리량이 목표에 미달할 때, 어느 항이 병목인지에 따라 대응 방법이 완전히 달라집니다.
| 현상 | 병목 | 해야 할 일 |
|---|---|---|
| BytesInPerSec 가 sustained 기준선 근처, CPU 60% 근처 | ① 네트워크 | 클러스터 확장 (묶음이 크면 scale up) |
| 네트워크 / CPU 모두 여유, 프로듀서를 늘려도 처리량 무변화, 커밋 지연 증가 | ② 코디네이터 | 묶음 크기 확대 → 코디네이터 파티션 분산 → scale out |
| 네트워크 / CPU 모두 여유, 프로듀서를 늘리면 처리량 증가, 커밋 지연 안정 | ③ 클라이언트 | 프로듀서( transactional.id ) 추가 |
표6. 현상에 따른 병목과 해결 방안
②와 ③을 구분하는 방법은 프로듀서 수를 두 배로 늘려보는 것입니다. 처리량이 오르면 ③, 오르지 않으면 ②입니다. 프로듀서를 48 → 96개로 늘리는 테스트를 수행 시, 처리량이 123.8 → 120.5 MB/s로 변동이 없었고, 그때 클라이언트 CPU는 4.9%였습니다. 이로써 ② 코디네이터가 병목임을 확인할 수 있습니다.
트랜잭션 워크로드 병목의 원인
앞 절에서 ② 코디네이터가 병목이라는 것을 확인했습니다. 이 절에서는 해당 식을 좀 더 자세히 확인해보겠습니다. 여기서 나오는 분석 결과가 뒤이어 다룰 처방의 순서를 결정합니다.
CPU도 네트워크도 클라이언트도 아닙니다
| 자원 | 사용률 | 한계까지 여유 |
|---|---|---|
| 네트워크 ingress | 120.5 / 187.5 MB/s | 64% (max quota 281.1 대비 43%) |
| 브로커 CPU ( CpuUser + CpuSystem ) | 44.2% | AWS 권장 상한 60% 미달 |
| 클라이언트 CPU | 4.9% | 유휴 |
세 자원 모두 여유가 있습니다. 후보를 하나씩 배제해 보겠습니다.
브로커 CPU 는 원인이 아닙니다. CPU가 병목이라면 처리량이 멈춘 지점에서 상한에 닿아야 하지만 44%에 머물렀습니다. 더 결정적인 것은 CPU가 처리량이 낮을 수록 CPU 가 오히려 더 높다는 점입니다.
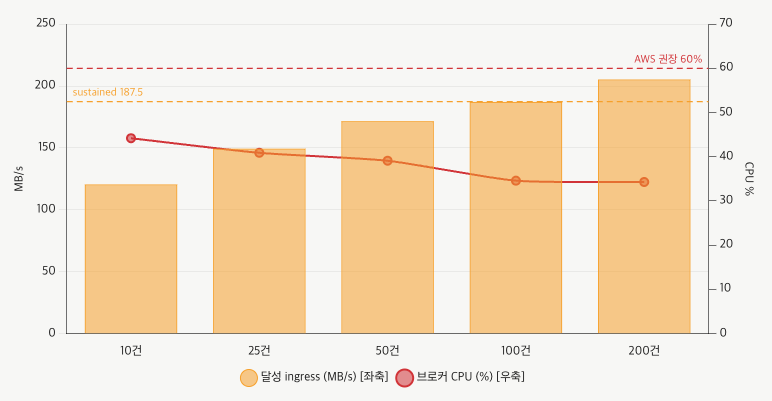

그림 3. 트랜잭션 묶음별 Network ingress 와 브로커 CPU 사용률 ( express.m7g.2xlarge x 3 / 10KiB 메시지 )
처리량이 낮은 쪽이 CPU를 더 씁니다. 커밋 처리 자체가 CPU를 소모하고, 묶음이 작으면 같은 바이트를 보내기 위해 커밋을 더 많이 하기 때문입니다.
다만, 동일 처리량 기준으로는 트랜잭션이 CPU를 확실히 더 씁니다. 10건 묶음은 120.5 MB/s에서 이미 막히므로, 187 MB/s 지점에서 비교할 수 있는 것은 100건 묶음과 트랜잭션 미사용뿐입니다. 이 지점에서 트랜잭션(100건 묶음)은 34.6%, 트랜잭션 미사용은 25.3%로 1.37배입니다. 따라서, 브로커 사이즈 선택 시 트랜잭션 사용에 따른 CPU 증가분을 추가로 고려해야 합니다.
실제 원인은 복제 ack 왕복을 동기적으로 기다리는 구조입니다
테스트 결과를 정리하면 아래와 같습니다.
| 자원 대상 | 근거 |
|---|---|
| 브로커 CPU | 처리량이 멈춘 지점에서 44%. 처리량과 반비례 |
| 네트워크 | sustained의 64%, max quota의 43%, 스로틀링 없음 |
| 클라이언트 | 프로듀서 2배(48→96)에 처리량 무변화, 클라이언트 CPU 4.9% |
| 파티션 증가 | 참여 파티션 1개(54.6 ms)와 10개(56.6 ms)의 커밋 지연 차이 없음 |
| 브로커 크기 | 2배 크기 교체 후에도 커밋 1회 지연 55.5 → 57.1 ms |
| 최종 원인 | 코디네이터 왕복 + __transaction_state 복제 ack 대기 |
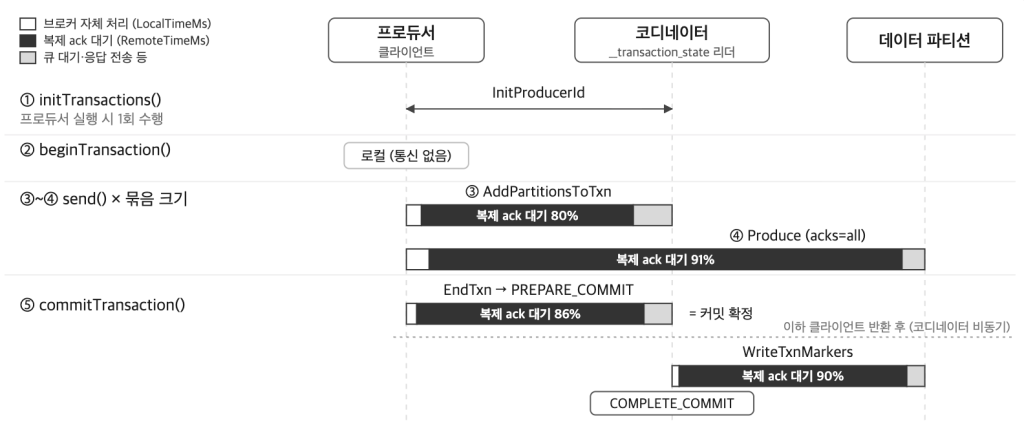

그림 4. 트랜잭션 처리별 ack 대기 비율( JMX Metric 측정 – TotalTimeMs, LocalTimeMs, RemoteTimeMs 평균값 기준 )
커밋을 수행하는 주 API 인 EndTxn, WriteTxnMarkers 의 처리 시간 85~90%가 RemoteTimeMs (복제 ack 대기) 였고, 클라이언트 커밋 지연 전체에서 브로커가 차지하는 비중은 5~20%에 불과했습니다. 브로커는 복제 응답을 기다리고 있고, 클라이언트는 그 대기를 기다리고 있습니다. 자원을 더 투입해도 확장되지 않는 이유입니다.
성능·비용 최적화를 위한 조정 방안
지금까지의 진단을 최적화를 수행합니다. 아래 순서로 권장합니다. 뒤쪽 항목일수록 비용이 들고, 앞쪽 항목을 먼저 시도하지 않으면 그 비용 대비 효과를 충분히 얻기 어렵습니다.
트랜잭션 묶음을 키워 커밋 고정비용을 분산하세요
가장 먼저 시도할 대상이며, 효과가 가장 크고 비용이 들지 않습니다. 커밋 비용은 데이터 양과 무관하게 일정하므로, 한 번의 커밋에 더 많은 레코드를 담으면 레코드당 고정비용이 그만큼 줄어듭니다.
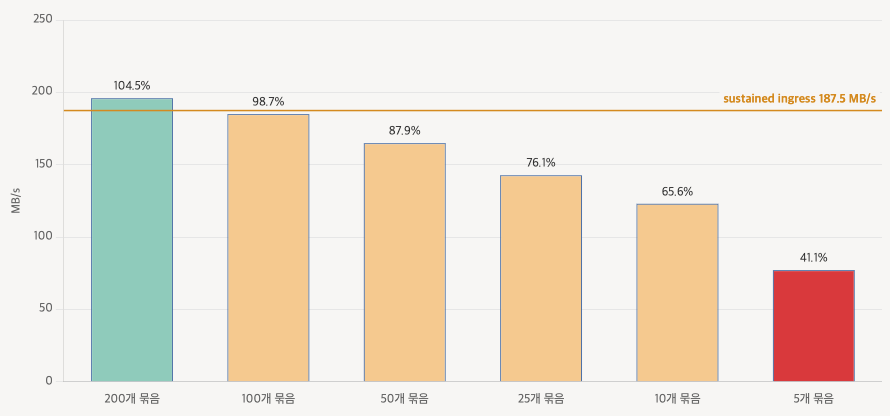

그림 5. 트랜잭션 묶음 크기 별 sustained 기준 대비 Network 처리 비율
( express.m7g.2xlarge x 3 / 10KiB 메시지 / 묶음크기별 최대 성능 프로듀서 수 기준 )
다만 묶음 크기를 키우는 데는 다음과 같은 트레이드 오프가 발생합니다.
- 커밋 1건 당 지연 시간이 길어집니다.
- read_committed 컨슈머의 end-to-end 지연이 커집니다. 커밋 전 레코드는 컨슈머에게 보이지 않으므로, 프로듀서의 묶음 크기 결정이 컨슈머의 지연을 발생 시킬 수 있습니다.
- 실패 시 재처리 범위가 넓어집니다. 200건 트랜잭션이 실패하면 200건을 다시 처리합니다.
- 업무 단위와 충돌할 수 있습니다. “주문 1건 = 트랜잭션 1건”처럼 경계가 업무적으로 고정된 경우 임의로 늘릴 수 없습니다.
프로듀서를 조정하면서 최고점을 찾으세요
commitTransaction() 이 동기방식으로 동작하므로, 프로듀서가 커밋 응답을 기다리는 동안 다른 프로듀서가 데이터를 전송하게 하려면 여러 프로듀서를 병렬로 돌려야 합니다. 식 1) 의 ③ 항을 키우는 작업입니다. 효과가 있지만 최고점이 존재하고, 그 지점을 넘으면 처리량이 감소합니다.
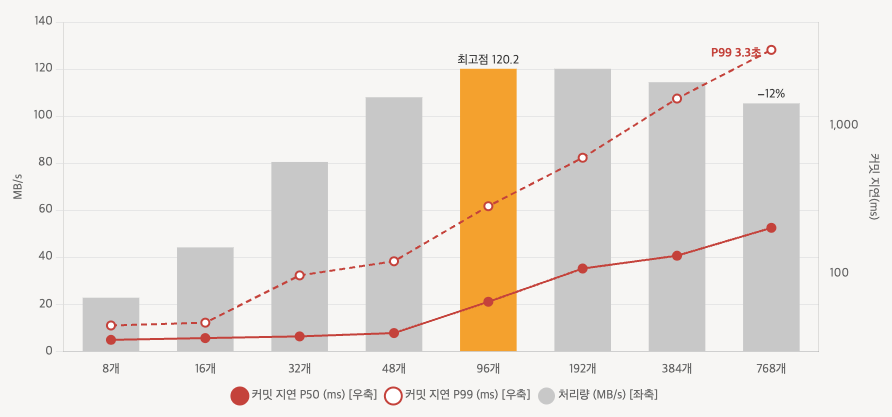

그림 6. 프로듀서 개수 별 처리량과 커밋 지연시간 ( express.m7g.2xlarge x 3, 10KiB 메시지, 묶음 크기 10 )
메커니즘은 식 1) 로 설명됩니다. 프로듀서를 늘리면 ③이 커지지만, 코디네이터에 도착하는 커밋 요청이 ② 한도를 넘어서면서 큐 대기가 커밋 지연으로 전가됩니다. 커밋 지연이 길어질수록 프로듀서 하나가 내는 처리량( 묶음 크기 ÷ 커밋 지연 )은 낮아져, 프로듀서 수를 늘린 만큼의 효과를 얻지 못하게 됩니다. 96개 지점부터 처리량은 줄지만, P50, P99 커밋 지연은 지속적으로 늘어나는 것을 확인할 수 있습니다.
따라서 프로듀서 개수는 무조건 늘릴 것이 아니라, 실측을 통해 최적값을 찾아야 합니다. 그리고 메시지 전송 응답시간 목표치가 있다면, 처리량이 가장 높은 지점이더라도 그 시점의 커밋 지연이 SLO를 넘을 수 있습니다. 위 표에서 최고점인 96개 지점의 P50 커밋 지연은 65ms이므로, 응답시간 목표치에 따라 프로듀서 수를 그보다 적게 유지해야 할 수 있습니다. 프로듀서 수를 늘려도 처리량이 오르지 않는 지점에 도달했다면, 그것이 ② 코디네이터 한도이며 다음 두 항목으로 넘어갈 신호입니다.
컨슈머의 isolation level은 성능에 영향을 미치지 않습니다
컨슈머는 read_committed 에서 커밋 마커를 필터링하고 LSO 이후를 노출하지 않으므로 비용이 있을 것으로 예상할 수 있습니다. 하지만, 테스트 결과는 그렇지 않았습니다.
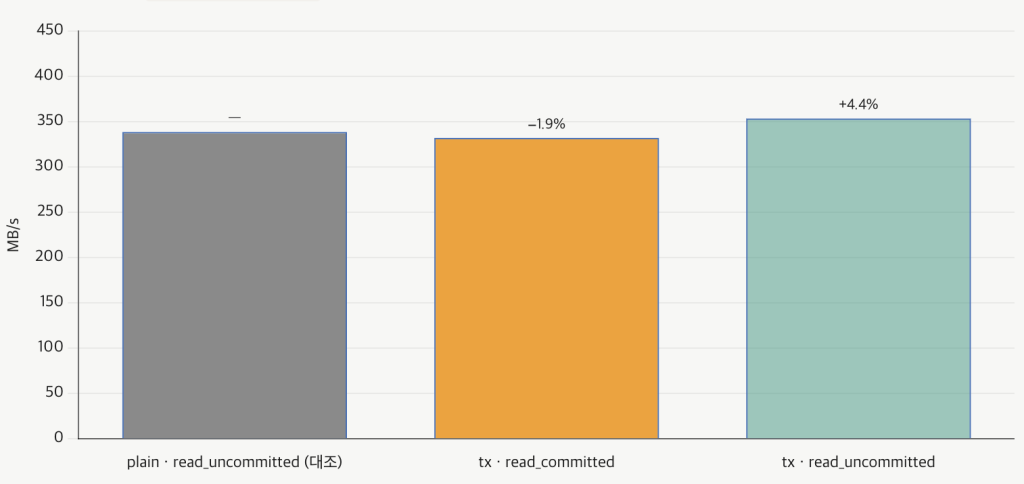

그림 7. Consumer isolation level 별 처리량( express.m7g.2xlarge x 3 / 10KiB 메시지, 컨슈머 1대 )
트랜잭션 비용은 프로듀서와 커밋 경로에 집중되며, 컨슈머 측 처리량은 거의 영향받지 않습니다. 정확성이 필요하다면 read_committed를 주저 없이 사용하고, 성능 개선 노력은 프로듀서 경로에 집중하십시오.
단, 처리량과 별개로 지연 특성은 달라집니다. read_committed 컨슈머는 트랜잭션이 커밋될 때까지 레코드를 볼 수 없으므로, 앞서 다룬 묶음 크기 결정이 여기에 직접 반영됩니다. 프로듀서 팀과 컨슈머 팀이 이 트레이드오프를 함께 인지하고 있어야 합니다.
코디네이터 파티션을 분산해 scale out 이득을 확보하세요
브로커를 추가했다면 확인해볼 수 있는 항목입니다.
코디네이터 파티션은 브로커가 확장되더라도 기존 브로커에 그대로 몰려 있기 때문에, ② 항이 개선되지 않습니다. Express Broker 의 경우 Intelligent Rebalancing 가 기본값으로 설정되어 있기 때문에, 이를 PAUSED 로 바꾸고 kafka-reassign-partitions.sh 를 활용하여 __transaction_state 를 분산하십시오. Scale out 을 통한 성능상의 이점을 얻을 수가 있습니다.
express.m7g.2xlarge × 3 를 생성하면 __transaction_state 50개 파티션이 3대에 고르게(17/16/17) 분산되어 생성됩니다. 여기서 6대로, 그리고 별도 테스트에서 9대로 확장한 뒤 브로커 대수는 고정한 채 __transaction_state 토픽만 원래 3대에 집중된 상태 vs 전 브로커에 분산한 상태를 비교했습니다.
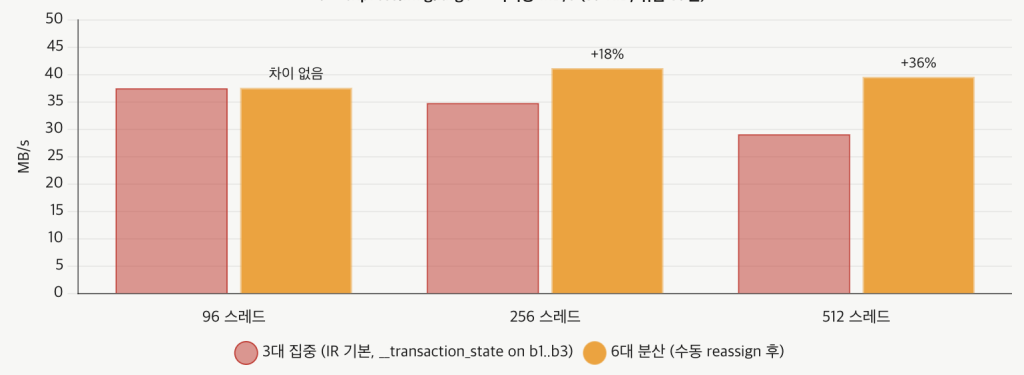

그림 8. __transaction_state 파티션 분산에 따른 네트워크 처리량-1 (express.m7g.large x 6, 10KiB 메시지, 트랜잭션 10묶음 )
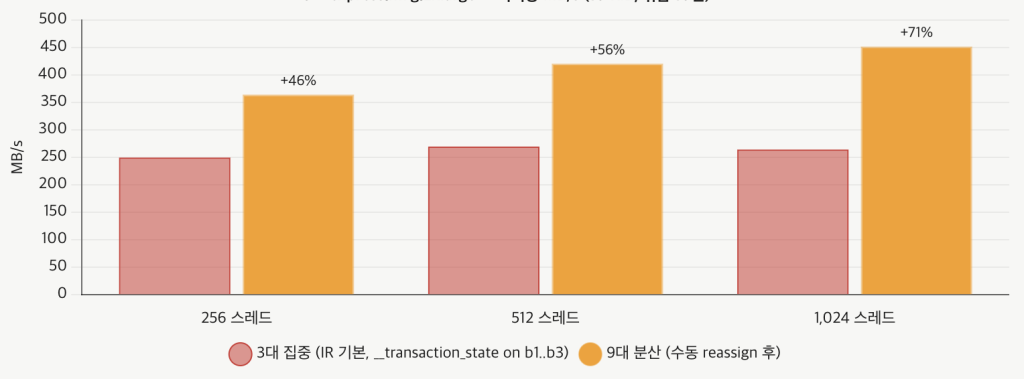

그림 9. __transaction_state 파티션 분산에 따른 네트워크 처리량-2 (express.m7g.2xlarge x 9, 10KiB 메시지, 트랜잭션 10묶음 )
두 테스트의 패턴은 같습니다. 동시 프로듀서가 적어 코디네이터가 부하가 크지 않는 구간에서는 성능의 유의미한 차이는 없습니다. 그러나 동시성을 높여 코디네이터에 충분한 부하가 들어가면, 파티션이 3대에 집중된 경우 처리량은 정체되고 커밋 지연은 길어지는 반면, 전 브로커에 고르게 분산한 경우에는 처리량이 계속 늘어납니다. 손실은 부하가 클수록 커져 9대에서는 최대 71%에 달했습니다. 즉 scale out 후 __transaction_state 를 재배치하지 않으면 브로커는 늘렸지만 코디네이터는 여전히 3대만 일해, 고부하 트랜잭션 처리량의 상당분을 잃습니다. (저부하에서는 재배치하지 않아도 성능저하가 크게 없습니다.)
참고로 목표 대수를 처음부터 알고 있다면 그 대수로 클러스터를 생성하는 것이 좋습니다. __transaction_state 는 첫 트랜잭션 시점에 존재하는 전 브로커에 분산 생성되므로, 확장 후 수동 재배치가 아예 불필요해집니다.
묶음 크기에 따라 scale out과 scale up을 선택하세요
앞의 항목들을 다 고려했음에도 목표에 미달한다면 클러스터를 조정합니다. 여기서 어느 방향이 유리한지가 트랜잭션 묶음 크기에 따라 결정합니다. 동일 비용(2배) 조건의 실측입니다.
| 묶음 크기 | scale out (2xl×3 → 2xl×6) |
scale up (2xl×3 → 4xl×3) |
권장 |
|---|---|---|---|
| 10건 | 1.67배 (효율 84%) | 1.33배 (효율 68%) | scale out |
| 200건 | 1.14배 (효율 57%) | 1.57배 (효율 79%) | scale up |

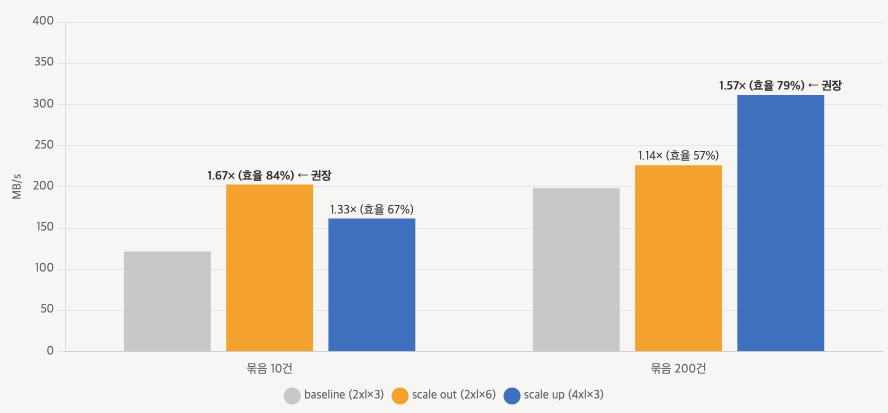
그림 10. 트랜잭션 묶음 크기 별 Scale Out / Scale Up 성능 비교
묶음 크기에 따라 식 1) 에서 어느 항이 병목이 되는지가 달라지기 때문입니다.
- 묶음이 크면 ① 네트워크가 병목입니다. 커밋 횟수가 적고 트랜잭션당 데이터가 많으므로 브로커당 대역폭을 키우는 것이 맞습니다.
- 묶음이 작으면 ② 코디네이터가 병목입니다. __transaction_state 파티션이 더 많은 브로커에 분산되면 초당 커밋 처리 총량이 늘어납니다. 대수를 늘리는 것이 직접적입니다.
Scale up의 성격을 좀 더 풀어 보겠습니다.
| 인스턴스 | 묶음 크기 | 프로듀서 | 달성 처리량 | sustained 대비 | 커밋 p50 |
|---|---|---|---|---|---|
| 2xlarge × 3 | 10 | 96 | 121.5 MB/s | 65% | 94.8 ms |
| 4xlarge × 3 | 10 | 96 | 161.9 MB/s (1.33배) | 43% | 58.1 ms |
| 2xlarge × 3 | 200 | 24 | 198.5 MB/s | 106% | 251.4 ms |
| 4xlarge × 3 | 200 | 24 | 310.8 MB/s (1.57배) | 83% | 388.2 ms |
scale up은 프로듀서 1개를 빠르게 만드는 것이 아니라, 동시에 받아줄 수 있는 커밋 처리 총량을 늘리는 것입니다. 위 테스트에서 초당 커밋 처리(Commits/sec) 최고치는 약 477회에서 약 820~990회로 늘었습니다. 따라서 scale up의 이득은 늘어난 용량을 채울 만큼 프로듀서가 충분할 때만 실효성이 있습니다.
따라서, 클러스터 확장(Scale Up / Scale Out)은 묶음 크기와 프로듀서 개수를 먼저 조정해 현재 클러스터에서 최대한의 성능을 확인한 후에 검토하는 것이 좋습니다. 순서를 바꾸면 확장 비용을 지불하고도 기대한 효과를 얻기 어렵습니다.
클러스터 지표 외에 클라이언트, 커밋 지표도 함께 모니터링하세요
트랜잭션 워크로드는 낮은 CPU 사용률에서도 처리량이 한계에 도달할 수 있으므로, CPU 기반 알람은 병목을 놓칠 수 있습니다.
| 목적 | 지표 | 모니터링 지표 |
|---|---|---|
| ① 네트워크 한도 접근 | BytesInPerSec , BytesOutPerSec | CloudWatch – AWS/Kafka |
| 파티션 한도 | PartitionCount | CloudWatch – AWS/Kafka |
| CPU 헤드룸 (60% 미만 권장) | CpuUser + CpuSystem | CloudWatch – AWS/Kafka |
| 브로커 실제 처리 시간 | ProduceLocalTimeMsMean | CloudWatch – AWS/Kafka |
| ② 코디네이터 한도 접근 | 초당 커밋 수, 커밋 지연 p50/p99 | 애플리케이션 계측 |
| 클라이언트가 병목이 아님 확인 | 클라이언트 CPU·네트워크 | 사용자 정의 |
커밋 수와 지연에 대한 지표는 CloudWatch에 없습니다. 애플리케이션에서 commitTransaction() 호출 시간을 직접 계측해 내보내야 합니다. 이 값이 없으면 코디네이터 한도에 접근하고 있는지 알 수 없고, 처리량 저하의 원인을 진단할 수 없습니다.
결론
클러스터를 먼저 구성하고 성능을 확인하는 대신, 필요한 성능 요건을 먼저 정의한 뒤 그에 맞는 클러스터 구성을 찾아가는 방식을 권장합니다.
1. 성능 요건을 구체적인 숫자로 정의하세요.
트랜잭션 워크로드는 MB/s 하나만으로는 충분하지 않습니다. 처리량, 응답 시간, 그리고 트랜잭션 단위까지 함께 정의해 두어야 이후 단계에서 올바른 기준으로 판단할 수 있습니다.
세 번째 조건(트랜잭션 단위)이 가장 중요합니다. 이 블로그에서 가장 효과적인 튜닝은 묶음 크기를 조정하는 것인데, 묶음 크기를 조정한다는 것은 곧 트랜잭션 단위를 바꾸는 것이기 때문입니다. 트랜잭션 단위가 업무 요건상 고정이라면, 브로커 확장에 더 의존해야 합니다.
2. 식 1) 을 활용해 초기 클러스터 규모를 추정하세요.
네트워크 한도는 공식 문서를 통해 확인 가능하며, 코디네이터 한도와 클라이언트 한도는 애플리케이션의 묶음 크기와 프로듀서 수로 계산합니다. 세 값 중 최소값이 트랜잭션을 처리하는 클러스터의 상한이며, 프로덕션 목표는 그 값의 80% 수준으로 권장합니다.
3. 실제 애플리케이션의 트랜잭션 패턴으로 측정하세요.
표준 벤치마크 도구는 트랜잭션 묶음 크기를 고정하지 못하거나 트랜잭션을 쓰지 않습니다. 따라서, 측정할 시 실제 트랜잭션의 묶음 크기를 출력해 확인하고, 프로듀서를 두 배로 늘려 클라이언트가 병목이 아님을 확인하세요.
4. 어느 항이 제약하는지 판별한 뒤, 순서대로 조정하세요.
묶음 크기 조정 (비용 0, 효과 최대) → 프로듀서 개수(최고점 탐색) → 클러스터 확장(Scale Up / Scale Out 은 묶음 크기로 결정) → Scale Out 시 코디네이터 파티션 분산. scale up 의 이득은 늘어난 커밋 처리 용량을 채울 프로듀서가 있을 때만 실현되므로, 순서를 뒤집으면 비용만 늘어납니다. 축소는 지원되지만(지능형 리밸런싱 Active 시 AZ당 1대씩) 확장보다 제약이 많다는 점도 함께 고려하십시오.
5. 여유 용량을 확보하고 계속 모니터링하십시오.
트랜잭션 워크로드는 CPU 사용률이 높지 않은 상황에서도 병목이 발생할 수 있으므로, CPU 기반 알람만으로는 부족합니다. commitTransaction() 지연과 초당 커밋 수를 애플리케이션에서 계측해 점검하세요.
MSK Express Mode 에서 트랜잭션 워크로드를 운영하신다면, 네트워크 처리량 기준선만으로 클러스터를 사이징하기보다는 이 글에서 소개한 식 1) 과 측정 방법을 함께 활용해 보시기를 권장합니다. 트랜잭션 묶음 크기가 작으면 네트워크 기준선보다 훨씬 낮은 수준의 처리량에 머무를 수 있으며, 그 지점에서 브로커 CPU는 여유로워 보일 수 있습니다. 한 번 측정해 둔 기준점은 이후 클러스터 규모나 묶음 크기를 조정할 때 정량적 기준점으로 활용할 수 있습니다.
참고 자료
- Amazon MSK Express brokers
- Best practices for Express brokers
- Amazon MSK quota — Express broker throughput
- Express brokers read-only configurations
- Best practices for right-sizing your Apache Kafka clusters to optimize performance and cost
- KIP-98 — Exactly Once Delivery and Transactional Messaging
- Apache Kafka — Semantics