AWS 기술 블로그
Category: Analytics

Amazon Bedrock 및 Amazon Neptune을 이용한 미래에셋증권의 상품지식 온톨로지 및 상품AI검색 서비스구축기 ( 혁신금융서비스 )
“AI 프로젝트의 95%가 실패하는 이유는 모델이 아니라 데이터다” GenAI 프로젝트가 실패하는 원인은 대부분 모델 성능이 아니라 데이터의 준비 상태에 있습니다. MIT NANDA 보고서의 의하면 GenAI 파일럿의 95%가 AI-Ready Data 부재로 프로덕션에 도달하지 못했고, Gartner는 조직의 63%는 AI-Ready 데이터 관리 체계를 갖추지 못했다고 분석했습니다. 이러한 리서치가 보여주듯 AI-Ready Data가 준비되어 있지 않으면 기업의 AI 프로젝트는 성공하기 […]

GS에너지의 Amazon Bedrock 기반 전사 Claude 도입 과정에서의 사내 인증, 비용 관리와 업무 시스템 연계
이 블로그는 GS에너지와 AWS가 함께 작성했습니다. 1. 전사 AI 서비스 도입 배경 GS에너지는 GS그룹 에너지 부문의 지주회사로, 계열사와 함께 정유·석유화학, 발전·집단에너지, LNG 터미널 등 에너지 사업을 운영하고 있습니다. Digital Tech팀은 이러한 사업을 지원하는 IT 시스템을 운영하며, 안정성과 보안을 기반으로 새로운 기술의 전사 활용을 추진하고 있습니다. 사내 생성형 AI 활용 수요가 늘면서, GS에너지는 비용 통제와 보안을 […]
KB증권 AI 에이전트는 어떻게 최적의 모델을 선택할까? – Amazon Bedrock 기반 Context Tier-Routing
들어가며 – 모든 질문을 같은 LLM으로 처리하는 게 맞을까? KB증권은 ‘슈퍼 금융 에이전트’를 지향하며, 다양한 스킬(Skill)과 도구(Tool)를 자율적으로 선택하고 활용하는 사내 에이전틱 AI 서비스 ‘깨비AI’를 자체 구축해 운영하고 있습니다. 깨비AI는 KB증권 전 임직원을 위한 AI 어시스턴트입니다. 업무 지식 검색, 투자 분석, 문서 작성 및 검토, 계약서 법무검토 등 증권 업무 및 사내 업무에 특화된 다양한 […]

Amazon MSK Express Broker에서 Kafka 트랜잭션 워크로드를 최적화하는 방법
Amazon MSK Express 브로커는 Kafka 클러스터 운영의 복잡성을 크게 줄입니다. 스토리지를 별도로 프로비저닝하거나 용량을 예측할 필요가 없고, 복제 계수(RF=3)와 최소 ISR(minISR=2)이 고정되어 있어 잘못된 복제 설정으로 인한 문제를 원천적으로 방지할 수 있습니다. KRaft 모드로 생성하면(Kafka 3.9 이상) ZooKeeper 관리 부담도 사라집니다. 사이징도 단순해집니다. 인스턴스 타입별 처리량 기준선 (sustained ingress/egress)이 문서에 숫자로 공개되어 있어, 필요한 처리량을 […]

기존 LangGraph 워크플로우를 Amazon Bedrock AgentCore Runtime으로: 아이지에이웍스 클레어의 프로덕션 이관과 운영 경험
이 글은 AWS와 아이지에이웍스가 함께한 프로젝트의 프로덕션 이관 경험을 다룹니다. 1부에서는 Agentic 프로토타입의 설계와 평가를 소개했습니다. 2부에서는 기존 서비스의 실행 환경을 이관한 과정과 이관에서 확인한 성능·운영 특성을 살펴봅니다. 들어가며 클레어(Claire)는 아이지에이웍스의 CDP & CRM 통합 플랫폼 디파이너리(DFINERY)에 내장된 AI 분석 에이전트입니다. Text-to-SQL 기반으로 마케터의 자연어 질문을 정확한 SQL 쿼리로 변환해 실행하고, 결과를 해석한 답변까지 제공합니다. […]

아이지에이웍스 클레어의 Agentic AI PoC 여정: Amazon Bedrock AgentCore로 설계하고 평가하기
이 글은 AWS와 아이지에이웍스가 함께 진행한 프로토타입 검증 프로젝트를 아이지에이웍스 문석민·장소진 님과 공동으로 작성했습니다. 1부는 프로토타입 설계와 평가를, 2부는 프로덕션 이관과 운영 경험을 다룹니다. 들어가며 아이지에이웍스는 AI 기반의 SCI(Synthetic Consumer Intelligence) 기술로 기업이 소비자를 이해하고 시장을 예측해 성장할 수 있도록 돕는 AI 빅데이터 테크 기업입니다. 20년간 축적해 온 실제 소비자 행동 데이터를 학습해, 과거 데이터를 […]

롯데백화점의 생성형 AI 기반 파트너 제안 채널 ‘AI 비즈센터’ 구축기
AI 비즈센터 키 비주얼 롯데백화점은 수천 개의 입점 브랜드 및 파트너사와 협력하며 입점, 계약, 행사 기획, 마케팅 제휴 등 다양한 비즈니스 프로세스를 운영하고 있습니다. 고객용 앱에서 AI 컨시어지 ‘더스틴‘을 운영하는 등 생성형 AI를 고객 접점에 적용해 왔으며, 이번에는 그 활용 범위를 파트너사의 입점 및 협업 지원 영역으로 확장했습니다. 롯데백화점은 파트너사의 정보 탐색과 제안 준비, 제안서 […]

Amazon OpenSearch Service 고급 활용 – 자체 빌드 Nori 분석기를 통한 사용자 사전 미세 조정
검색 서비스에서는 브랜드명이나 상품명처럼 해당 분야에서 사용하는 도메인 용어를 정확하게 처리하는 것이 중요합니다. 이런 용어가 의도와 다르게 분리되면 사용자가 찾는 상품을 놓치거나 관련 없는 결과가 검색될 수 있으며 점진적으로 사용자 경험 저하라는 악순환이 반복됩니다. Amazon OpenSearch Service는 커스텀 패키지를 통해 사용자 사전과 동의어 사전을 적용할 수 있습니다. 이를 활용하면 서비스에 필요한 용어를 추가하고 서로 다른 검색 […]

GS에너지의 SageMaker Unified Studio와 Bedrock AgentCore로 구축하는 엔터프라이즈 에이전트 데이터 플랫폼
프로젝트 기반 데이터 구독과 에이전트 실행을 연결한 GS에너지 발전 계열사 통합 데이터 플랫폼 구축 사례 1. 소개 에너지 산업의 디지털 전환이 가속화되면서, 기업들은 단순한 데이터 저장과 분석을 넘어 AI가 데이터를 능동적으로 활용하는 플랫폼을 요구하고 있습니다. 에너지 기업의 운영 데이터는 발전소 설비 센서, 운전 지표, 환경 계측, 전력 거래, 시장 가격, 규제 공시처럼 성격이 서로 다른 […]
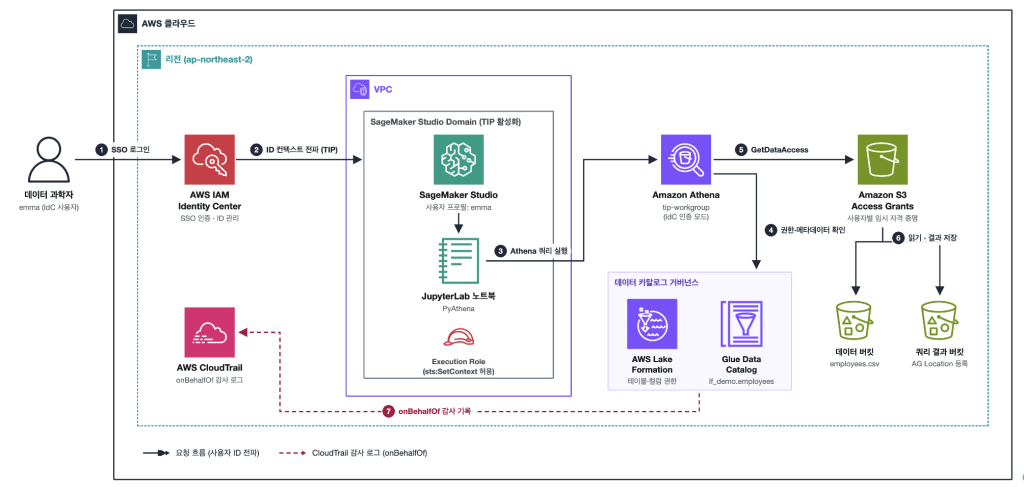
SageMaker Studio에서 TIP와 S3 Access Grants를 활용한 Athena 쿼리 실행하기
개요 기업 환경에서 여러 데이터 과학자가 Amazon SageMaker Studio를 공유하여 사용할 때, 사용자별로 세밀한 데이터 접근 권한을 관리하고 감사 추적을 수행하는 것은 중요한 보안 요구사항입니다. 그러나 기존의 IAM Role 기반 접근 방식에서는 SageMaker Studio의 모든 사용자가 동일한 Execution Role을 공유하게 되어, 개별 사용자를 식별하고 차별화된 권한을 부여하는 것이 어려웠습니다. IAM Identity Center가 제공하는 Trusted Identity […]