O blog da AWS
Como a Algoritmo escala operações de receita com agentes de IA generativa usando Amazon Bedrock
Por Daniel Abib, Arquiteto de Soluções Sênior e Especialista em Amazon Bedrock na AWS.
Escalar operações de receita com agentes de IA exige conectar marketing, vendas e pós-venda, áreas que costumam depender de informações espalhadas por diferentes sistemas e de uma sequência de tarefas manuais. A sétima edição do relatório State of Sales, da Salesforce, publicada em 2026, aponta que os vendedores dedicam 60% da semana a atividades classificadas como não relacionadas à venda. A Algoritmo, empresa brasileira de tecnologia, enfrenta esse problema com agentes de IA generativa que usam o Amazon Bedrock e atuam ao longo do ciclo de receita, da qualificação de interessados à venda, ao suporte e à renovação.
A história da empresa começou dentro da Fluency Academy, onde um time que combinava experiência em vendas, produtos e IA passou a automatizar a comercialização dos próprios cursos de idiomas. Era necessário consultar dados, entender o interesse de cada pessoa, responder dúvidas, acompanhar a negociação e retomar contatos. Ao conectar essas etapas com agentes de IA, o time identificou uma oportunidade de transformar essa prática em uma plataforma para múltiplos segmentos.
O resultado foi o Agent Management System (AMS), sistema próprio para configurar, acompanhar e coordenar agentes especializados. A empresa combina essa plataforma com engenheiros que trabalham próximos à operação de cada cliente, traduzindo processos comerciais em jornadas, ferramentas e critérios de avaliação. A atuação se concentra em empresas de médio e grande porte, com necessidades de integração e personalização que atravessam diferentes áreas do negócio.
Nesta publicação, explicamos como a Algoritmo utiliza o Amazon Bedrock em conjunto com seu motor de agentes, avaliações contínuas e uma estratégia de prompt caching para sustentar essas operações. Desde o início da coleta de dados, a plataforma já processou 23 milhões de chamadas a modelos de linguagem, e a equipe relata uma redução de custos de 65% com a estratégia de cache. A DreamSquad, Parceiro AWS, apoia o aprimoramento da infraestrutura e da observabilidade que sustentam a plataforma.
O desafio: transformar conhecimento comercial em uma operação escalável
O tempo disponível para vender é um desafio recorrente nas equipes comerciais. O relatório State of Sales ouviu 4.050 profissionais de vendas em 22 países. Além do tempo consumido por atividades que não são de venda, o estudo mostra que 51% dos líderes de vendas que utilizam IA afirmam que a fragmentação dos sistemas atrasa ou limita essas iniciativas.
Para a Algoritmo, essa fragmentação aparece em tarefas muito concretas. Um agente que atende alguém interessado em um curso precisa acessar as informações dos produtos, levantar o orçamento disponível e apresentar uma alternativa adequada. Em uma operação de aluguel de consultórios, precisa consultar as características de cada unidade, identificar quais especialidades podem utilizá-la e compartilhar informações corretas sobre localização e disponibilidade. Em outro segmento, a venda só avança depois da coleta e da validação de documentos.
Cada jornada exige conhecimento de negócio e acesso aos sistemas que permitem executá-la. Uma resposta com o preço errado, um endereço incorreto ou uma solicitação repetida de documento prejudica a experiência do cliente e pode interromper a negociação. Ao mesmo tempo, acompanhar manualmente todas as interações se torna inviável à medida que o volume cresce.
Esse desafio também apareceu no desenvolvimento da própria plataforma. No início, a equipe acompanhava a conversão agregada, mas tinha dificuldade para explicar suas oscilações, identificar a participação de humanos no atendimento e localizar os pontos em que os agentes falhavam. Alterações rápidas nos prompts chegavam à produção sem uma avaliação suficientemente estruturada. Era preciso saber quais ferramentas haviam sido acionadas, em que etapa a conversa estava e por que uma interação deixava de avançar.
O custo acrescentava outra restrição. Os prompts comerciais chegavam a aproximadamente 38 mil a 40 mil caracteres, reunindo instruções, regras de negócio, orientações de uso de ferramentas e cuidados específicos de cada operação. Reprocessar esse contexto em sucessivas chamadas aos modelos aumentava o custo das conversas. A empresa precisava preservar a personalização, medir a qualidade e controlar o gasto enquanto ampliava o uso da plataforma.
A solução: agentes especializados com contexto de negócio e avaliação contínua
A Algoritmo estruturou a solução em torno de uma combinação de engenharia de contexto, execução de agentes e acompanhamento dos resultados. O AMS concentra a gestão dos agentes, enquanto um motor próprio controla a execução das conversas, o acesso às ferramentas e as transferências entre especialistas. O Amazon Bedrock fornece o acesso aos modelos de linguagem utilizados nesses fluxos.
Da operação do cliente à jornada dos agentes
A implantação começa com a participação de um engenheiro de domínio, no modelo conhecido como Forward Deployed Engineer (FDE). Esse profissional trabalha com o cliente para entender o catálogo, os critérios comerciais, as dúvidas recorrentes e as etapas necessárias para concluir uma venda ou um atendimento.
A partir desse mapeamento, o time define os prompts, as bases de conhecimento e as ferramentas que os agentes poderão utilizar. Também configura a sequência de contatos: quando responder, quando retomar uma conversa, quando enviar um documento e em quais situações transferir o atendimento.
Essa aproximação com o negócio permite adaptar a mesma plataforma a setores diferentes. O conhecimento de uma empresa que vende cursos se traduz em regras e integrações distintas das exigidas por uma operação de espaços de saúde. O processo de implantação transforma essas particularidades em instruções executáveis e critérios que podem ser avaliados.
No AMS, cada agente recebe uma função e um conjunto de ferramentas. Cada um tem acesso à lista de especialistas disponíveis em sua rede e pode transferir a conversa conforme a necessidade da jornada. As integrações, incluindo ferramentas expostas por meio do Model Context Protocol (MCP), conectam a plataforma aos sistemas de gerenciamento de relacionamento com o cliente (CRM) e aos demais sistemas da empresa.
Um motor próprio para controlar a conversa
A equipe desenvolveu seu motor de agentes a partir da experiência acumulada com as primeiras implementações. Entre os requisitos estavam o controle das ferramentas disponíveis para cada agente, o gerenciamento de memória e a visibilidade sobre cada etapa da execução.
Durante uma conversa, o sistema combina o histórico da sessão com informações persistentes sobre o interessado. Processos auxiliares extraem fatos relevantes das interações para compor essa memória, ajudando a manter a continuidade do atendimento. Na coleta de documentos, por exemplo, o agente registra o que já recebeu para acompanhar as pendências sem reiniciar a solicitação a cada mensagem.
A dinâmica das conversas também influencia o desenho técnico. No WhatsApp, é comum que uma pessoa distribua uma mesma ideia em várias mensagens curtas. A Algoritmo utiliza um intervalo de espera para agrupar essas mensagens antes de responder. Esse comportamento permite que o agente processe a solicitação completa e evita respostas fragmentadas durante a digitação do cliente.
Para as conversas de vendas, a equipe prioriza a qualidade da negociação e utiliza modelos da família Claude Sonnet, da Anthropic, disponíveis no Amazon Bedrock. Já tarefas auxiliares, como avaliações e extração de fatos, podem utilizar modelos de menor custo. A escolha varia conforme a função de cada chamada e o valor da operação atendida.
Arquitetura da solução
Na arquitetura apresentada pela Algoritmo, o Omnichannel, o motor próprio de agentes e o AMS utilizam o Amazon Elastic Kubernetes Service (Amazon EKS). Os componentes representados no Amazon EKS compartilham o mesmo cluster, embora apareçam separados por função no diagrama. O processamento das interações combina esses componentes com serviços de roteamento, filas e execução de eventos.
- Recebimento da interação. O Omnichannel, executado no Amazon EKS, concentra mensagens, conversas e atendimento humano. A entrada HTTPS utiliza um Application Load Balancer (ALB).
- Roteamento e agrupamento. Uma camada no Amazon Elastic Container Service (Amazon ECS) com AWS Fargate agrupa mensagens consecutivas, organiza as interações e encaminha os eventos.
- Processamento assíncrono. O Amazon Simple Queue Service (Amazon SQS) mantém as filas que desacoplam as etapas. Funções do AWS Lambda consomem os eventos e encaminham as solicitações ao motor de agentes.
- Execução com contexto. O motor reúne instruções, memória e ferramentas de negócio, consulta os modelos pelo Amazon Bedrock e aciona os sistemas do cliente. Informações que afetam a negociação, como preços e endereços, são conferidas antes do envio ao cliente.
- Retorno ao atendimento. O motor devolve a resposta pelo Omnichannel, mantendo a interação integrada aos canais e ao acompanhamento da operação.
A camada de gestão reúne o AMS, as jornadas, as avaliações e a memória persistente. O desenho também identifica Amazon Relational Database Service (Amazon RDS) para dados relacionais, Amazon ElastiCache para coordenação e Amazon Simple Storage Service (Amazon S3) para mídia e artefatos. Esses componentes sustentam o estado da aplicação; a reutilização de contexto dos modelos é tratada pela estratégia de prompt caching no Amazon Bedrock.
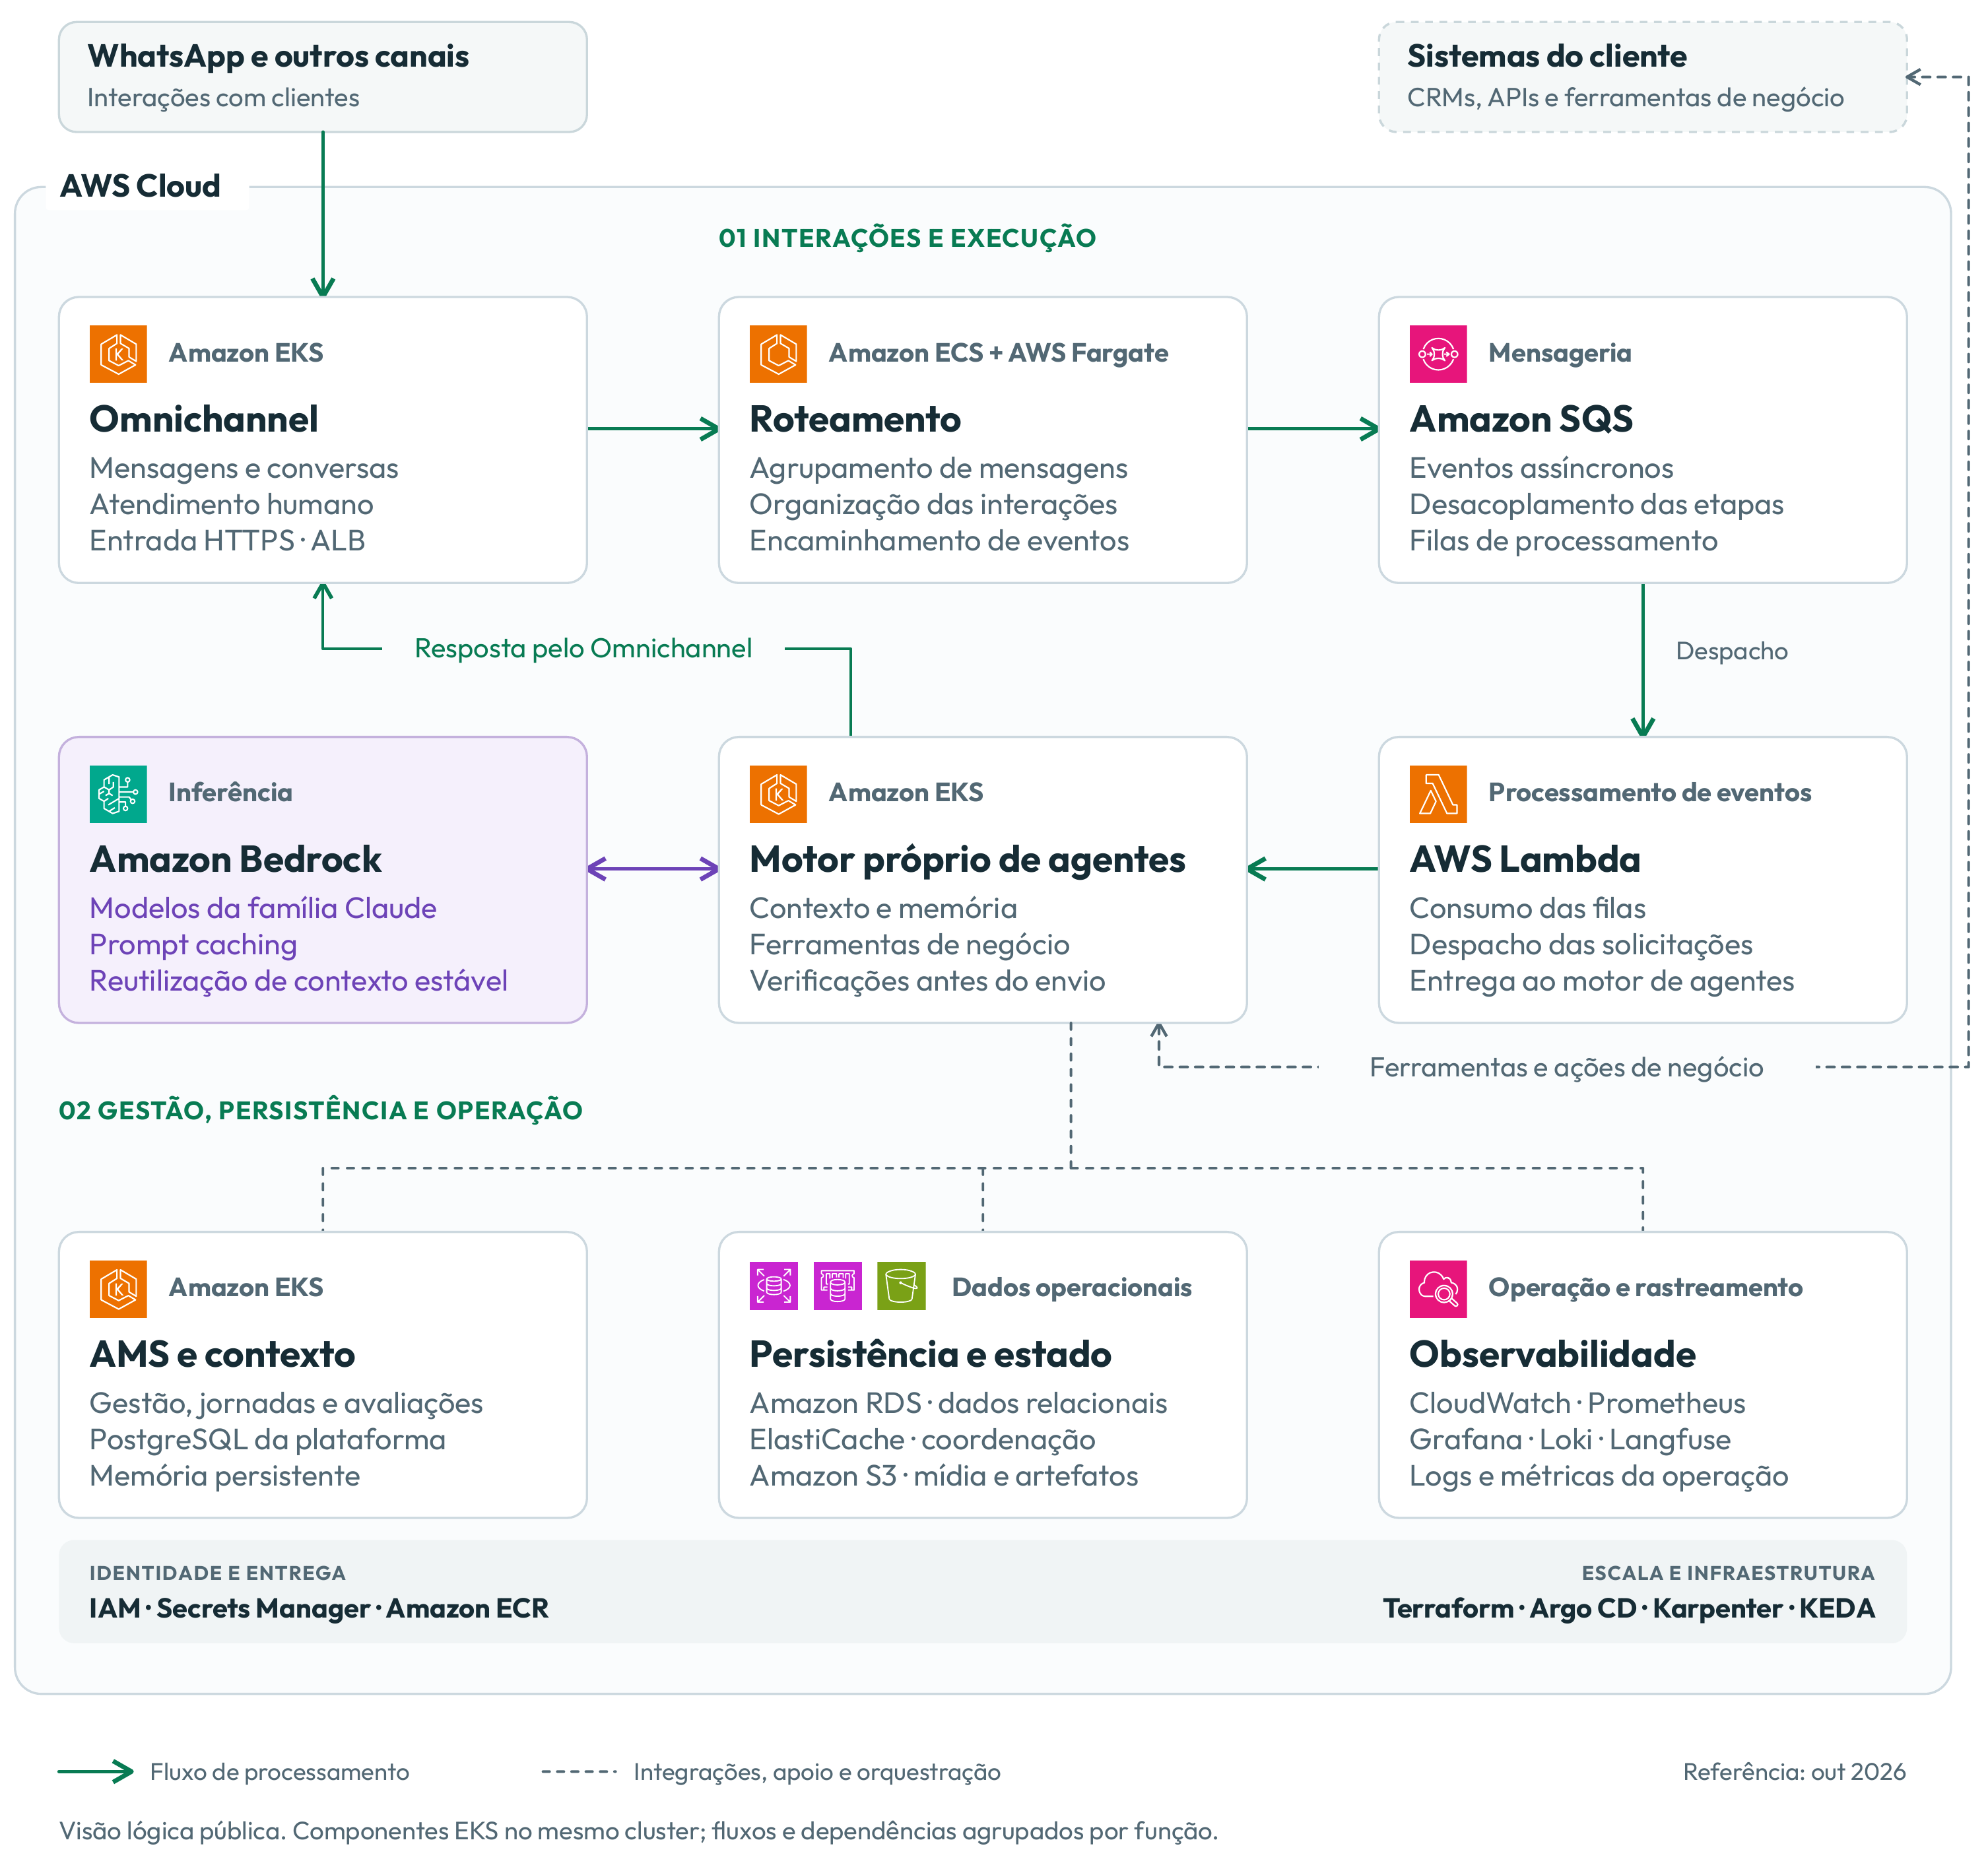
Figura 1 – Interações, execução dos agentes e serviços de apoio na AWS. Recorte da arquitetura fornecida pela Algoritmo, com data de referência em outubro de 2026. Os agrupamentos representam funções da solução.
Avaliações antes e depois de cada mudança
A observabilidade foi pensada para responder a perguntas sobre a operação comercial. A equipe precisa identificar se o agente apresentou uma oferta adequada, informou o preço correto, tratou uma objeção e avançou para a próxima etapa da jornada.
Na arquitetura, essa frente reúne Amazon CloudWatch, Prometheus, Grafana, Loki e Langfuse para apoiar o acompanhamento de logs, métricas e rastreamento da operação. A visibilidade técnica complementa as avaliações de comportamento dos agentes e a gestão das jornadas no AMS.
Além disso, a Algoritmo estabeleceu um processo de revisão dos prompts. Uma nova versão passa primeiro por avaliações com cenários representativos de cada cliente. Esses cenários incluem perfis e situações de negociação que o agente precisa atender. As versões com desempenho satisfatório seguem para testes A/B, nos quais são comparadas com a versão em uso antes de uma adoção mais ampla.
O acompanhamento continua nas conversas reais. O motor registra metadados que permitem reconstruir mudanças de estágio, chamadas a ferramentas, repetições e transferências para humanos. Depois, avaliações conduzidas por modelos de linguagem analisam grupos de conversas conforme a etapa alcançada.
“É humanamente impossível olhar 100.000 conversas de uma vez”, explica Gabriel Aranha, cofundador da Algoritmo.
Uma avaliação pode selecionar as conversas que chegaram à negociação e verificar se o preço foi informado corretamente ou se o agente apresentou uma alternativa diante de uma objeção. Esse recorte torna o resultado mais útil para a equipe que precisa decidir o que ajustar.
Em etapas críticas da negociação, a plataforma também aplica validações durante o atendimento. Antes do envio de um preço, um agente adicional confere a informação com a base de dados. O mesmo princípio é usado para verificar endereços e acompanhar a coleta de documentos. Essas verificações complementam as avaliações e ajudam a controlar erros com impacto direto na jornada do cliente.
Prompt caching para controlar o custo da personalização
A estratégia de prompt caching no Amazon Bedrock nasceu de uma tentativa inicial que aumentou os gastos. A equipe identificou que precisava reorganizar o contexto e considerar a frequência das chamadas para obter economia.
O primeiro passo foi separar o conteúdo estável das informações que mudam a cada atendimento. Instruções de comportamento, regras de negócio e protocolos de uso de ferramentas passaram a compor a parte inicial do prompt. Dados como nome do cliente, data e histórico da conversa ficaram depois dessa parte reutilizável. A equipe ajustou as referências entre os blocos para preservar a personalização e definiu pontos explícitos de cache.
Essa organização permite reutilizar o processamento de prefixos estáveis nas chamadas compatíveis. A resposta continua sendo gerada a partir do contexto do atendimento, incluindo as informações variáveis.
O segundo passo foi controlar quando utilizar o recurso. A criação do cache tem um custo, e sua reutilização depende de novas chamadas dentro da janela de validade. A Algoritmo passou a observar o volume de requisições e a ajustar o uso de cache conforme o tráfego. Em períodos de baixa atividade, manter a estratégia ativa sem reutilização suficiente podia consumir a economia esperada.
Com a combinação de reorganização dos prompts e controle de utilização, a equipe relata uma redução de custos de 65% com a estratégia de cache. O aprendizado passou a integrar o desenho das jornadas: a frequência de uso e a estabilidade do contexto influenciam a eficiência econômica dos agentes.
Da infraestrutura à plataforma de dados com a DreamSquad
A DreamSquad apoiou a migração da infraestrutura da Algoritmo para a AWS e a modernização do ambiente durante essa transição. O trabalho incluiu ajustes de rede e segurança, revisão dos mecanismos de escalabilidade do cluster e apoio na investigação de problemas de memória que limitavam o crescimento.
A arquitetura também apresenta uma plataforma de dados associada à engenharia de dados da DreamSquad. Essa camada conecta as fontes operacionais a modelos analíticos para apoiar a leitura dos indicadores de negócio e seu consumo pelo AMS.
O Airbyte, executado no Amazon EKS, faz a ingestão das fontes operacionais para um data lake no Amazon S3. O AWS Glue realiza a transformação dos dados, com catalogação pelo AWS Glue Data Catalog. O Apache Airflow coordena os pipelines de ingestão e transformação, incluindo suas dependências e agendamentos.
A camada identificada como data warehouse no desenho utiliza modelos analíticos no Amazon S3, com Parquet e Apache Iceberg. O Amazon Athena consulta esses modelos para alimentar indicadores, dashboards e o consumo pelo AMS. Essa organização aproxima os registros da operação conversacional das análises que orientam as jornadas e as decisões comerciais.
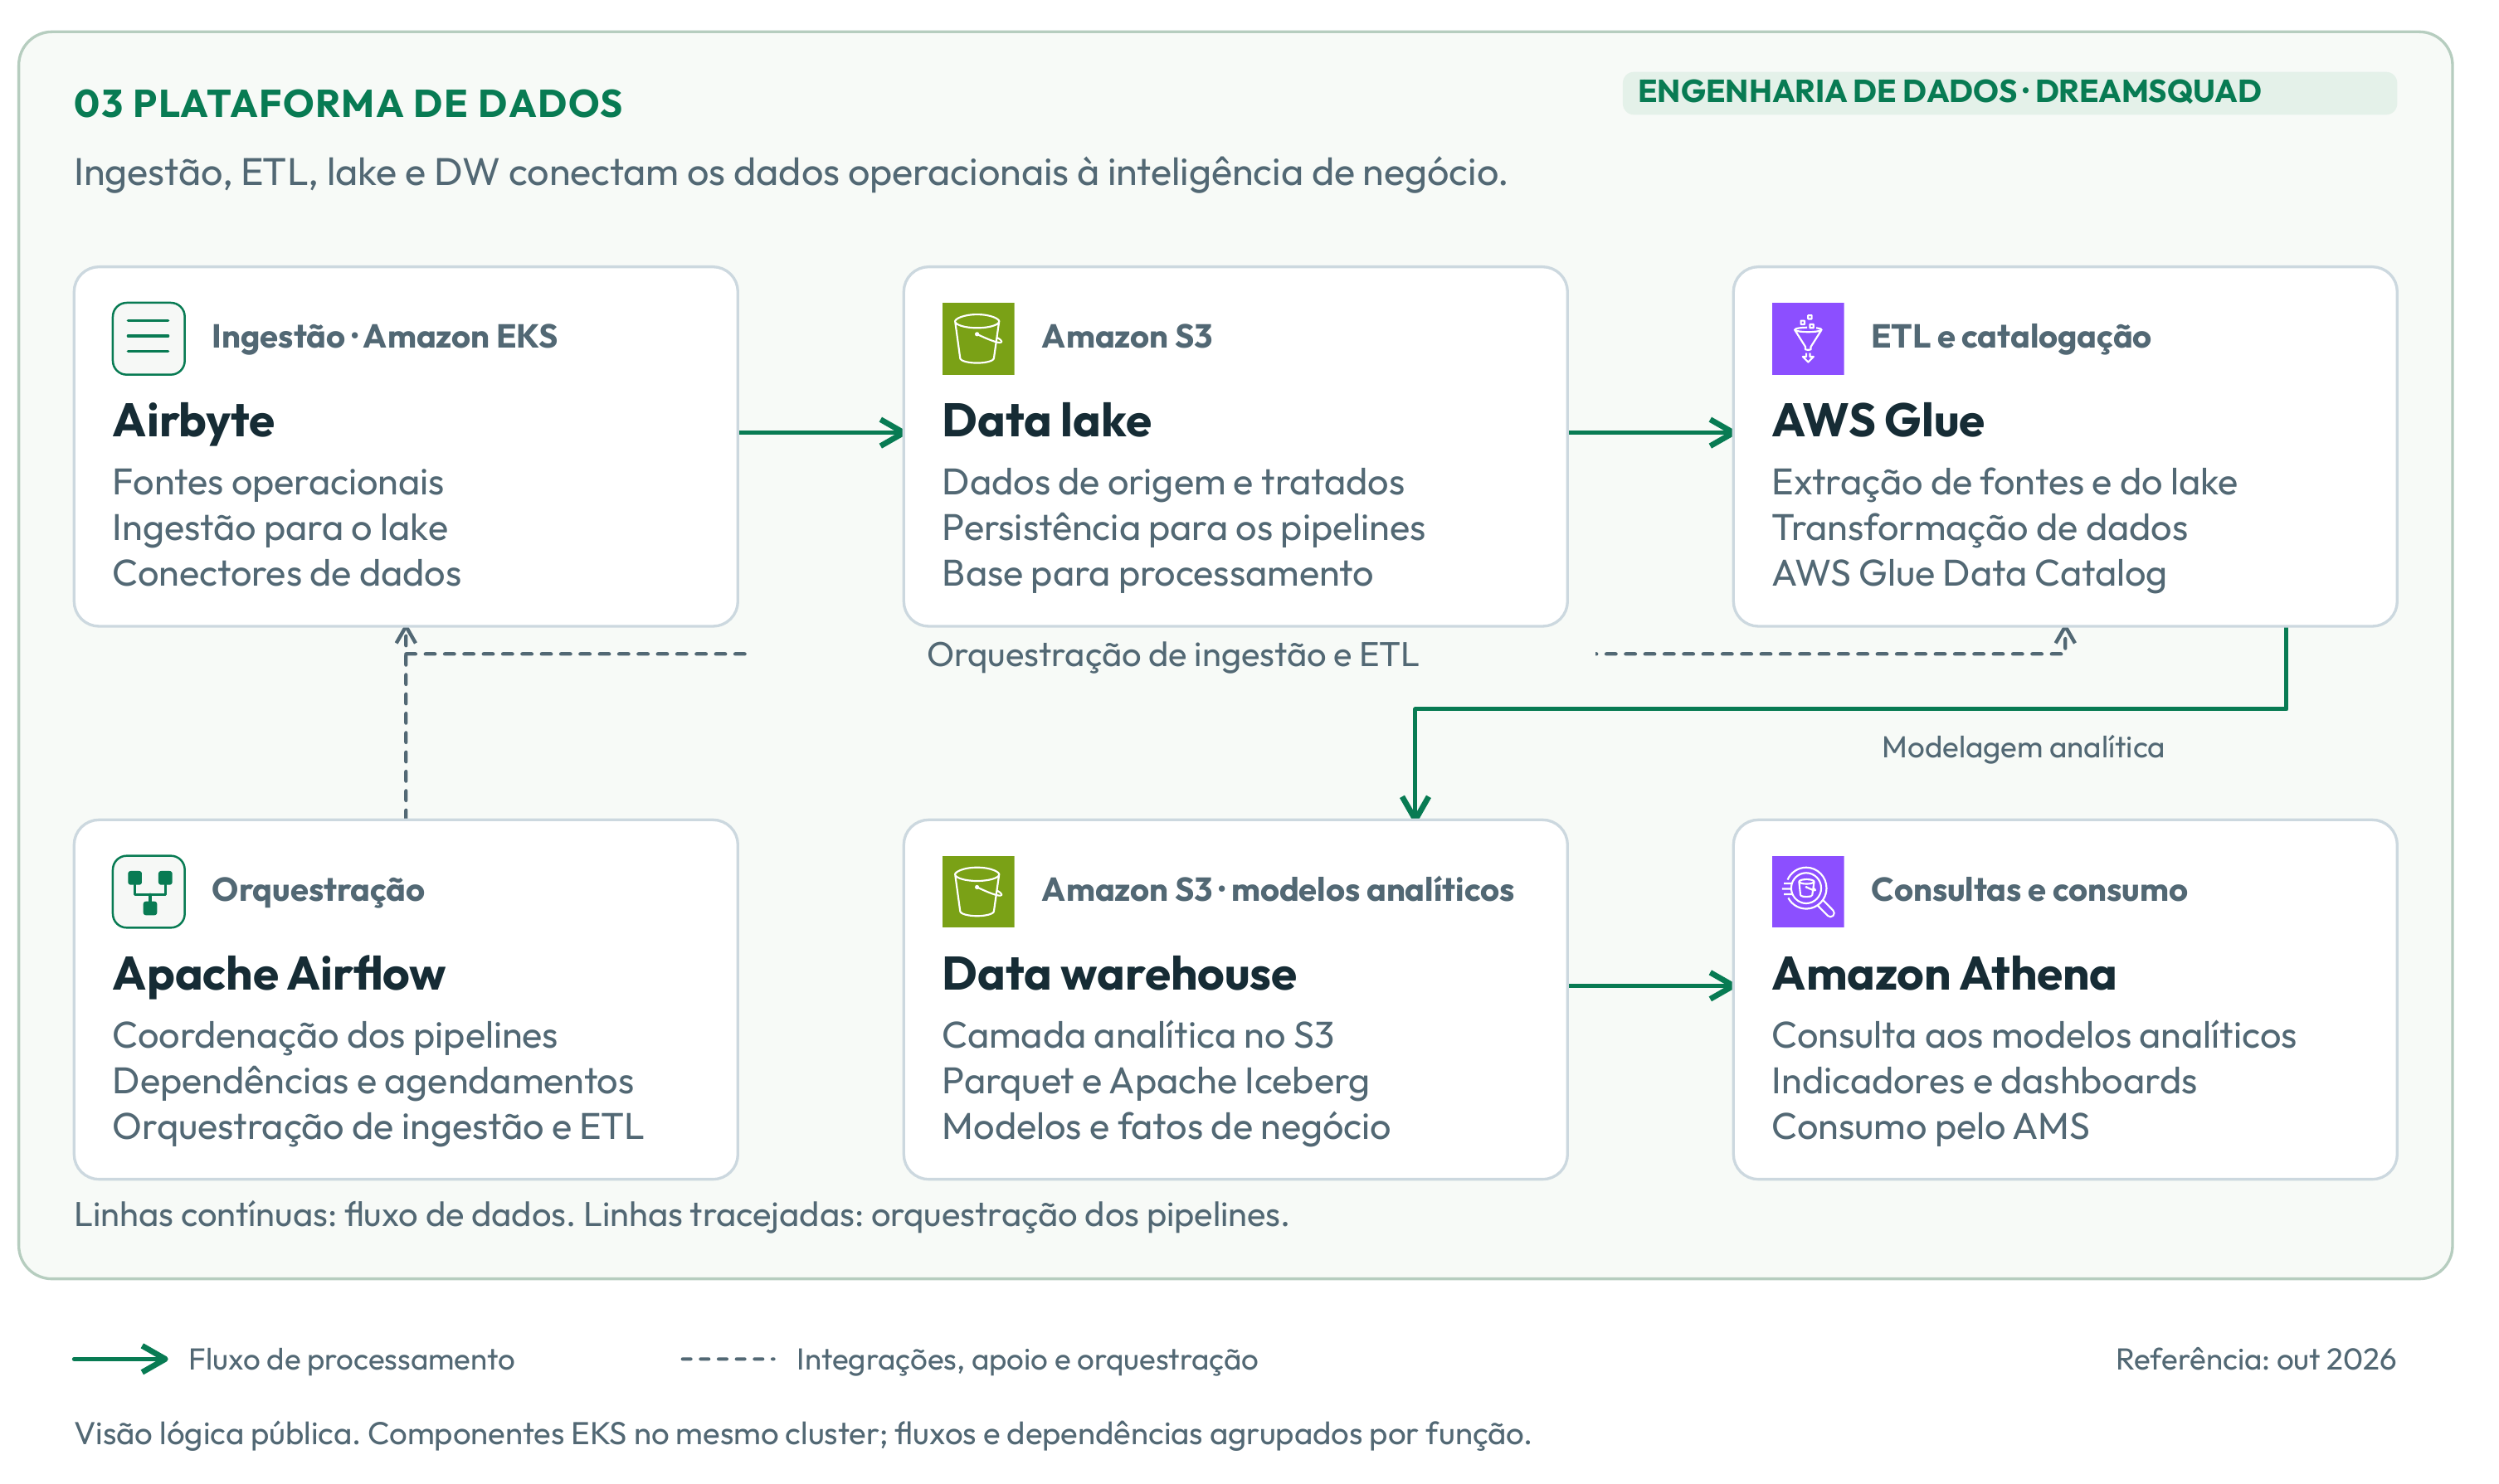
Figura 2 – Plataforma de dados apresentada pela Algoritmo e associada à engenharia de dados da DreamSquad, com data de referência em outubro de 2026. As linhas contínuas representam o fluxo de dados; as tracejadas, a orquestração dos pipelines.
Resultados
Esta seção reúne indicadores da plataforma e resultados de diferentes operações atendidas pela Algoritmo. Os resultados informados pela equipe abrangem pré-vendas, conversão, receita, atendimento e implantação, com recortes próprios de período e escopo.
Eficiência operacional e conversão
- 100% da pré-venda operada por agentes em uma rede de consultórios médicos. Segundo a equipe, a operação passou de 17 representantes de desenvolvimento de vendas (SDRs) para nenhum, com dois profissionais dedicados à gestão dos agentes, uma função que não existia antes. A jornada dura 45 dias, atende médicos de mais de 70 especialidades e combina WhatsApp, Instagram, ligação, e-mail e SMS. Com todos os interessados atendidos pelos agentes, a conversão passou de 13,9% para 18,7%, um aumento de 4,8 pontos percentuais.
- Cerca de 25 mil interessados atendidos no lançamento de um produto de um grande grupo educacional. A empresa estruturou a frente comercial com a Algoritmo sem contratar vendedores para o lançamento. Segundo a estimativa da equipe, uma operação equivalente exigiria aproximadamente 30 vendedores.
- Conversão aproximadamente 73% maior que a do time humano em uma edtech de idiomas. Em setembro de 2026, com agentes e vendedores atuando em paralelo, a conversão dos agentes foi de 5,15%, contra 2,97% do time humano, segundo os indicadores compartilhados pela equipe. Os agentes acumulam as funções de pré-vendas e venda, e a operação já soma mais de 111 mil interessados atendidos.
- Agente entre os cinco maiores vendedores de uma empresa de software com serviços financeiros. Segundo a equipe, o agente aparece no mesmo ranking dos vendedores humanos. Ele vende o software e oferece a maquininha e outras soluções financeiras conforme o momento de cada cliente na jornada.
- Ticket médio superior ao do time humano na conversão de períodos de teste de um software como serviço (SaaS) para empresas, segundo a equipe. O agente atende no WhatsApp quem solicita a contratação pelo site e retoma contato com quem testou o produto sem converter, um público que antes não recebia contato humano. A integração com o CRM e a plataforma de cobrança permite transferir a conversa para a pré-venda quando necessário. Em agosto de 2026, 100% dos novos interessados passaram a ser atendidos pelos agentes.
Receita e atendimento na Exame
R$ 660 mil em nova receita em setembro de 2026 no funil alternativo da Exame, segundo a equipe. A oferta, direcionada a pessoas interessadas em conteúdo de IA que não avançavam na compra de um produto de maior valor, atingiu a meta do mês. A automação permitiu explorar esse interesse em uma nova jornada de venda.
Na frente de atendimento da Exame, a equipe também informa que outros agentes resolvem 45% dos tickets sem transferência para atendimento humano, em três meses de operação. Esse indicador se refere ao atendimento, enquanto o resultado financeiro corresponde ao funil comercial alternativo.
O depoimento de Leonardo Cirino, diretor de marketing (CMO) da Exame, publicado no site da Algoritmo, descreve o efeito da implantação comercial: “Em três semanas a equipe do Algoritmo implantou um agente funcional dentro do nosso fluxo de vendas. Hoje ele conversa com clientes reais, gera receita nova com CAC [custo de aquisição de clientes] baixíssimo.”
Implantação e acompanhamento da base
- Três semanas entre o início do projeto e o primeiro atendimento em um SaaS para restaurantes, segundo a equipe. O prazo inclui o mapeamento da operação pelo engenheiro de domínio, a configuração das jornadas e a integração com os sistemas do cliente.
- Cerca de 6% das pessoas atendidas pedem para falar com um humano, na média da base de clientes informada pela equipe. O acompanhamento dessas solicitações ajuda a dimensionar a equipe necessária para tratar exceções e transferências.
Escala e eficiência da plataforma
Além dos resultados por cliente, a equipe acompanha os volumes acumulados e a eficiência de custo da plataforma. Os indicadores publicados no site da Algoritmo documentam a operação que deu origem à empresa.
- Redução de custos de 65% com a estratégia de cache, segundo o relato da equipe. A economia foi associada à reorganização dos prompts e ao controle de utilização do recurso nas chamadas aos modelos.
- 23 milhões de chamadas a modelos de linguagem acumuladas desde o início da coleta de dados. Esse volume amplia a base disponível para analisar o comportamento dos agentes e orientar o ajuste dos fluxos.
- Cerca de 600 mil conversas na operação da Fluency Academy, segundo a equipe da Algoritmo. O aprendizado nessa jornada contribuiu para a definição de ferramentas, memórias e critérios de avaliação utilizados pela equipe.
- Mais de 1 milhão de leads (contatos captados) e taxa de conversão três vezes maior no caso da Fluency Academy, conforme os indicadores publicados no site da Algoritmo. Esses números descrevem a operação de origem apresentada pela empresa.
A evolução da plataforma também mudou a forma de desenvolver os agentes. Alterações de prompt passaram a ser avaliadas antes de uma adoção mais ampla, e as conversas reais se tornaram insumo para identificar falhas de informação, dificuldades de negociação e oportunidades de melhoria. Essa ligação entre comportamento e resultado orienta tanto o trabalho dos engenheiros de domínio quanto a evolução do produto.
Próximos passos
A Algoritmo organiza seus próximos passos em frentes que ampliam a atuação dos agentes e simplificam a operação da plataforma:
- Ampliar a integração entre canais. A equipe já relata jornadas que combinam WhatsApp, Instagram, ligação, e-mail e SMS. O plano inclui ampliar essa integração em diferentes operações e manter a continuidade do atendimento entre os canais.
- Operar o AMS por meio de um assistente. A empresa desenvolve agentes especializados para consultar dados, criar jornadas e configurar outros agentes. O objetivo é permitir que clientes e engenheiros de domínio façam perguntas sobre a operação e executem tarefas em linguagem natural.
- Avançar na especialização dos modelos para vendas. A empresa desenvolve um modelo próprio para jornadas comerciais. Nessa frente, a evolução dos modelos considera a qualidade das respostas, o custo de inferência e a avaliação em cenários de venda.
- Explorar o comércio entre agentes. Em uma perspectiva de longo prazo, a empresa pretende preparar seus agentes para interagir com assistentes de compra e outros agentes digitais, acompanhando a evolução dos protocolos dessa área.
Essas iniciativas aproveitam o conhecimento acumulado em vendas e atendimento. A especialização dos modelos, a ampliação dos canais e a gestão conversacional do AMS serão avaliadas pela capacidade de melhorar a execução das jornadas e os resultados dos clientes.
Conclusão
A trajetória da Algoritmo mostra como o aprendizado de uma operação comercial pode se transformar em uma plataforma de agentes de IA para diferentes segmentos. O conhecimento de negócio orienta a configuração das jornadas; o motor próprio conecta os agentes aos sistemas dos clientes; e as avaliações permitem acompanhar a qualidade de cada nova versão.
O Amazon Bedrock integra essa arquitetura como camada de acesso aos modelos e de reutilização de contexto com prompt caching. Com apoio da DreamSquad na infraestrutura, na observabilidade e na plataforma de dados, a Algoritmo combina execução, acompanhamento e controle de custos para ampliar sua atuação em operações de receita.
Se sua empresa enfrenta desafios semelhantes na integração de vendas, atendimento e pós-venda, entre em contato com seu representante AWS ou conheça o Amazon Bedrock.
Biografia do Autor
 |
Daniel Abib é Arquiteto de Soluções Sênior e Especialista em Amazon Bedrock na AWS, com mais de 25 anos trabalhando com gerenciamento de projetos, arquiteturas de soluções escaláveis, desenvolvimento de sistemas e CI/CD, microsserviços, arquitetura Serverless & Containers e especialização em Machine Learning. Ele trabalha apoiando Startups, ajudando-os em sua jornada para a nuvem. https://www.linkedin.com/in/danielabib/ |