O blog da AWS
Fine-tuning de embeddings para busca de produtos em português
Por Thiago Couto, Principal Solutions Architect na AWS e Caio Monteiro, Principal Customer Solutions Manager na AWS.
Quando um cliente digita um produto na busca da sua loja, o produto certo e um parecido compartilham quase todas as palavras. Acertar essa diferença é o trabalho da busca semântica, e é onde um modelo de embeddings de uso geral, treinado majoritariamente em inglês, pode não ser suficiente.
Neste post, mostramos como fazer fine-tuning de um modelo de embeddings aberto e compacto para busca de produtos em português usando o Amazon Translate, o Amazon Bedrock e o Amazon SageMaker AI. Com 11 minutos de treinamento e cerca de US$ 0,27, o nDCG@10 (normalized Discounted Cumulative Gain em 10 resultados) do modelo subiu 56%. Todo o código está no repositório aws-samples/sample-product-retrieval-embeddings-fine-tuning no GitHub.
Por que buscar produtos em português é difícil
Na busca de produtos em português, as consultas são curtas, misturam português com nomes de marca em inglês, trazem medidas e códigos e raramente usam o vocabulário do catálogo. Clientes acostumados a conversar com assistentes virtuais também passaram a escrever buscas menos estruturadas. Nesses casos, a correspondência por palavra exata deixa de encontrar produtos relevantes.
Modelos de embeddings resolvem parte desse problema: eles representam consultas e produtos como vetores e comparam a proximidade entre eles. Modelos de uso geral, como o Amazon Titan Text Embeddings V2 no Amazon Bedrock, funcionam sem treinamento, oferecem suporte a português e são um bom ponto de partida. A questão é quanto se ganha ao especializar um modelo no idioma e no domínio.
Para medir esse ganho, precisávamos de dados de busca de produtos em português com relevância anotada. O Shopping Queries Dataset (ESCI), da Amazon Science, tem mais de 2,6 milhões de pares consulta-produto anotados manualmente em quatro níveis de relevância: exato, substituto, complementar e irrelevante. O dataset, porém, cobre apenas inglês, espanhol e japonês.
O que comparamos
Nosso objetivo foi responder a uma pergunta prática: um modelo de embeddings aberto e compacto, ajustado com dados de busca, consegue igualar ou superar um modelo de uso geral na busca de produtos em português?
Para isso, comparamos três configurações:
- Modelo candidato: intfloat/multilingual-e5-small, um modelo aberto com 118 milhões de parâmetros e vetores de 384 dimensões, após o fine-tuning.
- Referência aberta: o mesmo e5-small sem ajuste, para isolar o ganho do fine-tuning.
- Referência gerenciada: Amazon Titan Text Embeddings V2, usado sem ajuste e configurado com 1.024 dimensões, o padrão do modelo.
O critério de avaliação foram 2.000 consultas de teste, nunca vistas no treinamento, buscando entre todos os 59.270 produtos do catálogo. Medimos o resultado com nDCG@10 e Recall@10.
Como fizemos o experimento
O diagrama a seguir mostra as três etapas orquestradas pelo notebook (reproduce_experiment.ipynb): criação do dataset, medição das referências e fine-tuning.
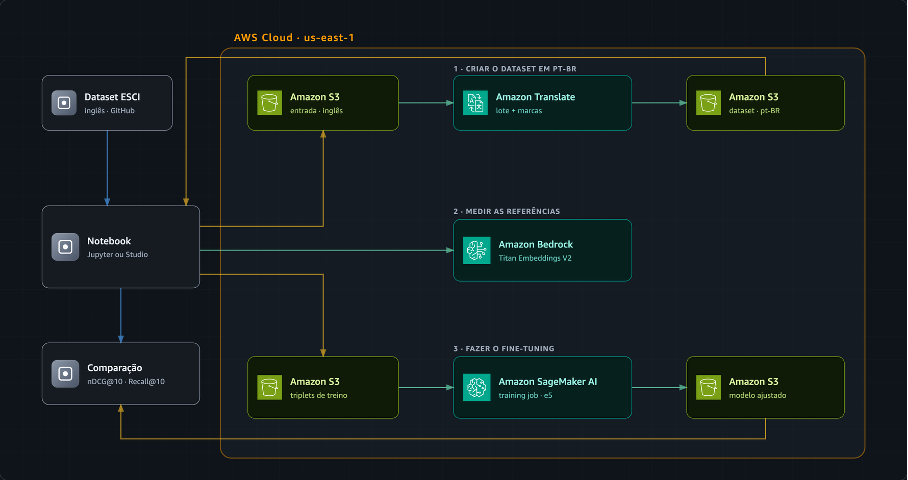
O notebook orquestra as três etapas: criar o dataset em português com o Amazon Translate, medir as referências no Amazon Bedrock e fazer o fine-tuning no Amazon SageMaker AI
1. Criar o dataset em português
Das 23.238 consultas do ESCI em inglês que tinham ao menos um produto exato e dois irrelevantes, sorteamos 10.000, com 62.689 julgamentos e 59.270 produtos. Depois traduzimos consultas e produtos com um trabalho de tradução em lote do Amazon Translate. O ponto crítico foram as marcas: sem cuidado, a consulta “revent” virava “evitar”. Uma terminologia personalizada do Amazon Translate com 26.503 marcas do catálogo, cada uma mapeada para ela mesma, manteve os nomes intactos.
O trecho a seguir, do notebook, inicia o trabalho de tradução:
translate.start_text_translation_job(
    InputDataConfig={"S3Uri": f"s3://{S3_BUCKET}/{in_prefix}/", "ContentType": XLSX_CT},
    OutputDataConfig={"S3Uri": f"s3://{S3_BUCKET}/translate-out/{run_id}/"},
    DataAccessRoleArn=TRANSLATE_ROLE_ARN,
    SourceLanguageCode="en", TargetLanguageCodes=["pt"],
    TerminologyNames=["product-brands"],
    JobName=f"esci-ptbr-{run_id}",
)
Os 81 arquivos, 80 de produtos e 1 de consultas, foram traduzidos sem erros, e nenhum campo se perdeu na remontagem. Por fim, dividimos as consultas em 7.000 para treino, 2.000 para teste e 1.000 para validação, sem que nenhuma consulta aparecesse em mais de um conjunto.
2. Medir as referências
Geramos os embeddings das consultas de teste e do catálogo inteiro com o e5-small sem ajuste e com o Amazon Titan Text Embeddings V2. Em seguida, ordenamos os produtos por similaridade do cosseno, com busca exata e sem índice aproximado, para que nenhum parâmetro de indexação influenciasse a comparação. Para calcular o nDCG, cada produto recebe um peso: exato vale 1,0, substituto vale 0,1, e irrelevante ou sem anotação vale 0.
3. Fazer o fine-tuning no Amazon SageMaker AI
Cada exemplo de treino é um trio: a consulta em português, um produto exato e um produto irrelevante da mesma consulta. Como o ESCI anotou produtos que apareceram como resultado de cada consulta, o irrelevante muitas vezes se parece com o produto certo, e é ele que ensina o modelo a separar o certo do quase certo. Foram 15.761 trios, treinados com MultipleNegativesRankingLoss, que também usa os produtos das outras consultas do lote como exemplos negativos. O treinamento roda em um trabalho de treinamento do SageMaker AI, que é encerrado automaticamente ao concluir. Ao final, selecionamos o checkpoint com o melhor nDCG@10 no conjunto de validação.
O trecho a seguir, do notebook, configura e inicia o treinamento:
estimator = HuggingFace(
    entry_point="train.py", source_dir="finetune_src", role=role,
    instance_type="ml.g5.xlarge", instance_count=1,
    transformers_version="4.36", pytorch_version="2.1", py_version="py310",
    hyperparameters={"model-id": "intfloat/multilingual-e5-small", "epochs": 2,
                     "batch-size": 32, "max-seq-length": 256, "lr": 2e-5},
)
estimator.fit({"train": train_s3, "validation": val_s3})
Como reproduzir o experimento na sua conta
Você precisa de uma conta da AWS, Python 3.9 ou superior, um bucket do Amazon Simple Storage Service (Amazon S3) e uma função de execução do AWS Identity and Access Management (IAM) para o SageMaker AI. Execute em uma Região onde o Amazon Bedrock, o Amazon Translate e o SageMaker AI estejam disponíveis, como us-east-1. O acesso ao Amazon Titan Text Embeddings V2 no Amazon Bedrock é opcional.
git clone https://github.com/aws-samples/sample-product-retrieval-embeddings-fine-tuning.git
cd sample-product-retrieval-embeddings-fine-tuning
pip install -r requirements.txt
jupyter lab reproduce_experiment.ipynb
Por padrão (DATA_MODE = “bundled”), o notebook usa uma amostra de 500 consultas já traduzidas, incluída no repositório, e não chama o Amazon Translate. Ela valida o fluxo, mas retorna métricas mais altas que as deste post, porque busca em 3.072 produtos em vez de 59.270. Para reproduzir os resultados, use DATA_MODE = “full”.
Esse modo traduz o dataset completo e custa cerca de US$ 947. Ele também exige uma função do IAM que permita ao Amazon Translate ler e gravar no seu bucket e cota para ml.g5.xlarge em trabalhos de treinamento, que você pode verificar no AWS Service Quotas.
Já tem dados reais de busca em português? Use-os no lugar da amostra: aponte BUNDLED_SAMPLE para o seu arquivo, no mesmo formato da amostra. Antes, remova ou anonimize dados pessoais dos registros de busca e siga as políticas de dados da sua empresa. Dados do seu próprio catálogo refletem melhor as suas marcas e o jeito que os seus clientes buscam.
A tabela a seguir resume o custo aproximado de cada etapa.
| Etapa | Custo aproximado (us-east-1) |
| Fine-tuning no Amazon SageMaker AI (ml.g5.xlarge, ~11 min) | US$ 0,27 |
| Embeddings no Amazon Bedrock para avaliação | centavos |
| Tradução completa com o Amazon Translate (DATA_MODE = “full”) | US$ 947 |
Os preços variam por Região; consulte a página de preços da AWS antes de executar.
Resultados
Avaliamos as três configurações nas mesmas condições: 2.000 consultas de teste, nunca vistas no treinamento, buscando entre todos os 59.270 produtos do catálogo. O nDCG@10 mede se os produtos certos aparecem no topo e na ordem certa, com mais peso para produtos exatos do que para substitutos. O Recall@10 mede que proporção dos produtos exatos aparece entre os 10 primeiros resultados.
| Modelo | Dimensões | nDCG@10 | Recall@10 |
| e5-small sem ajuste | 384 | 0,2764 | 0,3452 |
| e5-small com fine-tuning | 384 | 0,4320 | 0,5276 |
| Amazon Titan Text Embeddings V2 | 1.024 | 0,3730 | 0,4580 |
- O fine-tuning melhorou o modelo em mais de 50%. O nDCG@10 subiu de 0,2764 para 0,4320 (+56%) e o Recall@10 subiu de 0,3452 para 0,5276 (+53%), com o mesmo modelo, a mesma dimensão e o mesmo texto de entrada.
- A ordem se inverteu. Sem ajuste, o Amazon Titan Text Embeddings V2 ficou à frente do e5-small. Depois do fine-tuning, o e5-small superou o Amazon Titan em 15,8% no nDCG@10 e em 15,2% no Recall@10. Ele também usa vetores de 384 dimensões, contra as 1.024 que configuramos no Amazon Titan, o que reduz em 2,7 vezes o espaço para armazenar os vetores. O Amazon Titan V2 também gera vetores de 512 e 256 dimensões, que não avaliamos.
- Avaliar no catálogo inteiro faz diferença. Quando reordenamos apenas os produtos já anotados de cada consulta, os modelos ficaram próximos, em torno de 0,83 de nDCG@10. A diferença só apareceu na busca sobre todo o catálogo, que se aproxima mais do cenário real de uma loja.
Considere estes limites ao interpretar os números:
- Os dados são traduzidos do inglês e não reproduzem gírias, abreviações e regionalismos de buscas reais de brasileiros.
- Produtos sem anotação contaram como irrelevantes. Por isso, os valores absolutos são conservadores e não equivalem ao recall de um mecanismo de busca em produção. A comparação entre os modelos continua válida.
- O catálogo tem 59.270 produtos, bem menos que o de um grande varejista.
- O resultado vem de uma única execução, sem intervalos de confiança.
- Testamos um modelo aberto e uma configuração do Amazon Titan. Outros modelos e dimensões podem produzir resultados diferentes.
Além disso, hospedar o modelo por conta própria traz o custo de inferência e o trabalho operacional que um serviço gerenciado absorve. O Amazon Titan continua sendo a escolha mais simples quando você ainda não tem dados rotulados.
Limpeza
Para evitar cobranças futuras e remover recursos que você não usa mais, exclua os objetos do Amazon S3 criados para a tradução e o treinamento, incluindo o modelo ajustado, e o bucket, se você o criou só para este experimento. Exclua também a terminologia personalizada do Amazon Translate (product-brands) e qualquer endpoint do SageMaker AI que você tenha criado para servir o modelo. Se executou o notebook no SageMaker AI Studio ou em uma instância de notebook, pare o ambiente. Trabalhos de treinamento deixam de gerar cobrança quando terminam, e as chamadas ao Amazon Bedrock não criam recursos para excluir.
Conclusão
Neste post, mostramos como especializar um modelo de embeddings compacto para busca de produtos em português. Criamos um dataset rotulado em português com o Amazon Translate, medimos dois pontos de referência e fizemos fine-tuning no Amazon SageMaker AI. Depois do ajuste, o e5-small superou o Amazon Titan Text Embeddings V2 em 15,8% no nDCG@10, com vetores de 384 dimensões. O resultado indica que, em uma tarefa bem definida, adaptar o modelo ao idioma e ao domínio pode pesar mais do que usar um modelo de uso geral com vetores maiores.
Na prática, isso ajuda a escolher o caminho para cada momento. Se você ainda não tem dados rotulados, o Amazon Titan Text Embeddings V2 entrega busca semântica sem nenhum treinamento e oferece suporte a português. Quando você já tem dados de busca do seu catálogo com relevância anotada, um fine-tuning como o deste post, que levou cerca de 11 minutos e custou US$ 0,27, pode melhorar a relevância e reduzir o espaço ocupado pelos vetores. Quando o catálogo mudar, você pode repetir o treinamento e gerar de novo os embeddings dos produtos.
Para começar, clone o repositório e execute o notebook com a amostra em português incluída. Depois, troque a amostra pelos dados de busca da sua loja. Para outros idiomas, mude o idioma de destino do Amazon Translate, crie a terminologia de marcas para esse idioma e valide as métricas de novo.
Sobre os autores
 |
Thiago Couto é Principal Solutions Architect na AWS, especialista em Inteligência Artificial, IA Generativa, varejo e bens de consumo. Com mais de 15 anos de experiência em tecnologia, ajuda grandes empresas a transformar inovação em resultados de negócio. É também palestrante e apresentador do Podcast AWS Brasil. |
 |
Caio Monteiro é Principal Customer Solutions Manager na AWS, atuando no segmento Enterprise com foco em clientes de Varejo e Bens de Consumo. Possui ampla experiência em guiar organizações em suas jornadas de nuvem, ajudando a identificar oportunidades estratégicas, desenvolver soluções e acelerar a adoção de tecnologias. |