亚马逊AWS官方博客
在 Amazon EKS 上共享 GPU:Time-Slicing、NVIDIA DRA 与 HAMi 的功能验证和选型建议
摘要:本文基于 Amazon EKS 和 NVIDIA A10G 实测对比 Device Plugin Time-Slicing、NVIDIA DRA Driver Time-Slicing 与 HAMi 三种 GPU 共享方案,并结合性能变化、资源隔离能力和部署边界给出选型建议。
目录
1. 概述
企业在 Amazon Elastic Kubernetes Service(Amazon EKS)上部署生成式 AI 推理服务时,Kubernetes 通常以整张 GPU 为单位分配 nvidia.com/gpu 资源。对于模型较小、请求频率较低或流量高峰错开的推理服务,单个服务即使只使用部分显存和算力,也可能长期占用整张 GPU。让每个服务独占 GPU 节点虽然简单,却容易造成资源闲置并增加基础设施成本。
让多个 Pod 共享同一张物理 GPU,可以提高资源承载密度,但也会带来显存超配、算力竞争、延迟抖动和故障域扩大等问题。GPU 共享是一种资源复用方式,采用前需要综合评估模型显存需求、请求峰值重叠、延迟、隔离要求和运维复杂度。
本文在相同的实例规格和主要软硬件版本配置下,对三条 GPU 共享路径进行了验证:
- 使用 NVIDIA Kubernetes Device Plugin 的 Time-Slicing,让两个推理 Pod 共享一张 A10G 物理 GPU,并观察邻居空闲和两个服务同时活跃时的 vLLM 推理行为;
- 使用 NVIDIA Dynamic Resource Allocation(DRA)Driver,验证结构化设备发现、ResourceClaim 生命周期,以及两个 Pod 通过同一个 Claim 访问同一张 GPU,并在同一测试窗口内持续执行 GEMM;
- 使用 Heterogeneous AI Computing Virtualization Middleware(HAMi),验证用户态显存配额、越界 CUDA OOM、算力节流,以及两个 vLLM 服务共享 GPU 时的运行行为。
本文聚焦 GPU 共享能力验证和性能趋势观察。Time-Slicing 与 HAMi 用于展示固定测试环境下的 vLLM 运行变化;NVIDIA DRA 部分使用通用矩阵乘法(General Matrix Multiplication,GEMM)负载验证设备发现、Claim 生命周期和共享机制。生产部署时,可结合实际模型、上下文长度、并发模式和服务等级目标(SLO)进一步开展容量与稳定性验证。
| 方案 | 本次验证 | 资源控制边界 | 适用方向 |
| Device Plugin Time-Slicing | 同卡多 Pod、vLLM 性能趋势 | 无 Pod 级显存和计算份额保证,共享故障域 | 可信工作负载、显存可规划、流量错峰 |
| NVIDIA DRA Driver Time-Slicing | 设备发现、Claim 生命周期、同一时间窗口执行 GEMM | 本次分时模式无运行时显存或计算隔离 | 需要结构化设备选择和 Claim 生命周期管理 |
| HAMi | 用户态显存配额、OOM、计算节流和 vLLM 趋势 | 软件配额,不等同于 MIG,仍共享故障域 | 需要软件显存上限和计算份额控制 |
2. Amazon EKS GPU 共享原理
2.1 Kubernetes 默认 GPU 分配方式
NVIDIA Kubernetes Device Plugin 通常将每张 GPU 注册为一个 nvidia.com/gpu 扩展资源。Pod 请求 nvidia.com/gpu:1 后,Kubernetes 调度器会为其分配一张可用 GPU;在默认配置下,其他 Pod 不能再申请这张 GPU。这种整卡分配方式适合长期高负载、严格延迟要求或需要明确故障边界的服务。对于低频或间歇性推理服务,模型权重和 KV Cache 可能只使用部分显存,GPU 计算单元也会在请求间隔中处于空闲状态,此时可以评估软件层共享,以优化 GPU 资源使用率。
本文使用的 GPU 硬件资源 A10G 不在 NVIDIA Multi-Instance GPU(MIG)支持的 GPU 列表中,无法通过 MIG 将一张卡划分成多个硬件隔离实例,因此重点比较软件共享路径。
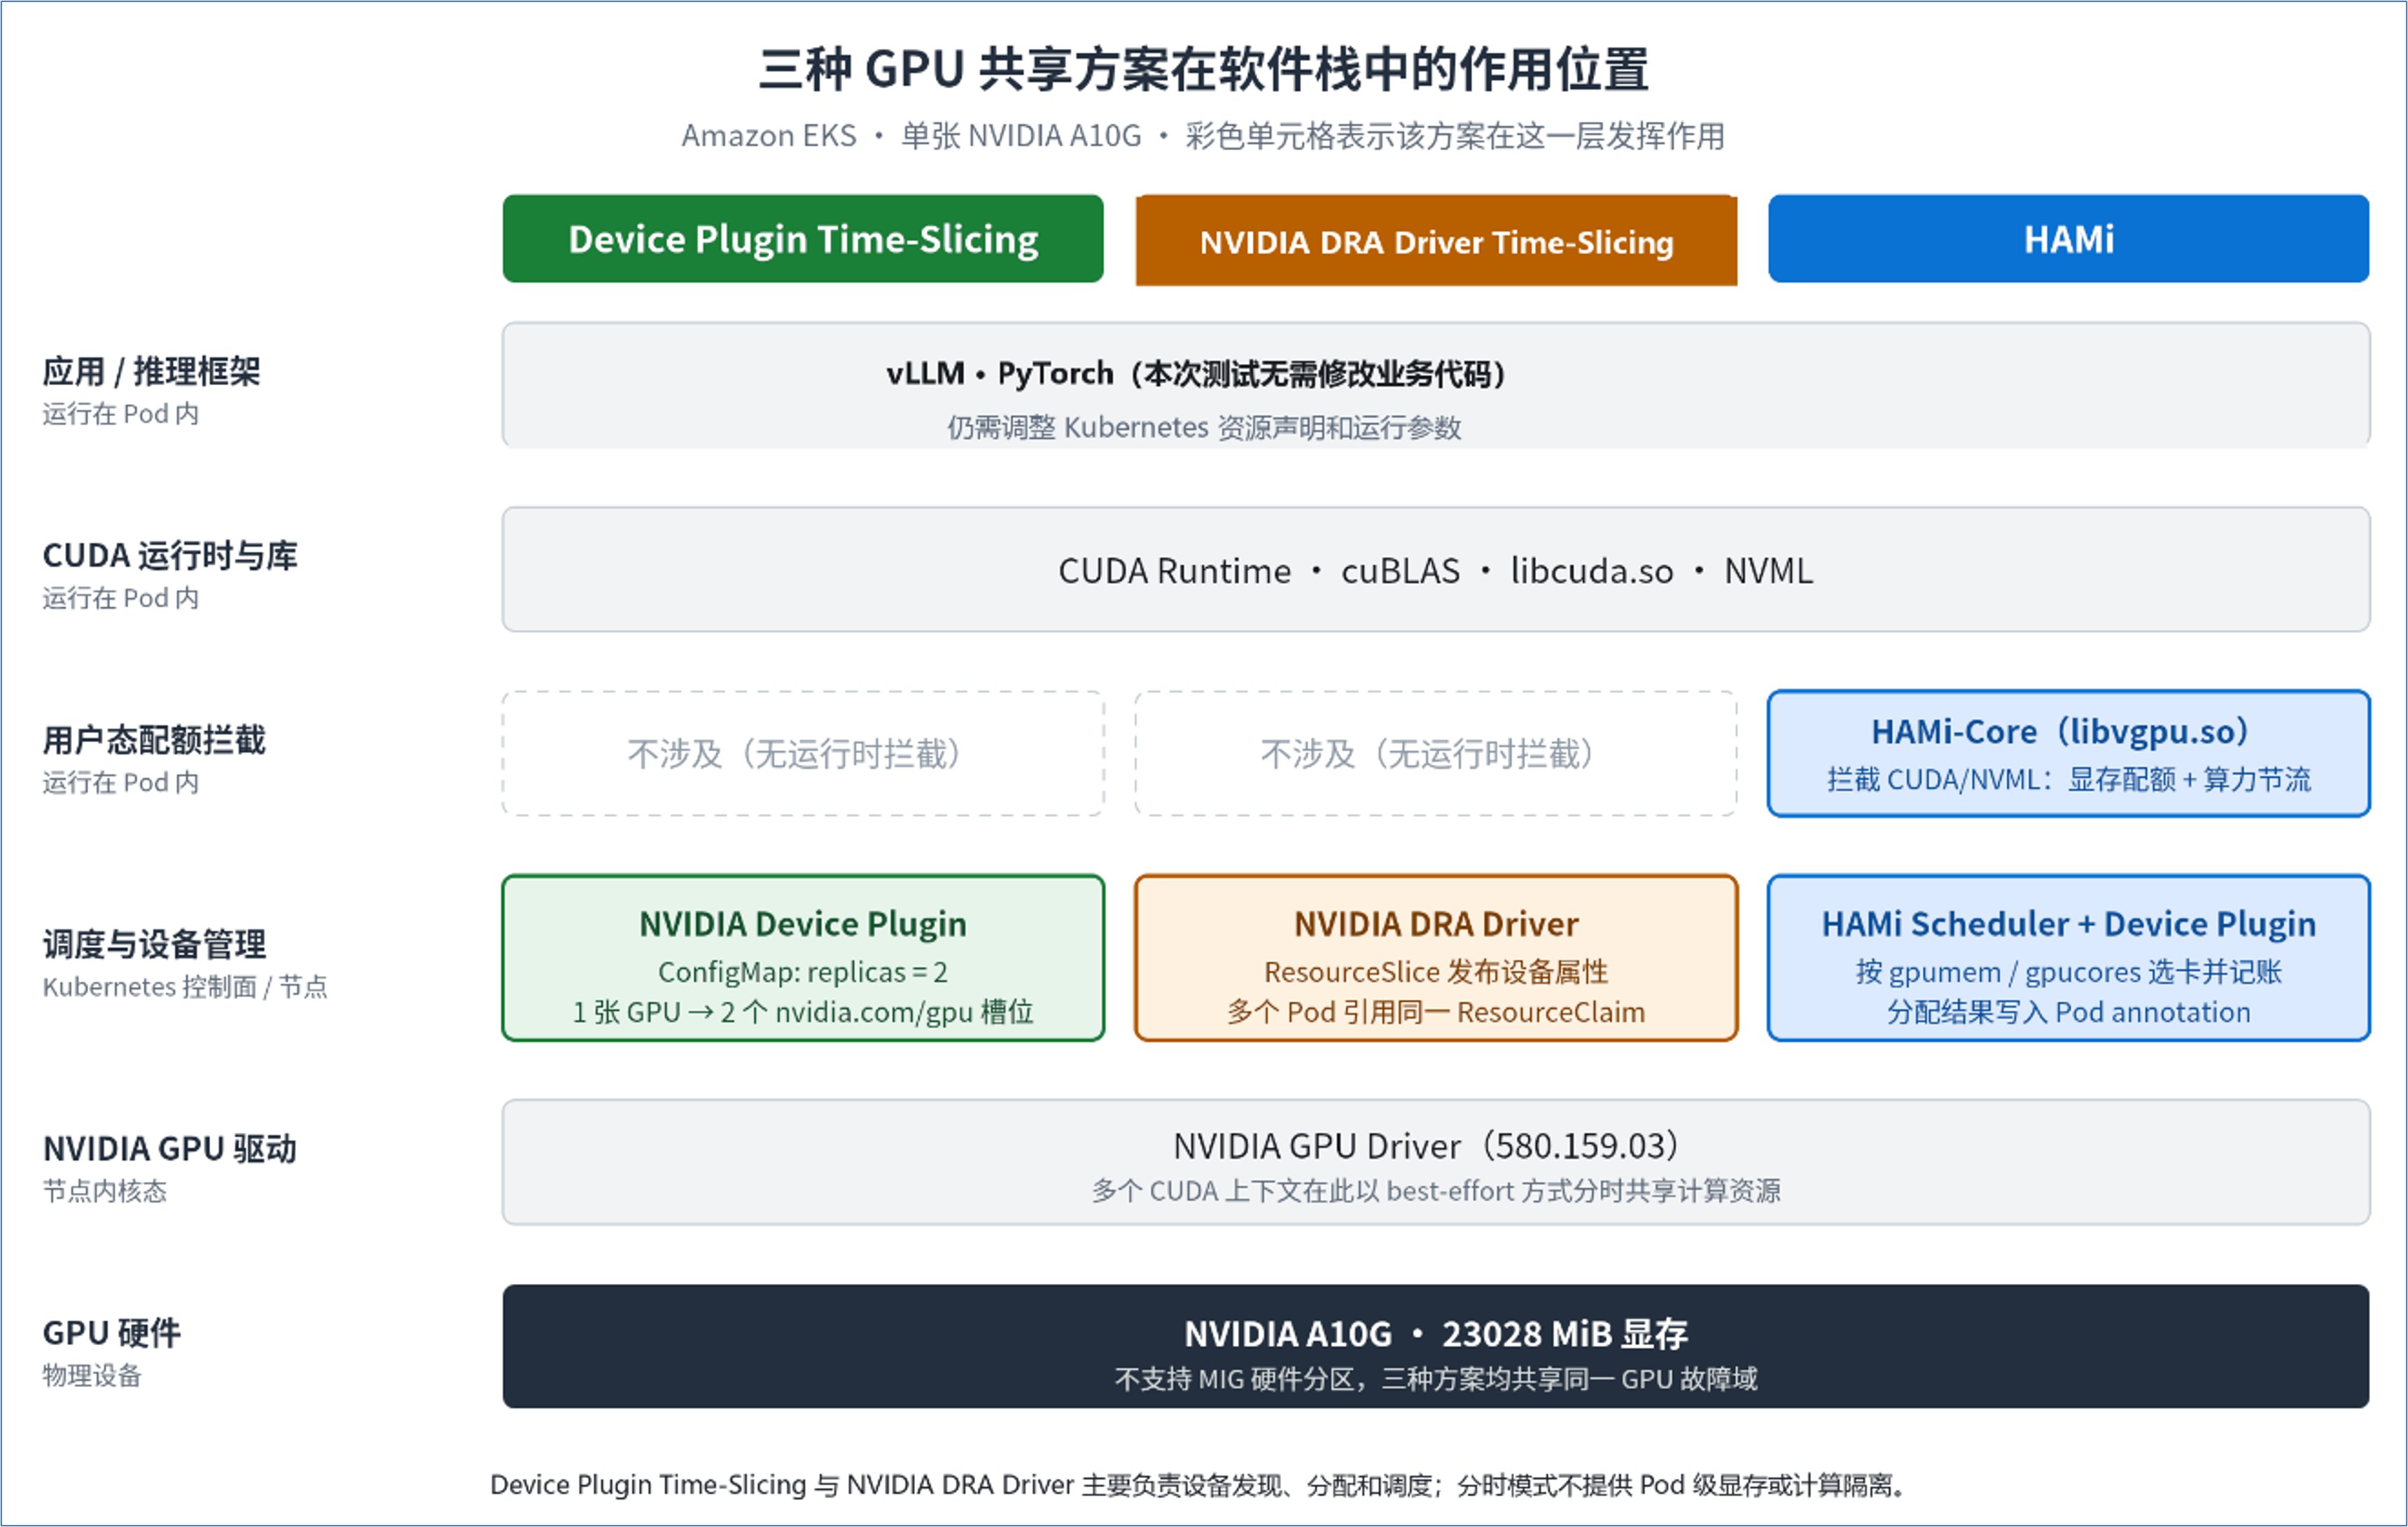
[图 1:Time-Slicing、NVIDIA DRA 与 HAMi 在 GPU 软件栈中的作用位置] |
图 1 展示了三种方案在软件栈中的作用层次。Device Plugin Time-Slicing 与 NVIDIA DRA 主要负责设备发现、分配、准备和调度;本文验证的分时模式不提供 Pod 级显存或算力隔离。HAMi 还会在容器内注入 HAMi-Core,对受支持的 CUDA/NVML 调用执行用户态显存配额和计算节流。三种方案均不要求修改应用代码,但运行参数仍需根据容器可见显存进行调整。
2.2 NVIDIA Device Plugin Time-Slicing
此种 Time-Slicing 方式通过 NVIDIA Device Plugin 将一张物理 GPU 暴露为多个可调度槽位。例如,replicas:2 会让节点报告两个 GPU 访问槽位,使两个分别请求 nvidia.com/gpu:1 的 Pod 可以被调度到同一张物理 GPU 上。这些槽位不预留显存,也不对应固定比例的算力。共享 Pod 可以看到同一张 GPU 的显存,并处于同一个 GPU 故障域;计算资源按尽力而为(best-effort)方式共享,不保证最低算力比例、公平性或延迟。
2.3 NVIDIA Dynamic Resource Allocation
Dynamic Resource Allocation 是 Kubernetes 的结构化设备分配框架。与传统 Device Plugin 只发布整数资源数量不同,DRA Driver 可以通过 ResourceSlice 发布 GPU 型号、显存、UUID 和拓扑等属性;工作负载通过 DeviceClass 和 ResourceClaim 描述设备需求。在 NVIDIA DRA Driver Time-Slicing 中,多个 Pod 通过引用同一个、配置了 Time-Slicing 的 ResourceClaim 显式建立共享关系,并共同使用该 Claim 分配到的物理 GPU。DRA 改进了设备的表达、选择和生命周期管理,但此种 Time-Slicing 方式同样不提供显存或算力隔离。
2.4 HAMi
HAMi 在调度和运行时两个层面处理 GPU 共享。HAMi Scheduler 根据 Pod 请求的显存和计算份额选择节点与 GPU,并通过 annotation 记录分配结果;HAMi Device Plugin 在容器中注入 HAMi-Core 动态库,对受支持的 CUDA/NVML 调用执行显存配额检查和计算节流。HAMi 可以在常规 CUDA 分配路径中强制执行用户态显存配额,但它仍属于软件隔离,不等同于 MIG 硬件隔离,也不能直接作为不可信租户之间的安全边界。直接 Driver API、静态链接、Docker-in-Docker 和特权容器等路径仍需单独评估。
2.5 显存与算力发生竞争时会怎样
在共享机制方面,显存和计算能力存在差异,具体如下:
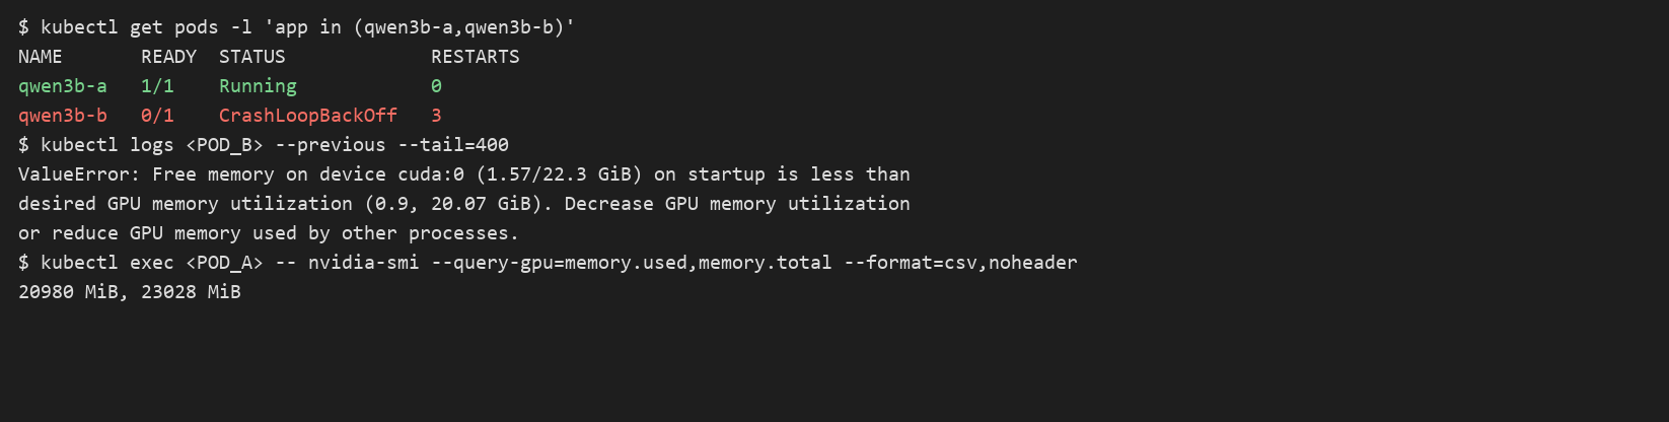
- 显存方面,Device Plugin Time-Slicing 和 NVIDIA DRA Driver Time-Slicing 都不会为每个 Pod 预留显存,已经分配出去的显存也不会因为别的 Pod 申请而被回收。剩余显存不够时,后来的分配请求会失败;至于应用层是报错退出还是降级运行,取决于应用设计本身。vLLM 在启动时会检查可用显存;可用显存不足时,服务无法完成初始化。本次测试中,后启动的服务因此进入 CrashLoopBackOff 状态。
- 计算能力方面,多个活跃 CUDA 上下文通过 NVIDIA GPU 驱动和 GPU 执行调度机制共享计算资源。持续繁忙的工作负载可能增加其他工作负载的排队时间和延迟抖动。Time-Slicing 不承诺 Pod 至少获得固定比例的计算能力。
而 HAMi 在显存和计算能力两层增加了软件配额:调度器记录显存和计算能力预算,HAMi-Core 对受支持的 CUDA 调用执行运行时限制。两个 Pod 使用相同 gpucores 配置并运行对称负载时,本次测试观测到近似均分的计算吞吐。需要注意的是,该结果并不代表严格的算力 SLO。
3. 测试环境、验证范围与方法
3.1 测试环境
| 项目 | 测试配置 |
| 集群 | 标准 Amazon EKS(非 EKS Auto Mode),Kubernetes 1.34 |
| 区域 | 中国(宁夏)区域 cn-northwest-1 |
| GPU 节点 | 1 × g5.2xlarge,EKS 优化的 AL2023 NVIDIA AMI |
| GPU | 单张 NVIDIA A10G,nvidia-smi 报告显存 23028 MiB |
| 宿主机 NVIDIA Driver | 580.159.03 |
| NVIDIA Device Plugin | 0.17.4 |
| NVIDIA DRA Driver | 0.5.0 |
| HAMi | 2.9.0 |
| GPU 节点供给 | eksctl 创建的预置 GPU 节点组 |
| nvidia-smi 显示的 CUDA 兼容版本 | 13.0(不等同于容器 CUDA Runtime) |
| 容器 CUDA Runtime / PyTorch CUDA Build | CUDA 13.0(由镜像标签 cu130 标识);PyTorch CUDA Build 随所用 DLC 镜像 |
| 推理镜像 | public.ecr.aws/deep-learning-containers/vllm:0.24.0-gpu-py312-cu130-ubuntu22.04-ec2-soci |
| 模型 | Qwen/Qwen2.5-3B-Instruct |
| 推理引擎 | vLLM 0.24.0 |
三种方案均使用相同的镜像 URI 和 Tag:public.ecr.aws/deep-learning-containers/vllm:0.24.0-gpu-py312-cu130-ubuntu22.04-ec2-soci。镜像 Tag 对应的 Digest 可能随镜像仓库中的版本更新而变化;为了确保环境可复现,建议在测试和生产部署时同时记录并固定 Digest。其余版本见表中配置,复现前应核对 Amazon EKS、NVIDIA、HAMi 和所用 DLC 镜像的兼容性。
3.2 验证范围
本文将验证分为两类:
- 功能验证:确认资源注册、Pod 调度、物理 GPU 共享、显存配额及异常行为是否符合预期;
- 性能趋势观察:在固定请求和固定并发下,观察独占、邻居空闲和双活跃时的单请求延迟、单流 tokens/s 与并发聚合 tokens/s。
Time-Slicing 和 HAMi 使用同一个 vLLM 模型及 bench.sh 观察性能变化。NVIDIA DRA Driver Time-Slicing 使用两个持续 180 秒的 FP16 GEMM 工作负载,验证两个 Pod 能否通过同一 Claim 访问同一张 GPU,并在同一测试窗口内持续执行 GEMM;vLLM 性能趋势比较聚焦 Time-Slicing 和 HAMi。
3.3 vLLM 性能观察方法
请求从推理 Pod 内访问 localhost:8000,避免 kubectl port-forward 带来的额外网络转发影响。测试包含预热、串行请求和 10 并发请求,覆盖如下测试项:
| 测试项 | 口径 |
| 测试入口 | 从推理 Pod 内访问 localhost:8000 |
| 预热 | 每个场景完成预热后开始统计 |
| 单请求测试 | 串行执行 5 次并取平均值 |
| 并发测试 | 每个服务 10 并发 |
| 输入 | 一句要求模型生成约 150 字中文介绍的指令 |
| 输出上限 | max_tokens=200,由 bench.sh 指定 |
| 实际输出 tokens | bench.sh 读取 vLLM 返回的 usage.completion_tokens;逐请求打印“输出 tokens”,并发测试结束后打印“总输出 tokens” |
| 采样参数 | temperature=0.7、max_tokens=200 由 bench.sh 指定;top_p、top_k 来自模型 generation_config.json;vLLM 引擎 seed=0 |
测试方法为:
- 独占基线:卡上只运行一个推理服务;
- 邻居空闲:两个服务已加载到同一张卡,但只向其中一个发送请求;同卡的另一个服务下文简称“邻居服务”;
- 双活跃:两个服务同时接收请求。
单请求输出速率(tokens/s)用于观察单个请求的变化。双活跃测试由两个服务独立发起,服务 A 与服务 B 的吞吐之和用于观察整体趋势;如需量化精确的上下文切换开销,可采用同步压测方法单独评估。生产环境还应结合实际流量验证 TTFT、P95/P99、队列时间、错误率和长期稳定性。
4. NVIDIA Device Plugin Time-Slicing 验证
4.1 配置 Time-Slicing
以下 ConfigMap 将每张 nvidia.com/gpu 声明为两个共享槽位:
通过 Helm 安装或更新 NVIDIA Device Plugin,并确保插件加载该 ConfigMap:
验证节点把 1 张卡广播为 2 个
为了让 NVIDIA Device Plugin 加载前面创建的 Time-Slicing ConfigMap,并且只部署到本次测试使用的 GPU 节点,本次通过 nvdp-values.yaml 指定 ConfigMap 名称和目标节点标签。Node Feature Discovery(NFD)为测试节点生成的标签与 Chart 默认的 node affinity 不匹配,因此这里将 affinity 设置为 null,再通过 nodeSelector 选择带有 gpu-sharing: timeslice-test 标签的节点。具体配置如下:
插件加载配置后,节点报告的 nvidia.com/gpu 资源数量会从 1 变为 2,表示一张物理 GPU 被注册为两个共享资源槽位。这些槽位只表示允许调度的共享数量,不代表预留了显存或固定比例的算力。本次测试只配置了 replicas:2,未启用 renameByDefault 和 failRequestsGreaterThanOne。
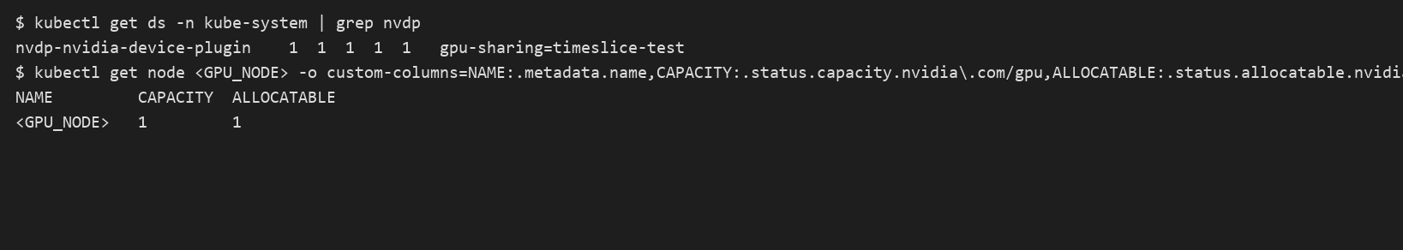
Time-Slicing 功能启用前:
[图 2:Time-Slicing 启用前后节点可调度 GPU 槽位变化-1] |
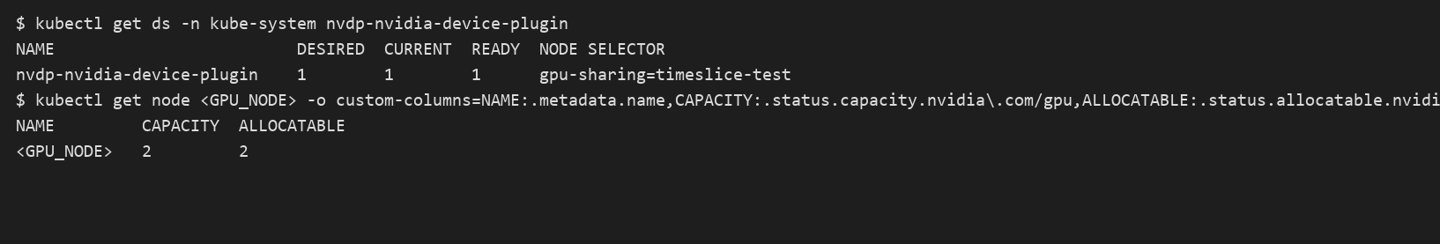
Time-Slicing 功能启用后:
[图 3:Time-Slicing 启用前后节点可调度 GPU 槽位变化-2] |
启用前,节点仅报告 1 个 nvidia.com/gpu;加载 replicas:2 的 Time-Slicing 配置后,Capacity 和 Allocatable 均变为 2,说明同一张物理 GPU 已对 Kubernetes 暴露为两个可调度槽位。
- 插件 DaemonSet 的 DESIRED 为 0:Chart 默认的 node affinity 会匹配 feature.node.kubernetes.io/pci-10de.present、feature.node.kubernetes.io/cpu-model.vendor_id=NVIDIA 或 nvidia.com/gpu.present。本次测试节点上的 NFD 标签为 feature.node.kubernetes.io/pci-0302_10de.present,因此在 values 中设置 affinity: null,并改用 nodeSelector 选择节点。复现时应以目标节点的实际标签为准。
- 集群中已存在默认 Device Plugin:本次 eksctl 创建流程自动安装了 nvidia-device-plugin-daemonset。启用自定义 Time-Slicing 插件前,应先移除默认实例,避免两个 Device Plugin 同时管理 GPU;也可以在创建集群时使用–install-nvidia-plugin=false。具体参数和默认行为以所用 eksctl 版本为准。
4.2 部署两个推理服务
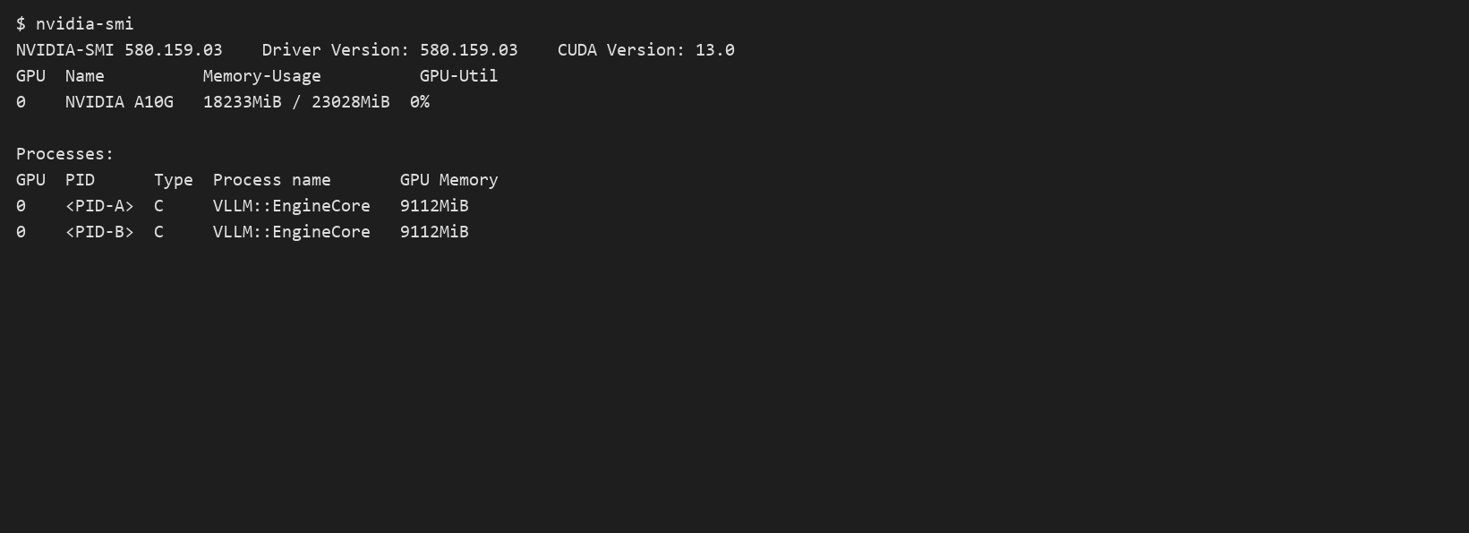
两个独立 vLLM 服务均加载 Qwen2.5-3B-Instruct。使用相同模型可以控制模型结构、显存占用和请求差异。本文主要关注 GPU 工作负载共享与隔离,并非模型之间的性能差异。共享模式中,每个服务配置–gpu-memory-utilization=0.40,即该 vLLM 实例按照容器可见 GPU 显存的 40%规划可使用的显存预算。两个 Pod 分别请求一个 nvidia.com/gpu 共享资源槽位,并采用顺序启动方式降低同时初始化时的显存峰值竞争。部署完成后,在节点侧使用 nvidia-smi 检查两个推理进程的显存占用,结果如图 4 所示。
[图 4:两个独立vLLM推理服务共享同一张 A10G] |
图 4 中的 nvidia-smi 输出显示,同一张 A10G 上同时存在两个 VLLM::EngineCore 进程,二者分别占用 9112 MiB(约 8.9 GiB)显存,各占 A10G 可见总显存的约 39.6%,与–gpu-memory-utilization=0.40 的设置基本一致。
4.3 功能验证结果
本次功能测试验证结果如下:
| 验证项 | 默认整卡分配 | Time-Slicing |
| 节点报告资源 | nvidia.com/gpu: 1 | nvidia.com/gpu: 2 |
| 同卡运行的测试服务数 | 1 | 2 |
| 第二个服务 | Pending,提示 GPU 不足 | Running |
| 两个服务所在位置 | 不适用 | 同一 GPU 节点、同一张 A10G |
| 共享时显存隔离 | 不适用:默认只分配给一个 Pod | 无 |
| 共享时算力保证 | 不适用:默认只分配给一个 Pod | 无 |
4.4 性能趋势观察
测试使用一条要求模型生成约 150 字中文介绍的指令,max_tokens 设置为 200。以下数据反映本次环境中的性能变化。
| 场景 | 单请求平均延迟 | 单请求输出速率(tokens/s) | 10 并发聚合 tokens/s |
| 独占基线 | 2.17 s | 63.5 | 460.6 |
| 邻居空闲,只压测服务 A | 1.99 s | 64.4 | 464.9 |
| 双活跃,服务 A | 3.88 s | 31.0 | 222.4 |
| 双活跃,服务 B | 3.87 s | 31.0 | 214.0 |
| 双活跃,服务 A 与服务 B 吞吐之和 | — | 62.0 | 436.4 |
邻居空闲时,活跃服务的单请求输出速率接近独占基线。两个服务运行相同负载并同时活跃时,单请求输出速率均约为 31 tokens/s,约为独占基线的一半。该结果反映本次负载下的变化趋势;Time-Slicing 本身不为每个 Pod 固定分配 50%计算能力。双活跃场景的统计口径见 2.3。
4.5 显存超配验证
为验证显存超配场景,将两个 vLLM 服务的–gpu-memory-utilization 均设置为 0.90 并按顺序启动,随后检查第二个服务的启动状态和整卡显存使用情况。结果见图 5。
[图 5:Time-Slicing 不提供显存配额,显存超配导致后启动服务初始化失败] |
图 5 同时保留了两种观察口径:nvidia-smi 显示整卡已用显存为 20980 MiB,vLLM 启动检查报告可用显存为 1.57 GiB。无论采用哪一口径,剩余显存都无法满足第二个服务约 20.07 GiB 的启动目标。该结果说明 Time-Slicing 不会根据共享槽位数量自动划分显存,生产环境需要结合模型权重、KV Cache、最大上下文、并发和运行时开销制定显存预算。
5. NVIDIA DRA 功能验证
5.1 安装与设备发现
本次采用 host-provided 模式安装 NVIDIA DRA Driver,不安装 GPU Operator。安装前,应确认同一 GPU 节点上没有其他组件正在分配相同设备,例如 NVIDIA Device Plugin 或 HAMi Device Plugin,避免底层设备被重复分配。下面的安装命令同时通过 featureGates.TimeSlicingSettings=true 启用后续测试所需的 Time-Slicing alpha 功能。
安装完成后,集群发布 gpu.nvidia.com DeviceClass,目标 GPU 节点通过 ResourceSlice 发布 A10G 设备及 23028 MiB 显存等属性。这里的 23028 MiB 用于描述设备能力,不表示多个独立 ResourceClaim 可以按照该数值切分和分配部分显存。
5.2 独占 Claim 的分配与回收
第一个 ResourceClaim 分配到 gpu-0 后,对应 Pod 进入 Running。由于节点只有一张 A10G,第二个独立整卡 Claim 保持 Pending。删除第一个 Pod 及其 ResourceClaim、释放 GPU 后,第二个 Claim 获得该设备,表明 DRA 能够维护设备库存并回收资源。
5.3 NVIDIA DRA Driver Time-Slicing
前一节验证的是 NVIDIA DRA Driver 默认的整卡分配能力。要让多个 Pod 通过 DRA 共享同一张 GPU,还需要使用 NVIDIA DRA Driver 提供的 Time-Slicing 扩展。本文使用的 0.5.0 版本在测试时处于 alpha 阶段,默认不启用,因此安装 Driver 时需要通过–set featureGates.TimeSlicingSettings=true 显式开启。该开关属于 NVIDIA DRA Driver 自身的功能开关,不需要修改 Amazon EKS 控制面的 feature gate。
启用该功能后,需要创建一个将 sharing.strategy 设置为 TimeSlicing 的 GpuConfig,并将其配置在 ResourceClaim 中。多个 Pod 通过引用同一个 ResourceClaim,显式共享该 Claim 分配到的 GPU。由于 ResourceClaim 是命名空间级资源,参与共享的 Pod 必须位于同一命名空间。
以下为关键字段摘录,展示 GpuConfig、ResourceClaim 以及多个 Pod 引用同一个 resourceClaimName 的配置关系:
为验证共享是否生效,本次部署了两个测试 Pod,分别连续运行 180 秒的 FP16 8192×8192 GEMM 计算。测试重点是确认两个 Pod 看到相同的 GPU UUID,并且都能在同一个测试窗口内持续完成计算。测试结果如下:
| 验证项 | 结果 |
| Claim 分配 | 一次分配 gpu-0 |
| reservedFor | 同时包含两个测试 Pod |
| 两个 Pod 看到的 GPU UUID | 相同,证明访问同一张物理 GPU |
| 同一时间窗口执行 | 两个 Pod 在 180 秒内各完成约 5300 次 GEMM,约 29.4 次/秒 |
| GPU 利用率 | SM 利用率在采样期间持续为 100% |
| 显存隔离 | 无;nvidia-smi 显示 23028 MiB,PyTorch 报告 22.30 GiB。两者来自不同 API,仅用于说明 Pod 看到整卡而非独立显存配额 |
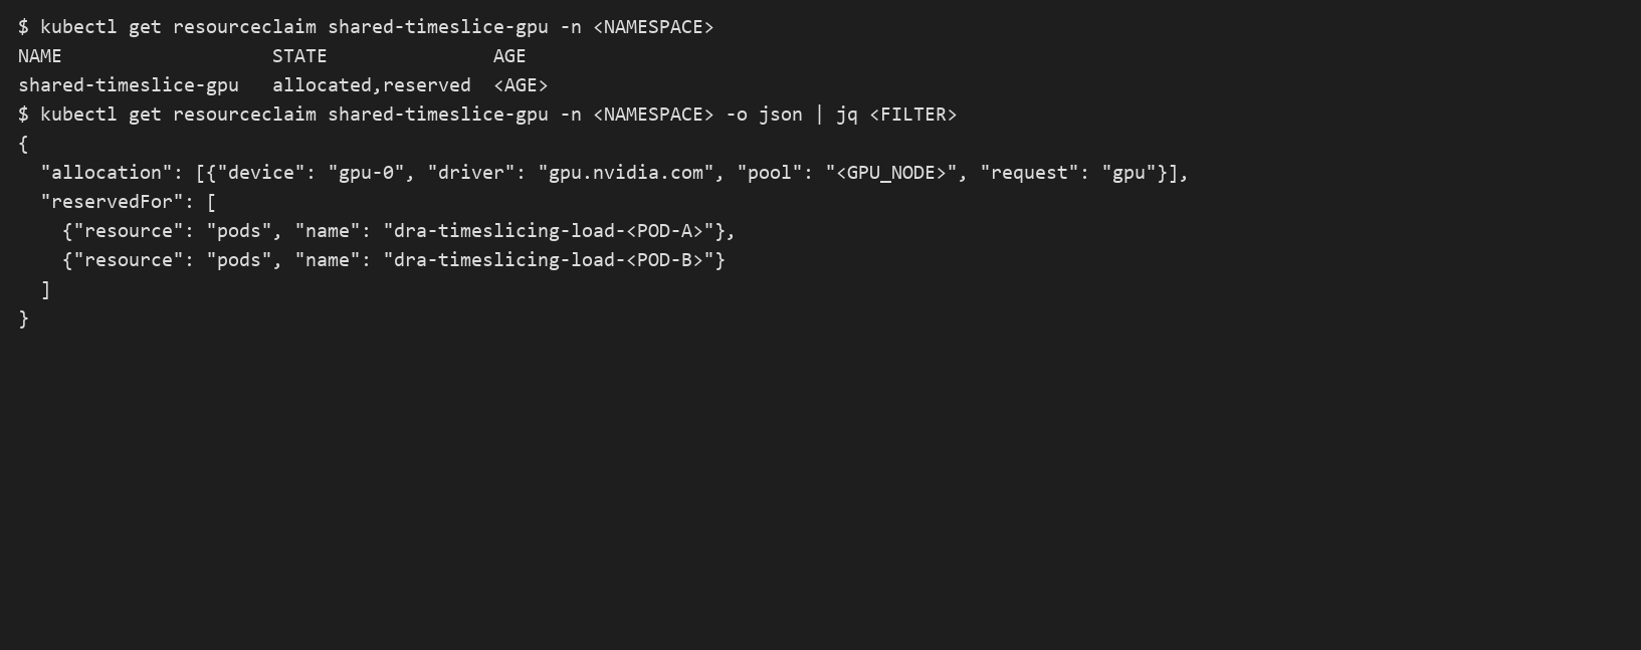
[图 6:同一个 DRA ResourceClaim 被两个 Pod 引用] |
ResourceClaim 的 allocation 结果显示设备为 gpu-0,reservedFor 中同时记录了两个测试 Pod,表明二者显式共享同一个 Claim。
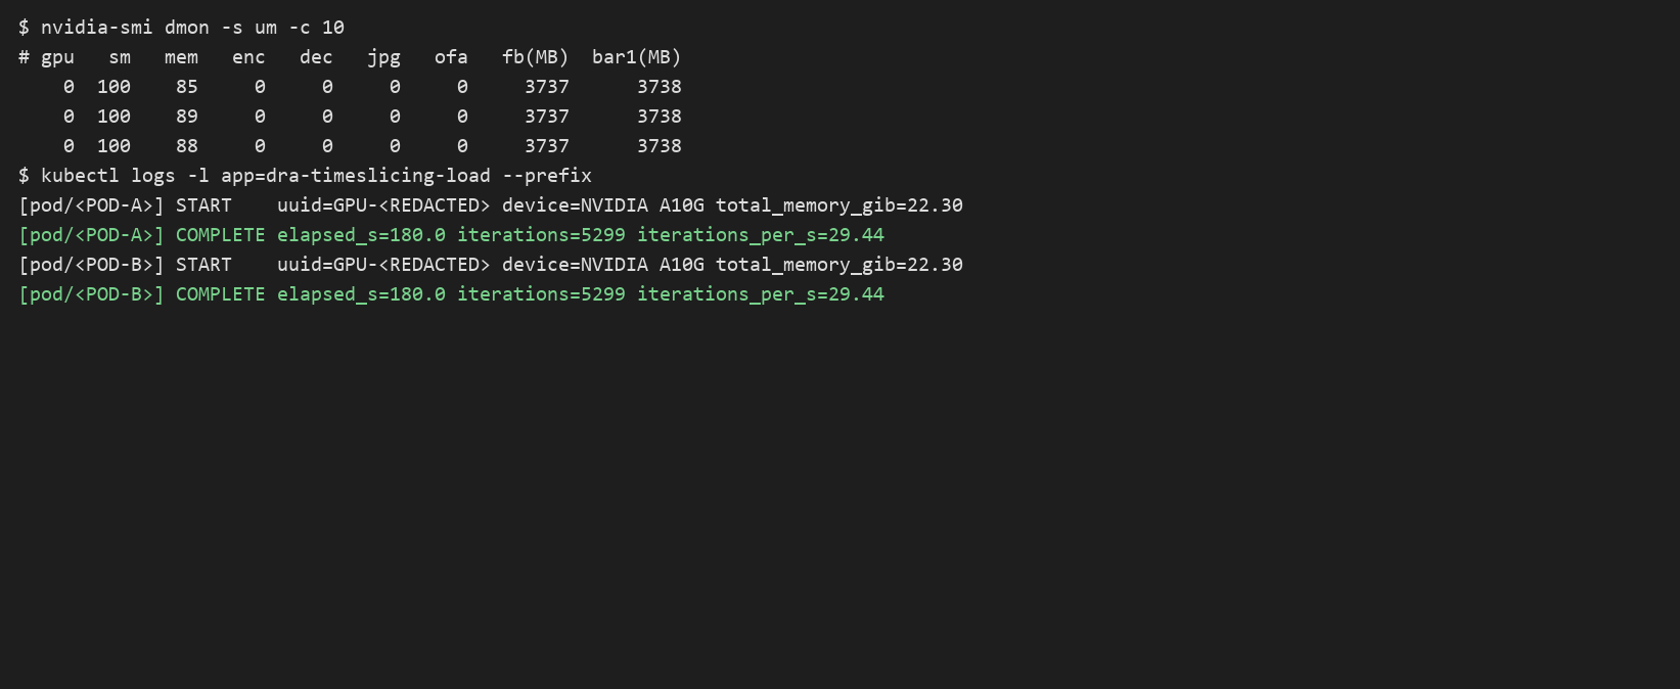
[图 7:NVIDIA DRA Driver Time-Slicing 功能验证] |
两个 Pod 报告相同的 GPU UUID,并在同一个 180 秒窗口内各完成约 5300 次 GEMM;采样期间 SM 利用率持续为 100%。本文据此确认两个工作负载在同一测试窗口内均持续获得 GPU 执行机会;Kernel 级并发不在本次验证范围内。
本文的 DRA 验证范围包括设备发现、Claim 生命周期和 Time-Slicing;Consumable Capacity 可作为后续专项验证内容。本文的选型建议基于已经完成验证的能力。
6. HAMi 功能与推理行为验证
6.1 中国区域镜像准备
HAMi Chart 的部分默认镜像来自公共镜像仓库。中国区域 GPU 节点访问公共仓库时可能出现连接超时,因此可先在能够访问源仓库的环境中拉取 projecthami/hami:v2.9.0、liangjw/kube-webhook-certgen:v1.1.1 以及符合 Kubernetes 组件版本偏差规则的 kube-scheduler 镜像,再同步到本账号的中国区域 Amazon Elastic Container Registry(Amazon ECR)。
镜像同步完成后,通过 Helm values 将 scheduler、extender、patch、devicePlugin 和 monitor 使用的镜像地址指向当前账号在中国区域的 Amazon ECR 仓库。kube-scheduler 镜像版本应遵循 Kubernetes 组件版本偏差规则,不高于 kube-apiserver;具体标签应结合目标 EKS 版本、HAMi Chart values 和 HAMi 兼容矩阵确定。
6.2 节点注册与工作负载配额
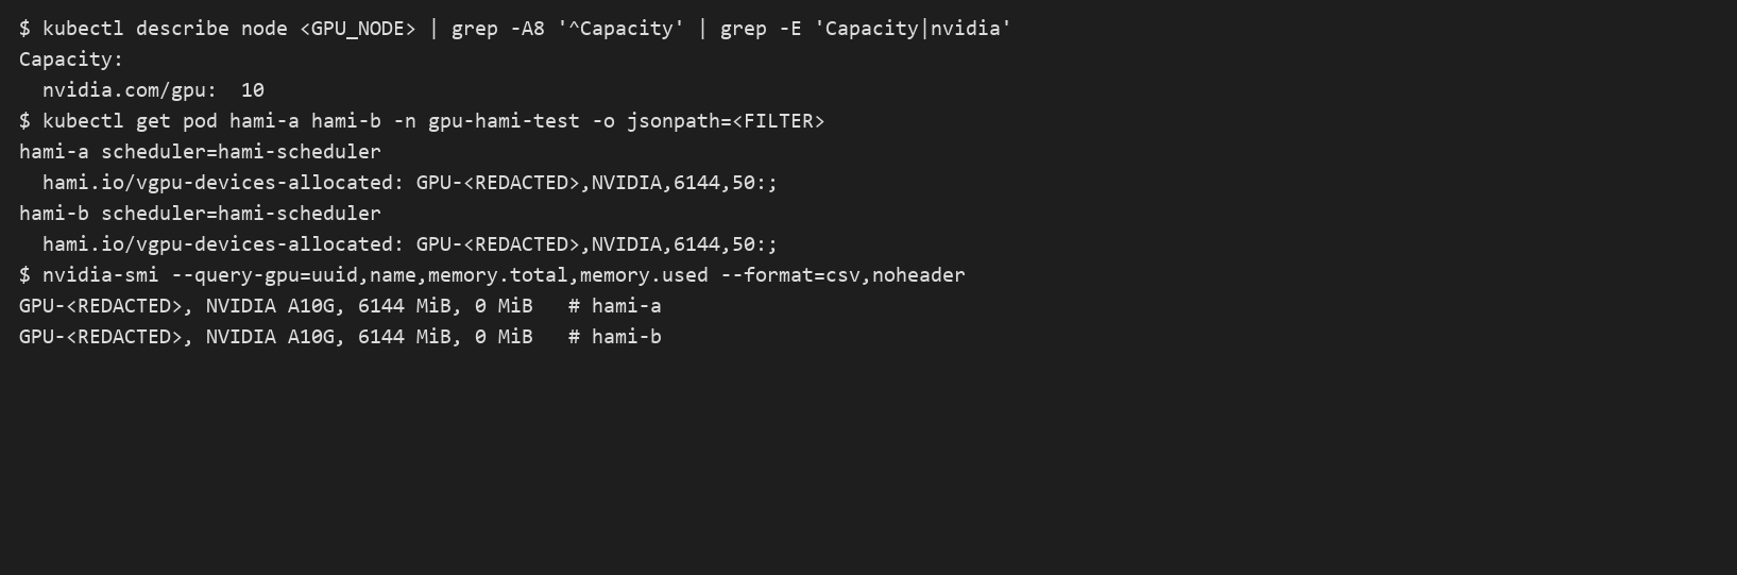
HAMi 安装后,测试节点广播 nvidia.com/gpu:10。这是 deviceSplitCount 定义的逻辑调度槽位上限,不表示节点有十张物理 GPU,也不表示显存被平均切成十份。实际调度还会考虑 Pod 请求的显存和计算份额。
示例资源请求:
本次安装未覆盖 HAMi 2.9.0 Chart 的资源缩放参数,按默认值运行:gpuCorePolicy=default、deviceSplitCount=10、deviceMemoryScaling=1、deviceCoreScaling=1、disablecorelimit=false。gpucores 同时参与调度预算和用户态软件节流;邻居空闲时,工作负载仍可能使用空闲计算能力。如果将 deviceMemoryScaling 设置为大于 1,调度层可能允许显存超配,需要重新验证 OOM 和邻居影响。
[图 8:HAMi 的逻辑槽位、调度记录和容器显存视图] |
节点报告 10 个逻辑 GPU 槽位;两个 Pod 的分配 annotation 指向同一张物理 GPU,并分别记录 6144 MiB 显存配额和 gpucores=50 的计算份额参数。容器内查询到的可见显存也是 6144 MiB。
6.3 用户态显存配额验证
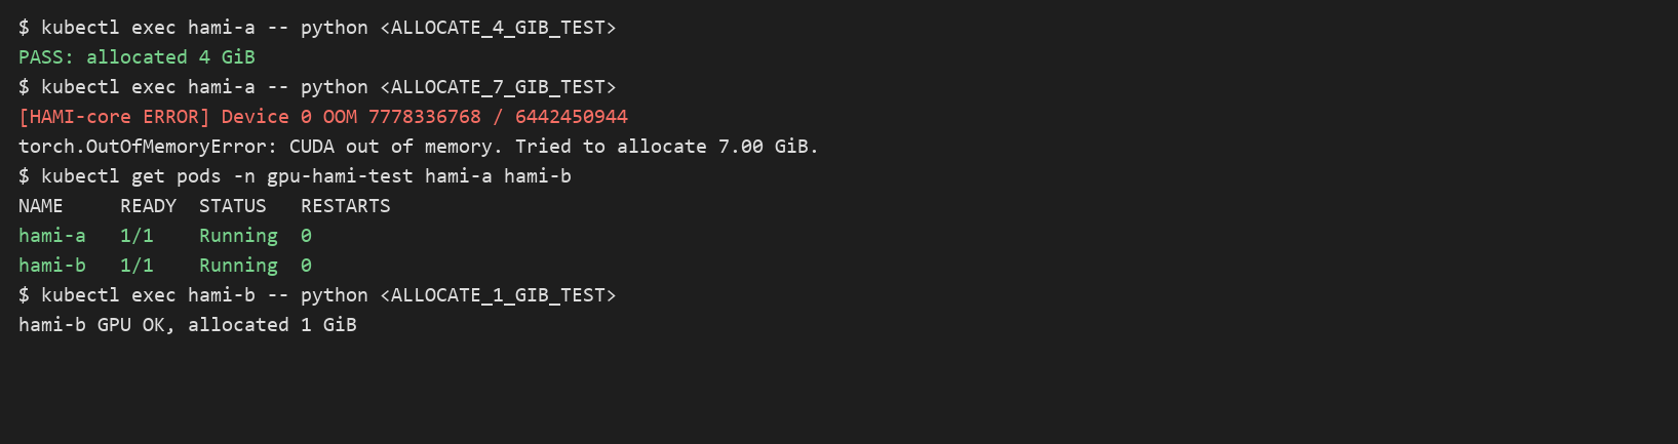
两个 Pod 分别配置 6144 MiB 显存配额,并被调度到同一张 A10G。容器内显存视图均显示 6144 MiB,而不是物理卡的完整 23028 MiB。
| 验证项 | 结果 |
| 两个 Pod 的 GPU UUID | 相同 |
| 容器内显存视图 | 各 6144 MiB |
| 4 GiB 显存分配 | 成功 |
| 7 GiB 显存分配 | HAMi-Core 返回 CUDA OOM |
| 测试进程与邻居状态 | hami-a 的 kubectl exec 测试进程收到 OOM;容器主进程保持 Running,hami-b 仍可分配 1 GiB |
能力边界:生产应用需要捕获 CUDA OOM,并根据业务要求执行降级、重试或退出。HAMi 提供用户态软件配额,不等同于 MIG 硬件隔离。
[图 9:HAMi 用户态显存配额验证] |
图 9 显示,hami-a 中通过 kubectl exec 启动的测试进程成功分配 4 GiB,但 7 GiB 请求收到 CUDA OOM。测试进程退出后,容器主进程仍保持 Running,hami-b 也能继续分配 1 GiB。
6.4 计算份额竞争测试
两个 Pod 均配置 gpucores:50,使用 PyTorch 执行 8192×8192 FP16 矩阵乘,并统计固定 30 秒内的完成次数。
| 场景 | hami-a(次/秒) | hami-b(次/秒) |
| 只压测 hami-a(hami-b 空闲) | 59.5 | — |
| 两个 Pod 同时运行 | 27.0 | 27.0 |
在相同配额和对称负载下,两个 Pod 的完成速率接近。nvidia-smi dmon 显示,双活跃期间 SM 利用率持续为 100%。两个 Pod 的完成速率之和略低于单 Pod 结果,差异可能来自上下文调度和软件节流开销。
在默认策略下,无竞争的工作负载可以使用空闲算力。需要更严格的计算上限时,可评估相应的强制策略,并在目标负载上验证;该能力仍属于用户态软件节流。
6.5 HAMi 下的 vLLM 行为
两个 Qwen2.5-3B vLLM 服务分别配置 gpumem:10240、gpucores:50,并将 vLLM 的–gpu-memory-utilization 设置为 0.85,使推理引擎在 HAMi 提供的 10240 MiB 视图内规划显存。
| 场景 | 单请求输出速率(tokens/s) | 平均延迟 | 10 并发聚合 tokens/s |
| 单服务无竞争基线 | 约 67.4 | 约 2.0 s | 约 485 |
| 邻居空闲 | 约 67.4 | 约 1.9 s | 约 450 |
| 双活跃,两个服务分别观察 | 各约 31 | 约 3.9–4.7 s | 各约 210–299 |
本次 vLLM 测试中,HAMi 与 Device Plugin Time-Slicing 呈现相似趋势:邻居空闲时,单请求输出速率接近单服务基线;两个对称服务同时活跃时,每个服务的单请求输出速率约降至基线的一半。HAMi 额外提供用户态显存配额和计算节流,但也增加了组件、动态库注入和兼容性验证方面的运维成本。
表中的“单服务无竞争基线”仍保留 gpucores:50。结果显示,无竞争场景下工作负载可以使用空闲算力;更细粒度的节流行为可以结合 HAMi 运行指标和 GPU 监控数据进一步分析。
7. 横向对比与选型建议
7.1 能力与部署边界对比
| 维度 | Device Plugin Time-Slicing | NVIDIA DRA Driver Time-Slicing | HAMi |
| 主要接口 | nvidia.com/gpu 共享槽位 | DeviceClass / ResourceClaim | gpu + gpumem + gpucores |
| 同卡多 Pod | 支持,静态槽位 | 支持,共享同一 Claim,alpha | 支持 |
| 显存配额 | 无 | 本次验证的 Time-Slicing 无 | 有,用户态软件配额 |
| 计算份额控制 | 无 | 无 | 有(用户态软件节流,非硬件 SLO) |
| 设备属性选择 | 主要依赖节点标签 | ResourceSlice + CEL | HAMi Scheduler 与 annotation |
| 部署复杂度 | 低 | 中 | 中至高 |
| EKS 与节点供给边界 | 不支持 EKS Auto Mode;与 Karpenter 组合使用 Time-Slicing 时采用静态容量 | Kubernetes 1.34+;不支持 EKS Auto Mode;Karpenter 仅支持静态容量 | 需自管理调度和设备组件,并使用独立 GPU 节点组 |
| 本次验证 | 功能 + vLLM 趋势 | DRA 生命周期 + GEMM 功能 | 功能 + 配额 + vLLM 趋势 |
| 主要边界 | 无显存、算力和故障隔离 | 分时功能为 alpha;无运行时隔离 | 可绕过路径和兼容性需验证;仍共享故障域 |
7.2 性能趋势
| 场景 | Time-Slicing 单请求输出速率(tokens/s) | HAMi 单请求输出速率(tokens/s) |
| 单服务无竞争基线 | 63.5 | 约 67.4 |
| 邻居空闲 | 64.4 | 约 67.4 |
| 双活跃,每个服务 | 31.0 | 约 31 |
两组测试的显存配置参数不同,因此本节聚焦各方案相对于自身基线的变化趋势,不比较方案间的绝对性能高低。两种方案呈现的共同趋势是:邻居空闲时影响较小;两个相似负载同时活跃时,单个服务的吞吐明显下降。
7.3 场景化选型
| 客户需求 | 建议 |
| 小型、低频、流量错峰,希望快速提高承载密度 | 优先评估 Device Plugin Time-Slicing |
| 需要为可信工作负载设置软件显存上限 | 评估 HAMi,并完成绕过路径测试 |
| 需要按比例进行软件计算节流 | 评估 HAMi,不能将其视为硬件级算力 SLO |
| 需要 Kubernetes 原生结构化设备选择和 Claim 模型 | 关注 NVIDIA DRA,并核验具体版本成熟度 |
| 需要更强的硬件级显存和计算资源隔离 | 使用支持 MIG 的 GPU |
| 需要隔离物理 GPU、驱动或节点故障域 | 使用独立 GPU 或独立节点 |
| 关键业务、严格 P95/P99 或长期满载 | 优先独占 GPU |
7.4 容量合并的成本关系
如果两个原本各占一台 g5.2xlarge 的低利用率服务能够合并到一台,并且共享后仍满足容量、可用性和 SLO 要求,则相关实例小时费用理论上可降低 50%。实际单位 Token 成本还需要结合峰值重叠、高可用副本、折扣计划以及共享后的 SLO 达标情况进行评估。
8. 生产使用限制和检查清单
8.1 关键限制
- 本文面向标准 Amazon EKS 集群,不包含 EKS Auto Mode。使用 Device Plugin Time-Slicing 时,Karpenter 会把每个 nvidia.com/gpu 请求按一张物理 GPU 计算,因此应使用静态 GPU 容量。本文版本的 NVIDIA DRA Driver 支持 Karpenter 静态容量、EKS 托管节点组或自管理节点。
- Time-Slicing 和 NVIDIA DRA Driver Time-Slicing 不提供 Pod 级显存或算力隔离,一个工作负载的显存和计算行为可能影响邻居;
- HAMi 依赖用户态动态库注入,对受支持 CUDA/NVML 路径实施配额,不等同于 MIG,不应作为不可信租户之间的安全隔离边界;
- 三种软件共享方式都不能消除物理 GPU、驱动和节点级共享故障域;
- 不应让多个设备管理组件同时分配同一 GPU 节点上的设备。不同方案可使用独立节点组,并通过标签、污点和亲和性隔离;
- NVIDIA DRA Driver Time-Slicing 在本次版本中为 alpha,启用前应接受相应的升级和兼容性风险;
- Time-Slicing 下 DCGM 等工具难以将 GPU 指标准确归因到每个容器,GPU 级指标仍可使用,但需要结合服务端请求指标判断影响。
8.2 生产前检查清单
- 根据实际模型版本、量化方式、上下文长度和并发度,测算模型权重、KV Cache、运行时开销与安全余量;
- 测试单活跃、部分重叠、全活跃和突发流量;
- 验证 TTFT、P95/P99、队列时间、错误率和超时率是否满足 SLO;
- 演练 CUDA OOM、Pod 重启、插件重启、节点重启、GPU Xid、驱动异常和 Spot 中断;
- 对 HAMi 执行 Driver API、静态链接、Docker-in-Docker、特权容器等边界测试;
- 固定并记录节点 AMI、NVIDIA Driver、CUDA、Chart、镜像 digest、模型 revision 和启动参数;
- 使用 Prometheus、Grafana、Amazon CloudWatch 或其他监控系统关联 GPU、Pod、队列和用户体验指标;
- 对关键业务采用独占 GPU 或支持硬件隔离的实例,将共享池用于可降级、低峰值重叠的服务;
- 制定从共享池降低密度或迁移到独占池的回退方案。
9. 总结
本文在相同的实例规格和主要软硬件版本配置下验证了三种 GPU 共享方案。Device Plugin Time-Slicing 部署路径相对直接,适合显存可规划且流量峰值较少重叠的可信工作负载;NVIDIA DRA Driver 提供结构化的设备发现、分配和 Claim 生命周期管理;HAMi 进一步提供用户态显存配额和计算节流。GPU 共享的价值在于复用闲置和错峰容量;底层物理算力以及 GPU、驱动和节点级故障域边界保持不变。生产部署时,应结合实际模型、并发模式、延迟目标和隔离要求完成验证。
➡️ 下一步行动:
相关产品:
- Amazon EKS — 托管式 Kubernetes 服务
- Amazon CloudWatch — 可观测性工具
- Amazon EC2 — 安全且可调整大小的计算容量
相关文章:
- MTP 加速推理最佳实践:在亚马逊云科技中国区使用 llama.cpp 部署 Qwen3.6 的实测指南
- 在 Amazon EKS 上使用 NVIDIA GPU Operator 管理自定义 GPU 驱动与 CUDA 工作负载
- 企业级 EKS 集群生产环境配置最佳实践
- 在 Amazon EC2 GPU 实例上部署 NVIDIA NemoClaw — 以 Amazon Bedrock 作为推理后端的生产级参考架构
- 宣布推出由 NVIDIA RTX PRO 4500 Blackwell 服务器版 GPU 加速的 Amazon EC2 G7 实例
10. 参考资料
- Amazon EKS:Manage hardware devices on Amazon EKS
- Amazon EKS:Use the NVIDIA DRA driver or device plugin
- Amazon EKS:Use time-slicing with NVIDIA GPUs
- AWS Containers Blog:GPU sharing on Amazon EKS with NVIDIA time-slicing and accelerated EC2 instances
- Kubernetes:Dynamic Resource Allocation
- NVIDIA Kubernetes Device Plugin
- NVIDIA DRA Driver for GPUs
- NVIDIA Multi-Instance GPU User Guide:Supported GPUs
- HAMi:GPU Virtualization Principles
- HAMi:Installation
- HAMi:Troubleshooting
- Project HAMi GitHub Repository
*前述特定亚马逊云科技生成式人工智能相关的服务目前在亚马逊云科技海外区域可用。亚马逊云科技中国区域相关云服务由西云数据和光环新网运营,具体信息以中国区域官网为准。
本篇作者
AWS 架构师中心:云端创新的引领者探索 AWS 架构师中心,获取经实战验证的最佳实践与架构指南,助您高效构建安全、可靠的云上应用
|
 |