亚马逊AWS官方博客
Amazon S3 表类数据存储服务现在支持将 Apache Hive 表托管迁移至 Apache Iceberg
今天,我们正式宣布推出一条简单且经济高效的数据湖现代化升级路径。Amazon S3 表类数据存储服务现在支持将 Apache Hive 表托管迁移至 Apache Iceberg。迁移适用于在 AWS Glue Data Catalog 中注册的 Amazon S3 中的 Parquet 表,并使您能够升级数据湖,无需构建管道或预置计算资源,同时生产工作负载仍保持运行。
Apache Iceberg 已成为大型分析数据集的开放标准。该服务让您能够管理 PB 级表,并支持模式演化、隐藏分区和时间旅行查询等功能,同时保持您的数据开放并且可通过任何兼容 Iceberg 的引擎进行查询。Amazon S3 表类数据存储服务提供专为 Iceberg 表在增长时保持性能和成本效益而构建的完全托管式存储,具有自动维护、优化、复制和内置的 S3 智能分层等功能。
新增功能
以前,将 Apache Hive 表迁移到 Apache Iceberg 可能需要数周的工程工作来构建和管理所需的基础设施。转换数据类型和构建回滚功能增加了操作复杂性。现在,它可以作为 API 驱动的托管操作使用。
S3 表类数据存储服务可以处理整个迁移工作流,包括数据验证、兼容性检查、类型转换、文件重新压缩和文件合并。在复制任何数据之前,S3 表类数据存储服务会识别范围内的每个源对象并生成兼容性报告。您可以根据需要多次同步,而不会停止对源表的写入操作,除了切换期间的几分钟之外。准备就绪后,您可以完成迁移,从而最大限度地缩短表格离线的时间。
与自行管理的方法相比,S3 表类数据存储服务托管迁移具有成本效益,因为您只需为复制的数据付费,而无需为 Hive-to-Iceberg 转换付费,而且 S3 智能分层中的源对象保留在其当前访问层中。
首先来了解下迁移
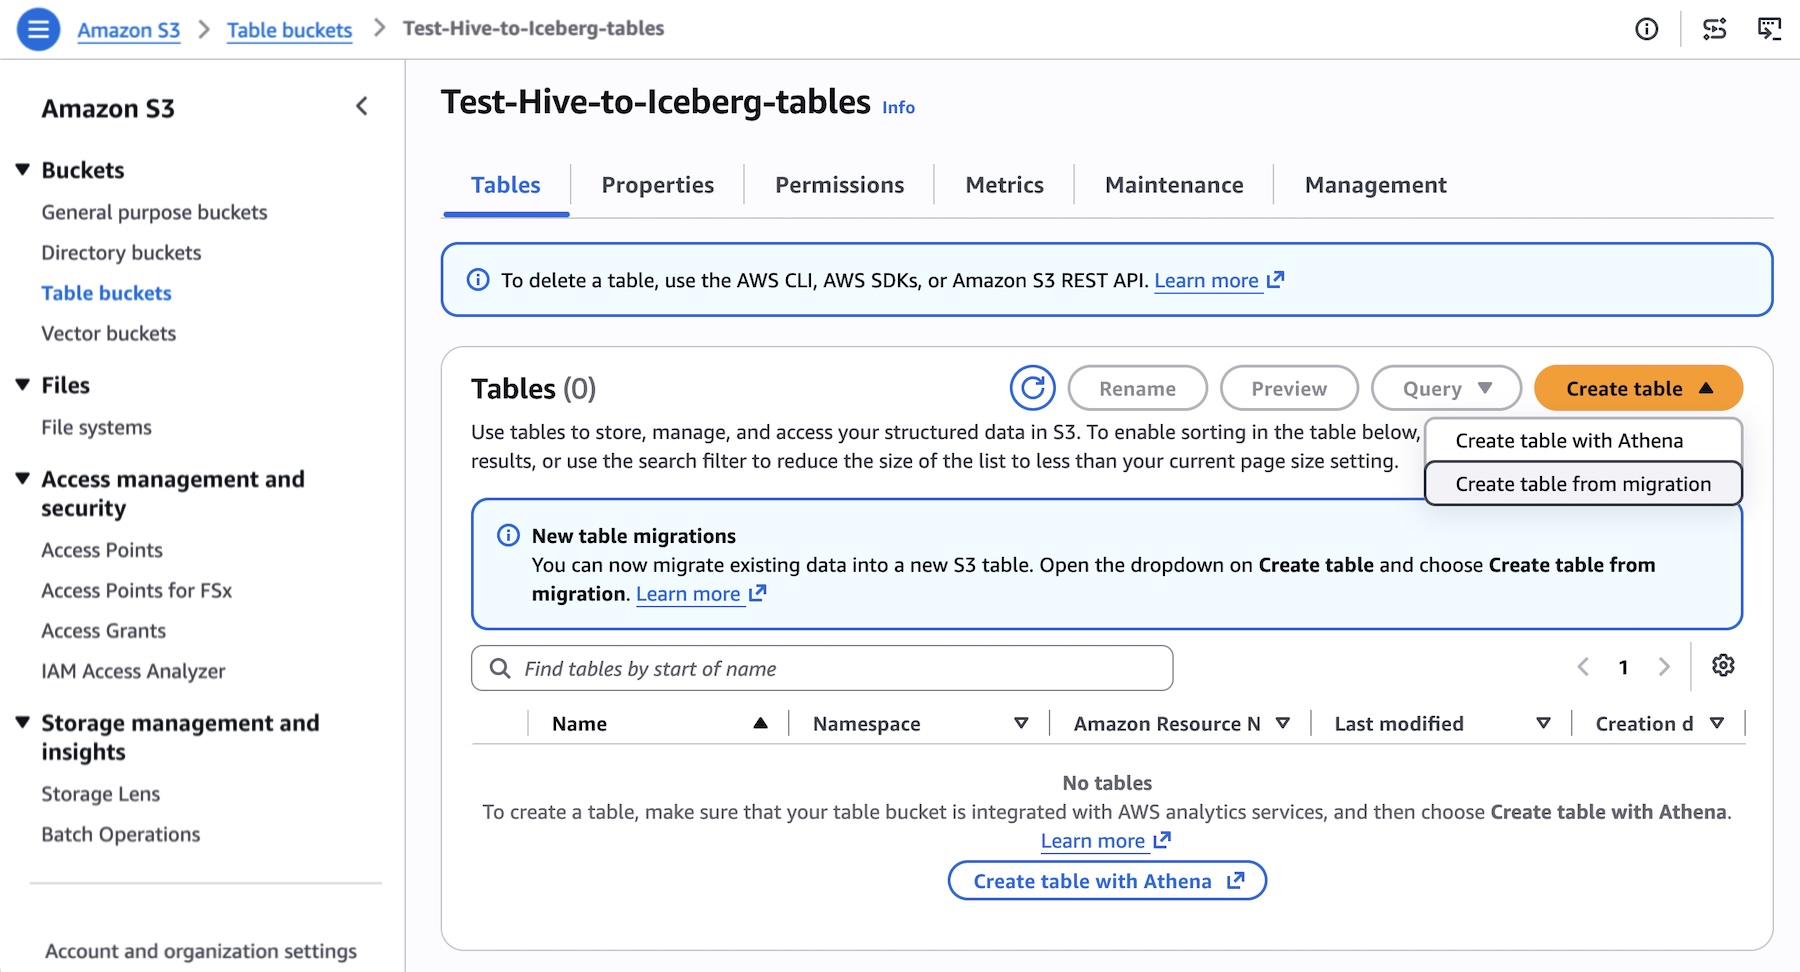
要迁移 AWS Glue Hive 表,请在 S3 控制台中选择您的目标表存储桶,然后选择通过迁移创建表。
为您的目标 Iceberg 表创建命名空间和表名。目标表是使用针对查询性能和存储效率进行调优的推荐默认设置创建的。
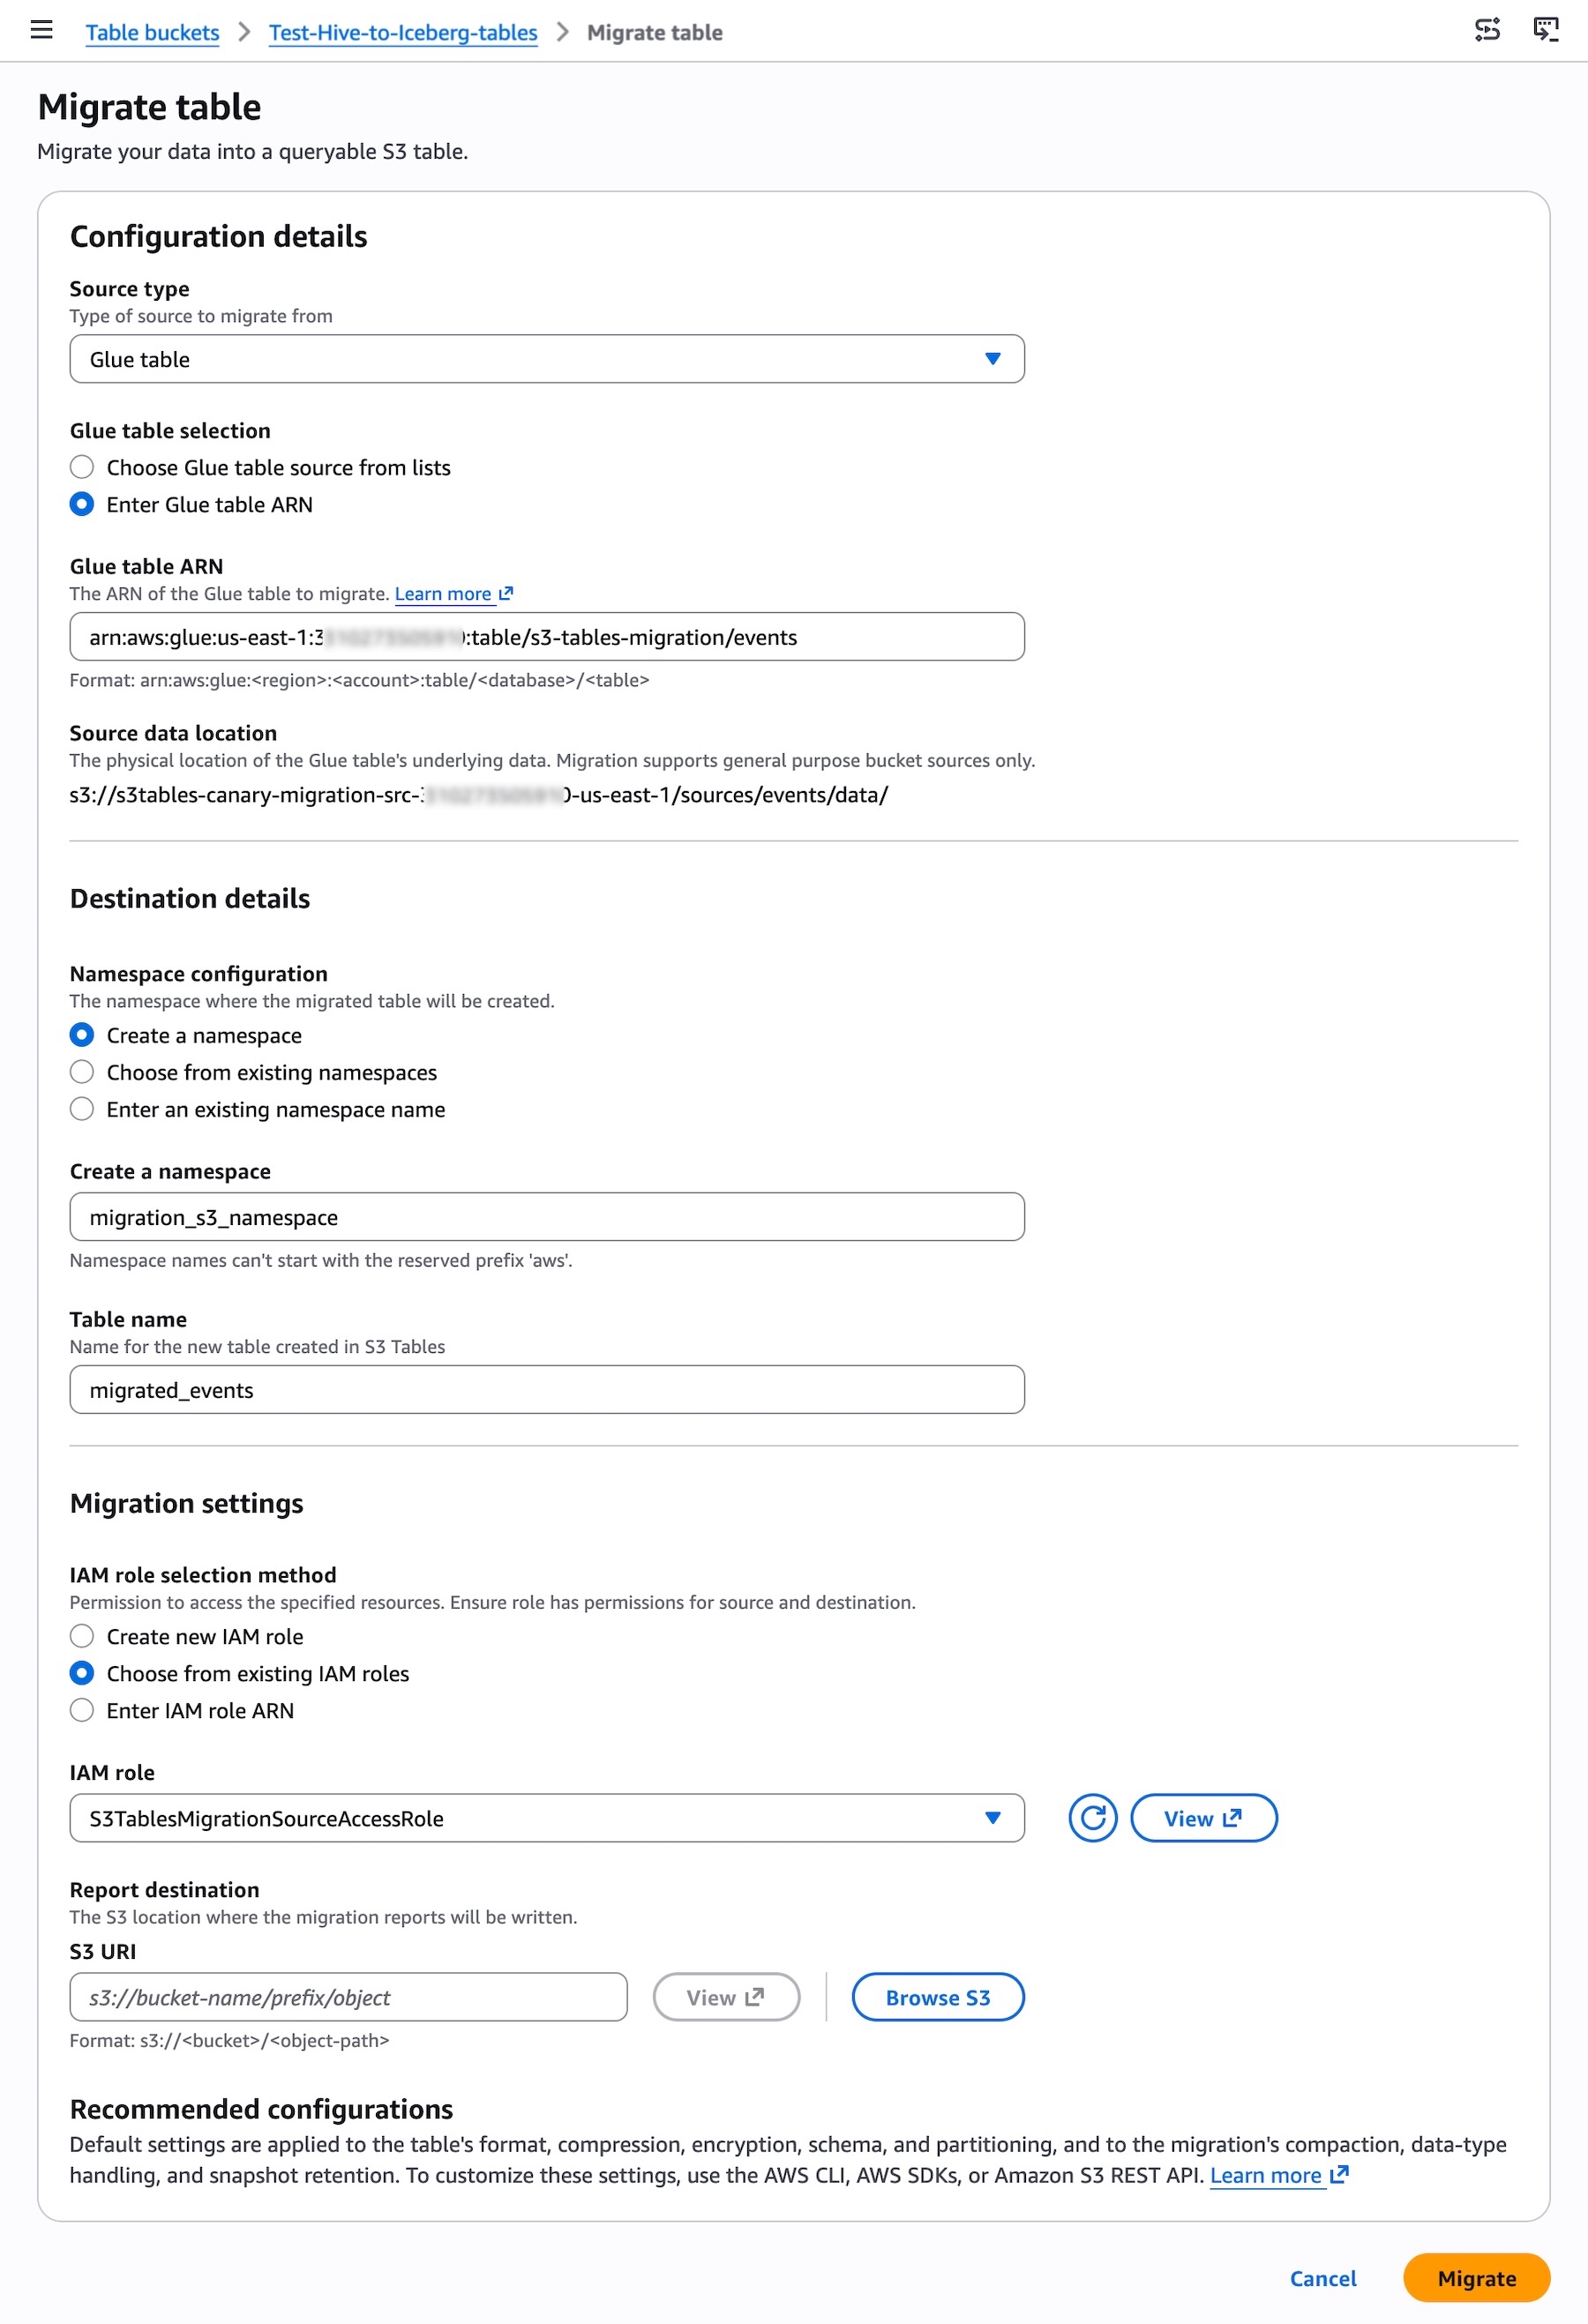
当您开始迁移时,S3 表类数据存储服务会验证源表、生成兼容性报告并开始复制数据。迁移期间,目标表是只读的。完成迁移后,目标表将被提升为读写表。
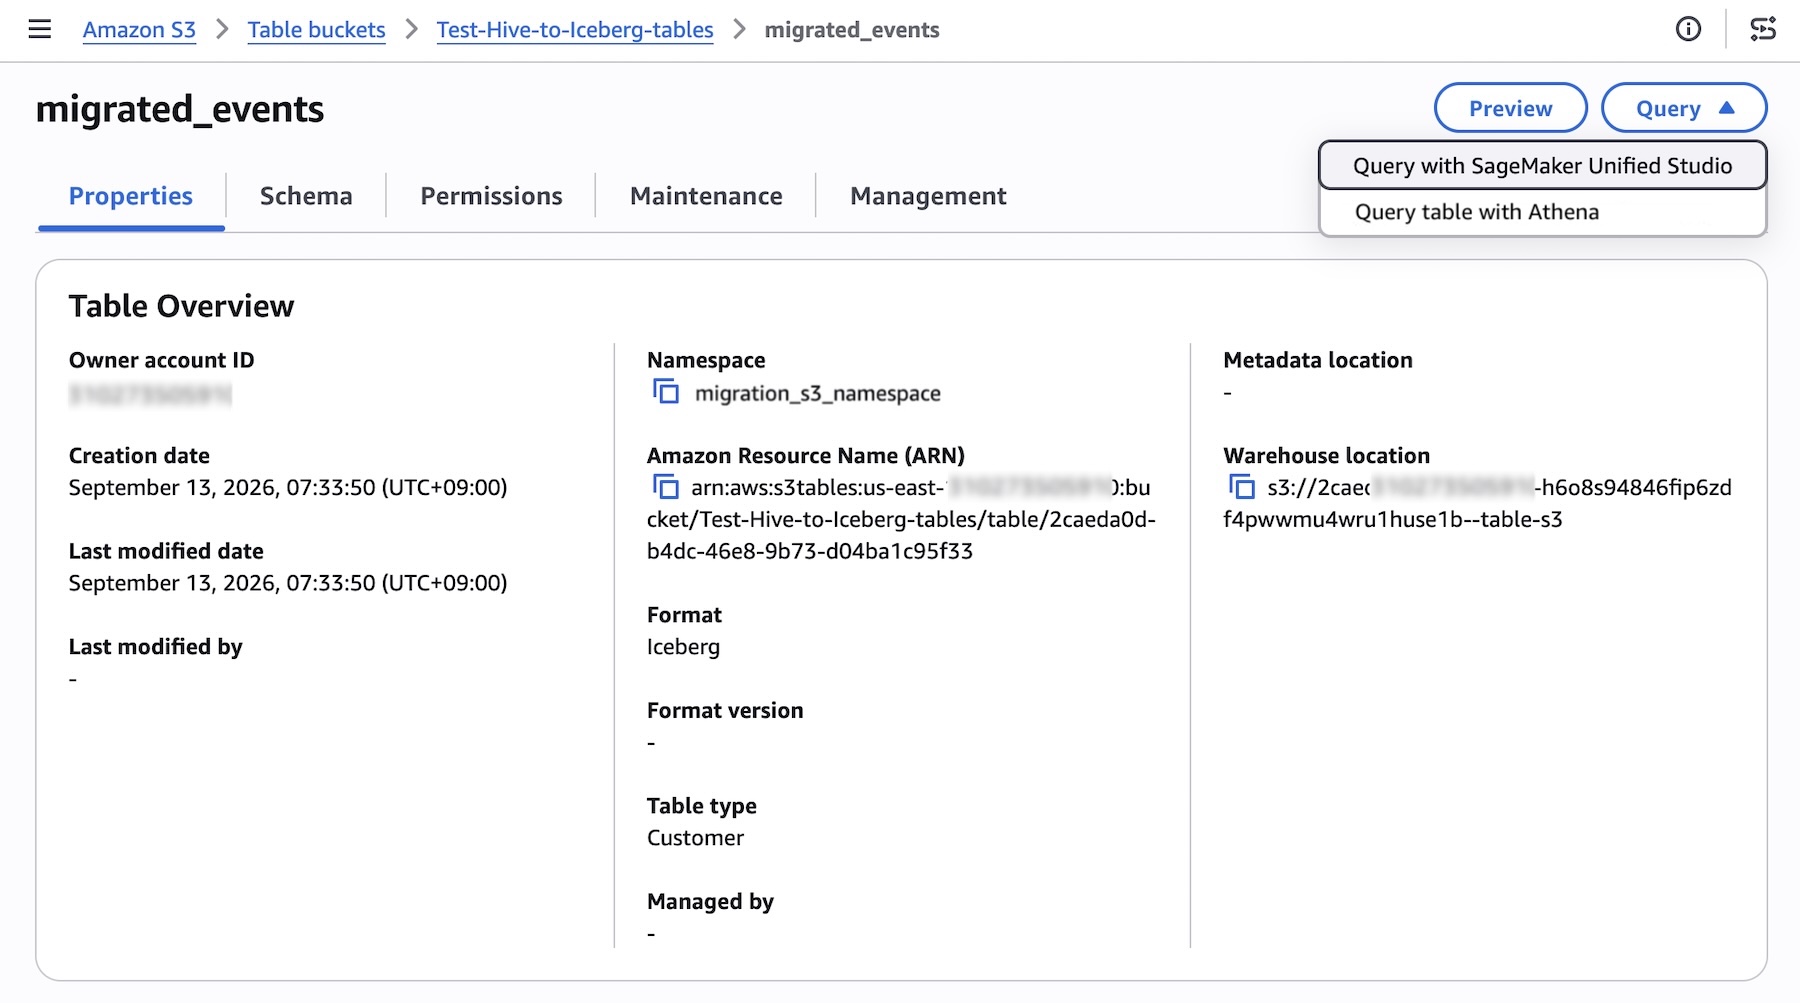
您可以通过在 AWS 管理控制台中直接集成 Amazon Athena 和 Amazon SageMaker 融通式合作开发工作室来立即开始处理数据,也可以使用任何与 Apache Iceberg REST API 兼容的工具直接查询这些表。要了解更多信息,请访问 S3 表类数据存储服务迁移文档。
您还可以使用 AWS 命令行界面(AWS CLI)、AWS SDK 或 Agent Toolkit for AWS。例如,设置迁移作业并调用 start-table-migration 命令。
cat > /tmp/start-migration.json <<'EOF'
{
  "roleArn": "arn:aws:iam::123456789012:role/S3TablesMigrationRole",
  "destinationTable": {
    "tableBucketARN": "arn:aws:s3tables:us-east-1:123456789012:bucket/my-destination-bucket",
    "namespace": "mynamespace",
    "name": "my_destination_table",
    "encryptionConfiguration": {
      "sseAlgorithm": "aws:kms",
      "kmsKeyArn": "arn:aws:kms:us-east-1:123456789012:key/1234abcd-12ab-34cd-56ef-1234567890ab"
    },
    "storageClassConfiguration": { "storageClass": "INTELLIGENT_TIERING" },
    "tags": { "team": "s3tables", "purpose": "migration" },
    "properties": {
      "writeFormat": "parquet",
      "icebergFormatVersion": 2,
      "compressionCodec": "zstd",
      "dictionaryEncoding": true
    },
    "schema": {
      "type": "struct",
      "schema-id": 0,
      "identifier-field-ids": [1],
      "fields": [
        { "id": 1, "name": "id",      "type": "long",   "required": true, "doc": "primary key" },
        { "id": 2, "name": "payload", "type": "string", "required": false }
      ]
    },
    "icebergSortOrder": {
      "orderId": 1,
      "fields": [ { "sourceId": 1, "transform": "identity", "direction": "asc", "nullOrder": "nulls-first" } ]
    }
  },
  "sourceType": "glueTable",
  "source": {
    "glueTable": {
      "catalogId": "123456789012",
      "databaseName": "my_glue_database",
      "tableName": "my_source_table"
    }
  },
  "dataMigration": {
    "maintenanceSettings": {
      "icebergCompaction": { "targetFileSizeMB": 512, "strategy": "binpack" },
      "icebergSnapshotManagement": { "minSnapshotsToKeep": 3, "maxSnapshotAgeHours": 168 }
    },
    "migrationPolicies": {
      "unmatchedSourceFieldsPolicy": "fail",
      "incompatibleValuesPolicy": "fail"
    }
  },
  "reviewMigrationPlan": false,
  "migrationOutput": {
    "bucket": "arn:aws:s3:::my-report-bucket",
    "prefixes": {
      "tableCompatibilityReport": "reports/table-compatibility/",
      "objectCompatibilityReport": "reports/object-compatibility/",
      "objectMigrationReport": "reports/object-migration/"
    }
  }
}
EOF

aws s3tables start-table-migration \
  --cli-input-json file:///tmp/start-migration.json
要使目标表赶上源表中的更改,在完成迁移之前,可以根据需要多次调用 sync-table-migration。每次同步仅复制更改的内容。
如果您使用像 Kiro 这样的编码智能体,Agent Toolkit for AWS 中的 migrating-hive-tables-to-s3-tables 技能可为智能体提供分步迁移指导和安全护栏。该技能可以:
- 分析现有 IAM 策略并推荐等效的目标策略
- 在开始之前验证迁移计划
- 执行开始 → 同步 → 完成 API 调用
- 监控作业进度并指导验证和切换
要了解更多信息,请访问该技能的 GitHub README 页面。
现已推出
Amazon S3 表类数据存储服务托管迁移现已在美国东部(弗吉尼亚州北部、俄亥俄州)、美国西部(俄勒冈州)、亚太地区(孟买、新加坡、悉尼、东京)和欧洲(法兰克福、爱尔兰、斯德哥尔摩)区域提供。该功能在推出时支持以 Parquet 格式存储在同一 AWS 账户和 AWS 区域中的 AWS Glue 注册的 Hive 表。如果您想调用 API、搜索文档、查找区域可用性并对此新功能进行问题排查,请尝试在首选人工智能工具中使用 AWS MCP 服务器和插件。
立即在 Amazon S3 控制台中试用该功能,并向 AWS re:Post for Amazon S3 发送反馈,或通过您常用的 AWS Support 联系方式发送反馈。
— Channy