亚马逊AWS官方博客
基于 Amazon EC2 和 Amazon EKS 一键部署可长期运维的 ClickHouse 集群:方案与实践
摘要:本文介绍一套可以在亚马逊云科技上一键部署、并且可以长期运维的 ClickHouse 集群方案。方案同时提供 Amazon EC2 和 Amazon EKS 两种部署形态,部署、版本升级、扩容、磁盘扩容、监控和备份设置都通过修改 CloudFormation 堆栈参数来完成。
一、前言
ClickHouse 是一个开源的列式 OLAP 数据库,凭借向量化执行、高压缩比和原生的 Shard + Replica 架构,被广泛用于日志分析、用户行为分析、实时报表和计费明细查询等场景。在亚马逊云科技上使用 ClickHouse,除了 ClickHouse Cloud 这类托管服务之外,有相当多的客户出于数据合规、成本或者深度定制的考虑,选择在自己的账号中自建 ClickHouse 集群。
自建集群首先要解决的是“如何快速、正确地把集群搭起来”。但集群搭起来只是第一步,集群上线之后的日常运维才是更大的挑战,主要体现在以下几个方面:
- 协调服务:早期方案依赖 ZooKeeper,需要单独维护一套 Java 服务。ClickHouse 官方现在推荐使用 ClickHouse Keeper,它与 ClickHouse 同版本发布,资源占用更小,也不存在 ZooKeeper 的 zxid 溢出等问题;
- 版本升级:ClickHouse 迭代很快,每年有两个 LTS 版本。手工升级需要逐台节点安装、重启、确认副本追平,节点一多就容易出错,回退也没有章法;
- 扩容与变更:增加分片或副本后,每台节点的
remote_servers配置都要同步修改;修改实例类型、磁盘大小这类操作,稍有不慎就可能触发 CloudFormation 替换实例,造成数据丢失; - 监控与告警:节点宕机、Keeper 失去 leader、副本只读、part 过多、磁盘写满等问题都需要及时发现,自建集群往往缺少开箱即用的监控指标和告警;
- 备份与恢复:很多自建集群没有例行备份,或者备份从未做过恢复演练;
- 容器化部署:越来越多的客户希望把 ClickHouse 运行在 Amazon EKS 上,与其它业务统一管理,但在 Kubernetes 上运行有状态的 ClickHouse 需要处理好存储、调度、权限等一系列问题。
针对这些问题,本文介绍一套可以在亚马逊云科技上一键部署、并且可以长期运维的 ClickHouse 集群方案。方案同时提供 Amazon EC2 和 Amazon EKS 两种部署形态,部署、版本升级、扩容、磁盘扩容、监控和备份设置都通过修改 CloudFormation 堆栈参数来完成。随后我们会在实际环境中对部署、性能、监控、备份以及各类运维操作进行验证。方案的全部代码已开源在 GitHub。
二、方案
方案使用 AWS CDK(TypeScript)编写,并生成两个独立的 CloudFormation 模版:
templates/clickhouse-cluster.template.json:在 Amazon EC2 上部署 ClickHouse 集群;templates/clickhouse-eks.template.json:在 Amazon EKS 上部署 ClickHouse 集群。
模版不依赖任何 Asset 和 cdk bootstrap,所有脚本都内嵌在模版中,可以直接在 CloudFormation 控制台上传使用,也可以通过 AWS CLI 或者 CDK 部署。
2.1 EC2 部署方案
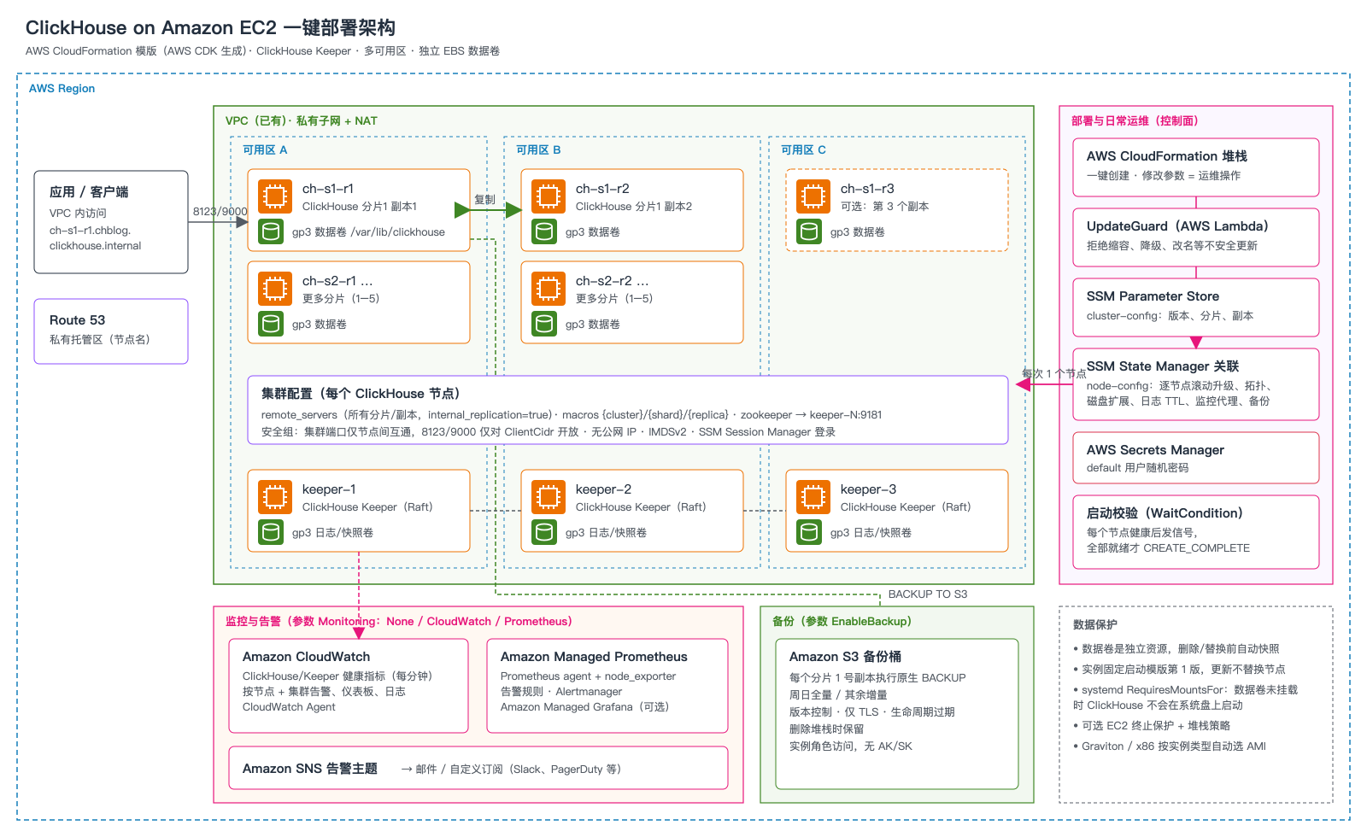
EC2 部署方案的架构如下图所示:
[图 1] |
2.1.1 集群拓扑
- ClickHouse 节点数量 = 分片数(1–5)× 副本数(1–3),节点命名为
ch-s<分片>-r<副本>;每台节点自动生成remote_servers(internal_replication=true)、macros({cluster}/{shard}/{replica})以及指向 Keeper 的zookeeper配置,建表时可以直接使用ReplicatedMergeTree和ON CLUSTER; - ClickHouse Keeper 部署在 1 台(开发测试)或 3 台(生产,Raft 多数派)独立节点上,这也是 ClickHouse 官方推荐的做法;
- 子网分配规则:
MultiAZ=true时,副本和 Keeper 会部署到不同的 AZ 的子网中, 单个可用区故障不会影响集群的读写; - 支持 Graviton(m/r/c 6g/7g/8g)和 Intel/AMD(m/r/c 6i/7i/7a)实例,模版根据实例类型自动选择对应架构的 Amazon Linux 2023 AMI;
- 每个节点在 Route 53 私有托管区中有固定的域名,如
ch-s1-r1.<集群名>.clickhouse.internal,节点 IP 变化不影响客户端和集群配置。
2.1.2 数据保护
ClickHouse 是有状态服务,方案在数据保护上做了以下设计:
- 系统盘和数据盘分离。每个节点的数据盘是一个独立的
AWS::EC2::Volume资源,设置了DeletionPolicy和UpdateReplacePolicy为Snapshot,即使资源被删除或替换,也会先自动创建快照; - 实例固定使用启动模版的第 1 个版本,ClickHouse 版本、集群拓扑等可变配置存放在 SSM Parameter Store 中,由节点启动脚本读取,因此更新堆栈不会导致实例被替换;
- 节点启动时通过
WaitCondition向 CloudFormation 发送信号,只有所有 Keeper 加入集群、所有 ClickHouse 节点可以访问 Keeper 之后,堆栈才会进入CREATE_COMPLETE状态; - 数据卷通过 systemd 的
RequiresMountsFor与 ClickHouse 服务绑定,数据卷未挂载时 ClickHouse 不会启动,避免数据误写到系统盘; - 安全方面,节点不分配公网 IP,集群内部端口只在节点之间互通,8123/9000 端口只对
ClientCidr开放;default用户的密码由 AWS Secrets Manager 随机生成;节点通过 SSM Session Manager 登录,无需 SSH 密钥和堡垒机。
2.1.3 日常运维机制
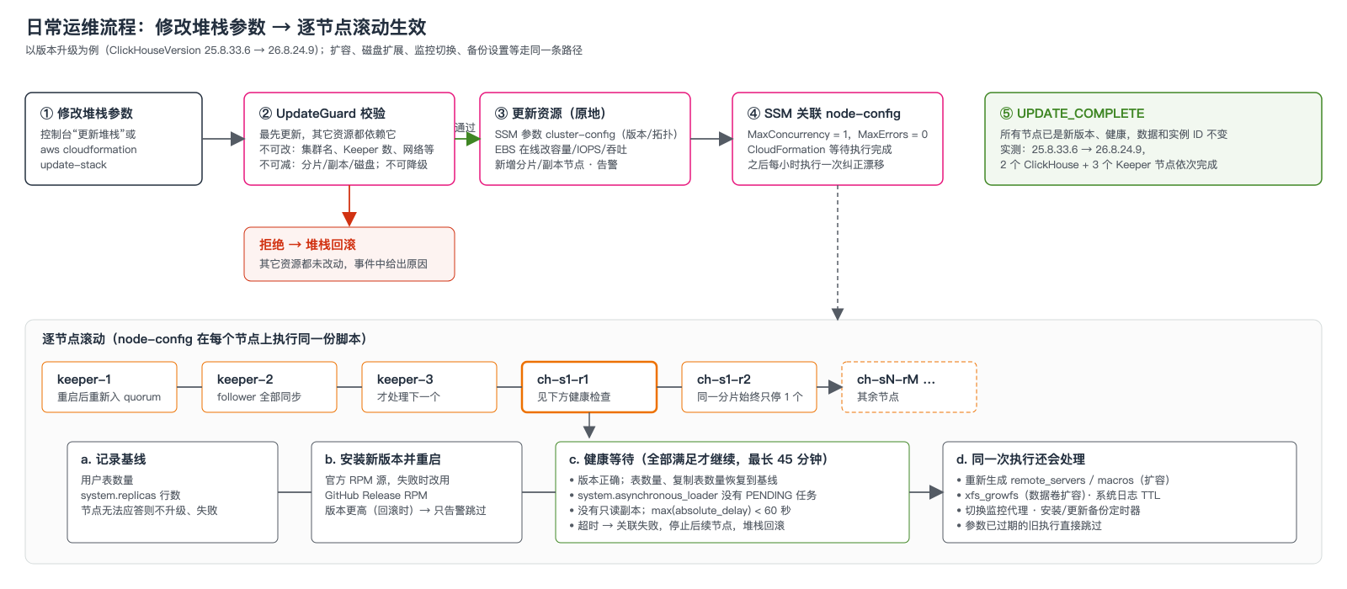
方案的核心设计是:所有日常运维操作都通过修改 CloudFormation 堆栈参数完成。整个流程如下图所示:
[图 2] |
- 用户修改堆栈参数并更新堆栈;
- 堆栈中的
UpdateGuard自定义资源(AWS Lambda)最先被更新,模版中其它所有资源都依赖它。它会检查本次变更,拒绝不安全的修改,比如修改集群名、Keeper 数量、网络和实例类型,减少分片数、副本数或者磁盘大小,以及降级 ClickHouse 版本。一旦拒绝,堆栈直接回滚,其它资源不会做任何改动; - 校验通过后,CloudFormation 原地更新资源:更新 SSM 参数中的集群配置、在线修改 EBS 卷的容量/IOPS/吞吐、创建新增的分片或副本节点等;
- SSM State Manager 关联(Association)
<stack>-node-config在所有节点上执行同一份配置脚本,设置MaxConcurrency=1、MaxErrors=0,即每次只处理一个节点,失败立即停止。CloudFormation 会等待关联执行完成,之后关联每小时执行一次,用来纠正配置漂移。
以版本升级为例,每个节点会先记录当前的表数量和复制表数量,然后安装新版本并重启,重启后等待以下条件全部满足才会处理下一个节点:版本正确、表和复制表数量恢复、system.asynchronous_loader 中没有等待中的加载任务、没有只读副本、复制延迟小于 60 秒。Keeper 节点则要等待重新加入 quorum 并且 leader 报告所有 follower 已同步。这样可以保证同一个分片任何时候最多只有一个副本不可用。
2.1.4 监控与备份
- 监控通过参数
Monitoring选择None、CloudWatch或Prometheus,可以随时切换。CloudWatch 模式下,每个节点每分钟上报 ClickHouse 和 Keeper 的健康指标,模版创建仪表板和告警;Prometheus 模式下,节点上运行 Prometheus agent 和 node_exporter,指标写入 Amazon Managed Service for Prometheus,告警规则在 AMP 中评估,可选创建 Amazon Managed Grafana 工作区。两种模式的告警都发送到同一个 Amazon SNS 主题; - 备份通过参数
EnableBackup开启,每个分片的 1 号副本每天执行一次 ClickHouse 原生BACKUP到 Amazon S3,周日做全量,其余日子做增量。备份桶开启了版本控制,只允许 TLS 访问,按BackupRetentionDays自动过期,删除堆栈时会保留。ClickHouse 通过实例角色访问 S3,配置中不保存任何密钥; - 系统日志表(
system.*_log)按SystemLogRetentionDays设置 TTL,避免系统表无限增长占满磁盘。
2.2 EKS 部署方案
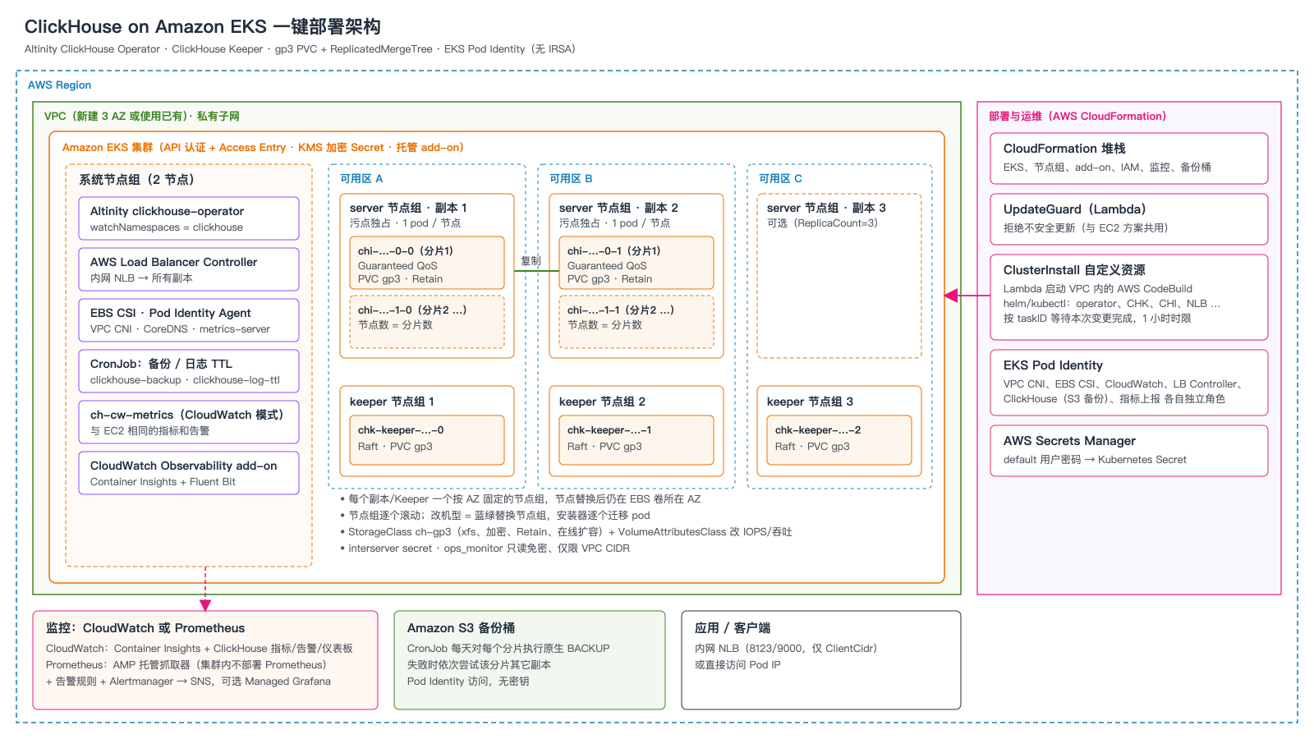
EKS 部署方案的架构如下图所示:
[图 3] |
- 网络:可以新建 3 个可用区的 VPC,也可以使用已有的 VPC 和子网;
- EKS 集群:使用 API 认证模式和 Access Entry,Secret 使用 KMS 信封加密,默认只开启私有 API 端点,VPC CNI、CoreDNS、EBS CSI、Pod Identity Agent 等组件都以托管 add-on 方式安装;
- ClickHouse:使用 Altinity ClickHouse Operator 管理
ClickHouseKeeperInstallation和ClickHouseInstallation,镜像为官方的clickhouse/clickhouse-server和clickhouse/clickhouse-keeper;
- 节点组:除了 2 个节点的系统节点组,每个副本、每个 Keeper 都有一个固定在某个可用区的独立节点组,并通过污点(Taint)独占节点,每个节点只运行一个 ClickHouse 或 Keeper pod,pod 采用 Guaranteed QoS。这样节点被替换后一定还在 EBS 卷所在的可用区,pod 不会因为跨可用区而无法挂载卷;
- 存储:StorageClass 使用 gp3(xfs、加密、
Retain、支持在线扩容),IOPS 和吞吐通过 VolumeAttributesClass 在线修改; - 权限:VPC CNI、EBS CSI、CloudWatch Agent、AWS Load Balancer Controller、ClickHouse(S3 备份)和指标上报程序都通过 EKS Pod Identity 获得各自的 IAM 角色,集群中不创建 OIDC Provider,也不使用 IRSA;
- 安装与运维:
ClusterInstall自定义资源通过 Lambda 启动一个运行在 VPC 内的 AWS CodeBuild 项目,用 helm 和 kubectl 完成 operator、Keeper、ClickHouse、NLB 以及备份和日志 TTL CronJob 的安装与升级。安装器为每次变更设置唯一的taskID,等 operator 确认本次变更完成后才向 CloudFormation 返回结果; - 监控与备份:CloudWatch 模式使用 CloudWatch Observability add-on(Container Insights)加上与 EC2 方案相同的 ClickHouse 指标和告警;Prometheus 模式使用 AMP 托管抓取器,集群内不需要部署 Prometheus。备份由 CronJob 每天对每个分片执行原生
BACKUP,失败时依次尝试该分片的其它副本。
EKS 方案同样通过修改堆栈参数完成升级、扩容等操作,并且使用同一个 UpdateGuard。不同的是,修改实例类型在 EKS 上是允许的:节点组会被蓝绿替换,安装器按新机型计算 pod 资源,然后把 pod 逐个迁移到新节点上,旧节点组在清理阶段删除。
2.3 两种方案的选择
| EC2 方案 | EKS 方案 | |
| 适用场景 | 专用的 ClickHouse 集群,追求简单、性能可预期 | 已有 Kubernetes 平台,希望统一管理 |
| 部署耗时 | 约 6 分钟 | 约 30 分钟(包含 EKS 集群创建) |
| 日常运维 | SSM State Manager 逐节点执行 | Altinity Operator 逐 host 滚动 |
| 修改实例类型 | 按操作手册逐节点手工修改 | 修改参数,节点组蓝绿替换 |
| 单节点可用资源 | 整台实例 | 节点 allocatable 减去预留(m7g.2xlarge 上约 7.1 vCPU / 27.75 GiB) |
三、方案验证与实践
接下来我们在 us-west-2 区域对 EC2 方案进行实际部署和验证。EKS 方案的验证结果在本章最后一节介绍。
3.1 部署安装
3.1.1 前提条件
- 已有 VPC,开启 DNS 解析和 DNS 主机名,私有子网可以通过 NAT 网关访问互联网(节点需要下载 ClickHouse 安装包并访问 SSM);
- 如果开启
MultiAZ,需要准备至少max(副本数, Keeper数) 个不同可用区的子网; - 本地安装 AWS CLI,并具有创建 IAM、EC2、CloudFormation 等资源的权限。
3.1.2 下载模版并创建堆栈
模版大小超过了 --template-body 51,200 字节的限制,需要先上传到 S3(使用 CloudFormation 控制台上传模版时,控制台会自动完成这一步)。为了在后面演示版本升级,我们先部署 ClickHouse 25.8 LTS 版本,集群为 1 分片 × 2 副本,3 个 Keeper,开启 CloudWatch 监控和备份,参数文件内容如下(替换 VpcId, SubnetIds 成您自己的 VpcId 和 SubnetIds,并且修改 ClientCidr 为您的 Vpc 对应的 Cidr):
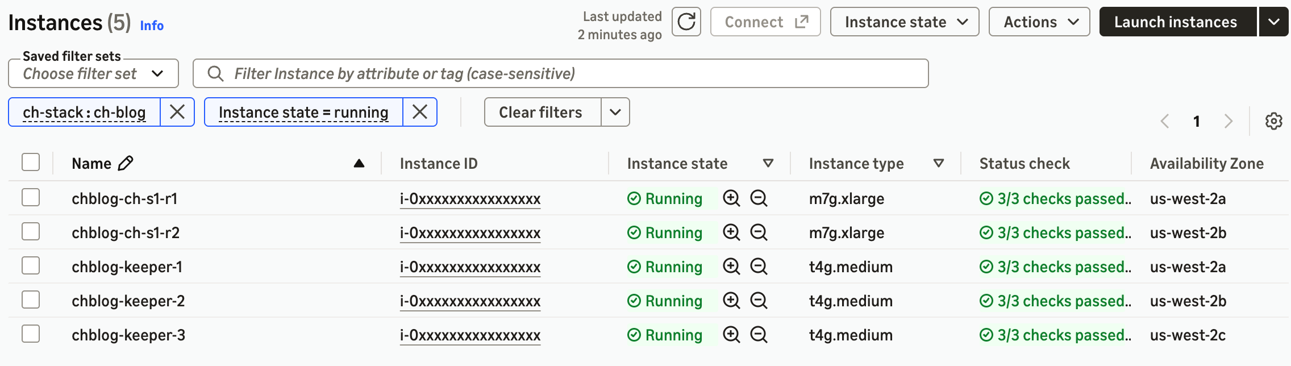
其它参数(如系统盘大小、数据盘 IOPS、备份时间、日志保留天数、终止保护等)都有默认值,完整的参数说明见代码仓库的 README。本次部署从提交到 CREATE_COMPLETE 用时约 6 分钟。部署完成后,在 EC2 控制台可以看到 2 台 ClickHouse 节点和 3 台 Keeper 节点分布在 3 个可用区:
[图 4] |
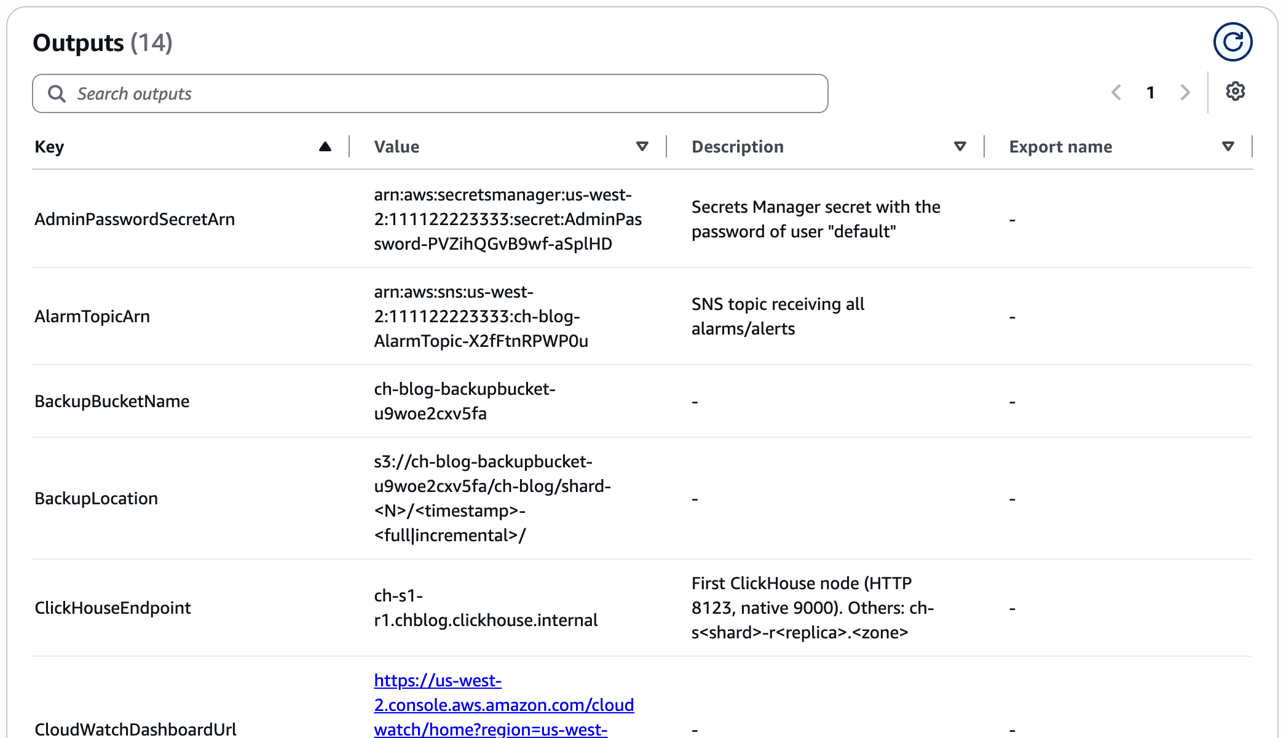
堆栈的输出中给出了集群名、各节点的访问地址、密码所在的 Secrets Manager ARN、CloudWatch 仪表板地址以及备份位置等信息:
[图 5] |
3.1.3 连接集群并验证功能
通过 SSM Session Manager 登录任意一台 ClickHouse 节点(实例 ID 见堆栈输出 FirstNodeInstanceId),从 Secrets Manager 获取密码后即可使用 clickhouse-client 连接。为了避免密码出现在进程列表中,这里通过环境变量传入密码:
查看集群拓扑和 Keeper 连接状态:
使用 ON CLUSTER 创建复制表和分布式表,并写入 5,000 万行测试数据:
ReplicatedMergeTree 的 Keeper 路径和副本名都来自模版生成的 macros,建表时不需要指定。写入完成后,通过 clusterAllReplicas 对比两个副本的行数和行哈希,两个副本的数据完全一致:
3.2 性能验证
为了验证方案在实际业务负载下的表现,我们使用一个计费明细场景的表结构(宽表,包含 trace_id、用户、组织、模型、费用等字段,按月分区)进行了压测。压测环境为 1 分片 × 2 副本,ClickHouse 节点为 m7g.2xlarge(8 vCPU / 32 GiB),数据盘为 100 GiB gp3(3000 IOPS / 125 MiB/s),Keeper 为 3 台 m7g.large,压测客户端是同一 VPC 内的另一台 m7g.2xlarge。压测脚本和报告生成工具都在代码仓库的 perf/ 目录中,可以在任意版本上重复执行。
压测内容包括:
- W1:服务端批量导入(
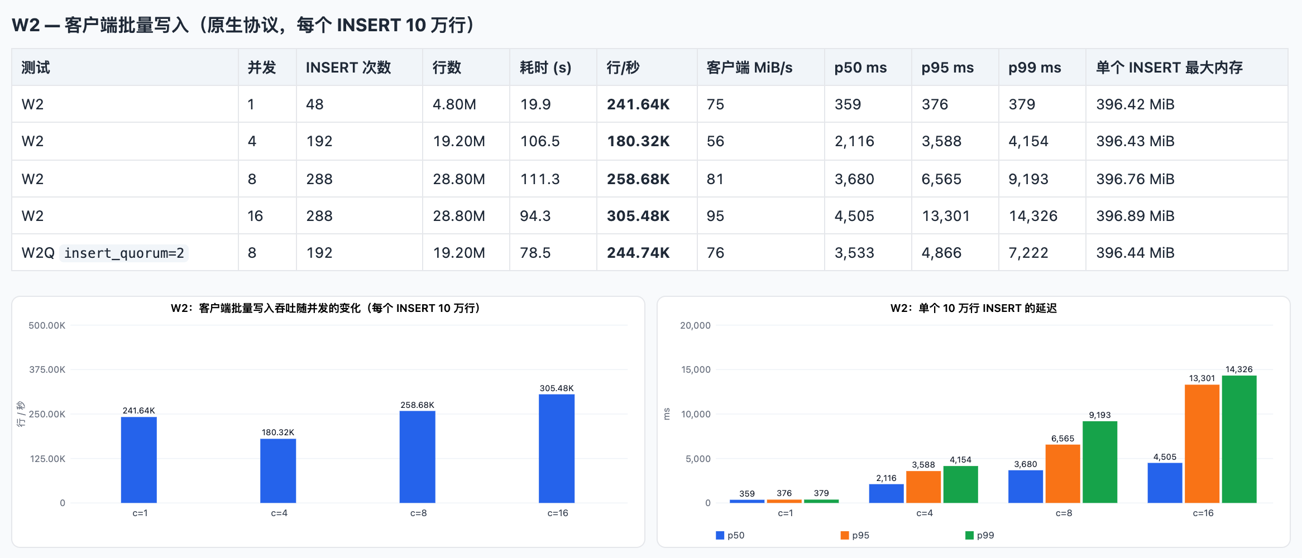
INSERT … SELECT,每批 1,000 万行); - W2:客户端批量写入,每个 INSERT 10 万行,并发 1/4/8/16,以及开启
insert_quorum=2的情况; - W3:小批量写入,每个 INSERT 1,000 行,同步写入与
async_insert对比; - W4:物化视图管道,模拟从 Kafka 消费的 JSON 事件经物化视图解析后写入目标表;
- 读取:8 类业务查询(用户账单、最近记录、组织月报、24 小时看板、按 trace_id 查询、月度财务报表等),并发 1/8/32,以及 16 并发的混合负载。
客户端批量写入的结果如下图所示,单客户端每秒可写入约 24 万行,增加并发后吞吐变化不大,但单次 INSERT 的延迟明显升高:
[图 6] |
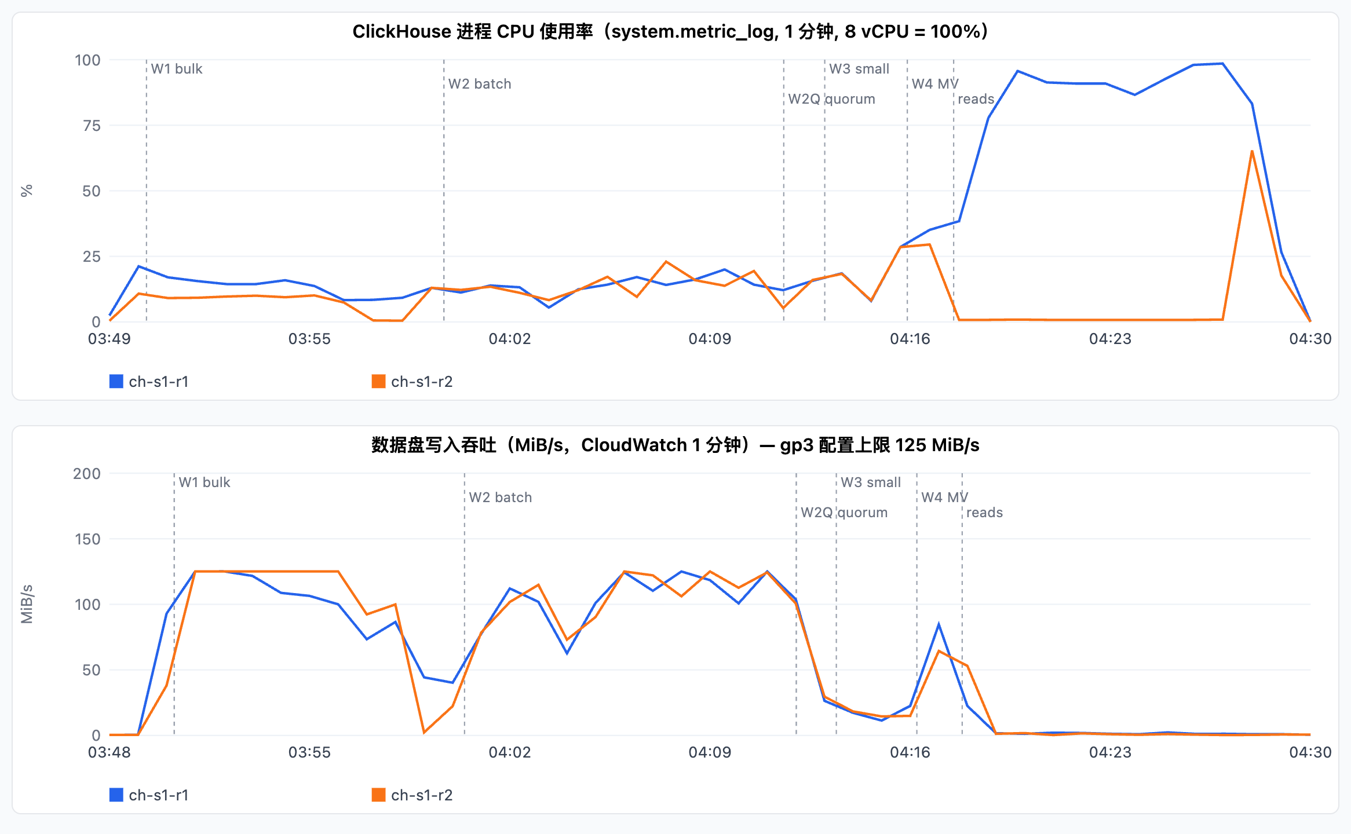
从压测期间的资源使用情况可以看出,写入阶段 ClickHouse 进程的 CPU 使用率只有 10–20%,而两个副本的数据盘写入吞吐长时间顶在 gp3 默认的 125 MiB/s,即持续写入的瓶颈在磁盘吞吐。读取阶段数据可以完全放进页缓存,数据盘几乎没有读 IO,CPU 使用率达到 90% 以上,读取是 CPU 瓶颈:
[图 7] |
主要结论如下:
- 持续写入的瓶颈是数据盘吞吐,而不是 CPU。生产环境建议把
DataVolumeThroughput调到 300 MiB/s 左右(m7g.2xlarge 的 EBS 基线带宽为 312.5 MB/s),IOPS 保持 3000 即可; - 批量写入时单客户端就能把磁盘写满,增加并发主要换来更高的延迟;
insert_quorum=2(等待两个可用区的副本都确认)只带来约 5% 的吞吐下降,对计费类数据建议开启; - 每批 1,000 行的小批量写入比每批 10 万行低一个数量级,上游应在客户端攒批,或者使用
async_insert、Kafka 引擎; - 物化视图管道是 CPU 密集型,吞吐随并发线性增长(c=1/4/8 分别为 2.3/9.2/17.4 万行/秒);使用 Kafka 引擎时应把
kafka_num_consumers设置为 topic 分区数; - 轻量查询(最近记录、看板、错误率)在 c=1 时 p50 为 20–55 ms;按用户、按组织的查询因为排序键中
user_id位于时间之后,每次需要扫描数千万行,建议通过 PROJECTION 或预聚合物化视图优化; - 读请求应分摊到两个副本:16 并发混合负载下,只访问一个副本时为 7.8 QPS,在两个副本间分发后为 11.9 QPS,提升约 52%。
另外,我们在 25.8.33.6 和 26.8.24.9 两个 LTS 版本上执行了同样的压测,发现 26.x 有两处需要注意的行为变化:新增的 deduplicate_insert 设置默认开启并取代了 insert_deduplicate,内容相同的数据块会被静默去重;查询中的 S3 函数默认不能使用服务器自身的凭证(实例角色),需要显式设置 s3_allow_server_credentials_in_user_queries = 1,这一点会影响备份与恢复,方案的备份脚本已经自动处理。
3.3 监控
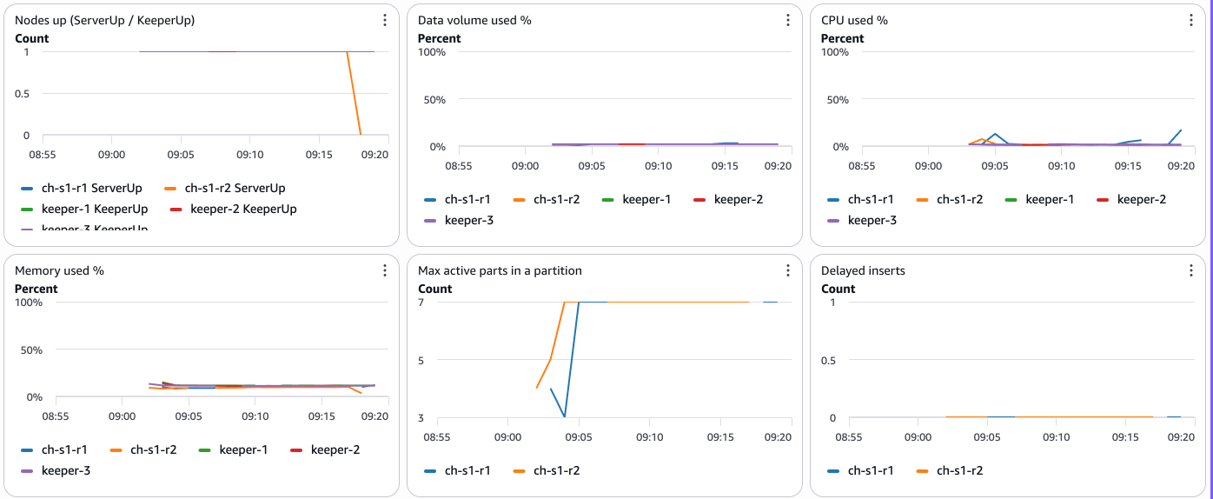
CloudWatch 模式下,每个节点每分钟向命名空间 ClickHouse 上报健康指标,模版同时创建 CloudWatch 仪表板 <stack>-clickhouse,包含节点存活、磁盘使用率、CPU、内存、part 数、延迟插入、复制队列、副本延迟、只读副本、Keeper leader、Keeper 延迟、距上次备份的小时数等图表:
[图 8] |
模版创建的告警分为几类:
| 类别 | 告警(默认阈值) |
| 可用性 | 每个节点的 ClickHouse/Keeper 宕机(3 分钟);Keeper 集群没有 leader;非升级引起的服务重启 |
| 复制与 Keeper | 只读副本;副本延迟 > 300 秒;复制队列 > 1000;Keeper 会话断开、连接错误;Keeper 延迟 > 100 ms;Keeper 积压请求 > 100 |
| 写入与查询 | 单分区活跃 part 数 > 600;延迟插入;拒绝插入;Distributed 表积压 > 1000 个文件;失败查询;失败的 mutation |
| 容量 | 每个节点的数据盘使用率 > DiskUsageAlarmPercent(默认 80%)、系统盘 > 85%;CPU、内存 > 90% 持续 15 分钟 |
| 运维任务 | 距上次成功备份超过 26 小时 |
为了避免误报,只有节点宕机和 Keeper 无 leader 两类告警把“没有数据”视为告警;每个节点的告警在该节点就绪之后才创建,扩容时新节点启动期间不会误报;旧版本 ClickHouse 没有的指标按 0 上报。
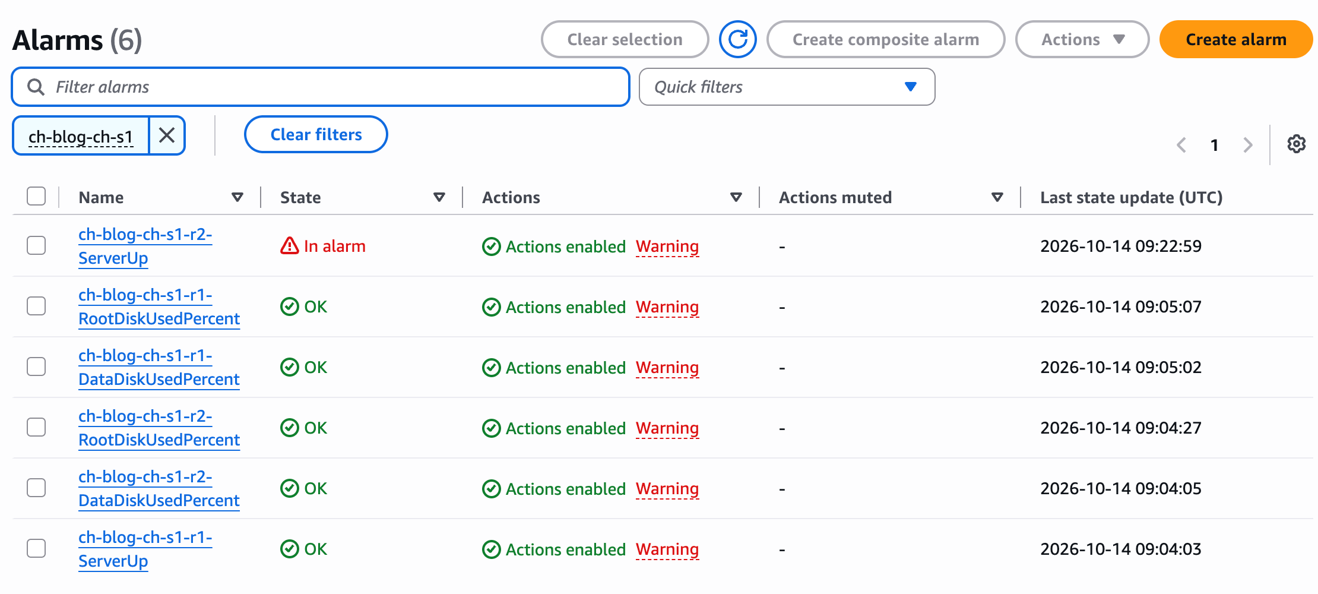
我们手动停止 ch-s1-r2 上的 ClickHouse 服务来验证告警。约 4 分钟后,告警 ch-blog-ch-s1-r2-ServerUp 进入 ALARM 状态,并通过 SNS 主题发出通知,其它节点的告警保持正常。上面的仪表板中也可以看到 ch-s1-r2 的 ServerUp 指标掉到 0。重新启动服务后告警自动恢复。
[图 9] |
如果选择 Prometheus 模式,告警规则在 Amazon Managed Service for Prometheus 中评估,Alertmanager 同样把告警发到 SNS 主题;代码仓库中提供了 Grafana 仪表板 docs/grafana/clickhouse-cluster-dashboard.json,在 Amazon Managed Grafana 中导入即可使用,同一个仪表板也适用于 EKS 方案。监控方式可以随时通过更新 Monitoring 参数切换,节点不会被替换。
3.4 备份与恢复
开启备份后,每个分片的 1 号副本上会安装一个 systemd 定时器 ch-backup.timer,每天在 BackupTimeUTC 执行备份。除了定时备份,也可以在节点上手动执行:
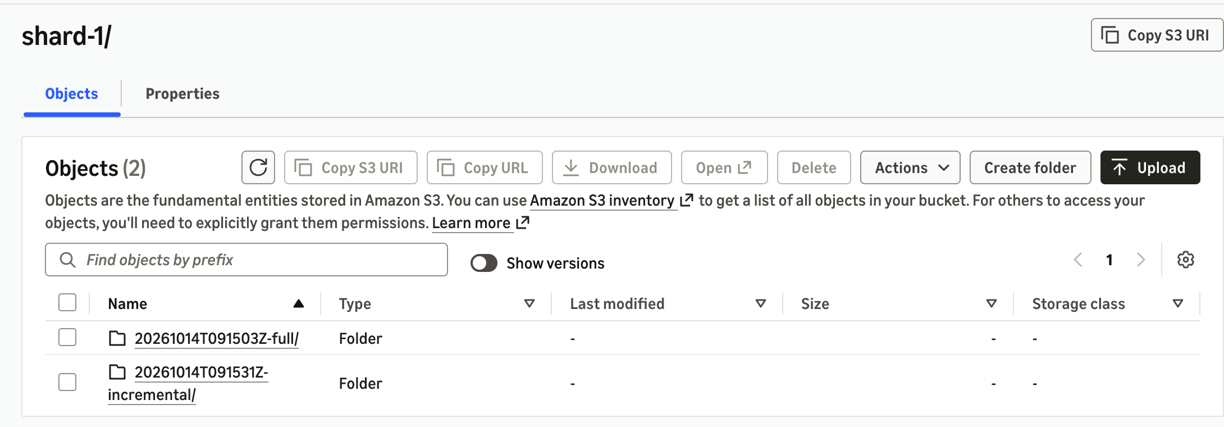
我们先执行一次全量备份,再写入 500 万行新数据后执行一次增量备份。备份写入 s3://<bucket>/<stack>/shard-<N>/<时间>-<full|incremental>/,本次全量备份约 465 MiB,增量备份只上传了约 88 MiB 的新数据:
[图 10] |
恢复时建议先恢复成一张新表,校验无误后再替换原表。从增量备份恢复时,ClickHouse 会自动读取它所依赖的全量备份:
5,500 万行数据约 4.7 秒恢复完成,行数和行哈希与原表完全一致。需要注意的是,在 26.x 版本上,RESTORE 语句需要加上 SETTINGS s3_allow_server_credentials_in_user_queries = 1,而 25.8 版本没有这个设置,加上反而会报错。
由于增量备份依赖它的全量备份,而全量备份会先于后续的增量备份过期,所以可以保证恢复的时间窗口是 BackupRetentionDays − 7 天(默认 28 天)。建议每个季度做一次恢复演练。
3.5 运维
3.5.1 版本升级
将堆栈参数 ClickHouseVersion 从 25.8.33.6 修改为 26.8.24.9 并更新堆栈:
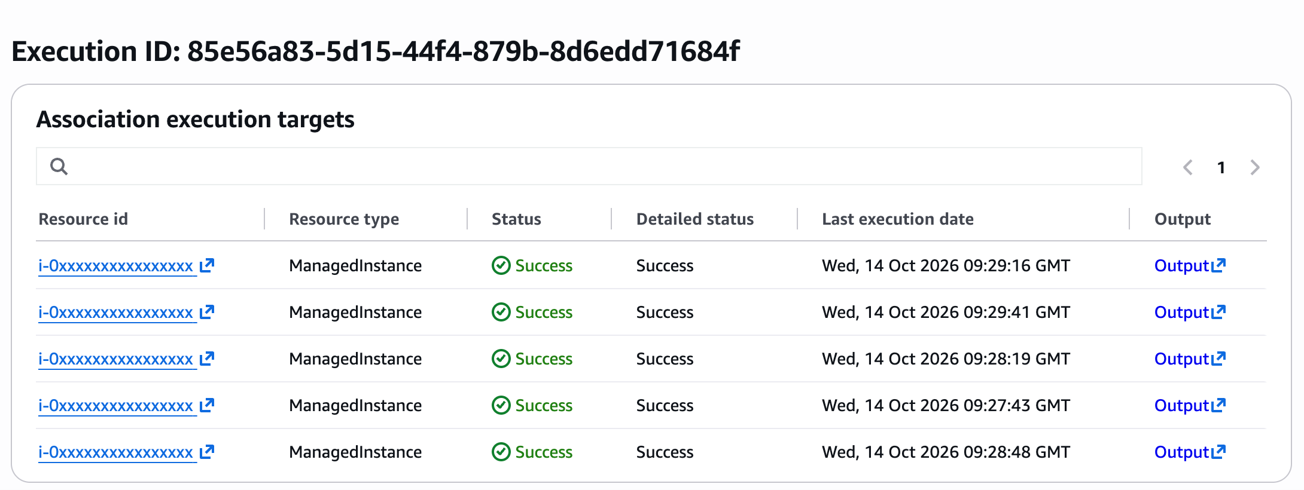
SSM State Manager 关联逐个节点执行升级,在关联的执行历史中可以看到 5 个节点依次完成:
[图 11] |
node-config 脚本的执行日志不写入节点上的本地文件,而是作为 SSM 命令的输出保存在关联的执行记录中。在控制台中依次进入 Systems Manager → State Manager → 关联 <stack>-node-config → Execution history,选择某一次执行,在目标列表中点击节点对应的 Output 链接(即上图最右侧一列)即可查看。也可以通过 AWS CLI 获取某个节点最近一次执行的日志:
下面是 ch-s1-r1 在这次升级中的执行日志(节选),可以看到升级前记录了表和复制表的数量,升级后还顺带完成了系统日志 TTL 和监控代理的配置:
整个升级用时约 3 分钟,升级后所有节点都是 26.8.24.9,实例 ID 不变,表的行数和行哈希与升级前一致。升级前建议:只使用 LTS 版本并且不要跨越多个 LTS;先在预发环境用业务 SQL 和 perf/ 中的压测脚本验证;确认最近一次备份成功;必要时在 settings profile 中设置 compatibility 保留旧版本行为。方案不支持降级,降低 ClickHouseVersion 会被 UpdateGuard 拒绝。如果升级过程中某个节点没有在规定时间内恢复健康,关联会停止执行并让堆栈回滚,已升级的节点保持新版本,修复问题后重新更新堆栈即可。
3.5.2 水平扩容(增加分片)
将 ShardCount 从 1 修改为 2 并更新堆栈,CloudFormation 创建 ch-s2-r1 和 ch-s2-r2 两台新节点,新节点直接安装当前版本 26.8.24.9;关联在所有节点上重新生成 remote_servers,ClickHouse 自动加载新配置,不需要重启。本次扩容用时约 2 分钟:
新分片上还没有业务表,可以使用 CREATE ... IF NOT EXISTS ... ON CLUSTER 补建,已有节点上的表不受影响。之后通过分布式表写入的数据会按分片键分布到两个分片:
需要注意,ClickHouse 不会自动把已有数据重新分布到新分片,如果需要均衡历史数据,可以通过 INSERT INTO ... SELECT 重写,或者在新分片上导入新的分区。增加副本(ReplicaCount)的过程与此类似,新副本上建表时需要带上原表的 UUID,新副本会自动从已有副本拉取数据,具体步骤见代码仓库中的运维手册。缩容(减少分片或副本)会被 UpdateGuard 拒绝,需要更小的集群时,建议新建集群并通过 BACKUP/RESTORE 迁移数据。
3.5.3 磁盘扩容
将 DataVolumeSize 从 100 修改为 150 并更新堆栈,CloudFormation 在线修改所有数据卷的大小,不会重启实例;之后执行一次关联(或者等待下一次每小时的例行执行),节点会自动执行 xfs_growfs 扩展文件系统:
数据盘的 IOPS(DataVolumeIops)和吞吐(DataVolumeThroughput)也可以用同样的方式在线调整。注意 EBS 对同一个卷每 6 小时只允许修改一次。
3.5.4 纵向扩容(更换实例类型)
在 EC2 方案中,实例固定使用启动模版的第 1 个版本,这是为了保证更新堆栈时实例不被替换,因此修改实例类型不能通过堆栈参数完成(UpdateGuard 会拒绝)。我们需要按副本逐个节点修改:先换完所有分片的 1 号副本,再换 2 号副本,保证同一分片任何时候只有一个副本停机。以 ch-s1-r2 为例:
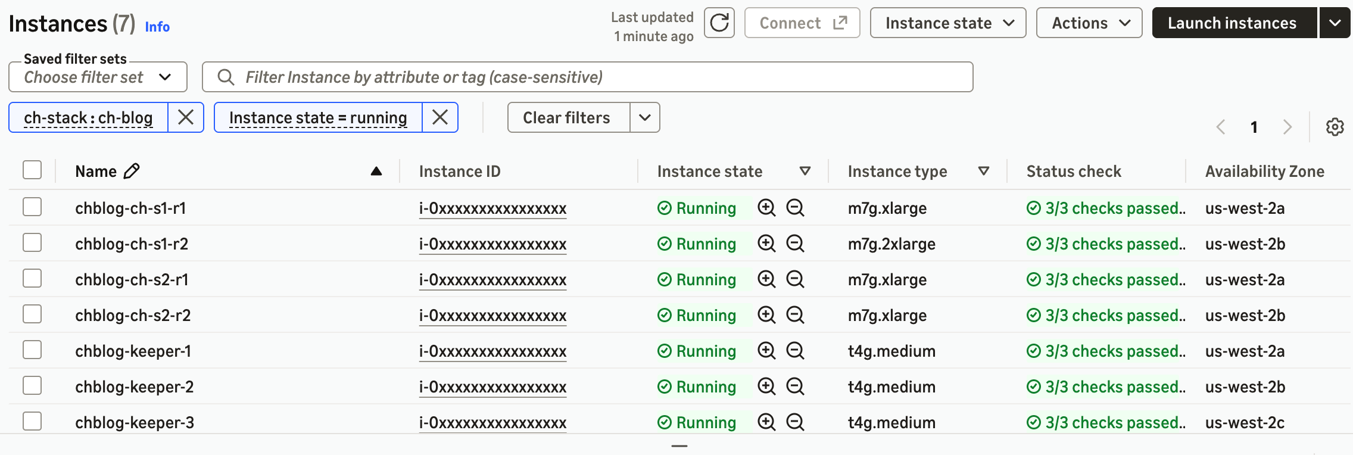
从停机到实例重新运行用时不到 1 分钟,ClickHouse 随实例自动启动,数据完整,复制延迟为 0。修改后 ch-s1-r2 的实例类型变为 m7g.2xlarge,可以看到扩容出来的 ch-s2-r1 和 ch-s2-r2 也已经在列表中:
[图 12] |
需要说明的是,Graviton 和 x86 实例之间不能这样互换(AMI 架构不同);以后扩容新建的节点仍然使用创建堆栈时的实例类型,需要对它们重复上述步骤。
3.5.5 更新保护
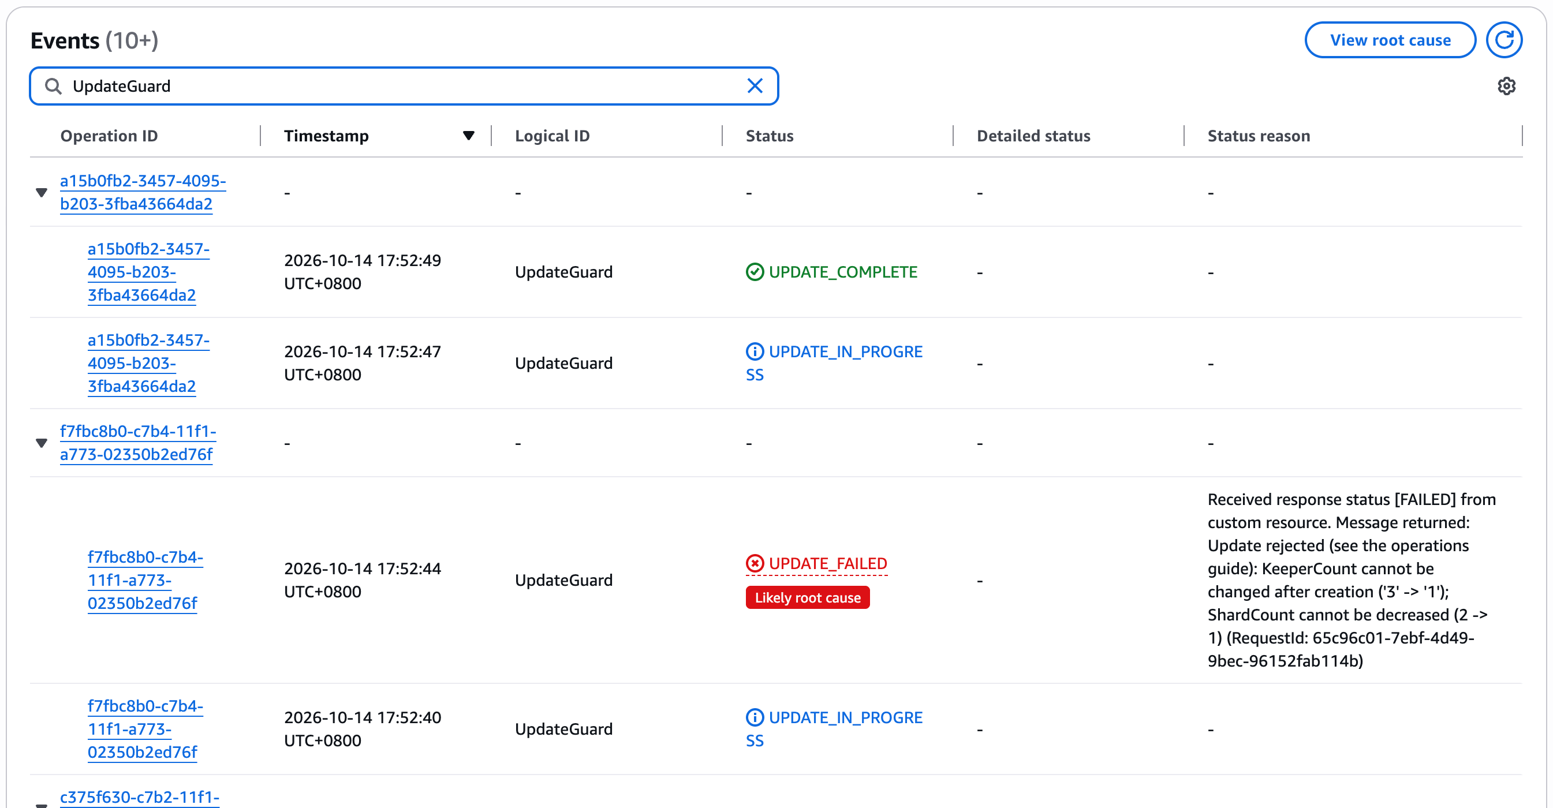
最后我们验证 UpdateGuard 的保护作用。在一次堆栈更新中同时把 KeeperCount 从 3 改为 1、ShardCount 从 2 改为 1。如果这次更新被执行,Keeper 会失去多数派,第 2 个分片的节点和数据也会被删除。实际结果是 UpdateGuard 在 4 秒内拒绝了这次更新,并在事件中给出了明确的原因,堆栈回滚,其它资源没有任何改动:
[图 13] |
回滚过程中 UpdateGuard 会再次被调用,它检测到堆栈处于回滚状态会直接放行,因此回滚本身不会失败。
3.6 EKS 方案验证
EKS 方案我们按照相同的步骤进行了验证(ClickHouse 26.8.24.9,Kubernetes 1.36),主要结果如下:
- 部署:使用已有 VPC,从提交到
CREATE_COMPLETE约 31 分钟,其中安装器(CodeBuild)用时约 5 分钟;Keeper 和 ClickHouse 都按taskID确认完成,所有 pod 均为 Guaranteed QoS; - 扩容:
ShardCount从 1 改为 2 用时约 6 分钟,ReplicaCount从 2 改为 3 用时约 7 分钟,节点组逐个更新;operator 会把已有的表结构同步到新 host,新副本自动从已有副本复制数据,不需要手工建表; - 更换实例类型:6 个 ClickHouse 节点从 m7g.xlarge 改为 m7g.large,节点组蓝绿替换,任何时刻最多只有 1 个 pod 不在运行状态,整个更新约 30 分钟,其中安装器 11 分钟,数据哈希与更换前一致;
- 备份:CronJob 通过 Pod Identity 把每个分片备份到 S3,恢复后的行哈希与原表一致;
- 更新保护:修改
KeeperCount被UpdateGuard拒绝,堆栈在 23 秒内回滚完成; - 安全:安装器和运维脚本通过 stdin 或 Kubernetes Secret 传递密码,在 EKS 审计日志中检索不到任何密码片段。
我们在 EKS 上执行了与 EC2 完全相同的压测(相同的实例规格、脚本和数据),与 EC2 的对比如下:
| 类别 | 指标 | EKS | EC2 | 差异 |
| 写入 | W1 服务端批量导入(行/秒) | 24.07 万 | 24.69 万 | -2.5% |
| 写入 | W2 批量写入 c=8(行/秒) | 24.89 万 | 25.87 万 | -3.8% |
| 写入 | W2Q insert_quorum=2 c=8(行/秒) | 24.83 万 | 24.47 万 | +1.4% |
| 写入 | W4 物化视图管道 c=8(行/秒) | 17.61 万 | 17.37 万 | +1.4% |
| 读取 | Q1 用户账单 c=32 QPS | 9.3 | 10.0 | -6.3% |
| 读取 | Q4 24 小时看板 c=32 QPS | 26.8 | 30.0 | -10.7% |
| 读取 | 混合负载单副本 QPS | 6.8 | 7.8 | -13.2% |
| 读取 | 混合负载两副本 QPS | 12.9 | 11.9 | +8.7% |
| 存储 | 每副本压缩后大小 | 24.72 GiB | 24.01 GiB | +3.0% |
写入性能两者基本一致(差异在 ±6% 以内,瓶颈都是 gp3 的磁盘吞吐);高并发读取 EKS 低 5–13%,主要原因是 pod 只能使用节点 allocatable 中扣除系统预留后的约 7.1 vCPU,而 EC2 上 ClickHouse 可以使用全部 8 vCPU;把读请求分发到两个副本后,EKS 的混合负载 QPS 与 EC2 相当。如果业务对读性能敏感,在 EKS 上可以选择大一号的实例规格来弥补系统预留。
四、总结
本文介绍了在亚马逊云科技上一键部署 ClickHouse 集群的方案,并对部署、性能、监控、备份和各类运维操作进行了实际验证。方案提供 Amazon EC2 和 Amazon EKS 两种部署形态,使用 ClickHouse Keeper 替代 ZooKeeper,支持 1–5 个分片、1–3 个副本、多可用区部署以及 Graviton 和 x86 实例。与单纯的“快速部署”不同,方案把集群上线之后的日常运维也纳入了设计:版本升级、扩容、磁盘扩容、监控切换、备份设置都通过修改 CloudFormation 堆栈参数完成,并由 SSM State Manager 或 ClickHouse Operator 逐节点执行;UpdateGuard 在更新的第一步拒绝可能破坏集群或数据的变更;数据盘独立于实例、删除前自动快照,备份每天写入 S3 并经过恢复验证。
两种部署形态在写入性能上基本一致。EC2 方案结构简单,适合专用的 ClickHouse 集群;EKS 方案适合已有 Kubernetes 平台、希望统一管理的团队。方案的全部代码、模版、运维手册和压测脚本都已开源,用户可以直接使用,也可以根据实际需求进行定制。
➡️ 下一步行动:
相关产品:
- Amazon EKS — 托管式 Kubernetes 服务
- Amazon EC2 — 安全且可调整大小的计算容量
- Amazon CloudFormation — 基础设施即代码服务
- Amazon CloudWatch — 可观测性工具
- Amazon S3 — 适用于 AI、分析和存档的几乎无限的安全对象存储
相关文章:
- 使用 AWS CloudFormation 快速模式将基础设施部署速度提升多达 4 倍
- 亚马逊云科技中国区 Health Event 集中 IM 通知方案
- EC2 NAT 实例选型与部署实践
- 从一键部署到 AI 洞察:基于 Serverless 架构与 LLM 的压测与分析平台 Load Testing Pilot
- 基于 Amazon WorkSpaces Applications 快速搭建企业级应用培训环境
五、参考资料
- https://github.com/Moonlight-CL/clickhouse-on-aws
- https://aws.amazon.com/cn/blogs/china/based-on-amazon-ec2-rapid-deployment-of-high-availability-clickhouse/
- https://clickhouse.com/docs/guides/sre/keeper/clickhouse-keeper
- https://clickhouse.com/docs/operations/backup
- https://clickhouse.com/docs/engines/table-engines/mergetree-family/replication
- https://github.com/Altinity/clickhouse-operator
- https://docs.aws.amazon.com/systems-manager/latest/userguide/systems-manager-state.html
- https://docs.aws.amazon.com/eks/latest/userguide/pod-identities.html
- https://docs.aws.amazon.com/prometheus/latest/userguide/AMP-collector.html
- https://docs.aws.amazon.com/ebs/latest/userguide/ebs-modify-volume.html
*前述特定亚马逊云科技生成式人工智能相关的服务目前在亚马逊云科技海外区域可用。亚马逊云科技中国区域相关云服务由西云数据和光环新网运营,具体信息以中国区域官网为准。
本篇作者
AWS 架构师中心:云端创新的引领者探索 AWS 架构师中心,获取经实战验证的最佳实践与架构指南,助您高效构建安全、可靠的云上应用
|
 |
