亚马逊AWS官方博客
基于 GraphRAG 的汽车售后知识检索方案
摘要:本文提出一种基于 AWS 托管服务(Amazon Neptune、OpenSearch Serverless、Bedrock 等)构建的图谱增强 RAG(GraphRAG)智能维修知识助手参考架构,通过融合知识图谱的关系检索与向量数据库的语义检索,实现对汽车售后多模态维修文档的深度解析、实体抽取、混合检索及可溯源问答,有效解决维修知识难以即时获取和关联查询的痛点,并可推广至其他知识密集型领域。
一、背景
汽车制造商在全球布局售后服务体系时,都积累了大量复杂的维修知识——维修手册、零部件手册、技术通报、标准作业程序(SOP)以及故障排查指南。这些知识往往被锁在篇幅长、格式丰富的文档(PDF、Word、Excel、PowerPoint)中,文字、拆装图、参数表和电路图混杂在一起,并需要分发到全球不同语言、不同区域的服务站与一线技师。如何让一线技师快速、可靠地从这些文档中获取正确的维修答案,是汽车售后服务长期面临的挑战。
检索增强生成(Retrieval-Augmented Generation,RAG)已成为将大语言模型(LLM)接地到企业自有内容的标准范式。经典的 RAG 流水线将文档分块、嵌入到向量存储,并在查询时检索最相似的段落。这对于直接的事实查找很有效,但汽车维修场景中的问题往往涉及多个相关概念——例如“当某个传感器故障时会连带影响哪些零部件,对应的拆装与更换步骤又是什么?”纯向量相似度检索到的是“看起来相似”的段落,却无法理解零部件、故障与维修步骤之间的关系。
本文以汽车售后维修为主线场景,介绍一个可复用的图谱增强 RAG(graph-enhanced RAG)智能维修知识助手参考架构,完全基于 AWS 托管服务构建。通过将知识图谱(用于结构化、感知关系的检索,如“零部件—故障—维修步骤”之间的关联)与向量索引(用于语义相似性检索)相结合,再叠加多模态文档解析和精确的引用溯源能力,让技师得到的维修答案既准确,又能一键回溯到手册原文的确切位置。
二、业务挑战
对于在海外布局售后服务的汽车制造商而言,维修手册的翻译与知识传递存在严重障碍,直接影响新车型维修的及时性与服务质量。具体表现为四类痛点:
- 语言障碍显著。维修手册从中文翻译为当地语言平均需 2–4 周,导致新车型维修响应滞后;同一技术术语在不同国家的翻译标准不统一,造成理解偏差,误诊风险上升。紧急场景下,翻译环节会使响应时间显著拉长。
- 诊断高度依赖经验。培训材料本地化成本高,新技师需 6–12 个月才能独立处理复杂故障。资深技师诊断准确率可达 90% 以上,而新手仅为 60%–70%,服务质量不稳定;经验难以系统化传承,人员流动导致知识流失,面对新车型或罕见故障时解决时间成倍延长。
- 知识同步困难。新维修知识从总部发布到海外服务站实际应用需 4–8 周,版本管理混乱,部分服务站仍在使用过时手册;海外反馈机制缺失,新问题与解决方案无法及时回流总部,维修信息分散在多个系统,技师跨平台查找效率低下。
- 跨区域协调缓慢。沟通渠道单一(以邮件、电话为主),缺乏实时协作平台,时差问题又使紧急处理进一步延迟;总部技术信息无法及时传达一线,复杂问题需多级审批,客户投诉处理流程冗长,满意度随之下降。
共同的痛点在于:有价值的维修知识确实存在,但既不能被一线技师即时获取,也不具备关系感知。下面的架构通过让维修文档支持自然语言查询、让每个答案都有源可溯,并捕捉零部件与故障之间的关系,来系统性地解决这一问题。
三、方案概览
从高层来看,该方案将汽车维修手册等复杂文档摄入并转化为两种互补、可查询的表示,然后针对技师的自然语言问题同时查询两者:
- 文档摄入(Ingestion)。文档(PDF、DOCX、XLSX、PPTX)经多模态管道解析:执行 OCR、恢复表格结构、提取图片,并保留每个元素的页面坐标(边界框 bbox)。随后由 LLM 抽取实体(如零部件、病因、操作步骤)及其关系,写入知识图谱;文本嵌入(embedding)写入向量索引。
- 查询(Query)。用户提问时,系统先提取高级(抽象概念)和低级(具体实体)关键词,然后并行从图谱(实体及其邻居关系)和向量索引(语义相似段落)中检索。将合并后的上下文交给 LLM 生成回答。
- 可溯源(Traceability)。每个答案都携带引用标记,可映射回原始 chunk 及其边界框,前端据此在文档查看器中高亮显示确切的源位置,让用户确信答案基于权威内容。
由于整个技术栈基于 AWS 托管与 Serverless 服务构建,它能弹性伸缩、清晰地隔离多租户,并将运维负担降至最低。
四、方案展示
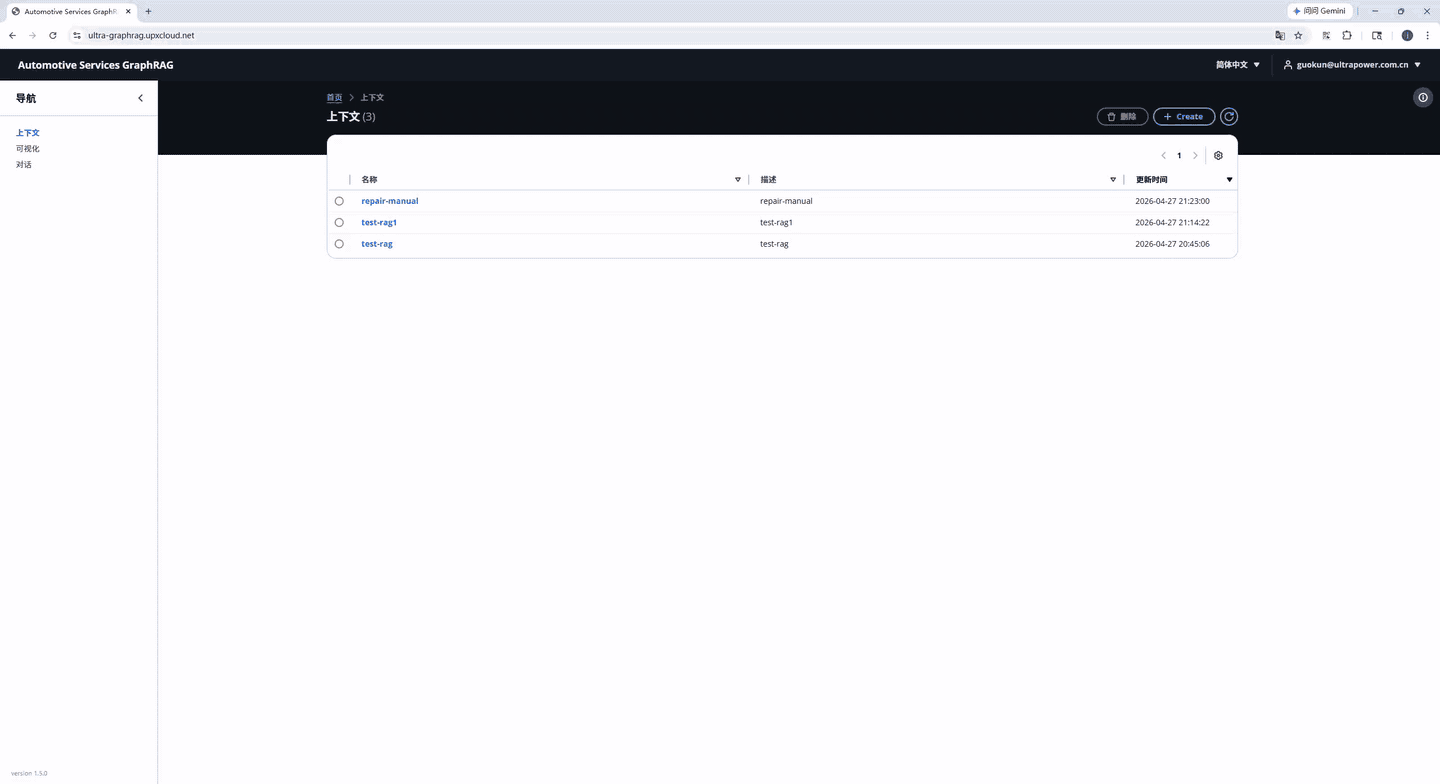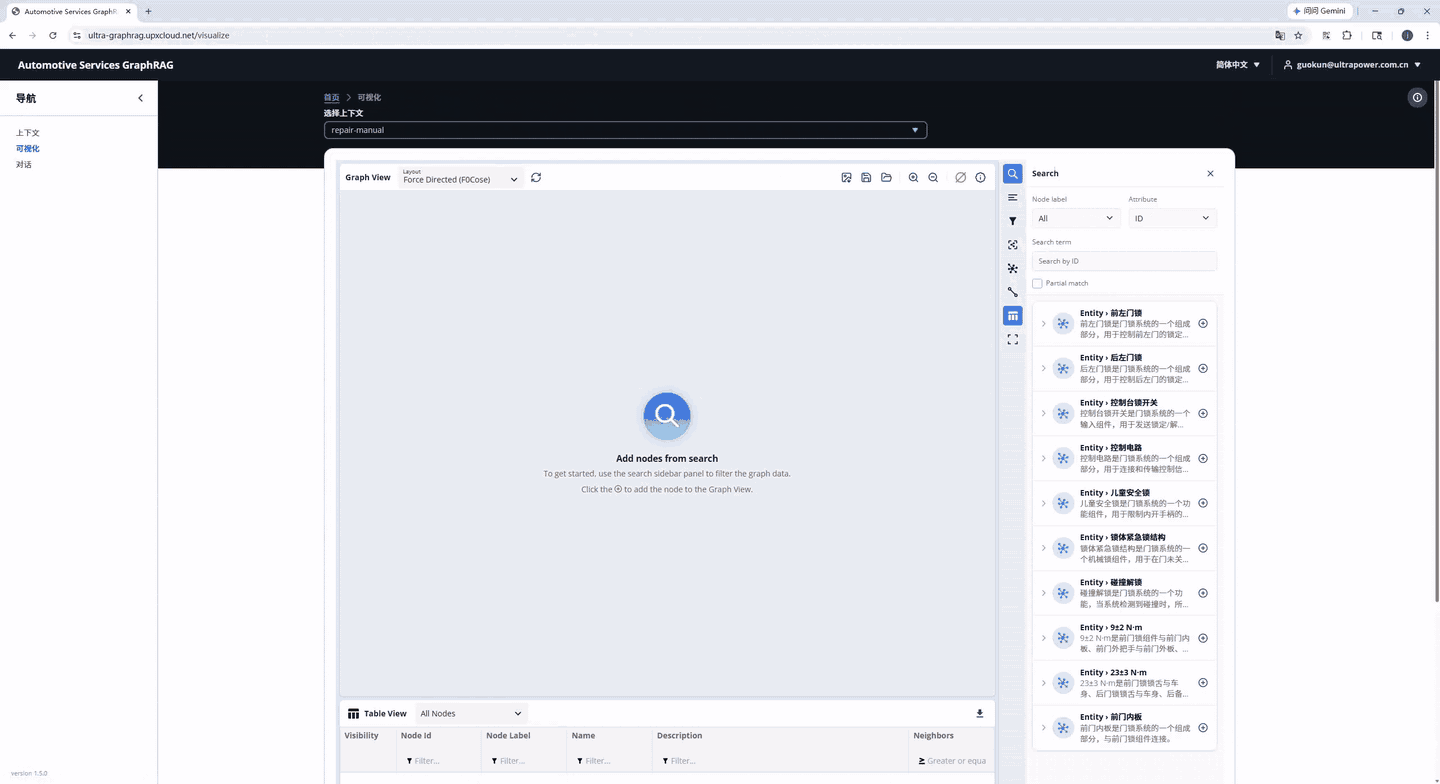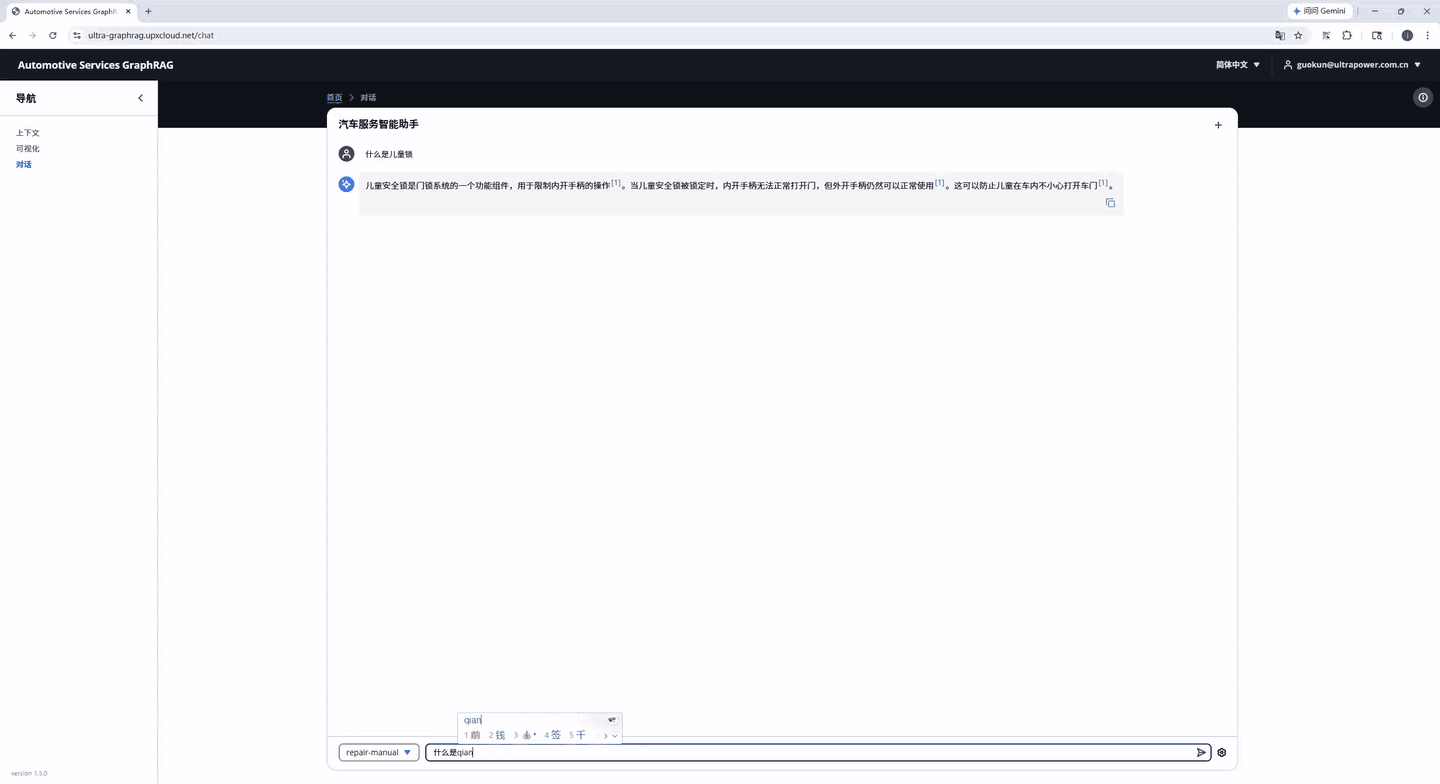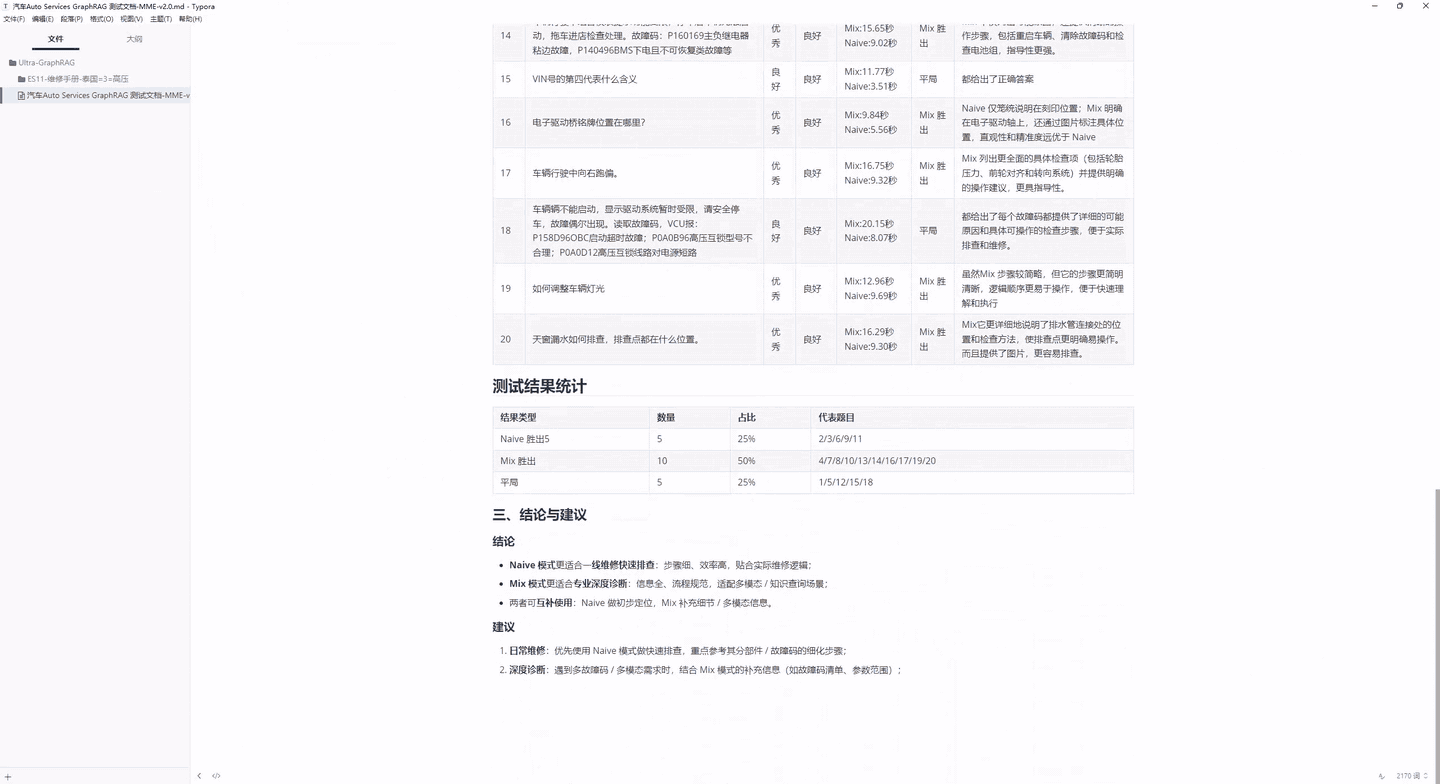
[图 1] |
五、方案架构
下图展示了参考架构。方案使用的核心 AWS 服务包括:
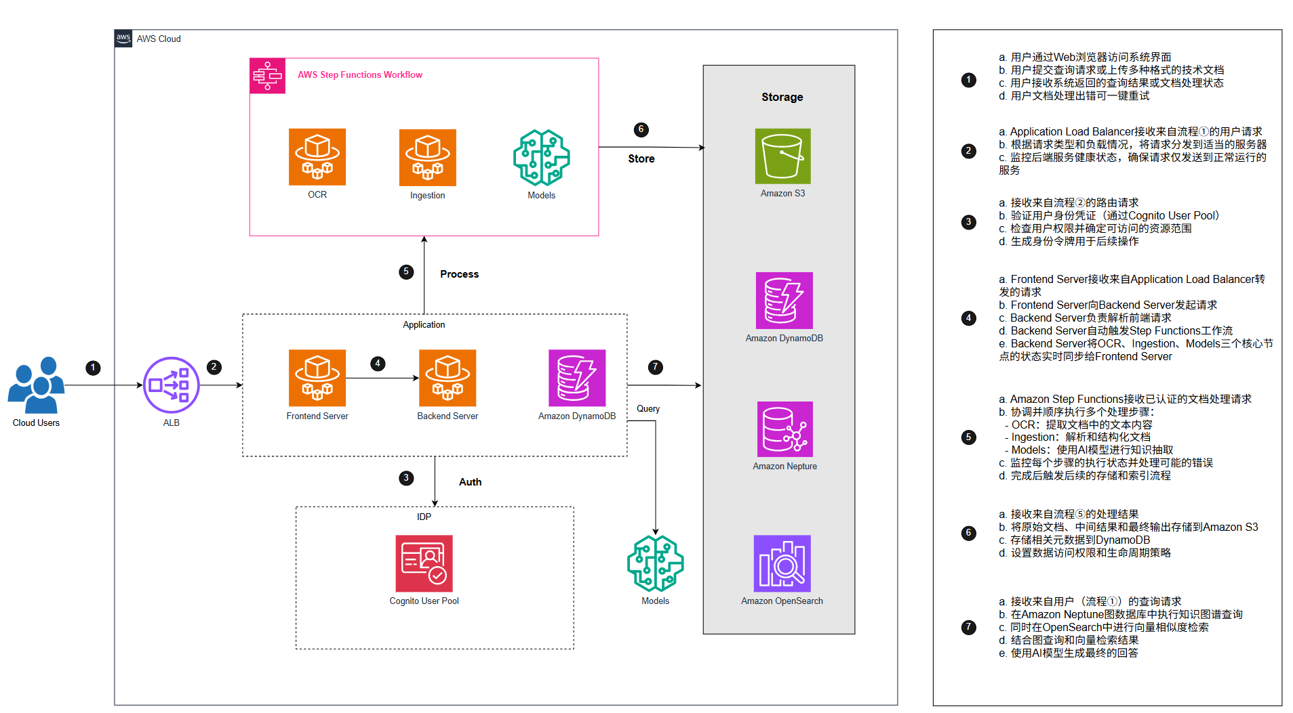
[图 2:图谱增强 RAG 参考架构(摄入与查询两条流水线)] |
- Amazon Neptune — 图数据库,存储知识图谱(实体和关系)。
- Amazon OpenSearch Serverless — 向量数据库,存储文本/实体/关系的 embedding。
- Amazon DynamoDB — 元数据存储(文档状态、上下文配置、Prompt 模板、KV 缓存)。
- Amazon S3 — 文件存储(原始文档、处理后的 artifacts、图片)。
- AWS Step Functions — 编排文档处理管道(OCR → 图像描述 → 实体抽取)。
- Amazon ECS Fargate — 运行后端服务和处理任务容器。
- Application Load Balancer(ALB) — 负载均衡入口。
- Amazon Cognito / OIDC — 用户认证。
- AWS Secrets Manager — 密钥与 API Key 管理。
- Amazon Bedrock — 提供 LLM 与 Embedding 模型能力。
5.1 流程一:文档摄入
用户通过门户上传文档至 Amazon S3,触发 Step Functions 工作流。工作流首先由 Lambda 从 DynamoDB 读取上下文配置(模型选择、分块参数等),然后在 ECS Fargate 容器中运行文档解析:OCR 识别文本、将表格转为 Markdown、提取图片并保留每个元素的页面坐标(bbox)。若启用图像描述,系统会并行调用视觉模型为图片生成文字描述。解析完成后进入知识抽取阶段:系统对解析结果进行语义分块,每个 chunk 保留 bbox 位置并用标签标注;然后调用 LLM 从每个 chunk 中抽取实体和关系(如“属于”、“用于”),相同实体的描述会自动合并摘要。最终,实体和关系写入 Neptune 图数据库,文本 embedding 写入 OpenSearch 向量库,元数据和 bbox 映射写入 DynamoDB。
5.2 流程二:用户查询
用户在聊天界面提问后,系统从 DynamoDB 加载上下文配置和自定义 Prompt,初始化检索实例并连接 Neptune、OpenSearch 和 DynamoDB。查询分四步:(1)LLM 从问题中提取高级关键词(抽象概念)和低级关键词(具体实体);(2)多路并行检索——用低级关键词在 Neptune 图谱中查找匹配实体及其邻居关系(local 检索),用高级关键词查找相关关系网络(global 检索),同时用原始问题在 OpenSearch 中做向量相似度搜索(naive 检索);(3)根据权重或向量相似度,从检索结果关联的 chunk 中选取最相关的文本片段,与实体描述、关系描述一起组装为上下文;(4)将上下文和问题发送给 LLM 生成回答。回答中包含引用标记(chunk_id + bbox_id),前端据此在 PDF 查看器中高亮显示原文出处,实现精确的引用溯源。
六、关键实现细节
6.1 使用 Bedrock 调用大模型
Amazon Bedrock 支持生成 API Key,持有该 Key 的任何账号或服务都可以通过 Bearer Token 方式调用 Bedrock,无需配置跨账号 IAM 角色信任关系。 安全提示:不要将 API Key 硬编码到代码或镜像中。应将其存储在 AWS Secrets Manager,部署时通过安全参数传入,运行时从密钥管理服务动态读取。
部署时(CDK 层):从 Secrets Manager 读取密钥,注入到 ECS 容器的环境变量 AWS_BEARER_TOKEN_BEDROCK 中(下例以占位符代替真实密钥):
运行时(Python 层):利用 botocore 的 before-send 事件钩子,boto3 正常完成 SigV4 签名后,在请求实际发送前用 Bearer Token 替换 Authorization 头。这样无需修改 boto3 的调用方式,所有 converse、converse_stream、embed 调用都自动携带认证。
6.2 基于 Docling 的多模态文档解析管道
使用 Docling 框架配置多模态文档解析管道,同时启用 OCR 文字识别、表格结构解析和图片提取,支持中英文混合文档:
6.3 并行实体抽取与多存储写入
通过 asyncio.gather 实现 LLM 实体抽取与多存储写入的并行执行,抽取完成后将实体和关系合并写入图数据库和向量库,最大化吞吐量:
6.4 可插拔的存储后端(基于 AWS 托管服务)
方案基于 LightRAG 框架,将其四种存储后端替换为 AWS 托管服务:DynamoDB 做 KV 和文档状态存储,Neptune 做图数据库,OpenSearch 做向量库。通过 workspace(context_id)实现多租户数据隔离:
6.5 多模式图谱 + 向量检索
检索入口支持五种模式:local(图谱局部)、global(图谱全局)、hybrid(混合)、naive(纯向量)和 mix(图谱 + 向量融合,默认),并可按文档标签缩小检索范围:
七、功能展示
下面通过几个界面截图展示方案的核心使用流程。
7.1 创建知识上下文
用户首先创建一个独立的知识上下文(context)并配置模型与参数。每个上下文对应一个独立的 workspace,实现多租户/多项目的数据隔离。
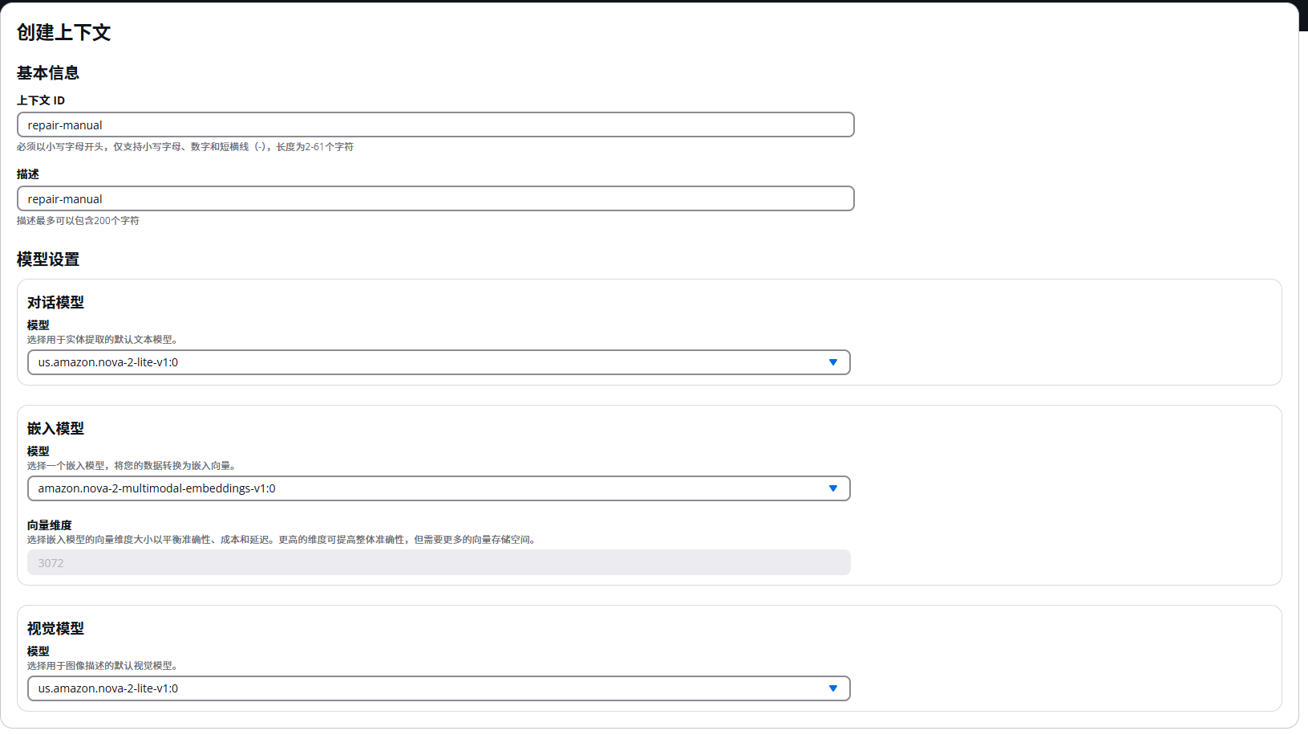
[图 3:创建并配置知识上下文] |
7.2 文档摄入与处理进度
上传文档后,系统自动触发解析与知识抽取流水线,并实时展示各阶段的处理状态。
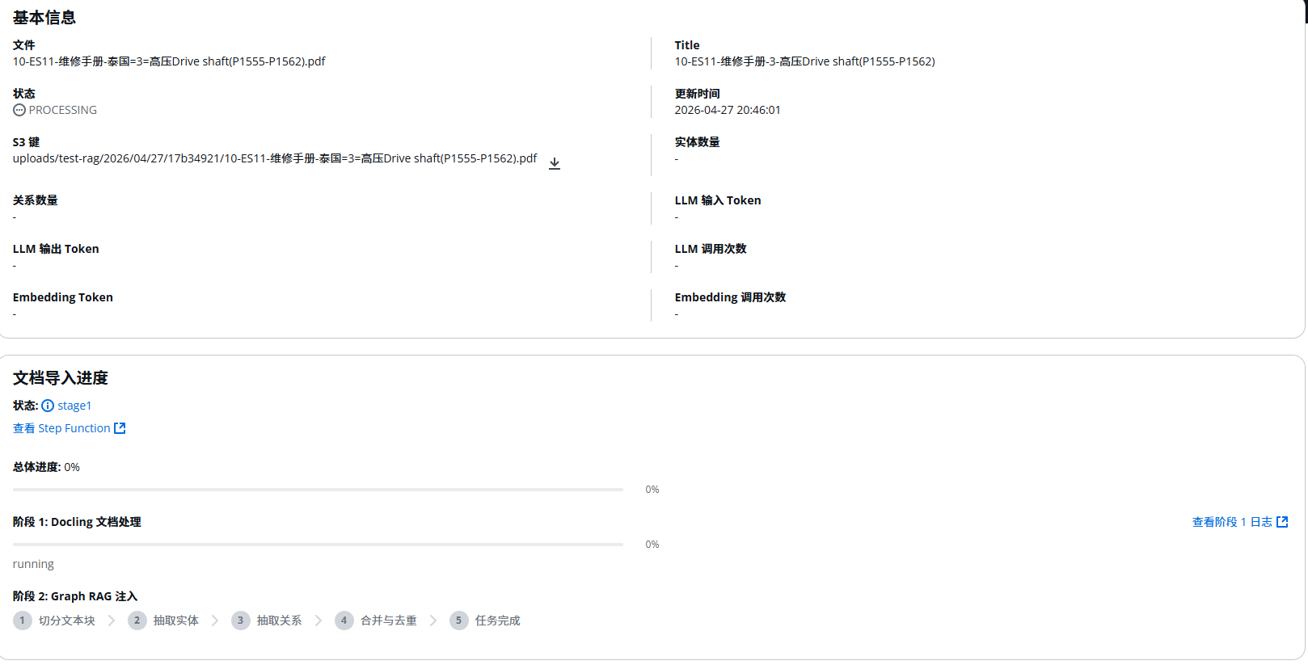
[图 4:文档摄入与处理进度] |
7.3 知识图谱可视化
解析完成后,系统构建出实体与关系组成的知识图谱,并以可交互的方式可视化展示,便于理解文档中的概念关联。
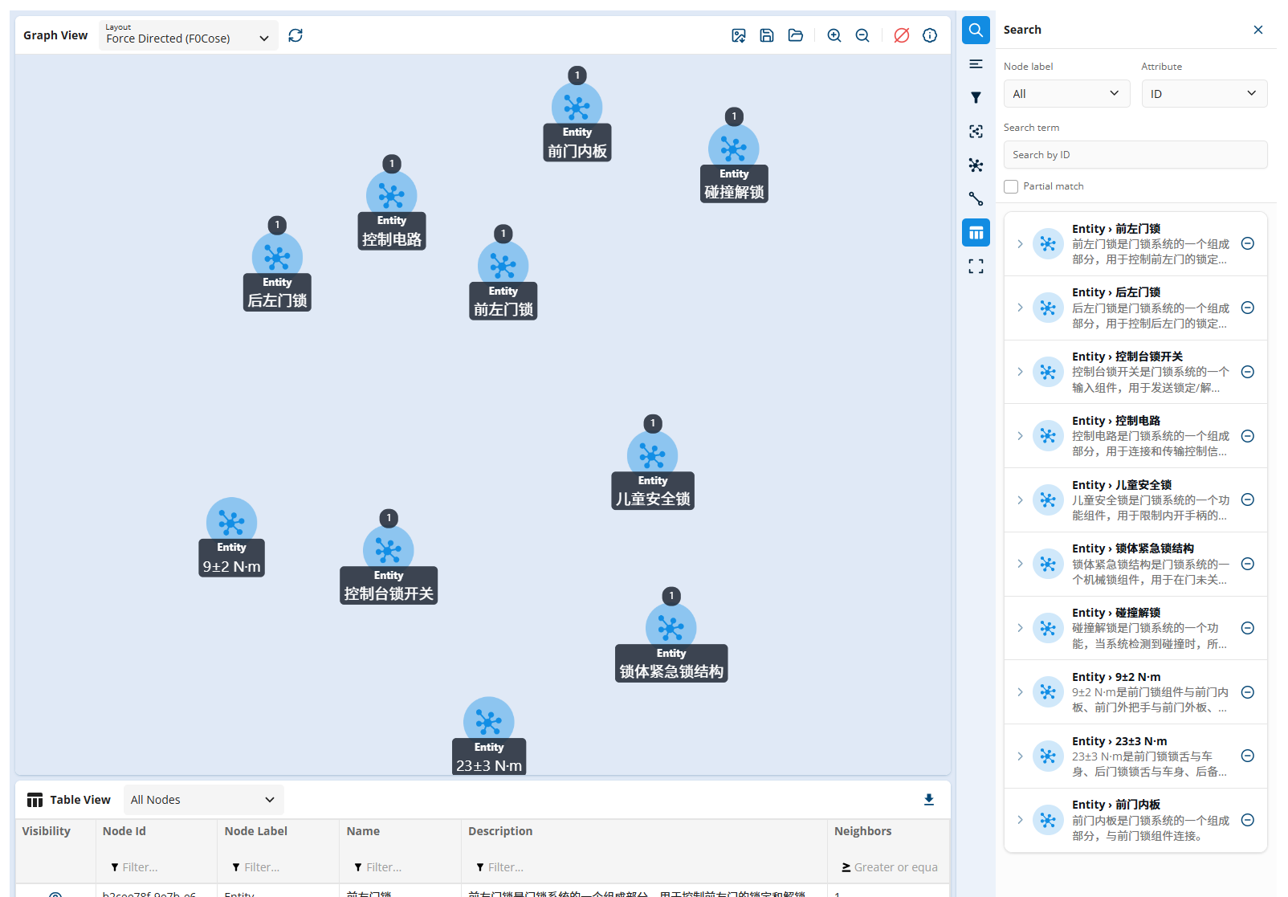
[图 5:知识图谱可视化] |
八、总结
本文以汽车售后维修为场景,展示了如何在 AWS 上构建一个图谱增强的智能维修知识助手。与传统 RAG 相比,它具备几个关键优势:
- 更准确。图谱提供关系感知的检索,向量提供语义相似性检索,两者互补,能回答跨多个相关概念的复杂问题。
- 可溯源。每个答案都能回溯到维修手册原文的确切位置,显著提升一线技师对答案的信任度,降低误诊风险。
- 多语言、多模态。支持中英文混合文档,解析 PDF/DOCX/XLSX/PPTX 中的文字、表格与图片。
- 托管与 Serverless。基于 Neptune、OpenSearch Serverless、DynamoDB、S3、Step Functions、ECS Fargate 等托管服务,弹性伸缩、运维负担低。
将这套方案落地于汽车售后服务,可以缩短新车型维修手册的启用周期、降低对资深技师的依赖、加速全球服务站的知识同步,并通过可溯源的回答提升首次维修成功率与客户满意度。同时,这一参考架构并不局限于汽车行业——其他装备制造、金融、医疗、法律等知识密集型场景,只要需要从复杂文档中快速、准确、可溯源地获取知识,都能复用同一套架构。您可以基于本文,在自己的 AWS 环境中快速搭建属于自己的图谱增强 RAG 智能维修知识助手。
➡️ 下一步行动:
相关产品:
- Amazon DynamoDB — 无服务器分布式 NoSQL 数据库
- Amazon OpenSearch — 搜索和分析引擎
- Amazon Neptune — 无服务器图形数据库
- Amazon Bedrock — 用于构建生成式人工智能应用程序和代理的端到端平台
- Amazon Secrets Manager — 密钥管理
相关文章:
- Amazon Bedrock模型推理的Serverless 异步架构 – 处理在线多模态高负载案例
- ELK迁移Amazon OpenSearch Service最佳实践
- 从自建 Elasticsearch 迁移到 Amazon OpenSearch Service 实践(二):向量索引迁移与 Amazon Bedrock 集成
- 从自建 Elasticsearch 迁移到 Amazon OpenSearch Service 实践(一):数据迁移与同步
- 从自建 Elasticsearch 迁移到 Amazon OpenSearch Service 实践(三):查询兼容性验证与 BBoss 应用适配
九、合作伙伴介绍
神州泰岳一直专注于提供亚马逊云科技专业的顾问咨询服务与技术支持服务,其中包括了云咨询、迁移、账单服务、CDN 服务、云托管服务以及企业出海服务等。并且针对制造、媒体、游戏、电商等行业提供专业的解决方案,以交付价值的理念为客户提供优质服务。
*前述特定亚马逊云科技生成式人工智能相关的服务目前在亚马逊云科技海外区域可用。亚马逊云科技中国区域相关云服务由西云数据和光环新网运营,具体信息以中国区域官网为准。
本篇作者
AWS 架构师中心:云端创新的引领者探索 AWS 架构师中心,获取经实战验证的最佳实践与架构指南,助您高效构建安全、可靠的云上应用
|
 |