亚马逊AWS官方博客
使用 Amazon Bedrock Request Metadata 增强您的模型调用追踪与成本分析能力
摘要:本文将详细介绍这一功能的使用方法及其应用场景,并结合 Amazon CloudWatch,Amazon Athena 分析能力,展示如何利用元数据进行精确的成本分析和分账统计。
一、背景
在人工智能和机器学习应用日益普及的今天,有效管理和监控模型调用变得尤为重要。为了满足这一需求,Amazon Bedrock 最近推出了一项新功能——Request Metadata,这一功能允许用户在调用模型时添加自定义元数据,从而实现更精细的日志过滤、调用跟踪、成本分配及复核。
本文将详细介绍这一功能的使用方法及其应用场景,并结合 Amazon CloudWatch,Amazon Athena 分析能力,展示如何利用元数据进行精确的成本分析和分账统计。
二、功能概述
Request Metadata 是 Amazon Bedrock 的一项新功能,它允许用户在调用模型时附加键值对形式的元数据。这些元数据不会影响模型的输出结果,但会被记录在 Amazon CloudWatch 或 Amazon S3 中,主要用于如下场景:
- 分析业务的模型调用:为不同的业务场景添加唯一标识符,以分析不同业务的模型使用情况;
- 过滤调用日志:通过添加特定标签,可以在大量日志中快速定位特定的模型调用;
- 添加自定义标识符:便于后续的分析和审计。例如,可以在请求中增加追踪 ID,方便查询和分析单次请求的日志、根据追踪 ID 同步特定请求的 Token 消耗数到自有账单系统;
- 与 Amazon Bedrock 模型蒸馏集成:在使用 Bedrock 蒸馏模型时过滤出用于蒸馏的模型调用日志。
三、为请求添加 Request Metadata 数据
3.1 准备工作
3.1.1 启用 Bedrock 调用日志
Bedrock 支持将模型调用日志输出到 Amazon CloudWatch 或/及 Amazon S3 上。前者可以借助 CloudWatch Logs Insights 功能实现方便快速的查询、后者可以借助 Amazon Athena 或者其他日志分析服务进行分析。
您可以参考文档启用 Bedrock 模型调用日志。此外,两者的使用成本不同,您可以参考官方的价格页面查询具体的成本构成及单价。
3.1.2 选择支持的 API
Request Metadata 最初仅支持 Converse 及 ConverseStream API。自 2026 年 5 月起,InvokeModel 及 InvokeModelWithResponseStream API 也已支持设置 Request Metadata,如果您之前使用的是 InvokeModel 系列 API,无需再切换到 Converse API,只需将 SDK 升级到较新的版本即可(Python SDK 需要 boto3/botocore 1.43.12 及以上版本)。Converse 的具体请求格式见文档。
两类 API 的传参方式略有不同:Converse / ConverseStream 在请求体中以键值对对象的形式传入 requestMetadata;InvokeModel / InvokeModelWithResponseStream 则需要传入 JSON 字符串,SDK 会将其放入 HTTP 请求头 X-Amzn-Bedrock-Request-Metadata 中。
3.2 AWS CLI 使用方法
在 AWS CLI 中,您可以通过 --request-metadata 参数来添加元数据。
Request Metadata 的参数格式非常简单:
- 键 (key):字符串类型,用于标识元数据的类别,长度为 1~256 个字符
- 值 (value):字符串类型,用于存储具体的元数据内容,长度为 0~256 个字符
每个请求最多可以添加 16 个键值对。需要注意的是,键和值仅支持英文字母、数字、空白字符以及 : _ @ $ # = / + , - . 这些符号,不支持中文等非 ASCII 字符。
以下是两种常见的格式,--request-metadata 只是为了示意,请按照自己的需求修改。
a) 键值对格式
aws bedrock-runtime converse \
  --model-id amazon.nova-lite-v1:0 \
  --messages '[{"role": "user", "content": [{"text":"你好,请介绍一下自己"}]}]' \
  --request-metadata "ProjectName=AI,Department=IT,UserID=user123"
b) JSON 格式
aws bedrock-runtime converse \
  --model-id amazon.nova-lite-v1:0 \
  --messages '[{"role": "user", "content": [{"text":"你好,请介绍一下自己"}]}]' \
  --request-metadata '{"ProjectName": "AI", "Department": "IT", "UserID": "user123"}'
c) InvokeModel
使用较新版本的 AWS CLI v2 时,invoke-model 及 invoke-model-with-response-stream 命令同样支持 --request-metadata 参数,以 JSON 格式传入即可:
aws bedrock-runtime invoke-model \
  --model-id amazon.nova-lite-v1:0 \
  --cli-binary-format raw-in-base64-out \
  --body '{"messages":[{"role":"user","content":[{"text":"你好,请介绍一下自己"}]}]}' \
  --request-metadata '{"ProjectName": "AI", "Department": "IT", "UserID": "user123"}' \
  output.json
3.3 SDK 使用示例
如果您使用 AWS SDK,也可以轻松添加请求元数据。以下是使用 Python SDK 的示例,本文中 requestMetadata 只是为了示意,请按照自己的需求进行替换:
a) Converse / ConverseStream
import boto3

bedrock_runtime = boto3.client('bedrock-runtime')

## streaming mode
# response = bedrock_runtime.converse_stream(

##  non streaming mode
response = bedrock_runtime.converse(
    modelId='amazon.nova-lite-v1:0',
    messages=[
        {
            'role': 'user',
            'content' : [{
               "text": '你好,请介绍一下自己'
            }]
        }
    ],
    requestMetadata={
        'ProjectName': 'AI',
        'Department': 'IT',
        'UserID': 'user123'
    }
)
# ...
b) InvokeModel / InvokeModelWithResponseStream
需要 boto3 1.43.12 及以上版本。与 Converse 不同,这里的 requestMetadata 需要传入 JSON 字符串:
import json
import boto3

bedrock_runtime = boto3.client('bedrock-runtime')

body = json.dumps({
    'max_tokens': 512,
    'messages': [{'role': 'user', 'content': '你好,请介绍一下自己'}]
})

## streaming mode
# response = bedrock_runtime.invoke_model_with_response_stream(

##  non streaming mode
response = bedrock_runtime.invoke_model(
    modelId='模型 ID',
    body=body,
    requestMetadata=json.dumps({
        'ProjectName': 'AI',
        'Department': 'IT',
        'UserID': 'user123'
    })
)
# ...
Request Metadata 是在 API 层处理的,与具体模型及请求体格式无关。我们使用 InvokeModel 及 InvokeModelWithResponseStream 对多家厂商的模型进行了验证,元数据均能正确记录到调用日志中。
四、实际应用场景
4.1 业务场景分析
不同的业务场景可能需要不同的模型调用策略。通过添加业务场景相关的元数据,您可以分析不同场景下的模型调用情况,从而优化您的应用。
例如,您可以添加如下元数据:
{
  "BusinessScenario": "CustomerService",
  "QueryType": "ProductInquiry",
  "UserSegment": "PremiumUser"
}
4.2 成本分配与管理
在企业环境中,不同部门或项目的 AI 模型使用成本需要分别计算。通过添加部门或项目相关的元数据,您可以轻松实现成本分配。例如:
{
  "Department": "Marketing",
  "Project": "SummerCampaign2025",
  "CostCenter": "MKT-2025-001"
}
五、查询分析 Bedrock 模型调用日志
5.1 示例日志格式
这里以模型调用的日志格式为例进行介绍,注意替换成自己的模型 ID。
{
    "schemaType": "ModelInvocationLog",
    "schemaVersion": "1.0",
    "timestamp": "2025-04-24T17:22:24Z",
    "accountId": "123456789012",
    "identity": {
        "arn": "arn:aws:iam::123456789012:user/xxx"
    },
    "region": "us-east-1",
    "inferenceRegion": "us-east-2",
    "requestId": "073b234f-xxxx-xxx-8f90867e8fdc",
    "operation": "Converse",
    "modelId": "模型 ID",
    "input": {
        "inputContentType": "application/json",
        "inputBodyJson": {
            "messages": [
            // ...
            ]
        },
        "inputTokenCount": 10,
        "cacheReadInputTokenCount": 0,
        "cacheWriteInputTokenCount": 0
    },
    "output": {
        "outputContentType": "application/json",
        "outputBodyJson": {
        // ...
        },
        "outputTokenCount": 49
    },
    "requestMetadata": {
        "Project": "projectA",
        "TraceId": "123-1234-123-xxx"
        // ...
    }
}
其中 requestMetadata 位于日志的顶层,Token 数位于 input / output 对象内;inferenceRegion 表示跨区域推理时实际执行推理的区域。这里有几点需要注意:
- 使用推理配置文件(Inference Profile)时,Converse 类请求的
modelId记录为配置文件 ID(如上例),而 InvokeModel 类请求记录为完整的 ARN(如arn:aws:bedrock:us-east-1:123456789012:inference-profile/***),按模型聚合统计时需要统一处理; cacheReadInputTokenCount、cacheWriteInputTokenCount字段并非每条日志都有,统计时需要做空值处理;- Converse 与 InvokeModel 两类请求的日志结构一致,
requestMetadata及 Token 数等字段的位置相同,因此本文中的查询对两类请求都适用;区别仅在于inputBodyJson/outputBodyJson中记录的请求与响应正文,Converse 类请求为 Bedrock 统一的 Converse 格式,InvokeModel 类请求为各模型厂商的原生格式; - 调用日志的投递存在几分钟的延迟,刚发出的请求可能无法立即查询到。
5.2 使用 CloudWatch Logs Insights 分析 CloudWatch 中的日志
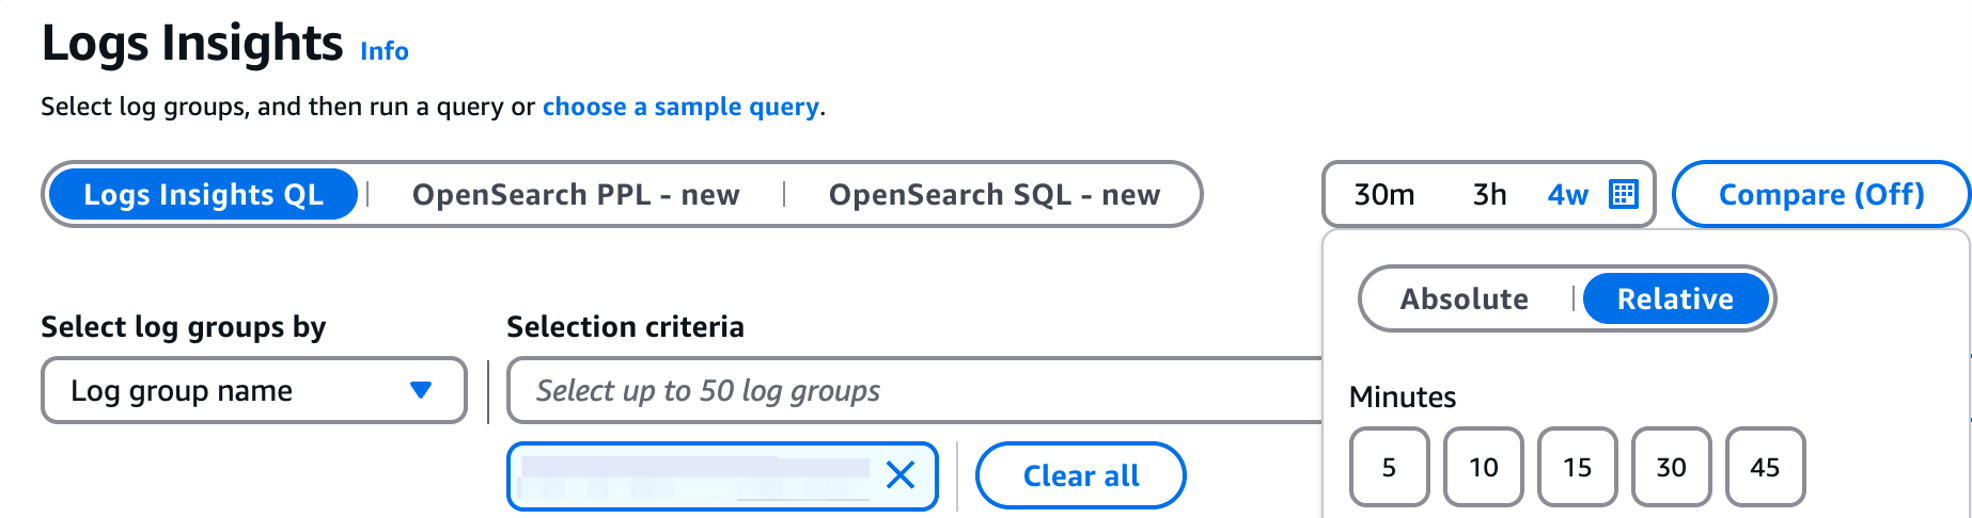
在使用 Logs Insights 的时候,可以在查询页面修改查询的时间范围为绝对值或者相对值,如下图:
[图 1] |
这里,我们给出通过 Console 查询每个请求的具体 Token 消耗、按照 Request Metadata 聚合查询及查看延迟数据三个示例。更多有关 Logs Insights 的查询语法、示例及最佳实践见文档。
Logs Insights 也支持通过 AWS CLI、SDK 进行查询,具体可以参考 CLI 文档、SDK 文档。
需要注意的是,Logs Insights 中的字段名是区分大小写的,requestMetadata.Project 与 requestMetadata.project 会被视为两个不同的字段,查询时请与调用时使用的键名保持一致。
5.2.1 查询单个请求的 Token 数消耗
fields @timestamp, operation, modelId,
  input.inputTokenCount as inputTokens,
  input.cacheReadInputTokenCount as cacheReadInputTokens,
  input.cacheWriteInputTokenCount as cacheWriteInputTokens,
  output.outputTokenCount as outputTokens,
  requestMetadata.Project as project,
  requestMetadata.TraceId as traceId
# | filter requestId == '0731234f-xxx-fdc' # uncomment to filter request id
# | filter traceId == '123-1234-123-xxx'  # uncomment to filter trace id
# | filter operation not like /Converse/  # uncomment to filter operation
# | filter project == 'projectA'          # uncomment to filter project metadata
| sort @timestamp desc
| limit 10
5.2.2 按照项目聚合 Token 消耗
fields input.inputTokenCount as inputTokens,
  input.cacheReadInputTokenCount as cacheReadInputTokens,
  input.cacheWriteInputTokenCount as cacheWriteInputTokens,
  output.outputTokenCount as outputTokens,
  requestMetadata.Project as project
| filter ispresent(project)
| parse modelId /(?<model>[^\/]+)$/
| stats
    count(*) as calls,
    sum(inputTokens) as inputTokenSum,
    sum(cacheReadInputTokens) as cacheReadInputTokenSum,
    sum(cacheWriteInputTokens) as cacheWriteInputTokenSum,
    sum(outputTokens) as outputTokenSum
    by project, model
| sort inputTokenSum desc
| limit 100
其中 parse modelId 一行将 ARN 形式的 modelId 统一为 ID,避免同一个模型因调用 API 不同而被拆分成两行。
5.2.3 查看延迟数据
日志中记录的延迟字段因 API 而异:Converse / ConverseStream 请求记录在 output.outputBodyJson.metrics.latencyMs 中;InvokeModelWithResponseStream 请求会在流式事件中记录首字节延迟 firstByteLatency 及总延迟 invocationLatency;非流式的 InvokeModel 请求日志中没有延迟字段,可以使用 CloudWatch 指标 InvocationLatency 进行观测,注意替换成自己的模型 ID。
filter modelId like /模型 ID/
| parse @message /"firstByteLatency":(?<ttftMs>\d+)/
| parse @message /"invocationLatency":(?<invokeLatencyMs>\d+)/
| parse @message /"latencyMs":(?<converseLatencyMs>\d+)/
| display @timestamp,
    operation,
    modelId,
    inferenceRegion,
    input.inputTokenCount,
    output.outputTokenCount,
    ttftMs,
    invokeLatencyMs,
    converseLatencyMs
| sort @timestamp desc
| limit 100
这里使用 like /.../ 而不是 == 来匹配模型,可以同时覆盖以 ID 和以 ARN 形式记录的 modelId。
5.3 使用 Amazon Athena 分析 S3 中的 Bedrock 日志与元数据
Amazon Athena 是一个交互式查询服务,可以直接分析存储在 Amazon S3 中的数据。结合 Request Metadata 功能,您可以使用 Athena 对 Bedrock 的调用日志进行深入分析,特别是进行成本分配和使用情况统计。
5.3.1 创建 Athena 表
Athena 查询相关操作、Glue Data Catalog 中库表的读写权限(如 glue:GetDatabase、glue:GetTable、glue:CreateTable)、日志桶的 s3:GetObject 与 s3:ListBucket 权限,以及查询结果桶的 s3:PutObject、s3:GetObject、s3:GetBucketLocation 权限。如果日志桶使用了 SSE-KMS 加密,还需要相应密钥的 kms:Decrypt 权限。
在建表之前,我们先来看一下 Bedrock 投递到 S3 中的日志目录结构:
当请求或响应正文较大时,Bedrock 会将其单独存放在同一目录下的 data/ 子目录中;如果启用了图片等数据的投递,请求中的图片、PDF、表格等原始文件也会存放在这里。这些文件的格式与调用日志不同。由于 Athena 会递归读取表 LOCATION 下的所有文件,如果将 input、output 定义为嵌套结构,查询时会因为 data/ 中的文件报 BAD_DATA 错误。因此在下面的建表语句中,我们将 input、output 定义为字符串,查询时再通过 json_extract_scalar 提取 Token 数,并使用 schemaType 过滤出调用日志。同时,我们使用 Partition Projection 按天进行分区,查询时只需在 WHERE 条件中指定 day 的范围,即可只扫描对应日期的数据,节省 S3 的扫描费用、提升查询效率,也无需手动维护分区。
在 Athena Query editor 中创建一个表来映射 Bedrock 日志数据:
CREATE EXTERNAL TABLE bedrock_logs (
  schemaType      STRING,
  `timestamp`     STRING,
  accountId       STRING,
  region          STRING,
  inferenceRegion STRING,
  requestId       STRING,
  operation       STRING,
  modelId         STRING,
  requestMetadata MAP<STRING, STRING>,
  input           STRING,
  output          STRING
)
PARTITIONED BY (day STRING)
ROW FORMAT SERDE 'org.openx.data.jsonserde.JsonSerDe'
WITH SERDEPROPERTIES ('ignore.malformed.json' = 'true')
LOCATION 's3://你的日志桶名/可选前缀/AWSLogs/你的账号 ID/BedrockModelInvocationLogs/us-east-1/'
TBLPROPERTIES (
  'projection.enabled'           = 'true',
  'projection.day.type'          = 'date',
  'projection.day.format'        = 'yyyy/MM/dd',
  'projection.day.range'         = '2025/01/01,NOW',
  'projection.day.interval'      = '1',
  'projection.day.interval.unit' = 'DAYS',
  'storage.location.template'    = 's3://你的日志桶名/可选前缀/AWSLogs/你的账号 ID/BedrockModelInvocationLogs/us-east-1/${day}/'
);
这里需要特别注意的是,Athena 使用的 OpenX JsonSerDe 默认会将 JSON 中的键名全部转为小写,这同样作用于 requestMetadata 中的键。因此在 Athena 中需要使用 requestMetadata['department'] 进行查询,如果写成 requestMetadata['Department'] 将始终返回空值;同理,json_extract_scalar 的路径也需要使用小写,如 $.inputtokencount。
5.3.2 使用元数据进行分析查询
有了 Request Metadata 功能,您可以进行更精细的查询分析。以下是一些实用的查询示例,其中的模型单价仅为示意,请以 Amazon Bedrock 价格页面为准:
a) 按部门统计模型使用成本
假设您在调用时添加了部门信息作为元数据:
WITH logs AS (
  SELECT
    requestMetadata['department'] AS department,
    -- 将 ARN 形式的 modelId 统一为 ID
    regexp_replace(modelId, '^arn:aws[^/]*/', '') AS model,
    COALESCE(CAST(json_extract_scalar(input,  '$.inputtokencount')          AS BIGINT), 0) AS in_tok,
    COALESCE(CAST(json_extract_scalar(input,  '$.cachereadinputtokencount') AS BIGINT), 0) AS cache_read_tok,
    COALESCE(CAST(json_extract_scalar(input,  '$.cachewriteinputtokencount') AS BIGINT), 0) AS cache_write_tok,
    COALESCE(CAST(json_extract_scalar(output, '$.outputtokencount')         AS BIGINT), 0) AS out_tok
  FROM bedrock_logs
  WHERE day BETWEEN '2026/10/01' AND '2026/10/09'
    AND schemaType = 'ModelInvocationLog'
    AND requestMetadata['department'] IS NOT NULL
),
-- 模型单价(USD / 百万 tokens):输入、输出、缓存读、缓存写
pricing (model_pattern, p_in, p_out, p_cache_read, p_cache_write) AS (
  VALUES ('%nova-lite%',         0.06,  0.24, 0.015, 0.0)
)
SELECT
  department,
  model,
  COUNT(*)             AS call_count,
  SUM(in_tok)          AS total_input_tokens,
  SUM(cache_read_tok)  AS total_cache_read_tokens,
  SUM(cache_write_tok) AS total_cache_write_tokens,
  SUM(out_tok)         AS total_output_tokens,
  ROUND(SUM(in_tok * p_in + out_tok * p_out + cache_read_tok * p_cache_read + cache_write_tok * p_cache_write) / 1e6, 6) AS estimated_cost_usd
FROM logs
LEFT JOIN pricing ON logs.model LIKE pricing.model_pattern
GROUP BY department, model
ORDER BY estimated_cost_usd DESC;
对于没有配置单价的模型,estimated_cost_usd 会显示为空值,便于及时发现遗漏的价格配置。
b) 按项目进行用量统计
SELECT
  requestMetadata['projectname'] AS project,
  regexp_replace(modelId, '^arn:aws[^/]*/', '') AS model,
  COUNT(*) AS call_count,
  SUM(CAST(json_extract_scalar(input,  '$.inputtokencount')  AS BIGINT)) AS total_input_tokens,
  SUM(CAST(json_extract_scalar(output, '$.outputtokencount') AS BIGINT)) AS total_output_tokens
FROM bedrock_logs
WHERE day BETWEEN '2026/10/01' AND '2026/10/09'
  AND schemaType = 'ModelInvocationLog'
  AND requestMetadata['projectname'] IS NOT NULL
GROUP BY 1, 2
ORDER BY project, call_count DESC;
增加 TraceId 的方法也是同理,在 requestMetadata 中增加 TraceId 字段,在查询 WHERE 条件中增加 requestMetadata['traceid'] = '你的 TraceId‘ 即可(注意键名使用小写)。
5.4 下载后使用脚本分析
客户也可以将日志数据从 S3 下载到本地或者私有数据中心进行成本分析。
5.4.1 参考代码
以下脚本会按天从 S3 下载调用日志(跳过 data/ 子目录中的大载荷文件),按照日志的实际结构解析 input.inputTokenCount 等字段,并按部门、项目统计 Token 用量与估算成本。需要注意的是,Python 中字典的键是区分大小写的,Department 与 department 会被视为不同的键,注意替换自己的模型 ID。
#!/usr/bin/env python3
"""
本地分析 Amazon Bedrock 模型调用日志(S3 投递格式)
需要安装: pip install boto3 pandas
用法:
  python analyze_fixed.py --download   # 从 S3 下载后分析
  python analyze_fixed.py              # 分析 ./bedrock_logs/ 下已有文件
"""

import glob
import gzip
import json
import os
import re
import sys

import boto3
import pandas as pd

# ==================== 配置区 ====================
BUCKET_NAME = 'bucket-name'
KEY_PREFIX = ''                      # 启用日志时配置的 S3 key prefix(没有则留空),需以 / 结尾
ACCOUNT_ID = '<account-id>'
REGION = 'us-east-1'
LOCAL_DIR = './bedrock_logs'

# 日期过滤范围(UTC,含首尾)
START_DATE = '2026-10-01'
END_DATE = '2026-10-09'

# 模型价格配置 (USD / 百万 tokens),请以官方价格页面为准,按 modelId 子串匹配
PRICING = {
    'nova-lite': {'input': 0.06, 'output': 0.24, 'cache_read': 0.015, 'cache_write': 0},
    'default': {'input': 0, 'output': 0, 'cache_read': 0, 'cache_write': 0},
}

# ==================== 函数定义 ====================

def download_logs_from_s3(bucket, prefix, start_date, end_date, local_dir=LOCAL_DIR):
    """按天下载日志文件;跳过 data/ 目录下的大载荷文件"""
    s3 = boto3.client('s3')
    paginator = s3.get_paginator('list_objects_v2')
    files = []
    for day in pd.date_range(start_date, end_date, freq='D'):
        day_prefix = f"{prefix}{day:%Y/%m/%d}/"
        print(f"正在从 s3://{bucket}/{day_prefix} 下载日志...")
        for page in paginator.paginate(Bucket=bucket, Prefix=day_prefix):
            for obj in page.get('Contents', []):
                key = obj['Key']
                if '/data/' in key or not key.endswith('.json.gz'):
                    continue
                # 保留相对路径,避免不同小时目录下的同名文件互相覆盖
                local_file = os.path.join(local_dir, key[len(prefix):])
                os.makedirs(os.path.dirname(local_file), exist_ok=True)
                s3.download_file(bucket, key, local_file)
                files.append(local_file)
    print(f"共下载 {len(files)} 个文件")
    return files


def parse_log_files(file_paths):
    """解析日志文件,展开为扁平的 DataFrame"""
    records = []
    for file_path in file_paths:
        opener = gzip.open if file_path.endswith('.gz') else open
        with opener(file_path, 'rt', encoding='utf-8') as f:
            for line in f:
                if not line.strip():
                    continue
                try:
                    r = json.loads(line)
                except json.JSONDecodeError:
                    continue
                if r.get('schemaType') != 'ModelInvocationLog':
                    continue
                inp, out = r.get('input') or {}, r.get('output') or {}
                records.append({
                    'timestamp': r.get('timestamp'),
                    'requestId': r.get('requestId'),
                    'operation': r.get('operation'),
                    # InvokeModel 类请求会记录完整 ARN,统一成 ID 便于聚合
                    'modelId': re.sub(r'^arn:aws[^/]*/', '', r.get('modelId', '')),
                    'requestMetadata': r.get('requestMetadata') or {},
                    'inputTokens': inp.get('inputTokenCount') or 0,
                    'cacheReadTokens': inp.get('cacheReadInputTokenCount') or 0,
                    'cacheWriteTokens': inp.get('cacheWriteInputTokenCount') or 0,
                    'outputTokens': out.get('outputTokenCount') or 0,
                })
    print(f"共解析 {len(records)} 条记录")
    return pd.DataFrame(records)


def filter_by_date(df, start_date, end_date):
    df['timestamp'] = pd.to_datetime(df['timestamp'], utc=True)
    start = pd.Timestamp(start_date, tz='UTC')
    end = pd.Timestamp(end_date, tz='UTC') + pd.Timedelta(days=1)
    filtered = df[(df['timestamp'] >= start) & (df['timestamp'] < end)].copy()
    print(f"日期过滤后剩余 {len(filtered)} 条记录")
    return filtered


def calculate_cost(row):
    p = next((v for k, v in PRICING.items() if k in row['modelId']), PRICING['default'])
    return (row['inputTokens'] * p['input'] + row['outputTokens'] * p['output']
            + row['cacheReadTokens'] * p['cache_read'] + row['cacheWriteTokens'] * p['cache_write']) / 1_000_000


def analyze_by(df, metadata_key):
    """按某个 requestMetadata 键统计 Token 与成本(键名大小写敏感)"""
    print("\n" + "=" * 80 + f"\n 按 {metadata_key} 统计\n" + "=" * 80)
    df = df.copy()
    df[metadata_key] = df['requestMetadata'].apply(lambda m: m.get(metadata_key))
    df = df[df[metadata_key].notna()]
    if df.empty:
        print(f"没有找到包含 {metadata_key} 的记录")
        return None
    df['cost'] = df.apply(calculate_cost, axis=1)
    result = df.groupby([metadata_key, 'modelId']).agg(
        call_count=('requestId', 'count'),
        input_tokens=('inputTokens', 'sum'),
        cache_read_tokens=('cacheReadTokens', 'sum'),
        cache_write_tokens=('cacheWriteTokens', 'sum'),
        output_tokens=('outputTokens', 'sum'),
        estimated_cost_usd=('cost', 'sum'),
    ).reset_index().sort_values('estimated_cost_usd', ascending=False)
    print(result.to_string(index=False))
    print(f"\n 总成本: ${result['estimated_cost_usd'].sum():.6f}")
    return result


def main():
    if len(sys.argv) > 1 and sys.argv[1] == '--download':
        prefix = f"{KEY_PREFIX}AWSLogs/{ACCOUNT_ID}/BedrockModelInvocationLogs/{REGION}/"
        files = download_logs_from_s3(BUCKET_NAME, prefix, START_DATE, END_DATE)
    else:
        files = [f for f in glob.glob(f'{LOCAL_DIR}/**/*.json*', recursive=True) if '/data/' not in f]
    if not files:
        print(f"未找到日志文件,请使用 --download 参数从 S3 下载,或将日志文件放在 {LOCAL_DIR}/ 目录下")
        return

    df = parse_log_files(files)
    if df.empty:
        print("没有解析到任何记录")
        return
    df = filter_by_date(df, START_DATE, END_DATE)

    for key in ('Department', 'ProjectName'):
        result = analyze_by(df, key)
        if result is not None:
            result.to_csv(f'{key.lower()}_cost_analysis.csv', index=False)
            print(f"已导出: {key.lower()}_cost_analysis.csv")


if __name__ == '__main__':
    main()
六、最佳实践
6.1 元数据使用最佳实践
- 制定元数据标准:在团队内部制定统一的元数据命名和使用标准,确保一致性,尤其要统一键名的大小写,避免出现
Project与project混用的情况 - 仅使用英文字符:键和值仅支持英文字母、数字、空白字符及 :
_ @ $ # = / + , - .,中文等内容请转换为英文代码 - 控制数量与长度:每个请求最多 16 个键值对,键和值的长度均不超过 256 个字符
- 避免敏感信息:不要在元数据中包含敏感信息
- 合理使用键值对:使用有意义的键名和值,便于后续查询和分析
- 定期审查元数据使用情况:确保元数据的使用符合预期,并根据需要进行调整
6.2 成本分析最佳实践
- 统一元数据格式:确保所有应用程序使用一致的元数据格式,便于后续分析
- 统一模型标识:在按模型聚合前,将 ARN 形式的
modelId统一为 ID - 建立成本模型:根据不同模型的实际价格(包括缓存读写等计费项),建立准确的成本计算模型
- 定期更新价格信息:确保查询中的价格参数是最新的,并定期与实际账单进行核对
- 设置成本预警:基于元数据分析结果,设置成本预警机制,避免意外支出
七、总结
Amazon Bedrock 的 Request Metadata 功能结合 Amazon CloudWatch 及 Amazon Athena 的强大分析能力,为用户提供了一种简单的方式来增强模型调用的可追踪性、可管理性以及成本可视化。目前 Converse 及 InvokeModel 系列 API 均已支持该功能,并适用于 Bedrock 上各厂商的模型。通过合理使用这些功能,您可以实现更精细的日志过滤、更有效的调用跟踪以及更精确的成本分配。
➡️ 下一步行动:
相关产品:
- Amazon Bedrock — 用于构建生成式人工智能应用程序和代理的端到端平台
- Amazon Athena — 使用 SQL 在 S3 中查询数据
- Amazon S3 — 适用于 AI、分析和存档的几乎无限的安全对象存储
- Amazon CloudWatch — 可观测性工具
- Amazon Glue — 简单、可扩展的无服务器数据集成
相关文章:
- 基于 Amazon Bedrock ApplyGuardrail API 的内容安全过滤:可观测性看板与运营实践
- 使用 Amazon Athena 分析 Kiro 团队用量报表:动态模型列的数据建模实践
- 基于 Application Inference Profile 为 Amazon Bedrock 构建分业务单元的近实时成本告警
- 基于 Amazon Bedrock AgentCore 与 AWS DevOps Agent 打造对话式多账户运维助手
*前述特定亚马逊云科技生成式人工智能相关的服务目前在亚马逊云科技海外区域可用。亚马逊云科技中国区域相关云服务由西云数据和光环新网运营,具体信息以中国区域官网为准。
本篇作者
AWS 架构师中心:云端创新的引领者探索 AWS 架构师中心,获取经实战验证的最佳实践与架构指南,助您高效构建安全、可靠的云上应用
|
 |
