Le Blog Amazon Web Services
Évaluez 100 % de vos interactions client grâce à l’IA générative avec Amazon Connect
Dans la plupart des centres de contact, les équipes qualité n’évaluent que 1 à 3 % des interactions. Les superviseurs écoutent manuellement des appels, remplissent des grilles de notation et espèrent avoir sélectionné les cas représentatifs. Le reste demeure invisible, et les écarts de conformité, les opportunités de coaching et les signaux de frustration client passent sous le radar.
Ce modèle était déjà insuffisant pour les agents humains. Les agents IA (voicebots, chatbots, assistants digitaux) amplifient le défi avec de nouveaux modes de défaillance : demandes mal comprises, réponses inexactes, hallucinations, boucles conversationnelles et transferts insuffisamment contextualisés vers un humain.
Ce blog post montre comment déployer un template AWS CloudFormation qui évalue automatiquement les interactions éligibles des agents humains et des agents IA, à l’aide de formulaires d’évaluation alimentés par l’IA générative, de règles de correspondance sémantique et d’alertes temps réel dans Amazon Connect.
L’opportunité : une assurance qualité avec les capacités IA incluses
Historiquement, les équipes arbitraient entre profondeur de revue et couverture, et assemblaient des outils séparés pour l’enregistrement, la transcription, le sentiment, les formulaires QA, le reporting et le coaching. Dans Amazon Connect, des capacités telles que l’analytics conversationnelle, les évaluations de performance, les agents IA et les tableaux de bord sont incluses dans le modèle de tarification du service : vous pouvez donc construire une assurance qualité à grande échelle sans ajouter un outil dédié à chaque étape.
Les coûts de communication restent applicables selon le canal et la région, que vous trouverez directement sur la page de tarification Amazon Connect.
La question passe de « quelles interactions pouvons-nous nous permettre d’analyser ? » à « quels critères qualité améliorent réellement l’expérience client et la performance opérationnelle ? ».
Pour vous accompagner, nous avons publié le workshop Contact Center AI Quality Management. Utilisez-le comme environnement sandbox, ou déployez le template directement dans votre instance et adaptez-le. En effet, avant de déployer en production, nous vous invitons à explorer la solution via le workshop AWS Contact Center AI Quality Management. Il vous permet de comprendre chaque composant, de tester les règles et les formulaires, et de valider l’approche dans un cadre guidé : accéder au workshop.
Prérequis
- Une instance Amazon Connect avec l’analytics conversationnelle configurée pour les canaux ciblés.
- Des flux activant l’analyse post-appel, post-chat ou temps réel selon vos scénarios.
- Les permissions IAM (Gestion des identités et des accès AWS) pour créer les formulaires d’évaluation, les règles, le rôle AWS Lambda et la fonction Lambda.
- Les quotas de règles, d’analytics conversationnelle et d’évaluations vérifiés dans votre région.
- Une instance de développement ou de test pour la validation avant la production.
- Une stratégie définie de conservation, de rédaction des données sensibles et de stockage des transcriptions, alignée sur vos exigences de sécurité et de conformité.
Personnaliser le template pour votre contexte
Le template CloudFormation (quality-management-evaluations.yaml) est un point de départ. Pour l’adapter :
- Reformulez les questions d’évaluation selon vos critères qualité et votre terminologie métier.
- Ajustez les affirmations sémantiques pour refléter les formulations réelles de vos clients et de vos agents.
- Modifiez les mots-clés des alertes temps réel selon votre contexte linguistique et sectoriel.
- Ajoutez ou supprimez des catégories en fonction de vos principaux motifs de contact.
- Adaptez les critères des agents IA aux capacités et limites connues de vos bots.
Le blueprint : trois types d’interaction, un seul template
La solution couvre trois parcours : appels vocaux d’agents humains, interactions vocales d’agents IA et interactions chat d’agents IA.
Le template CloudFormation déploie :
| Composant | Quantité | Détail |
|---|---|---|
| Formulaires d’évaluation | 3 | Agent humain voix, agent IA voix, agent IA chat |
| Règles post-appel / post-chat | 21 | Catégorisation et déclenchement d’évaluations automatisées |
| Règles temps réel | 4 | Correspondance de mots/expressions et sentiment pour alerter les superviseurs |
| Fonction Lambda | 1 | Ressource personnalisée pour associer formulaires et règles |
| Total des règles | 25 | À déduire du quota disponible dans l’instance |
Pourquoi trois formulaires distincts ?
Les agents humains et les agents IA n’échouent pas de la même manière, leurs critères diffèrent donc :
| Critère | Agent humain voix | Agent IA voix | Agent IA chat |
|---|---|---|---|
| Conformité aux scripts | ✓ | ||
| Qualité de communication | ✓ | ||
| Complétude de tâche | ✓ | ✓ | |
| Détection d’hallucination | ✓ | ✓ | |
| Détection de boucle | ✓ | ✓ | |
| Qualité du transfert | ✓ | ✓ | |
| Taux de containment | ✓ | ✓ | |
| Nombre de tours conversationnels | ✓ |
Un formulaire unique ne peut pas couvrir ces dimensions hétérogènes ; des formulaires spécialisés adaptent l’évaluation au type d’interaction.
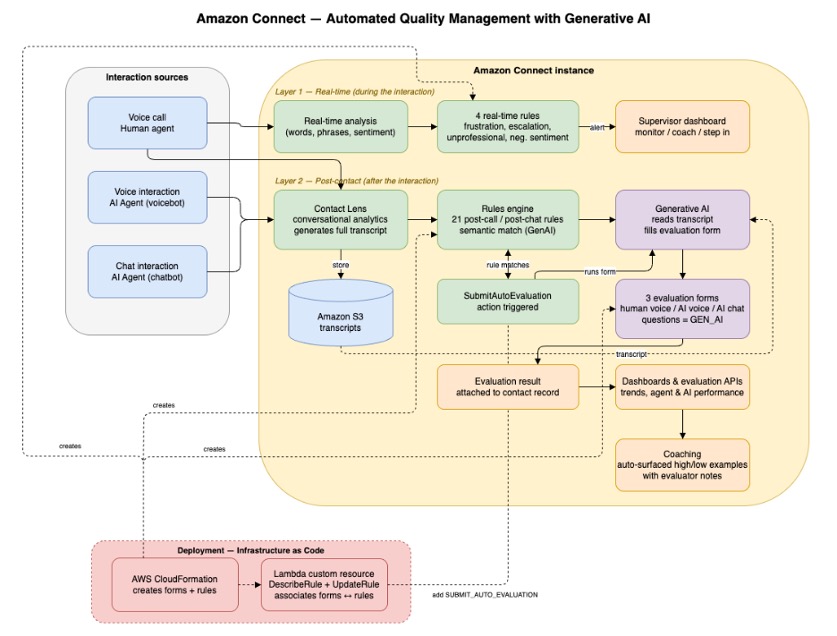
Figure 1 : Schéma d’architecture
Layer 1 : alertes temps réel
Pendant un appel en cours, quatre règles temps réel déclenchent des alertes sur le tableau de bord du superviseur :
| Type d’alerte | Exemples de déclencheurs |
|---|---|
| Frustration client | « c’est ridicule, » « j’attends depuis longtemps » |
| Demande d’escalade | « je veux parler à un responsable » |
| Langage non professionnel | « ce n’est pas mon problème, » « je m’en fiche » |
| Sentiment négatif | Seuil de détection de sentiment dépassé |
Ces règles reposent sur la correspondance exacte/motif sur des mots et expressions, et sur l’analyse de sentiment de Contact Lens. Lorsqu’une règle se déclenche, un superviseur peut surveiller l’appel, coacher l’agent ou intervenir.
Pourquoi pas la correspondance sémantique en temps réel ?
L’analyse sémantique évalue le sens global d’une conversation et nécessite un contexte suffisant. Les règles temps réel privilégient les signaux immédiatement exploitables (mots, expressions, sentiment) pour alerter un superviseur pendant l’interaction. Utilisez les règles temps réel pour l’intervention immédiate ; utilisez les règles post-contact pour l’analyse qualitative nécessitant le transcript complet.
Layer 2 : règles post-contact et évaluations d’IA générative
Après la fin d’un appel ou d’un chat, Amazon Connect exécute l’analyse post-contact. Les règles peuvent alors catégoriser l’interaction et soumettre automatiquement un formulaire d’évaluation :
Fin de l’interaction
→ Contact Lens génère la transcription complète
→ Le moteur de règles évalue les conditions sémantiques
→ Si la règle correspond → action SubmitAutoEvaluation déclenchée
→ Amazon Connect utilise l’IA générative pour renseigner et soumettre le formulaire
→ Résultat d’évaluation rattaché au contact
Les règles s’appliquent uniquement aux nouveaux contacts créés après leur publication ; elles ne peuvent pas réévaluer rétroactivement des conversations déjà stockées.
Les trois types de correspondance
La correspondance exacte recherche un mot ou une expression littérale, sans tenir compte de la casse :
billing
Identifie `billing` ou `Billing`. Utile pour les termes métier connus, les scripts de conformité ou les formulations précises.
neighbo*
Identifie `neighbor`, `neighbors`, `neighborhood`.
credit [is not within 1 word from] card
Détecte `credit` en excluant `credit card`.
La correspondance sémantique en langage naturel utilise l’IA générative pour déterminer si une affirmation est vraie ou fausse au regard du transcript complet :
The customer's issue was resolved during the call.
L’objectif n’est pas de trouver les mots `issue`, `resolved`, `call` ; Connect évalue le sens global. Utile pour les conditions contextuelles, ou lorsque les formulations sont trop larges pour des mots-clés.
Note : les affirmations d’exemple sont en anglais ; rédigez-les dans la langue de vos interactions si la correspondance sémantique d’Amazon Connect la prend en charge.
Pour améliorer la précision :
- Rédigez des affirmations qui s’évaluent clairement à vrai ou faux.
- Utilisez agent et customer de manière cohérente.
- Utilisez les guillemets uniquement pour une formulation exacte.
- Regroupez uniquement des intentions sémantiquement proches sur les cartes multi-intents.
Documentation : Use Generative AI to semantically match contacts with natural language statements.
Évaluer les agents humains
Pour les appels d’agents humains, le formulaire automatisé peut répondre à des questions ouvertes : raison principale de l’appel, résultat, identification et traitement du problème par l’agent, expression de frustration du client, satisfaction probable, respect des éléments de conformité attendus.
L’évaluation va au-delà des mots-clés et des questions binaires : elle prend en compte l’ensemble du transcript, le ton du client, les étapes de résolution et la conclusion. Considérez une réponse générée comme un signal opérationnel qui complète, sans remplacer, les contrôles de conformité formels requis dans votre secteur.
Évaluer les agents IA vocaux
Le formulaire dédié aux agents IA vocaux évalue notamment : la réalisation d’au moins une action en libre-service ; la réussite complète, partielle ou l’échec de la tâche ; la frustration ou la confusion ; les demandes de transfert ; la qualité du handoff ; les incompréhensions ; les réponses inexactes ou fabriquées ; les boucles de dialogue ; et un résumé de résolution avec recommandations.
Exemples de catégories créées par le template :
- ai-voice-task-completed
- ai-voice-customer-frustrated
- ai-voice-transfer-requested
- ai-voice-human-handoff
- ai-voice-misunderstand
- ai-voice-hallucination
- ai-voice-loop-detected
Ces catégories permettent de suivre la performance de l’agent IA au fil des itérations de prompt, de base de connaissances, d’outils ou de logique de routage.
Évaluer les agents IA conversationnels
Le même modèle s’applique au chat, déclenché après l’analyse post-chat via l’événement `OnPostChatAnalysisAvailable`. Les critères sont comparables : résolution de tâche, containment, frustration, demande de transfert, qualité du handoff, incompréhension, hallucination et boucles. Le chat ajoute des spécificités : les échanges sont souvent multi-tours, asynchrones et mêlent différents médias (texte, boutons, cartes, liens), le nombre de tours avant résolution, le maintien du contexte et le taux de containment y sont particulièrement utiles.
Déployer les formulaires et règles avec AWS CloudFormation
Le template utilise `AWS::Connect::EvaluationForm` pour créer les formulaires. Structure simplifiée :
HumanAgentEvaluationForm:
  Type: AWS::Connect::EvaluationForm
  Properties:
    InstanceArn: !Ref ConnectInstanceArn
    Title: human-agent-voice-evaluation
    Status: ACTIVE
    AutoEvaluationConfiguration:
      Enabled: true
    TargetConfiguration:
      ContactInteractionType: AGENT
    Items:
      - Section:
          Title: Call Classification
          Items:
            - Question:
                Title: What was the primary reason for the customer's call?
                QuestionType: TEXT
                QuestionTypeProperties:
                  Text:
                    Automation:
                      AnswerSource:
                        SourceType: GEN_AI
Propriétés clés :
- Enabledactive l’évaluation automatisée.
- QuestionType: TEXTpermet à l’IA générative de fournir une réponse libre.
- ContactInteractionTypedistingue les interactions humaines (AGENT) des interactions automatisées (AUTOMATED).
- Itemsdéfinit les sections et questions du formulaire.
Un formulaire peut contenir jusqu’à 100 sections et 100 questions. Documentation : AWS::Connect::EvaluationForm.
Associer automatiquement les formulaires aux règles
Une fonction AWS Lambda s’exécute comme ressource personnalisée CloudFormation pour associer les formulaires aux règles, en gardant un déploiement reproductible et piloté par l’infrastructure en tant que code :
- CloudFormation crée les formulaires et les règles.
- La ressource personnalisée invoque la fonction Lambda.
- La fonction récupère chaque règle avec DescribeRule.
- Elle appelle UpdateRule pour ajouter l’action SUBMIT_AUTO_EVALUATION.
- Elle associe l’identifiant du formulaire d’évaluation à la règle concernée.
Permissions minimales :
Quotas et considérations de déploiement
Le template déploie 25 règles. Ce nombre n’est pas un quota Connect ; il doit être déduit des règles déjà présentes dans votre instance.
Les valeurs ci-dessous sont des quotas Amazon Connect par défaut susceptibles d’évoluer ; vérifiez les valeurs à jour et les possibilités d’ajustement sur la page Amazon Connect service quotas.
| Élément | Valeur par défaut / information |
|---|---|
| Règles par instance | 500 par défaut, ajustable |
| Questions complétées automatiquement par l’IA générative sur un contact | 15 par défaut, ajustable via AWS Support |
| Évaluations par contact | 10, non ajustable |
| Formulaire d’évaluation | Jusqu’à 100 sections et 100 questions |
L’évaluation automatique ne remplace pas une évaluation manuelle : si une évaluation manuelle existe déjà pour un contact, l’évaluation automatisée échoue pour ce contact.
Bonnes pratiques de conception
- Commencez avec quelques règles à forte valeur (résolution, escalade, frustration, conformité, handoff humain).
- Analysez les faux positifs et faux négatifs avant d’étendre ; une règle sémantique imprécise produit des catégories peu exploitables, même à fort volume.
- Utilisez les règles temps réel pour l’intervention immédiate ; les règles post-contact et les évaluations GenAI pour l’analyse qualitative nécessitant le contexte complet.
- Faites évoluer règles et catégories à mesure qu’apparaissent de nouveaux motifs de contact, produits et comportements.
- Pour les centres multilingues, adaptez phrases et mots-clés à chaque langue prise en charge.
Exploiter les résultats
Construisez une boucle d’amélioration continue :
- Identifiez les motifs de contact récurrents.
- Analysez les causes de sentiment négatif ou de transferts fréquents.
- Repérez les écarts de conformité et les besoins de coaching.
- Pour les agents IA, analysez les incompréhensions, les hallucinations et les boucles.
- Ajustez les prompts, bases de connaissances, outils et règles de routage.
- Mesurez l’évolution des métriques après chaque changement.
Les tableaux de bord Amazon Connect suivent les évaluations des agents, les tendances des motifs de contact et la performance des agents IA sans outil de BI tiers. Vous pouvez aussi utiliser les APIs d’évaluation pour intégrer les résultats à votre environnement analytique, et les règles Contact Lens peuvent créer des tâches ou envoyer des notifications pour les scénarios urgents.
Des évaluations au coaching : trouver les bons exemples
Évaluer 100 % des interactions produit un grand nombre de contacts notés. Amazon Connect fait automatiquement remonter les exemples pertinents lorsqu’un manager prépare un coaching : pour un thème donné, il reçoit les évaluations récentes où l’agent a obtenu un score élevé ou faible, accompagnées des notes de l’évaluateur (humain ou IA) expliquant les comportements derrière chaque résultat.
Pour la « désescalade », un manager obtient des appels où l’agent a su apaiser un client frustré, aux côtés d’appels escaladés, avec l’éclairage sur ce qui a conduit à chaque issue. Cela se combine naturellement avec le template : les évaluations GenAI génèrent les interactions notées et annotées, et Connect met les plus pertinentes à disposition du manager au moment du coaching. Disponible dans toutes les régions où Amazon Connect est proposé. Voir l’annonce Amazon Connect.
Au-delà de l’assurance qualité : validation et regression testing
Les formulaires d’évaluation GenAI servent aussi avant et après les mises en production.
- Avant le go-live : pour un nouveau flow, voicebot ou agent IA, les évaluations automatisées vérifient que les réponses sont cohérentes et alignées sur les attentes métier, sans maintenir de jeu de tests conversationnels manuels.
- Après un changement : lorsqu’un prompt, une base de connaissances ou un outil change, les mêmes règles et formulaires servent de regression testing sur 100 % des interactions, pas sur un échantillon. Exemple : après une modification de prompt pour améliorer le traitement des réclamations, les évaluations détectent que le taux d’hallucination passe de 2 % à 8 % en 24 heures, avant qu’un client ne le signale.
- Pour les expériences agentiques : lorsque l’IA génère ses réponses sans script figé, l’évaluation GenAI devient le filet de sécurité qui détecte incohérences, hallucinations et réponses hors contexte avant les clients.
Cette approche transforme l’assurance qualité en validation continue : les évaluations GenAI jouent le rôle de tests automatisés exécutés sur chaque interaction, et le suivi des métriques après chaque changement fournit le monitoring continu – la même logique de tests automatisés et d’observabilité que les équipes DevOps appliquent au code, ici appliquée aux systèmes conversationnels.
Nettoyage
Lorsque vous avez terminé vos tests, supprimez la stack CloudFormation pour retirer les trois formulaires d’évaluation, les 25 règles et la fonction Lambda, et libérer votre quota de règles. Dans la console, ouvrez AWS CloudFormation, sélectionnez la stack et choisissez Delete ; ou via l’AWS CLI : aws cloudformation delete-stack –stack-name <nom-de-votre-stack>. La suppression ne retire pas les résultats d’évaluation ni les transcriptions déjà rattachés aux contacts : ces données restent régies par la stratégie de conservation de votre instance.
Conclusion
L’assurance qualité ne se limite plus à un échantillon aléatoire. Amazon Connect permet de bâtir un système qualité automatisé couvrant agents humains et agents IA, passant de 1-3 % à 100 % de couverture sans augmenter vos effectifs QA.
Avec ce template, vous déployez trois formulaires d’évaluation alimentés par l’IA générative, 21 règles de catégorisation post-appel/post-chat, quatre règles d’alerte temps réel et une association automatisée règles↔formulaires via AWS Lambda.
Déployez le template dans une instance de test, adaptez les questions et règles à votre domaine, validez les résultats, puis promouvez en production.
Pour aller plus loin :
- Workshop Contact Center AI Quality Management
- Créer une règle qui soumet une évaluation automatique
- Évaluer la performance des interactions avec l’IA générative
- Correspondance sémantique en langage naturel
- Exact Match, Pattern Match et Semantic Match
- AWS::Connect::EvaluationForm
- Évaluer la performance des interactions
- API GetContactEvaluation
- Tarification Amazon Connect