Le Blog Amazon Web Services
Video-as-Code Agent : Votre prochaine vidéo marketing est un fichier .html
Une équipe marketing publie aujourd’hui la même annonce sous des dizaines de formes : un format vertical pour les réseaux sociaux, un format paysage pour le site, une version par langue, par marché et par audience, puis une nouvelle série à chaque lancement. Chaque vidéo demande un motion designer, un monteur, un sound designer et plusieurs allers-retours de validation. Le volume demandé augmente plus vite que les équipes, et chaque déclinaison doit garder la charte, les noms exacts des produits et les chiffres validés.
Dans cet article, je présente Video-as-Code Agent, un agent qui joue le rôle de directeur créatif. Il lit la source, décide de l’idée, du style, du mouvement et de la musique, écrit le code qui dessine chaque image et chaque son, regarde ses propres rendus et les corrige, puis publie le MP4. L’agent tourne sur Amazon Bedrock AgentCore pour déployer et exploiter des agents, avec Claude Opus 5.5. Le rendu repose sur le framework open source HyperFrames.
À partir d’une seule consigne, l’agent a livré trois épisodes TikTok d’une série au format 1080×1920, avec musique et sound design sans autre message. Vous verrez pourquoi l’approche par le code rend ce résultat reproductible et modifiable, comment l’architecture sépare le modèle du code qu’il exécute, ce que contient la boîte à outils de rendu, et quels cas d’usage média elle ouvre.
Le besoin
Le besoin tient en quatre exigences, que l’on retrouve dans la plupart des équipes marketing et média.
- Le volume et la variété. Une campagne se décline en formats, en langues et en audiences. Produire chaque version à la main limite le nombre de versions qu’une équipe peut tenir, et pousse à réutiliser le même gabarit jusqu’à ce que toutes les vidéos se ressemblent.
- L’exactitude. Un nom de produit, une commande, un prix ou un chiffre de performance affiché à l’écran doit être exactement celui de la source validée. Une vidéo marketing qui invente un chiffre pose un problème de conformité, pas seulement de qualité.
- La modification par petites touches. Le client relit et donne des notes de réalisateur : « coupe sèche à 0:03 », « ralentis le zoom final », « le logo plus tôt ». Chaque note doit coûter une modification ciblée, pas une nouvelle production.
- La cohérence du son et de l’image. Un impact doit tomber sur l’image où l’objet touche le sol, un titre sur un temps de la musique, une voix off sur la bonne scène. Cette synchronisation à l’image près est ce qui distingue une vidéo marketing d’un diaporama animé.
Le problème : générer des pixels ou générer du code
Deux approches existent pour produire une vidéo avec l’IA générative. La première demande à un modèle de génération vidéo de produire directement les pixels. La seconde demande à un modèle de langage d’écrire le programme qui dessine chaque image, puis exécute ce programme.
Les modèles de génération vidéo produisent leurs images par échantillonnage, à partir d’une graine aléatoire. La documentation d’Amazon Nova Reel le décrit ainsi : changer la graine sans rien changer d’autre produit une vidéo totalement nouvelle, qui respecte toujours la consigne. Cette propriété est utile pour explorer des idées. Elle l’est moins pour les quatre exigences du besoin : une retouche demandée par le client produit un nouveau plan, pas le même plan corrigé, et le texte exact ou le timing à l’image près demandent des itérations.
Le son pose la même question. Une piste générée par échantillonnage change à chaque appel, alors qu’une coupe vidéo attend un impact sur une image précise.
Le code a les propriétés inverses. Une page HTML dont chaque pixel est une fonction du temps donne la même image à chaque rendu. Une note du client devient une modification de quelques lignes, puis un nouveau rendu de la seule scène concernée. Les noms, les commandes et les chiffres affichés viennent du texte source. L’agent compose aussi le son en code : une partition MIDI jouée par FluidSynth, et des effets synthétisés hors ligne par SuperCollider avec une graine fixe.
Vue d’ensemble de la solution
L’idée tient en une phrase : on laisse Claude Opus 5.5 être très créatif dans le code, et HyperFrames transforme ce code en vidéo à l’identique à chaque rendu. Une boucle de revue relie les deux : le modèle rend, regarde ses images, se note, corrige, et recommence. Trois briques portent cette idée.
Claude Opus 5.5, le directeur créatif
Anthropic a publié Claude Opus 5.5 le 22 septembre 2026, et le modèle est disponible sur Amazon Bedrock depuis le même jour. Claude ne génère ni vidéo ni audio. Les modèles Claude acceptent du texte et des images en entrée et produisent du texte. L’agent s’appuie sur ces deux capacités : il écrit le code de la vidéo, et il regarde les images extraites de ses rendus. Le guide vision d’Anthropic et l’API Converse d’Amazon Bedrock fixent les limites de taille et de nombre d’images par requête : l’agent ne regarde donc jamais une vidéo entière, mais une image par scène, des planches contact et des bandes de transition.
HyperFrames, le moteur de rendu
HyperFrames est un framework open source de HeyGen, sous licence Apache 2.0, qui transforme du HTML, du CSS, des médias et des animations en MP4 déterministes. Quatre notions suffisent pour comprendre ce qu’il apporte.
- Une composition est une page HTML. Chaque élément qui apparaît dans la vidéo, un titre, un plan vidéo, une piste audio, porte des attributs
data-*qui disent quand il commence, combien de temps il dure et sur quelle piste il se trouve. La timeline de la vidéo est donc écrite dans la page elle-même, et une note comme « coupe sèche à 0:03 » devient la modification d’un attribut. - Les animations passent par des adaptateurs. L’agent anime avec les bibliothèques du web qu’il connaît : GSAP pour les timelines, Three.js pour la 3D, anime.js, Lottie ou les animations CSS. Un adaptateur relie chaque bibliothèque à l’horloge de HyperFrames, pour que l’animation soit pilotée par le temps de la vidéo et non par l’horloge système.
- Le rendu cherche l’instant au lieu de lire la vidéo. Chaque composition expose une fonction
seek(t). Le moteur n’appelle jamaisplay(): il positionne la page au temps de l’image, capture, puis passe à l’image suivante. HeyGen décrit ce principe dans How HyperFrames Solved AI Video Rendering : sous Linux, le moteur pilotechrome-headless-shellen mode déterministe, une image à la fois, puis encode le résultat avec FFmpeg. - Le déterminisme est un contrat. Pas d’horloge système, pas d’aléatoire sans graine, pas d’appel réseau au moment du rendu ; les vidéos incluses sont décodées à l’avance en images fixes et les polices sont embarquées. En échange, la même composition donne la même vidéo à chaque rendu.
Amazon Bedrock AgentCore, l’exécution
L’agent est écrit avec le Strands harness, le harnais d’agent généraliste publié par l’équipe Strands Agents. Il tourne dans un AgentCore Runtime. Le code qu’il écrit s’exécute dans une session AgentCore Code Interpreter, et la conversation est conservée dans AgentCore Memory.
Architecture
L’utilisateur envoie sa consigne par InvokeAgentRuntime à Amazon Bedrock AgentCore Runtime, qui exécute l’agent Strands harness, appelle Claude Opus 5.5 dans Amazon Bedrock pour l’inférence et garde la conversation et ses notes dans AgentCore Memory ; le shell, les fichiers et les rendus tournent dans un AgentCore Code Interpreter placé dans un VPC, qui sort sur internet par une passerelle NAT pour récupérer les sources, appelle Amazon Polly pour la narration et Amazon Transcribe, et monte le bucket Amazon S3 du studio en /mnt/studio avec S3 Files ; Amazon ECR héberge l’image du runtime et Amazon CloudWatch ses journaux.
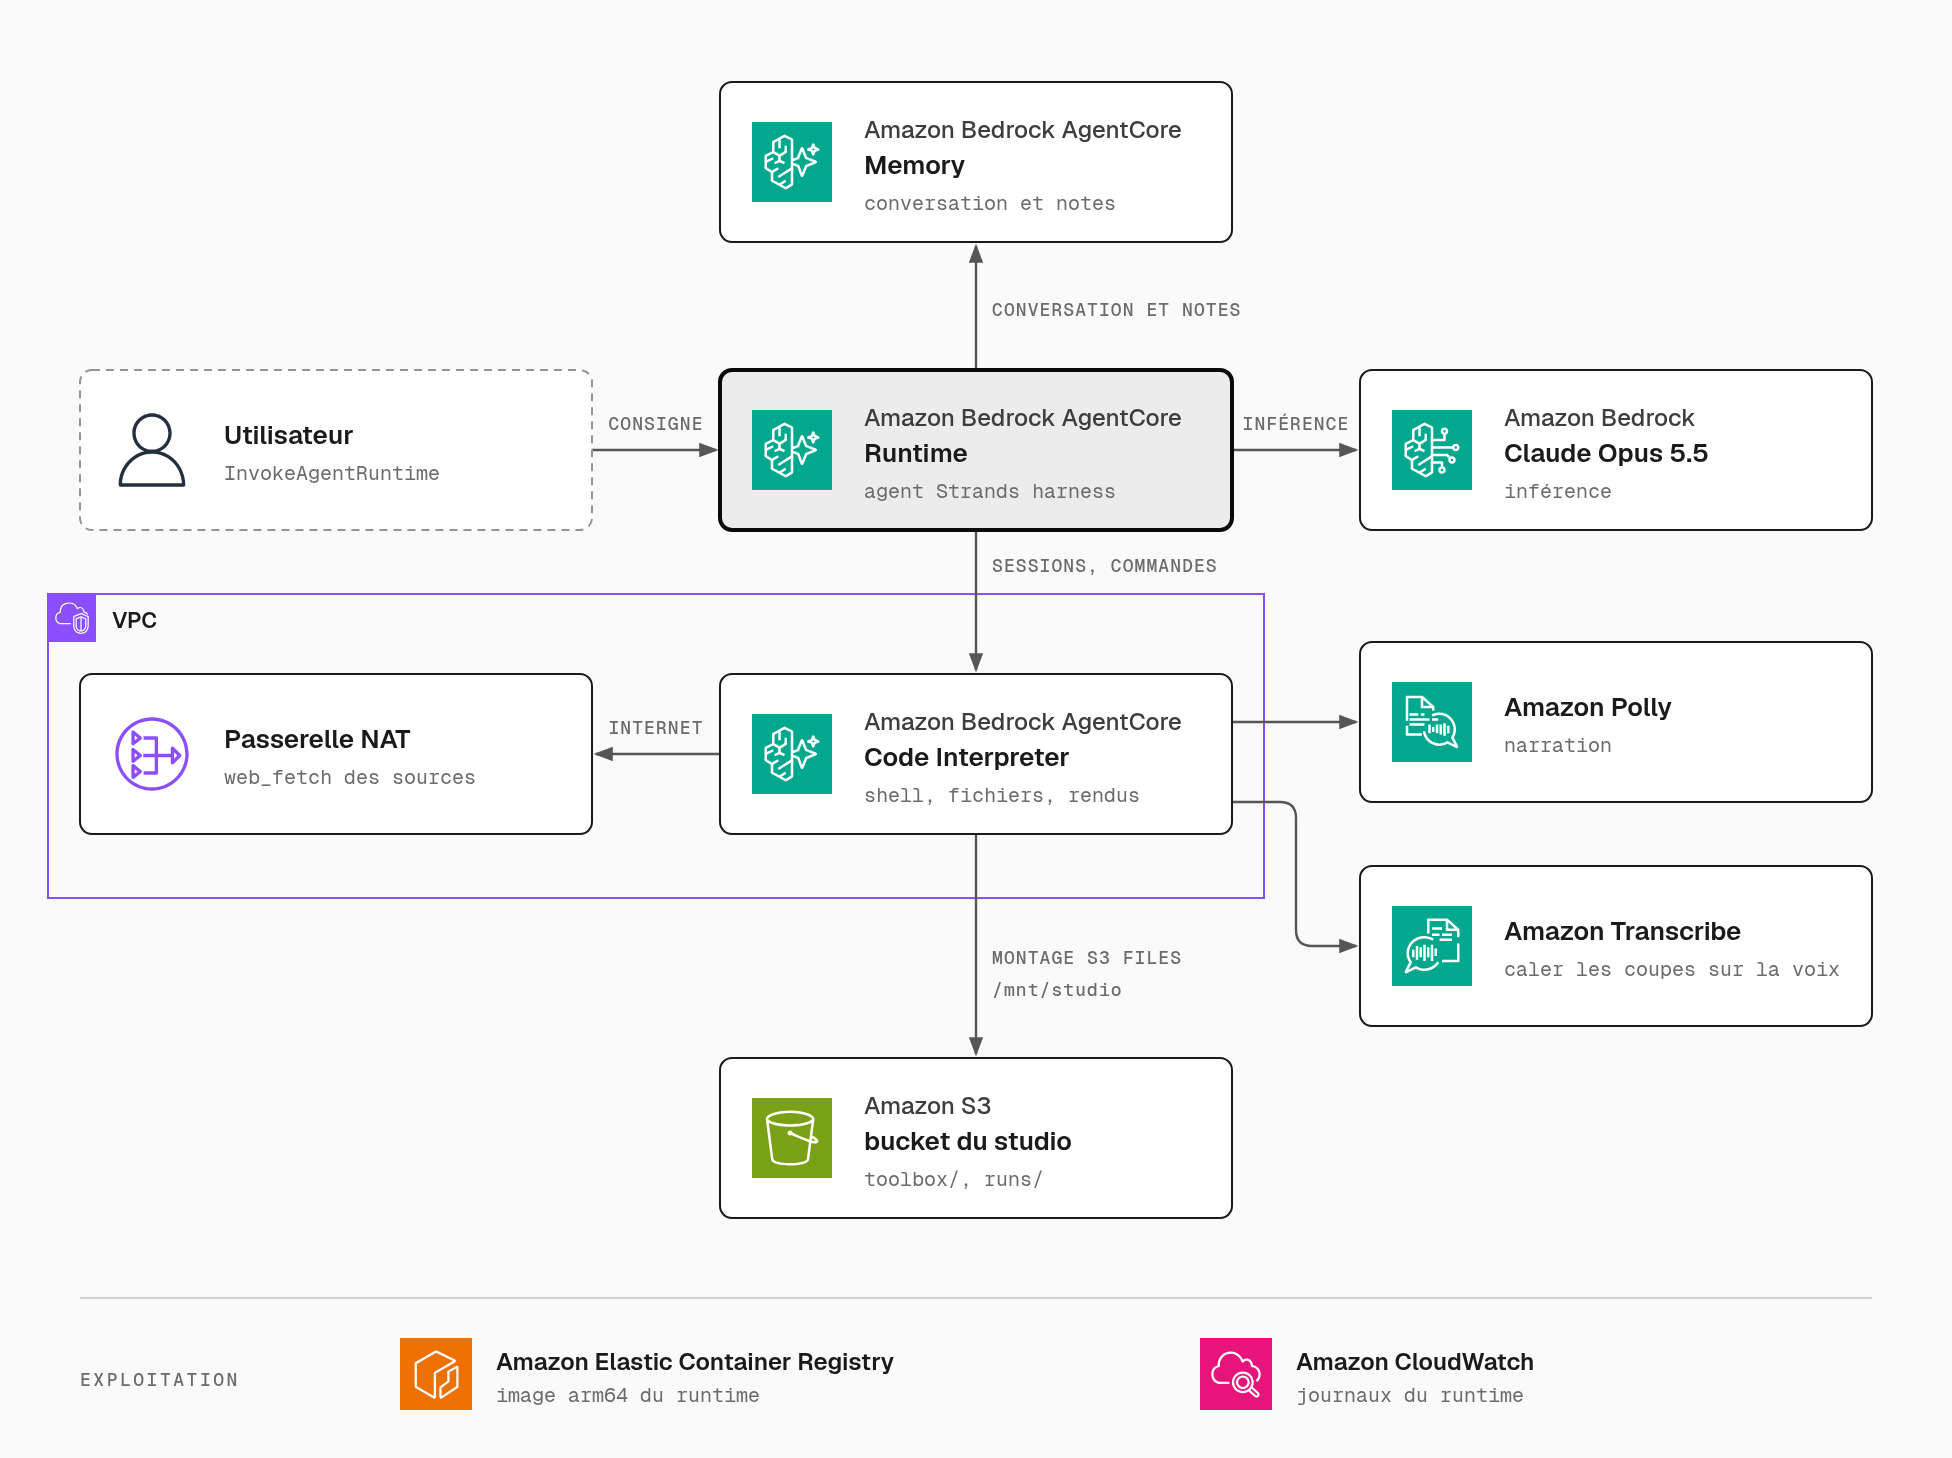
Figure 1 : architecture de l’agent. Le runtime détient le modèle ; le Code Interpreter exécute le code de l’agent, avec la boîte à outils montée depuis le bucket du studio.
Quatre décisions structurent cette architecture.
- Le code de l’agent ne détient pas les droits de l’agent. Le directeur écrit et exécute du code après avoir lu des pages web qu’il ne contrôle pas. Ce code tourne donc dans le Code Interpreter, avec son propre rôle d’exécution, limité au montage du studio, à Amazon Polly et à Amazon Transcribe. Le rôle du runtime détient l’accès au modèle sur Amazon Bedrock et l’API du Code Interpreter. Aucun des deux rôles ne détient les droits de l’autre.
- La boîte à outils vit sur un montage, pas dans une image. Un Code Interpreter ne prend pas d’image de conteneur personnalisée. La boîte à outils est donc construite une fois sur le bucket du studio, monté dans chaque session avec Amazon S3 Files, et chaque session démarre avec elle sans rien télécharger. Les rendus travaillent sur le disque local de la session, et seuls les fichiers finis sont copiés dans le dossier de publication, qui est le bucket vu comme un système de fichiers.
- Une consigne est un travail de fond. Une consigne revient immédiatement, et le tour de l’agent tourne en arrière-plan. Le client interroge l’état du tour avec un simple appel de statut sur la même session.
- Les notes du client reprennent le même film. Chaque appel à AgentCore Runtime porte un identifiant de session, et chaque session reçoit son propre environnement d’exécution isolé. Il reste actif tant que le tour de l’agent travaille en arrière-plan, et s’arrête après 15 minutes d’inactivité par défaut, ou 8 heures au plus. Chaque échange est donc aussi écrit dans AgentCore Memory sous cet identifiant : quand une note arrive après l’arrêt, un nouvel environnement relit la conversation depuis la mémoire. Les fichiers publiés restent dans le bucket, et l’agent tient un fichier
HANDOFF.mdqui dit ce qui est décidé, ce qui est un brouillon et ce qui reste à faire. Une note du client arrive donc chez un directeur qui se souvient du film, relitHANDOFF.md, modifie les scènes concernées et ne rend à nouveau que celles-ci.
La boucle de revue
La figure 2 montre la boucle que fixe le prompt système. C’est elle, plus que la taille du prompt, qui fait la qualité des vidéos. Opus 5.5 écrit le code de la vidéo, HyperFrames transforme ce code en MP4 (Chrome headless se positionne à chaque instant et capture l’image, FFmpeg encode), puis Opus 5.5 regarde ses rendus et mesure le son, se note de 1 à 10 sur six critères et corrige ses trois pires défauts avant un nouveau rendu, jusqu’à ce que chaque note atteigne 8 et qu’il publie le MP4″ />
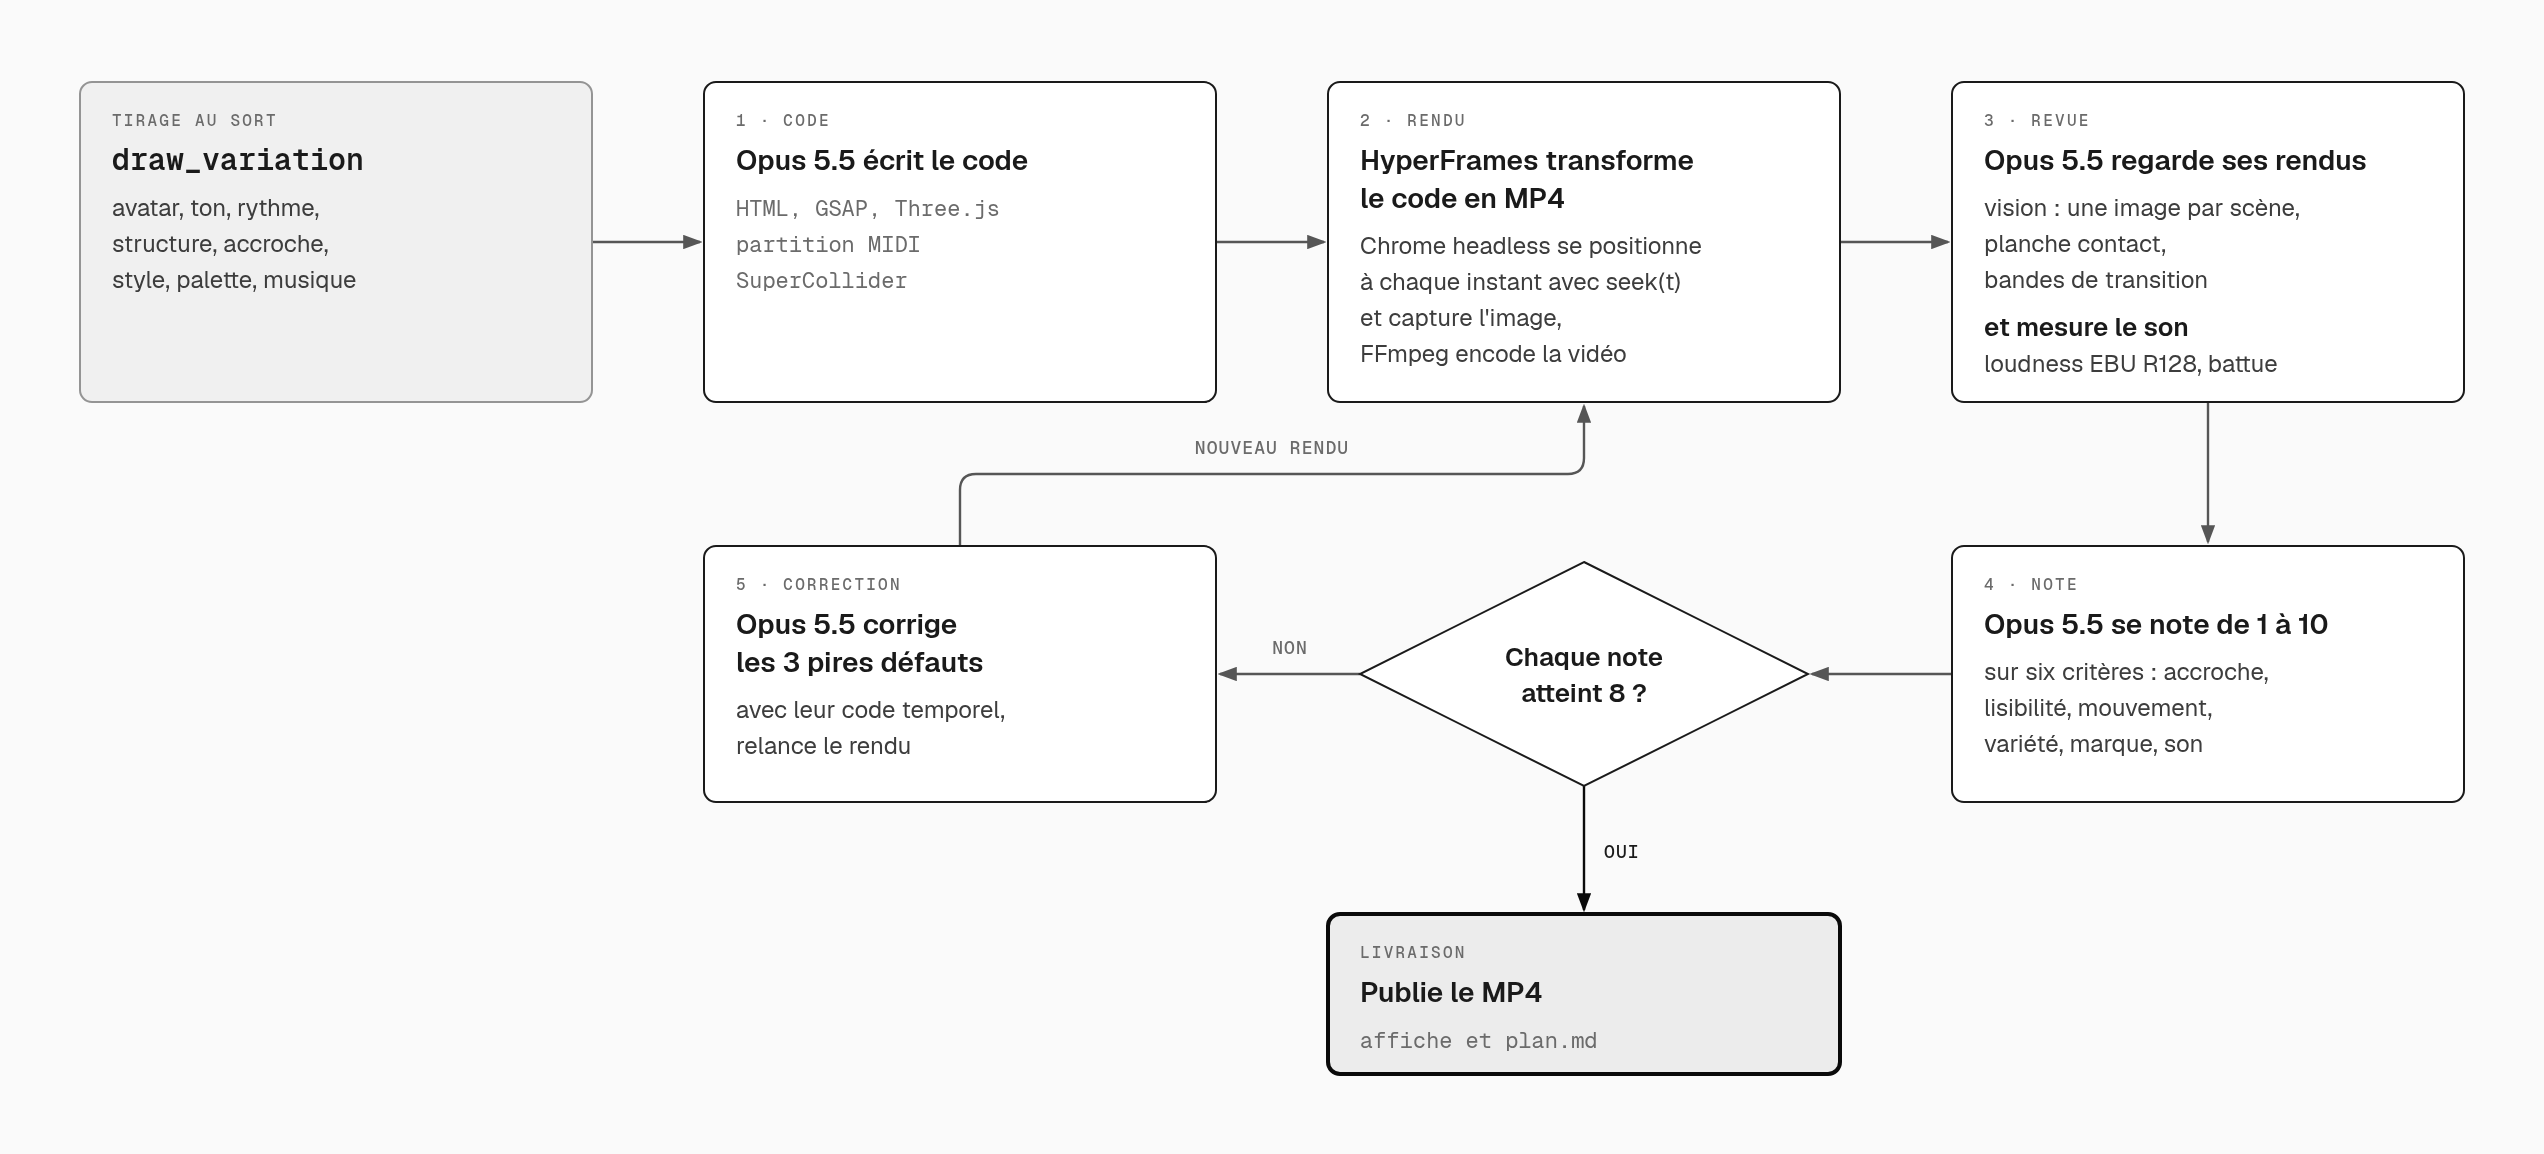
Figure 2 : la boucle de revue. Opus 5.5 écrit, HyperFrames rend, puis Opus 5.5 regarde, se note et corrige jusqu’à ce que chaque critère atteigne 8.
Le prompt système est court. Voici les passages qui changent le plus le résultat, tels qu’ils sont écrits, en anglais :
You can see your own frames: the `read` tool returns an image you can look at. That habit does more
for quality than anything in this prompt.

1. Before the full render, render one still per scene and look at them. Fix the look there, where
   a change is cheap.
2. After each render, make a contact sheet and a strip of every frame across each transition. Look
   at every image you make.
3. Be a harsh motion director, not a proud author. Score 1 to 10: hook in the first 2 seconds,
   readable on a phone, motion quality, variety, on-brand, sound sync. List the 3 worst problems
   with timecodes, fix them, re-render only what changed, and repeat until every score is 8 or more.

- A video that moves forward by swapping headlines over a fixed layout is an animated slide deck,
  not motion design. Build a world the camera travels through.
- Every frame is a pure function of time: no timers, no wall clock, no unseeded randomness, no
  network at render time.
- Use the real material: real names, real numbers, the real API call, the real UI. Nothing on screen
  is invented; if a claim cannot be traced to the source, it does not appear.
La planche contact est l’outil central de la boucle. La figure 3 en montre une, produite par l’agent sur le premier épisode de la démonstration : une ligne par scène, deux images par seconde. D’un coup d’œil, Opus 5.5 voit un texte qui sort du cadre, une scène qui ne bouge pas assez ou une transition qui saute.
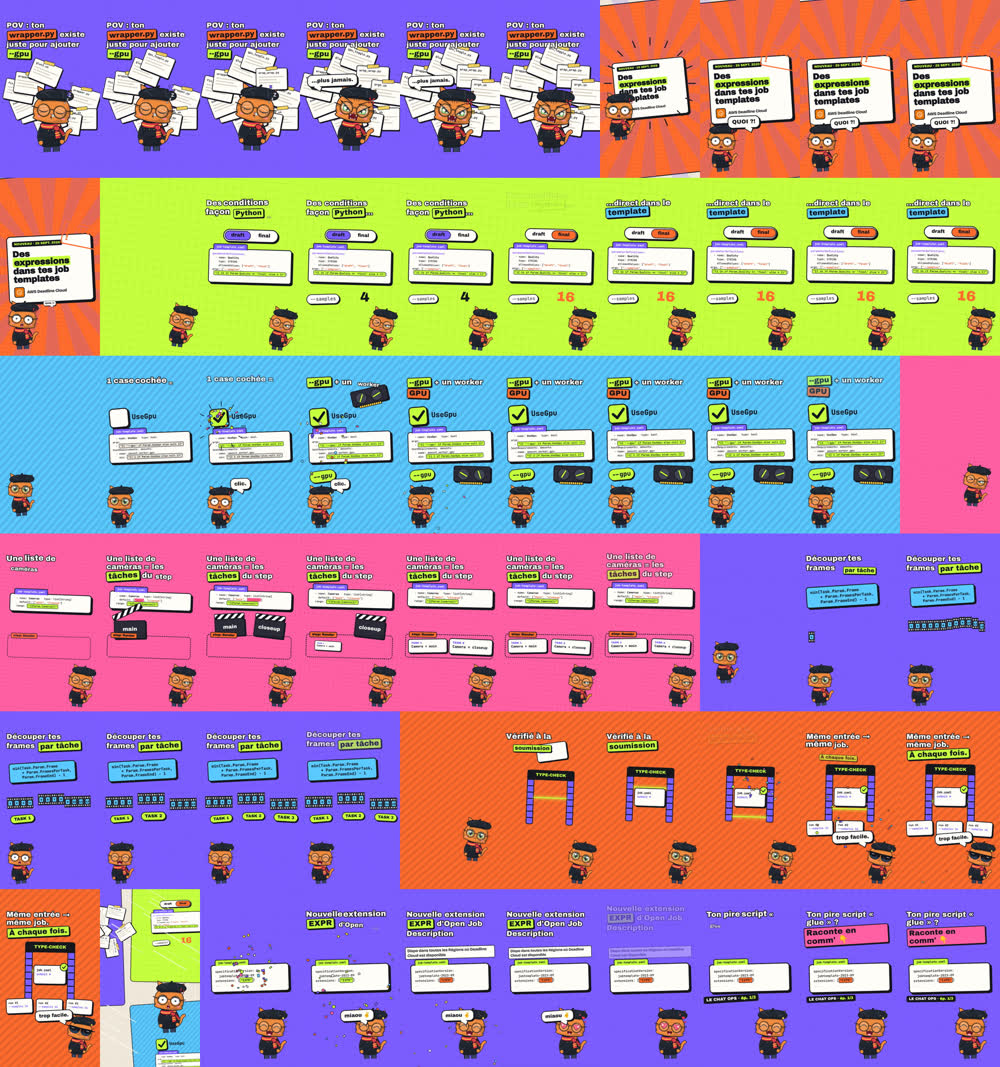
Figure 3 : une planche contact produite par l’agent pendant sa revue.
Le son suit une boucle comparable. L’agent mesure la loudness avec FFmpeg (filtre ebur128) contre une cible de -14 LUFS intégrés et un pic vrai sous -1 dBTP pour les réseaux sociaux, et vérifie avec librosa que les impacts tombent sur la grille de battue de sa partition.
Le tirage créatif
Laissé à lui-même, un modèle converge vers les mêmes quelques styles. Un modèle de langage ne tire pas non plus au sort : le tirage doit donc venir du code. Avant de planifier, l’agent appelle un outil draw_variation. L’outil choisit, avec une graine propre à la session, un avatar, un ton, un rythme, une structure, une accroche, un style, une palette et un genre musical. Il parcourt les attributs dans l’ordre et écarte, à chaque étape, les valeurs incompatibles avec ce qui est déjà choisi. Ce que la consigne décide elle-même n’est pas tiré.
Les listes et les incompatibilités tiennent dans un fichier de configuration. En voici un extrait :
[tone]
humorous = "Humorous: one clear joke per scene, timed on a beat."
epic = "Epic: scale, weight, a slow build to a big payoff."
warm = "Warm: human, friendly, soft light and round shapes."

[pace]
calm = "Calm: 80 to 95 BPM, long shots, one change every 2 to 4 beats."
fast = "Fast: 140 to 170 BPM, a cut on every beat."

[music]
lo-fi = "Lo-fi: dusty drums, soft keys, vinyl noise (FluidSynth and SuperCollider)."
chiptune = "Chiptune: square and triangle waves, arpeggios (SuperCollider)."

# A tone and the music that contradicts it.
[[exclude]]
when = "tone.epic"
excludes = ["music.lo-fi", "music.chiptune", "music.funk", "hook.visual-gag", "palette.pastel"]
Envoyée deux fois sur deux sessions, la même consigne sur une même annonce a donné deux films sans rapport visuel : l’un en bande dessinée sur fond néon, en écran partagé et sur une musique lo-fi, l’autre en risographie pastel, sur un compte à rebours et une musique chiptune.
La boîte à outils du studio
La boîte à outils est figée par versions et construite sur le montage. Aucun outil n’est obligatoire : le directeur choisit selon l’idée. Le tableau 1 regroupe les outils par étape de production.
| Étape | Outils | Rôle |
|---|---|---|
| Composition et rendu | HyperFrames, chrome-headless-shell via Playwright, FFmpeg |
Composer, capturer et encoder ; planches contact, image d’affiche, loudness |
| Animation | GSAP, anime.js, Three.js, React Flow, Lottie | Timelines, typographie animée, mondes 3D, schémas qui se construisent nœud par nœud |
| Partition | music21, mido, pretty_midi | Écrire la musique : tonalités, accords, formes calées sur la durée du montage, export MIDI |
| Instruments | FluidSynth avec la SoundFont GeneralUser GS | Jouer le MIDI avec des instruments acoustiques : piano, nappes, cordes, basse |
| Design sonore | SuperCollider, rendu hors ligne | Montées, whooshes, impacts, sub drops, basses et leads synthétiques, à partir d’un kit avec graine |
| Spatialisation | Module binaural maison sur les réponses impulsionnelles SADIE II (tête artificielle Neumann KU 100) |
Placer et déplacer chaque effet autour de l’auditeur au casque, élargir les ambiances |
| Montage et mastering | librosa, pydub, pedalboard | Battue d’une piste fournie, découpe, fondus, compression, limiteur |
| Image | Python préinstallé du Code Interpreter : Pillow, OpenCV, scikit-image, moviepy | Masques, transfert de couleur, flux optique, graphiques tirés de données réelles |
| Voix | Amazon Polly (moteur génératif), Amazon Transcribe | Narration ; caler les coupes sur une parole existante |
| Savoir-faire | Skills d’agent : contrat de composition HyperFrames, icônes AWS officielles, avatars, scènes Three.js | Les règles de chaque outil, chargées seulement quand l’agent en a besoin |
Tableau 1 : la boîte à outils du studio, par étape de production.
Deux interpréteurs Python coexistent, et ce n’est pas un choix de confort. Le Code Interpreter fournit un Python avec des centaines de bibliothèques préinstallées, dont OpenCV, compilé contre numpy 1.26. La pile audio a besoin de librosa 1.0, qui exige numpy 2.1 ou plus. Les deux ne cohabitent pas dans un même interpréteur : nous avons mesuré qu’OpenCV refuse de se charger à côté de numpy 2. La boîte à outils apporte donc son propre Python pour l’audio, garde celui du Code Interpreter pour l’image, et l’agent passe des fichiers de l’un à l’autre, jamais des objets.
Résultats
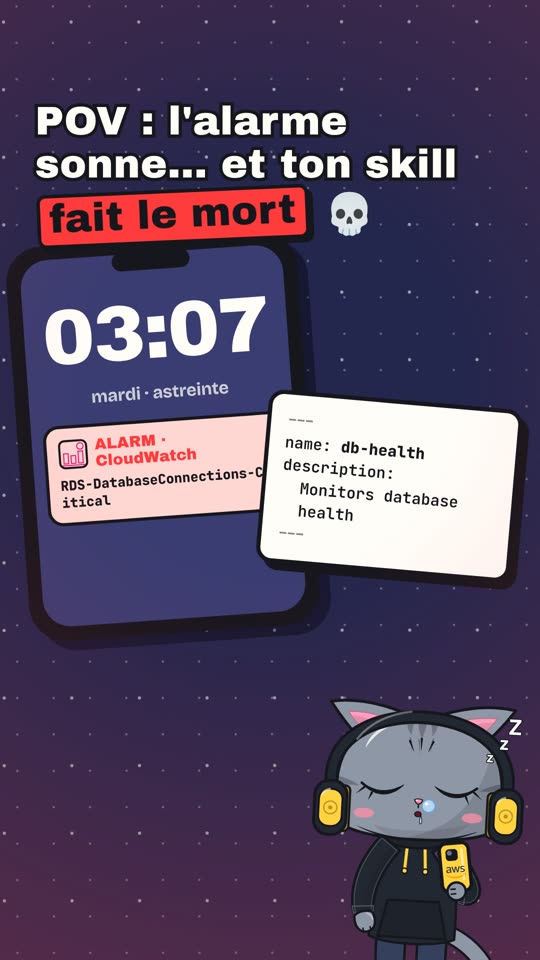
Nous avons envoyé une seule consigne à l’agent déployé : une vidéo TikTok pour chacun de trois articles AWS, sur un ton humoristique, avec l’avatar chat en première scène et les bonnes pratiques de la plateforme. L’agent a livré une série de trois épisodes qu’il a lui-même nommée Le Chat Ops : les expressions dans les modèles de jobs d’AWS Deadline Cloud, l’écriture de skills pour AWS DevOps Agent, et les exercices d’évacuation de zone de disponibilité avec le zonal shift d’Amazon Application Recovery Controller (ARC).
 |
 |
 |
Figure 4 : les affiches des trois épisodes. Chaque affiche est l’image 0 de la vidéo, choisie par l’agent comme l’image la plus forte.
Chaque fichier livré fait 1080×1920 à -14 LUFS, avec une piste audio composée en code. Chaque nom, commande et chiffre affiché vient de l’article, avec sa source dans le plan.md de l’épisode.
Ce résultat ne retire pas l’humain de la boucle. L’agent termine en listant ce qui demande encore un œil et une oreille humains, et les notes du client existent pour cela.
Cas d’utilisation
Le même principe, un modèle qui écrit le code et un moteur qui le rend à l’identique, s’applique au delà des vidéos d’articles. Les cas qui suivent sont des pistes : ils ne sont pas implémentés dans l’agent présenté ici.
Découpe et montage à l’image près à partir de Media2Cloud
La Guidance for Media2Cloud on AWS ingère et analyse des vidéos et des images : détection de plans avec l’API Segment d’Amazon Rekognition, transcription avec Amazon Transcribe, et détection de scènes et de points de coupure publicitaire avec des modèles Claude sur Amazon Bedrock. Elle produit des métadonnées JSON horodatées par scène, des sous-titres WebVTT, et un paquet de listes de décisions de montage (EDL) à importer dans un logiciel de montage. La détection de segments d’Amazon Rekognition Video renvoie pour chaque plan et chaque repère technique (barres de couleur, images noires, génériques) un code temporel SMPTE et un numéro d’image, à l’image près.
Un agent d’analyse peut s’appuyer sur ces métadonnées pour choisir les moments forts d’un programme ou les meilleures images d’une banque. Le directeur reçoit alors les codes temporels, découpe les plans avec FFmpeg à l’image près, recadre ou détoure les images, monte le tout sur une timeline HyperFrames, et ajoute des graphismes par-dessus : titres animés, bandeaux, infographies et sous-titres. La figure 5 montre cette chaîne.
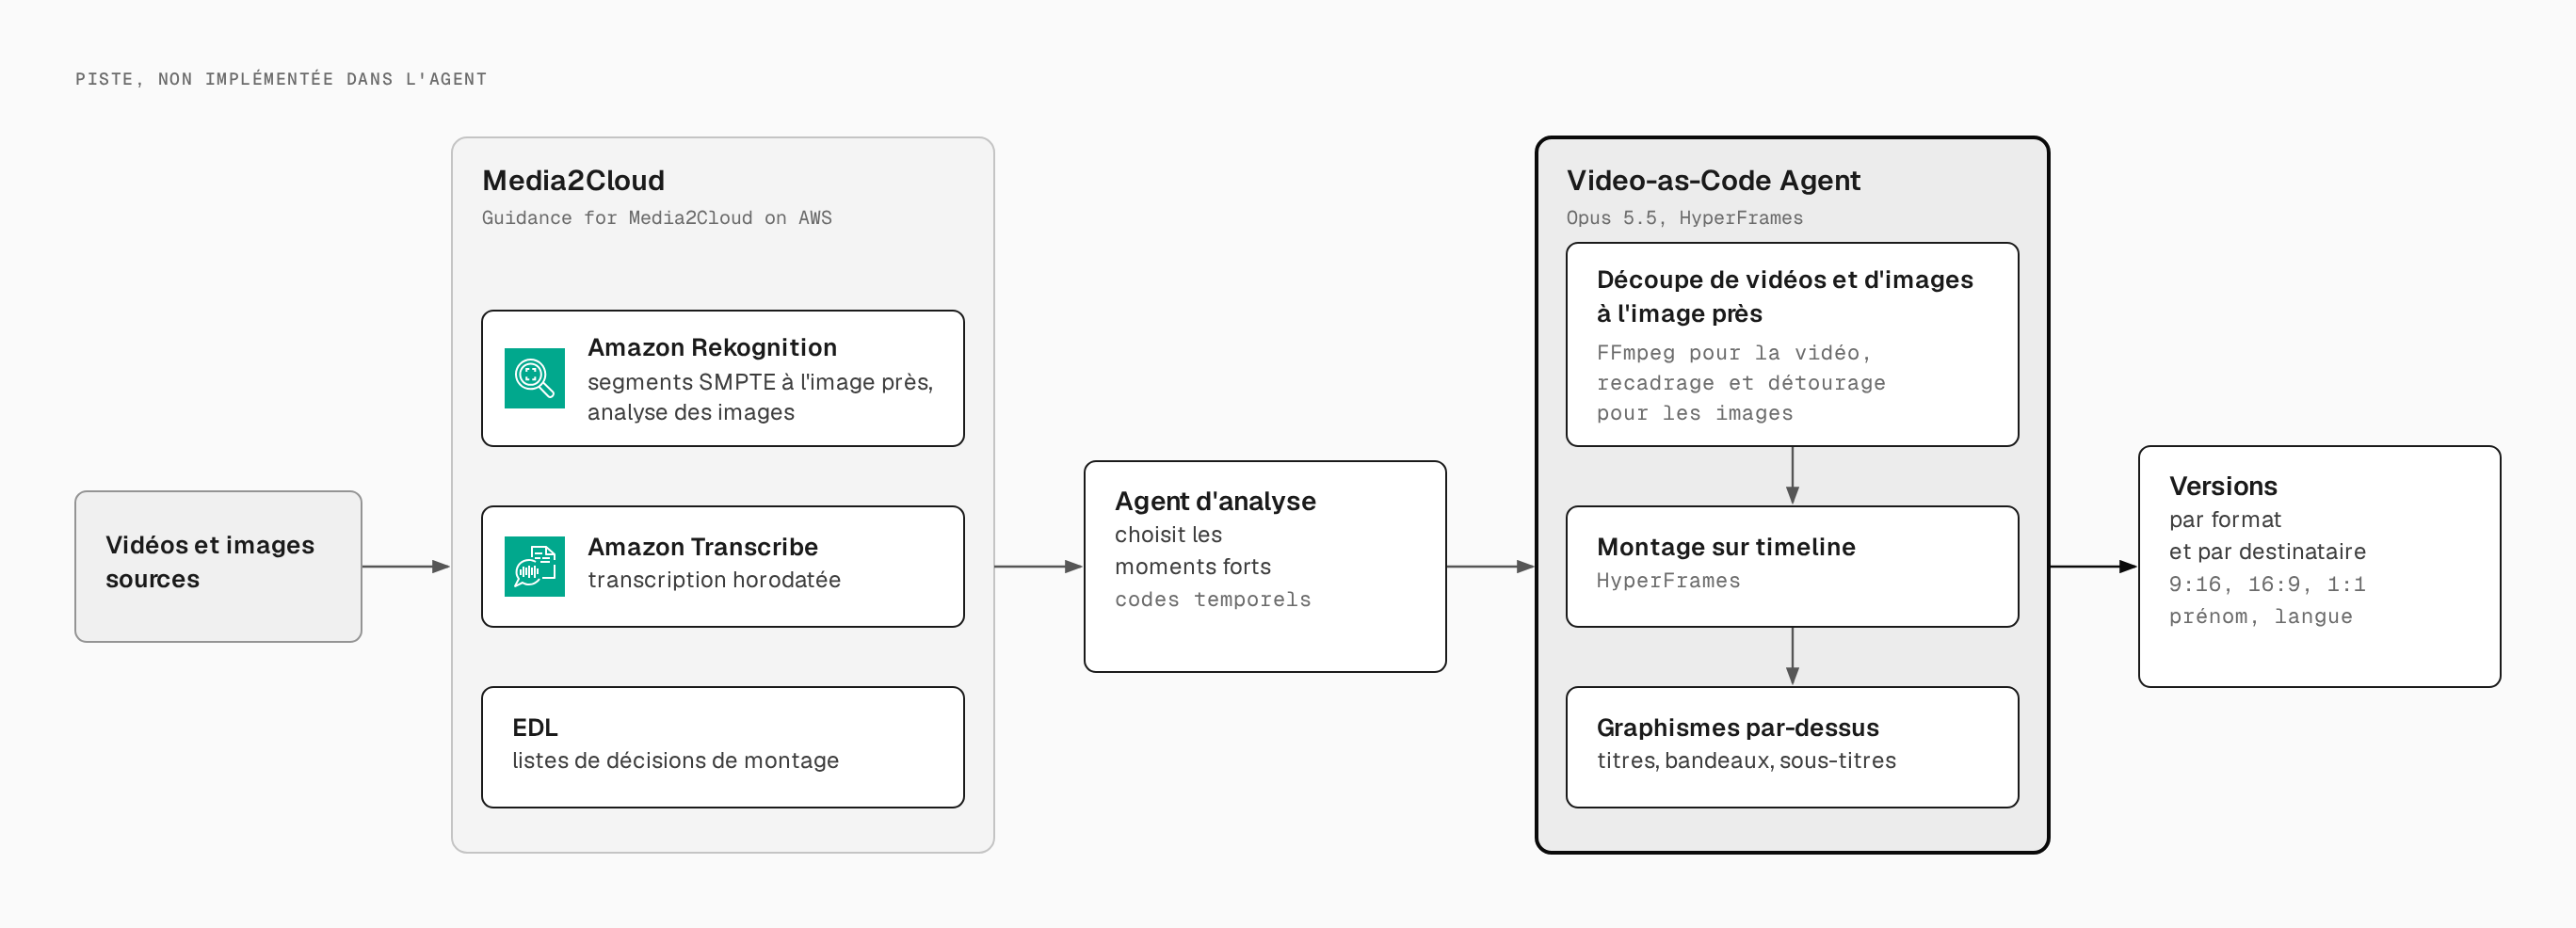
Figure 5 : découpe et montage à l’image près à partir de Media2Cloud. Cette chaîne est une piste : elle n’est pas implémentée dans l’agent présenté ici.
Bandes-annonces TV
Une bande-annonce combine une sélection de plans, un habillage graphique, une musique calée sur le montage et une mention de diffusion. Le directeur sait déjà caler un montage sur une grille de battue (librosa pour une piste fournie, music21 quand il compose), et produire plusieurs formats depuis une seule timeline en recomposant la typographie et la mise en page pour chaque format plutôt qu’en recadrant. Associé aux segments de Media2Cloud, il peut proposer une bande-annonce par programme et par format de diffusion.
Hyper-personnalisation de vidéos marketing
Une composition HyperFrames accepte des variables. Une même vidéo peut donc être rendue autant de fois qu’il y a de destinataires : prénom, ville, produit recommandé, langue de la voix off. Comme le rendu est déterministe, la version d’un destinataire est reproductible, ce qui simplifie la validation et la conformité. L’agent intervient sur le modèle et sur ses variantes créatives, et le rendu en volume peut s’exécuter sans modèle de langage, avec le rendu distribué sur AWS Lambda que propose HyperFrames.
Automatiser le versioning de promos
Les chaînes de télévision produisent chaque jour des milliers de versions de promos : une par programme, par horaire, par territoire et par plateforme. Ce travail repose aujourd’hui sur des orchestrateurs pilotant des fermes de logiciels de motion design. Ils connectent les systèmes de programmation et de traffic, les plateformes de gestion d’actifs médias ou de simples tableurs à une bibliothèque de modèles graphiques. Le contenu est collecté, le modèle choisi, les variables appliquées et les versions générées, par des workflows déclenchés par un planning, des métadonnées ou un événement externe.
Cette chaîne a deux contraintes. Chaque modèle est conçu à la main dans l’application de motion design, et une nouvelle déclinaison créative (un habillage par saison, par événement, par marque) demande un nouveau modèle. Et le rendu dépend d’une application bureautique, avec ses plug-ins, sur chaque machine de rendu. Sur AWS, AWS Deadline Cloud gère des fermes de rendu pour ce type d’applications de création numérique.
Le directeur ne remplace pas cette chaîne : il s’y insère à deux endroits. En amont, il conçoit un nouveau modèle de promo en code, le teste en le rendant et en le regardant, puis le livre comme composition HyperFrames à variables, rendue sous Linux sans application de bureau. En parallèle, il écrit les variantes créatives d’une campagne, que l’orchestrateur décline ensuite en volume avec les données de programmation.
Conclusion
Dans cet article, vous avez vu comment Video-as-Code Agent, un directeur créatif IA, produit des vidéos marketing en écrivant le code qui dessine chaque image et chaque son, plutôt qu’en générant des pixels. Claude Opus 5.5 apporte l’idée, le style, le mouvement et la musique ; HyperFrames et la boîte à outils rendent ce code à l’identique ; une boucle de revue permet au modèle de regarder ses propres images et de corriger ses défauts avant de livrer. Le résultat répond aux quatre exigences du besoin : des versions variées en volume, des chiffres qui viennent de la source, des notes de réalisateur qui coûtent une modification ciblée, et un son calé à l’image près.