Amazon Web Services ブログ
Amazon Timestream for InfluxDB 3 の機能とワークフロー
本記事は 2026 年 4 月 29 日に公開された、Features and workflows with Amazon Timestream for InfluxDB 3 を翻訳したものです。
本記事では、時系列データベースの技術を大きく進化させた Amazon Timestream for InfluxDB 3 のアーキテクチャ設計、機能、ケイパビリティについて、技術的な観点で解説します。この次世代時系列データベースは、従来のエンジンバージョンからアーキテクチャが再設計されています。コア性能を支える Rust、列指向データ処理を実現する Apache Arrow、効率的なストレージを提供する Apache Parquet、高性能クエリを可能にする Apache Arrow Flight SQL といったモダンなテクノロジーでゼロから構築されています。
このマネージドサービスは、InfluxData の最新データベースと AWS のインフラストラクチャおよびツールを組み合わせ、お客様の時系列データワークフローをサポートします。Amazon Timestream for InfluxDB 3 を今すぐ使い始めるには、ドキュメントをご覧ください。
新しいエンジンの機能
InfluxDB 3 のコアエンジンは、ストレージフォーマット、クエリエンジン、ネットワークプロトコルにオープンソースのテクノロジーを使用してゼロから設計された、オープンソースソリューションです。Apache Arrow Flight SQL が InfluxDB 3 の新しい高性能 SQL インターフェイスとして導入されたことで、バージョン 2 で使われていた Flux のような独自言語を使用してクエリする必要がなくなりました。ネイティブ SQL のサポートにより、データベースとのやり取りの障壁が下がり導入が容易になるだけでなく、Amazon S3 などのオブジェクトストレージに大量のデータを保存できるエンジンの特性を活かし、分析指向のユースケースにも対応しやすくなります。オブジェクトストレージを活用することで、大規模なデータセットを手頃なコストで保持しつつ、Parquet の効率的な列指向フォーマットと Apache Arrow のインメモリ機能により優れたパフォーマンスを実現します。
InfluxDB 2 から得た知見を基に、InfluxDB 3 は InfluxDB 2 では対応できなかったユースケースに対応しています。InfluxDB 3 では、アーキテクチャの変更により、事実上無制限のカーディナリティをサポートしています。変動の大きいデータセットでも、インデックス付きタグとデータベースパフォーマンス低下のトレードオフを気にする必要がなくなりました。InfluxDB 3 はコアなストレージレイヤーとして Amazon S3 を使用しており、Amazon S3 のマルチ AZ アーキテクチャと 99.999999999% のデータ耐久性の恩恵を受けながら、永続ストレージのコスト削減も実現します。
InfluxDB 3 には、時系列データの収集、整理、変換のための新しくて強力な処理エンジンが統合されています。処理エンジンは InfluxDB 3 に組み込まれた Python 仮想マシンであり、時系列データに対してゼロコピー操作を実行できます。例えば、ストレージコストとデータ量を削減するためのダウンサンプリングや、閾値条件や異常検知に基づいて通知をトリガーするためのアラームといった、リアルタイムでのデータ処理機能が利用できます。Python で記述されたプラグインで、トリガーイベントを契機として処理エンジンがデータに対して何をどのように実行するかを定義します。トリガーイベントの種類には、スケジュールされたイベントと WAL フラッシュイベントがあります。Amazon Timestream for InfluxDB 3 には、セキュリティ強化が施された処理エンジンプラグインが用意されています。Timestream for InfluxDB 3 で利用可能なプラグインの一覧は、処理エンジンのドキュメントで確認できます。
豊富な新機能により、InfluxDB 3 は変動の大きいデータを扱うシステム、直近のデータに対する最適化されたクエリを必要とするワークフロー、マルチノードソリューションを必要とする大量のデータ取り込みに最適です。ユースケースとしては、システムモニタリング、アプリケーションモニタリング、IoT センサーデータなどがあります。また、InfluxDB 3 は、現在メンテナンスモードにある Amazon Timestream for LiveAnalytics の後継として、拡張された機能、優れた柔軟性、そして AWS における時系列ワークロードの今後の道筋を提供します。
Core エディションと Enterprise エディション
AWS では、InfluxDB 3 を Core エディションと Enterprise エディションの 2 つで提供しており、それぞれ特定のユースケースに最適化された異なる機能を備えています。両エディションともストレージレイヤーに S3 を使用していますが、アーキテクチャ、想定されるワークロード、料金モデルは大きく異なります。
Amazon Timestream for InfluxDB Core は、直近のデータ(集計要件やタイムスタンプの粒度に応じて通常は過去 3〜5 日間)を常時効率的にクエリする必要があるリアルタイムモニタリングシナリオ向けに設計されています。Core は、高速なクエリレスポンスタイム、ディスクレスアーキテクチャ、Parquet ファイルの永続化、処理エンジンなど、時系列ワークロードに不可欠な機能を提供します。ただし、Core クラスターは単一ノードデプロイに制限されており、データの取り込み、クエリ、圧縮、プロセッシングの 4 つの主要機能が同一インスタンス上で実行され、これらの機能が限られたコンピューティングリソースを共有して使用します。特に、Core にはコンパクター(圧縮を行うコンポーネント)が含まれていないため、大量の時系列履歴データを効率的に保存およびクエリする機能が制限されます。そのため、直近のデータに焦点を当てたユースケースに最適です。
Core クラスターの場合、コストは主にコンピューティングとストレージの料金で構成されます。例えば、バージニア北部リージョン (us-east-1) で db.influx.large インスタンス (2 vCPU) を 1 台使用する場合、コンピューティング料金は 1 時間あたり約 $0.264 × 月 730 時間 = 月額 $192.72 に加え、ストレージ料金が 1 GB あたり $0.023 となります。Core の料金の詳細については、料金ページ をご覧ください。
Amazon Timestream for InfluxDB Enterprise は、履歴データの保持と分析を必要とする本番ワークロード向けに設計されており、Core の機能を拡張します。Enterprise クラスターにはコンパクター(圧縮を行うコンポーネント)が含まれており、大量の履歴データを保存しつつ、パフォーマンスへの影響を最小限に抑えて効率的にクエリできます。また、Enterprise はマルチノードクラスターデプロイをサポートしており、異なるノードに個別の役割を割り当てることで、データの取り込み、クエリ、圧縮、プロセッシングの各機能を分離し、リソース使用率を最適化できます。Enterprise のその他の機能には、細かいアクセス制御、より柔軟に設定可能なデータ保持ポリシー、高負荷な本番環境向けに強化されたスケーラビリティが含まれます。
InfluxDB 3 Enterprise は、データの取り込みとクエリ負荷の要件に合わせて最大 15 ノードのクラスター構成で利用できます。1〜4 のライターノード、0〜13 の読み取り専用ノード、1 つのコンパクターノードから選択できます。すべてのマルチノードデプロイメントでは、クラスターの可用性を最大化するために異なるアベイラビリティゾーンにインスタンスを分散させます。
Enterprise の料金には、コンピューティングとストレージのコストに加えて、AWS Marketplace を通じて自動的に有効化される InfluxDB 3 Enterprise ライセンスが含まれます。Enterprise ライセンスは従量課金制で、ノードあたりの時間単位で課金されます。例えば、バージニア北部リージョン (us-east-1) で db.influx.large インスタンス 3 台のクラスターを使用する場合、おおよそのコストは以下のとおりです。
- コンピューティング: $0.264/時間 × 3 ノード × 730 時間 = $578.16/月
- ライセンス: $0.264/時間 × 1.5 × 3 ノード × 730 時間 = $867.24/月
- コンピューティング + ライセンスの合計: $1,445.4/月、これにストレージ料金 1 GB あたり $0.023 が加算
Enterprise の料金の詳細については、AWS Marketplace listing をご覧ください。
InfluxDB 3 への時系列データの書き込み
時系列データに InfluxDB を使用するメリットの 1 つは、データ取り込みに使用される人間が読みやすいラインプロトコルテキスト形式です。ラインプロトコルはシンプルで可読性が高いため、InfluxDB が初めてでも始めやすく、複雑なフォーマット要件なしにデータ取り込みのテスト、データモデルの微調整、取り込みパスのデバッグを迅速に行えます。ラインプロトコルは InfluxDB 1 から使用されており、InfluxDB 3 でも引き続き標準として採用されているため、既存ユーザーは継続して使用できます。InfluxDB 1 または 2 からワークフローを移行する際、ラインプロトコルをそのまま使い続けられるだけでなく、InfluxDB 3 では v1・v2 との下位互換性がある書き込みエンドポイントも利用できます。この互換性により、既存のアプリケーション、スクリプト、ツールは変更なしにデータの書き込みを行うことができ、InfluxDB 3 へのアップグレード時に既存の時系列ワークフローの移行をスムーズに行えます。
InfluxData は、InfluxDB 3 へのデータ取り込み用のクライアントライブラリセットを提供しています。これらのライブラリはアプリケーションと統合することで、バッチ処理、ラインプロトコルの構築、gRPC を使用した Arrow Flight プロトコルによるクエリのためのボイラープレートコードを別途記述することなく、データの書き込みとクエリを実行できます。クライアントライブラリは C# .NET、Go、Java、JavaScript、Python で利用可能です。クライアントライブラリの詳細については、「Client libraries for InfluxDB 3」を参照してください。
クエリと DSL
InfluxDB 3 は、Apache DataFusion をクエリエンジンとして、Apache Arrow Flight SQL をネットワークプロトコルとして使用することで、標準 SQL を主要なクエリ言語として採用しました。このアーキテクチャの転換により、InfluxDB 2 の Flux スクリプト言語が、馴染みのある SQL 構文に置き換わり、学習コストが大幅に低下するとともに、既存の SQL ツールやビジネスインテリジェンスアプリケーションとのシームレスな統合が可能になります。
Apache Arrow Flight SQL は、効率的な列指向データ転送と gRPC ベースの通信を使用して、従来の HTTP ベースのインターフェイスと比較して優れたパフォーマンスの向上を実現します。基盤となる Apache Arrow の列指向フォーマットにより、ベクトル化実行や述語プッシュダウンが可能になり、大規模なデータセットに対する生データクエリと集計クエリの両方でパフォーマンスが向上します。Apache DataFusion のクエリオプティマイザは、フィルターやプロジェクションのプッシュダウンによりデータ処理を最小化し、パフォーマンスをさらに向上させます。
InfluxDB 3 は、リアルタイム分析向けに設計された専用キャッシュ戦略により、時系列ワークロードのクエリパフォーマンスを最適化します。2 つのインメモリキャッシュが最も一般的なクエリパターンを高速化します。Last Value Cache (LVC) は各フィールドの最新値を保存し、リアルタイムダッシュボードで使用される「最終ポイント」を取得するクエリをミリ秒のレスポンスタイムで返します。Distinct Value Cache (DVC) はテーブル内の一意なタグ値とフィールド値を保持し、ホスト名やセンサー ID の一覧表示などのメタデータクエリを高速化します。これらのキャッシュにより、一般的なクエリパターンがほぼ瞬時に実行され、大量のデータ取り込みが行われている最中でもダッシュボードの応答性が維持されます。これらの最適化により、InfluxDB 3 は直近のデータ(通常は過去 3〜5 日間)に焦点を当てたモニタリングユースケースに特に効果的であり、これはリアルタイム分析向けの Core エディションの設計と合致しています。
移行の互換性と幅広いデプロイシナリオに対応するため、InfluxDB 3 はモダンな SQL インターフェイスに加えて v1 互換の InfluxQL エンドポイントを提供しており、レガシーアプリケーションを変更なしに引き続き運用できます。InfluxDB 3 Explorer と Timestream for InfluxDB の利用を開始するには、InfluxData のドキュメントを参照してください。
Explorer ユーザーインターフェイス
InfluxDB 3 は、InfluxDB 3 Explorer のグラフィカルインターフェイスを通じて管理できます。InfluxDB 3 Explorer を使用すると、データベースの管理、データの取り込みやクエリ、可視化など、さまざまな操作を実行できます。Timestream for InfluxDB 3 で InfluxDB 3 Explorer を使用するには、InfluxData のクイックスタートガイドに従って Docker で Explorer を実行してください。
データベースの管理
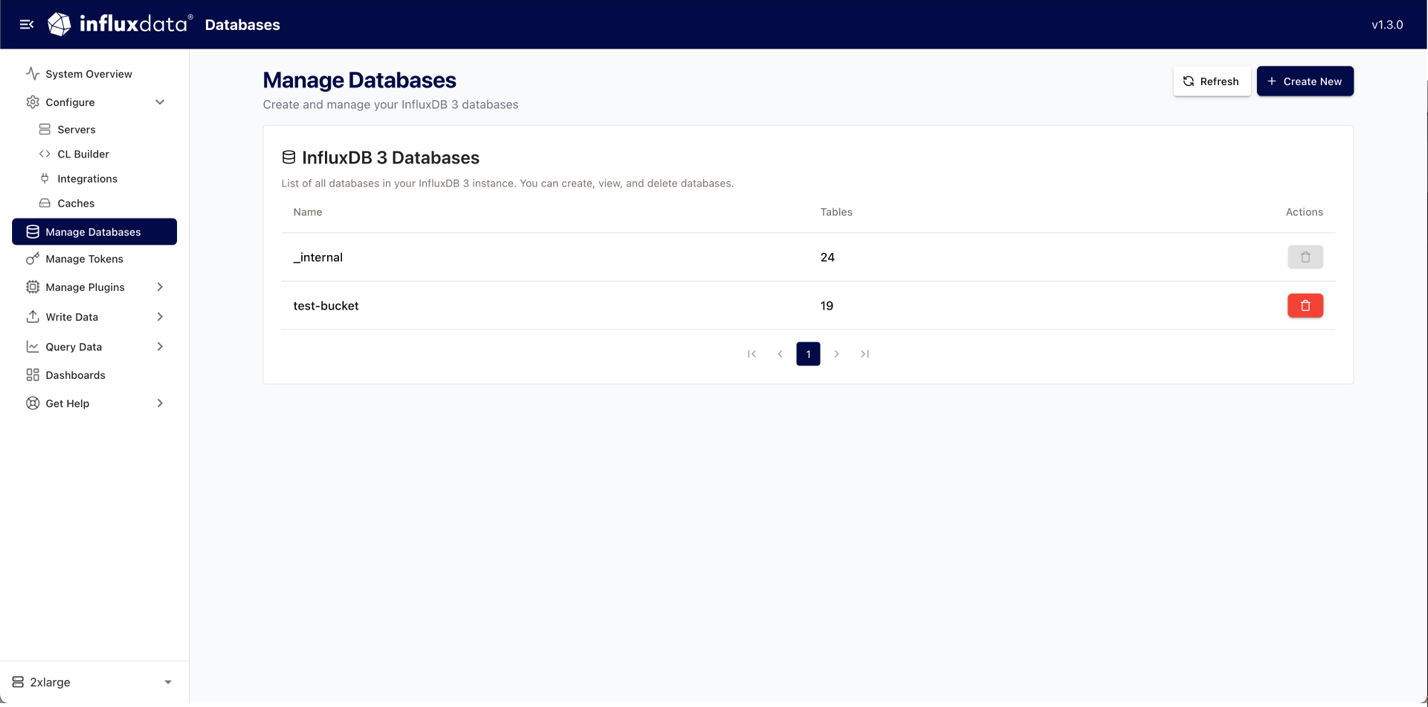
Explorer では、InfluxDB 3 インスタンスのホストアドレスと、関連付けられたトークンを指定して新しい接続を作成できます。インスタンスが追加され検証されると、Explorer を使用してデータベースを管理できます。Explorer では、新しいデータベースの作成や既存のデータベースの削除が可能です。
データのクエリと可視化
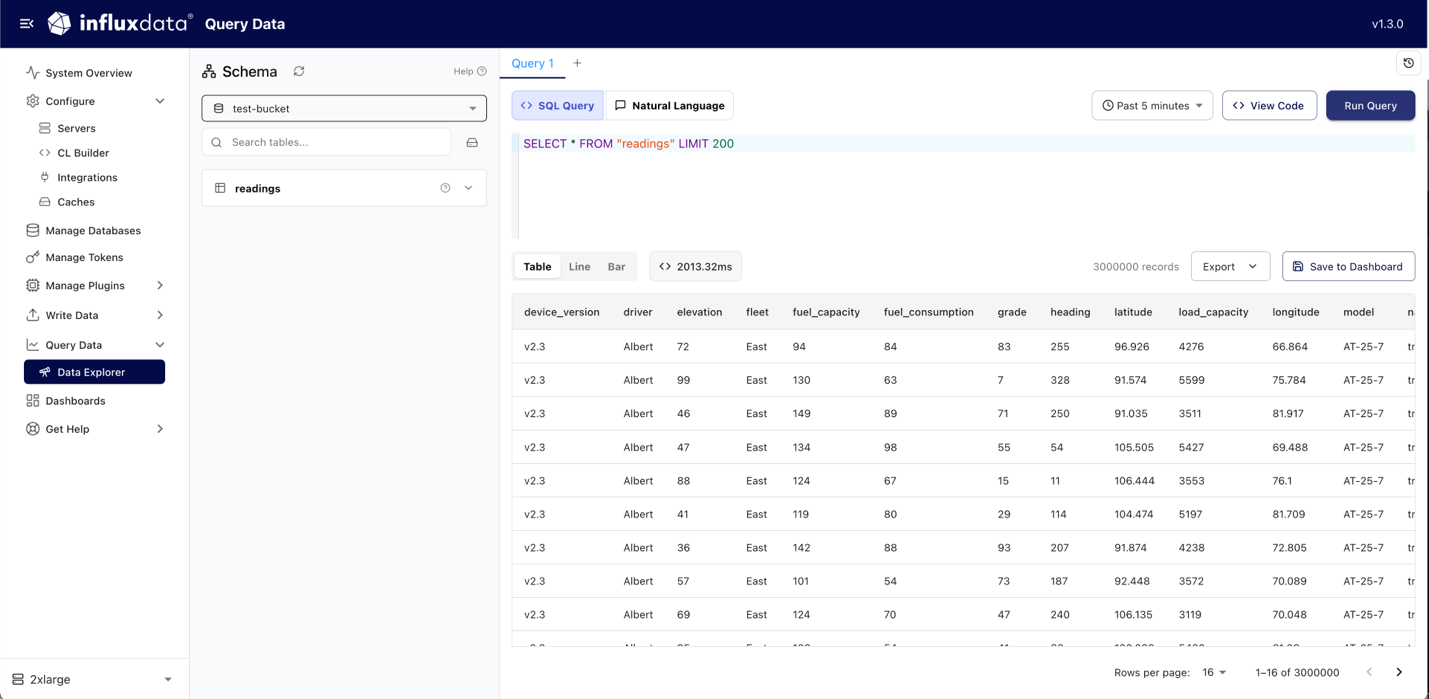
InfluxDB 3 Explorer 内の Data Explorer を使用すると、SQL クエリを実行したり、自然言語を使用してデータを確認できます。InfluxDB 3 の SQL 実装の詳細については、InfluxData の SQL reference documentation を参照してください。
結果は Explorer 内で折れ線グラフや棒グラフとして表示でき、CSV、JSON、Parquet にエクスポートすることもできます。さらに、結果をダッシュボードに追加して、データのインサイトを整理することもできます。
現行バージョンの Explorer は、Timestream for InfluxDB 3 エンジンの基本を理解し、クエリ構文を試し、管理オプションに慣れることを目的として設計されている点に留意してください。パフォーマンステスト、複雑なクエリパターン、本番ワークロードに必要な機能は、InfluxDB CLI または API ですべて利用できます。Explorer は、より高度なツールに移行する前にシステムの基本を安全に学べる学習環境として活用してください。
データの取り込み
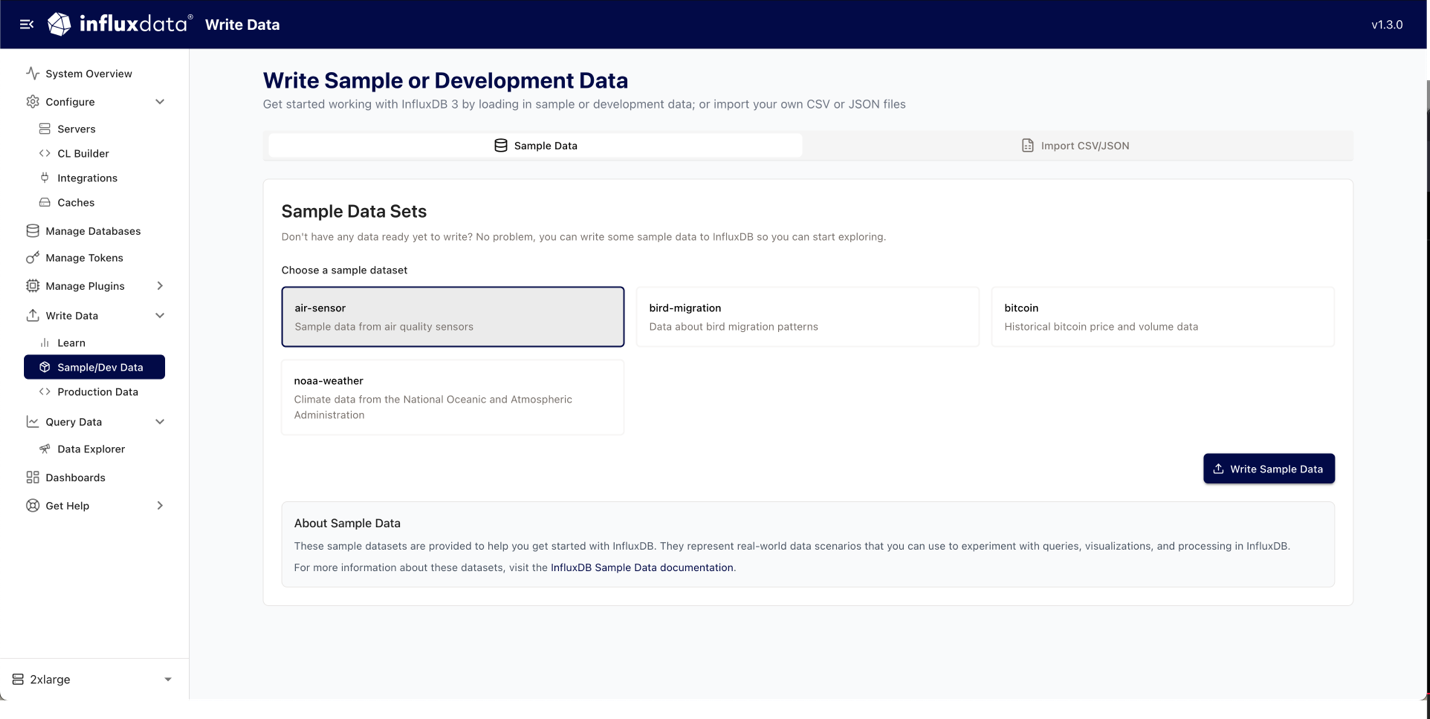
Explorer から直接データを取り込むことができます。Explorer には、ラインプロトコル、InfluxDB 3 のクライアントライブラリ、InfluxDB 3 の REST API、Telegraf の使用方法、CSV や JSON データのインポート方法、サンプルデータの取り込み方法など、InfluxDB へのデータ書き込みを支援するガイドが用意されています。
すぐに使い始められるよう、Explorer 内からサンプルデータを取り込むことができます。サンプルデータセットには、大気質センサーデータ、鳥の渡りデータ、ビットコインの過去の価格と取引量データ、気候データが含まれます。
デプロイメントの監視
インスタンスのデプロイ後、サイジングの妥当性を検証し、最適化の余地がないかを確認するため、パフォーマンスをモニタリングすることが重要です。Amazon CloudWatch は、CPU 使用率やメモリ使用量など、Timestream for InfluxDB 3 の重要なメトリクスを提供します。InfluxDB 3 の処理エンジンに含まれる System Metrics Plugin は、CloudWatch と同様のサーバーレベルのパフォーマンスデータを収集します。これには、詳細な CPU 統計(全体およびコアごと)、メモリ使用量の内訳、ディスク I/O パフォーマンス、ネットワークインターフェイス統計が含まれます。
データベース固有のパフォーマンスメトリクスについてより深い洞察を得るには、メトリクスエンドポイントをスクレイピングすることで、クエリパフォーマンス、書き込みスループット、その他のサービスレベル指標を詳細にモニタリングするための包括的な内部メトリクスを収集できます。Timestream for InfluxDB インスタンスの /metrics エンドポイントをスクレイピングする包括的なメトリクス収集ソリューションを提供しています。このソリューションは、Telegraf を実行する EC2 インスタンスをデプロイし、クエリパフォーマンス、書き込みスループット、メモリ使用パターンなどの内部エンジンメトリクスを継続的に収集した後、CloudWatch に取り込み、事前設定された Grafana ダッシュボードで可視化します。ダッシュボードには、インスタンスのサイジング仕様に基づく主要パフォーマンス指標をモニタリングするパネルが含まれており、サイジングの判断の検証と最適化の機会の特定に役立ちます。
デプロイ手順、設定オプション、サンプルスクリプトについては、GitHub リポジトリをご覧ください。リポジトリには、Telegraf の設定から Grafana ダッシュボードの作成まで、セットアッププロセスを自動化する完全な CDK アプリケーションが含まれています。
まとめ
Apache Arrow、Parquet、Flight SQL を採用した InfluxDB 3 の再設計により、ビジネスニーズに対してパフォーマンス上のメリットと長期的な相互運用性を提供するオープンソースフレームワークが構築されました。ネイティブ SQL サポートにより独自のクエリ言語を学ぶ負担が軽減され、処理エンジンの組み込み Python ランタイムによりゼロコピーのデータ変換が可能になります。
InfluxDB 3 Explorer は、データベース管理、クエリの実験、データの可視化に使用できます。本番環境への移行に際しては、CloudWatch 統合やメトリクス収集によるモニタリングソリューションがパフォーマンス特性の可視性を確保します。
InfluxDB 3 は、統合された処理エンジン、無制限のカーディナリティサポート、コスト効率の高い S3 データストレージにより、強力な新機能を提供します。Amazon Timestream for InfluxDB 3 にアクセスしてクラスターをデプロイし、この新しい時系列データベースで利用可能なすべての機能を実際にお試しください。
著者について
Victor Servin
Victor は AWS の Amazon Timestream チームのシニアプロダクトマネージャーです。プロダクトレッドグロース戦略やスケーラブルなアーキテクチャでスタートアップを支援してきた長年の専門知識を持ち、データドリブンなアプローチで Timestream のような分析プロダクトの普及を推進しています。豊富な経験とカスタマーサクセスへの取り組みにより、お客様が効率的に目標を達成できるようサポートしています。
Forest Vey
Forest は Improving 社のチームリードです。時系列およびサーバーレステクノロジーの経験を持ち、クラウド開発と組み込みシステムへの情熱が高まっています。ソフトウェア開発の学習以外の時間では、友人とのロッククライミングやハイキングを楽しんでいます。
Trevor Bonas
Trevor は Improving 社のシニアソフトウェア開発者です。時系列データベースと ODBC ドライバーの開発経験があります。プライベートでは小説の執筆や、ゲーム開発にも取り組んでいます。
Fred Park
Fred は Improving 社のシニアソフトウェア開発者で、時系列データベースと AI エージェントのオブザーバビリティを専門としています。VR やクラウドサービスから量子コンピューティングまで幅広いバックグラウンドを持ち、新しいテクノロジーに惹かれています。コーディング以外の時間は、ハイキングに出かけたり友人と音楽を作ったりしています。
本記事の翻訳はクラウドサポートエンジニアの平出が担当しました。