Amazon Web Services ブログ
Kiro が自身のハーネスの性質を Lean で証明する
本記事は 2026 年 11 月 2 日に Kiro ブログで公開された「Kiro proves properties of its own harness in Lean」を翻訳したものです。
私たちは、Kiro が自身のコードの一部を Lean でモデル化し、そのモデルについての定理を証明し、各モデルを TypeScript、Rust、Python のコードと照らし合わせる作業を、自動で進める仕組みを作りました。最初に適用した対象は Kiro 自身です。26 個の関数のモデルについて、性質の候補と観察を合わせて 96 件を分析しました。そのうち 70 件は Lean で証明でき、2 件は有界検査(上限までの有限の入力を調べる検査)を行いました。18 件はモデルの上で反証され、分析対象のコードでも再現できました。残りの 6 件は部分的な結果か観察です。本記事では、Lean を使った検証のワークフローが、実際に本番で使われているエージェントのハーネスについて、その性質を検証し、隠れたバグを見つけるのに使えることを示します。
私たちのチームは Kiro のコンテキスト管理を担当しています。LLM を取り巻くハーネスは、何をどれだけコンテキストウィンドウに入れるかを決め、長い会話を圧縮し、プロンプトキャッシュが効くように各リクエストのプレフィックス(先頭部分)を安定させ、セッションを復元できるように保存します。その周りには、ツール呼び出しとその承認、ストリーミングの応答、サブエージェント、バックグラウンドタスクといった、ハーネスのほかの基本機能があります。このコードのバグはテストで見つけにくいものです。バグが出るかどうかは、LLM が選ぶ入力、並行するイベントの順序、多くのターンや再起動を経て積み上がった状態に左右されます。しかも、こうしたバグはエラーを出さずに起きることが多く、LLM は少しだけ誤ったコンテキストのまま作業を続けます。そこで私たちは、この基盤を深く調べてバグを見つけ、改善につなげる自動化の方法を探しています。
Kiro が自身のハーネスを確かめる方法。私たちは Kiro に、自身のハーネスにある 26 個の関数の性質を証明するよう頼みました。エージェントは各関数を、プログラミング言語であり証明支援系でもある Lean 4 でモデル化し、各モデルを実際のコードと照らし合わせたうえで、期待される振る舞いが成り立つことを証明するか、それを破る入力を(Lean の反例として)見つけました。対象は Kiro の 3 つのコードベース(Kiro エージェントハーネス、CLI クライアント、Kiro Crew)です。Kiro CLI にコードベースを走査させ、Lean のモデルを作れる程度に小さく、かつテストするのが簡単ではない関数を対象として選ばせたので、どれも調べる価値のある対象です。これは、自分が動いているシステムを改善するエージェントに向けて、まだ始まったばかりの取り組みです。すべての証明は Lean のカーネル(証明が正しいかを最終的に検査する、Lean の小さな中核部分)が検査し、すべての発見は実際のコードで確かめ、すべての定理の記述は私たちがレビューしました。ソースコードとずれた証明でも、カーネルの検査は通ってしまうからです。こうしてできたのは、プロンプトキャッシュの保証や並行処理のように、テストでは検証が届きにくい部分を補う、繰り返し使える手順です。Lean のカーネルを通った証明は、単体テストにある有限個の入力だけでなく、モデル化したすべての入力について保証を与えます。証明に失敗した場合は、実際のコードで試せる具体的な反例が見つかることがあります。
証明したこと。Kiro エージェントサーバー(Kiro ハーネスとも呼びます)、Kiro CLI v3、Kiro Crew の中核にある 26 個の関数について、Lean はそれらのモデルに関する 70 個の性質を証明しました。どの性質も、定理に書いた仮定を満たす、モデル化したすべての入力について成り立ちます。各モデルは、ランダムに生成した入力で実際のコードと照らし合わせています(「手法」と「制約」の節を参照)。たとえば次のことを証明しました。
- 重複したファイル添付を取り除いても、前のターンで LLM が見た内容は変わりません。そのため、会話が長くなっても、この処理がプロンプトキャッシュのプレフィックスを壊すことはありません。
- サブエージェントの権限の判定を親の判定と組み合わせても、親より大きな権限にはなりません。また、ポリシーを厳しくしても、拒否が承認に変わることはありません。
- Kiro Crew のキューにあるタスクが新しいワーカーに渡ったあとは、古いワーカーのフェンス付きの書き込み(取得したときの世代番号を添えた書き込み)でそのタスクが変わることはありません。ただし、ストアの各呼び出しが不可分な(アトミックな)1 ステップとして実行されることを前提とします。
見つかったこと。証明が失敗した箇所からは、テストが届いていなかったエッジケースが見つかることがよくありました。多くは 2 つの表現の境目や 2 つのプログラムの境目、あるいは並行するイベントのまれな順序にありました。失敗した証明を発見として数えたのは、手を加えていない実際のコードで再現できたものだけです。
エージェントにテストだけでは足りない理由
通常のテストスイートは、人が書いたものでも LLM が生成したものでも、誰かが思いついた入力や生成器が作った入力を確かめるだけで、すべてのコーナーケースは捉えられません。エージェントでは、入力の大半は LLM と LLM が読むファイルから来るため、入力がとりうるケースは、誰かがテストに書く数よりはるかに多くなります。それを扱うコードは小さく、見るからに正しそうなことがよくあります。切り詰め、読み取り専用かどうかの判定、許可リストとの照合などです。証明がもっとも役に立つのはこうした箇所です。こうした関数は正確にモデル化できるほど短く、コードの意図は定理として書けるほど明確で、しかもすべてのセッションで実行されます。網羅的でない通常のテストスイートは振る舞いを標本として確かめるだけですが、証明は形式モデルについて、すべての場合に成り立つ結果を示します。ただし、証明が対象とするのはあくまでモデルなので、後で説明するように、モデルとコードを結び付けるテストは引き続き必要です。
エージェントサーバー、CLI、Kiro Crew のどれでも、ハーネスは次のような種類の性質の上に成り立っています。網羅的でないテストでは、どれも標本として確かめることしかできません。
- 内容の上限。LLM のコンテキストウィンドウに入る内容には、どれもサイズの上限があります。内容が切り詰められた場合、エージェントは残りを取得できます。
- 永続化。再起動したあとでも、セッションを読み込み直すと、LLM には、セッションが続いていたときに見ていたのとまったく同じメッセージが渡ります。
- プロンプトキャッシュ。各リクエストのプレフィックス(ツールの一覧、最初のメッセージ、履歴)がターンをまたいで変わらないので、LLM のプロバイダーはキャッシュした処理を再利用できます。
- 権限。承認は、承認した範囲だけにきっちり効きます。また、サブエージェントが親より大きな権限を持つことはありません。
- 順序。セッション、ストリーミングの応答、バックグラウンドタスクは、イベントがどの順序で届いても正しい状態で終わります。
- リポジトリをまたぐ契約。2 つのコードベースが互いに依存している箇所では、両者のあいだの約束事(契約)が守られている必要があります。たとえば Crew は、ツールの許可リスト 1 つを、エージェントサーバー向けと CLI 向けの両方の形式に変換します。また CLI は、セッションの開始時にエージェントサーバーから届く更新を取りこぼしてはいけません。各リポジトリのテストが確かめるのは、通常は自分のリポジトリのコードだけです。Lean のモデルなら両側を含めて、両者が一致することを証明できます。
どれも、すべての入力、すべてのセッション、あるいはイベントのすべての順序についての命題です。これはまさに定理として書く形の命題で、網羅的でないテストでは標本として確かめることしかできない形です。
手法
作業は Kiro 自身が行いました。具体的には、Kiro CLI が Amazon Bedrock で提供される Claude Opus 5.5 を使い、Lean 4 用の一連のスキルを読み込んで作業しました。エージェントは対象を見つけ、Lean のモデル、証明、差分テスト(同じ入力をモデルと実際のコードに与えて出力を比べるテスト)、再現スクリプトを書きました。再現スクリプトは、手を加えていない実際のコードに対して反例を実行する小さなプログラムです。生成された証明は、エージェントとは独立に Lean が検査します。ただし、その証明を本番のコードに結び付けられるかどうかは、モデル、定理の記述、差分テストの実行環境(テストハーネス)の正確さにかかっており、これらは私たちが別にレビューしてテストしました。範囲を決めたのは私たちで、対象のリポジトリと領域を選び、定理の記述と発見が上がってくるたびにレビューしました。各定理は、コードの意図を形式的な命題として書き直したものです(コードの意図はドキュメントや設計上の不変条件から導き、発見はすべて実際のコードで確認しています)。使ったのは Lean 4.28.0 のディストリビューションだけで、Mathlib(Lean の数学ライブラリ)のような、Lake(Lean のビルドツール)で取り込む外部の依存は使っていません。エージェントサーバーは Kiro の IDE、Web、CLI v3 が共有するハーネスで(「One agent, every surface」)、CLI についての結果は Kiro CLI v3 に当てはまります。エージェントサーバーと Kiro CLI はそれぞれの非公開リポジトリで、Kiro Crew は公開リポジトリのコミット 909e0fc で分析しました。本記事の数字は、Kiro チームがレビューした社内の実験結果です。
証明を書いたのがエージェントなので、意味は近いもののコードの意図が抜け落ちたゴール(証明すべき命題)を Lean が受け入れてしまうケースがないかも確かめました。具体的には、未完成のステップ、余分な公理、決して同時には成り立たない仮定がないかを調べました。すべての定理、5 件の発見を裏付ける 10 個の反例、そのうち 1 件の発見のための 1 つの対照ケースについて、それぞれが依拠する公理を洗い出しました。仮定どうしが矛盾する定理は自明に成り立つ(空虚に真になる)ので、役に立ちません。本記事で引用または説明する定理のすべてについて、仮定をすべて満たす具体的な入力を与えて Lean で検査し、各定理の仮定が同時に満たせることを確かめました。
Lean モデルとは
Lean モデルとは、関数をもう一度 Lean で実装したものです。ソースの入力と観測できる出力を明示的なエンコーディングで表し、Lean が推論できるように書きます。定理が対象とするのはモデルで、ソースコードではありません。Lean は Python も TypeScript も Rust も読めないからです。したがってモデルは、そのエンコーディングのもとでソースと同じものを計算し、なおかつ性質を証明できるほど単純でなければなりません。
並行処理の問題が起こりうる、Kiro Crew のタスクキューの例を見てみます。キューは SQLite にタスクごとに 1 行を持ち、多数のディスパッチャー(キューからタスクを取ってワーカーに渡す処理)、実行ループ、コールバックが同時にキューを呼び出します。2 つのディスパッチャーが同じタスクを同時に取ろうとすることがあり、勝てるのは片方だけです。それを決めるのが claim で、ストアのロックのもと、トランザクションの中で、条件付きの UPDATE を 1 回実行します。taskq/store.py にあるその中心部分は次のとおりです。
with self._lock:
    conn = self._c()
    try:
        conn.execute("BEGIN IMMEDIATE")
        cur = conn.execute(
            "UPDATE tasks SET state=?, lease_owner=?, lease_expires_at=?, "
            "generation=generation+1, attempts=attempts+1, next_run_at=NULL, "
            "updated_at=? "
            f"WHERE id=? AND state IN {_SQL_CLAIMABLE} "
            "AND (next_run_at IS NULL OR next_run_at<=?) "
            "AND (lease_expires_at IS NULL OR lease_expires_at<?)",
            (ADMITTED, who, ts + lease, ts, task_id, ts, ts),
        )
        if cur.rowcount != 1:
            conn.execute("COMMIT")
            return None
        row = conn.execute("SELECT * FROM tasks WHERE id=?", (task_id,)).fetchone()
        rec = TaskRecord.from_row(row)
        self._append_event_in_tx(
            conn, task_id, "claimed", {"owner": who, "generation": rec.generation}
        )
        conn.execute("COMMIT")
    except sqlite3.Error as exc:
        self._rollback(conn)
        raise TaskStoreUnavailable(f"task claim failed: {exc}") from exc
return ClaimResult(record=rec)
これに対応する Lean モデルは次のとおりです。
/-- The columns the write paths read or set. Owner 0 is the store's own incarnation. -/
structure Row where
  state : St
  gen : Nat
  attempts : Nat
  owner : Option Nat
  expires : Option Nat
  nextRun : Option Nat
  hasWait : Bool

/-- `claim` (store.py:877): one UPDATE guarded by state, `next_run_at` and lease. -/
def claim (who now lease : Nat) (r : Row) : Option Row :=
  if claimable r.state && r.nextRun.all (· ≤ now) && r.expires.all (· < now) then
    some { r with state := admitted, gen := r.gen + 1, attempts := r.attempts + 1,
                  owner := some who, expires := some (now + lease), nextRun := none }
  else none
心配なのは、タスクが 2 回実行されることです。2 つのディスパッチャーがキューで待っている同じタスクを同時に見て、どちらも claim を呼んで取りにいくことがあります。両方の呼び出しが成功すると、2 つのエージェントが同じ作業をし、タスクが Kiro の外で変えるものはすべて 2 回変わってしまいます。次の Lean の定理は、これが起きないことを示します。あるディスパッチャーの claim 呼び出しが成功した直後、タスクは admitted(取得済みで、これから開始する状態)になり、ほかのどのディスパッチャーからの claim 呼び出しも、いつ行われても拒否される、という内容です。タスクが再び取れるようになるのは、リトライの予約のように、タスクをキューに戻す書き込みがあとで行われたときだけです。
theorem claim_exclusive (who who' now now' lease : Nat) (r r' : Row)
    (h : claim who now lease r = some r') :
claim who' now' lease r' = none ∧ r'.state = admittedこの定理はあえて小さくしてあります。claim の条件と、admitted が取得可能な状態ではないことから導かれます。この定理の価値は、依拠している条件が、差分テストで実際の SQL と一致することを確かめた条件そのものである点にあります。証明の難しさに価値があるわけではありません。この定理が述べるのは claim が成功した直後の行についてで、その後の呼び出しをまたいで何が起きるかは、後で紹介する stale_writer_fenced_out が扱います。並行処理については、成功したトランザクションはそれぞれ 1 つの不可分な状態遷移である、という仮定を通じてしか扱っていません。この仮定のもとでは、取得可能な同じ行に対して 2 つの claim 呼び出しがどちらも成功することはありません。競合する接続は、代わりにロックのエラーを受け取ることがあります。BEGIN IMMEDIATE はストアの busy_timeout まで待ってから失敗し、claim は TaskStoreUnavailable を送出します。リトライ、可用性、そのエラーの経路はこの定理の範囲外です。Crew のゲートウェイ(Kiro Crew の常駐プロセス)は自分のホームディレクトリにファイルロックをかけるので、2 つ目のゲートウェイが同じデータベースに書き込むことはできません。それでも、手動の sqlite3 セッションのような別のプロセスなら書き込めてしまいます。プロセスをまたいだ不可分性を保証しているのは SQLite の書き込みロックだけで、この前提は Lean では検査していません。
モデルはいくつかの点でソースと異なります。モデルは純粋関数で、状態を受け取って新しい状態を返します。モデルは呼び出しの列を扱い、ストアの各操作を不可分な 1 ステップとして扱います。これはストアについての仮定で、Lean が証明するものではありません。プロセス内ではストアのロックに、プロセス間では SQLite のトランザクションに依拠しています。時刻、文字列のエンコーディング、バイト数の上限のように、バグが潜みうる箇所ではデータを正確に表しています。また、モデルは普通のプログラムにコンパイルできるので、実際のコードと並べて実行できます。
モデルが役に立つのは、ソースコードと同じことをする場合だけです。各モデルの冒頭には元のソースファイルと行番号を示すヘッダーがあり、レビュアーが 2 つを並べて比べられるようにしています。このレビューだけには頼っていません。どのモデルも数千個のランダムな入力で実際のコードと並べて実行し、出力の違いがなくなるまでモデルを直しました(後述の手順 3)。そのうえで定理は、仮定を満たすモデル化したすべての入力について、モデルの上で成り立ちます。差分テストはモデルとソースが一致することの証拠であって、証明ではありません。試したすべての入力で一致することを示すだけで、どこまで信頼できるかは、生成した入力が壊れやすいケースをどれだけ突いているかで決まります。
ここには、この種の手法でよく問題になる、モデルとコードのすき間が残ります。証明は仮定を満たすモデル化したすべての入力を対象とする一方、モデルとコードの一致は約 100,000 個のランダムに生成した入力でしか確かめていません。ここでは 3 つのことがこのすき間を小さく保っています。関数が短いこと、モデルがソースコードの構造を保っていること、そして生成器が、マルチバイトのテキスト、上限ちょうどの長さ、順序を入れ替えたイベントのように、これらの関数が壊れやすい入力を狙っていることです。テスト自体の確認として、2 つのトラッカーについて実際のコード側の振る舞いを 1 つ変えてみたところ、差分テストは数百件の不一致を報告しました。
どのリポジトリでも同じ手順を踏みました。図 1 に全体の流れを示します。不一致が出たときにモデルの修正に戻る 2 か所も含めています。
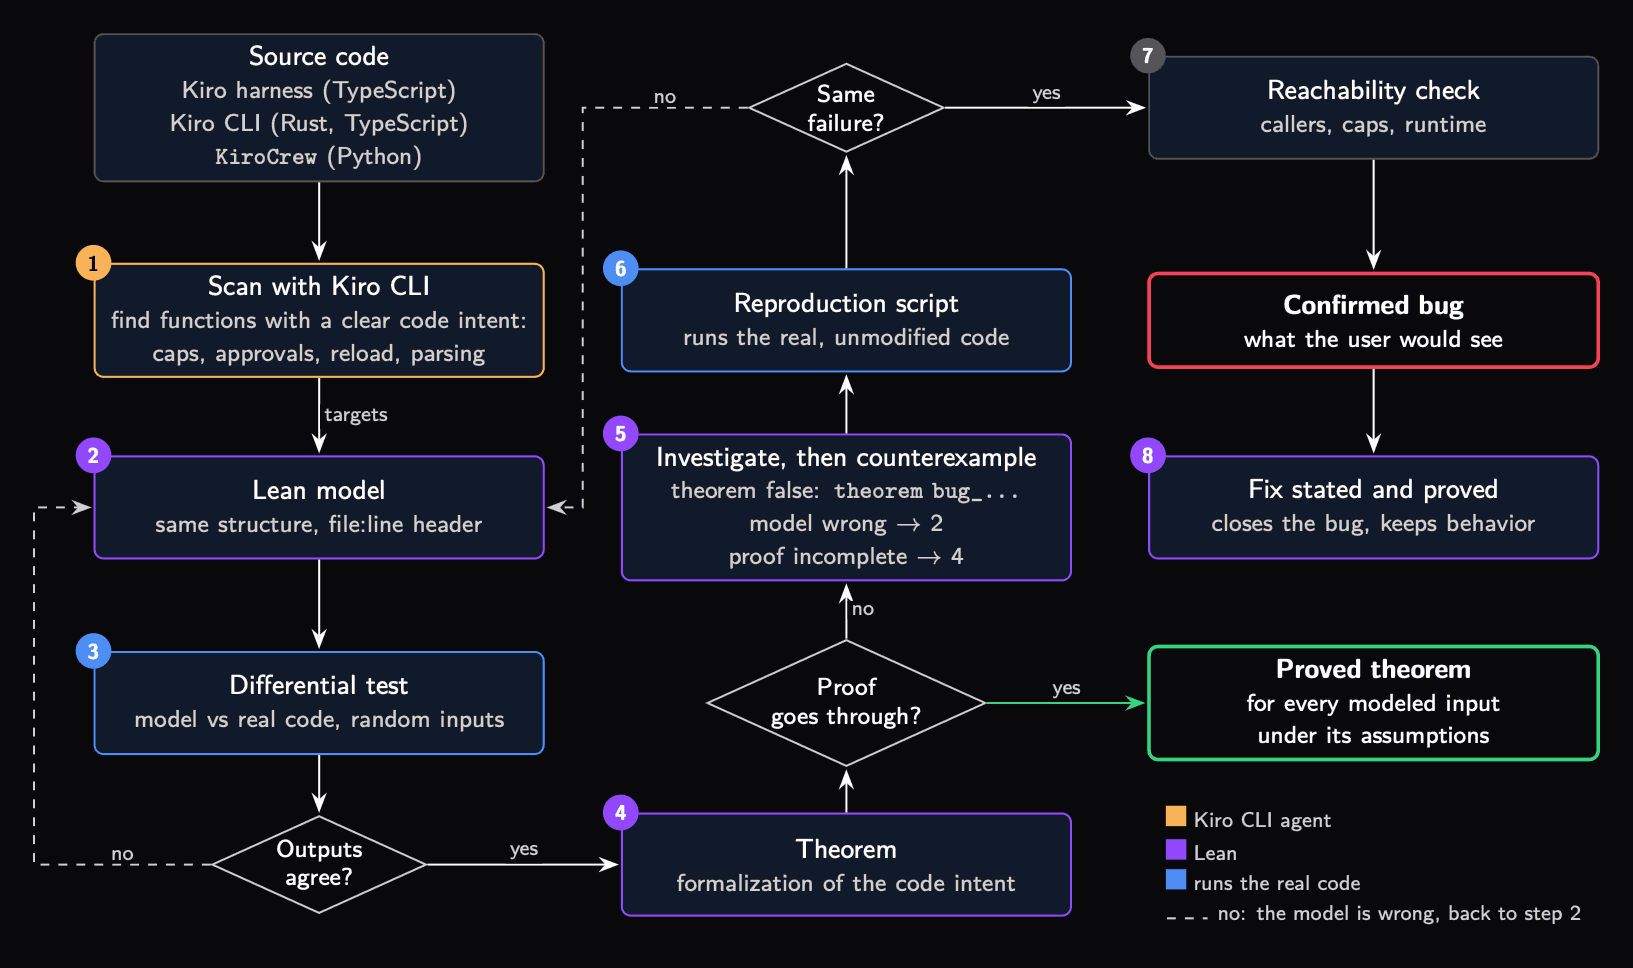
1. 対象を見つける。各リポジトリ(Kiro ハーネス、Kiro CLI、Kiro Crew)を Kiro CLI に読ませ、コードについての命題を定理として書ける関数を探すよう頼みました。サイズの上限、承認のルール、ライブのセッション(再起動せずに続いているセッション)と一致しなければならない再読み込み、決して後戻りしてはいけないステートマシンなどです。走査ではドキュメントコメント、設計上の不変条件、呼び出し箇所を読み、各対象のソースファイルと行を付けた、優先順位付きの対象の一覧を作りました。モデルはコードが何をするかを記述し、定理はコードが満たすべき振る舞いを述べます。
2. モデル化する。エージェントは前述のとおり各関数の Lean モデルを書きました。レビュアーが 1 行ずつ比べられるように、元のコードの構造を保っています。
3. モデルを実際のコードと照らし合わせる。モデルが誤っていれば、それについて証明しても実際のコードについては何も言えません。そこで、何かを証明する前に、各 Lean モデルを実行ファイルにコンパイルし、数千個のランダムな入力で実際の実装と並べて実行しました。TypeScript は Node か Bun で、Rust は実際のクレートにリンクした小さなバイナリで、Python は実際のモジュールを import して実行します。入力は、ランダムな文字列やランダムな呼び出しの列から、実際の bash と git で実行するシェルコマンドまでありました。生成器は境界を狙いました。マルチバイトや CJK のテキスト、各上限のすぐ下とすぐ上の長さ、シャッフルしたり繰り返したりしたイベントの順序、CLI がセッション開始時に保留する更新の上限 64 件を超える大量の更新などです。出力が違ったときはどちらが誤っているかを確かめ、モデル側が誤っていればモデルを直しました。3 つのコードベースで合計 97,938 ケースを流した最終の実行では、不一致はありませんでした。
4. 証明する。対象のコードの意図をそれぞれ定理として書き、証明しました。証明が行き詰まる理由はいくつか考えられます。定理が偽なのかもしれませんし、モデルが誤っているのかもしれませんし、証明が未完成なのかもしれません。行き詰まった証明は 1 つずつ調べました。行き詰まったゴールが、期待される振る舞いを破る入力を指していた場合は、特定の入力でモデルが期待される振る舞いに違反することを述べる bug_… という定理を証明しました。こうすることで、反例そのものも Lean で検査されます。2 つの性質については、証明の代わりに有界検査を書きました(これらの性質は外部のソフトウェアに依存しており、Lean で忠実にモデル化できなかったためです)。有界検査が対象とするのは、上限までのすべての入力、または固定の一覧にあるすべてのケースだけで、それ以外は対象外です。表 1 で 2 件の有界検査を証明済みに含めず、別に数えているのはそのためです。
5. 再現する。反例を発見として数えたのは、手を加えていない実際のコードを実行するスクリプトで同じ結果が出た場合だけです。そのうえで、実際の呼び出し元がその入力に到達できるかを確かめ、それが起きたときにユーザーに何が見えるかを調べました。
大半の発見では、さらに一歩進めました。修正を Lean で書き、コードが保つべき振る舞いを変えずに問題を塞ぐことを証明したのです。これで証明されるのは修正後のモデルの正しさです。修正を実装するコードの変更については、その変更自体の差分テストを通すまで、証明は何も保証しません。
| コードベース | 関数 | 性質 | 証明済み | 有界検査 | 見つかったエッジケース | 部分的な結果または観察 | Lean の定理 | テストケース |
|---|---|---|---|---|---|---|---|---|
| Kiro ハーネス(TypeScript) | 15 | 51 | 36 | 0 | 9 | 6 | 111 | 23,281 |
| Kiro CLI(Rust、TypeScript) | 8 | 29 | 23 | 0 | 6 | 0 | 86 | 65,000 |
| Kiro Crew(Python) | 3 | 16 | 11 | 2 | 3 | 0 | 38 | 9,657 |
| 合計 | 26 | 96 | 70 | 2 | 18 | 6 | 235 | 97,938 |
表 1: Kiro ハーネス、Kiro CLI、Kiro Crew の検証結果と、それを裏付ける検査。各行の「性質」は 4 つの結果の列の合計です。「証明済み」は、定理に書いた仮定を満たすモデル化したすべての入力について証明した性質の数です。「有界検査」は、サイズの上限までのすべてのケース、または固定の一覧にあるケースで検査した性質の数で、証明済みには数えていません。「部分的な結果または観察」は、一部だけを証明した性質と、到達できないコードについての観察の数です。「Lean の定理」には証明に必要な補題を含みます。「テストケース」は差分テストで生成した入力の数で、純粋関数なら 1 つの入力、状態を持つ関数なら 1 つのランダムな呼び出しの列を 1 ケースと数えます。
Lean が証明したこと
Lean は 96 個の性質のうち 70 個を、それぞれ定理に書いた仮定を満たすモデル化したすべての入力について証明しました(残りの性質は、バグの発見か、部分的な結果または観察になりました)。ここでは、そのうち特に役に立つと考えているものを紹介します。どれも多くの入力やイベントの順序に左右され、テストがもっとも手薄になる部分だからです。
コンテキストと履歴
重複したファイルを取り除いても、リクエストのプレフィックスは保たれる。同じファイルが何度も添付されると、Kiro ハーネスはリクエストを送る前に、その内容のコピーを 1 つだけ残します。会話が長くなるにつれてこの処理が以前のメッセージを変えてしまうと、ターンごとにプレフィックスが変わり、キャッシュが効かなくなるおそれがあります。私たちは、任意の履歴 xs と任意の新しいメッセージ ys について、xs に ys を続けたものの処理結果が、xs の処理結果で始まることを証明しました。つまりこの処理は、ファイルがいくつあっても、どんな順序でも、前のターンで LLM が見た内容を書き換えません。この定理が対象とするのは重複の除去だけで、リクエストのプレフィックスは、リクエストを組み立てるほかの処理にも左右されます。
履歴は編集や再読み込みを経ても保たれる。Kiro ハーネスは、削除したメッセージや元に戻したメッセージもセッションファイルに残し、履歴を組み立てるときに削除や取り消しを反映します。私たちは、この反映を 2 回行っても 1 回行ったのと同じ結果になること、結果はメッセージを落とすだけで並べ替えはしないこと、フォークしたセッションは必ず、削除や取り消しを反映したあとの親の履歴から始まることを証明しました。再読み込みのあとは、すべてのツールカード(チャット画面でツール呼び出しを表示する欄)が、ユーザーがライブで見ていた状態で終わります。これは 8 つあるツール呼び出しの状態(承認待ち、実行中、成功、受け入れ済み、エラー、処理済みのエラー、キャンセル、却下)のすべてについて成り立ちます。
切り詰めた出力は上限を超えない。CLI のエージェントは、シェルコマンドの出力などのツールの結果を、コンテキストウィンドウに入れる前にバイト数の上限まで切り詰めます。私たちは、有効な UTF-8 のどんな文字列についても、切り詰めたテキストが UTF-8 のバイト数で上限を超えないことを証明しました。切り詰めの通知を末尾に付ける場合も同じで(上限より長い通知は、それ自体が収まるように切り詰められます)、通知を付けない場合は、文字を途中で分割せずに収まるもっとも長い先頭部分を残すことも証明しました。モデルは、マルチバイトのテキストの約 4,000 ケースで実際の Rust の関数と一致しました。
イベントがどんな順序で届いても、セッションの状態は保たれる。Kiro ハーネスは、セッションが処理中か、ユーザーの入力待ちか、アイドルかをクライアントに伝えます。この判定には、そのセッションが開始したバックグラウンドのワークフローも含まれます。ワークフローのイベントは別々の非同期処理の中で扱われ、どの順序で終わるかは決まっていないため、トラッカーはシーケンス番号を使って元の順序に並べ直します。私たちは、実行を開始、一時停止、終了するイベントについて、どの順序で届いても元の順序で届いた場合と同じ状態になることを証明しました。この証明は、一部の並べ替えではなくすべての並べ替えを対象とします。モデルを、6,000 個のランダムなイベントの列(大半は順不同で届くもの)で実際のトラッカーと照らし合わせました。
権限
サブエージェントの制限が親より緩くなることはない。Kiro ハーネスはサブエージェントを開始するとき、サブエージェント自身の権限の判定を親の判定と組み合わせます。私たちは、その結果が常に 2 つの判定のどちらかであり、常にそのうち制限の厳しいほうであること、そしてサブエージェントからの拒否や明示的な確認の要求が弱められることはないことを証明しました。したがってこの処理を通じて、2 つのポリシーが何を定めていても、親が拒否する、または確認を求めるツール呼び出しをサブエージェントが承認することはできません。また、ポリシーを厳しくしても拒否が承認に変わることはないことも証明しました。ここで「厳しくする」とは、許可、確認、明示的な確認、拒否という順序で、判定が少なくとも同じだけ制限的になることを指します。あわせて、正規化した絶対パスが .. を使ってルートより上に出られないことも証明しました。
1 つの許可リストを 2 つのバックエンドで使う。Crew では、ユーザーが CLI の allowedTools の形式でツールの許可リストを書くと、Crew がそれを Kiro ハーネスのポリシーのパターンに変換します。私たちは 3 つの照合器(Crew の変換、Kiro ハーネスのポリシーの照合器、CLI の glob の照合器)をすべてモデル化し、それぞれのモデルを実際のコードと照らし合わせたうえで、バックスラッシュを含まないどのエントリについても、変換後のパターンで判定する Kiro ハーネスが、CLI より大きな権限を与えないことを証明しました(kas_le_cli)。バックスラッシュを含むエントリは、Kiro ハーネスで CLI より大きな権限を与えることがあります。これは Crew の 3 件の発見のうちの 1 つで、そうしたエントリを拒否する修正も証明しました。
CLI と Kiro Crew のステートマシン
LLM のフォールバックは必ず止まる。LLM がリクエストを拒否すると、CLI のフォールバックの処理が別の LLM に切り替えます。私たちは、拒否と呼び出しがどんな順序で起きても、1 つのターンで 3 回を超えて切り替えることはなく、そのターンですでに試した LLM に切り替えることもないことを証明しました。
2 つのディスパッチャーが同じタスクを取ることはない。複数のディスパッチャーがキューで待っている 1 つのタスクを奪い合っても、成功する claim 呼び出しは 1 つだけです。その直後、タスクは admitted になり、ほかのどのディスパッチャーからの claim 呼び出しも拒否されます(前述の例の定理 claim_exclusive)。モデルは、ストアのロックがそうしているとおりに、ストアの各呼び出しを不可分な 1 ステップとして扱います。したがってその仮定のもとでは、どんな順序でも、取得可能な同じ行に対して 2 つの claim 呼び出しが成功することはありません。競合する呼び出しが代わりにロックのエラーで失敗することはありますが、それはこの定理の範囲外です。
タスクキューは古いワーカーを締め出す。Kiro Crew のタスクキューでは、各タスクは 15 の状態をとり、queued から running や各種の待ち状態を経て、done、failed、cancelled のいずれかで終わります。claim 呼び出しが成功するたびに行の世代(generation)が増え、ワーカーがその後に行う書き込みには、自分が持つ世代が付きます。私たちは、どんな呼び出しの列についても世代が減らないことを証明しました。そのため、タスクが新しいワーカーに取られたあとは、古いワーカーのフェンス付きの書き込みで行が変わることはありません。
theorem stale_writer_fenced_out (lease : Nat) (ops : List Op) (r : Row) (o : Op) (g : Nat)
    (hg : g < r.gen) (ho : o.fencedBy = some g) :
    step lease o (run lease ops r) = run lease ops r
モデルは、SQLite で動く実際のストアと、合計約 20,000 回の呼び出しからなる 4,500 個のランダムな列で一致しました。これらの列では呼び出しを 1 つずつ順に実行したので、確かめたのは各呼び出しのロジックで、ストアの並行処理は確かめていません。並行するワーカーについての主張は、前述の不可分性の仮定に依拠しています。
Lean の反例として見つかったバグ
18 件のコードの意図について、モデルの上で反例が見つかり、そのすべてを分析したコードで再現しました(セッション開始時の競合はモジュール単位で再現)。この規模のコードでは、こうしたエッジケースがあるのは普通のことです。2026 年 10 月 1 日に CLI と Kiro Crew の GitHub の issue、エージェントサーバーのプルリクエストを検索したところ、どの発見にも一致する未解決(open)の issue はありませんでした。ただし、エージェントサーバーのマージされていない(open)プルリクエストのうち 1 つは 1 件の発見を直すもので、別の 1 つは 1 件の発見の一部を説明していました。どの発見も、普通でない入力か特定のタイミングを必要とします。いくつかは安全側に倒れて失敗します。ユーザーにもう一度確認が求められるか、LLM に見えるテキストが意図より少し多いか少ないかです。大半については、Lean で修正も証明しました。
Kiro Crew のコードベースで見つかった並行処理のバグを、具体的に見てみます。
キャンセルしたのに実行されるジョブ(PR 25130 を参照)。Kiro Crew では、決めた時刻にジョブを 1 回だけ実行でき、ユーザーは実行中のジョブをキャンセルできます。コードの意図は、キャンセルした「1 回だけ」のジョブは二度と実行されない、というものです。この振る舞いを破る流れは次のとおりです。ジョブが作業の開始を待っているあいだにユーザーが Cancel run をクリックすると、Cancel は実行を止めますが、ジョブを有効なまま残します。そのため数秒後にスケジューラーがジョブをもう一度実行し、結局リリースノートが投稿されてしまいます。キャンセルが、ジョブの作業が始まる直前のごく短い時間に入る必要があるため、テストではこれを見逃します。Lean はこれを反例として見つけました。ジョブのライフサイクルのモデルにおける、キャンセルのあとにジョブの作業が実行されて終わる、10 個のイベントの列です。私たちはこの列を実際のスケジューラーで再現しました。修正は Cancel の処理に条件を 1 つ足すだけです。修正後のモデルについては、どんなイベントの列でもキャンセルしたジョブが再び実行されないことを Lean が証明します。
/-- A counterexample. A user cancel that lands while the fire-time gate is awaited: `run_never_started` is set, so the finally does not auto-pause, and cancel() does not park a delete_after_run job. The next tick dispatches it again and its payload runs, after the user cancelled it. -/
def cancelInGate : List Ev :=
  [tick, firstStep, enterExecute, cancelTake, cancelFinish, runFinally,
   tick, firstStep, enterExecute, gatePass]

/-- Job status outcome. What a trace ends with: payloads started, dispatches, and whether the user cancelled. -/
def outcome (fixed : Bool) (dar : Bool) (es : List Ev) : Option (Nat × Nat × Bool) :=
  (run fixed (init dar) es).map (fun t => (t.payloads, t.dispatches, t.userCancelled))

/-- Lean theorem that checks the counterexample. On the current code, for a job that deletes itself after it runs: the work ran once, the job was dispatched twice, and the user had cancelled it. -/
theorem bug_cancel_in_gate_runs_anyway : outcome false true cancelInGate = some (1, 2, true) := by
  decide
ほかに見つかったバグは、主に次のグループに分かれます。
- 並行処理の競合。同時に開始した 2 つのセッションが干渉することがあります。
session/newの処理中に別のセッションが CLI に登録すると、セッションの開始中に送られた更新(たとえばセッション開始時のフックからのツール呼び出し)が失われることがあります。この種の競合はテストで見つけにくいものです。テストが実行するのはイベントの 1 つの順序だけで、バグは別の順序でしか現れないからです。Lean では、セッションの数を問わず、モデルにおけるセッション開始のイベントのすべての列を対象に定理を書きました。証明は通らず、更新が失われるインターリーブ(2 つのセッションのイベントが入り混じる順序)をbug_…の定理として書き、Lean で検査しました。そのうえで、そのインターリーブを、セッションの更新を保留して再送する CLI の実際のコードで再生しました。このコードは手を加えずに import し、クライアントのハンドラー表の写しにつないでいます。これはモジュール単位の再現で、動いている CLI でのエンドツーエンドの再現ではありません。 - 誤った単位で測った上限。Kiro ハーネスの 9 件の発見のうち 7 件は、テキストを上限に収まるように切り詰める関数にあります。
web_fetchにはバイト数の上限がありますが、ページを切り詰めるときは UTF-16 のコード単位を数える JavaScript の文字列の長さを使い、上限のバイト数の半分の数のコード単位を残します。これは、各コード単位が UTF-8 で 2 バイト以下であることを前提にしています。中国語や日本語の文字は 1 コード単位ですが UTF-8 では 3 バイトなので、そうしたページは上限の最大 1.5 倍の大きさで返ってくることがあります。また、既定のモードでは、ページを切り詰めたことが示されません。UTF-16 のコード単位で数えて切り詰めると、テキストのいちばん最後にある絵文字を分割してしまうこともあります。grep_searchは一致した行は短くしますが、前後の文脈の行は短くしません。そのため、たとえば minify されたファイルにあるとても長い文脈の行が 1 行あるだけで、一致した行が上限内の結果から押し出されることがあります。どの場合も何かが失敗するわけではなく、LLM に見えるテキストが意図より多少多いか少ないかになります。 - とても大きなコマンドの出力。シェルコマンド、フック、ワークフローのステップが 229 − 24 個を超える UTF-16 のコード単位(ASCII のテキストで約 512 MiB)を出力すると、試したビルド(macOS arm64 上の Node 26.3.0 と V8 14.6)で V8 が作れる最長の文字列を超えます。ハーネスは、V8 を使う Node の上で動きます。Kiro ハーネスはサイズの上限をかける前に出力を 1 つの文字列にまとめるので、エラーは上限より先に起きます。このエラーを捕まえるものはなく、Kiro ハーネスの捕捉されないエラーのハンドラーがプロセスを終了するため、開いているセッションも終わってしまいます。Kiro ハーネスのバックグラウンドのターミナル用の収集処理は、もともと最新の出力だけを残しており、この収集処理が V8 の文字列長の制限に決して達しないことを証明しました(
tail_join_safe)。そこで、すべてのコマンドにこの収集処理を使うことが修正になります。 - コールドリロード後の spec のルール。Kiro の spec モードでは、ライブの経路と再読み込みの経路で、暗黙のルールを付けるメッセージが異なります。そのため、コールドリロードのあとのターンは、ライブのセッションが送ったはずのリクエストとわずかに異なり、再利用できるプレフィックスを 1 回変えてしまいます。その結果、そのターンではキャッシュを再利用できないことがあります。
- 承認したパスに含まれる glob の文字。CLI は「常に許可」したパスを、エスケープせずに glob のパターンに変換します。
app/[slug]/page.tsxのような Next.js のルートでは、承認したファイルについてもう一度確認を求められ、app/s/page.tsxのような別のパスまで承認されてしまいます(glob では[slug]が s、l、u、g のいずれか 1 文字に一致するため)。私たちはモデルで修正を証明しました。先にパスをエスケープすれば、許可は承認したパスとその配下のファイルだけにきっちり一致し、glob の文字を含まないパスの扱いは変わりません。
ほかにも 2 つのコードの意図が成り立ちませんでしたが、それを破る入力に到達する本番の呼び出し経路は見つかりませんでした。そのため、これらは発見ではなく観察として数えています。表 1 にある Kiro ハーネスについての 2 件の観察がこれで、18 件には含めていません。3 つのコードベースのどれでも、見つかったバグの中に、セキュリティ上の問題に当たるものはありませんでした。
分かったこと
証明はハーネスによく合う。コンテキスト管理、権限、そしてその周りのステートマシンは、短く正確な定理になります。次のターンでも同じプレフィックス、再読み込みのあとでも同じリクエスト、ちょうど 1 つのファイルだけに効く承認、イベントがどの順序でも成り立つ結果などです。その背後にある関数は小さく、そのまま Lean に置き換えられます。証明した性質の大半と、18 件の発見のうち 15 件はこれらの領域にあり、発見の大半は UTF-16 と UTF-8、ファイルパスと glob のような 2 つの表現の境目にあります。両側を 1 つの言語で書き下すことで、どこで食い違うかが見えました。
差分テストは証明と同じくらい重要。差分テストは、Lean のモデルの誤りを見つけて直すのに役立ちました。Lean が証明を完了できなかったときは、残ったゴールが失敗の原因となる入力を示していることがよくありました。そのうえで修正を書き、その特定の入力だけでなくすべての入力で、修正後のモデルが意図した振る舞いを満たすことを証明しました。
制約
証明が示すのは、モデルの定義と仮定のもとでの Lean モデルの性質です。それが実際のシステムについてどこまで語れるかは、証明だけでは確かめられない次の点にかかっています。
- モデルはコードの動作と一致していなければならない。エージェントは各モデルをソースから書いたので、モデルがコードの動作の一部を取りこぼすことはありえます。差分テストはモデルを実際のコードと照らし合わせますが、ランダムに生成した入力でしか確かめないため、生成しなかった入力での違いには気づけません。また、タスクキューがストアの各呼び出しを不可分な 1 ステップとして扱うことのように、明示した仮定に依拠しているモデルもあります。
- 定理はコードがすべきことを述べていなければならない。エージェントは各定理をドキュメントコメント、設計上の不変条件、呼び出し箇所から書き、私たちがそれをレビューしました。定理が意図した振る舞いの一部を書き漏らしていれば、証明が成功してもバグを見逃すことがあります。
- モデルの型は忠実でなければならない。モデルが Lean の上限のない自然数を使ったり、データ構造を抽象化したりしている箇所では、オーバーフロー、浮動小数点の振る舞い、操作のコストは捉えられません。UTF-8 や UTF-16 の長さのように、コードの振る舞いについての厳密な命題(定理や補題)が値の表現に依存する箇所では、表現を正確にモデル化しました。
- 信頼する基盤はカーネルより広い。証明は Lean のカーネルに依存します。差分テストはさらに、Lean のコンパイラー、両側に同じ入力を与えるテストハーネス、実際のコードのランタイムにも依存します。
native_decide(命題をコンパイルして実行し、真偽を判定する Lean の機能)を使う 17 個の定理は、Lean のコンパイラーと、それがビルドに使う C のツールチェーンも信頼しています。ただし、この 17 個はどれも、証明済みとして数えた性質の根拠には使っていません。これらは有界検査、反例、1 つの対照ケースで、反例はすべて実際のコードでも再現しています。 - 結果はコミットに結び付いている。各モデルが記述するのは、分析したコミットの時点のコードです。その後のコードの変更は、モデルを更新して差分テストを再び通すまで対象外です。
これらの問題は、自動形式化(autoformalization)の分野ではよく知られています。自動形式化でいちばん難しいのは、自然言語で書かれた数学の主張であれ、別のプログラミング言語のコードであれ、Lean の命題が元のものを忠実に捉えていると確かめることです。発見については、実際のコードが決着を付けます。各反例を実際のコードで再生しており、そこで失敗すれば、モデルとは独立にバグが確定します。証明を信頼する根拠としては、差分テストと定理の記述のレビューで十分だと判断しました。この手法を当てたのは、命題を小さく簡潔に書け、その大半が 2 つの表現の境目にある、効果が出やすい 26 個の関数です。各発見が、それを呼び出すコードから到達できるかどうかも判断しました。
コンテキスト管理の仕事にとっての意味
Kiro のコンテキスト管理は、コンテキストウィンドウの内容には上限がある、再読み込みしたセッションは変わらない、プロンプトキャッシュは一連の処理を通じて保たれる、といったハーネスの性質の上に成り立っています。これまで、こうした前提は設計ドキュメントと単体テストの中にしかありませんでした。本記事で取り上げた関数については、これらが Lean モデルについての定理になり、それぞれがランダムに生成した入力での差分テストによって実際のコードに結び付いています。対象は分析したコミット時点のこれらの関数で、ハーネス全体ではありません。
これが今後のロードマップの土台になります。機能を設計する段階で性質を 1 つずつ定理として書き、コードが変わるたびに差分テストを流し直して、レビューの前にリグレッションを見つけやすくする計画です。手順は自動化されていますが、定理の記述と発見はいずれも人がレビューする必要があります。そのため、Kiro のほかのリポジトリに検査を広げられるかどうかは、計算資源だけでなくレビューにかけられる労力にも左右されます。目指しているのは、ハーネスの中核の振る舞いのうち、前提として置くのではなく証明されたものを増やしていくことです。
自分のコードで試す
Lean を始めるには、Lean のドキュメントを参照してください。Kiro のエージェントハーネスの仕組みについては「One agent, every surface」で詳しく説明しています。Kiro をダウンロードして、ご自身のコードベースで試してみてください。
原文の著者
Yaroslav Kharkov、Ferhat Erata、Behrooz Omidvar-Tehrani、Rajdeep Mukherjee(いずれも Applied Science)