Amazon Web Services ブログ
Kiro はどのように自らを修正し、その修正の正しさをどう担保しているか
Kiro のファイル読み取りツールと検索ツールの説明に、ハーネスの動作について事実と異なる主張をする一文がありました。この一文は数百のセッションで 61,742 回モデルに届いていました。何の役にも立っておらず、誰かがチケットを起票することもまずなかったでしょう。こうした問題は見つけるのが難しく、修正の良し悪しを判断するのも同じくらい難しいものです。たとえば私たちは、より多くのタスクに合格し、使用トークンも少ない修正をあやうくリリースするところでした。結果をホストごとに分けてみると、改善のほぼすべてが、エージェントがいつもはまり込むループからたまたま抜け出した 1 回の実行によるものだとわかったのです。そのホストを除くと、その修正は遅く、コストが高く、精度も下がっていました。自分の修正を自分で採点するループなら、これをリリースしていたでしょう。
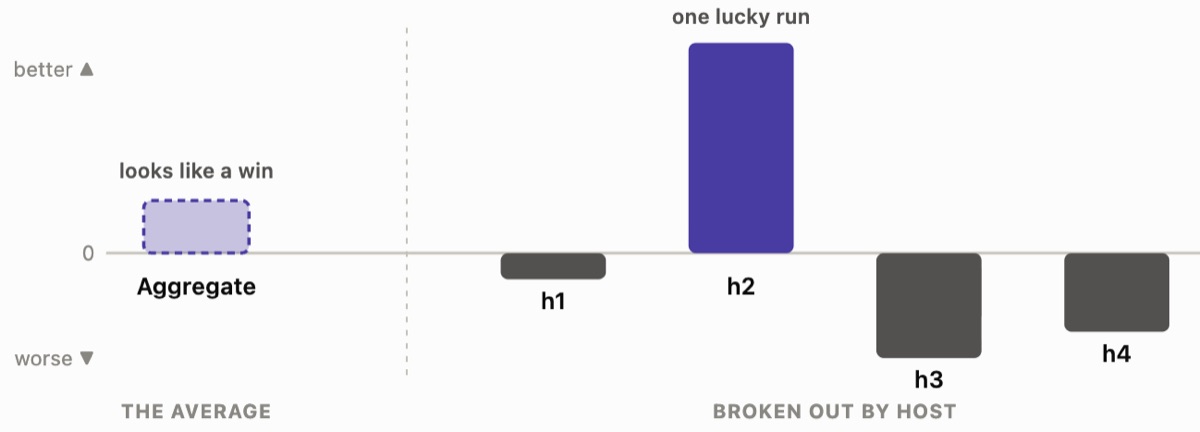
私たちは、AI コーディングエージェントである Kiro を、Kiro 自身の実行結果から改善するための社内トレーシングシステムを構築しました。社内で kiro-trace と呼んでいるこのシステムは、実行結果を読んで Kiro が失敗している箇所や無駄な労力を使っている箇所を見つけ、変更を提案し、その変更を退けるために作られたチェックをくぐり抜けた場合にだけ変更を残します。これらのチェックは、先ほどの例のように勝ちに見えて実際には運にすぎなかった結果を捕まえるためのものでもあります。変更を提案するのはモデルでも構いませんが、受け入れるか退けるかは決定的なコードで判断します。
最初の 1 週間で、kiro-trace は Kiro に 8 件のプルリクエストを出しました。7 件がマージされ、1 件は無関係な理由でクローズされ、コードレビューで差し戻されたものはありませんでした。7 件はいずれも Kiro のプロンプトやツール、つまりツールの説明、引数のチェック、応答の振る舞いを変更するものでした。どれも私たちが計測していた特定のパターンを対象にしており、どれもそのパターンを改善しました。いくつかはこの記事の後半で結果とともに紹介します。残りは、ユーザーに見えるエラーとして表面化したことはなく、指摘するチケットもありませんでした。人が見つけることもできたでしょうが、それには誰にも時間がないほど大量の実行結果を読む必要がありました。これが、Kiro が自己改善を続ける仕組みです。
以下の数値は Amazon 社内での Kiro の利用から得たもので、どの数値も本番環境での推定値ではなく社内実験での差分です。関連記事の Continuous Prompt Evaluation では、人が書いたプロンプトの変更を LLM ジャッジとライブ A/B テストでどう評価しているかを紹介しています。この記事はその続きとして、実行軌跡 (trajectory) の自動マイニング、変更の生成、ハーネスの自己改善を扱います。
自己改善が難しい理由
先月、Kiro のコアモジュールには 141 件のバグ修正コミットが入りました。1 日 5 件近くになり、しかもこれは人が気づいて修正する時間を取れた失敗だけの数です。最も厄介な問題は、きれいなバグ報告の形では現れないことがほとんどです。エージェントがエラーからどう回復するか、ツールをどの順序で使うか、長いコンテキストをどう保持するかの中に潜んでいて、何千もの実際の実行を読み通して初めて気づきます。この記事の冒頭のツール説明の一文は、その種の問題の一例です。
そのため、やるべきことは、Kiro が失敗したり無駄な労力を使ったりしている箇所を見つけ、他の箇所で退行を起こさずに改善するよう Kiro を変更することです。これはバグ修正よりも範囲が広く、誤解を招くツールの説明、形式上の理由で拒否されるツール呼び出し、無駄な呼び出しやトークン、エラー後の不十分な回復、もう役に立たなくなった指示まで含みます。これらを見つけるために何千もの実行を人手で読むことは誰にもできないので、この作業は自動化する必要があります。わかりやすい近道は、エージェントに最初から最後まで自分自身を改善させることですが、多くの自己改善ループがつまずくのはまさにそこです。自分の修正を自分で採点するループは、その場しのぎの局所的な対処をリリースして先へ進んでしまいます。これを正しく行うには、kiro-trace は 4 つの問題を同時に解く必要があります。1) 修正する価値のある失敗を見つける、2) その原因を狙った変更を書く、3) ベンチマークに合わせ込まず汎用的な解決策に保つ、4) 変更によって結果が改善したことを証明する、の 4 つです。自己採点ループは 4 番目を飛ばしており、それがなければ 1 から 3 にやる価値があったのかを知る手段がありません。
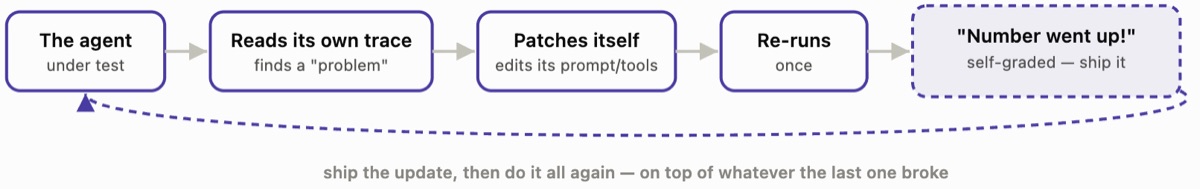
図のループは、各変更を狙った問題に対してしかチェックしないため、新しい変更が以前の変更で直したものを壊しても、ループは気づきません。これは、ループの外で退行をチェックするものが何もないときに起こります。kiro-trace では、候補は Kiro がすでに合格しているタスクでも実行され、最終候補はベンチマーク全体で変更を加えていない対照群と比較され、プルリクエストはマージ前に通常のコードレビューも通ります。
kiro-trace の仕組み
次の図は、ループの 1 回分の流れを示しています。左側から、ベンチマークと、人が承認したライブトラフィック上の不満という証拠が入ってきます。ループは失敗を読み、診断し、変更するレバーを 1 つ選び、同じ Kiro で変更をオフにした場合とオンにした場合を実行します。その後、3 段階のゲート (スクリーニング、退行チェック、確認) が判定します。合格した変更は人がマージするためのプルリクエストになり、退けられた変更は診断に戻ります。
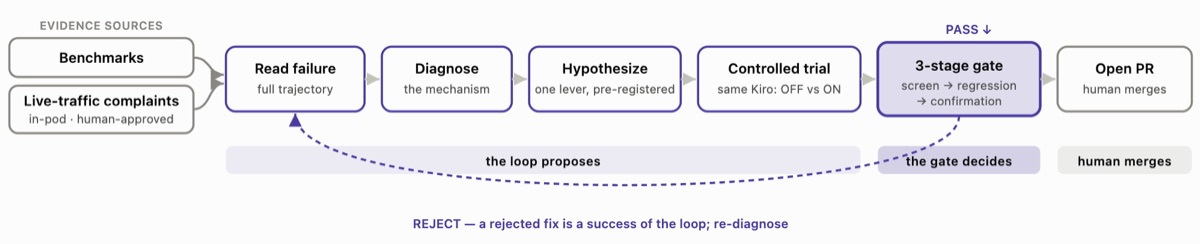
私たちは常に 3 つの役割を分けています。変更を書く者と、それが機能したかを判断する者が同じだと、変更を受け入れてしまいがちだからです。これは私たち自身の失敗から学んだことでもあります。比較結果を人手で判定していたとき、同じ実行を 3 通りに読んでしまったことがあり、それが現在判定をコードに置いている理由です。Kiro は改善される側のエージェントです。ループは変更を提案して適用します。ゲートは普通のコードで、変更を残すかどうかを判定します。この 3 つとは別に、最終的なマージの判断は人が行います。以下は、それぞれの部分を作る中で学んだことです。
ベンチマーク全体ではなく、失敗に対して反復する
毎回ベンチマーク全体を実行するのは時間もコストもかかりますし、タスクは互いに置き換えのきくものではありません。タイムアウトするもの、実質的には長いコンテキストのテストになっているもの、エージェントではなく評価ハーネスが原因で失敗するものもあります。そこでループは、各タスクについてすでに知っていること、つまり失敗の種類、コスト、そもそも本当の信号になっているかどうかを使って、無駄なものを含めずに失敗の種類を網羅する小さなセットを組み立てます。ループはその小さなセットで反復するので、速く低コストです。ベンチマーク全体は、候補が小さなセットで合格した後、最後に一度だけ実行します。変更を加えた実行を、変更を加えていない対照群の実行と全体で比較し、小さなセットでは勝っても全体では勝てない変更はリリースしません。
レビュアーを Kiro 自身の履歴に基づかせる
汎用的な LLM ジャッジは、どんな実行でも読んで修正を提案できますが、あなたのエージェントループや推論レイヤーのことは知りません。kiro-trace のレビュアーは Kiro の実際のコードレビューのコメントや開発者の議論を読んでいるので、このチームが指摘するであろうことを指摘します。レビュアーが検討するアイデアは証拠から来ています。Kiro があるタスクに失敗すると、ループは同じタスクを、同じ入力と予算で、参照エージェントの一団に実行させます。参照エージェントとは、Kiro の実行と比較するための、他の高性能なモデルやエージェントです。Kiro が失敗したところで参照エージェントのどれかが成功すれば、その差は、ループが修正に変えられる具体的な振る舞いになります。これとは別の調査ステップでは、論文から公開コード、同じ問題を他のエージェントがどう解いているかまで、外部の取り組みから汎用的な手法を取り込みます。それらのコードをコピーすることはありません。各候補は、診断した失敗と引用した証拠を記録するので、どの修正もその根拠までたどれます。最近のモデルはすでに多くのことを知っているので、既定ではルールを追加する前に何かを削除することを試みます。
モデルの手が届かないチェックを通じて、差分で判定する
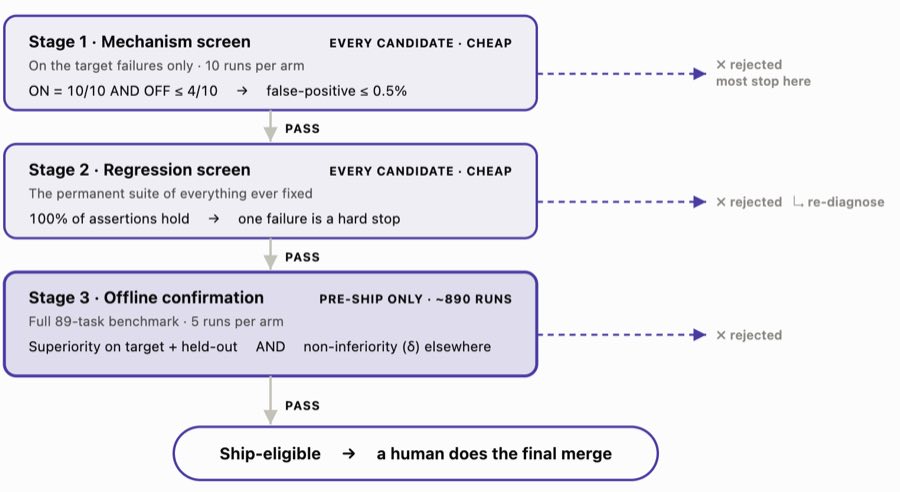
修正を数回実行して平均を見るだけでは、一貫した結果は得られません。先ほどの例のように、外れ値 1 つで結果が大きく振れるからです。そこで変更は、最も安価なものから順に段階的に厳しくなる一連のチェックにかけられ、ほとんどの候補は高価なチェックに進む前に落ちます。通常の A/B テストとは異なり、私たちはスコアではなく差分を計測し、毎回対照群を再実行します。そのため、報告される改善はその変更による寄与であり、新しいモデルならどのみち出していたであろう結果ではありません。また、変更は定めたマージンに照らして退行していないことを示す必要があります。サンプルが少ないと、検出力の弱い検定は既定では何も有意なものを見つけませんが、実際の害を持ち込むことはあり得るからです。最後に、汚染チェックで、エージェントが自分で解くのではなく、タスクのソースやテストを取得するなどネットワークを使ってタスクの答えを調べた合格を除外します。
修正の例
弱い候補は早い段階でふるい落とされるので、人のレビュアーに届く変更は、たいてい意味のあるものです。以下にいくつか紹介します。数値はいずれも社内実験での差分です。
- すべてのファイル読み取りと検索に付いていた、ハーネスの動作に関する誤った主張。モデルは 445 サンプルの中でこれを 61,742 回目にしていましたが、何にも使われていなかったので削除しました。
- 存在しないツールを呼び出すようモデルに指示していたガイダンス。削除しました。
- 冗長なファイルの再読み込みを約 83% 削減。変更されていないファイルを読み直さないようにしました。
- 厳しすぎる、または説明が不十分なツールの契約 2 件を修正。サンプリングした 80 セッションで、読み取りツールのスキーマによる拒否 205 件と、サブエージェントのオーケストレーションでの拒否 167 件を解消しました。
- 型に厳密なツール入力が、形式上の理由で失敗しなくなった。モデルがブール値を生のブール値ではなく文字列の “true” として返すと、呼び出しが拒否されて作業が止まっていました。現在はそうした値をリトライ時に補正するので、意図の正しい呼び出しは通ります。
- 検索のおよそ 8 回に 1 回を失敗させていた、表に出ないファイル検索のバグ。仕様の誤りによりエラーなしで空の結果が返り、エージェントは検索しても何も見つけられませんでした。修正済みです。
- 過剰な委任を根本から削減。単純な直接編集にもサブエージェントを起動させていた一律の委任指示を削除し、役に立つ場面での委任は残しました。
より厳格な参照エージェントを一団に加えたことで、探していなかったものが見つかりました。その参照エージェントの読み取りの 13〜17% を失敗させていた相対パスのバグが、私たちがリリースしているモデルでは 1.6% しか現れていなかったのです。より寛容なモデルが、仕様の欠陥をエラーなしで吸収していました。仕様を修正すれば、同じ契約を共有するすべてのモデルの助けになります。その修正は現在レビュー中です。
最も大きな変更はまだリリースしておらず、チームでレビュー中です。積極的に削除を進めた結果、ループはより小さなツールとプロンプトの構成を作り上げ、Terminal-Bench 2.1 で pass@1 (最初の試行で解けたタスクの割合) が 77.5% に対して 82.4% となり、トークンコストはおよそ 3 分の 1 でした。まだリリースしていないのは、すべての Kiro ユーザーの既定のツールとプロンプトが変わるためで、これはベンチマークの判断というより製品の判断だからです。チームは、より小さな構成を既定にするかどうか、そして削除したツールのうちどれをタスクで必要なときだけ戻すかを検討しています。
kiro-trace はどのようにコンパクションの保持率を 0.82 から 0.92 に上げたか
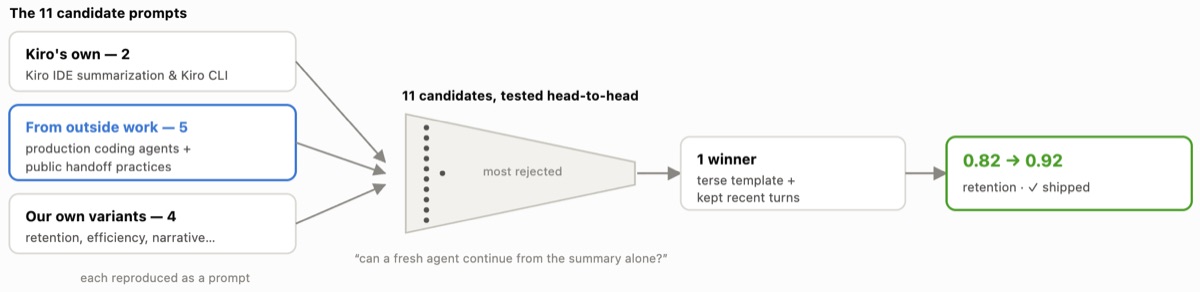
ここまでの修正は小さく、それぞれ独立したものでした。コンパクションは、ループが 1 つの問題に診断からリリースまで取り組む様子がわかるので、最初から最後まで順を追って見ていく価値があります。コンパクションとは、長い会話がコンテキストの上限に達したときに Kiro が会話を要約し、新しいインスタンスが作業を続けられるようにする仕組みです。次の図は、修正をどう選んだかを示しています。11 個の要約プロンプトの候補 (Kiro から 2 個、外部の取り組みから 5 個、私たち独自のもの 4 個) を、新しいエージェントが要約だけから作業を続けられるかという観点で総当たりで比較しました。
診断する
コンパクションの後、Kiro が現在のタスクを放棄して、ずっと前のタスクを自信満々に再開してしまうことがありました。以前の設計では、過去のユーザーメッセージを新しい順に並べた生のダンプをすべての要約の末尾に付け加えていました。そのため要約は最も古い質問で終わり、その直後に「上の要約から再開する」という合図が来ていました。きっかけとなったメッセージが「うん、それやって」のような短いものだった場合、そのメッセージのコンテキストは要約されて消えている一方で、古いスレッドは一字一句残っていたため、エージェントはその了承を別の依頼に結び付けてしまっていました。
計測する
kiro-trace は、実際にコンパクションが発生した社内の実際の会話から、最大約 150 万トークンまでの 4 つのサイズ帯でベンチマークを作りました。要約は、それをもとに誰かが作業を引き継げるかどうかで評価しました。各候補の要約だけを他に何も与えずに新しいモデルに渡し、作業を続けられたかを採点したのです。スコアは、要約が行動に移せる内容になっているか、ファイルパスが含まれているか、以前の決定事項が書かれているか、話の流れがつながっているかの 4 点を対象にしました。私たちはこのスコアを保持率 (retention) と呼んでいます。作業を続けるために必要なものがコンパクション後にどれだけ残っているかを、0 から 1 の尺度で表したものです。
外部の取り組みを参考にする
kiro-trace は、本番運用されているさまざまなエージェントや公開されている引き継ぎの手法がどのようにコンパクションしているかを読み、それぞれをプロンプトとして組み直しました。全部で 11 個になり、そのうち 5 個は私たち自身のコード以外から来たものです。中身は多岐にわたり、複数のセクションからなる長いテンプレートもあれば、簡潔な固定テンプレートもあり、状況・行動・結果の形で語るナラティブもあれば、いつコンパクションするかを決めるステップもありました。
レバーを見つけてリリースする
修正は、コンパクションをまたいで引き継ぐコンテキストを減らすことでした。以前の Kiro は要約に加えて古いユーザーメッセージの生のリストを残しており、エージェントを誤ったタスクに戻していたのはそのリストだったので、並べ替えるだけでは足りませんでした。外部のプロンプトからは比較対象とすべき設計の幅がわかりましたが、リストをなくすというアイデアは、失敗に対する私たち自身の診断から生まれたものです。修正ではそのリストを削除しました。現在のコンパクションは、簡潔な固定テンプレートで書かれサイズに上限のある短い要約と、直近のターンを残します。そして、どのタスクも名指ししない固定の再開の合図で終わります。1 つのセッションでは複数のタスクが進行中のことがあり、そのうち 1 つを推測することが誤った結び付けの原因だったからです。保持率は 0.82 から 0.92 に上がり、この修正はリリースされました。
ループはすべての候補について同じ記録を残します。診断した失敗、使った証拠と外部の手法、変更した 1 点、計測した結果です。どの部分もタスクの答えそのものには触れません。
ループ自体をどう改善し続けているか
kiro-trace は Kiro と並行して、ループ自体も改善し続けています。最初は私たち自身のこれまでの研究とコードから引き出したチェックから始まり、その後は失敗から育ってきました。新しいチェックはどれも、ループかチームが一度何らかの具体的な形でだまされたことがあるから存在しており、その多くは Kiro のバグではなく、私たちの計測方法の誤りでした。
あるケースでは、正しい修正の出力が採点器に届いていなかったため、0/5 と採点されました。別のケースでは、タスクのセットアップがエージェントに自分の誤りを元に戻す手段を与えており、それが本物のバグを隠していました。また、古いチェックアウトのせいで、前日に上流で修正済みだったものに対してプルリクエストを出してしまったこともあります。こうした一つひとつが、ループのコードのチェックになりました。
確認済みの修正はそれぞれ、その実行に関する決定的なアサーションを恒久的な退行テストスイートにも追加します。そのため、一度直した失敗が検出されずに再発することはありません。現在、これらのチェックは 1 つのチームから生まれたものです。次のステップは、Amazon がすでに対価を払って得た教訓である、解決済みのインシデントやチケットをもとにチェックを作ることです。そうすることで、お客様はより信頼性の高いエージェントと、より良い開発者体験を得られます。
まとめ
kiro-trace は、Kiro 自身の実行の中から問題を見つけ、変更を 1 つずつ提案し、決定的なチェックとその後の人のレビュアーが受け入れた場合にだけ変更を残します。1 週間で 7 件の修正がマージされ、コンパクションの取り組みでは保持率が 0.82 から 0.92 に上がりました。
得られた教訓
- 提案する者と判定する者を分けること。受け入れと却下は、モデルの手が届かないコードに置きます。
- 差分で判定し、毎回対照群を再実行すること。新しいモデルだけでもスコアは動くからです。
- 「有意な害がない」ことは害がないことと同じではなく、小さな害は変更を重ねるうちにすぐに積み重なります。マージンに照らして検定します。
- 確認済みの修正はすべて、失敗したメカニズムに対する恒久的な退行チェックにすること。そうすれば、その 1 つの結果だけでなく、より広い範囲をカバーできます。
- 追加する前に削除を試すこと。最も安全な改善は削除であることが多く、モデルが良くなるほどその傾向は強まります。
Kiro のユーザーにとっては、無駄な呼び出しが減り、委任がより慎重になり、長い会話の中で Kiro が自分のしていたことをよりよく把握できるようになるということです。kiro-trace による変更は、それを退けるために作られたチェックを備えたゲートを通過し、その後に人のコードレビューを経るまで、ユーザーに届くことはありません。私たちはエージェントの実験を、まず何を退けたかで評価します。ほとんどの候補はゲートを通過できず、通過したものこそが開発者体験を意味のある形で改善できる変更です。
Kiro は今すぐお試しいただけます。
この記事は Kiro ブログの How Kiro fixes itself, and how we keep the fixes honest を翻訳したものです。