Amazon Web Services ブログ
AI エージェントに書き込みを任せるとき、境界をどこに置くか ― Kiro CLI で仕組みを作り、1 か月運用した記録
本記事は、合同会社 BrightFlow 代表社員の池田 健人様による寄稿記事です。
はじめに
みなさん、こんにちは。合同会社 BrightFlow 代表の池田です。AWS Community Builder(DevTools 領域)として、2021 年から活動しています。
BrightFlow は、外部 CTO や技術顧問として企業の開発を支援しながら、自社プロダクトの開発にも取り組んでいます。プロダクト開発では、AI を全面的に活用しているだけでなく、開発の進め方そのものも実験的に試しています。開発の過程で得られた知見を、このように記事として発信することも、その試みの一つです。
AI エージェントにコードを書かせ、プルリクエスト(PR)を作らせることは、もう特別なことではありません。任せる範囲が広がるほど、問われるのはモデルの性能よりも「境界」です。
- 誰がタスクを決め、誰が書き込みを要求でき、誰が実際に書き込むのか
- エージェントが「完了しました」「テストが通りました」と言ったとき、何をもって事実とみなすのか
- 何をレビューし、何をマージしたのかを、後から確かめられるか
AI エージェント同士を組み合わせること自体は、いまではさまざまな方法で実現できます。2 つのコーディングエージェントを対話させる方法もあれば、Kiro のように公式の機能で複数のエージェントを段階的に動かす方法もあります。本記事が扱うのは、組み合わせ方そのものではありません。組み合わせた AI に書き込みを任せるとき、誰が権限を持ち、どこまで変更してよく、何を条件にマージするのか、という境界の置き方です。
私は、自社プロダクトの開発のために、Kiro CLI を実装役とする仕組み(以下 BRIDGE)を作り、約 1 か月運用しました。本記事では、BRIDGE を作ったきっかけ、その構成と 4 つの境界、運用で分かったことを紹介し、最後に 2026 年 10 月時点の Kiro の標準機能と比較します。
注: 本記事で紹介する構成は私の環境のもので、AWS が推奨する構成ではありません。利用条件については記事末尾を参照してください。
1. なぜ BRIDGE を作ったのか
BRIDGE を作り始めたのは 2026 年 8 月末です。この時点で、クラウドで自律的に作業する Kiro Web(2026 年 5 月 7 日にプレビュー公開)と、セルフホストで常駐させる Kiro Crew(2026 年 8 月 4 日に公開)は、すでに公開されていました。公式機能では技術的に不可能だったから自作した、というわけではありません。
自作を選んだのは、次の 3 つの使い方を先に決めていたためです。
- 異なる 2 つの AI の長所を組み合わせて、チームとして動かしたい。 人間の開発チームが設計担当と実装担当で役割を分けるように、計画とレビューを担う AI と、実装を担う Kiro を組み合わせたいと考えました。簡易的なオーケストレーションです。計画役の AI には、その AI に追加したアプリやコネクタを通じて、ドキュメントやチケット、Web 上の情報など、リポジトリの外にある情報を集めてもらいます。それを踏まえて整理した依頼を、実装の得意な Kiro に渡す、という分担です。計画役の AI は、MCP に対応したものであれば差し替えられるようにし、特定の製品に縛られない形にしました。
- 人が見るべきところは見続け、それ以外は任せて効率化したい。 方針の判断や、AI が迷って止まった場面には人が関わり、それ以外の定型的な流れは、AI のレビューを経てマージまで進める運用を想定しました。
- 想定どおりの変更はそのまま進め、想定外の変更が起きたら止めたい。 変更するファイルが依頼の内容から明らかな作業は、確認を待たずに進めて構わないと考えました。一方で、想定していないファイルにまで変更が及んだときは、自動で進めずに止めて確認したいと考えました。
1 つ目の使い方は、境界が必要になる理由そのものでもあります。計画役の AI が外部のアプリから集めた情報は、私が中身を管理できない入力です。その情報をもとに書かれた依頼で Kiro が動く以上、依頼の内容に関わらず、書き込める範囲とマージの条件をシステムで決めておく必要がありました。
2 つのエージェントを手元で対話させるだけであれば、仕組みを作る必要はありません。ただしその場合、両方のエージェントが同じ環境で、同じ資格情報を使うことがほとんどです。私が必要としたのは、計画役の AI には書き込みの資格情報を渡さず、書き込みの経路と条件を、システムで決めておく仕組みでした。本記事では実装役に Kiro を使いましたが、この考え方は、組み合わせるエージェントが何であっても変わりません。
2. BRIDGE の構成と、4 つの境界
全体の構成
BRIDGE は、チャット側の AI から接続する MCP(Model Context Protocol)サーバーと、その背後で実装を担当するコントローラーで構成しています。
チャット側は、MCP のリモートサーバーに接続できるクライアントであれば、原理的には何でも構いません。ChatGPT のカスタム MCP アプリや Claude のカスタムコネクタなど、選択肢は複数あります。私が実際に使ったのは ChatGPT で、本記事の数値や障害事例はすべて ChatGPT から利用したときのものです。
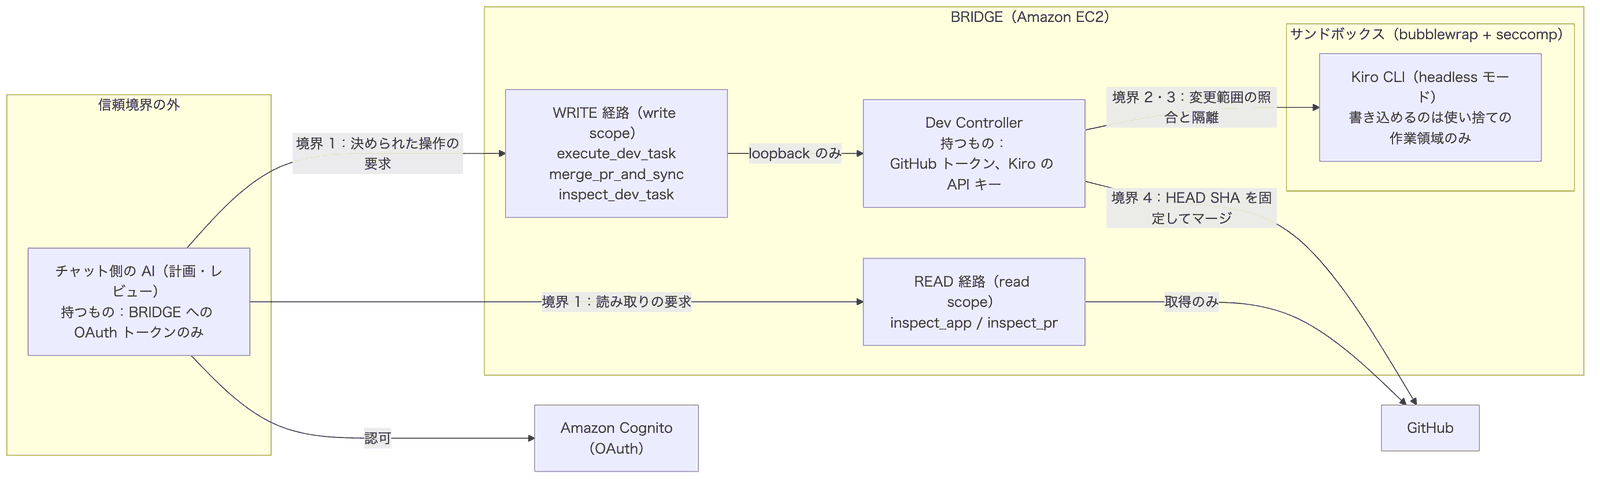
Kiro との接続は 2 通りです。READ 経路では、Agent Client Protocol(ACP)で Kiro のセッションを開き、リポジトリの設定ファイル(Steering)を読み取らせるだけです。WRITE 経路では、Kiro CLI を headless モードで実行し、出力を stream-json 形式で受け取ります。BRIDGE では、Kiro CLI 2.21 系(V2 エンジン)を使っています。
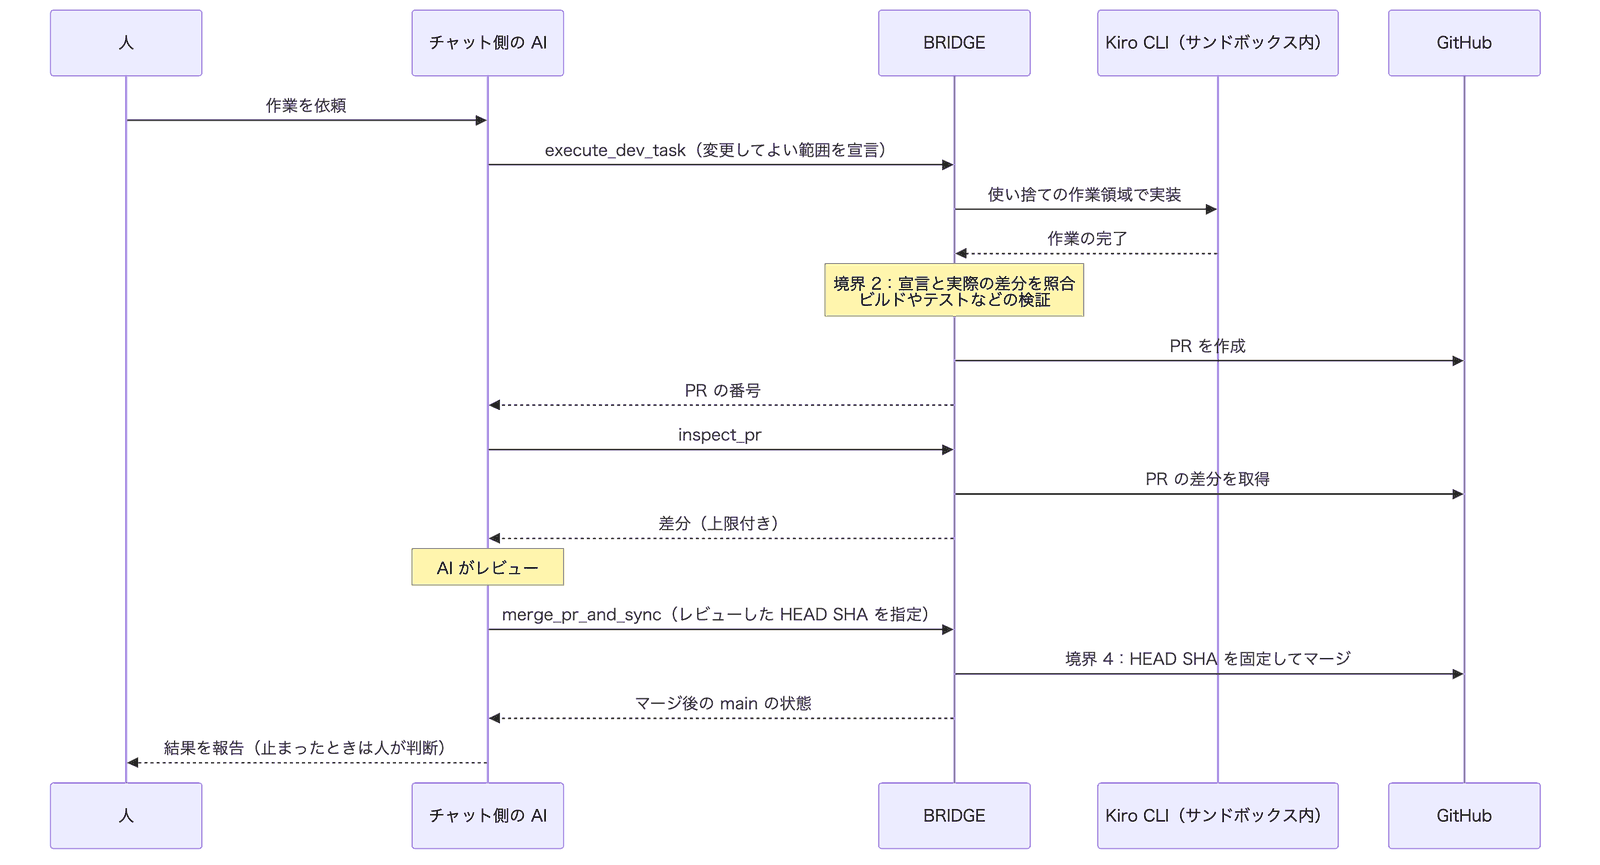
依頼からマージまでの流れは、次のとおりです。
人がどこで関与していたか
- 作業の開始と判断: 作業は私がチャットで依頼して始めていました。その後は AI がツールを続けて呼び、AI が止まったときや判断が必要な場面で、私が指示を出します。
- 書き込みの実行: チャットの実行確認は、「常に許可」に設定していました。何でも任せるために確認を外したわけではありません。後で説明する境界をシステムに作り込んでいたので、確認を外しても、AI が要求できることは変わらないからです。書き込めるのは依頼ごとに宣言した範囲だけで、実行はサンドボックスの中に限られ、マージできるのは指定した HEAD の PR だけです。操作のたびに人が判断する代わりに、システムで境界を強制することで、AI に任せる自由度と安全性のバランスを取りました。その一方で、変更の中身が正しいかどうかは、AI のレビューと検証に任せていました。この部分は、第 3 章の教訓 4 で振り返ります。
- 利用した機能: チャット側はクライアントが提供しているカスタム MCP の接続機能を、Kiro 側は公式の Kiro CLI を使っています。
境界 1: 資格情報を渡さず、要求できる操作を固定する
エージェントに書き込みを任せるとき、最初に決めるべきなのは「書き込みの資格情報を誰が持つか」です。GitHub のトークンやクラウドの認証情報をエージェント自身が持つと、指示の解釈次第で、どこにでも書き込めてしまいます。ただし、資格情報を持たないことは、書き込みができないことと同じではありません。要求できる操作の種類と引数まで固定して、初めて境界になります。
BRIDGE では、チャット側の AI は、GitHub のトークンも Kiro の API キーも持ちません。持っているのは、5 つのツールを呼ぶ手段だけです。
| ツール | 経路 | 役割 |
|---|---|---|
inspect_app |
READ | リポジトリの状態の確認 |
inspect_pr |
READ | PR のメタデータと差分の取得 |
execute_dev_task |
WRITE | 開発タスクを Kiro に委譲し、検証を通過したら PR を作成 |
merge_pr_and_sync |
WRITE | 指定した HEAD SHA と一致する場合だけマージし、同期 |
inspect_dev_task |
WRITE | タスクの実行状態を確認 |
書き込み先のリポジトリ、base のブランチ、マージの方法はサーバー側で固定し、チャット側からは指定できません。
READ と WRITE は、URL、OAuth の scope、チャット側の接続設定(READ 用と WRITE 用で別のアプリ)の 3 つのレベルで分けました。URL には、READ と WRITE で別々の秘密値を含めています。ただし、この秘密値は認証の代わりではありません。ツールの実行には、常に OAuth の認証が必要です。URL の秘密値は、それ以外のパスへのリクエストをすべて 404 にして、外部から見える範囲を狭めるための補助です。URL に秘密値が含まれるので、アクセスログも記録していません。
境界 2: 変更してよい範囲を先に決め、終わった後に照合する
「このファイル以外は触らないでください」という指示は、守られることを期待するものであって、保証ではありません。変更してよい範囲を機械が読める形で先に決め、作業後の差分と照合する必要があります。
BRIDGE では、execute_dev_task を呼ぶとき、チャット側の AI に、指示文と一緒に、どのファイルを作成・変更・削除してよいかを宣言させます。
{
  "taskId": "example-task-001",
  "baseCommit": "<40桁のコミットSHA>",
  "instruction": "…",
  "verifierProfile": "test",
  "changePolicy": {
    "allowedChanges": [
      { "path": "app/src/example.ts", "type": "modify" },
      { "path": "app/src/example.test.ts", "type": "create" }
    ]
  }
}
Kiro の実行後、Dev Controller は作業領域の差分を実際に観測し、宣言にない変更が一つでもあればタスクを失敗とします。想定どおりの変更はそのまま次に進み、想定外の変更が起きたときだけ止まる、という第 1 章の使い方を、この照合で実現しています。
境界 3: 書き込みを止めるのは、エージェントの申告ではなく実行環境
エージェントは、自分が何をしたかを出力します。しかし、その出力を見て書き込みを判定すると、出力形式の変化や想定外の操作に対して判定が漏れます。出力は後から確かめるための記録として扱い、書き込みの上限は実行環境(サンドボックス)で決めます。
BRIDGE では、Kiro CLI のプロセス全体を、Linux の bubblewrap と seccomp によるサンドボックスの中で動かしています。そのため、シェルコマンドだけでなく、Kiro の組み込みのファイルツールによる書き込みも、OS のレベルで使い捨ての作業領域に限定されます。サンドボックスを用意できない環境では、Kiro を起動しません。Kiro に事前許可するツールは read、grep、glob、write だけで、シェルの実行は許可していません(いずれも Kiro CLI 2.x 系のツール名で、V3 では read_file や grep_search などに名前が変わっています)。stream-json の出力は記録しますが、書き込みの判定には使いません。
なお、BRIDGE で使っていた Kiro CLI(2.21 系)には、後述する Kiro のローカルコマンドサンドボックスはまだありませんでした。
境界 4: 何をレビューし、何をマージしたかを固定する
PR はレビューの後でも更新されます。マージするときには、少なくとも「レビューした PR の HEAD」と「マージする PR の HEAD」が同じであることを確かめる必要があります。さらに、マージ先のブランチが進んでいれば、マージ後の状態はレビュー時と変わります。
BRIDGE では、マージの要求で、チャット側が指定できるのは PR 番号と、レビューしたときの HEAD SHA(expectedHeadSha)だけです。Dev Controller は PR を取得し直し、BRIDGE が作成した PR であること、draft でないこと、GitHub が競合なしと判定していることを確認したうえで、GitHub のマージ API に sha として expectedHeadSha を渡します。HEAD が動いていれば、GitHub がマージを拒否します。GitHub 上の承認を使わず、AI のレビュー結果に基づいてマージするため、branch protection の承認に関する設定の代わりに、HEAD SHA の一致を BRIDGE 自身で確認しています。
マージの後はサーバー上のリポジトリを同期し、main の最新 SHA とマージコミットの到達可能性を返します。「マージは成功したが同期に失敗した」状態は、「マージされていない」と区別して返します。呼び出し側の AI が誤解して、同じ操作を繰り返さないためです。
マージと同期を一つの手順にまとめたのは、運用を始めた直後の出来事がきっかけです。GitHub 上で PR をマージした後、サーバー上のリポジトリが古いままになり、次のタスクが古いコミットを基準に作業を始めてしまいました。このタスクは、PR を作る段階で基準のずれが検出されて止まりました。この経験から、マージと同期を分けずに、一つの手順として扱うようにしました。
規模
BRIDGE は約 49,000 行の TypeScript になりました(約半分がテスト)。書き込みの各段階(作業領域の作成、サンドボックスでの実行、変更範囲の照合、成果物の固定、検証、PR 作成)で、前の段階の結果を信用せずに独立して確認する設計にしたためです。
3. 1 か月運用して分かったこと
この章では、まず作成された PR の集計結果を示し、そこから得た教訓と、運用中に実際に発生した障害を紹介します。
3.1 PR の集計結果
BRIDGE を使って開発した、自社プロダクトのリポジトリの PR を、運用を始めてから約 1 か月分集計しました。
| 状態 | 件数 |
|---|---|
| マージ | 317(約 51%) |
| クローズ(未マージ) | 159(約 25%) |
| Open | 148(約 24%) |
約半数がマージされていません。未マージの 307 件を一件ずつ調べると、その多くは「レビューで不採用になった PR」ではありませんでした。
| 未マージの理由 | 件数 |
|---|---|
| PR 全体に差分が無い | 122 |
| 疎通確認用の PR | 9 |
| マージ済みの PR と内容が同一 | 2 |
| 同じ作業の後続の PR がマージ済み(※1) | 37 |
| 集計時点の main と競合する | 81 |
| 集計時点の main に適用できるが、未マージ(※2) | 56 |
| 合計 | 307 |
集計期間:2026 年 9 月 11 日〜10 月 12 日(2026 年 10 月 12 日時点の状態)。上の行から順に判定し、最初に当てはまった理由で数えています。
※1 PR の名前から判定した推定を含みます。
※2 うち約 20 件は、調査結果をファイルに書き出しただけと見られる PR です(ファイル名からの推定)。
差分が無い、疎通確認用、内容が同一、後続がマージ済みの PR を合わせると 170 件で、未マージの半数以上は、もともとマージする必要の無い PR でした。
BRIDGE の PR は、作成時の base を親とする 1 コミットで構成されます。差分の有無は、このコミットと base の tree の比較と、GitHub が返す PR 単位の変更ファイル数の両方で確認しました。
3.2 運用から得た教訓
集計結果から得た 4 つの教訓と、それぞれの解決方法を紹介します。
教訓 1: 書き込みの経路しかない作業は、書き込みの経路で行われる
READ 経路の inspect_app が返せるのは、リポジトリの状態と設定ファイルの確認結果だけでした。コードを読んで質問に答える経路はありません。そのため、チャット側の AI は照合・監査・確認のようなタスクにも execute_dev_task を使いました。Kiro が何も変更せずに終わると、変更の無い PR ができます。調査結果をテキストファイルとしてリポジトリに書き出す PR も作られました。
この間も、境界そのものは破られていません。調査のためのタスクも、宣言した変更範囲とサンドボックスの中で実行され、許可していない書き込みは起きていません。問題は、読み取りの経路が足りなかったために、本来は書き込み用の経路が調査にも使われ、変更の無い PR や調査結果だけの PR が増えたことでした。
書き込みを厳しく絞るほど、読み取りの経路を広く用意しないと、書き込みの経路が調査に使われます。
解決方法: 調査や確認を、読み取りだけで完結する経路に分けることで解決できます。Kiro であれば、ソースを変更せずに調査してレポートを返す Workflows の investigate や、書き込みを許可しない Permissions の設定が、この役割を担えます。調査の結果はリポジトリに書き出さず、レポートとして受け取る形にするのがポイントです。
教訓 2: PR の作成を完了の条件にすると、PR が入出力のチャネルになる
BRIDGE は、変更が無い場合でも PR を作成していました。PR がタスクの完了通知を兼ねていたためです。変更の無いタスクでは、PR を作らずに結果だけを返すべきでした。
解決方法: PR を作る条件に「差分があること」を加え、差分が無いタスクでは結果だけを返す形にすれば、変更の無い PR は生まれません。あわせて、差分が無い PR、内容が重複する PR、main と競合したまま残っている PR を定期的に検出する仕組みがあると、PR の滞留も防げます。
記事の執筆後、集計期間に作られた未マージの PR を整理しました。PR をまとめてクローズする操作は、取り消しにくい操作です。そこで、整理の方針と実行するコマンドは AI に作らせ、私が内容を確認してから実行しました。PR は番号や古さだけで閉じず、同じ作業の後続の PR との比較や、現在の main との差分の確認を経てから閉じています。その過程で見つかった、まだ必要な小さな変更 3 件は、BRIDGE で現在の main に合わせて作り直して取り込みました。集計期間の未マージの PR は、すべて整理済みです。
教訓 3: 秘密を守るための最小ログは、境界の効果を測れなくする
Dev Controller は、パス・ファイル内容・トークンを漏らさないように、ログには固定の文字列しか出さない設計でした。タスクの結果(宣言外の変更による失敗、SHA の不一致によるマージ拒否など)はチャット側への応答として返すだけで、サーバー側には記録していません。
その結果、境界 2 と境界 4 が実際に何回処理を止めたかを、後から数えられませんでした。秘密を含まない結果の種類と件数だけは、最初から記録すべきでした。
解決方法: パスやファイルの内容は記録せず、結果の種類(成功、宣言外の変更、SHA の不一致など)とその件数だけを記録すれば、秘密を漏らさずに境界の効果を数えられます。この 2 つは両立できます。
教訓 4: AI のレビューを自動化したら、レビューの範囲と記録を設計する
マージされた PR の、作成からマージまでの時間の中央値は 32 秒でした。約半数は作成から 30 秒以内に、8 割以上は 10 分以内にマージされています。GitHub 上の Review は 0 件で、レビューの判断はチャットの会話の中にだけ残っています。書き込み系ツールの実行確認を「常に許可」にしていたため、マージの多くは、私の都度の承認を経ずに、AI のレビュー結果だけで実行されていました。私が個々の PR の差分をどこまで自分で読んだかは記録していないため、集計できません。数十秒でマージに至った PR は、AI のレビュー結果に依拠していたと考えるのが自然です。
さらに、レビューの入力にも上限がありました。inspect_pr が返す差分は、1 ファイルあたり 8KiB、最大 50 ファイル、全体で 128KiB までで、それを超えると切り詰めを示すフラグが付きます。AI が全変更を見ていなかった可能性があります。
境界 4 の実装にも、運用してみて分かった限界がありました。マージ済み PR の 9 割以上は、作成時と同じ main にマージされていました。この場合、マージ後の main の中身は、BRIDGE が PR を作る前に検証した状態と同じになります。一方、約 6%(19 件)は、レビューの後に main が進んだ状態でマージされていました。この 19 件について、PR が変更したファイルと、レビューの後に main で変更されたファイルを比べたところ、重なっているものはありませんでした。その後に変更を取り消した記録もありません。それでも、この 19 件のマージ後の状態は、検証されないまま main に入っています。マージの前に、最新の main と合わせた状態で検証し直すべきでした。
解決方法: 次の 3 つをマージの条件に加えることで、この限界を補えます。
- 最新の main と合わせた状態で、CI のビルドとテストが通っていること
- レビューに使った差分が切り詰められていないこと
- レビューの判断と根拠が、PR など後から参照できる場所に残っていること
人がマージを承認する運用に切り替える場合は、GitHub の branch protection(第 4 章)で、最初の条件を満たせます。
3.3 実際に発生した障害
運用中に発生した障害のうち、外部の AI クライアントと MCP サーバーをつなぐ構成で共通して起こり得る 2 つを紹介します。
障害事例 1: OAuth の認証開始とツール一覧の取得が、互いを待っていた
この事例は ChatGPT のカスタム MCP アプリで起きたものですが、OAuth で保護した MCP サーバーを外部のクライアントにつなぐ場合に共通する論点を含んでいます。
ChatGPT のカスタム MCP アプリを作成すると、ツールが 0 件のままで、OAuth のアカウント連携が始まりませんでした。
原因は 2 つ重なっていました。1 つは、ツールごとの認証の宣言が、ChatGPT に届いていなかったことです。ChatGPT は、ツール一覧(tools/list)に含まれる各ツールの securitySchemes を見て、どの認証が必要かを判断します。使用していた MCP の公式 TypeScript SDK(@modelcontextprotocol/server 2.0.0)は、ツール定義の未知のキーを取り除くため、securitySchemes を直接書いても応答に含まれませんでした。もう 1 つは、BRIDGE が、認証済みでなければ tools/list を返さない設計だったことです。ChatGPT はツール一覧を見てから認証を始め、BRIDGE は認証が済むまでツール一覧を返さない。互いに相手を待つ状態でした。
対応は次のとおりです。
securitySchemesを、SDK に取り除かれない_metaの中に宣言したうえで、tools/listの応答を返す直前に、その値を各ツールの直下のsecuritySchemesに写す処理を加えました。この処理はtools/listの応答の形だけを変え、ツールの実行や認証の判定には触れません。WRITE 経路は、ツール一覧の応答を自前で組み立てているため、最初から直下に置いています。READ のツールは read scope だけ、WRITE のツールは write scope だけを要求します。- 認証なしで許可するのを、
initialize、notifications/initialized、tools/listの 3 つだけにしました。不正なトークンや、scope が違うトークンを持つリクエストは、匿名扱いに格下げせず拒否します。 - 未認証の
tools/callには、_meta["mcp/www_authenticate"]を含むツールエラーを返し、ChatGPT が認証を始められるようにしました。
本番で、initialize と tools/list が成功し、READ のツール一覧に READ の 2 ツールだけが含まれること、未認証の tools/call が認証を促すエラーを返すことを確認しました。
残る制約として、ツールの名前と入力スキーマは、URL を知っている相手には認証なしで見えます。URL に含めた秘密値によって、見える相手を絞っていますが、これは見える範囲を狭める補助で、ツールの実行は引き続き OAuth の認証で守っています。
障害事例 2: 長時間かかるツールと、MCP クライアントの再試行が衝突した
READ 経路の inspect_app は、完了までに約 60 秒かかることがありました。外側の MCP クライアントは約 60 秒で同じリクエストを再試行し、再試行は実行中の元のリクエストとぶつかって「実行中」のエラーを受け取っていました。実装タスクの execute_dev_task でも、再試行のたびに新しいタスク ID が採番され、2 つ目のタスクとして「実行中」のエラーになる一方、元のタスクは実行を続けていました。
execute_dev_task は、実装から PR の作成までを 1 回の呼び出しで終える、同期のツールです。この問題に対しては、呼び出し方を非同期に作り直すのではなく、同期のまま、足りない部分を足す形で対応しました。
まず、再試行を拒否せず、実行中の処理に合流させて同じ結果を返すようにしました(single-flight)。同じ内容のリクエストかどうかは、自動で採番されるタスク ID ではなく、リクエストの内容で判定します。内容が異なるリクエストは、従来どおり「実行中」として拒否します。あわせて、実装の時間の上限を、120 秒から 600 秒まで段階的に延ばしました。本番では、約 1 分後に届いた再試行が、新しいタスクを始めずに実行中の処理へ合流することを確認しています。
それでも、チャット側で応答を待ちきれずにタイムアウトすると、実行が続いているのか終わったのかを確かめる手段がありませんでした。そこで、タスク ID を指定して状態(実行中/完了)を確認できる inspect_dev_task を追加しました。これにより、タイムアウトの後でも、同じ依頼を再実行せずに結果を確認できるようになりました。
結果として、通常は同期で結果を受け取り、応答が途切れたときだけ状態を確認する、という構成になっています。振り返ると、1 回の呼び出しで PR の作成まで完結し、状態の確認を繰り返さずに済む点は、同期の利点でした。一方で、長時間の処理を同期で公開する限り、クライアント側のタイムアウトとの関係は残ります。これから作るのであれば、実行の開始だけを返し、状態は別のツールで確認する非同期の形も、最初から選択肢に入れておくとよいと思います。
4. Kiro の標準機能との比較
BRIDGE を作り始めた 2026 年 8 月末から、この記事を書いている 2026 年 10 月までの約 2 か月の間にも、Kiro には機能が追加されています。たとえば、各ステップを独立したエージェントのセッションで動かす Workflows は、2026 年 9 月 30 日に、Kiro CLI(2.26.0)と Kiro Web で提供が始まりました。
この章では、2026 年 10 月時点の Kiro の標準機能で、BRIDGE の 4 つの境界と運用の教訓がどこまで実現できるかを整理します。いずれも公式ドキュメントで確認できた範囲の内容です。
4 つの境界と Kiro の機能
境界 1(資格情報を渡さず、要求できる操作を固定する): Permissions で、エージェントが使える操作(ファイルの読み書き、シェル、MCP など)ごとに、許可・確認・拒否を設定できます。拒否が常に優先され、エージェントの設定にも埋め込めます。レビュー役のエージェントには書き込みを与えない、といった役割ごとの設定ができます。
境界 2(変更してよい範囲を先に決め、終わった後に照合する): 事前に絞る部分は、Permissions で実現できます。fs_write に書き込みを許可するパスを glob で指定でき、headless モードでは確認が必要な操作はすべて拒否として扱われるため、明示的に許可した範囲の外には書き込めません。終わった後の照合は、利用者が自分で組み込みます。エージェントが作業を終えたときにコマンドを実行できる Hooks や、PR の変更ファイルを確認する CI などを使い、許可した範囲と実際の差分を比べる処理を加えます。BRIDGE では、この照合を、依頼ごとの宣言と作成・変更・削除の区別まで含めて、自前で実装しています。
境界 3(書き込みを止めるのは、実行環境): Kiro CLI と Kiro IDE では、ローカルで実行するコマンドを隔離するローカルコマンドサンドボックスが使えます。Linux では bubblewrap、macOS では Seatbelt で動きます。対象は、エージェントが実行するシェルコマンドとその子プロセスです。エージェント本体と組み込みのファイルツールはサンドボックスの外にあり、ファイルの読み書きは Permissions で制御します。ファイルツールによる書き込みまで含めて OS のレベルで隔離したい場合は、BRIDGE のようにプロセスごと隔離する方法があります。また、Kiro Web はクラウドの隔離されたサンドボックスでエージェントを動かし、Kiro Crew は、OS レベルのサンドボックスと署名付きの監査ログを備えています。
境界 4(何をレビューし、何をマージしたかを固定する): Workflows には、PR を作成し、レビュー指摘に対応し、マージできる状態にして人に渡すレシピ(publish-pr)が用意されています。最終的なマージを人が行う運用であれば、GitHub の branch protection と組み合わせることで、レビューとマージの対象をそろえられます。
- レビューした HEAD とマージする HEAD をそろえる: 「Dismiss stale pull request approvals when new commits are pushed」で、承認の後に新しいコミットが追加されたら承認を取り消します。あわせて「Require approval of the most recent reviewable push」で、最後の更新を自分以外の人が承認することを必須にします。
- base の更新に対応する: 「Require branches to be up to date before merging」で、最新の base を取り込んだ状態で必須チェックが通るまで、マージできないようにします。マージが頻繁に重なるリポジトリでは、merge queue も使えます。
Kiro の中で役割を分けることもできます。Workflows では、各ステップが独立したセッションで動き、ステップ間は明示的な受け渡しでのみ結果を渡します。ステップごとにエージェントとモデルを指定できるので、設計・実装・レビューを別のモデルに担当させることもできます。
自作を選んだ理由は、いまも成り立つか
第 1 章で挙げた 3 つの理由を、2026 年 10 月時点の Kiro の標準機能と照らし合わせてみます。
| 自作を選んだ理由 | 2026 年 10 月時点の Kiro では | 自作の必要性 |
|---|---|---|
| 1. 異なる AI の長所を組み合わせて、チームとして動かしたい | Workflows で、計画・実装・レビューの各ステップに別のエージェントとモデルを割り当てられる。外部のツールや情報も、Kiro に MCP サーバーを追加すれば使える | 多くの場合は無い。Kiro 以外の AI を計画役にして、その AI にすでに整えているアプリやコネクタ、会話の文脈をそのまま活かしたい場合に必要 |
| 2. 人が見るべきところ以外は任せたい | Workflows の publish-pr は、PR をマージできる状態まで進め、最後のマージは人に渡す |
マージまで任せたい場合だけ必要。マージを人が承認する運用なら不要 |
| 3. 想定外の変更が起きたら止めたい | Permissions で、書き込めるパスをあらかじめ制限できる。終わった後の照合は、Hooks や CI で組み込める | 依頼ごとに範囲を宣言させ、作成・変更・削除を区別して照合したい場合に、その照合の処理が必要。多くの場合は、事前の制限と人による PR のレビューで足りる |
つまり、2026 年 10 月時点では、Kiro の中で完結させる使い方であれば、3 つの理由の多くは標準機能で満たせます。一方で、Kiro 以外の AI を計画役にする、マージまで任せる、照合を依頼ごとに細かく行う、といった使い方を選ぶ場合は、Kiro の外に仕組みを用意する必要があります。BRIDGE は、この 3 つの使い方をすべて選んだ場合の構成です。
Kiro で同じことを始めるなら
BRIDGE のような外部の仕組みを持たずに、同じような使い方を Kiro で始める場合は、まず Kiro の標準機能で組み立て、運用の教訓をもとに必要な部分を足していく形になります。
| 境界 | Kiro の機能で実現する部分 | 自分で足す部分(運用からの教訓) |
|---|---|---|
| 1. 資格情報を渡さず、操作を固定する | Permissions、Custom Agents(レビュー役に書き込みを与えない)、Workflows の investigate(読み取り専用の調査) |
調査や確認を、読み取りの経路だけで完結できるようにする |
| 2a. 変更範囲を先に決める | Permissions(fs_write のパス指定) |
— |
| 2b. 終わった後に照合する | 組み込み先として、Hooks の Stop トリガーを使える | 許可した範囲と差分を比べる処理。変更が無いタスクでは PR を作らない。不要になった PR を定期的に検出する |
| 3. 実行環境で書き込みを止める | ローカルコマンドサンドボックス、Kiro Web のサンドボックス、Kiro Crew | 境界が止めた結果の種類と件数を、秘密を含まない形で記録する |
| 4. レビューとマージの対象を固定する | Workflows の publish-pr と、GitHub の branch protection(承認の取り消し、最新の更新の承認、base への追従)、merge queue |
最新の main と合わせた状態で検証する。AI のレビューでマージまで進めるなら、レビューの入力が完全だったことと判断の記録を、マージの条件に加える |
Kiro 以外の AI を計画役にする場合は、これに加えて、その AI に資格情報を渡さず、要求できる操作と引数を固定し、READ と WRITE を分ける仕組みが必要になります。長時間の処理を公開する場合は、同期と非同期のどちらにするかも、最初に決めておくとよいと思います。
まとめ
AI エージェントを組み合わせること自体は、いまでは Kiro の標準機能で実現できます。難しいのは接続ではなく、どの判断を AI に任せ、どこをシステムで担保し、どの条件で次の工程に進めるかを決めることです。
BRIDGE での分担を整理すると、次のようになります。右の列は、BRIDGE のシステムで担保していることだけでは担保できず、教訓で挙げた解決方法や、人の確認で補う必要がある点です。
| AI に任せた判断 | システムで担保していること | それだけでは担保できないこと |
|---|---|---|
| どう実装するか | 変更が、宣言したファイルの範囲に収まっているか | 範囲内の変更が、正しく実装されているか |
| どんなテストが必要か | 使い捨ての環境で、ビルドとテストが通ったか | 最新の main と合わせた状態でも、ビルドとテストが通るか |
| レビューの結果 | マージする PR の HEAD が、レビューしたときの HEAD と同じか | レビューで差分をすべて見ていたか。レビューの後に main が進んでいないか |
| マージしてよいか | マージ後の main に、そのコミットが含まれているか | 人がその判断に同意していたか |
境界を設計するときは、境界そのものに加えて、「境界の外側で AI がどう振る舞うようになるか」と、「境界が働いたことを後から確かめられるか」まで考える必要があります。Kiro で同じことを始める場合も、この 2 点は確認しておく価値があると思います。
BrightFlow のプロダクトは、現在開発を進めています。リリースの際には、SNS などでお知らせしますので、そのときはぜひご覧ください。
利用条件について
本記事の構成は、各サービスが公式に提供している機能だけで組み立てています。Kiro 側は公式の Kiro CLI(headless モードと ACP)、チャット側はカスタム MCP の接続機能です。
AI エージェントを外部のツールと組み合わせる使い方については、各サービスの利用条件が更新されることがあります。同様の構成を試す場合は、Kiro、利用する AI チャット、GitHub それぞれの最新の利用条件を確認してください。