Amazon Web Services ブログ
Kiro の Auto がモデルカスケードで作業に合ったモデルを使い分ける仕組み
本記事は 2026 年 11 月 6 日に Kiro ブログで公開された「How Kiro Auto uses model cascading to match the model to the work」を翻訳したものです。
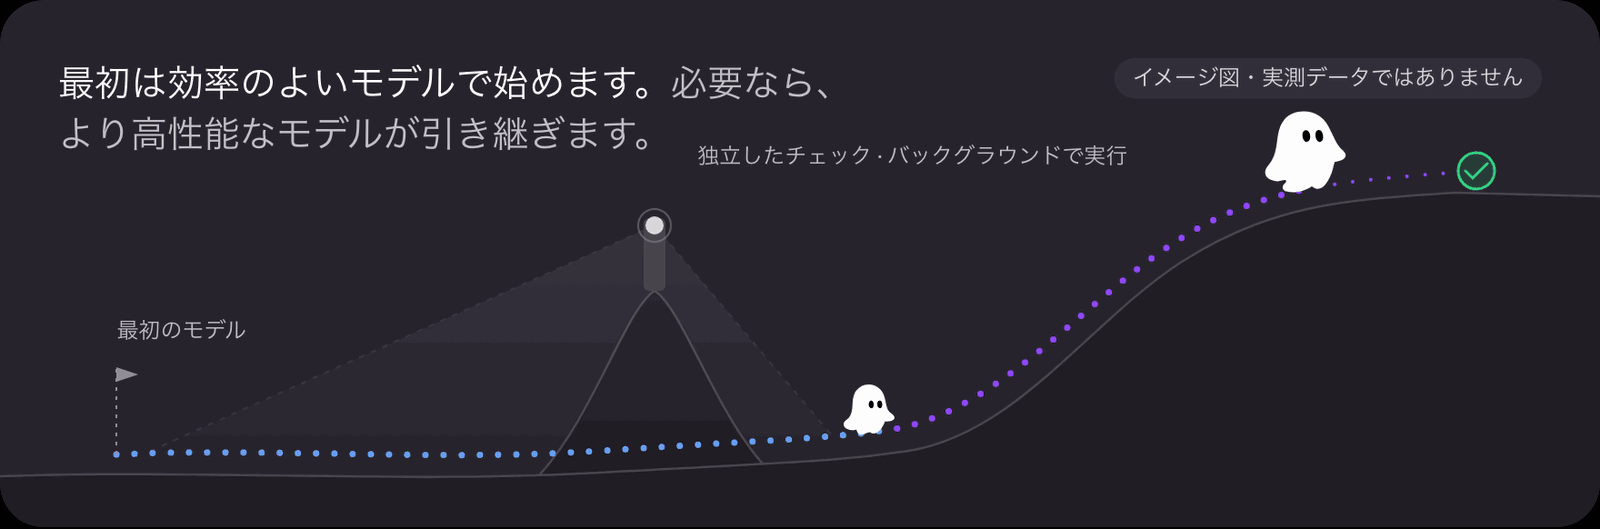
TL;DR:Auto は裏側でモデルカスケードを使っています。どのセッションも効率のよい最初のモデルで始まり、独立したチェックがバックグラウンドで作業を確かめ、必要になったときに Auto はセッションをより高性能なモデルに引き継ぎます。DeepSWE v1.1 を使った社内の評価では、カスケードは高性能なモデル単独とほぼ同じ成績を出し、タスクの約 5 件に 4 件は引き継ぎなしで完了しました。
Kiro では、ほとんどの方に Auto での作業をおすすめしています。モデルのドキュメントにあるとおり、Auto がユーザーに代わってモデルを選び、高い品質の基準を保ちます。有料プランでは、その基準は Claude Opus クラスの品質です。この記事では、Auto がその基準を満たすための方法の 1 つである、モデルカスケードという手法を紹介します。
難しさはセッションが進むにつれて見えてくる
Kiro に、不安定な日付パーサーの修正を頼んだとします。最初の手順は決まりきった作業です。ファイルを読み、関数を見つけ、不具合を再現する、失敗するテストを書きます。ところがそのテストで、ほかの 3 つのモジュールにまたがるタイムゾーンの前提が見つかり、小さな修正がリファクタリングに変わります。逆のことも起きます。大きく見えたタスクが、2 行の変更で済むこともあります。
モデルの性能が上がるにつれて、より大きな仕事を任せるようになり、Kiro のセッションは長くなっています。手順の多い長いセッションは、ファイルを読み、コードを編集し、テストを実行し、やり直すといった多くの手順を踏みます。その難しさは、始まった時点では決まっていません。セッションの難しさには形があり、その形は進めてみて初めて見えてきます。図 1 では、同じセッションを 3 通りのやり方で進めています。
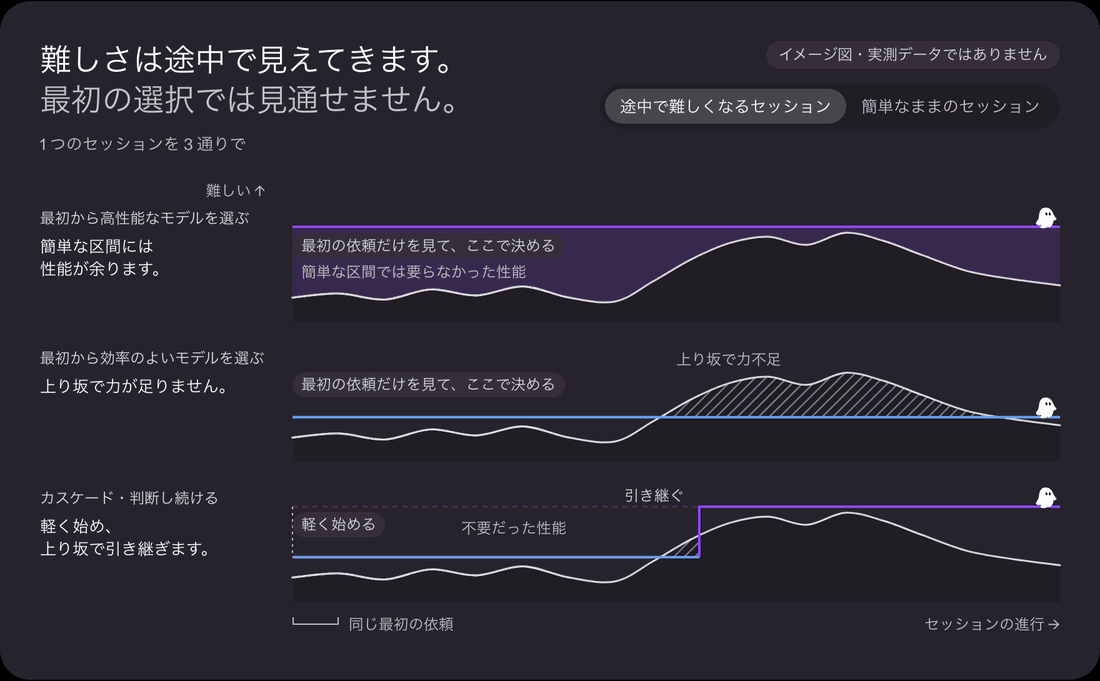
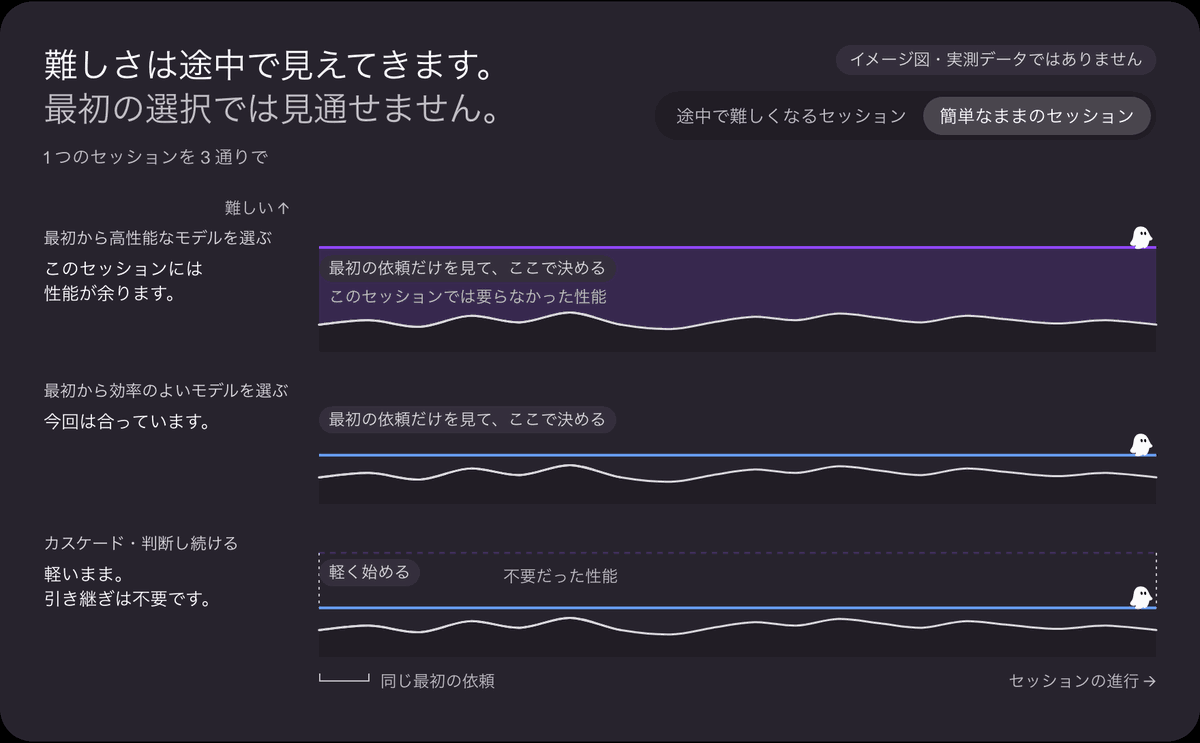
作業を始める前にモデルを選ぶとき、判断の手がかりは依頼の内容しかありません。高性能なモデルを選べば、効率のよいモデルでも同じようにこなせた決まりきった手順も含めて、すべての手順をそのモデルが担います。効率のよいモデルを選べば、決まりきった手順はうまくこなせますが、作業が難しくなると、行ったり来たりを始めたり、すでに終えた作業をやり直したりすることがあります。次に、図 1 の 2 枚目の、簡単なままのセッションを見てください。依頼が同じなので、最初に選ぶモデルは変わりません。カスケードは最後まで最初のモデルのままです。セッションが、そのモデルで扱える以上に難しくならないからです。
Auto のモデルカスケードのしくみ
モデルカスケードは、1 回のモデルの選択を、エージェントのセッション全体を通して行う一連の判断に変えます。
- 効率のよいモデルで始める。どのセッションも最初のモデルで始まります。最初のモデルは、日常的な幅広い作業をうまくこなす効率のよいモデルです。多くのセッションでは、このモデルが適切な選択で、作業のすべてをこなします。
- バックグラウンドで作業を確かめる。独立したモデルが、セッションの軌跡、つまりここまでに行われた作業を確かめます。チェックは非同期に動くので、セッションがチェックを待つことはありません。また、作業しているモデルが自分の進み具合を採点することもありません。
- そのまま続けるか、引き継ぐ。セッションが着実に進んでいるあいだは、何も変わりません。セッションが効率よく進まなくなった兆し(同じコードを繰り返し調べる、すでに終えた作業をやり直す、など)をチェックが見つけると、Auto はセッションをより高性能なモデルに引き継ぎます。引き継ぎではここまでの作業の要点が受け渡されるので、より高性能なモデルは最初からやり直すのではなく、今の状態のセッションをそのまま引き継ぎます。
- 必要に応じて繰り返す。引き継ぎは、セッションが最も高性能なモデルで動くようになるまで繰り返し起こりえます。現時点では、引き継ぎは上の方向にだけ行われます。セッションを効率のよいモデルへ戻すことは、今後のアップデートで検討します。
モデルへのアクセスを管理しているチームでは、引き継ぎ先も Auto が使えるモデルの中から選ばれるので、引き継ぎにも Auto と同じガバナンスの設定が適用されます。管理者がモデルへのアクセスをどう制御するかは、モデルのガバナンスをご覧ください。
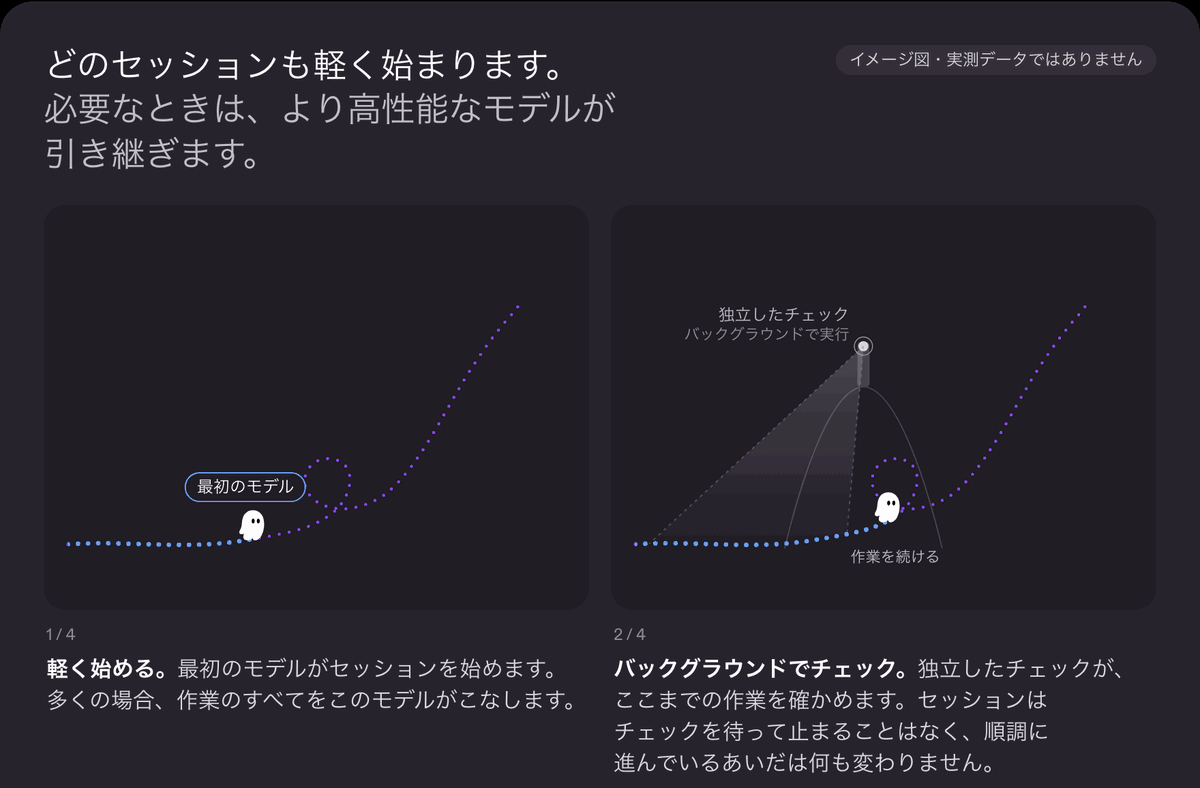
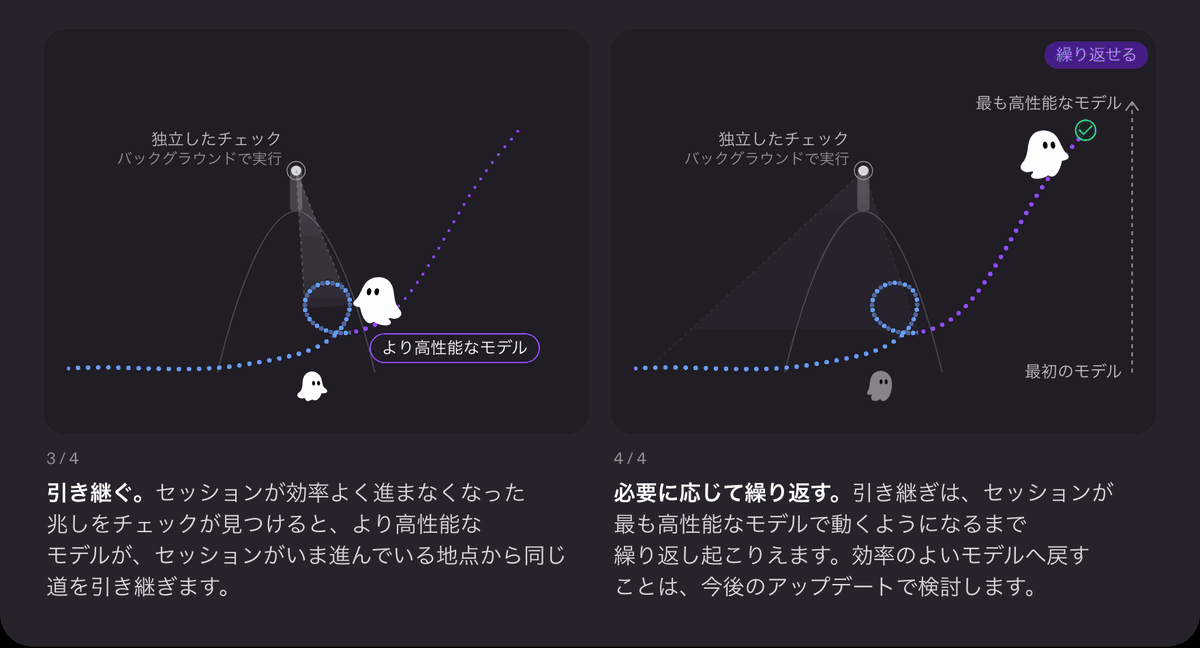
担当のエンジニアがチケットに取り組み、その肩越しにレビュアーが作業を見ている場面を考えてみてください。エンジニアは作業を続け、手を止めて自分の進み具合を採点することはありません。それはレビュアーの仕事です。作業が前に進んでいるあいだ、レビュアーは何も言いません。作業が同じところを回り始めたとレビュアーが気づいた時点で、チケットはより腕の立つエンジニアに渡り、そのエンジニアが今の状態から引き継ぎます。
カスケードを既定で動かしても安全なのは、このしくみがあるからです。作業しているモデルは自分の進み具合を採点せず、引き継ぎは最初からやり直すのではなく、すでに終えた作業の上に積み上げます。より高い性能が必要なセッションは途中でその性能を得られ、必要のないセッションは最初のモデルのまま進みます。
測定したこと
カスケードを、Datacurve による、手順の多い長いタスクを扱うソフトウェアエンジニアリングのベンチマークである DeepSWE v1.1 で評価しました。タスクはこのベンチマークのために新しく作られたもので、オープンソースのリポジトリを題材にし、人が書いた、動作を確かめるテストで採点されます。そのため、難しさが途中で変わりうる、何段階にもわたるセッションが必要になります。Kiro のエージェントエンジンで 3 つの構成を動かし、それぞれの構成でベンチマーク全体を 3 回ずつ、独立に実行しました。
- 最初のモデルのみ。すべてのタスクを、効率のよい最初のモデルで最初から最後まで実行します。
- 高性能なモデルのみ。すべてのタスクを、より高性能なモデルで最初から最後まで実行します。
- カスケード。すべてのタスクを最初のモデルで始め、より高性能なモデルへ引き継げる状態にしておきます。
3 つの構成とも、推論(reasoning)の設定は同じです。違いは、どのモデルが作業を担うかだけです。結果は pass@1(1 回の試行で解けたタスクの割合)を、3 回の実行の平均 ± 1 標準偏差で示します。
高性能なモデル単独とほぼ同じ品質
図 3 は 3 つの構成の pass@1 を比べたもので、その下の表に同じ値を載せています。
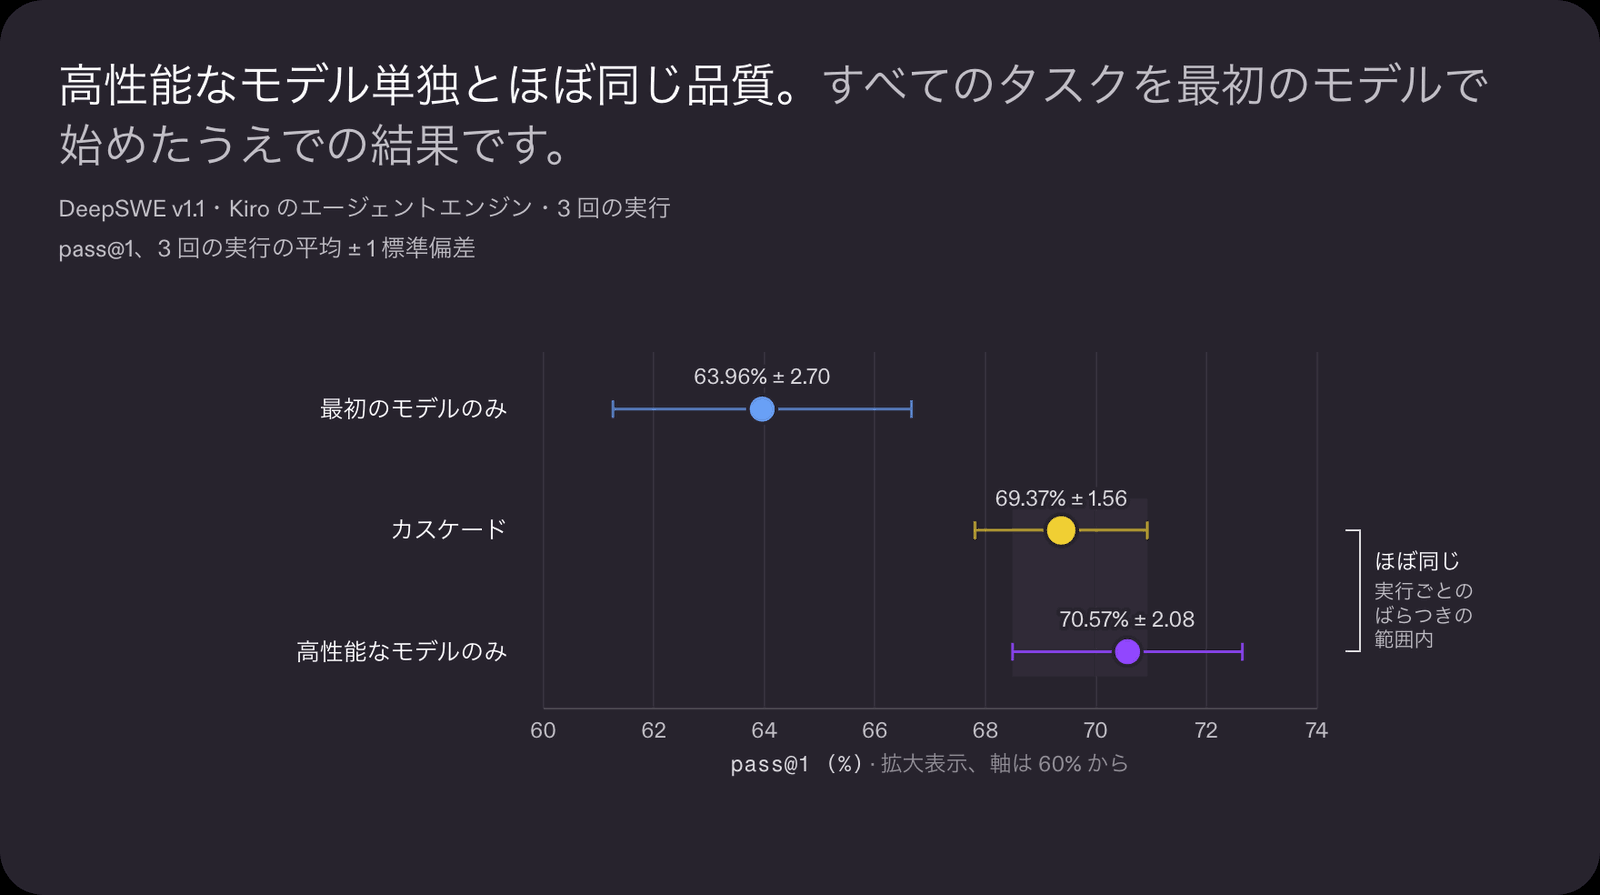
| 構成 | pass@1(3 回の実行の平均 ± 1 標準偏差) |
|---|---|
| 最初のモデルのみ | 63.96% ± 2.70 |
| 高性能なモデルのみ | 70.57% ± 2.08 |
| カスケード(最初のモデルで始め、より高性能なモデルを使える) | 69.37% ± 1.56 |
カスケードはタスクの 69.37% を解きました。高性能なモデル単独(70.57%)とほぼ同じで、その差は実行ごとのばらつきの範囲内です。また、最初のモデル単独(63.96%)より 5.40 ポイント高い値です。3 つの構成のうち、実行ごとのばらつきが最も小さかったのもカスケードでした。つまり、すべてのタスクを最初のモデルで始めても、それが品質の足かせにはなりませんでした。
約 5 件に 4 件は引き継ぎなしで完了
図 4 は、カスケードのタスクがどのモデルで終わったかを示しています。
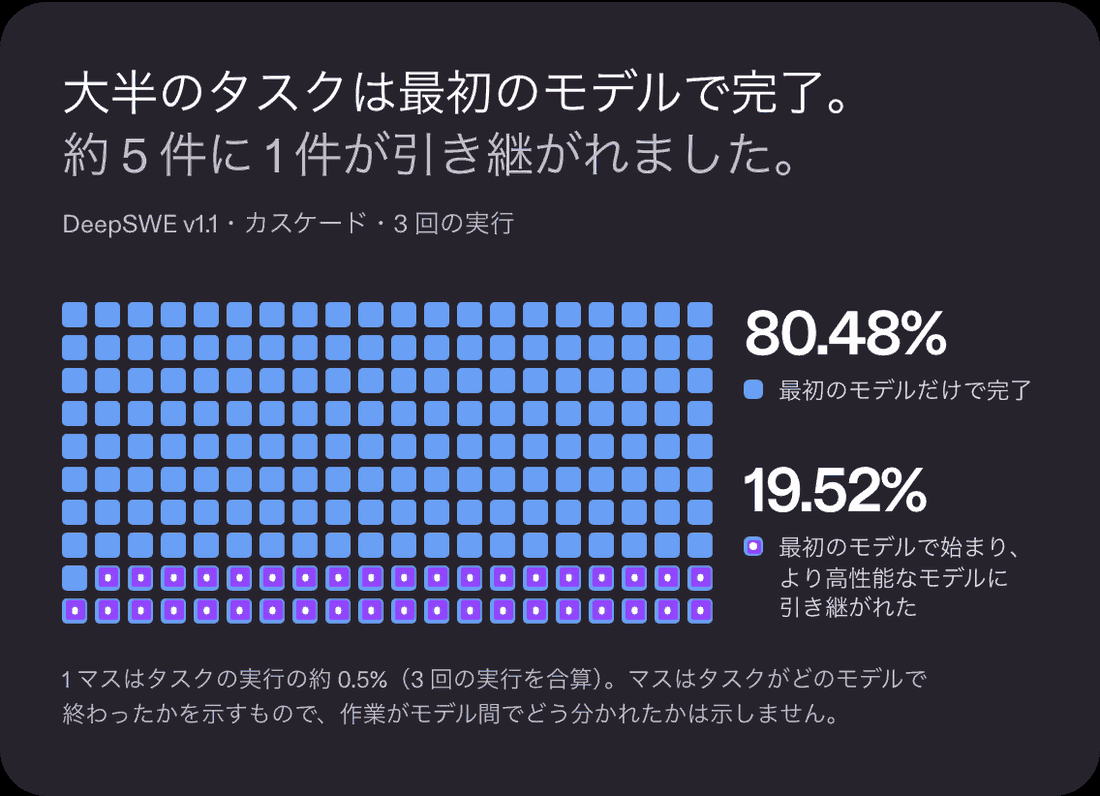
すべての実行を通して、タスクの 80.48% は最初のモデルで完了しました。残りの 19.52%、約 5 件に 1 件は、途中でより高性能なモデルに引き継がれました。
今回の DeepSWE の実行では、引き継がれたタスクには共通点がありました。最初から最後まで正しく仕上げるのが難しい変更だったことです。たとえば、型や API から CLI や設定まで、多くの層に同時に触れる機能や、保存された状態やキャッシュ、処理の順序に左右される振る舞いです。小さく局所的な変更で引き継ぎが必要になることはまれでしたが、大きな変更が必ず引き継ぎを必要としたわけでもありません。分かれ目になったのは、注意深い設計や、コードの複数の部分のあいだで整合性を保つことが、作業のどれだけを占めていたかでした。
引き継ぎが起きたタイミングにも、同じくらいはっきりした傾向がありました。これらのタスクでは、最初のモデルはほぼ必ず、序盤の手順を自力でこなしていました。コードを書き、多くの場合はビルドとテストを通すところまで進めています。引き継ぎは、そのあとの検証と統合の段階で起きる傾向がありました。最初のモデルが、変更したコード全体ですべての要件が満たされていることを示そうとしている段階で、セッションが効率よく進まなくなった兆しをチェックが見つけたのです。こうしたことは、どれも依頼の内容からは分かりませんでした。チェックが見守り続け、セッションが必要とするどの時点でも引き継ぎが起こりうるので、カスケードは作業がいつ難しくなるかを前もって知る必要がありません。
Auto がクレジット倍率 1x のまま複雑な作業を高い品質でこなせるのは、これが理由の 1 つです。ほとんどのセッションは最初のモデルで完了し、より高性能なモデルが引き継ぐのは作業上必要なときだけです。
ベンチマークの数値についての注意
これらの数値は、社内の評価用ベンチマークの、ある特定の実行で得られたものです。本番環境での見込みではなく、お客様ごとの実際のワークロードでの結果は異なります。
引き継ぎの割合はタスク全体の平均です。セッションがどれくらいの頻度で引き継がれるかは作業によるので、個々のセッションでは異なります。引き継ぎはユーザーには見えません。引き継ぎが起きていることを意識しなくても、品質の面での効果を得られます。
DeepSWE の数値は社内のベンチマーク用の実行環境(ハーネス)で測ったもので、公開されている DeepSWE のリーダーボードの公式の設定と同じではありません。そのため、割合を公開のリーダーボードの数値と比べることはできません。
試してみる
モデルカスケードは Auto のしくみの一部で、効率の面での利点はすべての Kiro のお客様が利用できます。次にセッションを始めるときは、Kiro で Auto を選んでください。Auto とモデルの選択のしくみについては、ドキュメントのモデルの概要をご覧ください。
原文の著者
Vijay Lingam(Applied Science)、Mayank Gupta(Applied Science)、Sudipto Nandi(Engineering)、Neil Kulkarni(Engineering)、Jack Wang(Engineering)、Sai Srinivas Somarouthu(Engineering)