AWS 기술 블로그
AWS AI-DLC Reverse Engineering: I/O 매트릭스로 모놀리스 공유 변수를 분해하여 spec 및 검증 기준으로 활용하기
레거시 모놀리스를 AI 코딩 도구로 현대화하면 문법 변환은 금방 끝납니다. 시간이 오래 걸리는 것은 공유 변수를 나누는 일입니다. 처리 단계 수십 개가 전역 상태와 공유 메모리를 함께 읽고 쓰는 코드에서는 단계마다 무엇을 입력받고 무엇을 출력하는지가 함수 시그니처에 드러나지 않습니다. 이런 공유 변수를 단계별 DTO로 옮기다 보면 숨은 입력을 빠뜨리거나, 현재 값이 아닌 낡은 값을 넘기는 결함이 생깁니다.
AWS AI-DLC(AI-Driven Development Life Cycle)는 AI 코딩 도구로 이런 작업을 체계적으로 진행하는 AWS의 오픈소스 방법론입니다. Kiro나 Claude Code에서 에이전트가 Reverse Engineering, Requirements Analysis, Units Generation, Functional Design, Code Generation, Build and Test 같은 스테이지를 차례로 진행하고, 스테이지마다 사람이 산출물을 승인하는 승인 게이트를 거칩니다. 요구사항부터 코드와 테스트까지 서로 추적(traceability)되는 것도 특징입니다. 다만 기존 코드를 분석하는 Reverse Engineering의 산출물은 아키텍처, API, 의존성 같은 구조를 다룰 뿐, 어느 단계가 어떤 변수를 읽고 쓰는지는 담지 않습니다.
이 글은 그 빈자리를 처리 단계마다 어떤 변수를 읽고 쓰는지 정리한 ‘I/O 매트릭스’로 채워 AI-DLC Reverse Engineering을 데이터 흐름 수준까지 넓히는 방법을 다룹니다. 가상의 주문 접수 프로그램을 예로, 숨은 흐름을 찾아 AI-DLC의 요구사항, API 계약, 검증 기준으로 잇는 과정을 따라갑니다. 다루는 범위가 데이터 흐름이므로 문법 변환과 업무 계산 로직 추출은 제외합니다.
공유 변수 분해가 어려운 이유
예제는 이 글을 위해 작성한 가상 쇼핑몰의 주문 접수 C 프로그램 new_order입니다. 주문 한 건을 초기화부터 배송 요청까지 10개 단계로 나눠 처리하고, 단계 함수는 모두 struct new_order_t *data 하나만 받습니다. 이 프로그램을 단계별 DTO로 나눈 To-Be에서, 할인 쿠폰을 적용한 주문이 쿠폰 할인 전 금액으로 결제되는 결함이 발생하는 시나리오를 가정하겠습니다. 결함의 원인은 레거시 코드가 값의 출처를 드러내지 않는다는 데 있습니다. 쿠폰을 쓰지 않은 주문은 결과가 정상이므로 이 결함은 테스트에서 쉽게 드러나지 않습니다. 가격 계산, 쿠폰 적용, 결제 승인 단계를 보겠습니다.
static struct new_order_state_t state;               /* 프로그램 전역 상태 */

static int calc_total(struct new_order_t *data)       /* 가격 계산 */
{
    state.total_amount = sum_line_amounts(data);     /* 품목 금액 합계 */
    state.discount_amount = state.total_amount * state.c_discount / 100;
    state.total_amount -= state.discount_amount;     /* 고객 할인을 뺀 결제 금액 */
    return 0;
}

static int apply_coupon(struct new_order_t *data)     /* 쿠폰 적용 */
{
    struct coupon_row_t cp = {0};
    if (data->cp_code[0] == '\0')
        return 0;                                    /* 쿠폰이 없으면 아무것도 쓰지 않음 */
    sql_execute("NEW_ORDER_5", data->cp_code, &cp);  /* 쿠폰 할인액 조회 */
    state.cp_amount = cp.cp_amount;
    state.total_amount -= state.cp_amount;           /* 가격 계산이 만든 금액을 고쳐 씀 */
    return 0;
}

static int request_payment(struct new_order_t *data)  /* 결제 승인 */
{
    struct payment_t pay = {0};
    pay.h_amount = state.total_amount;               /* 가격 계산 값일까, 쿠폰 적용 값일까 */
    call_module("PAYMENT", &pay);                    /* 외부 결제 모듈 호출 */
    return 0;
}
결제 승인은 전역 변수 state.total_amount를 읽지만, 이 값을 어느 단계가 만들었는지는 시그니처에 없습니다. 실제로는 가격 계산이 만든 값을 쿠폰 적용이 쿠폰이 있을 때만 고쳐 씁니다. To-Be에서 결제 승인에 가격 계산 결과만 넘기면 바로 위의 결함이 됩니다.
단계 사이의 데이터는 세 곳을 거쳐 오갑니다. 단계마다 넘겨받는 인터페이스 구조체 data, 프로그램 전역 변수 state, 그리고 같은 주문을 처리하는 모듈들이 문자열 키로 공유하는 공유 메모리(키-값 저장소)입니다. 고객 할인율은 이 프로그램을 부르는 상위 모듈이 공유 메모리에 미리 써 두고, 초기화 단계가 shared_get_int(&state.c_discount, "c_discount")로 읽어 옵니다. 실제로는 입력인데도 어느 시그니처에도 나오지 않는 숨은 입력입니다. 그림 1의 파란 선이 이 글에서 따라갈 결제 금액 흐름이고, 회색 선은 같은 방식으로 숨은 다른 흐름입니다.
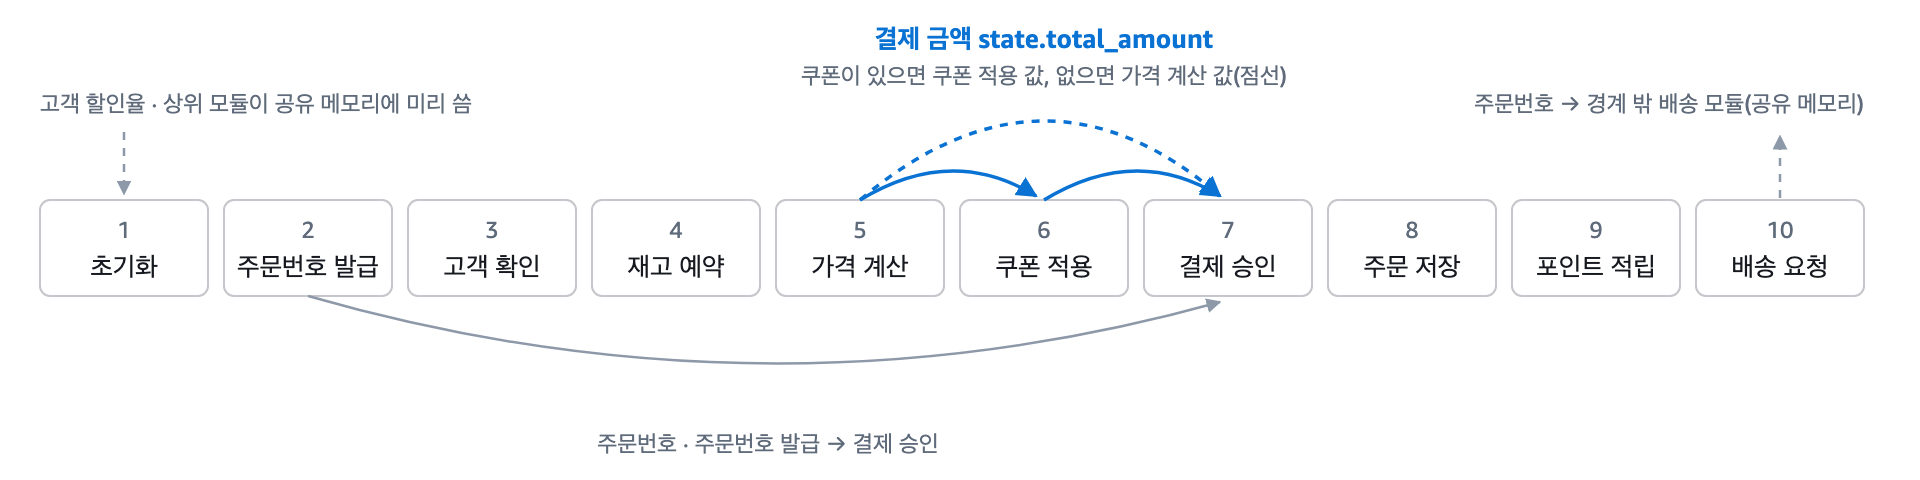
그림 1. 함수 시그니처에 보이지 않는 흐름
이런 코드를 단계별 DTO로 나눌 때 생기는 결함은 표 1의 다섯 가지로 나뉩니다.
표 1. 공유 변수를 나눌 때 생기는 결함
| 결함 유형 | 예제의 발생 사례 |
|---|---|
| 숨은 입력 유실 | 공유 메모리로 받던 고객 할인율을 요청 DTO에 넣지 않아 모든 고객의 할인이 사라짐 |
| 끊어진 흐름 | 주문번호 발급이 만든 주문번호가 To-Be의 결제 승인에 전달되지 않음 |
| 낡은 값 | 결제 승인에 쿠폰 적용 전 금액이 전달됨 |
| 순서 역전 | 결제 금액을 읽는 포인트 적립이 쿠폰 적용보다 먼저 실행되어 쿠폰 할인 전 금액으로 적립됨 |
| 의도치 않은 부수효과 | To-Be의 쿠폰 단계가 자기 몫이 아닌 고객 할인 금액(할인율로 계산한 금액)까지 덮어씀 |
분석할 수 있는 범위 안에서라면 다섯 가지 모두 ‘어느 단계가 어떤 변수를 언제 읽고 쓰는가’만 알면 기계적으로 찾을 수 있습니다. 이 정보를 요구사항으로 남겨 두면 AI-DLC가 검사할 수도 있습니다. AI-DLC에는 정해진 규칙으로 산출물을 검사하는 sensor 기능이 있어, 에이전트가 파일을 쓸 때나 승인 게이트에서 검사를 실행할 수 있습니다. 하지만 지금은 레거시의 값 흐름이 요구사항에 없으므로 검사할 대상이 없습니다.
솔루션 개요
AI-DLC가 이를 검사하게 하려면 먼저 이 정보를 소스에서 분석해 스테이지마다 제공해야 합니다. 결과물인 I/O 매트릭스부터 보겠습니다. 표 2는 예제에서 결제 금액과 관련된 네 단계와 변수 세 개만 뽑은 것입니다.
표 2. 결제 금액 주변의 I/O 매트릭스
| 변수 | 가격 계산 | 쿠폰 적용 | 결제 승인 | 주문 저장 |
|---|---|---|---|---|
state.total_amount |
WR | RW* | R | R |
state.cp_amount |
WR* | R | ||
data.cp_code |
R |
행은 변수, 열은 처리 단계입니다. 칸에는 그 단계가 변수에 접근하는 방식을 적습니다. 읽기만 하면 R, 쓰기만 하면 W, 앞 단계의 값을 읽어 고쳐 쓰면 RW, 새로 쓴 값을 그 단계 안에서 다시 읽으면 WR이며, 두 글자의 순서는 그 단계에서 읽기와 쓰기 중 어느 쪽이 먼저 일어나는지를 나타냅니다. 쿠폰이 없을 때처럼 실행되지 않을 수도 있는 접근만 있는 칸에는 별표(*)를 붙입니다.
세 행은 접근 패턴이 서로 다릅니다. 쿠폰 코드(data.cp_code)는 요청으로 들어와 쿠폰 적용이 읽기만 합니다. 쿠폰 할인액(state.cp_amount)은 쿠폰 적용이 만든 뒤 같은 단계에서 결제 금액을 줄이는 데 다시 읽고(WR*), 주문 저장이 읽습니다. 결제 금액(state.total_amount)은 가격 계산이 만들고, 쿠폰 적용이 조건부로 고쳐 쓰며, 결제 승인과 주문 저장이 읽습니다. 가격 계산이 WR인 이유는 앞의 코드처럼 결제 금액을 먼저 쓰고(품목 합계), 그 값을 읽어 고객 할인을 계산하기 때문입니다.
따라서 결제 승인이 받는 결제 금액의 출처는 두 곳입니다. 쿠폰이 없으면 가격 계산이, 있으면 쿠폰 적용이 만든 값입니다. 이렇게 ‘값을 만든 단계 → 읽는 단계’로 이어지는 연결을 흐름이라고 합니다. 흐름에는 프로그램 전체에서 E01부터 번호를 붙이며, 결제 승인으로 가는 두 흐름이 E07과 E08입니다. 이 글은 쿠폰이 있을 때의 흐름 E08을 요구사항과 테스트까지 따라갑니다. 변수마다 접근 패턴이 다르다는 점은 뒤에서 To-Be의 DTO 구조를 정하는 근거가 됩니다.
이 매트릭스를 생성하고 사용하는 작업은 3단계로 나뉩니다.
- 측정. 소스 코드에서 단계별 변수 읽기와 쓰기를 분석해 I/O 매트릭스와 흐름을 만듭니다.
- 제공. 매트릭스를 코드 그래프로 옮기고, AI-DLC 에이전트가 MCP(Model Context Protocol) 도구로 필요한 관계만 조회하게 합니다.
- 연결. 흐름을 AI-DLC 스테이지의 요구사항, API 계약 초안, 검증 기준으로 연결하고 승인 게이트에서 검사합니다.
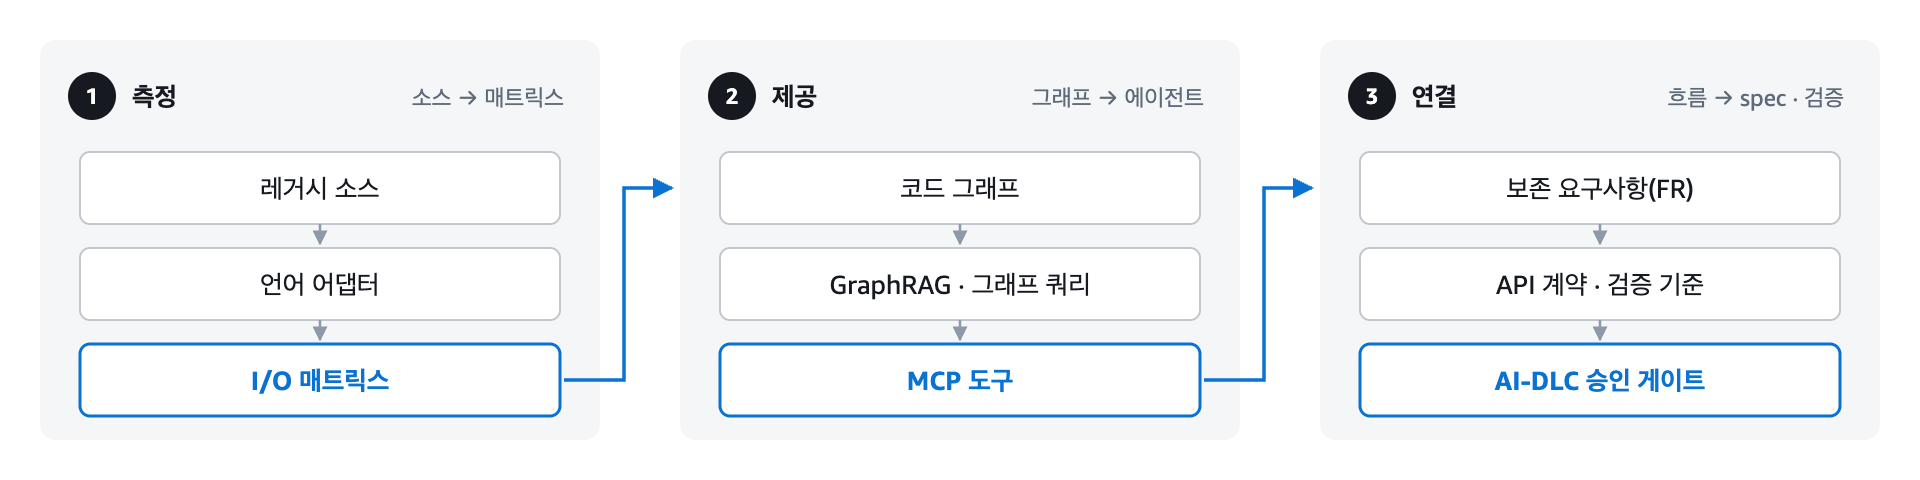
그림 2. 3단계 구성
AI-DLC가 제공하는 것은 스테이지와 승인 게이트, 그리고 워크플로를 확장하는 plugin 기능입니다. 그림 2의 각 단계에 쓰는 구성 요소는 모두 이 글의 예제에서 직접 만든 것입니다(표 3). 본문에서는 각 구성 요소의 주요 입력과 출력을 발췌해 보여 주므로, 같은 역할을 하는 도구를 각자 환경에 맞게 구현할 때 기준으로 삼을 수 있습니다.
표 3. 예제의 구성 요소와 실행 시점
| 구성 요소 | 역할 | 실행 주체 및 시점 |
|---|---|---|
| 분석기 | 소스에서 I/O 매트릭스와 흐름을 만들어 코드 그래프에 적재하고, 사람이 읽는 매트릭스 보고서(매트릭스, 흐름 목록, 결정이 필요한 변수, 미해결 목록)를 생성 | CI, 커밋마다 |
| MCP 서버 | 코드 그래프를 조회 도구로 제공 | 에이전트, 그래프를 조회할 때 |
io-matrix plugin |
스테이지에 지침과 지식 문서를 덧붙이고 승인 게이트에 sensor를 추가 | AI-DLC, 스테이지를 진행할 때 |
| 생성기 | API 계약 초안, 프레젠테이션 계층(presentation layer) 코드, 검증 테스트 생성 | 에이전트, Code Generation에서 |
이어지는 세 장에서 측정, 제공, 연결 단계를 차례로 설명하고, 마지막에 결함을 넣어 실제로 검출되는지 확인합니다.
소스 코드에서 I/O 매트릭스 추출
측정 단계는 표 2의 칸을 소스에서 분석하는 작업입니다. 소스를 AST(추상 구문 트리)로 파싱해 접근마다 읽기와 쓰기를 판정하고, 판정을 접근 레코드로 펼친 뒤, 레코드를 거슬러 올라가 값의 출처를 찾습니다.
AST 기반 읽기·쓰기 판정
문자열 검색으로는 한 줄이 읽기인지 쓰기인지 판별하지 못하고, LLM은 실행할 때마다 답이 달라질 수 있습니다. AST에서는 대입식의 왼쪽인지, 복사 함수의 첫 인자인지 같은 문법 위치로 판정하므로 언제 실행해도 같은 결과가 나옵니다. 다만 같은 결과가 나온다고 해서 빠짐없이 정확하다는 뜻은 아닙니다. 분석 범위는 대상에 따라 제한이 있으며, 정확성은 실행 결과 장에서 따로 확인합니다.
파싱과 판정은 언어마다 준비하는 어댑터가 맡습니다. 예제의 C 어댑터는 오픈소스 파서인 tree-sitter로 AST를 만들고, 매크로는 전처리(cc -E)로 펼친 뒤 분석합니다. tree-sitter는 컴파일러와 헤더 없이도 파싱할 수 있어 빌드 환경을 재현하기 어려운 레거시에 적합합니다. 빌드가 되는 코드라면 Clang의 AST를 쓰는 편이 정확합니다. 변수가 가리키는 선언과 함수 인자의 타입까지 확인할 수 있기 때문입니다.
어떤 함수가 어느 처리 단계인지는 단계 설정 파일로 알려 주며, 분석기와 생성 코드는 단계를 이 파일의 영문 ID로 부릅니다. 변수마다 업무 이름과 설명을 적은 용어 사전도 이때 함께 만듭니다. 용어 사전의 초안은 AI 에이전트가 소스 주석이나 조직의 표준 용어를 참고해 만들 수 있지만, 여기서 정한 이름이 그대로 API 필드 이름이 되므로 사람이 검토해 확정합니다. 두 파일은 처음에 한 번 정해 두는 입력이고, 이후 분석과 생성은 모두 이 파일을 기준으로 합니다.
# new_order.steps.yaml: 처리 단계와 단계 함수의 대응 (실행 순서대로, 발췌)
steps:
  - {id: price,   func: calc_total,      name: 가격 계산}
  - {id: coupon,  func: apply_coupon,    name: 쿠폰 적용}
  - {id: payment, func: request_payment, name: 결제 승인}

# new_order.terms.yaml: 용어 사전 (발췌)
state.total_amount: {name: totalAmount,  desc: 결제 금액 총액}
shared:c_discount:  {name: discountRate, desc: 고객 할인율}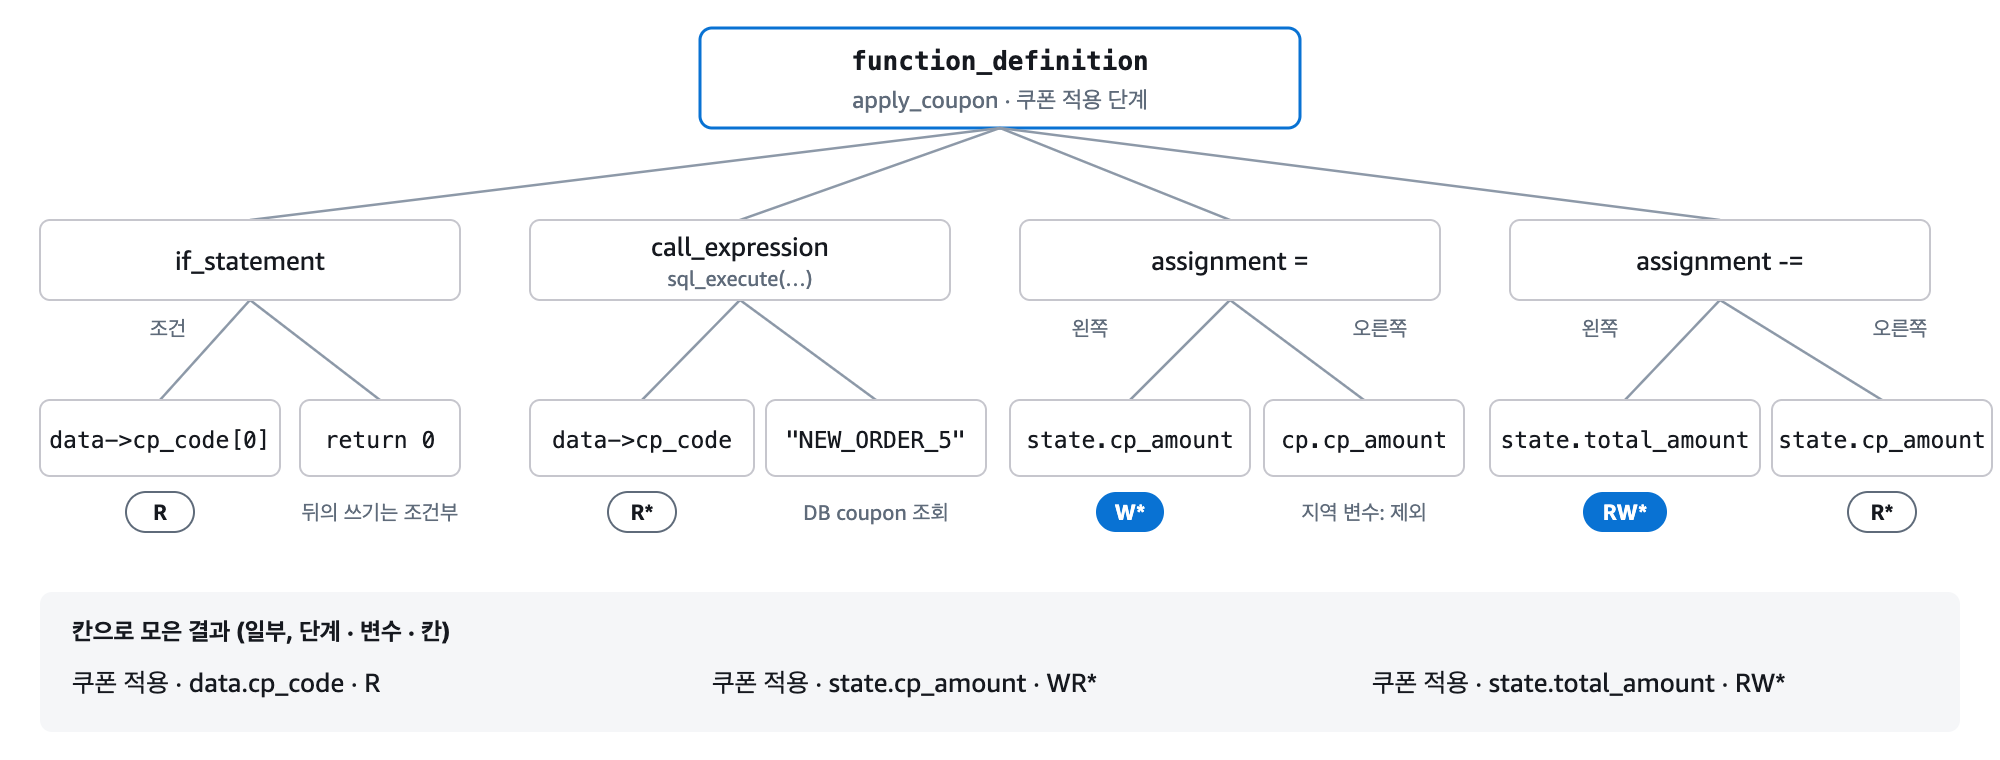
그림 3. R/W를 표시한 쿠폰 적용 함수의 AST
그림 3에서 대입의 왼쪽은 쓰기, 오른쪽과 조건식은 읽기, -=는 읽고 쓰기입니다. 쿠폰이 없으면 함수가 앞에서 return 0으로 끝나므로 그 뒤의 접근에는 조건부(*)가 붙습니다. 추적 대상이 아닌 지역 변수(cp)는 제외하고, SQL 실행과 외부 모듈 호출은 변수와 따로 기록해 두었다가 그래프에 함께 올립니다.
이 판정을 변수 접근 하나당 한 줄로 펼친 것이 접근 레코드입니다. 데이터가 오가는 곳에 따라 변수 이름 앞에 data.(인터페이스 구조체), state.(전역 변수), shared:(공유 메모리) 접두어를 붙입니다.
{"step": "coupon", "func": "apply_coupon", "line": 105,
 "var": "state.total_amount", "op": "RW", "cond": true}
같은 단계, 같은 변수의 레코드를 소스 순서대로 모으면 칸 하나가 됩니다. op는 접근 하나의 판정이고, 칸의 접근이 모두 cond가 true일 때 칸에 별표(*)가 붙습니다.
값의 출처 추적
칸을 채운 뒤에는 값의 출처를 찾습니다. 컴파일러의 데이터 흐름 분석인 도달 정의(reaching definitions)를 처리 단계 순서에 적용해, 어떤 단계가 변수를 읽으면 앞 단계를 거꾸로 훑어 그 값을 쓴 단계를 찾습니다. WR처럼 그 단계가 직접 만든 값을 읽는 경우는 찾지 않습니다. 그림 4는 결제 승인이 읽는 결제 금액의 출처를 찾는 과정입니다.
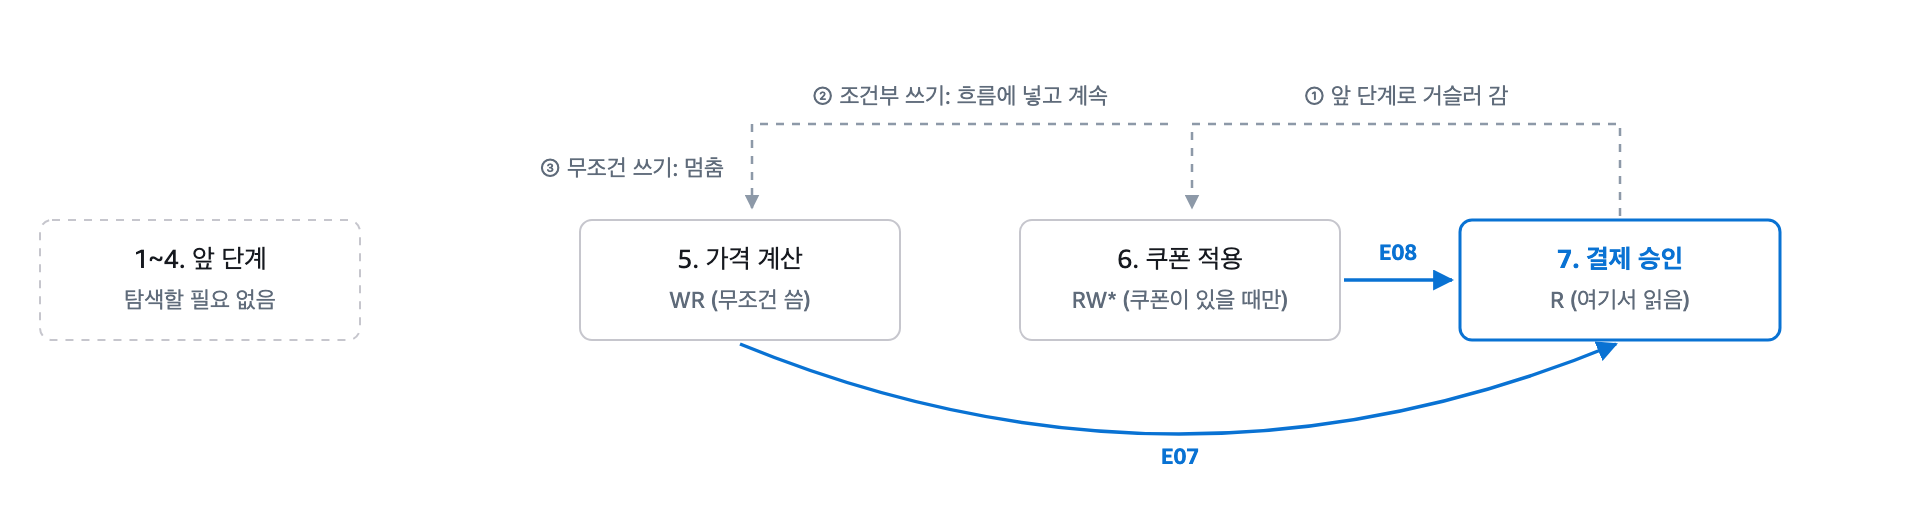
그림 4. 결제 금액의 출처 찾기
쿠폰 적용은 쿠폰이 있을 때만 쓰므로 탐색은 멈추지 않고 가격 계산까지 이어집니다. 그래서 결제 금액에는 쿠폰이 없을 때의 E07(가격 계산 → 결제 승인)과 있을 때의 E08(쿠폰 적용 → 결제 승인) 두 흐름이 생깁니다. 쿠폰 적용이 읽는 결제 금액도 같은 방법으로 찾으면 가격 계산에서 오는 흐름 E06이 나옵니다. ID를 붙이는 이유는 뒤에서 요구사항, 테스트, 게이트가 같은 흐름을 짧고 정확하게 가리키게 하려는 것입니다.
거슬러 올라가도 프로그램 안에서 쓰는 단계가 없는 공유 메모리 값은 숨은 입력으로 분류합니다. 고객 할인율이 그렇습니다. 초기화 단계가 이 값을 state.c_discount로 복사하더라도 출처가 공유 메모리이므로 숨은 입력으로 봅니다.
분석 범위와 미해결 처리
정적 분석으로 I/O 매트릭스를 정확히 구할 수 있는 범위는 이름이 코드에 정해져 있는 접근까지입니다. 구조체 필드, 전역 변수, 상수 키로 읽고 쓰는 공유 메모리는 단계 단위로 잡히고, 단계 함수가 같은 파일의 헬퍼 함수를 부르면 호출 위치에 펼쳐 함께 분석합니다. 반면 배열은 원소의 인덱스를 구분하지 않고 하나의 변수로 보며(원소의 필드는 구분합니다), 실행 순서는 단계 설정 파일을 따르므로 실행 중에 순서가 바뀌는 구조는 표현하지 못합니다. 분석하지 않은 외부 모듈이나 DB를 거쳐 다른 프로그램으로 가는 값은 호출 필드와 테이블까지만 보이고, 그 너머의 흐름은 해당 프로그램을 함께 분석해야 이어집니다.
판정할 수 없는 접근은 버리지 않고 ‘미해결’로 남긴 뒤, 사람이 해석을 정해 분석기 입력으로 되돌립니다. 예를 들어 키를 문자열 조합으로 만들거나 포인터로 간접 접근하는 곳이라면 실제 키나 변수를 단계 설정에 적습니다. 함수 포인터로 단계를 부르는 곳이라면 호출 대상을 적습니다. 그다음 다시 분석합니다. 해석이 설정 파일에 남으므로 다음 분석에서도 같은 결과가 나옵니다.
코드 그래프와 MCP 도구
매트릭스와 흐름은 AI-DLC 에이전트가 설계 내내 참고해야 하는 정보입니다. 에이전트는 ‘결제 금액은 어디서 왔나’, ‘가격 계산과 쿠폰 적용을 묶으면 경계를 넘는 값은 무엇인가’ 같은 질문을 던지는데, 모두 관계를 따라가야 답할 수 있습니다. 프로그램 하나라면 파일로도 충분하지만, 수백 개 혹은 수만 개 이상의 프로그램이 공유 메모리와 테이블로 얽힌 실제 레거시에서는 매트릭스를 그래프로 변환해 두고 에이전트가 필요한 부분만 조회하게 하는 편이 효율적입니다.
매트릭스를 그래프로 변환
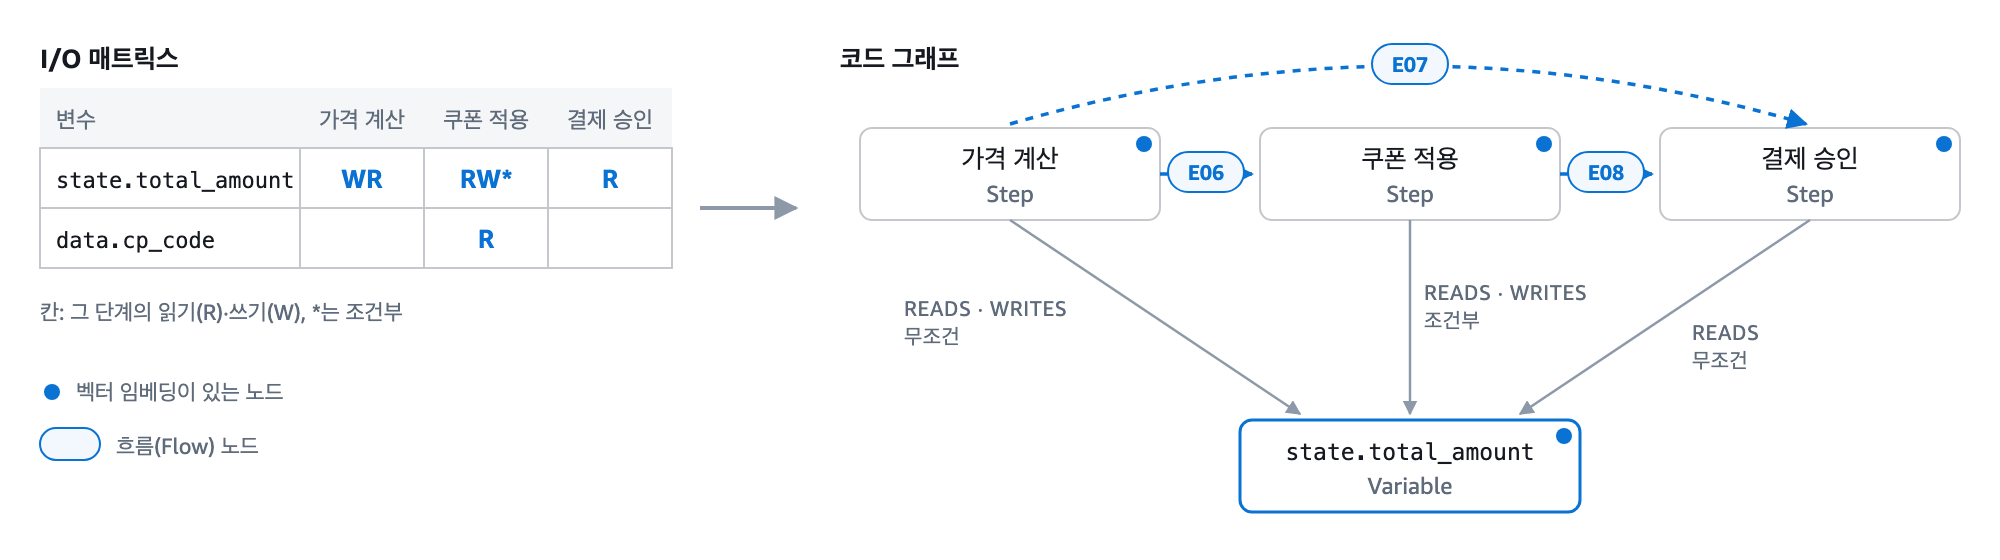
그림 5. I/O 매트릭스를 옮긴 코드 그래프
그림 5처럼 노드는 처리 단계(Step), 변수(Variable), 흐름(Flow)이고, 단계 함수(Function)와 단계가 실행하는 SQL, 외부 모듈 호출도 노드로 둡니다. 매트릭스의 칸은 단계와 변수 사이의 READS·WRITES 엣지가 되고, 엣지에 붙은 줄 번호로 소스 줄까지 거슬러 갈 수 있습니다. 흐름은 값을 만든 단계, 읽는 단계, 변수를 함께 가리키고, 나중에 요구사항과 테스트를 연결하기 위해 노드로 둡니다. 그래프는 AI-DLC 실행 전에 CI에서 미리 생성하며, 에이전트는 조회만 합니다.
벡터 검색과 그래프 탐색
자연어 질문으로도 시작점을 찾을 수 있도록 단계, 함수, 변수 노드에는 이름, 소스 발췌, 업무 설명으로 만든 임베딩을 함께 둡니다. 업무 설명은 앞에서 본 용어 사전에서 가져옵니다. 벡터 검색으로 질문과 가까운 노드를 찾고 그 노드에서 엣지를 따라가 답을 모으는 방식이 GraphRAG입니다. 여기서 벡터 검색은 시작점만 정하고, 에이전트가 받는 답은 분석기가 넣은 엣지에서 나옵니다. 변수 하나의 흐름처럼 답이 하나로 정해진 질문은 벡터 검색 없이 그래프 쿼리만으로 답합니다. 메모리 기반 그래프 분석 엔진인 Amazon Neptune Analytics로 GraphRAG를 구성하는 방법은 AWS 기술 블로그의 지식 그래프 GraphRAG 구축 글과 기존 Java 코드로 GraphRAG 구현 글을 참고하세요.
MCP 조회 예시
에이전트가 Requirements Analysis 스테이지에서 결제 금액의 출처를 물으면 get_var_flow 도구 하나로 답을 얻습니다. 다음은 get_var_flow(prog="new_order", var="state.total_amount") 호출의 응답을 발췌한 것으로, 값을 쓰는 단계와 읽는 단계, 그 사이의 흐름이 담깁니다.
{
  "var": "state.total_amount",
  "meaning": "결제 금액 총액",
  "writers": ["price", "coupon"],
  "readers": ["price", "coupon", "payment", "save", "points"],
  "flows": [
    {"id": "E06", "from": "price",  "to": "coupon"},
    {"id": "E07", "from": "price",  "to": "payment"},
    {"id": "E08", "from": "coupon", "to": "payment"}
  ]
}
가격 계산(price)은 자기가 만든 값을 바로 다시 읽으므로(WR) readers에도 들어 있습니다. 주문 저장(save)과 포인트 적립(points)으로 가는 흐름은 생략했습니다. 에이전트는 매트릭스 전체를 읽지 않고 이 조각만 받아 요구사항을 씁니다.
MCP 도구와 AWS 아키텍처
MCP 도구는 모두 미리 정의한 쿼리만 실행하고, 에이전트가 쿼리를 직접 쓰지는 않습니다(표 4). Kiro와 Claude Code 같은 AI 코딩 도구는 MCP를 지원하므로 코딩 도구를 바꾸더라도 같은 MCP 도구를 그대로 사용할 수 있습니다.
표 4. 코드 그래프 MCP 도구 예
| 도구 | 조회 질문 예 | 주요 활용 스테이지 |
|---|---|---|
get_matrix_summary |
이 그래프는 어떤 커밋을 분석했고, 사람이 정할 변수는 무엇인가? | Reverse Engineering |
search_code_context |
쿠폰 할인은 어디서 계산되고 무엇에 영향을 주나? (GraphRAG) | 모든 스테이지 |
get_var_flow |
state.total_amount는 누가 쓰고 누가 읽나? |
Requirements Analysis |
get_boundary_io |
가격 계산과 쿠폰 적용을 묶으면 경계를 넘는 값은? | Units Generation |
get_step_io |
결제 승인 단계의 입력과 출력은? | Functional Design |
list_unaccounted |
요구사항이나 테스트가 없는 흐름은? | Build and Test |
에이전트 입장에서는 도구의 입출력만 같으면 되므로, 그래프 저장소는 조회가 관계를 몇 홉(hop)까지 따라가는지를 보고 고릅니다. 파일럿은 로컬 파일과 로컬 MCP 서버로 충분합니다. 대부분의 조회가 몇 홉 안에서 끝난다면 Amazon Aurora PostgreSQL에 노드·엣지 테이블과 pgvector를 두는 구성도 가능하고, 얼마나 따라갈지 미리 알 수 없는 여러 홉의 추적이 많다면 Neptune Analytics로 구성할 수 있습니다. 그림 6은 Neptune Analytics를 쓰는 구성입니다.
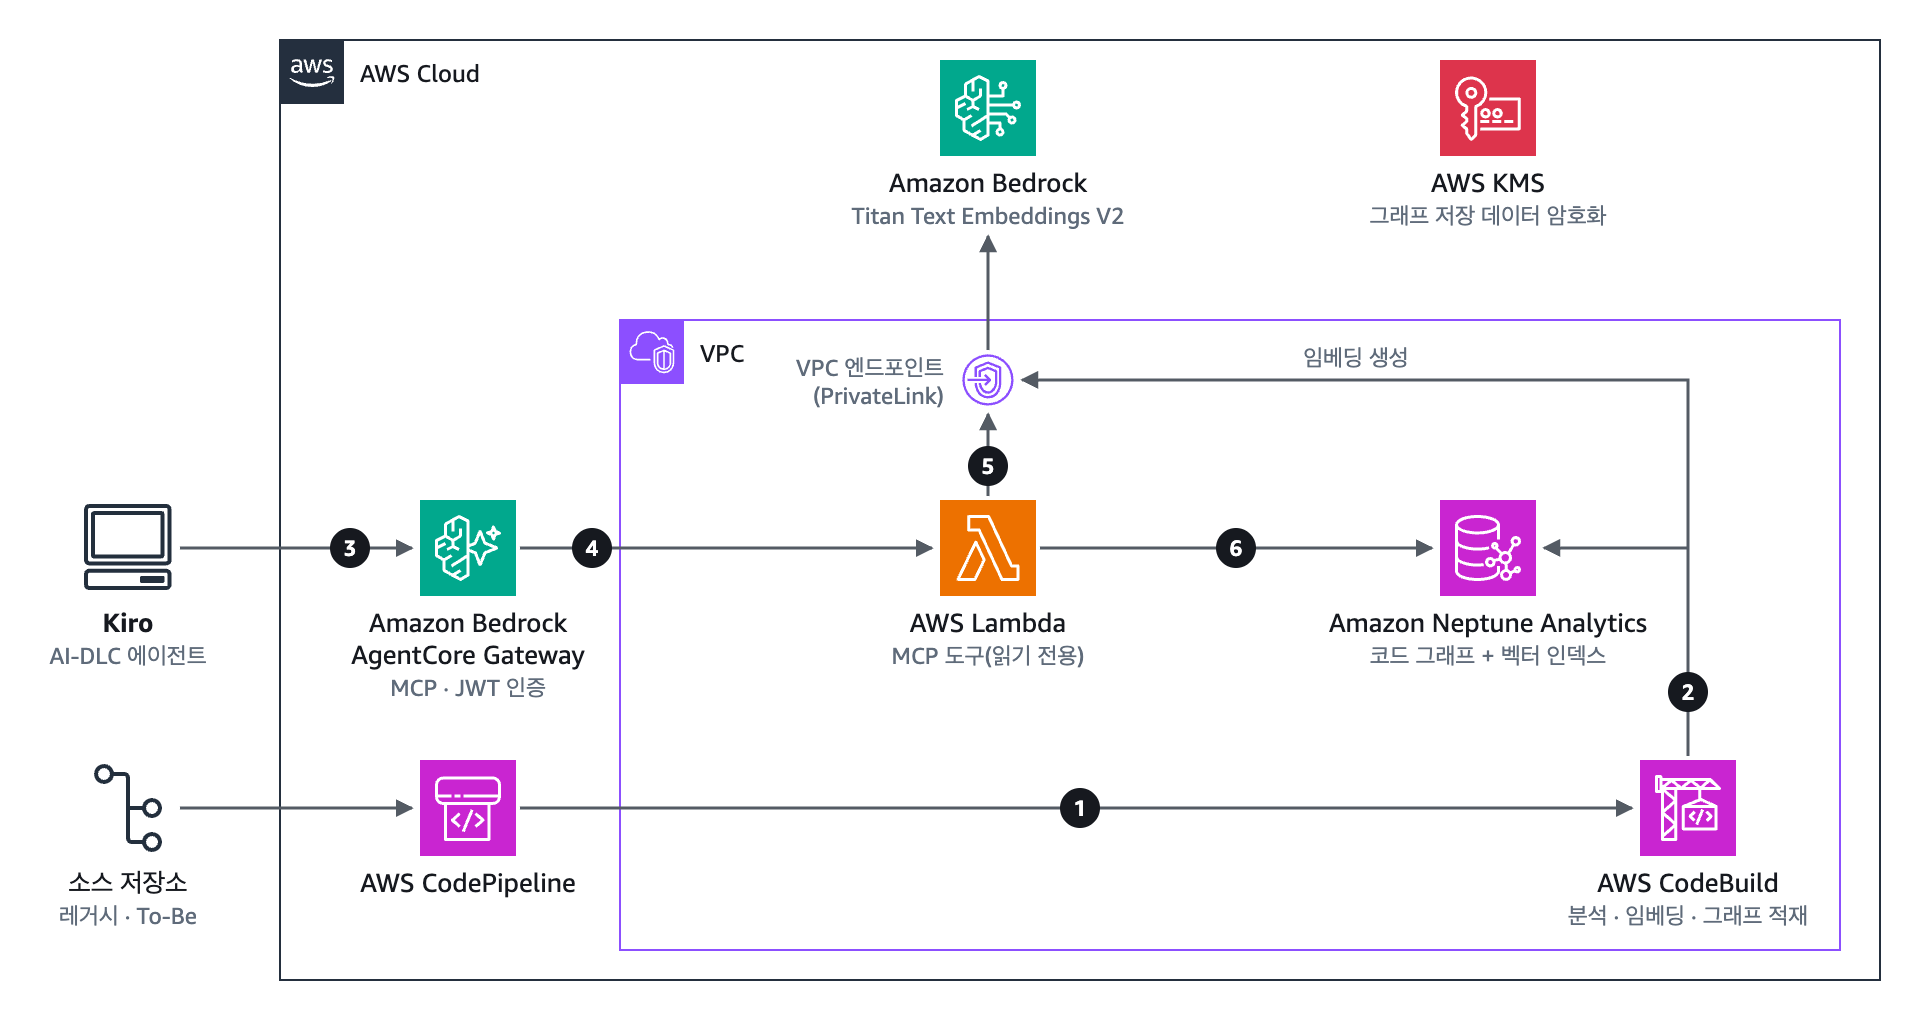
그림 6. AWS 기반 코드 그래프 구성
- 코드가 커밋되면 AWS CodePipeline이 AWS CodeBuild에서 분석기를 실행합니다.
- CodeBuild가 Amazon Bedrock으로 노드 임베딩을 만든 뒤 그래프와 함께 Neptune Analytics에 적재합니다. 그래프 쓰기 권한은 이 CI 역할에만 줍니다.
- 에이전트가 MCP로 도구를 부르면 Amazon Bedrock AgentCore Gateway가 JWT로 호출자를 확인합니다.
- 게이트웨이가 AWS Lambda 도구를 실행합니다.
- GraphRAG 도구라면 Lambda가 질문을 Bedrock에서 임베딩으로 바꿉니다.
- Lambda가 openCypher 쿼리로 그래프를 읽습니다.
도구는 임의 쿼리를 실행하는 범용 Amazon Neptune MCP 서버 대신 Lambda로 직접 구현했고, MCP 엔드포인트와 호출자 인증은 AgentCore Gateway에 맡겼습니다. 게이트웨이에 Lambda 도구를 등록하고 JWT 인증을 거는 방법은 AgentCore Gateway로 MCP 도구 관리하기 글을 참고하세요. Lambda 실행 역할에는 그래프에 대한 권한으로 읽기(neptune-graph:ReadDataViaQuery)만 주므로, 도구를 거쳐서는 그래프를 바꿀 수 없습니다. VPC 안의 Lambda와 CodeBuild는 bedrock-runtime 인터페이스 VPC 엔드포인트(AWS PrivateLink)로 Bedrock을 호출합니다.
Neptune Analytics는 그래프에 프로비저닝한 용량(m-NCU)에 시간당 요금을 매기며, 1 m-NCU는 메모리 1GB와 그에 맞는 컴퓨팅·네트워크 용량입니다. 인터페이스 VPC 엔드포인트에도 시간당 요금이 있으므로, 그림 6의 구성을 테스트한 뒤에는 필요하지 않은 그래프와 엔드포인트 같은 관련 리소스를 삭제하시기 바랍니다. 다시 쓸 그래프는 중지해 둘 수 있지만, 중지 중에도 정상 컴퓨팅 요금의 10%가 청구됩니다. 자세한 내용은 Amazon Neptune 요금과 AWS PrivateLink 요금을 참고하세요.
AI-DLC 스테이지별 연결
에이전트가 그래프를 조회할 수 있게 되었으니, 이제 AI-DLC 스테이지가 이 정보를 쓰게 할 차례입니다. AI-DLC는 스테이지마다 에이전트가 따를 지침 파일을 두는데, 이 파일은 업그레이드 때 덮어써지므로 직접 고치지 않고 AI-DLC의 plugin 기능으로 확장합니다. plugin에는 새 스테이지와 에이전트 정의, sensor, 방법론 지식 문서, 그리고 기존 스테이지에 덧붙이는 지침인 contribution 등을 담을 수 있습니다. 예제의 io-matrix plugin은 새 스테이지를 만들지 않고 contribution과 sensor, 그리고 에이전트가 참고할 지식 문서만 추가합니다. 이 글의 예제는 AI-DLC 2.11.3을 기준으로 작성했습니다.
To-Be는 가격 계산과 쿠폰 적용을 묶은 가격 서비스와, 나머지 단계를 담은 주문 서비스로 나누는 경우를 예로 듭니다. 서비스 안에서는 단계별 결과 DTO로, 서비스 사이에서는 API로 값을 주고받습니다. 그림 7은 결제 금액 흐름 E08이 스테이지를 거치며 요구사항, 작업 단위, 업무 규칙, To-Be 필드, 테스트로 이어지는 모습입니다. 요구사항에서 테스트까지의 추적은 AI-DLC가 원래 하는 일이고, plugin은 Requirements Analysis와 Build and Test 게이트에서 흐름 누락을 검사합니다.
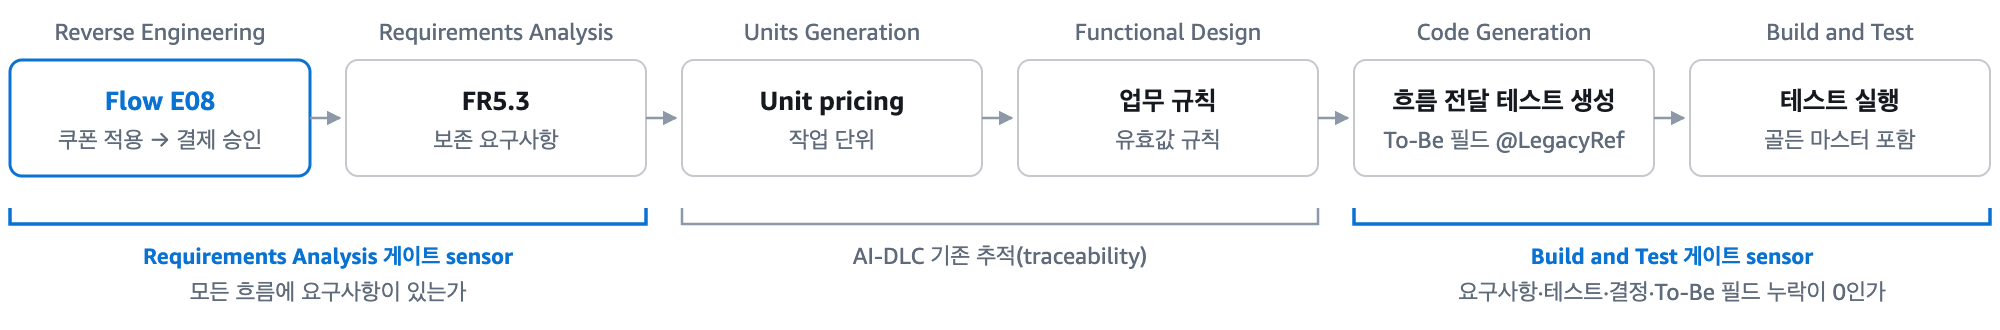
그림 7. 결제 금액 흐름이 AI-DLC 스테이지를 거쳐 이어지는 모습
스테이지마다 산출물이 늘어나므로, 누가 무엇을 만드는지 먼저 정리해 두겠습니다. 분석기와 생성기의 산출물은 표 3과 같고, 사람과 AI 에이전트가 맡는 산출물은 표 5와 같습니다. 아래에서는 E08을 스테이지 순서대로 따라갑니다.
표 5. 사람과 AI 에이전트가 맡는 산출물
| 작성 주체 | 산출물 | 시점 |
|---|---|---|
| 사람 | 단계 설정, 용어 사전 확정, 결정 기록(질문에 대한 답), 골든 마스터 입력 케이스, 스테이지별 승인 | 시작 전, Reverse Engineering, 각 승인 게이트 |
| AI 에이전트 | 용어 사전 초안, 보존 요구사항, 작업 단위 후보 비교, 업무 규칙 문서, 단계 결과 DTO와 서비스 코드 | 시작 전, Requirements Analysis ~ Code Generation |
Reverse Engineering: 그래프 확인과 결정 기록
Reverse Engineering 스테이지에는 승인 요청 전에 절차 하나를 덧붙입니다. 분석은 CI가 이미 끝냈으므로 에이전트는 get_matrix_summary로 그래프가 지금 읽은 소스와 같은 커밋을 분석했는지 확인하고, CI가 만든 매트릭스 보고서를 산출물에 넣기만 합니다.
이 절차는 plugin의 contribution 파일(contributions/inception/reverse-engineering.md)에 정의합니다. 파일 맨 위 --- 사이에는 지침을 붙일 위치와 추가할 산출물을 적고, 그 아래에는 에이전트가 따를 절차를 자연어로 적습니다.
---
target: reverse-engineering      # 지침을 덧붙일 스테이지
plugin: io-matrix
adds:
  produces:                      # 이 스테이지 산출물에 추가할 문서
    - io-matrix-report           # 매트릭스 보고서
    - io-matrix-decisions        # 결정 기록
fragments:
  - anchor: after-step:3         # Step 3(Architect Synthesis) 뒤에 끼워 넣음
    order: 100                   # 같은 위치에 붙는 지침끼리의 순서
---
## fragment: after-step:3
### Step 3a (io-matrix): Extend the scan to data access
1. Check that the graph matches the scanned source. Call `get_matrix_summary` ...
레거시 동작을 그대로 둘지 사람이 정해야 하는 항목도 있습니다. 여러 단계가 쓰는 값을 어느 단계에서 받을지, 숨은 입력을 To-Be에서 어디서 받을지, 아무도 읽지 않는 값을 지울지 같은 것입니다. 분석은 레거시가 어떻게 동작하는지 알려 줄 뿐이고, 그 동작이 결함일 수도 있기 때문입니다. 에이전트가 AI-DLC 질문 파일에 질문을 쓰고 사람이 [Answer]: 줄에 답하면, 그 답이 contribution 지침에 따라 만든 결정 기록 문서에 남습니다. 결제 금액에 대한 질문은 다음과 같습니다.
결제 금액(state.total_amount)은 가격 계산과 쿠폰 적용이 모두 씁니다.
To-Be의 결제 승인도 레거시처럼 쿠폰 적용 결과를 우선해 받아야 합니까?
[Answer]: 예. 쿠폰 적용 결과가 있으면 그 값, 없으면 가격 계산 값
이렇게 정한 ‘어느 값을 쓸지’를 이 글에서는 유효값 규칙이라고 부릅니다.
Requirements Analysis: 보존 요구사항
보존 요구사항은 레거시의 값 흐름을 To-Be에서도 지키라는 요구사항입니다. Requirements Analysis에서는 plugin 지침에 따라 에이전트가 흐름마다 보존 요구사항을 기능 요구사항(FR, Functional Requirement)의 하위 항목으로 쓰고, 같은 줄에 흐름 ID를 적습니다. FR 번호는 AI-DLC가 매기고, 흐름과는 줄 안의 흐름 ID로만 연결됩니다. 예를 들어 결제 요구사항이 FR5라면 결제 금액의 두 흐름은 그 하위 항목이 됩니다.
- FR5.2 (E07) 쿠폰 코드가 없을 때 결제 요청 금액은 가격 계산 금액이어야 한다.
- FR5.3 (E08) 쿠폰 코드가 있을 때 결제 요청 금액은 쿠폰 할인을 뺀 금액이어야 한다.
승인 게이트의 sensor는 그래프의 흐름 ID가 모두 요구사항 줄에 있는지 확인하고, 요구사항 문장의 내용이 맞는지는 승인하는 사람이 검토합니다. 이 예제에서는 이 검사를 게이트에서 실행하는 blocking sensor(fire_on: gate, default_severity: blocking)로 만들어 contribution으로 Requirements Analysis 스테이지에 등록합니다. 그래서 흐름이 하나라도 빠지면 게이트가 열리지 않고, 예외를 두려면 사람이 검사 실패를 무시하고 진행하기로(override) 명시적으로 결정해야 합니다. 이 결정과 이유는 기록에 남습니다. 서비스 안에서 끝나는 E06 같은 흐름도 똑같이 하위 항목이 되므로, 흐름이 많은 프로그램은 요구사항 문서를 기능별로 나눠 관리합니다.
Units Generation: 경계 입출력과 서비스 후보
작업 단위를 나누는 Units Generation 스테이지에는 후보 단위마다 get_boundary_io로 경계 입출력을 구해 후보끼리 비교하라는 지침을 추가합니다. 경계 입출력은 하나의 단위로 묶은 단계들의 경계를 넘나드는 값입니다. 가격 계산과 쿠폰 적용을 묶은 가격 서비스 후보라면 밖에서 들어오는 값(요청 입력, 숨은 입력, 경계 밖 단계가 만든 값)은 요청 필드 후보가 됩니다. 안에서 만들어 밖의 단계가 읽는 값은 응답 필드 후보가 됩니다. E08의 결제 금액은 경계 밖의 결제 승인이 읽으므로 응답 필드가 되고, 서비스 안에서는 유효값 규칙으로 두 값 중 하나를 골라 응답의 결제 금액 하나로 내보냅니다. 그림 8은 이 가격 서비스 후보의 경계 입출력입니다.
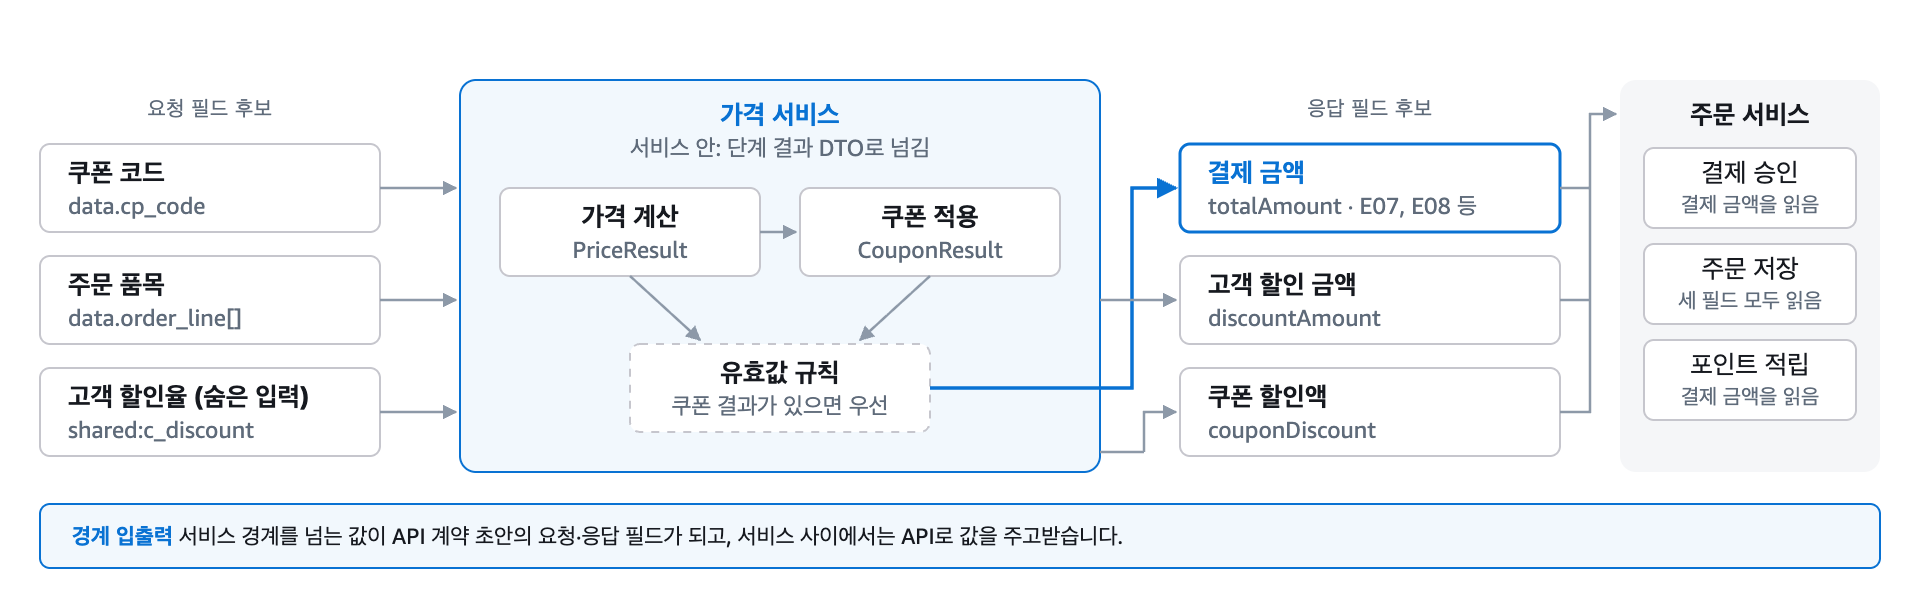
그림 8. 가격 서비스 후보의 경계 입출력
분석 범위 안에서 경계를 넘는 흐름은 모두 후보에 들어가므로, 경계를 바꿨을 때 늘거나 주는 필드를 바로 비교할 수 있습니다. 다만 어느 후보를 서비스 경계로 확정할지, DB 트랜잭션 범위와 실패 처리를 어떻게 할지는 사람이 정합니다.
Functional Design: 단계별 결과 DTO
Functional Design에서는 단위 안의 설계를 정하며, 산출물은 AI-DLC의 업무 규칙 문서입니다. plugin은 변수를 To-Be의 어디에 둘지 매트릭스의 접근 패턴으로 정하라는 지침을 넣습니다. 이 기준을 배치 기준이라고 부르며, 표 6의 위에서부터 적용해 처음 맞는 것 하나로 정합니다. 단계별 입출력은 get_step_io로 확인합니다.
표 6. 주요 배치 기준
| 기준 | 접근 패턴 | To-Be 위치 | 예제 변수 |
|---|---|---|---|
| 요청 입력 | 요청으로 들어오고 어느 단계도 쓰지 않음 | 요청 필드 | data.cp_code쿠폰 코드 |
| 숨은 입력 | 프로그램 안에서 쓰는 단계 없이 읽기만 하는 공유 메모리 값 | 출처를 표기한 요청 필드 | shared:c_discount고객 할인율 |
| 단계 산출 | 한 단계가 쓰고 뒤 단계가 읽음 | 쓰는 단계의 결과 필드 | state.cp_amount쿠폰 할인액 |
| 다중 writer | 둘 이상의 단계가 쓰고 다른 단계가 읽음 | 쓰는 단계별 결과 필드와 유효값 규칙 | state.total_amount결제 금액 |
| 단계 지역 | 한 단계 안에서만 쓰고 읽음 | 지역 변수 | state.ol_amount품목 금액 |
이 설계대로라면 Code Generation에서 AI가 작성할 Java 코드는 다음과 같은 모습입니다. @LegacyRef는 이 글의 예제에서 정의한 어노테이션으로, To-Be 필드에 레거시 변수 경로를 남겨 뒤의 테스트와 게이트가 레거시와 To-Be를 매핑할 수 있게 합니다.
// 쿠폰 적용 결과: 결제 금액을 쓰는 단계마다 결과 필드를 따로 둔다
public record CouponResult(
    @LegacyRef(value = "state.total_amount", writer = "coupon")
    long totalAmountAfterCoupon,
    @LegacyRef("state.cp_amount") long couponDiscount) {}

// 가격 서비스 안: 공유 변수 대신 단계 결과를 명시적으로 넘긴다 (req: 서비스 입력)
PriceResult price = priceStep.calculate(req.lines(), req.discountRate());
Optional<CouponResult> coupon = couponStep.apply(req.couponCode(), price);
long totalAmount = coupon.map(CouponResult::totalAmountAfterCoupon)  // 유효값 규칙
.orElse(price.totalAmount());req.discountRate()가 공유 메모리로 받던 고객 할인율, 곧 요청 필드가 된 숨은 입력입니다.
Code Generation: API 계약과 presentation layer
io-matrix plugin은 Code Generation 스테이지에 승인된 작업 단위마다 생성기를 실행하고 생성 파일은 손으로 고치지 않는다는 지침을 덧붙입니다. 이 스테이지에서는 두 종류의 구현 코드가 나옵니다. 서비스 안의 단계 결과 DTO와 서비스 구현은 AI가 Functional Design 문서를 따라 작성하고, 서비스 사이의 API 요청·응답 DTO와 컨트롤러는 생성기가 만듭니다. 코드가 컴파일되면 생성기가 검증 테스트도 만드는데, 이는 뒤의 Build and Test 절에서 설명합니다.
API 계약 초안은 Units Generation에서 구한 경계 입출력으로 만듭니다. 필드의 이름과 설명은 용어 사전에서, 타입과 길이는 레거시 선언에서 정하고(그림 9), 숨은 입력은 필수 필드가 되며, 필드마다 x-legacy-ref로 레거시 경로를 남깁니다. 생성기는 LLM 없이 정해진 대응표로만 만듭니다. 그래서 입력이 같으면 pricing.openapi.yaml의 내용도 동일하고, 용어 사전에 없는 변수가 나오면 이름을 지어내지 않고 멈춥니다.
# pricing.openapi.yaml: generated by io-matrix api (발췌)
paths:
  /pricing/quote:
    post:
      operationId: quotePricing
      x-legacy-steps: [price, coupon]         # 서비스로 묶은 레거시 단계
      x-flows: [E07, E08]                     # 경계를 넘는 흐름(일부)
components:
  schemas:
    QuotePricingRequest:
      required: [couponCode, lines, discountRate]
      properties:
        couponCode:                           # 빈 문자열이면 쿠폰 없음
          type: string
          maxLength: 15                       # char cp_code[16]
          x-legacy-ref: data.cp_code
        lines:                                # 수량과 단가만, 품목 ID는 없음
          type: array
          items: {$ref: '#/components/schemas/QuotePricingOrderLine'}
          x-legacy-ref: "data.order_line[]"
        discountRate:                         # 숨은 입력이 필수 필드로
          type: integer
          format: int32
          x-legacy-ref: "shared:c_discount"
          x-legacy-origin: hidden
    QuotePricingResponse:
      required: [totalAmount, discountAmount, couponDiscount]
초안에는 레거시가 실제로 읽는 필드만 들어갑니다. 예를 들어 주문 품목(lines)에는 수량과 단가만 들어가고 품목 ID는 빠집니다. 가격 계산과 쿠폰 적용이 품목 ID를 읽지 않기 때문입니다. 응답의 discountAmount와 couponDiscount는 경계 밖의 주문 저장이 읽는 고객 할인 금액과 쿠폰 할인액입니다.
초안은 Code Generation 승인 게이트에서 사람이 검토합니다. 빈 문자열로 ‘쿠폰 없음’을 나타내던 쿠폰 코드를 선택 필드로 바꿀지, 단가를 요청으로 받을지 서버에서 조회할지, 한글이 들어가는 필드의 길이를 바이트 대신 글자 수로 다시 정할지, 실패 응답을 어떻게 정의할지가 검토 대상입니다. 검토 결과는 생성된 파일을 직접 고치지 않고 용어 사전과 결정 기록 같은 입력에 반영한 뒤 다시 생성합니다.
presentation layer 코드도 이 계약 파일에서 생성합니다. 순서는 다음과 같습니다. 먼저 생성기가 계약 파일과 API 요청·응답 DTO를 만들고, AI가 서비스 인터페이스와 서비스 입력(앞의 req)을 작성하며 필드마다 @LegacyRef를 붙입니다. 마지막으로 생성기가 다시 실행되어, API DTO와 서비스 입력 사이에서 경로가 같은 필드끼리 값을 넘기는 컨트롤러를 만듭니다.
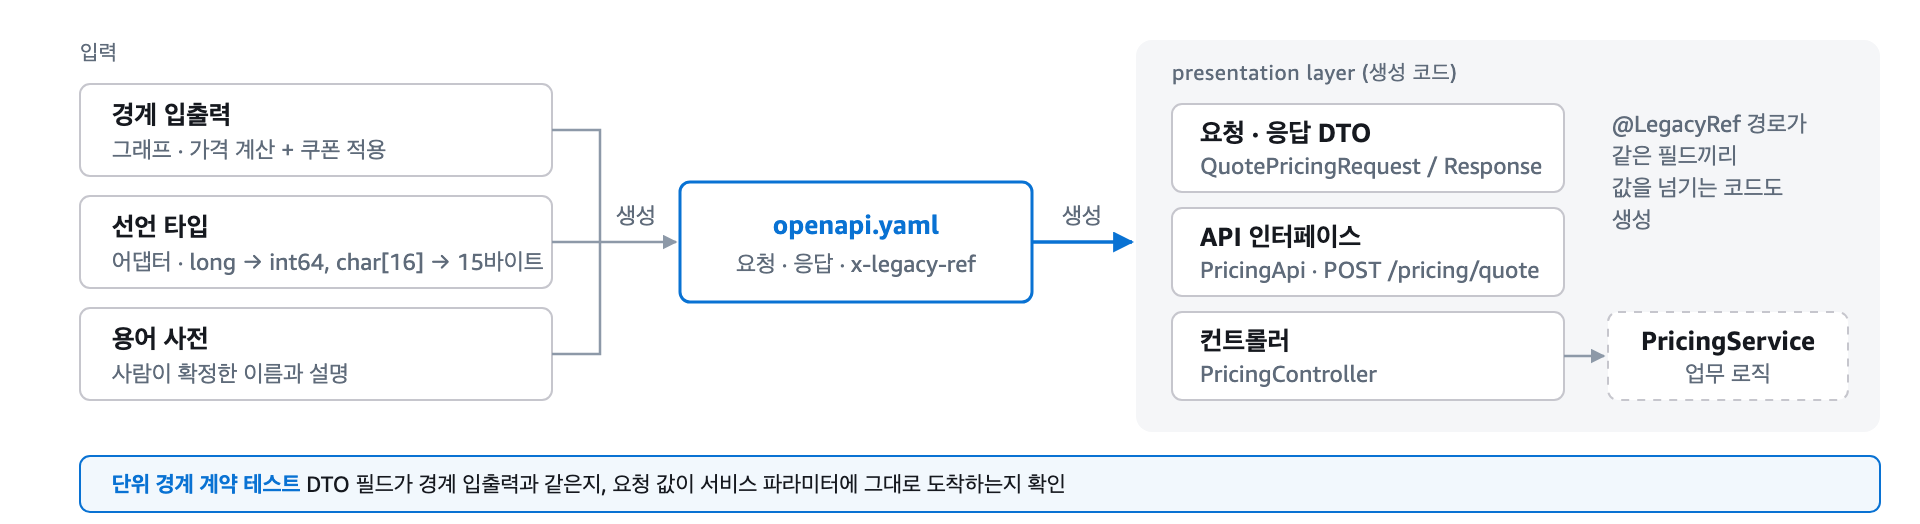
그림 9. 서비스 경계에서 API 계약과 presentation layer 코드 만들기
Build and Test: 검증 테스트
검증 테스트는 Code Generation에서 코드가 컴파일된 뒤 생성기가 같은 그래프와 결정 기록에서 규칙에 따라 만듭니다. plugin 지침에 따라 에이전트는 이 테스트를 고치지 않고, 테스트가 통과할 때까지 코드를 고칩니다. 표 7은 주요 검증 규칙이며, 규칙 이름은 이 글에서 붙인 것입니다. 골든 마스터와 누락 0을 뺀 나머지는 업무 계산 결과가 아니라 필드, 흐름, 순서 같은 구조를 검사하므로 구조 검증 테스트라고 부릅니다. Build and Test에서는 골든 마스터를 포함한 이 테스트를 실행하고, 마지막 규칙인 ‘누락 0’은 승인 게이트의 blocking sensor가 검사합니다. Requirements Analysis와 마찬가지로 누락이 있으면 게이트가 열리지 않으며, AI-DLC가 게이트를 스스로 승인하는 Construction 자율 모드에서도 이 검사는 실행되고 override할 수 없습니다.
표 7. 주요 검증 규칙
| 규칙 | 검증 항목 | 검출 대상 결함 |
|---|---|---|
| 요청 필드 완전성 | 요청 입력과 숨은 입력마다 요청 DTO에 필드가 있는가 | 숨은 입력 유실 |
| 숨은 입력 필수 | 숨은 입력이 비면 기본값으로 넘어가지 않고 실패하는가 | 숨은 입력 유실 |
| 흐름 전달 | 흐름마다 값을 만든 단계의 값이 읽는 단계에 그대로 도착하는가 | 끊어진 흐름, 낡은 값 |
| 조건별 유효값 | 여러 단계가 쓰는 값을 읽는 단계에, 조건마다 유효값 규칙대로 맞는 값이 도착하는가 | 낡은 값 |
| 실행 순서 | 값을 만드는 단계가 그 값을 읽는 단계보다 먼저 실행되는가 | 순서 역전 |
| 쓰기 범위 | 단계 결과에 레거시 단계가 쓰지 않던 값이 들어 있지 않은가 | 의도치 않은 부수효과 |
| 단위 경계 계약 | 서비스 API의 요청·응답 필드가 경계 입출력과 빠짐도 남음도 없이 같고, 값이 그대로 전달되는가 | API 필드 누락 |
| 골든 마스터 | 레거시를 정해진 입력으로 실행한 기록과 To-Be 결과가 같은가 | 계산 방식 차이(반올림 등) |
| 누락 0(게이트) | 모든 흐름에 요구사항과 테스트가, 결정이 필요한 변수에 결정이, 모든 변수에 To-Be 위치가 있는가 | 빠뜨린 흐름과 변수 |
흐름 전달 테스트는 단계 내부의 계산이 아니라 단계 사이의 값 전달을 검사합니다. 그림 10처럼 각 단계의 계산은 고유한 ‘카나리 값’만 반환하는 스텁으로 바꾸고(카나리 값은 실제 금액이 아니라 어느 단계가 넣은 값인지 알아보기 위한 식별용 값입니다), 값을 넘기는 To-Be 코드는 그대로 실행해 그 값이 읽는 단계에 도착하는지 봅니다. 테스트는 그 흐름이 생기는 조건에서 실행합니다. E08이면 쿠폰이 있는 주문입니다.
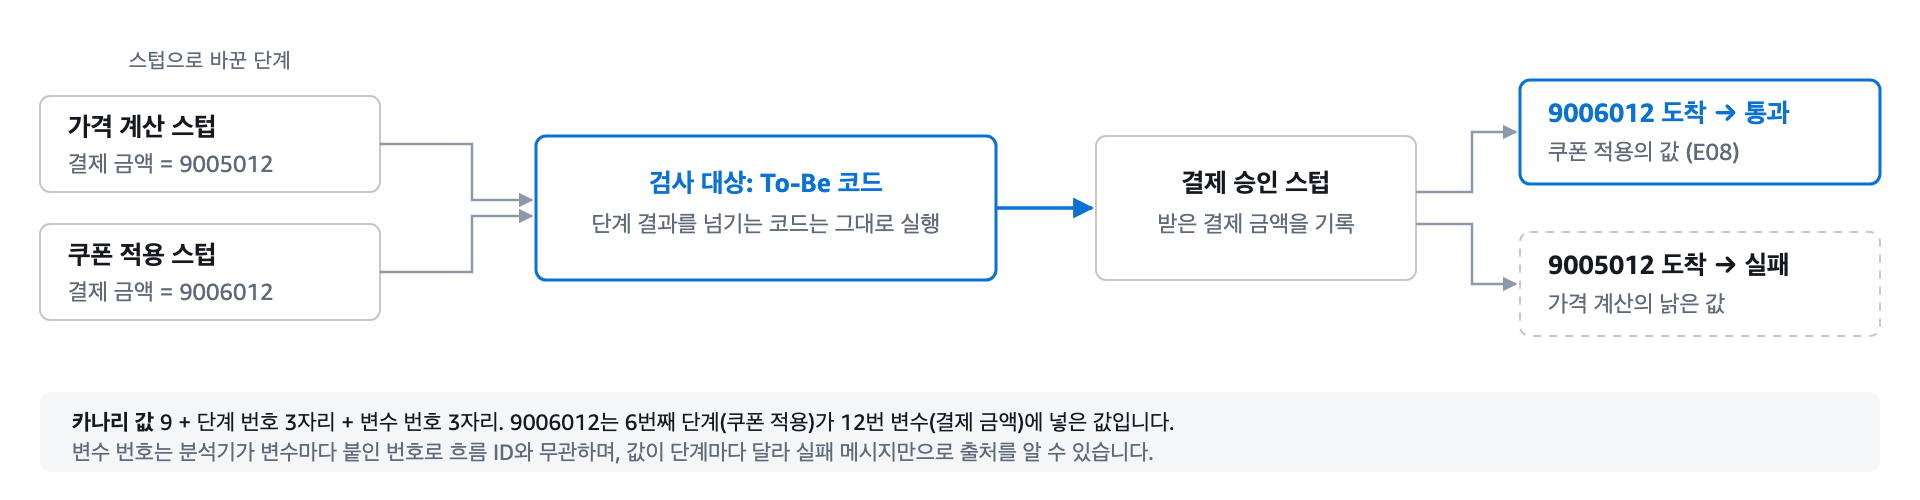
그림 10. 카나리 값으로 하는 흐름 전달 테스트
// FlowDeliveryTest.java: generated by io-matrix criteria - do not edit
@Test
@DisplayName("결제 승인은 쿠폰 적용이 만든 결제 금액을 받는다 [흐름 E08]")
void payment_receives_total_amount_from_coupon() {
    // 하네스가 To-Be 단계를 차례로 실행하되 단계 내부는 카나리 스텁으로 바꾼다
    // 쿠폰 적용을 실행하는 조건(E08이 생기는 조건)으로 돌린다
    var h = OrchestratorHarness.run(Map.of("coupon", true));
    // 쿠폰 적용 결과에 넣은 카나리 값이 결제 승인 입력에 그대로 도착해야 한다
    assertEquals(h.produced("coupon", "state.total_amount"),
                 h.consumed("payment", "state.total_amount"));
}
조건별 유효값 테스트는 같은 결제 금액을 쿠폰 적용을 실행할 때와 건너뛸 때로 나눠, 각각 E08과 E07의 값이 오는지 확인합니다. 흐름 전달은 분석이 찾은 레거시 흐름을, 조건별 유효값은 사람이 정한 규칙을 기준으로 삼습니다. 예제는 레거시 동작을 유지했으므로 같은 결함에 둘 다 실패합니다. 유효값 규칙을 레거시와 다르게 정했다면 결정 기록이 기준이 되므로, 해당 흐름의 흐름 전달 테스트도 결정에 맞춰 다시 생성합니다. 테스트는 레거시 단계 ID(coupon, payment)와 변수 경로만 쓰고, 하네스가 @LegacyRef로 To-Be의 대상을 찾으므로 To-Be의 클래스나 필드 이름이 바뀌어도 그대로입니다.
골든 마스터는 레거시를 정해진 입력으로 실행한 결과를 정답으로 기록해 두고 To-Be 결과와 비교합니다. 관찰할 지점(응답, DB 테이블, 외부 호출 필드)은 그래프에서 가져오지만 정답은 실행 기록에서 오므로, 구조는 같고 계산 결과만 다른 결함을 잡습니다. 테스트가 없는 레거시라면 구조 검증 테스트와 골든 마스터가 리팩터링 전 동작을 고정하는 기준선이 됩니다.
추적 정보의 관리
흐름과 요구사항, 테스트, To-Be 필드의 연결은 한곳에 모아 두지 않고 각 스테이지의 산출물에 남기며, 게이트의 sensor가 이를 모아 누락을 검사합니다(표 8). To-Be 필드는 코드가 나와야 갖춰지므로, 결정과 함께 Build and Test 게이트에서 확인합니다.
표 8. 추적 정보의 저장 위치, 갱신 주체 및 주기, 검사 게이트
| 추적 연결 | 저장 위치 | 갱신 주체 및 주기 | 검사 게이트 |
|---|---|---|---|
| 흐름 목록 | 코드 그래프 | CI, 커밋마다 | 각 게이트 검사의 기준 |
| 흐름 ↔ 보존 요구사항 | requirements.md의 요구사항 줄(예: FR5.3 (E08)) |
에이전트 작성, 사람 승인(Requirements Analysis) | Requirements Analysis |
| 흐름 ↔ 테스트 | 생성 테스트 목록 | 생성기(Code Generation) | Build and Test |
| 변수 ↔ 결정, To-Be 필드 | 결정 기록, To-Be 코드의 @LegacyRef |
사람(결정), AI와 생성기(Code Generation) | Build and Test |
실행 결과
예제 To-Be에서 생성된 테스트를 실행하면 정상 구현은 모두 통과합니다. 여기에 대표적인 결함 두 가지를 하나씩 넣어 보았습니다.
쿠폰 적용 전 금액 전달 결함
가격 서비스가 쿠폰 적용 결과 대신 가격 계산 결과를 결제 금액으로 내보내도록 한 줄을 바꾸면 다음 세 테스트가 실패합니다.
[흐름 전달] 결제 승인은 쿠폰 적용이 만든 결제 금액을 받는다 [흐름 E08]
  expected: <9006012> but was: <9005012>
[조건별 유효값] 쿠폰을 적용하면 결제 승인은 쿠폰 적용이 만든 결제 금액을 받는다
  expected: <9006012> but was: <9005012>
[골든 마스터] 쿠폰 주문 케이스의 결과가 레거시 실행 기록과 같다
  PAYMENT.h_amount: 레거시 23691, To-Be 24691
그림 10에서 본 것처럼 9006012는 쿠폰 적용의, 9005012는 가격 계산의 카나리 값이므로 결제 승인에 가격 계산의 낡은 값이 도착했다는 것을 바로 알 수 있습니다. 골든 마스터는 레거시 실행 기록 8건 가운데 쿠폰을 쓴 1건에서만 차이를 보였습니다. 케이스 데이터에 쿠폰 주문이 없었다면 골든 마스터만으로는 놓쳤을 결함입니다.
숨은 입력 누락 결함
이번에는 에이전트가 주문 접수 요청(예제의 Command 클래스)을 작성하면서 고객 할인율(shared:c_discount)을 빠뜨린 경우를 재현했습니다. 이 요청은 가격 계산과 포인트 적립에 할인율을 함께 넘기므로, 두 단계 모두 0을 받게 됩니다. 실패한 테스트는 다음과 같습니다.
[요청 필드 완전성] 요청(Command)에 숨은 입력 고객 할인율(shared:c_discount)이 있다
  Command has no @LegacyRef field for shared:c_discount
[숨은 입력 필수] 숨은 입력 고객 할인율(shared:c_discount)이 없으면 요청을 만들 수 없다
  Command has no field for hidden input shared:c_discount
[DB 부수효과] 포인트 적립의 DB 접근은 레거시와 같다: customer UPDATE (쿠폰 주문 케이스)
  expected: <[customer:UPDATE]> but was: <[]>
[골든 마스터] 레거시 실행 기록 8건 중 5건이 다르다. 쿠폰 주문 케이스의 차이:
  response.h_amount: 레거시 23691, To-Be 24990
  response.c_points: 레거시 236, To-Be 0
필드가 아예 사라졌으므로 요청 필드 완전성과 숨은 입력 필수가 함께 실패합니다. 필드는 남아 있고 값만 비어 들어오는 경우라면 구조 검증 테스트 중에서는 숨은 입력 필수만 실패합니다. 레거시의 포인트 적립은 고객 할인율이 0이면 회원이 아닌 것으로 보고 적립을 건너뛰므로, 할인율이 0이 된 To-Be에서는 포인트 적립의 DB 쓰기가 사라집니다. 이를 잡은 DB 부수효과 테스트는 단계마다 레거시와 같은 테이블에 같은 종류로 접근하는지 검사하며, 표 7에 넣지 않은 나머지 규칙 가운데 하나입니다. 골든 마스터는 그 결과로 달라진 결제 금액과 포인트를 보여 주며, 나머지 3건은 할인율이 0인 주문과 가격 계산 전에 중단되는 주문이라 결과가 같습니다.
분석기 자체의 검증
계약과 테스트를 모두 같은 그래프에서 만들기 때문에, 분석기가 흐름 하나를 놓치면 요구사항과 테스트에서도 함께 빠집니다. 생성된 테스트가 통과한다고 분석이 맞다는 보장은 없으므로 분석기는 따로 확인합니다. 첫째, 사람이 소스를 읽고 작성한 기대 결과(변수별 분류와 흐름 목록)와 분석기 출력을 비교합니다. 둘째, 레거시를 계측해 실행하면서 단계마다 실제로 호출한 SQL과 외부 모듈을 기록하고, 관측된 호출이 모두 그래프에 기록된 호출 안에 있는지 확인합니다.
두 방법에는 한계가 있습니다. 실행 기록은 SQL과 모듈 호출 수준까지만 확인하고 변수 하나하나의 읽기와 쓰기까지는 보지 않습니다. 프로그램이 수백 개 이상이라면 기대 결과를 모두 사람이 작성하기도 어렵습니다. 실제 프로젝트에서는 대표 프로그램 몇 개로 어댑터를 검증한 뒤, 나머지는 실행 기록 대조와 골든 마스터로 확인하는 방식이 현실적입니다.
마치며
레거시의 숨은 데이터 흐름은 코드를 새 언어로 옮기기 전에 먼저 찾아내야 합니다. 이 글의 방식에서 자동화되는 범위와 사람의 판단이 필요한 영역을 나누면 다음과 같습니다.
- 자동화 범위: I/O 매트릭스와 흐름 추출, 코드 그래프 적재, MCP 조회, API 계약 초안과 presentation layer 코드 생성, 검증 테스트 생성, 승인 게이트의 누락 검사
- 사람의 판단이 필요한 영역: 단계 설정과 용어 사전의 확정, 미해결 접근의 해석, 유효값 규칙 같은 결정, 보존 요구사항과 설계 승인, API 초안 검토, 서비스 경계와 DB 트랜잭션, 실패 처리, 골든 마스터의 입력 케이스
같은 흐름이 보존 요구사항, API 계약 초안, 검증 기준으로 이어지므로, AI가 코드를 다시 생성해도 레거시의 동작이 빠지지 않았는지 게이트에서 확인할 수 있습니다.
적용 순서
- 주문 처리 같은 업무 하나를 골라 단계 설정을 만들고, 분석기로 매트릭스와 보고서를 만들어 사람이 결과를 검토합니다.
- 보고서를 AI-DLC 프로젝트의 참고 문서로 넣어 Reverse Engineering과 Requirements Analysis에서 보존 요구사항을 만들어 봅니다.
- 효과가 확인되면 로컬 MCP 서버와
io-matrixplugin을 붙여 생성기 실행 지침과 승인 게이트 검사를 추가합니다. plugin을 쓰는 동안에는 AI-DLC 버전을 고정하고, 업그레이드할 때 contribution이 붙는 위치가 그대로인지 확인합니다. - 대상 프로그램이 늘면 코드 그래프를 AWS로 옮깁니다(탐색 깊이에 따라 Aurora PostgreSQL 또는 Neptune Analytics).
참고 자료
- AWS AI-DLC GitHub 저장소의 plugin 작성 가이드와 참조 plugin
- Amazon Neptune Analytics 사용 설명서의 그래프 생성과 벡터 인덱스
- Amazon Bedrock AgentCore Gateway 개발자 가이드의 Lambda 대상을 MCP 도구로 노출하는 방법
- Amazon Bedrock과 Amazon Neptune으로 지식 그래프를 활용한 GraphRAG 애플리케이션 구축하기, AWS 기술 블로그
- 기존 개발 코드(Java)로 Amazon Neptune Analytics GraphRAG 구현하기, AWS 기술 블로그
- Amazon Bedrock AgentCore Gateway: AI 에이전트의 MCP 도구 통합 관리하기, AWS 기술 블로그