AWS 기술 블로그
CJ올리브네트웍스의 LLM Gateway 구축 – 모델 접근, 비용 통합 관리
Amazon Bedrock부터 Claude Platform on AWS, 사내 오픈모델까지 하나의 엔드포인트로 연결해 통제는 강화하고 AI 사용은 멈추지 않도록 설계한 AWSome AI Gateway 기반 LLM Gateway 구축 여정
“문제는 모델이 아니라 통제입니다. 우리는 모든 LLM 호출을 한곳에서 관리하고 정책을 적용할 수 있도록 중앙 게이트웨이(Central Gateway)로 설계했습니다.”
1. 흩어진 LLM을 왜 하나로 모았을까?
전사 AX를 추진하면서 일부 개발자가 실험적으로 사용하던 LLM은 이제 전 임직원이 활용하는 핵심 업무 도구로 자리 잡았습니다. 변화의 속도는 빨랐지만, 조직 차원의 거버넌스는 그 속도를 따라가지 못했습니다. 누가 어떤 모델을 사용하고 있는지, 비용이 어디에서 얼마나 발생하는지, 어떤 데이터가 회사 밖으로 나가고 있는지 전사 차원에서 파악하고 통제하기 어려운 상황이었습니다.
이러한 가시성의 부재는 크게 두 가지 문제로 이어졌습니다. 첫 번째는 보안입니다. 다양한 프로바이더가 제공하는 모델 중 조직의 검토나 승인 없이 업무에 활용되는 모델이 있었고, 어떤 데이터와 프롬프트가 외부로 전달되는지 확인하고 통제하기 어려웠습니다.
두 번째는 비용입니다. 부서와 개인이 각자의 계정과 API키로 모델을 사용하면서 비용은 프로바이더별로 분산되어 청구되었고, 어느 부서가 어떤 모델에 얼마를 사용하고 있는지 통합적으로 파악하기 어려웠습니다.
이 문제를 해결하려면 개별 모델이나 사용자를 각각 관리하는 것이 아니라, 모든 LLM 호출을 하나의 지점으로 모을 필요가 있었습니다. 저희가 선택한 해결책은 전사 LLM Gateway를 구축하고, 조직에서 사용할 수 있는 모델에 접근하는 단일 엔드포인트를 제공하는 것이었습니다.
Amazon Bedrock의 모델, Claude Platform on AWS, 사내 On-premise 오픈모델을 단일 엔드포인트로 연결하고, 임직원은 LLM Gateway에서 조직이 승인·등록한 모델을 사용합니다. 모든 호출이 하나의 경로를 거치기 때문에 인증, 예산, 데이터 처리 및 기록 정책을 중앙에서 관리하고, 모든 모델에 일관된 기준을 적용할 수 있습니다. 저희는 이처럼 LLM 사용 경로를 하나로 통합하고 정책을 일관되게 적용하는 지점을 중앙 게이트웨이(Central Gateway)라고 정의했습니다.
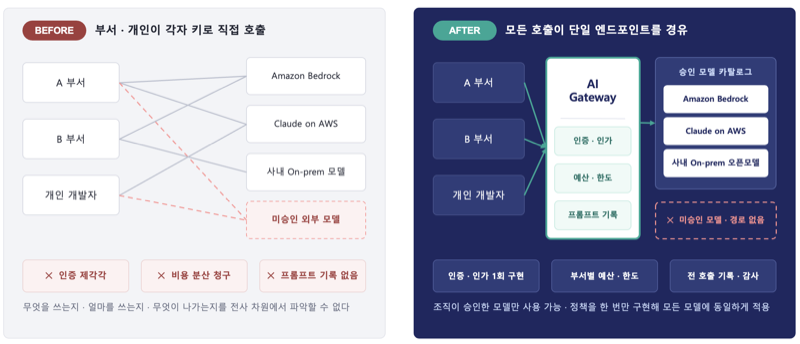
게이트웨이는 모든 요청을 인증 → 예산 확인 → 필요한 경우 모델 전환 → 호출량 제한 → 모델 호출 → 비용 기록의 순서로 처리합니다. 이를 통해 조직의 정책은 단순한 가이드라인에 머무르지 않고, 모든 LLM 요청에 일관되게 적용되는 실행 가능한 거버넌스로 동작합니다.
| 처리 단계 | 통제하는 것 | 조직에 주는 의미 |
|---|---|---|
| 인증 (VK 확인) | 누가 호출하는지 | 사내 SSO 계정과 서비스 계정만 모델에 접근할 수 있음 |
| 예산 확인 | 얼마나 쓸 수 있는지 | 팀·개인 월 Credit 한도를 모든 모델에 동일하게 적용 |
| 모델 전환 | 한도 이후에 어떻게 이어가는지 | 차단 대신 사용자 Credit이 차감되지 않는 내부 운영 모델로 전환 |
| 호출량 제한 | 순간 부하를 어떻게 막는지 | 특정 사용자나 에이전트의 폭주가 전체 이용에 영향을 주지 않도록 제한 |
| 모델 호출 | 어느 경로로 나가는지 | LLM Gateway에 승인·등록된 프로바이더의 모델만 제공 |
| 비용 기록 | 무엇이 일어났는지 | 사용자·모델별 비용과 토큰, 프롬프트 입력·출력까지 추적 가능 |
표 1. LLM Gateway 요청 흐름과 단계별 거버넌스 정책
그 결과 이제 모든 LLM 사용은 기록으로 남습니다. 누가 어떤 모델을 사용했는지, 비용이 어디에서 발생했는지, 어떤 데이터가 외부로 전달되었는지 요청 단위로 추적할 수 있습니다. 또한 요청의 입력과 출력이 함께 기록되므로 어떤 데이터가 회사 밖으로 전달되는지도 확인할 수 있습니다.
2. 통제하되, AI사용을 멈추게 하지 않는 방법
앞서 중앙 게이트웨이를 통해 모델 접근 경로를 통합하고, 이를 경유하는 요청에 동일한 정책을 적용하도록 구성했습니다. 하지만 모든 요청을 한곳으로 모으는 것만으로 거버넌스가 완성되는 것은 아닙니다.
조직이 AI 사용을 통제하려고 할수록 사용자는 불편해질 수 있습니다. 반대로 사용 편의성만 고려하면 비용과 데이터, 접근 정책은 통제하기 어려워집니다.
결국 엔터프라이즈 환경에서 중요한 것은 AI 사용을 제한하는 것이 아니라, 조직이 정한 기준 안에서 안전하고 지속적으로 사용할 수 있는 환경을 만드는 것입니다. 이를 위해 저희는 거버넌스를 접근·비용·데이터·가시성의 네 영역으로 구분하고, 각 영역의 정책이 모든 LLM 요청에 일관되게 적용되도록 구성했습니다.
| 영역 | 거버넌스 필요성 | 적용 방안 |
|---|---|---|
| 접근 | 팀별·개인별로 흩어져 발급된 API 키 | 사내 SSO 로그인 후 발급되는 임시 가상 키(VK)로만 접근 |
| 비용 | 팀별·개인별 얼마를 허용할지 예산 관리 방법이 없음 | 팀·개인 단위 월 Credit 한도를 통해서 예산 관리 |
| 데이터 | 외부로 전송되는 프롬프트 추적 불가능 | 프롬프트 입력·출력을 캡처 활성화 요청에 한해 암호화 저장 및 관리 |
| 가시성 | 사용 데이터가 프로바이더·서비스마다 흩어져 판단 근거 부재 | 사용자·팀·모델별 비용과 토큰을 통합 대시보드에서 집계. 매월 배분·이월 정책의 근거로 사용 |
표 2. 영역별 거버넌스의 필요성과 적용 방안
접근성
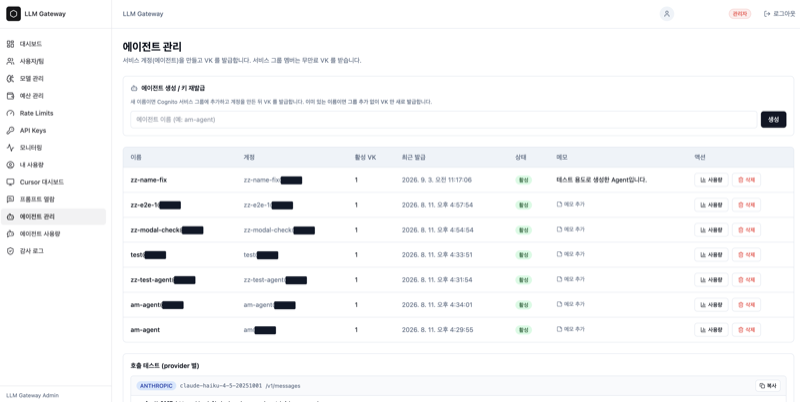
조직이 승인한 사용자만 AI를 사용할 수 있어야 했지만, 사용자마다 API Key를 발급하고 관리하는 방식은 운영 부담이 컸습니다. 이를 해결하기 위해 임직원은 사내 SSO로 로그인한 뒤 LLM Gateway 호출에 사용할 임시 가상 키(Virtual Key, 이하 VK)를 발급받도록 구성했습니다. 프로바이더의 실제 API 키와 계약 정보는 조직에서 중앙 관리하고 사용자에게 직접 노출하지 않습니다.
사용자용 VK에는 유효기간을 두고 만료 시 자동으로 갱신되도록 구성하여, 키가 유출되더라도 영향을 받을 수 있는 기간을 제한했습니다. 반면, 사람이 아닌 AI 에이전트는 대화형 로그인이 어렵기 때문에 별도의 서비스 계정과 무만료 VK를 사용하도록 구성했습니다. 서비스 계정과 AI 에이전트 VK는 운영자가 중앙에서 발급·관리·회수하여 지속적으로 통제할 수 있도록 했습니다.
비용
구성원에게 매월 인당 Credit을 배분하고, 개인과 팀의 사용량을 함께 집계하여 두 예산이 모두 허용하는 범위 내에서 유료 모델 요청을 처리합니다. 신규 팀과 사용자의 초기 예산은 0으로 설정하고, 관리자가 예산을 부여하는 승인 절차를 거친 후 유료 모델을 사용할 수 있도록 구성했습니다.
하지만 곧 하나의 질문이 생겼습니다.
“예산이 모두 소진되면 AI 사용도 함께 멈춰야 할까?”
가장 단순한 방법은 요청을 차단하는 것입니다. 비용은 확실하게 통제할 수 있습니다. 하지만 진행 중인 에이전트의 작업이나 LLM을 활용한 업무까지 함께 중단됩니다. 그래서 우리는 예산을 초과한 경우 유료 모델의 사용은 제한하되, 사용자 Credit이 차감되지 않는 사내 오픈모델로 요청을 전환하도록 구성했습니다.
비용을 통제하면서도 AI 사용은 멈추지 않도록 한 것입니다.
데이터
어떤 데이터가 어떤 모델로 전달되었는지 추적하려면 요청의 입력과 출력을 기록해야 합니다. 하지만 여기에는 또 다른 문제가 있었습니다. 기록 자체에 민감한 업무 정보가 포함될 수 있기 때문입니다.
즉, 데이터를 추적하기 위해 수집한 정보를 다시 보호해야 했습니다.
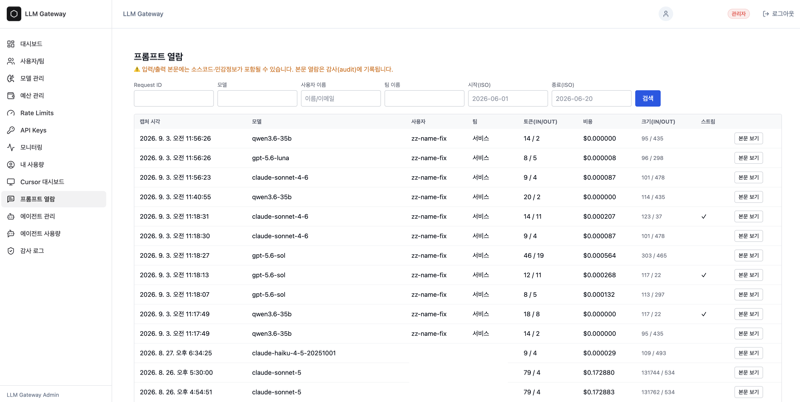
이를 위해 프롬프트 캡쳐가 활성환된 모든 LLM 요청의 입력과 출력을 기록하되, 저장과 열람 과정에도 별도의 통제 정책을 적용했습니다. 관리자는 프롬프트 열람 화면에서 Request ID, 모델, 사용자, 팀, 기간 등의 조건으로 요청을 검색할 수 있으며, 필요한 경우에만 실제 입력과 출력 내용을 확인할 수 있습니다. 또한 모든 열람 이력을 감사 로그에 기록하여 누가 어떤 데이터를 확인했는지 추적할 수 있도록 구성했습니다.
가시성
모델 호출 경로를 게이트웨이로 통합한 뒤에는 실제 사용 현황을 확인할 수 있어야 합니다. 운영자는 어느 팀이 어떤 모델을 사용하고 있는지 알아야 하고, 사용자 역시 자신의 Credit이 어떻게 사용되는지 확인할 수 있어야 합니다.
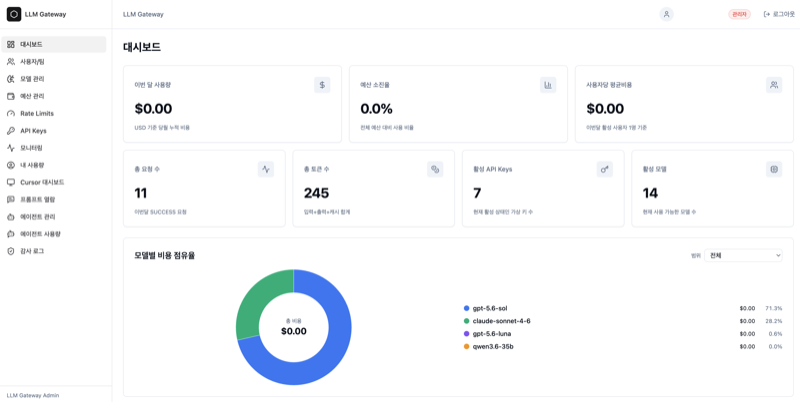
이를 위해 전체 LLM 사용 현황을 한눈에 확인할 수 있는 통합 대시보드를 구성했습니다.
대시보드에서는 월 누적 사용 비용과 예산 소진율, 모델별 비용 비중을 팀과 사용자 단위로 확인할 수 있습니다. 요청 수와 토큰 사용량, 활성 키와 모델 수도 함께 제공하여 비용 증가가 실제 사용량 변화와 어떤 관계가 있는지도 확인할 수 있도록 했습니다.
이렇게 수집된 데이터는 단순한 현황 파악에 그치지 않고, 매월 Credit 소진율과 팀별 사용 추이를 바탕으로 Credit 배분과 이월 정책을 조정하고 제공할 모델의 범위를 결정하는 근거로 활용합니다.
이제 운영자는 감이 아니라 데이터를 기반으로 정책을 조정할 수 있습니다.
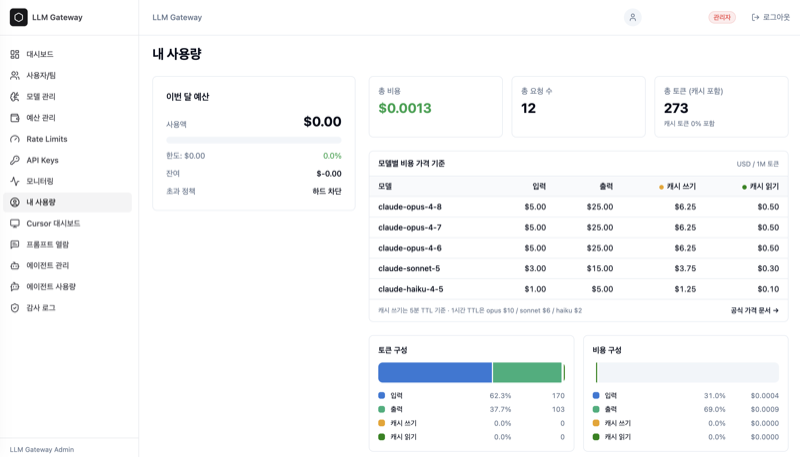
가시성은 운영자에게만 필요한 것은 아닙니다. 사용자가 자신의 사용량과 비용을 이해할 수 있어야 조직의 정책도 자연스럽게 작동합니다. 이를 위해 사내 SSO로 로그인하면 가장 먼저 개인 대시보드인 ‘내 사용량’을 확인할 수 있도록 구성했습니다.
대시보드에서는 이번 달 Credit 한도와 사용량, 잔여 Credit, 한도 소진 이후 적용되는 정책을 한눈에 확인할 수 있습니다. 또한 모델별 사용량과 비용을 제공하고, 캐시 쓰기·읽기 비용까지 제공하여 Credit이 어디에서 사용되고 있는지 확인할 수 있습니다.
사용자는 더 이상 남은 Credit을 추측할 필요가 없습니다. 자신의 사용현황을 확인하며 상황에 맞는 적절한 모델을 선택할 수 있습니다.
이 과정에서 두 가지 중요한 점을 확인할 수 있었습니다.
첫째, 접근·비용·데이터·가시성은 각각 독립된 관리 영역이 아니라 서로 연결되어 있습니다. 모든 요청이 하나의 같은 경로를 지나야 사용자와 모델별 비용을 집계할 수 있고, 축적된 사용 데이터를 기반으로 예산과 모델 정책을 조정할 수 있습니다. 또한 동일한 경로에서 프롬프트의 입력과 출력을 기록해야 어떤 데이터가 어떤 모델로 전달되었는지 추적할 수 있습니다. 이 사례에서는 접근·비용·데이터·가시성 정책을 중앙 게이트웨이에서 함께 적용하도록 구성했습니다.
둘째, 거버넌스는 AI 사용을 제한하기 위한 장치가 아니라, 조직이 정한 기준 안에서 지속적으로 사용할 수 있도록 만드는 운영 체계여야 합니다. 예산을 모두 사용했다고 요청을 차단하는 대신 사내 오픈모델로 전환한 것도 같은 이유입니다. 비용은 통제하면서도 사용자의 업무는 멈추지 않도록 하고자 했습니다.
엔터프라이즈 환경에서 거버넌스가 중요한 이유도 여기에 있습니다. AI 활용이 전사로 확대될수록 접근 권한과 비용, 데이터, 사용 현황을 일관된 기준으로 관리할 수 있어야 지속적인 확산이 가능합니다. 이를 위해 거버넌스는 문서상의 정책에 머무르는 것이 아니라 모든 LLM 요청이 지나가는 게이트웨이에서 실제로 실행되고, 그 결과가 사용자와 운영자에게 투명하게 보여야 합니다.
다음 장에서는 이러한 거버넌스를 제공하는 LLM Gateway를 AWS 환경에서 어떻게 구현했는지 구체적인 아키텍처와 함께 살펴보겠습니다.
3. 전사 AI 트래픽을 처리하기 위한 아키텍처
모델 호출 경로를 중앙 게이트웨이로 통합하면서, 게이트웨이의 처리 용량과 가용성을 함께 고려해야 했습니다. 개발자는 단일 엔드포인트로 모델을 호출할 수 있어야 했고, 운영 관점에서는 LLM Gateway의 늘어나는 트래픽과 비용, 장애, 배포를 안정적으로 관리할 수 있어야 했습니다.
이를 위해 Amazon Elastic Kubernetes Service (Amazon EKS)와 AWS Fargate를 기반으로 실행 환경을 구성하고, 모델 호출을 처리하는 프록시 영역과 인증·설정을 담당하는 관리 영역을 분리했습니다. 비용과 예산 처리는 별도의 워커가 담당하도록 역할을 나누고 상태 데이터는 Amazon ElastiCache for Valkey, Amazon Aurora PostgreSQL, Amazon Simple Storage Service (Amazon S3)와 같은 외부 저장소에 분리하여, 개별 컴포넌트의 생명주기에 종속되지 않도록 구성했습니다.
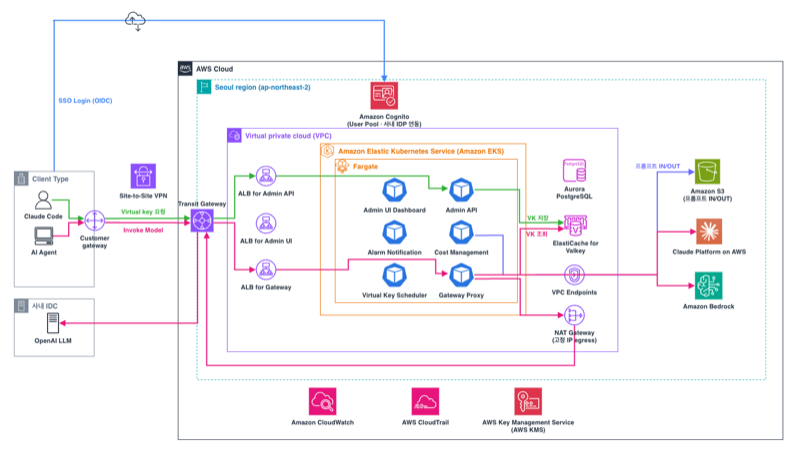
아키텍처의 핵심은 두 가지였습니다. 사용량이 늘어날 때 처리 용량을 유연하게 확장하는 것, 그리고 특정 컴포넌트의 문제가 전체 서비스 중단으로 이어지는 범위를 줄이는 것입니다.
정책 관리는 한곳에서, 요청 처리는 유연하게
모델 호출 경로를 중앙 게이트웨이로 통합하면, 게이트웨이는 늘어나는 요청량을 처리할 수 있어야 합니다. 사용자가 늘고 서비스 에이전트의 요청이 많아질수록 게이트웨이의 처리량은 전사의 LLM 활용을 뒷받침하는 중요한 조건이 됩니다. 하지만 부하에 따라 운영자가 서버를 직접 늘리고 줄여야 한다면, 모델 접근과 정책 관리를 통합해 줄인 운영 부담이 인프라 영역에서 다시 발생합니다. 따라서 트래픽 변화에 유연하게 대응하면서도 관리 포인트는 최소화할 수 있는 구조가 필요했습니다.
이를 위해 게이트웨이를 Amazon EKS와 AWS Fargate 기반으로 구성해 노드 준비와 패치에 대한 운영 부담을 줄이고, 파드 자동 확장 정책을 적용해 트래픽 부하에 따라 처리 용량이 자동으로 조절되도록 했습니다.
수평 확장을 위해 요청 간 유지해야 하는 인증·예산·사용 이력 등의 정보를 특정 게이트웨이 파드에 저장하지 않고 외부 저장소에서 공유하도록 구성했습니다. VK와 예산 카운터는 Amazon ElastiCache for Valkey에, 사용 이력은 Amazon Aurora PostgreSQL에, 프롬프트 본문은 Amazon S3에 저장합니다. 이처럼 각 파드가 자체적으로 상태를 보관하지 않는 스테이트리스(Stateless) 구조를 적용함으로써, 파드가 추가되거나 교체되더라도 동일한 정보를 참조해 요청을 처리할 수 있습니다. 이를 통해 트래픽 증가 시 게이트웨이 파드를 수평으로 확장하면서도 일관된 정책과 처리 기준을 유지할 수 있습니다.
이때 해결해야 할 문제는 비용 데이터의 동시 갱신이었습니다. 여러 파드가 공유하는 예산 카운터를 각각 읽고 갱신하면, 다른 파드가 반영한 증가분을 덮어쓸 수 있습니다. 이를 방지하기 위해 Amazon ElastiCache for Valkey의 Lua 스크립트로 사용자·팀별 카운터를 원자적으로 갱신했습니다. 여러 파드가 동시에 비용을 반영하더라도 집계 값이 어긋나지 않도록 한 것입니다.
하지만 AWS Fargate의 유동성은 네트워크에서 또 다른 과제를 만들었습니다. 사내 IDC 방화벽은 고정 출발지 IP만 허용했지만, AWS Fargate 파드의 출발 IP는 실행될 때마다 달라졌습니다. 이를 해결하기 위해 IDC로 향하는 트래픽이 Private NAT Gateway를 거치도록 구성하고, SNAT를 통해 방화벽에서 식별하는 출발지 주소를 NAT Gateway의 고정 사설 IP로 통일했습니다. 파드가 늘거나 교체되어도 방화벽 규칙을 수정할 필요가 없도록 구성했습니다.
그 결과 운영자의 수동 조작 없이 트래픽에 따라 처리 용량이 확장되고, 파드 수가 변경되더라도 비용 관리 체계와 IDC 연결 정책은 그대로 유지됩니다.
사용량이 늘어나도 인프라 구조를 다시 설계할 필요가 없도록 만든 것이 이 구조의 목표였습니다.
장애는 격리로, 배포는 독립적으로
트래픽 증가에 대응할 수 있는 구조를 마련했다면, 다음은 장애와 배포가 서비스에 미치는 영향을 줄이는 일이었습니다. 게이트웨이에는 모델 호출뿐 아니라 인증, 모델 관리, 사용량 집계, 예산 관리처럼 성격이 다른 기능이 모입니다. 이 기능들이 하나의 실행 단위로 묶여 있으면, 인증 기능을 수정하거나 비용 처리에 문제가 생겼을 때 모델 호출까지 함께 영향을 받을 수 있습니다. 관리 기능의 장애가 실제 AI 사용 중단으로 이어지는 구조는 피해야 했습니다.
이를 위해 게이트웨이를 역할에 따라 분리했습니다.
| 컴포넌트 | 역할 | 장애 시 영향 범위 |
|---|---|---|
| Gateway CLI (개발자 PC) |
사내 SSO 로그인, VK 발급·갱신, Claude Code 연결 설정 | 해당 개발자의 신규 로그인·갱신만 영향. 유효한 VK로 진행 중인 호출은 계속 |
| Admin API | 인증과 VK 발급, 팀·사용자·예산·모델 카탈로그 정책 설정, 프롬프트 열람 | 정책 변경과 신규 발급이 지연. 이미 발급된 VK와 저장된 정책으로 유효한 동안 호출 가능 |
| Gateway Proxy | 요청마다 정책 판정, 프로바이더 어댑터와 변환기 선택, 모델 호출, 카운터 갱신 | 다중 파드로 실행. 한 파드의 장애는 헬스 체크로 제외되고 다른 파드가 처리 |
| Cost Worker | cost:stream의 비용 이벤트를 읽어Amazon Aurora PostgreSQL에 사용 이력과 예산 집계 저장 | 이력 저장만 지연. 모델 응답과 다음 요청의 예산 판단(Valkey)은 영향 없음 |
표 3. 컴포넌트별 역할과 장애 시 영향 범위
이렇게 역할을 나눈 이유는 기능마다 장애의 영향 범위와 복구 시급성이 다르기 때문입니다. 신규 인증이나 정책 변경, 사용 이력 저장에 문제가 생기더라도 기존 사용자의 모델 호출은 이어질 수 있도록 했습니다. 실시간 요청 처리에 필요한 기능과 관리·후속 처리를 분리해, 일부 기능의 장애가 게이트웨이 전체의 중단으로 번지는 범위를 줄였습니다.
이 경계는 배포 단위에도 그대로 적용됩니다. 인증이나 관리 기능을 수정할 때는 Admin API를, 비용 집계 로직을 변경할 때는 Cost Worker를 독립적으로 배포할 수 있습니다. 모델 호출을 담당하는 프록시까지 함께 교체할 필요가 없어, 변경의 영향 범위와 배포 부담이 줄어듭니다.
프록시 자체를 배포할 때는 모델 호출의 연속성을 고려해야 합니다. 여러 파드를 순차적으로 교체하면서 준비된 새 파드로 요청을 전달하고, 기존 파드는 처리 중인 요청을 마친 뒤 종료하도록 하는 방식입니다. 특히 LLM 호출은 스트리밍 응답이 길게 이어질 수 있으므로, 기존 연결을 유지할 수 있는 종료 대기 시간을 함께 고려해야 합니다. 결국 중요한 것은 배포 때문에 사용자의 AI 사용이 중단되지 않는 것이었습니다. 역할 분리를 통해 기능별 독립 배포를 가능하게 하고, 순차적인 트래픽 전환과 종료 제어를 적용해 모델 호출을 유지한 상태에서 새로운 버전을 배포할 수 있도록 했습니다.
전사 AX가 확산되면 사용량뿐 아니라 정책 변경과 기능 개선도 계속 발생합니다. 그때마다 전체 서비스를 멈출 수는 없습니다. 앞 절에서 트래픽 증가에 대응할 수 있는 확장성을 확보했다면, 여기서는 장애와 변경의 영향을 제한하는 운영 구조를 마련했습니다. 관리 기능을 수정하거나 비용 처리 로직을 변경하더라도, 사용자의 모델 호출은 가능한 한 계속 이어질 수 있도록 설계한 것입니다.
4. 로그인 한 번으로 완료하는 개발자 온보딩
안정적인 LLM Gateway를 구축하는 것만으로는 충분하지 않았습니다. 사용자가 실제로 쉽게 사용할 수 있어야 전사 확산으로 이어질 수 있기 때문입니다. 아무리 안정적인 환경을 제공하더라도 로그인과 인증, 연결 설정 과정이 복잡하면 사용자는 새로운 도구를 사용하지 않게 됩니다.
저희는 이러한 진입 장벽을 낮추기 위해 개발자용 CLI 도구인 gateway-cli를 제공했습니다. 인증과 Gateway 연결에 필요한 설정을 gateway-cli 내부에서 처리하여, 개발자가 복잡한 구성을 직접 관리하지 않고도 익숙한 개발 환경에서 필요한 모델을 사용할 수 있도록 했습니다.
결국 개발자에게 필요한 것은 새로운 사용 방법을 배우는 것이 아니라 로그인 한 번이었습니다.
개발자 gateway-cli 자동 업데이트
gateway-cli는 LLM Gateway를 쉽게 사용할 수 있도록 기능을 제공하는 것뿐만 아니라, 배포 이후에도 모든 사용자가 최신 버전을 유지할 수 있도록 관리하는 것이 중요합니다. LLM Gateway는 중앙에서 관리할 수 있지만, gateway-cli는 개발자의 PC마다 설치됩니다. 따라서 배포 이후에는 기능보다 버전 관리가 더 중요한 운영 과제가 되었습니다.
특히 Gateway의 인증 방식이나 지원 모델이 변경되었는데 gateway-cli가 이전 버전에 머물러 있으면 정상적으로 동작하지 않거나 사용자마다 서로 다른 문제가 발생할 수 있습니다. 또한 버전별 문의와 장애 대응이 증가해 운영 부담으로 이어질 수 있습니다.
이를 해결하기 위해 gateway-cli가 실행될 때 최신 버전을 확인하고 필요한 경우 자동으로 업데이트하도록 구성했습니다. 사용자가 직접 버전을 확인하거나 설치 파일을 다시 내려받지 않아도 최신 버전을 유지할 수 있도록 한 것입니다.
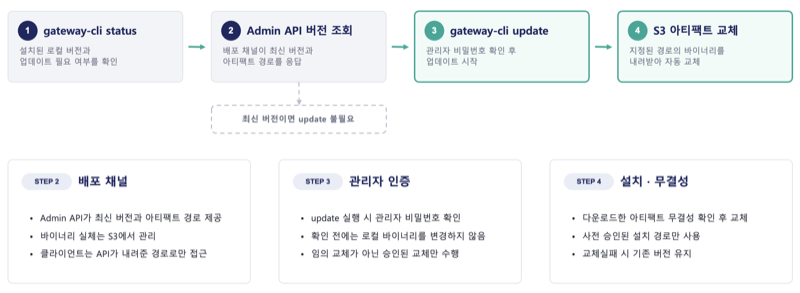
다만 자동 업데이트를 적용하더라도 모든 PC의 gateway-cli가 동시에 최신 버전으로 갱신되는 것은 아닙니다. 사용자가 CLI를 실행하는 시점에 따라 일정 기간 여러 버전이 함께 사용될 수 있기 때문에, LLM Gateway를 변경할 때는 이전 버전의 gateway-cli와의 호환성도 함께 고려해야 합니다.
자동 업데이트는 이러한 버전 차이를 완전히 없애는 것이 아니라, 사용자가 업데이트를 의식하지 않아도 최신 버전으로 자연스럽게 전환되도록 만드는 방식입니다. 개발자는 설치 파일을 다시 찾을 필요가 없고, 운영자는 모든 사용자에게 업데이트를 안내할 필요가 없습니다.
설정 불필요한 개발자 온보딩
개발자가 기억해야 할 것은 키의 만료일이 아니라 gateway-cli login 명령어 하나입니다. gateway-cli login 명령어 하나로 사내 SSO 인증부터 VK 발급, Claude Code 연결까지 한 번에 처리할 수 있도록 했습니다. 개발자가 브라우저에서 사내 SSO 인증을 완료하면 gateway-cli는 전달받은 ID 토큰으로 Admin API에 VK 발급을 요청합니다. Gateway는 사용자와 팀 정보를 확인해 VK를 발급하고, gateway-cli는 발급받은 VK와 Gateway 접속 정보를 Claude Code에 자동으로 설정합니다.
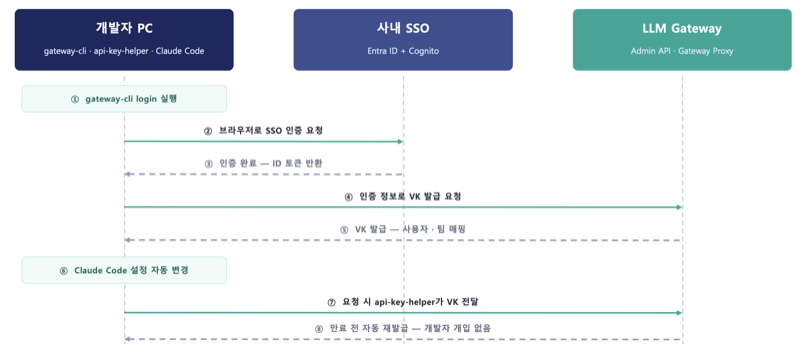
VK가 만료되더라도 사용자가 직접 키를 다시 발급받거나 설정을 변경할 필요는 없습니다. 이를 위해 api-key-helper를 구성해 gateway-cli가 VK를 자동으로 갱신하도록 했습니다. 개발자는 키를 복사해 설정 파일이나 환경 변수에 입력하거나, 만료일을 확인해 교체할 필요가 없습니다. 이 흐름을 개발자의 작업 기준으로 정리하면 다음과 같습니다.
| 단계 | 개발자가 하는 일 | 자동으로 처리되는 내용 |
|---|---|---|
| 로그인 | gateway-cli login 실행 후 사내 SSO 로그인 | 로그인 결과를 확인해 VK 발급 |
| 연결 설정 | 별도 작업 없음 | Claude Code의 접속 주소를 게이트웨이로 변경하고 키 전달 기능 설정 |
| 모델 사용 | 평소처럼 Claude Code 사용 | 요청에 필요한 VK를 Claude Code에 전달 |
| 키 갱신 | 별도 작업 없음 | VK 만료 전에 재발급 |
표 4. 사내 SSO 로그인과 Claude Code 연결 과정
개발자에게 필요한 것은 로그인뿐이지만, 사용 권한과 예산에 대한 통제는 그대로 유지됩니다. 사내 계정으로 확인된 사용자 및 팀 정보를 바탕으로 게이트웨이의 정책이 적용되고, 개발자는 할당된 예산 안에서 평소처럼 Claude Code를 사용할 수 있습니다.
전사 확산에서 중요한 것은 처음 연결하는 순간의 편의성과 이후 사용의 연속성입니다. 로그인부터 연결 설정, 키 갱신까지 자동화함으로써 반복적인 관리 작업을 줄였습니다. 개발자는 인증 정보를 관리하는 대신 개발에 집중하고, 조직은 거버넌스를 유지할 수 있도록 한 것입니다.
5. 마치며
이번 AWSome AI Gateway 기반의 LLM Gateway 구축을 통해 모델별로 분산되어 있던 접근 경로를 하나로 통합하고, 인증·예산·모델 전환·호출량 제한·사용 이력 기록 등의 정책을 모든 LLM 요청에 일관되게 적용할 수 있는 기반을 마련했습니다. 또한 사용자와 AI 에이전트의 인증 방식을 구분하고, 예산 소진 시 사내 오픈모델로 전환하며, 개발자 CLI를 통해 인증과 개발 도구 연결을 간소화하는 등 실제 사용 과정에서 필요한 부분도 함께 구현했습니다.
설계 과정에서는 중앙 게이트웨이에 트래픽이 집중되는 만큼 확장성과 가용성을 함께 고려했습니다. 요청 처리 영역을 스테이트리스(Stateless) 구조로 구성하고 상태 데이터를 외부 저장소에 분리했으며, 트래픽 변화에 따라 처리 용량을 자동으로 확장할 수 있도록 구성했습니다. 즉, 정책을 한곳에서 관리하되 실제 요청 처리는 유연하게 확장할 수 있는 구조를 만드는 데 중점을 두었습니다.
유사한 환경에서 LLM Gateway 도입을 검토한다면 기술이나 제품을 먼저 선택하기보다 조직에서 어떤 LLM 사용을 허용하고, 무엇을 통제하고 기록할 것인지부터 정의하는 것이 중요합니다. 사용할 모델과 사용자·서비스 계정의 인증 방식, 예산 정책, 데이터 저장 범위와 같은 기준이 정해지면 이를 게이트웨이의 정책과 아키텍처로 구체화할 수 있습니다.
AWSome AI Gateway를 기반으로 여러 모델을 연결하는 단일 엔드포인트에서 출발했지만, 이번 구축에서는 이를 전사의 LLM 사용 정책을 실제 요청에 적용하고 운영할 수 있는 중앙 게이트웨이로 확장했습니다. 앞으로도 다양한 모델과 AI 에이전트가 추가되는 환경에서 동일한 기준을 유지하며 확장할 수 있는 기반으로 발전시켜 나갈 계획입니다.
< 참고 링크 >
- Amazon Bedrock 위에 사내 LLM Gateway 구축하기: Claude Code, Codex를 위한 인증·비용·거버넌스
- AWSome AI Gateway 오픈소스 레파지토리
조대휘
CJ올리브네트웍스에서 AX 기술혁신을 수행하고 있습니다. 클라우드와 DevOps 경험을 바탕으로 LLM Gateway, AI Agent Platform 등 생성형 AI를 엔터프라이즈 환경에 적용하기 위한 공통 플랫폼을 설계하고 구축합니다. 실제 개발과 업무에 안정적으로 확산할 수 있는 AI기술과 운영 체계에 관심이 많습니다.
이향아
소프트웨어 엔지니어로 커리어를 시작해 다양한 디지털 서비스와 플랫폼 구축을 경험했으며, 현재는 CJ올리브네트웍스에서 기업의 AI 전환(AX)을 위한 전략과 실행을 연결하는 역할을 수행하고 있습니다. 현장이 겪는 과제 속에서 혁신을 이룰 기회를 발굴하고, 이를 기술로 구현하며 검증하는 과정에 집중하고 있습니다. 기술과 비즈니스를 연결하여 조직의 업무 혁신을 이끄는 AX 엔지니어로 성장하는 것을 목표로 하고 있습니다.