AWS 기술 블로그
AWS Elemental MediaConvert와 Amazon Bedrock으로 VOD 자동 챕터 생성하기
10분이 넘는 영상에서 다시 보고 싶은 장면을 찾으려면 시청자는 프로그레스바를 이리저리 옮겨 가며 더듬어야 합니다. 영상이 주제별 챕터로 나뉘어 있으면 시청자는 제목과 썸네일을 보고 원하는 구간으로 바로 이동할 수 있습니다. 서비스 입장에서도 챕터 제목과 요약은 영상 속 내용을 설명하는 메타데이터가 되어, 구간 단위 검색이나 추천 같은 기능으로 이어갈 수 있습니다. 다만 업로드되는 영상이 늘어날수록, 모든 영상에 일관된 품질의 챕터를 빠르게 생성하는 방법이 필요해집니다.
챕터를 자동화하려고 해도 문장(스크립트)으로는 부족합니다. 화면이 바뀐 시각(샷 전환)은 정확하지만 그것만으로는 “내용이 바뀐 지점”을 알 수 없고, 음성 인식 결과를 생성형 AI에 맡기면 주제는 잘 나누지만 AI가 말한 시각이 화면 전환과 어긋나 챕터를 눌렀을 때 이전 장면이 잠깐 보이거나 말이 중간에 끊긴 채 재생됩니다. 영상의 챕터는 “무슨 이야기를 했는가”와 “화면이 언제 바뀌었는가”를 함께 볼 때 비로소 자연스럽게 나눌 수 있습니다.
이 블로그에서 사용하는 주요 서비스는 AWS Elemental MediaConvert, Amazon Transcribe, Amazon Bedrock입니다.
이 블로그는 VOD 서비스에 자동 챕터 기능을 넣고 싶을 때, 세 서비스를 조합해 “AI가 시각을 만들지 않고, 화면 전환 후보 중에서 고르게 하는” 방식으로 챕터 경계·제목·요약을 자동으로 만드는 방법과, 구현 과정에서 얻은 인사이트를 설명합니다.
솔루션 개요
핵심 아이디어는 문제를 “생성”에서 “선택”으로 바꾸는 것입니다. MediaConvert가 트랜스코딩하면서 찾아 준 샷 전환 시각을 후보 목록으로 주고, Amazon Bedrock에게는 “챕터 시작은 반드시 이 목록 중 하나여야 한다”고 제약합니다. AI는 음성 스크립트를 읽고 어디서 주제가 바뀌는지 판단해 후보 중 일부를 고르고 제목과 요약을 씁니다. 고른 값이 곧 화면 전환 시각이므로 챕터 경계가 화면과 어긋나지 않습니다.
문장(스크립트)만으로 분석하면 “무슨 이야기를 했는지”는 알 수 있지만, 영상이 실제로 어떻게 편집되어 있는지는 알 수 없습니다. 여기에 MediaConvert가 트랜스코딩 과정에서 함께 만들어 주는 화면 전환 정보를 더하면, 영상의 편집 구조라는 별도의 신호가 생깁니다. 내용의 흐름과 화면의 흐름이 함께 바뀌는 지점을 챕터 경계로 삼을 수 있어, 텍스트만 쓸 때보다 시청자가 실제로 눌렀을 때 훨씬 자연스러운 챕터를 얻을 수 있습니다.
| 서비스 | 역할 |
|---|---|
| AWS Elemental MediaConvert | 재생용 HLS를 만들면서 샷 전환 시각(후보 목록)과 썸네일 타일을 함께 출력 |
| Amazon Transcribe | 음성을 타임코드가 붙은 문장으로 변환 |
| Amazon Bedrock | 후보 목록과 스크립트를 함께 읽고 챕터 경계를 선택, 제목·요약 작성 |
| AWS Step Functions | 트랜스코딩 → 분석 → 챕터 생성 → 저장 흐름을 자동으로 실행 |
표 1. 주요 서비스와 역할
전체 구성은 서버리스 관리형 서비스로만 이루어지며, 영상을 업로드하면 이후 과정에 사람이 개입하지 않습니다.
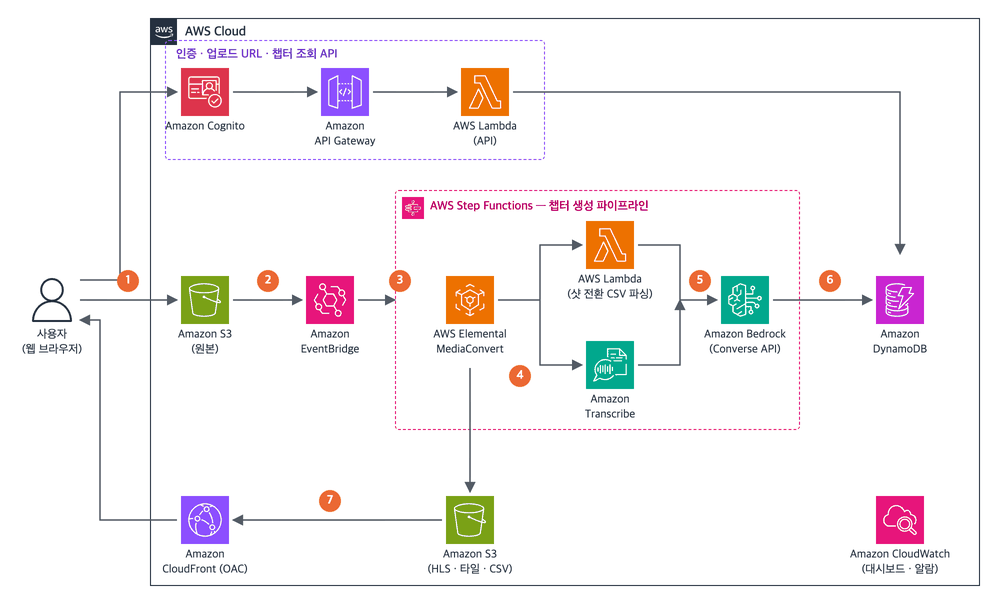
그림 1. VOD 자동 챕터 생성 아키텍처
- 사용자가 Amazon Cognito로 로그인한 뒤 원본 영상을 Amazon S3에 업로드합니다.
- Amazon EventBridge가 업로드 이벤트를 받아 AWS Step Functions 워크플로를 시작합니다.
- AWS Elemental MediaConvert 잡 하나가 재생용 HLS, 썸네일 타일, 샷 전환 리포트(화면이 바뀐 프레임 번호를 기록한 CSV 파일), 음성 추출 파일을 만듭니다.
- 샷 전환 리포트 파싱과 Amazon Transcribe 음성 인식을 동시에 실행합니다.
- Amazon Bedrock이 후보 목록 안에서 챕터를 고르고 제목·요약을 작성하면, 코드가 규칙을 한 번 더 확인합니다.
- 완성된 챕터를 Amazon DynamoDB에 저장합니다.
- 시청자는 Amazon CloudFront를 통해 영상과 썸네일을 재생합니다.
단계 요약
자동 챕터는 “후보 만들기 → 고르기 → 확정하기 → 보여 주기”의 네 단계로 만들어집니다.
- 단계 1 : MediaConvert로 샷 전환 후보와 재생용 출력을 한 번에 만듭니다.
- 단계 2 : Amazon Bedrock이 후보 안에서 챕터를 고르도록 프롬프트를 구성합니다.
- 단계 3 : AI가 낸 결과를 코드로 한 번 더 확인해 챕터를 확정합니다.
- 단계 4 : 썸네일 타일로 챕터를 탐색하는 경험을 완성합니다.
사전 준비사항
이 블로그의 구성을 직접 적용해 보려면 아래 사항이 필요합니다.
- AWS 계정과 MediaConvert, Transcribe, Bedrock을 지원하는 리전
- Amazon Bedrock 모델 액세스 — Converse API를 지원하는 모델이면 되며, 콘텐츠의 종류에 따라서 다양한 모델을 선택적으로 사용할 수 있습니다.
- 음성이 포함된 테스트 영상 — 예능, 강의, 웨비나, 대담처럼 말로 내용이 진행되는 영상이 챕터 결과를 확인하기 좋습니다.
- S3, Lambda, Step Functions, DynamoDB 등 서버리스 서비스에 대한 기본 지식
단계 1 : MediaConvert로 샷 전환 후보 만들기
MediaConvert에는 이름이 비슷한 두 설정이 있어 혼동하기 쉽습니다. SceneChangeDetect는 화면 전환 지점에 키프레임을 넣어 주는 인코딩 옵션일 뿐, 전환 시각을 알려 주지는 않습니다. 전환 시각 목록을 얻으려면 Per-frame metric reports 기능에서 SHOT_CHANGE를 지정해야 합니다.
이 블로그에서 말하는 리포트는 MediaConvert의 Per-frame metric reports 기능이 트랜스코딩 결과와 함께 S3 출력 폴더에 저장하는 프레임 단위 분석 결과 CSV 파일을 뜻합니다. 원래는 PSNR, SSIM, VMAF 같은 화질 지표를 프레임별로 기록하는 기능인데, SHOT_CHANGE를 지정하면 화면이 전환된 프레임의 번호가 {출력명}_SHOT_CHANGE.csv 파일에 기록됩니다(이하 샷 전환 리포트). 별도의 영상 분석 도구 없이, 어차피 수행하는 트랜스코딩에서 이 정보를 얻을 수 있다는 점이 핵심입니다.
Display_ID,Value      ← Display_ID: 화면이 전환된 프레임 번호
0,1.00
1447,1.00
1755,1.00
...
Average: 1.00         ← 파일 끝의 요약 행 (파싱 시 제외)
이 단계에서는 아래 절차를 따릅니다.
- MediaConvert 잡 하나에 출력 그룹 4개(재생용 HLS, 분석용, 음성용, 포스터)를 구성합니다.
- 분석용 480p 출력에만
PerFrameMetrics: SHOT_CHANGE를 켭니다. 이 옵션은 처리 시간을 늘리므로 시청자에게 전달되는 HLS 출력에는 켜지 않습니다. - 모든 비디오 출력에 SceneChangeDetect를 켜서, 챕터로 점프했을 때 화면이 깨지지 않게 합니다.
- 생성된 CSV에서 전환 프레임 번호를 읽어 초 단위 후보 목록으로 바꿉니다.
'H264Settings': {
    'SceneChangeDetect': 'TRANSITION_DETECTION',   # 전환 지점에 키프레임 삽입
    'PerFrameMetrics': ['SHOT_CHANGE'],            # 전환 시각 리포트 (분석용 출력에만)
}
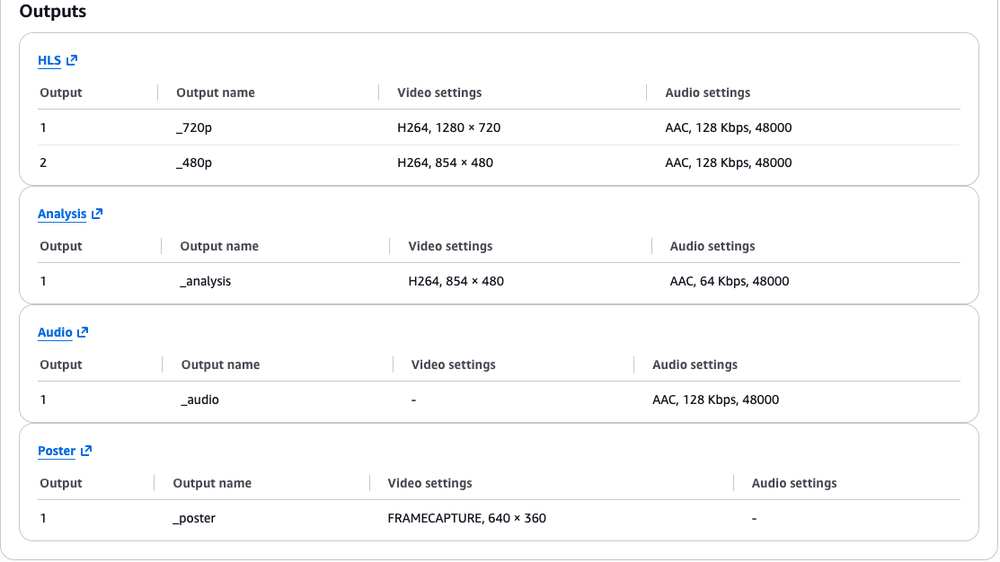
그림 2. MediaConvert 콘솔 — 잡 하나에 구성한 4개 출력 그룹
잡을 여러 개로 나누지 않고 하나로 유지하면 원본을 한 번만 읽고, 완료 시점도 하나로 판단할 수 있어 워크플로가 단순해집니다.
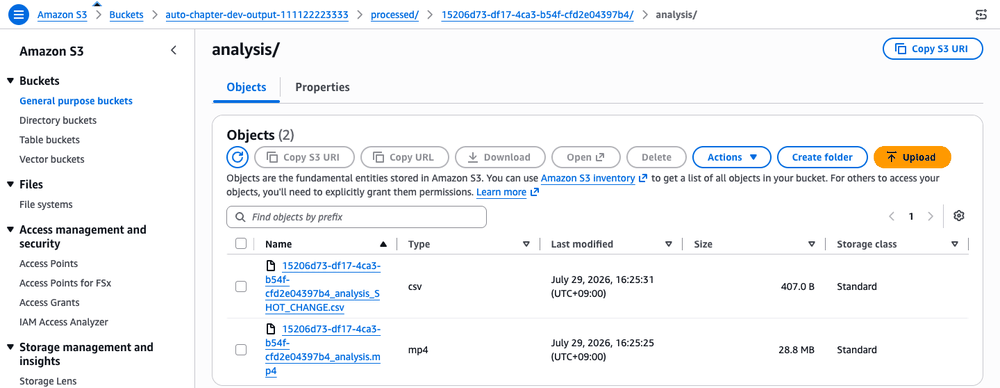
그림 3. Amazon S3 콘솔 — 분석용 출력 폴더에 생성된 SHOT_CHANGE.csv
참고: 프레임레이트는 추정하지 말고 확정된 값을 사용해야 합니다.
샷 전환 리포트에는 전환이 일어난 프레임 번호만 들어 있으므로, 초 단위로 바꾸려면 프레임레이트가 필요합니다. 이때 리포트의 마지막 프레임 번호는 영상의 전체 프레임 수가 아니라 마지막 전환 지점이라는 점에 주의해야 합니다. 이 값으로 프레임레이트를 역산하면 실제보다 작게 계산되고, 그림 4처럼 영상 뒤로 갈수록 전환 시각이 점점 늦게 기록됩니다. 프레임레이트는 출력 설정에 명시한 값이나 HLS 매니페스트의 FRAME-RATE 값을 그대로 쓰는 것이 안전합니다.
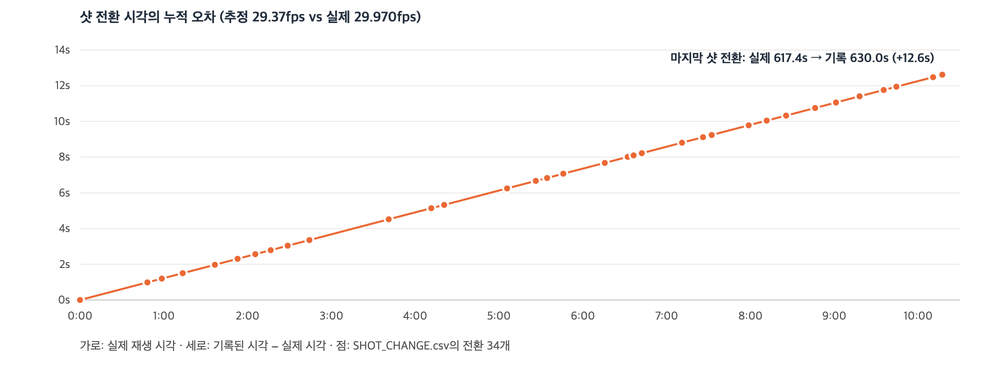
그림 4. 프레임레이트를 잘못 계산했을 때 샷 전환 시각에 누적되는 오차 (29.970fps 영상 예시)
단계 2 : Amazon Bedrock이 후보 안에서 챕터를 고르게 하기
Amazon Transcribe로 얻은 음성 스크립트와 단계 1의 후보 목록을 하나의 프롬프트에 담아 Amazon Bedrock을 호출합니다. 이 블로그에서는 테스트를 위해서 Claude Sonnet 4.6 모델을 사용했습니다. 호출에는 Converse API를 사용했습니다. 여러 모델을 같은 요청 형식으로 다룰 수 있어, 더 나은 모델이 나오면 모델 ID만 바꿔 교체할 수 있습니다.
이 단계에서는 아래 절차를 따릅니다.
- 음성 스크립트의 문장마다 [분:초] 타임코드를 붙입니다. 타임코드가 있어야 AI가 “어느 시점에 주제가 바뀌는지”를 숫자로 말할 수 있습니다.
- 프롬프트에 영상 길이와 목표 챕터 수, 샷 전환 후보 목록, 타임코드 스크립트, 작업 규칙을 차례로 넣습니다.
- “챕터 시작은 반드시 후보 목록 중 하나”라는 규칙을 명시합니다. 이 한 문장이 이 솔루션의 핵심입니다.
- 결과는 JSON으로만 받도록 요청합니다.
## 씬 체인지 후보 시각 (초)
챕터 시작 시각은 반드시 이 목록의 값 중 하나여야 합니다.
0.0, 48.3, 58.6, 73.5, 96.6, 112.8, 125.5, ...

## 음성 스크립트 (타임코드 포함)
[00:11] (진행자가 행사와 출연자를 소개하는 문장) ...
[00:53] (출연자가 자신의 역할을 설명하는 문장) ...

## 작업 규칙
1. 챕터 시작 시각은 위 후보 목록의 값 중에서만 선택하세요.
2. 첫 챕터는 반드시 0초에서 시작합니다.
3. 각 챕터는 최소 15초 이상이어야 합니다.
4. 제목은 60자 이내로 구체적으로 쓰고, "소개", "본문" 같은 일반적인 단어만 쓰지 마세요.

## 출력 형식
{"chapters": [{"startSec": 0, "title": "제목", "summary": "요약", "confidence": 0.9}]}
위의 작업 규칙은 하나의 예시이며, 콘텐츠의 종류에 따라 달라질 수 있습니다. 강의나 웨비나처럼 한 주제가 길게 이어지는 영상은 최소 챕터 길이를 늘리고, 예능이나 스포츠 하이라이트처럼 컷이 잦은 영상은 목표 챕터 수를 늘리거나 제목 스타일을 바꾸는 식으로 조정합니다. 제목과 요약의 출력 언어도 “한국어로 작성하세요”처럼 규칙에 명시해 두면 영상의 언어와 관계없이 일관된 결과를 얻을 수 있습니다.
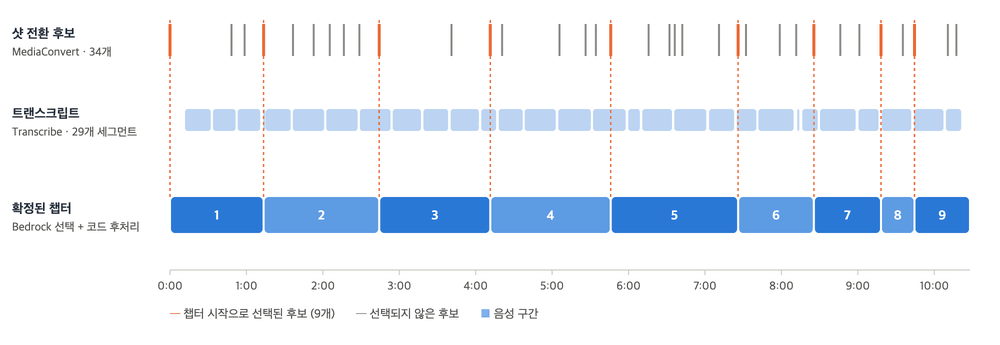
그림 5. 샷 전환 후보 중 일부를 챕터 시작으로 선택한 예시
그림 5처럼 AI는 스크립트를 근거로 여러 후보 중 일부만 챕터 시작으로 고르며, 모든 챕터는 후보 목록의 값, 즉 화면 전환 지점에서 시작합니다.
단계 3 : AI 결과를 코드로 확정하기
AI의 출력은 대부분 규칙을 잘 지키지만 항상 그렇다고 보장할 수는 없습니다. 그래서 규칙으로 표현할 수 있는 것은 프롬프트에 쓰는 것과 별개로 코드가 한 번 더 강제합니다. 이렇게 하면 모델을 바꾸더라도 결과 품질의 최저선이 유지됩니다.
이 단계에서는 아래 절차를 따릅니다.
- AI가 낸 시작 시각을 가장 가까운 샷 전환 후보로 맞춥니다. 단, 5초 이상 떨어져 있으면 억지로 옮기지 않습니다.
- 시작 시각 순으로 정렬하고, 첫 챕터를 0초로 고정합니다.
- 15초보다 짧은 챕터는 앞 챕터에 합칩니다.
- 각 챕터의 종료 시각(다음 챕터의 시작 시각)을 계산해 저장합니다.
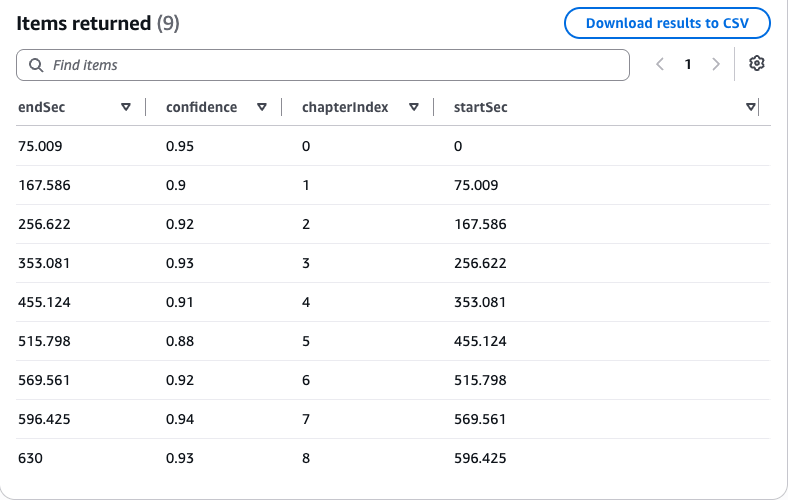
그림 6. Amazon DynamoDB 콘솔 — 저장된 챕터의 시작·종료 시각과 confidence
AI 호출이 실패하는 경우도 대비합니다. 이때는 후보 목록을 균등하게 나누어 “챕터 1, 2, 3” 형태의 기본 챕터를 만들어, 파이프라인 전체가 실패하지 않도록 합니다. 이렇게 만든 챕터에는 confidence를 낮은 고정값(예: 0.3)으로 기록해 두는 것이 필요합니다. AI가 스크립트를 근거로 만든 챕터와 기계적으로 나눈 챕터가 같은 형태로 저장되기 때문에, 이 값이 없으면 화면이나 처리 상태만으로는 둘을 구분할 수 없습니다. 고정값을 기준으로 모니터링하면 “성공처럼 보이지만 품질이 낮은” 처리 건을 나중에 찾아 다시 처리할 수 있습니다.
단계 4 : 썸네일 타일로 탐색 경험 완성하기
자동 챕터에는 챕터 목록에 보여 줄 챕터 단위의 대표 썸네일도 필요합니다. 시청자는 제목과 함께 그 구간의 장면을 보고 원하는 챕터를 고르기 때문입니다. 또한 챕터 안에서 원하는 장면을 찾으려면 프로그레스바에 마우스를 올렸을 때 미리보기가 보여야 합니다. 이 두 가지를 챕터마다 이미지를 따로 추출하지 않고 한 번에 해결할 수 있습니다. MediaConvert HLS 출력의 이미지 기반 트릭플레이 기능을 켜면, 일정 간격으로 뽑은 썸네일을 한 장의 격자 이미지(타일)로 묶어 함께 만들어 줍니다.
이 단계에서는 아래 절차를 따릅니다.
- HLS 출력 그룹에서 이미지 기반 트릭플레이를 켜고, 5초 간격·320×180 크기·5×6 격자로 설정합니다.
- 플레이어는 HLS 매니페스트에서 썸네일용 플레이리스트를 찾아, 각 타일 이미지가 담당하는 시간 구간을 읽습니다.
- 마우스 위치의 재생 시각에 해당하는 타일과 칸을 찾아 CSS로 그 부분만 잘라 보여 줍니다.
- 챕터 시작 시각에 해당하는 칸을 그대로 챕터 목록의 대표 썸네일로 사용합니다. 챕터용 이미지를 따로 만들 필요가 없습니다.
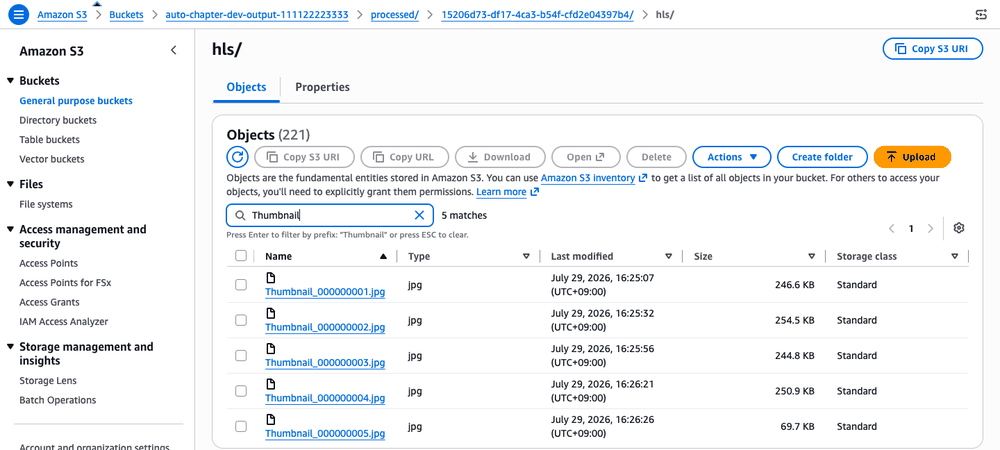
그림 7. Amazon S3 콘솔 — HLS 출력 폴더에 생성된 타일 이미지
썸네일을 개별 이미지로 만들면 1시간 영상에서 720개 파일이 생기지만, 타일로 묶으면 24개로 줄어듭니다. 개별 이미지는 마우스를 움직일 때마다 새 이미지를 요청해야 하지만, 타일은 한 번 내려받으면 그 안의 30칸(약 150초 분량)을 추가 요청 없이 바로 보여 줄 수 있어 미리보기가 끊기지 않습니다. CloudFront 입장에서도 캐시할 객체 수가 적고 같은 타일이 여러 시청자에게 반복해서 쓰이므로 캐시 적중률이 높아집니다.
간격을 5초로 설정해도 MediaConvert는 프레임 단위로 맞추기 때문에 실제 간격은 5.005초였습니다. 설정값 5초로 계산하면 100초 지점에서 이미 한 칸 옆 썸네일이 보이고, 영상이 길수록 어긋남이 커집니다. 매니페스트에 기록된 실제 간격을 쓰고, 각 타일의 시작 시각을 기준으로 칸을 계산하면 이런 오차가 생기지 않습니다.
#EXTINF:150.150,
#EXT-X-TILES:RESOLUTION=320x180,LAYOUT=5x6,DURATION=5.005
Thumbnail_000000001.jpg
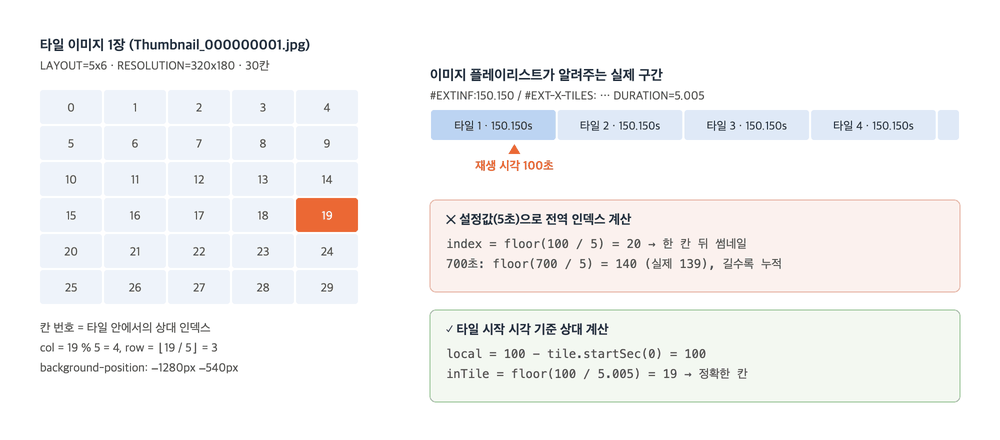
그림 8. 타일 이미지에서 재생 시각에 맞는 칸을 찾는 방법
전체 흐름 확인하기
단계 1~4는 AWS Step Functions 워크플로 하나로 이어집니다. 아래 그림처럼 트랜스코딩이 끝나면 샷 전환 리포트 분석과 음성 인식이 동시에 진행되고, 두 결과가 모이면 챕터 생성과 저장이 차례로 실행됩니다. 어느 단계에서든 오류가 나면 실패 처리 단계로 분기해 처리 상태를 기록합니다.
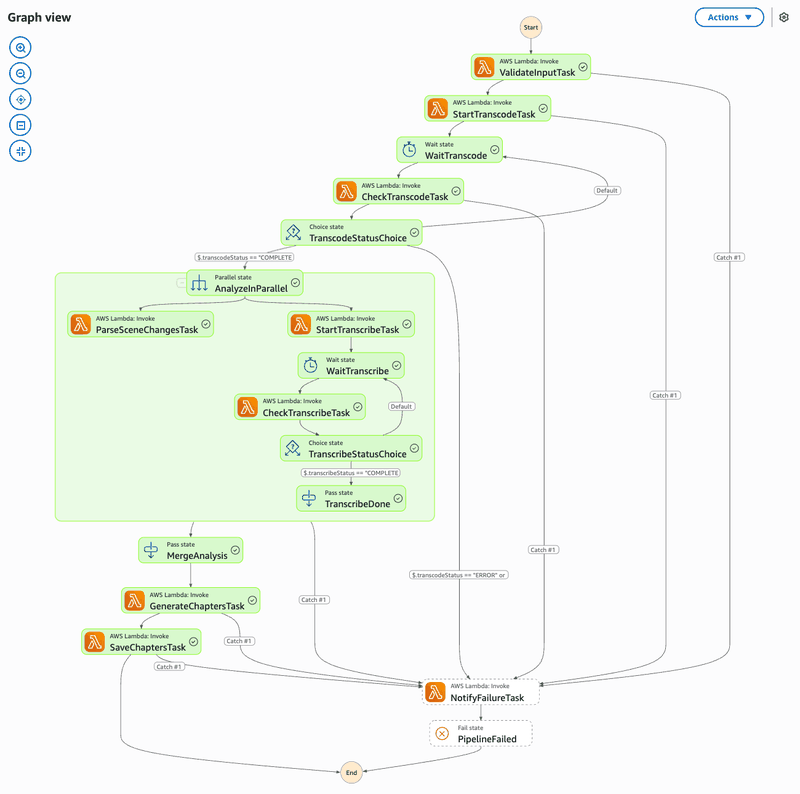
그림 9. AWS Step Functions 콘솔 — 챕터 생성 워크플로 실행 그래프
처리 시간은 영상과 설정에 따라 달라지며, 단계별로 영향을 주는 요소는 다음과 같습니다.
| 단계 | 처리 시간에 영향을 주는 요소 |
|---|---|
| MediaConvert 트랜스코딩 | 영상 길이와 해상도, 출력 그룹·렌디션 수, Per-frame metric 사용 여부 |
| Amazon Transcribe 음성 인식 | 음성 길이 (트랜스코딩 결과의 샷 전환 분석과 병렬로 실행) |
| Amazon Bedrock 챕터 생성 | 스크립트 길이, 후보 개수, 생성할 챕터 수, 사용하는 모델 |
표 2. 단계별 처리 시간 영향 요소
리소스 정리하기
이 블로그의 내용을 직접 구성해 검증했다면, 불필요한 과금을 막기 위해 사용한 리소스를 삭제하세요. 특히 MediaConvert 출력(HLS 세그먼트, 타일 이미지, 분석용 출력)은 영상마다 많은 파일을 만들고, CloudFront 배포와 S3 버킷은 사용하지 않는 동안에도 남아 있습니다. 실험용 리소스에 공통 태그나 이름 접두사를 붙여 두면 한 번에 찾아 정리하기 쉽습니다.
결론
이 블로그에서는 AWS Elemental MediaConvert, Amazon Transcribe, Amazon Bedrock을 조합해 별도의 영상 분석 인프라 없이 VOD 챕터를 자동으로 만드는 방법을 살펴보았습니다. 영상을 업로드하면 사람이 개입하지 않고도 제목과 요약이 붙은 챕터와 미리보기 썸네일이 준비됩니다.
- 이미 하는 트랜스코딩을 재활용 — 샷 전환 후보와 썸네일을 같은 MediaConvert 잡에서 함께 얻습니다.
- 문장과 화면을 함께 분석 — 스크립트만이 아니라 MediaConvert의 화면 전환 정보를 함께 쓰면, 내용과 편집 구조가 함께 바뀌는 지점을 챕터로 삼을 수 있습니다.
- 생성이 아니라 선택 — AI가 후보 목록 안에서 고르게 하면 챕터 경계가 화면 전환과 어긋나지 않습니다.
- 규칙은 코드로 확인 — 모델을 바꾸더라도 결과 품질의 최저선이 유지됩니다.
- 추정하지 말고 확인된 값 사용 — 프레임레이트, 썸네일 간격처럼 당연해 보이는 값도 매니페스트에서 읽어야 합니다.
챕터 제목과 요약이 쌓이면 영상 속 내용을 검색하거나, 비슷한 구간을 추천하는 기능으로도 확장할 수 있습니다. 챕터 품질은 콘텐츠 성격에 따라 달라지므로, 보유한 영상 일부로 먼저 검증해 보시기를 권합니다.