AWS 기술 블로그
ParallelCluster 잘 쓰고 있는데, 왜 AWS PCS인가? (2부) — 워크로드별 적용과 전환 실전 가이드
이 글은 2부입니다. 1부에서는 AWS PCS가 무엇이고(관리형 Slurm), 왜 필요하며, 요금이 어떻게 구성되는지를 다뤘습니다. 아직 1부를 보지 않으셨다면 개념과 비용 구조를 먼저 확인하시길 권합니다. 2부에서는 내 워크로드(CFD/CAE, 분산 트레이닝)에 PCS가 실제로 어떤 변화를 주는지, 하나의 클러스터로 통합하는 멀티 큐, AWS ParallelCluster에서 PCS로의 전환 가이드, 그리고 도입 사례를 살펴봅니다.
시리즈 블로그 보기
- ParallelCluster 잘 쓰고 있는데, 왜 AWS PCS인가? (1부) — 관리형 Slurm의 가치와 비용 구조
- ParallelCluster 잘 쓰고 있는데, 왜 AWS PCS인가? (2부) — 워크로드별 적용과 전환 실전 가이드
1. CFD/CAE 등 전통적 과학, 엔지니어링 워크로드 운영을 고려하는 고객이라면
AWS 클라우드 환경에서 자동차 충돌 해석, 유체 해석, 구조 해석 같은 시뮬레이션은 Slurm 클러스터에서 상용 솔버로 수행되는 경우가 대부분입니다. 이 영역 고객의 질문은 명확합니다. “무료 ParallelCluster를 잘 쓰고 있는데 왜 유료 PCS인가?” 답은 운영 부담과 중단 비용입니다. 그리고 여기서 중요한 것은, 범용 HPC를 위한 관리형 Slurm 선택지가 PCS라는 점입니다. SageMaker HyperPod도 Slurm을 쓸 수 있지만 ML 학습에 특화되어 있어 CFD/CAE 같은 상용 솔버 워크로드에는 적합하지 않습니다. 전통적 HPC에서 현실적인 선택지는 ParallelCluster를 직접 운영하거나 PCS를 사용하는 것, 두 가지입니다.
ParallelCluster와 비교해 CFD/CAE 엔지니어에게 달라지는 것
- 몇 주간 실행 중이던 해석을 다시 시작할 위험이 사라집니다. 며칠씩 이어지는 대규모 과도(transient) 해석이나 최적화 반복 계산이 진행되는 동안 OS와 스케줄러 패치가 배포되어도, 스케줄러는 AWS가 무중단으로 패치하고 노드는 순차적으로(롤링) 교체되어 실행 중인 해석은 끝까지 진행됩니다. ParallelCluster에서는 Slurm 버전을 올리려면 클러스터를 새로 만들어 작업을 옮겨야 했던 부분입니다.
- 스케줄러 다운이 곧 해석 중단이던 구조가 바뀝니다. 헤드 노드 장애를 새벽에 복구하던 일은 AWS 관리 영역으로 넘어가고, 월 99.9% 가동률 SLA가 적용됩니다.
- 팀별 큐가 노드를 공유합니다. 유체 해석 팀과 구조 해석 팀이 각자의 큐를 갖더라도, PCS에서는 두 큐가 같은 노드 그룹을 공유할 수 있어 한 팀이 쓰지 않는 노드를 다른 팀이 바로 사용할 수 있습니다. ParallelCluster처럼 큐마다 노드를 전용으로 갈라 두어 노는 자원이 생기는 일이 줄어듭니다(3장).
- 팀별 사용량 집계(Slurm accounting)도 관리형입니다. ParallelCluster에서는 slurmdbd와 데이터베이스를 직접 운영해야 하지만, PCS는 옵션으로 켜면 AWS가 accounting 데이터베이스를 운영합니다. fair-share 정책이나 팀별 비용 배분의 기반이 됩니다.
옮겨도 그대로 유지되는 것
- 상용 솔버 환경은 대부분 그대로 재사용할 수 있습니다. Fluent, STAR-CCM+ 등 상용 애플리케이션의 라이선스 서버(FlexNet 등)는 고객 VPC나 온프레미스의 외부 리소스로 지금처럼 연결하면 되며, 라이선스 재구성은 필요하지 않습니다. 다만 솔버 바이너리는 배치 위치에 따라 다릅니다. 공유 스토리지(FSx for Lustre, EFS 등)에 설치돼 있으면 해당 파일시스템을 PCS 클러스터에 마운트해 재설치 없이 재사용할 수 있고, 기존에 AMI나 노드 로컬에 설치돼 있었다면 새 AMI에 재설치하거나 공유 스토리지로 옮겨야 합니다.
- 컴퓨트 노드는 여전히 내 계정의 EC2입니다. 인스턴스 선택, 최신 HPC 인스턴스 채택, Savings Plans 같은 구매 구조가 ParallelCluster와 동일하게 유지됩니다.
어떤 경우에 PCS가 유리한가?
- 며칠에서 몇 주 걸리는 장기 해석이 많아 패치나 업그레이드로 인한 중단 비용이 큰 경우
- 스케줄러와 클러스터 인프라를 관리할 전담 인력이 부족한 경우 — 엔지니어가 해석 본업에 집중해야 하는 조직
- 여러 팀이 큐 간에 노드를 유연하게 나눠 쓰고 싶은 경우
반대로 클러스터 노드 개수가 몇 개 안되고 구성이 단순하다면 ParallelCluster를 유지하는 것도 합리적입니다(예외 조건은 4장에서 정리합니다).
2. 분산 트레이닝(ML) 워크로드를 고려하는 고객이라면
대규모 GPU로 모델을 학습하는 고객에게 PCS의 위치는 분명합니다. 표준 Slurm을 그대로 쓰는 관리형 클러스터로, 학습 인프라를 내 계정의 EC2 자원으로 직접 통제하면서 스케줄러 운영만 AWS에 맡기는 선택지입니다. 컴퓨트 노드가 내 계정의 EC2이기 때문에 다음이 가능합니다.
- 기존 EC2 Savings Plans, Reserved Instances, 용량 예약(ODCR), Capacity Blocks를 그대로 적용 – 노드가 EC2 자체이므로 SageMaker용 별도 약정이 필요 없음
- 새로운 GPU 인스턴스를 노드 그룹에 바로 추가
- OS 이미지, 드라이버, 라이브러리를 AMI로 직접 통제
- 스케줄러 가동률에 대한 월 99.9% 서비스 수준 계약(SLA) 적용
- GPU 드라이버, CUDA, EFA 갱신을 학습 중단 없이 롤링으로 반영
SageMaker HyperPod와의 관계
AWS에는 분산 트레이닝을 위한 관리형 선택지로 SageMaker HyperPod도 존재합니다. 두 서비스는 경쟁 관계가 아니라 지향점이 다릅니다. HyperPod는 노드 장애 시 완전한 자동 복구, SageMaker 생태계와의 통합, 주요 모델의 사전 학습 레시피 등 자동화와 편의성에 강점이 있습니다. PCS는 Slurm 기반이라 CFD/CAE 등 전통적 HPC 워크로드와 ML을 한 클러스터에서 함께 운영할 수 있고, 기존 ParallelCluster의 운영 방식과 EC2 약정을 그대로 승계하며, 스케줄러 가동률 SLA를 제공하는 데 강점이 있습니다.
| 이런 상황이라면 | 적합한 선택 |
|---|---|
| 기존 EC2 약정과 할인, 용량 예약을 그대로 활용하고 싶다 | PCS |
| 최신 GPU 인스턴스를 출시 직후 사용하고 싶다 | PCS |
| 스케줄러 가동률 SLA가 필요하다 | PCS |
| 이미 ParallelCluster로 Slurm 클러스터를 운영 중인데, 컨트롤러 운영에 부담을 느낄 때 | PCS |
| 학습과 함께 CFD/CAE 등 전통 HPC 워크로드도 하나의 클러스터에서 운영하고 싶다 | PCS |
| SageMaker Studio와 실험 관리 등 SageMaker 생태계를 이미 쓰고 있다 | HyperPod |
| 노드 장애 시 완전한 자동 복구가 최우선이다 | HyperPod |
| 주요 모델 사전 학습 레시피를 바로 활용하고 싶다 | HyperPod |
표 1. 상황별 선택 가이드 – PCS vs SageMaker HyperPod
3. 하나의 클러스터로 통합 — 멀티 큐 활용
PCS는 하나의 클러스터 안에 여러 큐와 여러 노드 그룹을 둘 수 있습니다. 덕분에 성격이 다른 워크로드를 하나의 관리형 플랫폼에서 함께 운영할 수 있습니다. 이 점은 바로 전통적 과학 애플리케이션과 분산 트레이닝을 모두 연결하는, PCS가 특히 잘 맞는 자리이기도 합니다.
대표적인 예가 완성차 기업입니다. 한 조직 안에 자율주행 모델 학습을 위한 GPU 분산 클러스터와 차량 공력 및 충돌 해석을 위한 CFD/CAE 클러스터가 동시에 필요합니다. 보통은 워크로드마다 별도 클러스터를 만들어 관리 부담이 늘고 자원이 파편화됩니다. PCS에서는 그림1과 같이 GPU 기반 학습 큐와 CPU 기반 시뮬레이션 큐를 하나의 클러스터에 함께 구성할 수 있습니다. 그림1에서는 학습을 reserved-queue와 large-training으로, 시뮬레이션을 FEA-simulation(R8i)과 cfd-simulation(C8i)으로 나눠, 총 4개의 큐를 단일 관리형 스케줄러 위에서 운영합니다. 팀별로 큐를 나눠 자원을 공유하면서 운영은 하나로 단순해집니다. 멀티 큐 자체는 ParallelCluster에서도 구성할 수 있습니다. 따라서 그림1의 개념 자체는 ParallelCluster에서도 동일하게 적용됩니다. 차이는 PCS에서는 하나의 노드 그룹을 여러 큐가 공유할 수 있고, 그 스케줄러를 AWS가 운영한다는 점입니다(그림2 참고).
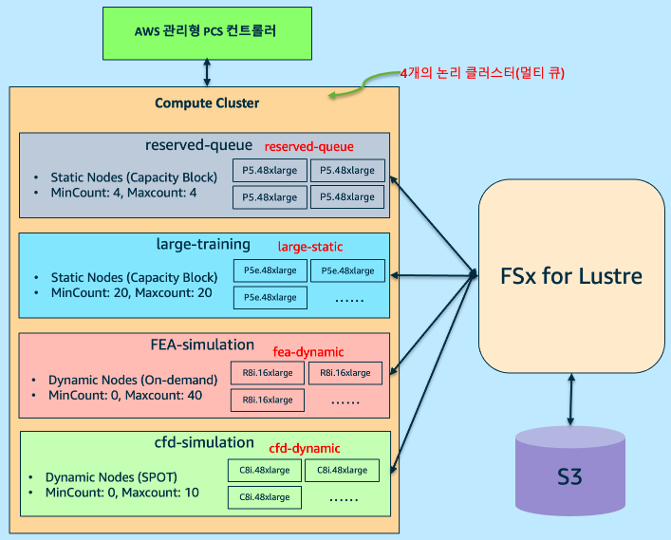
그림 1. 멀티 큐 개념 예 — 하나의 클러스터를 논리적으로 나눈 4개의 큐로, 학습 큐(reserved-queue, large-training)와 시뮬레이션 큐(FEA-simulation, cfd-simulation)를 단일 관리형 스케줄러로 함께 운영
여러 큐가 노드를 공유하는 방식 — ParallelCluster vs PCS
그림1과 같이 하나의 클러스터에서 여러 개의 멀티 큐를 운영한다는 개념은 ParallelCluster나 PCS에서 동일합니다. 다만 공유 방식에는 차이가 존재합니다. 예를 들어, 두 개의 큐(large-training, cfd-simulation)가 그림2와 같이 같은 서버 8대를 함께 쓰고 싶다고 가정해 보겠습니다. ParallelCluster(기존)는 큐마다 서버를 따로 둡니다. 큐마다 노드셋을 따로 정의하고 용량을 미리 갈라 두기 때문에, Queue1이 서버를 다 쓰지 않아 3대가 놀고 있어도 Queue2는 그 3대를 빌려 쓸 수 없습니다. 결국 낭비가 생기고, 헤드 노드(EC2)도 상시 직접 운영해야 합니다.
PCS(신규)는 서버 묶음(노드 그룹) 하나를 두 큐가 공유합니다(M:N). 8대를 통으로 두고 유연하게 나눠 쓰기 때문에, Queue1이 쓰지 않는 서버는 Queue2가 즉시 사용해 낭비가 없습니다(8대 모두 사용). 헤드 노드 없이 AWS가 컨트롤러를 관리합니다.
전제: 두 큐가 ‘같은 노드 그룹(같은 인스턴스 구성, 같은 용량 풀)’을 함께 쓰고 싶을 때의 비교입니다. 아키텍처가 다르거나 별도 용량 풀이 필요하면(예: CPU vs GPU) ParallelCluster와 PCS 모두 노드 그룹(리소스)을 따로 둡니다.
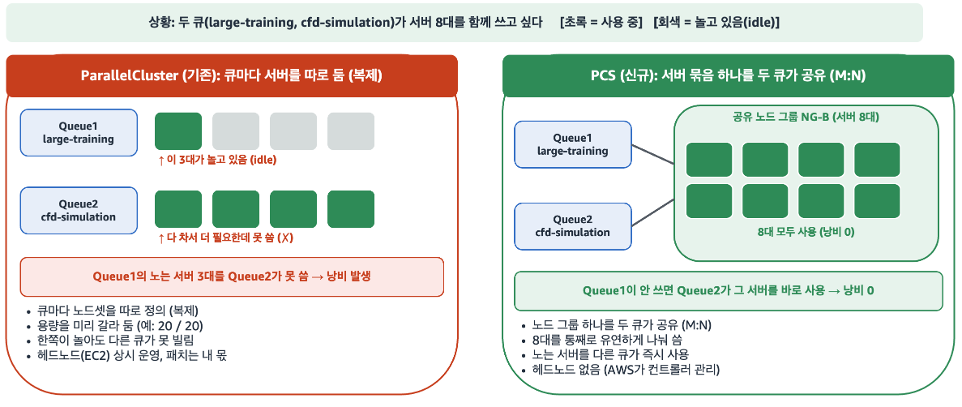
그림 2. 큐 간 리소스 공유: 전용(ParallelCluster) vs 공유(PCS), 이 예시는 큐 2개가 노드 그룹 1개를 공유(M=2, N=1)
4. PCS가 적합하지 않은 경우
모든 워크로드에 PCS가 최선은 아닙니다. 다음과 같은 경우에는 다른 선택이 낫습니다.
- 이미 Kubernetes(Amazon EKS) 기반으로 파이프라인이 구성된 환경 — Slurm 기반인 PCS는 적합한 대상이 아닙니다
- 노드 10대 미만의 소규모 클러스터 — 고정 컨트롤러 비용이 충분히 분산되지 않고, 운영 부담 자체도 크지 않은 경우가 많습니다
- 노드 장애 시 사람 개입 없는 완전한 자동 복구가 최우선인 분산 트레이닝 — SageMaker HyperPod가 더 적합합니다
- Slurm 컨트롤러 자체를 깊게 수정해야 하는 경우 — 컨트롤러가 AWS 관리 영역에 있으므로 ParallelCluster가 맞습니다
- 관리형 서비스 요금 자체를 쓸 수 없는 예산 구조 — 운영 편의성보다는 비용이 최우선일 경우에는 ParallelCluster가 현실적입니다.
5. 과학 애플리케이션을 위한 HPC 클러스터 구축을 AWS에서 새로 시작한다면 — PCS를 기본 추천
지금 AWS에서 HPC 클러스터를 새로 설계하는 고객이라면, 출발점으로 PCS 사용을 권장합니다. 이유는 세 가지입니다.
- 나중에 옮길 일을 만들지 않습니다. ParallelCluster로 시작하면 운영 부담이 쌓인 시점에 PCS로 전환하는 프로젝트를 다시 시작해야 할 수 있습니다(6장). 처음부터 PCS로 시작하면 이 전환 자체가 없습니다.
- AWS는 HPC 클러스터 운영 플랫폼으로 PCS에 무게를 두고 있으며, 새 기능과 개선은 PCS에 우선 반영됩니다. 무중단 메이저 업그레이드 같은 기능이 그 예입니다.
- 서울 리전 제약이 사라졌습니다. 2026년 7월 서울 리전 출시로, 국내 리전 요구 때문에 ParallelCluster를 선택해야 했던 이유가 사라졌습니다.
ParallelCluster가 여전히 나은 예외 조건은 앞 장(4장)에서 정리했습니다. 그 조건에 해당하지 않는다면, 새 클러스터의 기본 플랫폼은 PCS입니다.
6. ParallelCluster에서 PCS로 — 전환 실전 가이드
이미 ParallelCluster로 클러스터를 운영하는 고객에게 가장 중요한 질문은 “무엇이 그대로이고, 무엇을 다시 만들어야 하며, 전환 중에 계산이 멈추는가”입니다. 순서대로 정리합니다.
먼저 두 서비스의 차이를 한눈에 정리하면 다음과 같습니다.
| 핵심 질문 | ParallelCluster (기존) | AWS PCS (신규) |
|---|---|---|
| 관리 서버(헤드 노드)를 누가 운영하나? | 관리용 서버(헤드 노드)를 EC2로 직접 띄우고 운영 및 패치 | 헤드 노드 없음. 스케줄러를 AWS가 대신 운영 (접속은 로그인 노드로) |
| 클러스터를 어떻게 정의하나? | 설정 파일 1개(YAML)로 클러스터 정의 | 클러스터, 노드 그룹, 큐 리소스로 각각 정의 (기존 설정 자동 변환 안 됨) |
| 서버 시작 설정서(런치 템플릿)를 직접 만들어야 하나? | 안 만들어도 됨 (도구가 자동 생성) | 노드 그룹마다 직접 작성해야 함 (필수) |
| 서버 이미지(AMI)에 스케줄러를 누가 설치하나? | AWS 도구(pcluster)가 이미지를 만들 때 스케줄러(Slurm)까지 자동 설치. 단 그 ParallelCluster 버전 전용 | 사용자가 이미지에 PCS 에이전트와 (클러스터 버전에 맞는) Slurm을 AWS 설치 스크립트로 직접 설치해 AMI 생성. pcluster build-image 같은 내장 빌드 명령은 없고, AMI(서버 이미지)를 만드는 자동화는 EC2 Image Builder나 Packer 같은 범용 도구로 구성. 커스텀 빌드 없이 쓰려면 프로덕션용 PCS-ready DLAMI 사용 가능 (샘플 AMI는 데모용, 프로덕션 비권장) |
| 노드에 추가 설정을 어떻게 넣나? | 시작 시 실행할 스크립트를 설정에 넣음 | 이미지에 미리 굽거나 서버 시작 설정서(런치 템플릿)에 넣음 |
| 기존 클러스터를 그대로 전환할 수 있나? | (해당 없음, 이미 쓰던 방식) | 기존 클러스터를 그대로 PCS 환경으로 전환 불가 → 새로 만들어 옮김 (blue/green) |
| 미리 확보한 컴퓨트 용량을 여러 큐가 나눠 쓰나? |
큐마다 전용으로 분리 → 큐 – 리소스 매핑이 더 경직적이라 큐 간 용량 공유 유연성이 PCS보다 떨어짐 |
노드 묶음 하나를 여러 큐가 공유 → 알뜰히 씀 |
| 요금과 관리 방법은? | 서비스 요금 무료 (EC2, 스토리지 비용만). 관리는 주로 pcluster CLI | 관리 요금 (컨트롤러 시간당) 및 노드 관리 요금(인스턴스당 시간당). 관리는 콘솔, API (모니터링 CloudWatch는 둘 다 가능) |
표 2. ParallelCluster → PCS 전환 핵심 비교 (질문으로 짚는 차이점)
공통: 저장소(FSx/EFS/S3)는 그대로 다시 연결하며(데이터 이동 불필요), 작업 실행 스크립트(sbatch/srun)는 대부분 그대로 사용합니다.
PCS로 변경해도 그대로 유지되는 것
- Slurm 그 자체 – 같은 스케줄러이므로 사용자 재교육이 필요 없습니다
- 작업 스크립트와 워크플로 – PCS는 표준 Slurm이므로 sbatch/srun 스크립트와 Slurm 지시문은 대부분 그대로 사용할 수 있습니다. 파티션(큐) 이름이나 커스텀 Slurm 설정을 참조하는 부분만 확인해 조정하면 됩니다.
- OS 이미지, 상용 애플리케이션, 라이선스 서버 – 기존 환경을 유지합니다
- EC2 구매 구조 – Savings Plans, Reserved Instances, 용량 예약, 할인이 그대로 적용됩니다
- 데이터 – FSx for Lustre, EFS, S3를 기존 클러스터와 PCS가 동시에 마운트할 수 있어 데이터 이동이 필요 없습니다
다시 구성해야 하는 것
- 클러스터 인프라 정의 – ParallelCluster 설정 파일을 그대로 가져오는 것이 아니라, PCS API나 콘솔 기준으로 클러스터, 노드 그룹, 큐를 재구성해야 합니다
- 자동 전환 도구는 없습니다 – 원클릭 마이그레이션 도구는 제공되지 않으므로 인프라 재구성은 계획해야 하는 작업입니다
- 노드용 AMI 빌드 – 커스텀 AMI가 필요하면 빌드는 고객 담당입니다(표준 구성은 PCS-ready DLAMI로 대체 가능)
AMI vs 런치 템플릿 – 무엇이 다른가?
AMI는 ‘머신 안의 내용물’, 런치 템플릿은 ‘그 머신을 켜는 방법’입니다. 런치 템플릿이 AMI를 참조합니다.
AMI(서버 이미지)에는 운영체제(OS), PCS 에이전트, 호환 버전의 Slurm, GPU 드라이버와 CUDA, EFA(libfabric)와 NCCL, MPI와 수치 라이브러리, 애플리케이션(예: CFD 솔버) 등이 들어갑니다. 자주 바뀌지 않고 무거운 부분입니다.
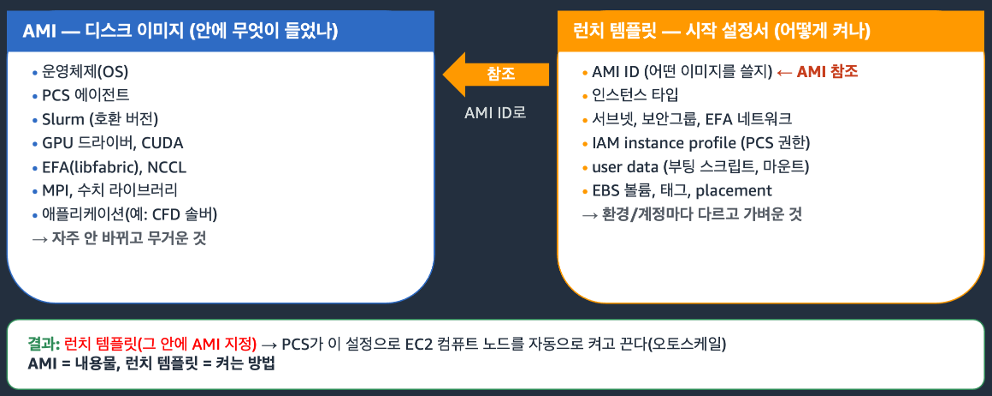
그림 3. AMI와 런치 템플릿의 개념
반면 런치 템플릿(서버 시작 설정서)에는 어떤 AMI를 쓸지(AMI ID 참조), 인스턴스 타입, 서브넷과 보안그룹, EFA 네트워크, IAM instance profile(PCS 권한), user data(부팅 스크립트와 마운트), EBS 볼륨, 태그, placement가 들어갑니다. 환경과 계정마다 다르고 가벼운 부분입니다.
결과적으로 런치 템플릿이 그 안에서 AMI를 지정하고, PCS는 이 설정으로 EC2 컴퓨트 노드를 자동으로 켜고 끕니다(오토스케일).
PCS 전환 권장 방식 – blue/green 컷오버
기존 ParallelCluster 기반 클러스터를 그대로 둔 상태에서 PCS를 병렬로 띄우고 신규 작업부터 옮기는 방식이 가장 안전합니다.
- 기존 ParallelCluster는 그대로 두고 작업을 계속 실행합니다
- 같은 VPC에 PCS 클러스터를 새로 구성하고 스토리지를 공유합니다
- 신규 작업은 PCS로 보냅니다. 기존 클러스터는 신규 접수를 중단하고(drain) 실행 중인 작업만 끝냅니다
- 기존 작업이 모두 완료되면 ParallelCluster를 삭제합니다
실제 PCS 클러스터 구축을 직접 따라 해보려면 AWS가 관리하는 HPC Recipes 라이브러리의 PCS 레시피(recipes/pcs/getting_started)를 활용하면 CloudFormation으로 빠르게 환경을 만들어 검증할 수 있습니다.
7. 도입 사례
다음은 기존에 ParallelCluster를 이용해 클러스터를 운영하다가 PCS로 전환한 대표적인 고객 사례입니다. 두 사례 모두 AWS re:Invent 2025 세션 CMP340 “HPC at Scale with AWS Parallel Computing Service (PCS)”에서 발표된 내용이며, 보다 자세한 내용은 다음의 영상을 참고하시기 바랍니다.
Shell – 지진파 영상화 HPC의 클라우드 전환
Shell은 석유 및 가스 업스트림 탐사에서 지진파 영상화(seismic imaging)에 막대한 컴퓨팅 자원을 사용합니다. 더 복잡한 지역과 심해로 탐사가 확대될수록 필요한 물리 연산이 늘었고, 알고리즘이 발전해도 컴퓨팅 비용이 늘 병목이었습니다. 과거에는 수요를 예측해 대규모 시스템을 미리 구매했지만, 클라우드는 필요할 때 용량을 확보해 더 빠른 의사결정과 비즈니스 가치 창출을 가능하게 합니다. 특히 팬데믹 이후 온프레미스 장비 조달이 어려워지면서 클라우드 도입의 중요성이 더 커졌습니다.
- 초기 시행착오(2017~2022): 클라우드를 도입했지만 온프레미스처럼 소수 노드를 고정적으로 운영하는 방식에 머물러 클라우드의 탄력성을 살리지 못했고, 비용을 줄이려 도입한 스팟 인스턴스도 중단에 대응하는 아키텍처가 없어 작업이 자주 깨지면서, 큰 진전을 얻지 못했습니다.
- 전환점(2022): 핵심 알고리즘인 Full Waveform Inversion(FWI)이 GPU 가속을 지원하게 되면서, 그동안 CPU와 GPU를 섞어 쓰던 구성에서 GPU 중심 구성으로 전환할 수 있었고, 이는 AWS P 시리즈 노드와 잘 맞았습니다. 전체 워크플로를 한 번에 옮기는 대신, 가속이 필요한 구간만 클라우드 GPU로 처리하는 전략을 택했습니다. 또한 “10배 더 빠르게”라는 목표 아래, 기술적으로 구현 가능한지와 비용 대비 사업성이 있는지를 분리해 단계적으로 판단했습니다.
- 프로덕션과 성과: 2022년 12월, P4(A100) 기반 프로덕션으로 클라우드 HPC 여정을 본격 시작했습니다. EC2 Capacity Blocks로 예측 가능한 버스트 용량을 확보해 이후 약 2.5년치 분량의 프로젝트를 가속했고, Shell이 re:Invent 2025에서 공유한 바에 따르면 특정 워크로드 기준으로 PCS에서 3~5배의 지속적인 성능 향상을 달성하며 “10배 더 빠르게”라는 목표에 다가가고 있습니다.
- PCS 전환 경험: ParallelCluster에서 PCS로의 전환은 필요한 기능 요구가 충족된 뒤 비교적 순조로웠고, 사용자 경험도 그대로 유지됐습니다. 특히 노드 그룹, 스팟 인스턴스 통합, 간편한 클러스터 업그레이드가 유효했습니다. 과거에는 스팟 용량을 확보하려면 클러스터를 중단했다가 다시 띄워야 했지만, PCS에서는 단 2줄의 Terraform 코드로 수 분 내에 스팟 기반 프로비저닝을 완료해 그 방식을 대체했습니다.
Toyota Central R&D Labs — 공유 연구 컴퓨팅의 관리형 전환
Toyota Central R&D Labs는 여러 연구팀의 다양한 컴퓨팅 수요를 감당하기 위해 공유 컴퓨팅 환경을 운영해 왔지만, 대규모이거나 오래 걸리는 작업이 늘면서 한계에 부딪혔습니다. 기존 HPC 클러스터는 모든 연구자가 하나의 공유 큐를 함께 쓰는 구조여서, 대용량 메모리 작업처럼 큰 요청 하나가 클러스터 자원 대부분을 차지하면 GPU 작업이나 장기 실행 작업 등 다른 작업은 대기 상태에 머물렀습니다. 새 컴퓨팅 자원을 추가하는 데는 수개월이 걸렸습니다. 이후 AWS ParallelCluster를 도입해 유연성을 확보했지만, 클러스터별 환경 설정이 번거롭고 컨트롤러(헤드) 노드 비용이 늘어 확장에 한계가 있었습니다.
AWS PCS는 ParallelCluster의 유연성을 관리형으로 제공하는 서비스로, 이 부담을 덜어 줬습니다. 구체적인 도입 효과는 다음과 같습니다:
- 자체 구축: PCS는 클러스터, 노드 그룹, 큐를 콘솔(GUI)에서 구성, 관리할 수 있어, 기존 CLI/YAML 방식보다 직관적입니다. 덕분에 외부 업체에 의존하지 않고 팀이 직접 환경을 구축할 수 있게 됐습니다.
- 연구자별 큐와 자동 종료: 연구자별 전용 큐로 대규모이거나 장기 실행되는 계산을 즉시 시작할 수 있고, 계산이 끝나면 인스턴스가 자동으로 중지되어 비용을 절감했습니다.
- 환경 설정 시간 단축: 환경 설정에 온프레미스에서는 6주, ParallelCluster에서는 며칠이 걸리던 것이 PCS 도입 후 30분으로 단축됐습니다.
- 도입 성과: 대규모 재료 시뮬레이션과 AI/머신러닝 워크로드의 고급 컴퓨팅 요구를 신속하게 수용하며 PCS의 유연성과 효율성을 입증했습니다. 필요할 때만 리소스를 사용해 전체 활용도를 높이고 비용을 최적화했으며, 일상적인 운영 부담에서 벗어나 새로운 가치 창출에 집중할 수 있게 됐습니다.
8. 어떻게 시작하면 될까?
직접 해보는 것이 가장 빠릅니다. 아래 자료로 시작할 수 있습니다.
- PCS 워크숍: catalog.workshops.aws/aws-pcs/en-US
- ML on PCS 워크숍: catalog.workshops.aws/ml-on-pcs/en-US
- 제품 페이지와 문서: aws.amazon.com/pcs, docs.aws.amazon.com/pcs
- 분산 학습 레퍼런스 아키텍처: https://github.com/awslabs/awsome-distributed-ai/tree/main/architectures/aws-pcs
맺음말
2부에서는 워크로드별 관점부터 전환 실전, 도입 사례까지 살펴봤습니다. 정리하면 PCS는 ParallelCluster의 완전한 통제권과 SageMaker HyperPod의 완전 자동화를 대체하려는 서비스가 아니라, “같은 Slurm을 그대로 쓰면서 스케줄러 운영 부담만 덜어낸다”는 분명한 지점을 제공합니다. CFD/CAE 고객에게는 장기 해석을 지키는 무중단 업그레이드, 스케줄러 장애 대응 부담 제거, 큐 간 노드 공유가, 분산 트레이닝 고객에게는 인프라 통제권과 EC2 구매 구조를 유지하면서도 스케줄러 SLA를 얻는 점이 선택의 이유가 됩니다. 두 워크로드를 하나의 클러스터에서 큐로 나눠 함께 운영할 수 있다는 점은 조직 단위의 관리를 단순화합니다.
과학 애플리케이션을 위한 클러스터를 새로 시작한다면 PCS를 기본 선택으로 두시길 권합니다. 이미 ParallelCluster 환경이 있다면 blue/green 방식으로 소규모부터 검증해 옮기면 됩니다. 관리형 Slurm이 만들어 주는 여유를 엔지니어가 인프라 관리가 아니라 본래의 해석과 연구에 쓰도록 하는 것, 그것이 PCS가 지향하는 핵심 가치입니다. 워크로드 적합성이나 전환 방법이 고민된다면 AWS 담당 팀 또는 HPC Specialist SA에게 문의하시기 바랍니다.