AWS 기술 블로그
Category: High Performance Computing

ParallelCluster 잘 쓰고 있는데, 왜 AWS PCS인가? (2부) — 워크로드별 적용과 전환 실전 가이드
이 글은 2부입니다. 1부에서는 AWS PCS가 무엇이고(관리형 Slurm), 왜 필요하며, 요금이 어떻게 구성되는지를 다뤘습니다. 아직 1부를 보지 않으셨다면 개념과 비용 구조를 먼저 확인하시길 권합니다. 2부에서는 내 워크로드(CFD/CAE, 분산 트레이닝)에 PCS가 실제로 어떤 변화를 주는지, 하나의 클러스터로 통합하는 멀티 큐, AWS ParallelCluster에서 PCS로의 전환 가이드, 그리고 도입 사례를 살펴봅니다. 시리즈 블로그 보기 ParallelCluster 잘 쓰고 있는데, […]

AWS ParallelCluster로 Teamcenter 시뮬레이션 가속하기
이 글은 AWS for Industries 블로그에 게시된 Run HPC Simulations faster with Siemens Teamcenter and AWS ParallelCluster by Chandan Murthy, Amanda Greer, and Ramin Torabi를 한국어로 번역 및 편집하였습니다. (원문 보기) 제조 조직은 이제 Teamcenter Simulation을 AWS ParallelCluster와 통합하여 시뮬레이션 주기 시간을 며칠에서 몇 시간으로 단축할 수 있습니다. 완전한 데이터 추적성을 유지하면서 고성능 컴퓨팅(HPC) 대기열 […]
인코어드의 AWS HPC 환경에서 WRF 실행하기 [1부: HPC 전용 인스턴스 선택과 비용 최적화]
신재생 에너지 전문기업 인코어드는 HPC 시뮬레이션으로 재생에너지 발전량 예측에 필요한 고해상도 기상예측과 다양한 기상 시나리오를 생성하고, 이를 기반으로 발전량을 사전에 예측합니다. 이 예측 결과는 전력시장 입찰량 산정, 실시간 출력 제어, 정산 및 임밸런스(예측 발전량과 실제 발전량의 차이) 관리까지 전력거래 프로세스 전반의 핵심 입력 자료로 활용됩니다. 이러한 업무를 위해서는 최소 15분 단위, 1,000m(1km) 해상도의 고정밀 기상 […]

ParallelCluster 잘 쓰고 있는데, 왜 AWS PCS인가(1부) — 관리형 Slurm의 가치와 비용 구조
HPC 클러스터를 AWS 환경에서 운영해 온 고객이라면, 거의 대부분 AWS ParallelCluster를 사용해 왔을 것입니다. 오픈소스이기 때문에 무료이며, 원하는 대로 변경할 수 있는 강력한 클러스터 운영 플랫폼입니다. 그런데 실제로 장기간 운영하다 보면 반복해서 부딪히는 지점이 있습니다. ParallelCluster 버전을 올리려면 클러스터를 다시 만들어야 하고, 헤드 노드가 죽으면 사용자가 직접 복구해야 하고, OS와 스케줄러 패치를 적용하려면 며칠씩 돌고 […]

분산 학습을 위한 AWS 컴퓨트 선택 가이드 (3편: 클러스터 구축과 운영)
1편에서 모델 규모에 맞는 인스턴스 타입과 인터커넥트 기술을, 2편에서 Amazon EC2 UltraClusters(울트라클러스터) 및 Amazon EC2 UltraServer(울트라서버)와 고성능 GPU 인스턴스 확보 전략을 다뤘습니다. 무엇을 고르고 어떻게 확보할지가 정해졌다면, 이제 실제로 클러스터를 구성하고 운영할 차례입니다. 이번 3편에서는 컨테이너 기반 환경 구성, 클러스터를 구성하기 전 점검사항, 온프레미스 환경과의 비교, GPU와 Trainium의 선택, 그리고 현장에서 자주 마주치는 문제의 해결까지 […]
분산 학습을 위한 AWS 컴퓨트 선택 가이드 (2편: 초대규모 스케일링과 인스턴스 확보)
1편에서는 모델 규모에 맞는 GPU 인스턴스와 인터커넥트, 병렬화 전략, 그리고 모델 메모리 계산까지 ‘무엇을 고를까’를 다뤘습니다. 이번 2편에서는 그 선택을 수천 장 규모로 확장합니다. 수천에서 수만 개의 GPU를 하나의 학습으로 묶는 울트라클러스터와 울트라서버 아키텍처, 그리고 이런 고성능 인스턴스를 실제로 확보하는 ODCR 및 Capacity Block 전략을 다룹니다. 시리즈 블로그 보기 분산 학습을 위한 AWS 컴퓨트 선택 […]
분산 학습을 위한 AWS 컴퓨트 선택 가이드 (1편: 모델 규모와 하드웨어 선택)
대규모 언어 모델(LLM) 학습을 준비하는 팀이 가장 먼저 부딪히는 질문은 결국 “어떤 GPU를 얼마나, 어떻게 확보할 것인가”로 귀결됩니다. 그러나 이 질문은 H100이냐 B200이냐를 고르는 단순한 하드웨어 선택으로 끝나지 않습니다. 하나의 노드로 충분한지, 아니면 여러 노드로 확장해야 하는지, On-Demand로 그때그때 띄울지, Capacity Block으로 미리 예약할지, 평범한 EC2 클러스터로 감당이 되는지, 아니면 Amazon EC2 울트라클러스터(UltraClusters)나 Amazon EC2 […]
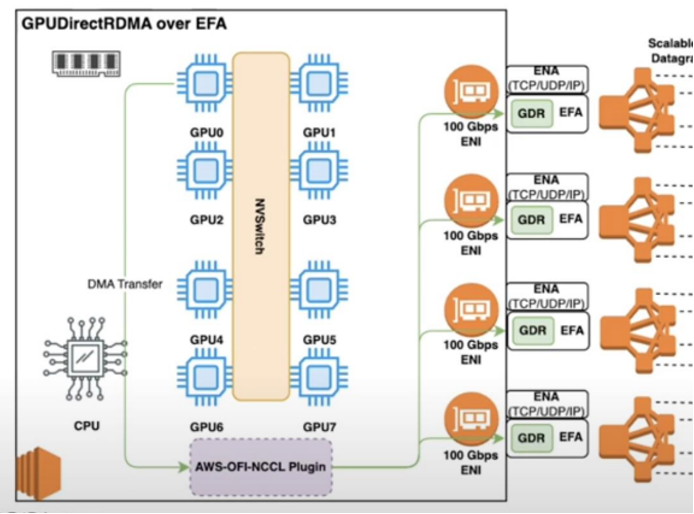
분산 트레이닝 관점에서의 AWS 인터커넥트 기술 소개 – 분산 트레이닝을 위해 알아야 할 GPU 간 고속 통신 기술
대규모 분산 훈련에서 GPU 간 통신 성능은 전체 훈련 효율을 좌우하는 핵심 요소입니다. 수백 대의 GPU가 그래디언트(gradient, 모델이 실수를 고치는 방향 지시서)를 주고받아야 하는 환경에서, 데이터가 GPU 메모리에서 네트워크를 거쳐 원격 노드의 GPU 메모리에 도달하기까지의 경로를 얼마나 효율적으로 설계하느냐가 곧 성능의 차이로 이어집니다. 이번 블로그는 이 시리즈의 마지막 편으로, AWS 인스턴스에서 활용되는 GPU 간 고속 […]
분산 트레이닝 관점에서의 AWS 인터커넥트 기술 소개 – AWS 환경에서 NCCL을 이용한 GPU 간 통신
지난 블로그에서는 ENI(Elastic Network Interface)의 구조와 역할, 그리고 p5.48xlarge와 p6-b300 인스턴스에서 EFA(Elastic Fabric Adapter)를 실제로 어떻게 구성하는지 살펴보았습니다. 이번 블로그에서는 이렇게 구성된 EFA 네트워크 위에서 실제 GPU 간 통신이 어떻게 이루어지는지, 그 핵심에 있는 NCCL(NVIDIA Collective Communications Library) 통신에 대해 소개하고자 합니다. EFA가 고속도로를 깔아주는 인프라라면, NCCL은 그 위에서 수백 대의 GPU가 효율적으로 데이터를 주고받을 […]
분산 트레이닝 관점에서의 AWS 인터커넥트 기술 소개 – AWS의 인터커넥트 기반 기술, ENI 소개
지난 블로그에서는 AWS가 인피니밴드 대신 EFA를 선택한 이유와 두 기술의 철학적 차이에 대해 살펴보았습니다. 이번 블로그에서는 한 단계 더 들어가, EFA가 EC2 인스턴스에 연결되는 기반 구조인 ENI(Elastic Network Interface)에 대해 소개하고자 합니다. EFA의 성능을 제대로 활용하려면 ENI가 무엇인지, 그리고 네트워크 카드와 ENI가 어떤 관계를 가지는지를 이해하는 것이 선행되어야 합니다. 특히 p5.48xlarge, p6-b300.48xlarge과 같은 고성능 GPU […]