AWS 기술 블로그
인코어드의 AWS HPC 환경에서 WRF 실행하기 [2부: MPI/OpenMP 하이브리드 병렬화 튜닝 심층 분석]
신재생 에너지 전문기업 인코어드(Encored)는 재생에너지 발전량 예측을 위해 고해상도 기상 시뮬레이션을 오픈소스 기상 모델 WRF로 수행하며, 온프레미스 클러스터 없이 AWS HPC 전용 인스턴스 위에서 운영하고 있습니다.
이 글은 AWS HPC 전용 인스턴스에서 WRF를 운영한 경험을 정리한 2부작 시리즈의 두 번째 글입니다. 1부에서 “어느 인스턴스를 몇 노드로 고를 것인가”를 다뤘다면, 2부의 질문은 하나입니다. 같은 인스턴스, 같은 vCPU 총량을 MPI 프로세스와 OpenMP 스레드로 어떻게 나눠 쓸 때 가장 빠른가?
직관과는 반대였습니다. MPI rank를 잘게 분할할수록 개별 rank가 맡는 계산이 줄어 빨라질 것 같지만, 실측에서는 구성에 따라 실행 시간이 최대 약 22%(가장 느린 2노드 64:3 124.24분 대비 가장 빠른 3노드 24:8 97.25분)까지 차이 났고, MPI 비중을 높인다고 반드시 빨라지지는 않았습니다. 저희는 그 원인을 EFA(Elastic Fabric Adapter) 패킷 분석으로 규명했으며, CPU 사용률이 높다고 해서 반드시 효율이 좋은 것은 아니라는 교훈을 얻었습니다.
이 글은 WRF뿐 아니라 매 타임스텝마다 인접 영역과 경계 데이터를 교환하는 모든 긴밀 결합(tightly-coupled) MPI 워크로드-CFD, 구조해석, 기후 및 해양 모델, 분자동역학 등-에 메커니즘 수준에서 그대로 적용됩니다. MPI:OpenMP 비율을 고민하는 엔지니어, “CPU 사용률은 높은데 왜 느릴까”를 진단하는 성능 및 SRE 엔지니어, WRF 성능 튜닝에 어려움을 겪는 연구자에게 실무적 근거가 되길 기대합니다. 1부를 안 읽으셨다면 아래 “이 시리즈의 실험 설정” 박스만 보셔도 이후 내용을 따라오실 수 있습니다.
이 시리즈의 실험 설정
- 워크로드: WRF(Weather Research and Forecasting), 1,000m 해상도, 10분 단위 기상 시뮬레이션
- 도메인 구성: 저해상도 모(母) 도메인 d01 + 고해상도 자(子) 도메인 d02
- 비교 인스턴스: hpc7g.16xlarge / hpc6a.48xlarge / hpc8a.96xlarge (모두 HPC 전용 인스턴스, 하이퍼스레딩 OFF = 1 vCPU, 1 물리코어)
- 평가 기준: 인코어드 내부 목표 시간을 만족하면서 총비용을 최소화하는 구성 탐색
- 가격 기준: On-Demand 단가 기준(FSx 등 스토리지 비용 제외)
시리즈 블로그 보기
- 인코어드의 AWS HPC 환경에서 WRF 실행하기 [1부: HPC 전용 인스턴스 선택과 비용 최적화]
- 인코어드의 AWS HPC 환경에서 WRF 실행하기 [2부: MPI/OpenMP 하이브리드 병렬화 튜닝 심층 분석]
1. WRF 도메인 분해와 MPI/OpenMP 병렬화 구조
WRF의 성능을 이해하려면 먼저 도메인 분해(domain decomposition) 방식을 알아야 합니다. WRF의 계산 영역(도메인)은 격자(cell)라는 최소 단위들의 집합이며, 이 격자들을 직사각형 블록으로 묶어 나눈 것을 패치(patch)라고 부릅니다. 하나의 MPI 프로세스가 패치 하나를 담당하므로, 전체 MPI 프로세스 수는 패치의 개수(x축 분할 × y축 분할)와 같습니다.
전체 MPI 프로세스(패치) 수 = nproc_x × nproc_y (x축 분할 × y축 분할)
각 패치는 다시 여러 개의 타일(tile)로 나뉘고, 타일 하나를 OpenMP 스레드 하나가 처리합니다. WRF의 OpenMP 빌드는 기본적으로 타일 수를 스레드 수에 맞추지만, numtiles, tile_sz 설정으로 달리 지정할 수도 있습니다. 이번 실험에서는 기본값을 그대로 사용해 프로세스당 타일 수를 스레드 수에 맞춰 구성했습니다. MPI는 도메인을 패치로(프로세스 단위), OpenMP는 패치를 타일로(스레드 단위) 나눕니다. 크기로 보면 패치 > 타일 > 격자 순이며, 패치는 여러 타일로, 타일은 여러 격자로 이루어집니다. 이 관계는 그림1과 같습니다.
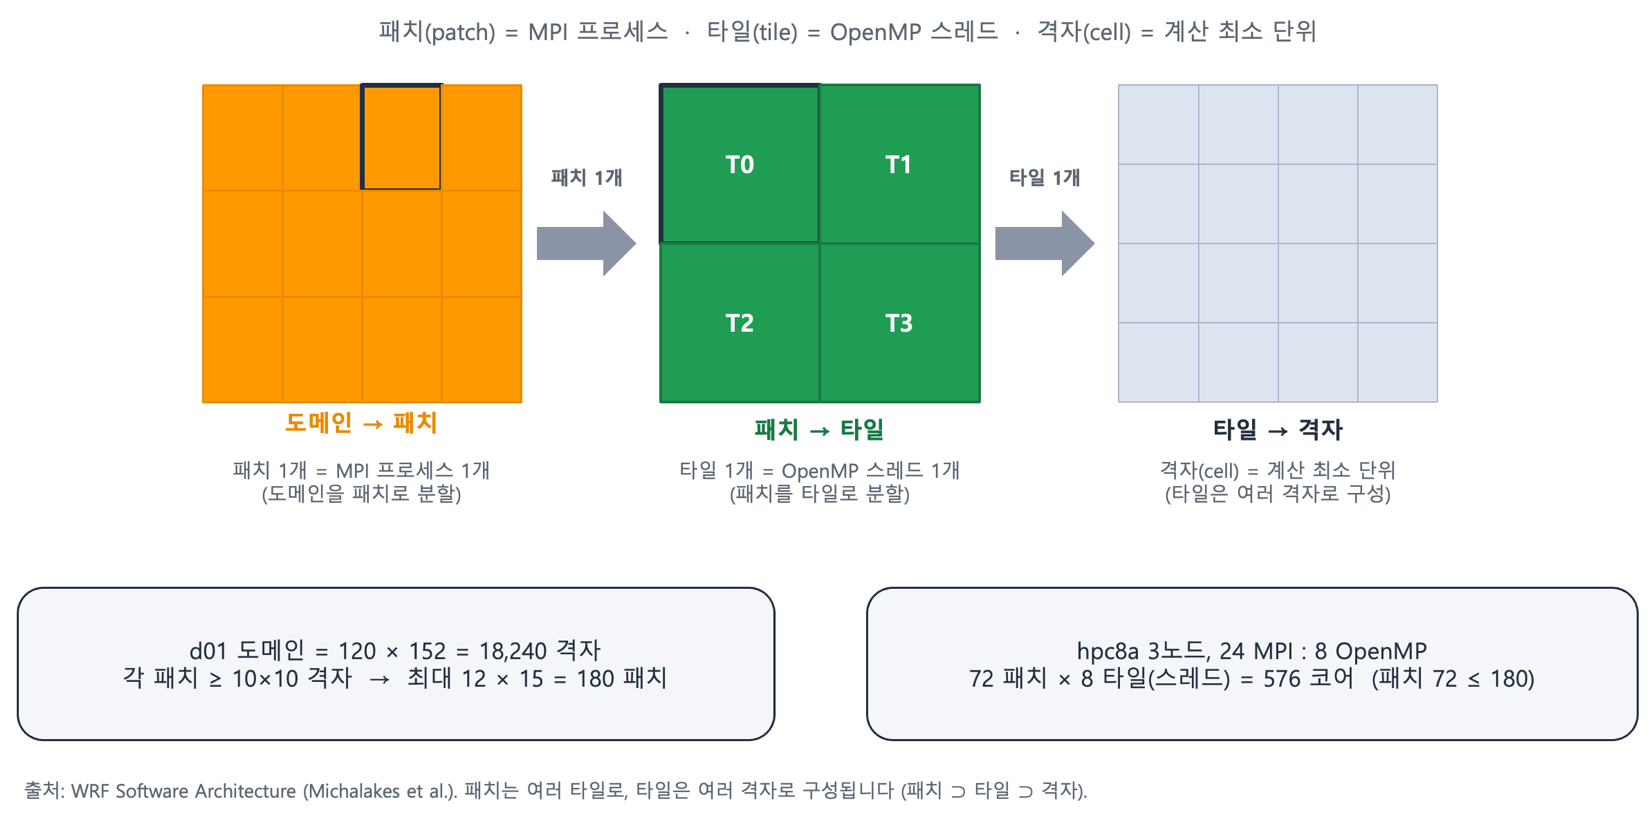
그림1. WRF 병렬 계층 구조: 패치 → 타일 → 격자
한편 도메인을 원하는 만큼 많은 패치로 쪼갤 수는 없습니다. 각 패치(MPI 프로세스가 맡는 조각)는 최소 수준 이상의 격자를 담고 있어야 하기 때문입니다. WRF는 유한차분 기반 모델이라, 각 패치가 인접 패치와 경계 데이터(halo)를 매 타임스텝마다 교환해야 계산이 성립합니다. 이 최소 크기 제약은 MPI 분해 단위인 패치에 적용되며, 바로 이것이 도메인을 나눌 수 있는 패치(MPI 프로세스) 수의 상한을 결정합니다. 각 패치는 한 변에 최소 약 10개 격자를 확보해야 하며, 이보다 작아지면 계산이 오류로 종료됩니다.
반면 타일에는 이러한 최소 크기 제약이 없습니다. 타일은 하나의 패치 안에서 OpenMP 스레드들이 공유 메모리를 나눠 계산하는 단위라, 프로세스 간 halo 교환이 필요 없기 때문입니다. 다만 타일의 모양은 패치와 다릅니다. WRF의 기본 타일링은 Y축 1D 분할이어서 X축은 쪼개지 않으므로, 패치를 스레드 수만큼 나눠도 정사각형 조각이 되지는 않습니다. 각 타일은 X 방향 폭을 그대로 유지한 채 Y 방향으로만 잘려 가로로 얇고 긴 띠 모양이 되며, 스레드 수가 늘어날수록 타일의 Y 방향 두께가 얇아집니다.
이 실험의 시뮬레이션은 두 개의 중첩 도메인(nested domain)으로 구성됩니다. 넓은 배경 영역을 낮은 해상도로 담당하는 모(母) 도메인 d01과, 관심 지역만 높은 해상도로 정밀하게 계산하는 자(子) 도메인 d02입니다. 여기서 나눌 수 있는 패치 수를 정하는 것은 도메인의 물리적 면적이 아니라 격자 칸(grid cell)의 수입니다. d01은 지리적으로는 더 넓지만 저해상도라 격자 수가 적고(120 × 152 = 18,240칸), d02는 영역이 좁아도 고해상도라 격자 수가 더 많습니다. 패치 최소 크기 제약(한 변 최소 약 10격자)을 적용하면, 격자 수가 적은 d01을 나눌 수 있는 패치 수는 120÷10 × 152÷10 = 12 × 15 = 180개로 제한됩니다.
중첩 도메인은 하나의 run 안에서 동일한 MPI 프로세스 집합을 공유하므로, 자 도메인 d02가 아무리 크더라도 더 작은 모 도메인 d01이 전체 시뮬레이션의 병렬화 상한을 결정합니다. 결국 이 워크로드 전체가 180개 MPI 프로세스라는 천장에 묶입니다.
이 제약은 인스턴스 선택과 튜닝에 직접적인 영향을 미칩니다. 예를 들어 hpc8a 3노드는 576개의 물리 코어(192 vCPU × 3)를 제공하지만, 순수 MPI 방식으로는 180개 프로세스가 상한이므로 나머지 코어가 유휴 상태가 됩니다. 이 유휴 코어를 계산에 활용하는 방법이 바로 MPI와 OpenMP를 함께 쓰는 하이브리드 병렬화입니다. 패치 하나를 여러 타일로 나눠 OpenMP 스레드가 병렬 처리하는 것입니다.
24 MPI 프로세스(패치)/노드 × 3노드 = 72 프로세스 (180 상한 이내)
각 패치당 타일(스레드) 8개
→ 72 × 8 = 576 스레드로 576개 코어를 모두 활용
정리하면, d01 도메인의 격자 수가 MPI 병렬화의 천장을 결정하기 때문에, 코어를 무작정 늘리는 것만으로는 성능이 향상되지 않습니다. 제한된 패치 수 안에서 남는 코어를 OpenMP 스레드(타일)로 얼마나 효율적으로 활용하는가가 성능을 좌우하며, 이것이 이 절에서 이어서 다룰 MPI:OpenMP 비율 튜닝이 중요한 근본적인 이유입니다.
1.1 실험 설정
| 항목 | 값 |
|---|---|
| WRF 버전 | v4.4.2 |
| 컴파일 옵션 | dm+sm (MPI + OpenMP 하이브리드 빌드) |
| MPI 통신 모드 | pure spin(busy-poll) |
| 도메인 구성 | 저해상도 모(母) 도메인 + 고해상도 nest |
| 시뮬레이션 기간 | 수십 시간 규모 예보 |
표1. WRF 실험 환경 설정
참고로 표1의 MPI 통신 모드 pure spin(busy-poll)은 특정 파라미터로 강제한 값이 아닙니다. 이번 실험에 사용한 MPI 라이브러리들은 기본 대기 정책이 busy-poll이라, 별도 설정 없이 기본 동작만으로 세 인스턴스 모두 spin으로 수행됐습니다. spin 모드에서는 MPI rank가 다른 rank의 데이터를 기다리는 동안에도 CPU를 양보(지금 이 코어에서 손을 떼고, OS 스케줄러에게 코어를 돌려줘서 다른 프로세스/스레드가 그 코어를 쓰게 해준다)하지 않고 도착 여부를 반복 확인합니다. 이 전제를 실험 설정에 밝혀 두는 이유는, 이 글의 핵심 진단인 “CPU 사용률이 높은데 오히려 느린” 현상이 바로 이 대기 방식에서 비롯되기 때문입니다(1.5절). 일반적으로 WRF처럼 통신이 잦은 tightly-coupled 워크로드에서는, 대기 중에도 즉시 메시지에 반응해 지연(latency)이 낮은 spin 방식이 유리한 것으로 알려져 있습니다. 다만 이번 실험은 모든 구성을 spin으로만 수행했고 yield 모드와 나란히 비교한 데이터는 없으므로, 이는 저희가 직접 입증한 결론이 아니라 일반적으로 알려진 특성입니다. 또한 SMT를 비활성화해 각 코어가 스레드 하나만 전용으로 실행하므로(하나의 MPI 프로세스는 자신의 스레드 수만큼 코어를 점유), 대기 중 CPU 점유가 다른 작업에 방해가 되지 않습니다.
MPI 라이브러리는 표2와 같이 인스턴스 아키텍처별로 다른 버전을 사용하였습니다.
| 인스턴스 | 아키텍처 | MPI | Compiler | NetCDF/HDF5 | EFA/Libfabric |
|---|---|---|---|---|---|
| hpc7g.16xlarge | Graviton3E (ARM) | OpenMPI 4.1.5 | gfortran 11.4.0 | NetCDF-C 4.9.2 / HDF5 1.14.5 | EFA 1.22.1 / Libfabric 1.17.1 |
| hpc6a.48xlarge | EPYC (x86) | IntelMPI 2021.7.1 | ifort 2021.5.0 | NetCDF-C 4.9.0 / HDF5 1.8.22 | EFA 1.18.0 / Libfabric 1.13.2rc1 |
| hpc8a.96xlarge | EPYC (x86) | IntelMPI 2021.14.0 | ifort 2021.5.0 | NetCDF-C 4.9.2 / HDF5 1.14.5 | EFA 1.44.0 / Libfabric 2.3.1amzn1.0 |
표2. 인스턴스별 아키텍처와 MPI/라이브러리 버전
Graviton3E(ARM)와 EPYC(x86)은 아키텍처가 서로 다르므로, 각 플랫폼에서 검증 및 최적화된 MPI 버전을 선택한 결과입니다. 동일 버전을 강제로 맞추기보다 플랫폼별 최적 빌드를 쓰는 편이 성능 및 안정성 모두에 유리합니다.
1.2 MPI/OpenMP 하이브리드 비율 최적화
hpc8a 인스턴스에서 같은 192 vCPU라도 MPI:OpenMP를 어떻게 나누느냐에 따라 wall time이 표3과 같이 달라졌습니다. 노드 수를 고정하고 비율만 바꿔도 3노드 기준 약 4%(64:3 101.14분 → 24:8 97.25분), 2노드에서는 MPI/OpenMP 양극단 비교(96:2 122.52분 → 24:8 117.23분) 기준 약 4.5%의 차이가 났습니다. 다만 64:3 구성이 (MPI가 더 많은 96:2보다도) 유독 느린 예외여서, 2노드 전체 편차는 가장 빠른 48:4(112.69분)와 가장 느린 64:3(124.24분) 사이로 약 10%까지 벌어집니다. MPI 비중을 높이면 CPU 사용률은 올라가지만 wall time은 대체로 늘어나는 경향을 보였습니다(단, 모든 구간에서 단조적이지는 않으며, CPU 사용률이 오르는 이유는 pure spin 모드 때문입니다. 자세한 진단은 1.5절 참고). 최적 구간은 24:8 ~ 48:4로 확인되었습니다.
각 설정은 다음 두 값의 조합으로 정해집니다. 하나는 노드당 실행하는 MPI 프로세스 수로, 본 글에서는 tasks_per_node로 표기합니다. 이 값은 MPI 실행 명령이나 잡 스케줄러에서 지정합니다(예: OpenMPI mpirun의 -npernode, Slurm의 --ntasks-per-node). 다른 하나는 각 MPI 프로세스가 사용하는 OpenMP 스레드 수로, OpenMP 표준 환경 변수인 OMP_NUM_THREADS로 설정합니다. hpc8a는 노드당 192 vCPU를 제공하므로, 이 두 값의 곱이 192가 되어야 노드의 모든 코어를 계산에 사용할 수 있습니다.
(노드당 MPI 프로세스 수, tasks_per_node) × (프로세스당 OpenMP 스레드 수, OMP_NUM_THREADS) = 192
예를 들어 24:8은 노드당 MPI 프로세스 24개에 각각 OpenMP 스레드 8개(24 × 8 = 192)를 할당한 구성입니다. 아래 모든 설정은 이 곱이 192로 동일하며, 차이는 오직 분할 방식뿐입니다.
| CPU:Thread | 노드 | Wall (분) | CPU % MAX | 메모리 % MAX |
|---|---|---|---|---|
| 96:2 | 2 | 122.52 | 81.90 | 10.40 |
| 64:3 | 2 | 124.24 | 77.20 | 9.61 |
| 48:4 | 2 | 112.69 | 69.50 | 8.64 |
| 24:8 | 2 | 117.23 | 67.00 | 7.88 |
| 64:3 | 3 | 101.14 | 70.30 | 9.06 |
| 48:4 | 3 | 98.12 | 64.20 | 8.27 |
| 24:8 | 3 | 97.25 | 59.30 | 7.60 |
표3. hpc8a 구성별 MPI:OpenMP 비율에 따른 wall time과 자원 사용률 (2~3노드)
2노드에서는 MPI 비중이 가장 높은 설정(96:2)과 OpenMP 비중이 가장 높은 설정(24:8)을 비교했고(122.52분 → 117.23분), 그 사이 구간인 64:3(124.24분)과 48:4(112.69분)도 함께 측정했습니다. 2노드에서 가장 빠른 것은 48:4였고 64:3이 가장 느려, 2노드 안에서는 MPI 비중과 wall time이 단조 관계를 보이지 않았습니다. 이 때문에 최적 구간을 24:8 단일 설정이 아니라 24:8~48:4로 보는 것이 데이터에 부합합니다. 3노드에서는 MPI 비중을 단계적으로 낮춰가며 측정했습니다(64:3 101.14분 → 48:4 98.12분 → 24:8 97.25분). 같은 노드 수 안에서 비율만 바꿨을 때의 차이는 3노드에서 약 4%, 2노드에서 약 4.5%입니다. 노드 수 차이까지 합한 전체 구성 격차는 맺음말에서 따로 다룹니다.
CPU 사용률은 pure spin 특성상 통신 대기까지 포함하기 때문에 높다고 효율을 뜻하지 않으며(1.5절 참고), 메모리 사용률이 최대 10% 안팎으로 낮아 이 워크로드는 메모리보다 CPU와 네트워크 성능이 관건임을 보여줍니다.
다음 두 그래프는 wall time(막대)과 EFA 패킷 수(선)를 함께 표시한 것입니다. 막대(wall time)와 선(tx_pkts)이 같은 방향으로 내려가며, MPI rank를 줄일수록 통신 패킷 빈도가 함께 줄어드는 것과 wall time 단축이 맞물려 있음을 보여줍니다(원인은 1.5절에서 진단합니다).
먼저 3노드 결과입니다. 같은 3노드 안에서 MPI 비중만 낮춰가며 비교하면, 64:3은 평균 101.14분으로 목표 시간을 약 1.1분 초과하고, 48:4와 24:8이 더 짧은 wall time을 보입니다.
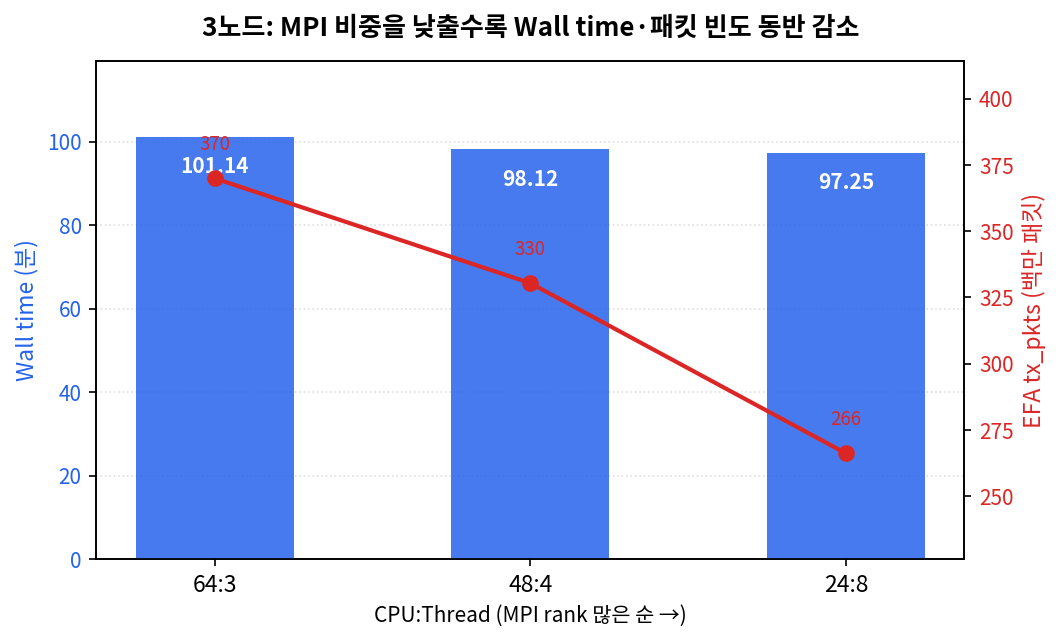
그림2. hpc8a 3노드: MPI:OpenMP 비율에 따른 wall time과 EFA 패킷 수 (이중 축)
다음은 2노드의 극단 비교입니다. 노드 수와 decomposition 변수를 배제하고 MPI 극단(96:2)과 OpenMP 극단(24:8)만 통제 비교한 결과, 2노드에서도 MPI rank 수가 감소할수록 패킷 수가 절반 수준(409M → 221M)으로 줄면서 wall time도 5분 이상 짧아집니다.
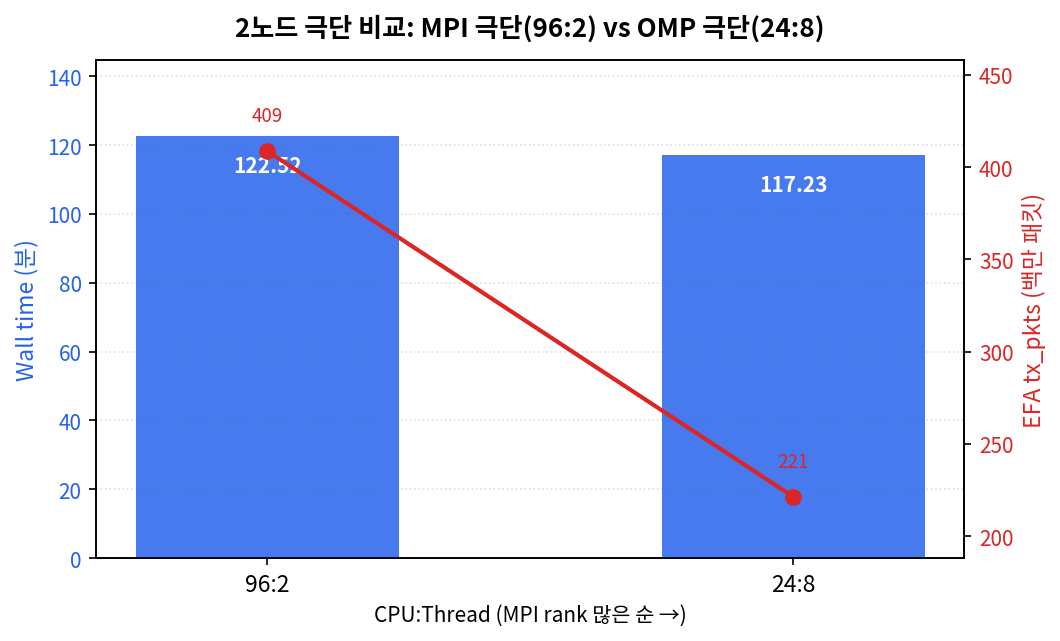
그림3. hpc8a 2노드: 96:2와 24:8 비교의 wall time과 EFA 패킷 수 (이중 축)
주목할 점은 CPU 사용률과 wall time이 반대로 움직인다는 것입니다. 96:2는 CPU 사용률이 82%로 가장 높지만 wall time은 오히려 더 깁니다. 높은 CPU 사용률이 효율을 의미하지 않는다는 신호이며, 그 원인은 1.5절에서 진단합니다.
1.3 d01(모 도메인)로 인한 구조적 제약
앞에서 언급한 것처럼, 이 워크로드에서 나눌 수 있는 계산 패치는 최대 180개로 제한됩니다. 패치 수가 이보다 많아지면 “각 패치는 한 변에 최소 약 10개 격자를 확보해야 한다”는 제약을 위반하게 됩니다.
그런데 왜 더 큰 자 도메인이 아니라 작은 모 도메인이 상한을 정할까요? WRF에서 네스팅을 쓰면 모 도메인 d01과 자 도메인 d02를 서로 다른 프로세스가 아니라 동일한 MPI 프로세스 집합이 함께 계산합니다. 따라서 프로세스 수는 두 도메인 모두를 만족해야 합니다. 고해상도 자 도메인 d02는 격자 수가 많아 훨씬 잘게 나눌 수 있지만, 저해상도 모 도메인 d01은 격자 수가 적어서 180개를 넘겨 나누면 각 조각이 최소 크기(한 변 약 10격자)보다 작아져 계산이 깨집니다. 그래서 더 큰 d02가 아니라 더 작은 d01이 전체 시뮬레이션의 병렬화 상한을 결정합니다.
여기서 hpc8a는 노드당 192 vCPU를 제공하기 때문에, 한 노드만 순수 MPI로 채워도 이미 계산 상한 180개를 넘어섭니다. 3노드 구성이면 576개 코어가 있지만, 이 중 계산 패치로 쓸 수 있는 것은 180개뿐입니다. 그러면 나머지 코어(또는 180개를 초과해 설정된 MPI 프로세스)는 다음 세 가지 중 하나로 처리됩니다.
- quilting I/O로 배정: 총 MPI 프로세스가 180개를 약간 초과하도록 설정한 경우, 초과분을 계산이 아니라 출력 파일 쓰기 전담(quilting I/O 서버) rank로 돌립니다. quilting I/O는 WRF의 비동기 출력 기능으로, 일부 rank를 계산에서 떼어 출력만 담당하게 하는 방식입니다. 실제로 일부 task 수에서는 worker decomposition이 노드 vCPU를 깔끔히 나누지 못해, quilting I/O rank를 추가해야만 WRF가 정상 동작합니다.
- 유휴로 방치: 순수 MPI 구성에서 계산 패치가 180개로 묶이면, 이를 초과하는 코어는 계산에 참여하지 못하고 그대로 놀게 됩니다.
- OpenMP로 흡수: 하나의 MPI 프로세스에 여러 OpenMP 스레드를 묶어, 패치 수를 180개 이하로 유지하면서 남는 코어를 스레드로 채워 계산에 활용합니다. 세 가지 중 코어를 실제 계산에 투입하는 유일한 방법이며, 하이브리드 구성이 유리한 근본 이유입니다.
예를 들어 2노드 96:2 구성은 총 MPI가 192개로 계산 상한 180개를 넘기므로, quilting(2 groups × 6 tasks = 12개)을 출력 전담으로 배정해 계산 rank를 180개 이하로 낮춰야 합니다. 반면 48:4와 24:8 구성은 총 MPI가 180개 이하라 quilting 없이 운영되며, 실측에서도 quilting이 필요 없는 설정이 전반적으로 더 나은 성능을 보였습니다.
즉 hpc8a는 노드당 192 vCPU를 제공하지만, 이 워크로드에서는 계산에 쓸 수 있는 MPI rank가 180개로 묶여 있어 vCPU를 전부 계산에 투입할 수 없습니다. 이 구조적 천장 때문에, 남는 코어를 유휴나 quilting으로 흘려보내기보다 OpenMP 스레드로 흡수하는(즉 OMP 비중을 높이는) 설계가 유리해집니다. 통신량 관점에서도 순수 MPI에 가까울수록 불리한데, 이는 1.5절에서 다룹니다.
1.4 패치 크기와 성능
패치 크기는 통신 부담과 캐시 효율 사이의 균형점을 정합니다. 아래에서 그 메커니즘과 실측 결과를 살펴봅니다.
여기서 패치 크기란 MPI 프로세스 하나가 담당하는 격자 영역의 크기를 뜻하며, 전체 도메인 격자 수를 계산 MPI 프로세스 수로 나눈 값입니다. 따라서 MPI 프로세스를 많이 두어 도메인을 잘게 쪼갤수록 패치는 작아지고, 반대로 MPI 프로세스를 줄이고 OpenMP 비중을 높이면 패치는 커집니다. 모 도메인을 상한인 180개까지 잘게 나누면 각 패치의 한 변은 최소 허용 수준에 바짝 붙게 되고, MPI 비중을 낮춰 패치 수를 줄이면 그만큼 각 패치의 한 변이 여유 있게 커집니다.
패치 크기는 성능에 양방향으로 영향을 줍니다. 패치가 작으면(프로세스 개수가 많으면) 프로세스 간 경계 데이터를 주고받는 halo 교환 횟수가 늘어 통신 부담이 커지고, 패치가 크면(프로세스 개수가 적으면) 프로세스 하나가 다루는 데이터가 캐시에 다 들어가지 못해 캐시 미스가 늘어납니다. 실측에서는 MPI 비중을 낮춰 패치를 최소 허용 수준보다 여유 있게 키운 구성(24:8, 3노드)에서 두 요인이 가장 균형을 이뤘습니다.
| 패치 크기 (grid cells) | 평가 |
|---|---|
| < 10 | WRF 실행 불가 (에러) |
| 작을수록 | 통신 부담 증가 |
| 클수록 | 캐시 미스 증가 |
표4. 패치 크기별 성능 특성
이번 실험에서 MPI rank를 많이 배정한 구성은 1.3절에서 다룬 상한 180개에 가깝게 패치를 만들거나 초과분을 quilting I/O로 돌려야 했고, 그 결과 계산 패치의 한 변이 최소 허용 수준인 약 10격자까지 작아져 통신 부담이 컸습니다. 예를 들어 96:2(2노드) 구성은 총 192개의 MPI rank 중 12개를 quilting으로 배정해 계산 패치를 180개로 맞췄고, 이때 패치의 한 변은 최소 허용 수준에 그대로 맞닿았습니다. 반면 MPI rank를 줄이고 OpenMP 비중을 높인 24:8(3노드) 구성은 노드당 24개 MPI × 3노드 = 총 72개의 계산 패치가 만들어지며, quilting 없이 운영됩니다. 패치 수가 상한의 절반 이하로 줄어든 만큼 각 패치의 한 변도 최소 허용 수준보다 여유 있게 커졌고, 캐시 효율과 통신 균형이 가장 좋았던 이유가 여기에 있습니다. 패치를 무작정 잘게 쪼개는 것이 능사가 아니라는 점을 보여줍니다.
한편 패치가 작아질 때 통신 부담이 왜, 얼마나 커지는지는 halo 교환 비용 모델로 정량적으로 설명되며, 이는 이어지는 1.5절에서 자세히 다룹니다.
1.5 패킷 분석: MPI rank 증가가 통신 부담으로 이어지는 이유
1.4절에서는 MPI rank 수가 늘어나면 계산 패치가 작아지고, rank 간 경계 통신이 증가할 수 있음을 설명했습니다. 이번 절에서는 같은 hpc8a 2노드 환경에서 MPI rank 비중이 높은 96:2 구성과 OpenMP thread 비중이 높은 24:8 구성을 비교해, 이 통신 부담이 실제 EFA 지표에서 어떻게 나타났는지 확인합니다.
표5의 주요 지표는 tx_pkts와 tx_bytes입니다. tx_pkts는 EFA 네트워크 인터페이스가 송신한 패킷 수이고, tx_bytes는 송신한 전체 데이터 양입니다. 평균 패킷 크기는 tx_bytes를 tx_pkts로 나눈 값으로, 패킷 하나에 평균적으로 얼마나 많은 데이터가 실렸는지를 나타냅니다. 이 값들은 EFA 하드웨어 카운터에서 수집한 실측값과, 이를 바탕으로 계산한 파생 지표입니다.
표5의 d01 및 d02 step median은 WRF가 시뮬레이션을 나누어 계산하는 타임스텝(time step) 한 번을 처리하는 데 걸린 시간의 중앙값으로, 모 도메인 d01과 자 도메인 d02에 대해 각각 측정한 값입니다. 한 타임스텝은 모델 시간을 정해진 간격만큼 전진시키는 한 번의 계산 사이클이며, 사이클마다 각 rank가 자기 패치를 계산하고 인접 rank와 halo(경계 데이터)를 교환합니다. 수천 번의 스텝 중 체크포인트 쓰기나 OS 지터로 간헐적으로 튀는 값에 영향받지 않고 전형적인 한 스텝의 소요 시간을 보기 위해, 평균 대신 중앙값을 사용했습니다.
이 지표를 표5에 포함한 이유는, 패킷 지표(원인)와 wall time(최종 결과) 사이를 잇는 중간 증거이기 때문입니다. 패킷이 잘게 쪼개지면 매 타임스텝이 느려지고 그 지연이 누적되어 전체 wall time이 늘어나는데, step median이 없으면 패킷 증가와 wall time 증가 사이가 비어 통신 부담이 실제로 계산 스텝을 느리게 했는지 확인할 수 없습니다. wall time은 초기화, I/O, 계산이 섞인 총 시간인 반면 step median은 계산 스텝만 떼어낸 값이라, 느려진 지점이 계산 스텝 자체임을 국소화해 보여줍니다. 또한 d01과 d02의 증가폭 차이는 halo 교환이 스텝 시간에 어떻게 반영되는지를 보여주며, 뒤에 이어지는 halo 비용 모델 설명과 연결됩니다.
| 항목 | 96:2 | 24:8 (기준점) | 비교 |
|---|---|---|---|
| Wall time (분) | 122.52 | 117.23 | +5.29 (+4.5%) |
| d01 step median (s) | 0.621 | 0.580 | +7.2% |
| d02 step median (s) | 0.091 | 0.079 | +15.4% |
| EFA tx_pkts | 408.75 M | 221.40 M | +84.6% ⚠️ |
| EFA tx_bytes (GB) | 1,648 | 1,321 | +24.8% |
| send/tx 비율 | 89.4% | ~100% | overhead 폭증 |
| 평균 패킷 크기 | 4,032 bytes | 5,968 bytes | 96:2가 33% 작음 |
| 평균 tx 대역폭 | 230 MB/s | 192 MB/s | 둘 다 링크의 < 2.5% |
표5. 96:2 대 24:8 통제 비교 (2노드)
표5에서 가장 중요한 점은 tx_bytes 증가율보다 tx_pkts 증가율이 훨씬 크다는 것입니다. 24:8을 기준으로 96:2는 전체 송신 데이터량이 24.8% 증가했지만, 송신 패킷 수는 84.6% 증가했습니다. 즉 96:2는 단순히 더 많은 데이터를 보낸 것이 아니라, 데이터를 더 많은 수의 작은 패킷으로 나누어 전송한 구성입니다.
이 차이는 평균 패킷 크기에서도 확인됩니다. 24:8의 평균 패킷 크기는 5,968 bytes였지만, 96:2에서는 4,032 bytes로 줄었습니다. 이는 96:2에서 MPI rank 수가 많아지면서 계산 패치가 더 잘게 나뉘고, rank 간 경계 통신이 더 작은 단위로 더 자주 발생했음을 시사합니다.
반면 평균 tx 대역폭은 96:2가 230 MB/s, 24:8이 192 MB/s로, 두 구성 모두 EFA 링크 용량 대비 2.5% 미만이었습니다. 평균 사용률 기준으로 보면 링크 대역폭이 포화된 상태로 보기는 어렵습니다. 따라서 96:2의 wall time 증가 원인은 EFA 대역폭 부족이라기보다는, 작은 패킷 증가에 따른 통신 처리 오버헤드와 지연 시간 누적으로 해석하는 것이 적절합니다.
이 현상은 halo 교환 관점에서도 설명할 수 있습니다. WRF는 각 time step에서 인접한 패치와 경계 데이터, 즉 halo를 교환합니다. 패치 한 변의 격자 수를 N이라고 단순화하면, 각 패치가 계산할 데이터는 면적에 비례하므로 N²에 가깝고, 교환해야 하는 경계 데이터는 둘레에 비례하므로 N에 가깝습니다. 따라서 통신 대 계산 비율은 대략 N / N², 즉 1 / N에 가까워집니다. 패치가 작아질수록 N이 작아지고, 계산량 대비 통신 비중이 커지는 구조입니다. 표6의 Halo:Compute 비율은 이 모델을 실제 분해에 적용한 값으로, 각 구성의 nproc_x×nproc_y 분해에서 얻은 패치 크기와 WRF의 halo 폭을 기준으로 (halo 영역 격자 수) ÷ (패치 내부 계산 격자 수)를 구해 산출했습니다. 3노드 24:8(1.25)이 2노드 24:8(1.03)보다 높은 것은, 같은 24:8이라도 3노드는 총 72 rank로 8×9 분해가 되어 2노드(48 rank, 6×8 분해)보다 패치가 작아지기 때문입니다. 즉 이 비율은 노드당 비율이 아니라 전체 rank 수가 만든 패치 크기에 따라 결정됩니다.
| 설정 | Halo:Compute 비율 |
|---|---|
| 96:2 (2노드) | 1.91 (통신 > 계산) |
| 48:4 (2노드) | 1.44 |
| 24:8 (3노드) | 1.25 |
| 24:8 (2노드) | 1.03 |
표6. 구성별 Halo 대 Compute 비율
96:2 구성은 자기가 계산할 양보다 많은 halo를 매 step 주고받는 셈입니다. 이 초과분이 곧 통신 오버헤드로 나타납니다.
이 관점에서 보면 96:2 구성은 계산 패치가 지나치게 작아져, 계산량 대비 halo 교환 부담이 커진 구성으로 볼 수 있습니다. 실제로 96:2는 24:8보다 평균 패킷 크기가 작고, tx_pkts가 크게 증가했습니다. 이 결과는 MPI rank를 늘려 패치를 더 잘게 나누는 것이 항상 성능 향상으로 이어지지 않음을 보여줍니다.
CPU 사용률도 함께 해석해야 합니다. 96:2 구성의 CPU 사용률은 약 82%로, 24:8의 약 59%(표3)보다 높았습니다. 그러나 CPU 사용률이 높다고 해서 항상 유효 계산을 많이 했다는 뜻은 아닙니다. MPI 라이브러리가 기본 대기 정책인 busy-poll(spin)로 동작하면, MPI rank는 다른 rank의 데이터를 기다리는 동안 CPU를 양보하지 않고 짧은 반복문을 계속 수행할 수 있습니다. 이 상태에서는 CPU가 바쁘게 보이지만, 실제로는 유용한 계산이 아니라 데이터 도착 여부를 반복적으로 확인하는 대기 동작일 수 있습니다.
spin 방식에서는 rank가 통신을 기다리는 동안에도 CPU를 user 모드에서 계속 점유합니다. 그 결과 커널 처리나 디스크 I/O 대기를 나타내는 %sys와 %iowait는 낮은데 %usr만 높게 나타나는 것이 일반적인 특성입니다. 이는 높은 CPU 사용률이 실제 계산이 아니라 애플리케이션 또는 MPI 라이브러리의 user-mode polling에서 비롯됐을 가능성을 시사합니다.
EFA는 kernel-bypass 방식으로 동작합니다. 즉 통신 경로에서 운영체제 커널 개입을 줄여 지연 시간을 낮추는 대신, 통신 처리 비용이 mpstat의 %sys에 잘 드러나지 않을 수 있습니다. 따라서 CPU 사용률이나 %sys만 보면 96:2가 자원을 잘 활용하는 것처럼 보일 수 있지만, 실제로는 EFA 하드웨어 카운터의 tx_pkts 증가가 통신 부담을 더 잘 보여줍니다.
정리하면, 96:2 구성은 24:8보다 MPI rank 수가 많아 계산 패치를 더 잘게 나눕니다. 그 결과 전체 송신 데이터량도 증가했지만, 송신 패킷 수는 그보다 훨씬 크게 증가했고 평균 패킷 크기는 작아졌습니다. 평균 대역폭은 링크 용량 대비 낮았기 때문에, 이번 결과는 대역폭 포화보다는 작은 패킷 증가에 따른 통신 처리 오버헤드와 지연 시간 누적이 wall time 증가에 영향을 주었음을 보여줍니다. WRF처럼 반복적인 time step마다 rank 간 경계 교환과 동기화성 통신이 발생하는 워크로드에서는, 일부 rank의 통신 지연이 전체 step 시간을 늘릴 수 있습니다.
1.6 스토리지 구성 (Amazon FSx for Lustre)
WRF의 입출력은 전 노드가 공유하는 Amazon FSx for Lustre 파일시스템 위에서 처리했습니다. WRF는 여러 노드가 동시에 초기 조건과 경계 조건 파일을 읽고, 실행 중 생성되는 출력 파일(wrfout)을 병렬로 기록합니다. 따라서 단일 노드 로컬 디스크가 아니라, 모든 계산 노드에서 접근할 수 있는 고성능 공유 병렬 파일시스템이 필요합니다.
본 실험에서는 HPC 워크로드에 적합한 병렬 파일시스템으로 FSx for Lustre를 사용했습니다. 파일시스템은 컴퓨팅 인스턴스와 같은 리전에 배치했으며, 성능을 안정적으로 확보하기 위해 컴퓨팅 노드와 같은 AZ에 배치하는 구성을 전제로 했습니다.
| 항목 | hpc7g | hpc6a | hpc8a |
|---|---|---|---|
| 스토리지 타입 | Persistent (SSD) | Persistent (SSD) | Persistent (SSD) |
| 단위당 처리량 | 125 MB/s/TiB | 125 MB/s/TiB | 125 MB/s/TiB |
| 구성 용량 | 약 2.4 TiB | 약 4.8 TiB | 약 2.4 TiB |
| 총처리량 | 300 MB/s | 600 MB/s | 300 MB/s |
| 배치 | 동일 리전 | 동일 리전 | 동일 리전 |
표7. 인스턴스별 FSx for Lustre 구성
세 구성 모두 SSD 기반 Persistent 파일시스템을 사용했으며, 단위당 처리량 등급은 125 MB/s/TiB로 동일했습니다. FSx for Lustre는 파일시스템 용량에 비례해 총 처리량이 결정되므로, 약 2.4 TiB 구성에서는 300 MB/s, 약 4.8 TiB 구성에서는 600 MB/s의 처리량을 제공합니다.
이 스토리지 구성은 1.3절에서 설명한 quilting(I/O 전담 rank) 설정과도 연결됩니다. quilting은 일부 MPI rank를 계산에서 분리해 WRF 출력 파일 쓰기를 전담하게 하는 방식입니다. 이때 출력 데이터가 최종적으로 기록되는 대상이 FSx for Lustre 파일시스템입니다. 따라서 quilting을 사용하더라도, 최종 I/O 성능은 FSx for Lustre의 처리량과 컴퓨팅 노드와의 배치에 영향을 받습니다.
참고로 이 글에서 제시한 실행 비용은 EC2 On-Demand 컴퓨트 비용만 기준으로 계산했습니다. FSx for Lustre 스토리지 비용과 데이터 전송 비용은 포함하지 않았습니다. 실제 총소유비용을 산정할 때는 파일시스템 용량, 처리량 등급, 사용 시간에 따른 FSx for Lustre 비용을 별도로 고려해야 합니다.
2. 인코어드의 AWS HPC 사용 소감
2.1 장점
온프레미스 환경 없이 고성능 컴퓨팅을 확보할 수 있습니다. HPC 클러스터를 자체 구축하려면 대규모 초기 투자, 물리 공간, 냉각과 전력 인프라, 운영 인력이 필요합니다. AWS HPC 클러스터를 사용하면 이런 선투자 없이도 최신 세대 프로세서와 최대 300 Gbps 대역폭의 EFA 같은 고성능 하드웨어를 필요할 때 바로 확보할 수 있습니다. WRF처럼 매일 정해진 시간 안에 한 번씩 돌리는 워크로드는, 24시간 상시 가동하는 온프레미스 기반 클러스터보다 필요 시점에만 띄우는 클라우드 방식이 자원 활용 면에서 합리적입니다.
하나의 인스턴스 패밀리 안에서 vCPU 규모를 골라 쓸 수 있습니다. 예를 들어 hpc7g에는 hpc7g.4xlarge(16 vCPU), hpc7g.8xlarge(32 vCPU), hpc7g.16xlarge(64 vCPU)가 있어, 워크로드 규모와 도메인 크기에 맞춰 인스턴스 크기를 선택할 수 있습니다. 이렇게 하면 과다 또는 과소 프로비저닝을 줄이고 비용을 워크로드에 맞춰 조정하기 쉽습니다.
성능 일관성이 매우 높습니다. 측정 신뢰도를 확인하기 위해 hpc8a 3노드 설정을 반복 실행했습니다. 반복 결과, 같은 설정 안에서의 실행 시간 변동은 매우 작았습니다.
- 3노드 24:8: 97.22분 / 97.25분 / 97.27분 (최대 차이 0.05분, 약 3초)
- 3노드 48:4: 98.07분 / 98.13분 / 98.17분 (최대 차이 0.10분, 약 6초)
- 3노드 64:3: 101.10분 / 101.12분 / 101.13분 / 101.20분 (최대 차이 0.10분, 약 6초)
여기서 중요한 점은, 같은 설정을 반복했을 때의 변동폭보다 설정 간 평균 실행 시간 차이가 훨씬 크다는 것입니다. 예를 들어 24:8의 평균은 약 97.25분, 48:4의 평균은 약 98.12분으로 두 설정 간 차이는 약 0.87분, 약 52초입니다. 이는 같은 설정 안에서 관찰된 최대 변동폭인 6초보다 8배 이상 큽니다. 또한 64:3의 평균은 약 101.14분으로, 48:4보다 약 3.02분, 24:8보다 약 3.89분 더 느렸습니다.
따라서 24:8, 48:4, 64:3 사이의 차이는 반복 실행 시 발생하는 우연한 편차라고 보기 어렵고, MPI:OpenMP 비율 차이에서 나온 실제 성능 차이로 해석할 수 있습니다. 특히 64:3은 4회 모두 101분대로 측정되어, 목표 시간 초과가 일시적 변동이 아니라 해당 설정의 반복 가능한 특성임을 보여줍니다.
이 정도의 일관성은 두 가지를 뜻합니다. 첫째, hpc8a 하드웨어와 EFA가 매우 안정적인 성능을 제공합니다. 둘째, 측정한 설정 간 차이(약 0.87분에서 3.89분)가 노이즈가 아니라 실제 신호라는 것을 뒷받침합니다. 목표 시간을 평균이 아니라 worst-case(최대값) 기준으로 판단해야 하는 운영 입장에서, 이 낮은 분산은 그 자체로 가치가 큽니다. HPC 전용 인스턴스는 SMT(하이퍼스레딩)가 비활성화되어 있어 1 vCPU가 1 물리 코어에 해당하므로 성능 예측이 단순하고, EFA의 kernel-bypass 방식 덕분에 메시징이 커널을 거치지 않아 지연이 안정적입니다.
2.2 제약사항
현재 HPC 전용 인스턴스를 서울 리전에서 사용할 수 없습니다. AWS HPC 전용 인스턴스(hpc6a, hpc7a, hpc7g, hpc8a)는 미국 동부 리전과 일부 유럽 및 아시아 리전 위주로 제공됩니다. hpc8a는 2026년 3월 도쿄 리전에 추가되었습니다. 한국 기업이 HPC 워크로드를 운영하려면 해외 리전(예: 미국 오하이오 또는 도쿄 리전)을 사용해야 하고, 이는 데이터 이동 거리에 따른 네트워크 지연, 데이터 소재지(데이터 거버넌스) 측면의 검토 부담을 동반합니다. (지원 리전은 변경될 수 있으므로 도입 시점에 Amazon EC2 인스턴스 페이지에서 최신 지원 리전을 확인하시길 권합니다.)
신규 인스턴스일수록 수요가 몰리는 시간대에 노드 확보가 어려울 수 있습니다. hpc8a처럼 비교적 최근 출시된 인스턴스는, 수요가 집중되는 시간대에 원하는 노드 수를 한 번에 확보하지 못할 가능성이 있습니다. 매일 정해진 시간 창 안에 목표 시간을 맞춰야 하는 운영 입장에서는, 노드 확보 자체가 지연되면 시작 시점이 밀려 위험이 될 수 있습니다. 안정적인 운영을 위해서는 EC2 On-Demand Capacity Reservations 등으로 필요한 노드 용량을 사전에 확보하는 방안을 함께 검토하는 것이 안전합니다.
맺음말
이 시리즈는 클라우드에서 WRF 같은 HPC 워크로드를 효율적으로 운영하는 방법을 두 층위로 나눠 다뤘습니다. 1부에서는 어떤 인스턴스를 몇 노드로 선택할 것인가를, 2부에서는 선택한 인스턴스 안에서 MPI rank와 OpenMP thread를 어떻게 배치할 것인가를 실측 데이터로 살펴봤습니다. 두 편을 관통하는 교훈은 하나입니다. 시간당 단가나 CPU 사용률 같은 겉보기 지표가 아니라, 작업을 목표 시간 안에 끝내는 실제 실행 시간과 총비용으로 판단해야 한다는 점입니다.
1부의 결론은 인스턴스를 시간당 단가가 아니라 완료까지의 총비용으로 판단해야 한다는 것입니다. 노드당 단가가 낮은 인스턴스라도 목표 시간을 맞추기 위해 더 많은 노드가 필요하다면 총비용은 오히려 커질 수 있습니다. 이번 실험에서는 노드당 단가가 낮고 실행 시간도 가장 짧았던 hpc7g 10노드 구성이 시간과 비용 측면에서 가장 좋은 결과를 보였습니다. hpc8a는 hpc6a를 대체할 수 있는 가능성을 보였지만, 이번 WRF 워크로드에서는 hpc7g를 대체하기에는 비용 효율 측면에서 충분하지 않았습니다.
2부의 첫 번째 결론은 WRF의 병렬화 효율이 코어 수만으로 결정되지 않는다는 것입니다. 이번 hpc8a 테스트에서는 노드 수와 MPI:OpenMP 구성을 어떻게 조합하느냐에 따라 실행 시간이 달라졌습니다. hpc8a 전체 테스트 설정 중 가장 느린 구성과 가장 빠른 구성의 실행 시간 차이는 최대 약 22%(2노드 64:3 124.24분 → 3노드 24:8 97.25분)였습니다. 다만 이 값은 MPI:OpenMP 비율만의 효과가 아니라, 2노드와 3노드의 노드 수 차이까지 함께 반영된 결과입니다. 같은 노드 수 안에서 비교하면 2노드는 MPI/OpenMP 양극단(96:2 vs 24:8) 기준 약 4.5%(64:3의 비단조성까지 포함한 2노드 전체 편차는 48:4 vs 64:3 약 10%), 3노드는 약 4%의 차이가 나타났습니다.
핵심은 MPI rank를 무작정 늘리는 것이 항상 유리하지 않다는 점입니다. 2노드 96:2 구성은 24:8 구성 대비 tx_bytes가 24.8% 증가한 반면, tx_pkts는 84.6% 증가했습니다. 평균 패킷 크기도 5,968 bytes에서 4,032 bytes로 줄었습니다. 이는 대역폭 포화보다는 작은 패킷 증가에 따른 통신 처리 오버헤드가 실행 시간 증가에 영향을 주었음을 시사합니다. 또한 인코어드의 모 도메인 d01에서는 계산에 사용할 수 있는 MPI rank 수가 최대 180개로 제한됩니다. 따라서 hpc8a처럼 노드당 코어 수가 많은 인스턴스에서는 코어 수를 단순히 MPI rank로만 늘리기보다, 도메인 크기에 맞춰 MPI rank와 OpenMP thread의 균형을 잡는 것이 중요합니다.
2부의 두 번째 결론은 CPU 사용률만으로 MPI 워크로드의 효율을 판단해서는 안 된다는 것입니다. MPI rank 비중이 높은 구성에서는 CPU 사용률이 더 높게 보였지만, 실행 시간은 오히려 더 길었습니다. 따라서 CPU 사용률이 높다는 사실만으로 유효 계산이 많거나 자원을 잘 활용하고 있다고 판단하기는 어렵습니다. tightly-coupled MPI 워크로드에서는 CPU 사용률과 함께 wall time, step time, EFA tx_pkts, tx_bytes, 평균 패킷 크기 같은 통신 지표를 함께 봐야 합니다.
이 글의 수치를 그대로 여러분의 환경에 이식해서는 안 됩니다. 1부의 최적 인스턴스와 2부의 효율적인 MPI:OpenMP 구성은 모두 인코어드의 도메인 구성, 특히 모 도메인 d01의 격자 크기에 강하게 의존합니다. 도메인 크기, 격자 해상도, nesting 구성, 출력 방식이 달라지면 병렬화 상한과 효율적인 MPI:OpenMP 구성도 달라질 수 있습니다. 따라서 클라우드에서 WRF 같은 HPC 워크로드를 운영하려는 조직은 인스턴스의 시간당 단가나 코어 수만 보지 말고, 자신의 도메인 구조에서 직접 측정해 최적 구성을 찾아야 합니다. 이 블로그 시리즈가 전달하려는 핵심은 특정 숫자가 아니라, 그 숫자에 도달하는 방법론입니다.
끝으로, 인코어드가 온프레미스 HPC 환경에서 AWS HPC로 전환한 도입 여정과 초기 검증 과정이 궁금하신 분들은 AWS Summit Seoul 2024 세션 “AWS의 고성능 컴퓨팅 환경을 활용한 인코어드의 에너지 솔루션 고도화 여정”을 참고하시길 권합니다. 이 블로그가 다루는 세부 튜닝 이전의 큰 그림, 즉 왜 인코어드는 AWS HPC로 클러스터를 이전하였고 어떻게 활용하고 있는지 잘 정리되어 있습니다.
저자 소개
이효섭
이효섭 부사장은 전력거래 솔루션 전문 기업인 인코어드 테크놀로지스의 운영을 총괄하며, KAIST 녹색성장대학원 겸임교수로 재직하고 있습니다. 고성능 컴퓨팅(HPC) 기반 병렬 수치해법 연구로 계산과학 분야 박사학위를 취득했으며, 현재는 전력판매 수익 최적화를 위한 서비스 개발과 사업화에 주력하고 있습니다.
이선정
이선정 연구본부장은 서울대학교 수리과학부에서 박사 학위를 받았으며, 현재 인코어드테크놀로지스 연구본부를 총괄하고 있습니다. AWS 기반 HPC 클러스터로 자체 기상예보 시스템을 구축해 재생에너지 발전량 예측의 정확도와 비용 효율을 함께 높이는 일을 하고 있습니다.
안건형
안건형 인프라팀 팀장은 전력거래 솔루션 전문 기업 인코어드 테크놀로지스에서 클라우드 설계, DevSecOps, 네트워크 및 보안 관리를 담당하며 AWS기반인 자체 VPP SaaS 플랫폼 인프라를 안정적으로 유지보수하고 있습니다. 또한 이번 WRF 시뮬레이션용 AWS HPC 인프라 구성과 같이 사내 연구팀의 원활한 연구를 돕기 위한 기술 지원을 수행하고 있습니다.
양선영
양선영 매니저는 인코어드테크 놀로지스에서 AWS HPC 환경을 기반으로 재생에너지 발전량 예측용 수치 기상 예보 시스템을 구축 및 운영하고 있습니다.
또한 글로벌 기상자료를 가공하는 데이터 파이프라인과 AI 기반 기상 예측 모델 연구를 함께 수행하고 있습니다.