O blog da AWS
Como a Certta unificou a governança de custos de IA generativa na AWS
Por Rafael Luiz Siebeneichler, Tech Lead na Certta; Matheus Campos, Engenheiro de Software na Certta e João César, Arquiteto de Soluções para startups na AWS.
Nesta publicação, explicamos como a Certta saiu de um cenário de adoção fragmentada de assistentes de IA para uma arquitetura que unificou o controle de custos e de tokens de todas as suas equipes, reduziu a complexidade operacional e criou um caminho de governança ativa que se estende hoje a qualquer novo modelo ou provedor.
Sobre a Certta
A Certta é um hub de verificação inteligente, fundado em 2019, que integra soluções antifraude, verificação de identidade e verificação de documentos para mais de 300 clientes — entre eles bancos, fintechs, seguradoras, provedores de pagamento e empresas de delivery.
O desafio: adoção de IA generativa sem controle de custo
Um levantamento da Ernst & Young (Pulse AI Survey, julho de 2026) mostra que 82% dos C-levels estão preocupados com o consumo de tokens de IA e seus custos, e 98% já revisam sua abordagem de adoção de IA para equilibrar custo e valor. Esse é exatamente o ponto de partida da jornada da Certta: como a própria equipe resume, “o erro não são os modelos, e sim usá-los sem governança”.
A adoção de assistentes de IA generativa na Certta cresceu de forma orgânica: o time de engenharia começou testando o Claude Code, depois o time de negócio quis experimentar o Claude Desktop, ao mesmo tempo que os próprios agentes de IA da empresa já chamavam o Amazon Bedrock diretamente. Em pouco tempo, o problema passou a ser como gerenciar tudo isso. Perguntas como “qual o modelo mais usado?”, “quanto cada colaborador consumiu de tokens?” ou “quanto cada área pode gastar por mês?” não tinham uma resposta clara.
A decisão: por que mudar a forma de contratação
Ao avaliar o modelo de contratação atual, a equipe da Certta identificou três problemas que esse modelo de licenciamento por assinatura não resolvia:
- Governança descentralizada: a equipe da Certta queria ter um modelo centralizado de gestão de usuários e acessos seguindo os padrões já estabelecidos.
- Privacidade e compliance: por trabalhar com dados sensíveis de identificação pessoal (PII) a Certta precisava que esses dados não saíssem do perímetro da conta AWS.
- Redução dos custos operacionais: o custo total de propriedade (TCO) sofria incidência de impostos (IOF, IRRF e PIS/COFINS) que elevavam o valor final em até 50% em relação ao preço de tabela.
A solução: um gateway multiprovedor auto-hospedado
Para superar esses desafios a Certta adotou um gateway como o ponto único de acesso que resolve tanto a questão de autenticação e autorização como a governança entre modelos. A arquitetura segue o guidance oficial da AWS Solutions Library baseado no LiteLLM, um gateway open source operado dentro da própria Amazon Virtual Private Cloud (Amazon VPC) da conta AWS, sem depender de licenciamento ou risco de lock-in com plataformas de terceiros.
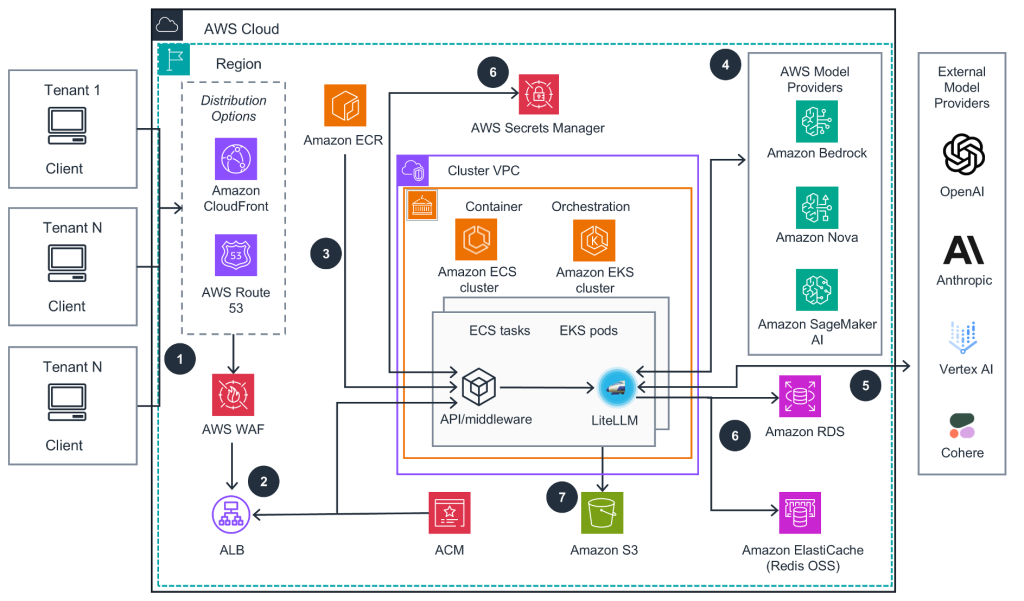
Figura 1. Arquitetura do gateway multiprovedor orquestrado pelo LiteLLM
O gateway funciona como um roteador de large language models (LLMs) para provedores internos (como por exemplo Amazon Bedrock e Amazon SageMaker AI) e também para provedores externos (como por exemplo OpenAI). Utiliza a autenticação corporativa via single sign-on e OpenID Connect (OIDC), já utilizada pela Certta, através de credenciais AWS gerenciadas centralmente.
Para o ciclo ponta a ponta de uma requisição, temos os seguintes componentes técnicos:
- Criação de um domínio customizado para acesso interno via VPN através do Amazon Route 53 e de uma zona de distribuição de conteúdo regional através do Amazon CloudFront.
- Roteamento por um balanceador de carga, através de um Application Load Balancer com AWS WAF para proteção contra explorações de vulnerabilidades em aplicação web (camada 7) e criptografia em trânsito feita por certificados SSL gerenciados através do AWS Certificate Manager (ACM).
- Orquestração em contêineres com Amazon Elastic Container Service (Amazon ECS) e AWS Fargate, com as imagens gerenciadas no Amazon Elastic Container Registry (Amazon ECR).
- Provedores internos de LLM sendo consumidos diretamente do LiteLLM apontando para o Amazon Bedrock e para o Amazon SageMaker AI no caso de modelos customizados.
- Provedores externos de LLM sendo consumidos diretamente do LiteLLM através de API Keys.
- Persistência de segredos (exemplo: API Keys) no AWS Secrets Manager e parâmetros para configuração do LiteLLM no Amazon Aurora Serverless, externos aos contêineres.
- Observabilidade via Amazon CloudWatch e uma trilha de auditoria própria construída como wrapper sobre o LiteLLM.
- Analytics com a extração dos dados do LiteLLM para um data lake no Amazon Simple Storage Service (Amazon S3), o que possibilita a geração de insights e de dashboards sobre o comportamento de uso: modelos mais utilizados, áreas que mais consomem e usuários com maior consumo.
- Provisionamento da infraestrutura como código, com todo o ambiente definido através do AWS Cloud Development Kit (AWS CDK), seguindo o padrão adotado pela Certta.
O projeto desde a idealização até a implementação em produção levou cerca de seis semanas. Nas duas primeiras semanas, a equipe fez uma avaliação sobre controles e custo; na semana seguinte o entendimento do guidance proposto pela AWS; três dias para a decisão do desenho final seguindo os padrões de segurança da Certta; duas semanas para a implementação e uma semana para migração gradual dos times para o novo gateway.
Onde a economia acontece de fato
Como todo o tráfego passa pelo gateway, as otimizações de custo deixam de depender de cada aplicação e passam a valer para todas as chamadas, configuradas em um só lugar e medidas por equipe. Três mecanismos concentram essa economia:
- Roteamento por complexidade da tarefa: o gateway classifica cada requisição e a envia ao modelo adequado: modelos menores para classificação, modelos intermediários para sumarização e análise contextual, e modelos avançados para desenvolvimento autônomo de software. A aplicação chama um único nome de modelo, e a política de roteamento fica centralizada no gateway.
- Prompt caching: o provedor armazena o trecho inicial que se repete entre chamadas, como instruções de sistema ou documentos de referência, e não o reprocessa enquanto o cache estiver válido. Isso reduz a latência e o custo de tokens de entrada. O gateway aumenta o reaproveitamento ao manter esse prefixo idêntico entre aplicações e ao enviar as chamadas para o mesmo modelo, sem dividir o cache entre implantações. Ele também reporta o uso do cache no mesmo formato para todos os provedores, padronizando o acompanhamento da taxa de acerto entre eles.
- Processamento em lote: cargas que não precisam de resposta imediata, como avaliações, reprocessamentos e geração de embeddings, rodam de forma assíncrona e custam menos por token que as chamadas sob demanda. O gateway oferece uma única interface de batch para vários provedores. As equipes usam o mesmo fluxo, sem lidar com o formato de arquivo e o processo de envio de cada provedor.
Mais do que um proxy que só redireciona as requisições, o gateway se tornou uma ferramenta de rastreabilidade e aplicação de limites de quotas para os times internos. Em uma análise inicial, a estimativa de redução no custo por tokens, chegou a até 30% para alguns cenários.
Dia 2 e operação
Após a implementação do gateway em produção, a Certta observou os seguintes pontos de melhoria:
- Onboarding de novos usuários na plataforma: antes a cada novo usuário era necessário enviar o convite manual por e-mail; hoje, a automação já cria a chave de acesso, atribui os modelos homologados para aquela área e configura automaticamente os clientes via esteira de TI.
- User experience: a experiência do usuário final continuou a mesma, com latência adicional mínima introduzida pelo gateway.
- Governança: mostra quem chamou o quê e quando, com gasto detalhado por usuário, time e chave e centro de custo definido.
- Custo de operação: o custo com a infraestrutura do gateway auto-hospedado já se paga com a economia gerada pelo modelo de pagamento por uso (por token).
- Resiliência: uma instabilidade ou throttling de quotas em um provedor de modelos não interrompe mais as tarefas dos times. Modelos de fallback entram em ação automaticamente aumentando a disponibilidade e a resiliência.
Aprendizados e próximos passos
Da jornada, a equipe da Certta destaca os aprendizados:
- Parceria AWS: a colaboração com a AWS foi fundamental desde o entendimento do problema, indicação de uma solução e acompanhamento para implantação até chegar em produção.
- Governança: usar IA generativa em produto, engenharia e negócio sem um ponto central de controle dificulta o acompanhamento de custos e o controle dos acessos; a observabilidade e a governança ocorrem quando temos um ponto centralizado de acesso.
- Uso de modelos open source: o uso do gateway facilitou a experimentação e a adoção de modelos open source para os times de engenharia sem degradar as operações.
Os próximos passos incluem a revisão contínua de modelos, expansão da governança para novos assistentes de IA generativa, unificação de outros produtos da Certta sob o mesmo gateway e controle de custo, e mais inteligência na camada de roteamento e prompt caching para uma redução ainda maior da parte operacional.
Conclusão
A jornada da Certta mostra que o principal risco da adoção de IA generativa em escala não está na escolha do modelo, mas na ausência de uma camada de governança que acompanhe esse crescimento. Ao adotar um gateway de LLM multiprovedor a Certta reduziu a complexidade operacional consolidando os gastos com IA sob o contrato já existente com a AWS e criou uma trilha de auditoria única para consumo em toda a empresa.
Em números, isso representa uma economia de US$ 38.400 por ano, independentemente do consumo de cada usuário. O roteamento por modelo também reduz o custo por token em até 30%, com uma governança que abrange colaboradores e agentes.
Se sua empresa enfrenta desafios semelhantes na governança de custos de IA generativa, veja como o guidance de um gateway multiprovedor na AWS pode lhe auxiliar.
Sobre os autores
 |
Rafael Luiz Siebeneichler é Tech Lead na Certta, formado em Engenharia da Computação, atua há mais de 10 anos na área de tecnologia, atualmente lidera iniciativas de IA em escala corporativa. https://www.linkedin.com/in/rafael-siebeneichler |
 |
Matheus Campos é Engenheiro de Software na Certta, formado em Análise e Desenvolvimento de Sistemas, atua há 5 anos na área de tecnologia e desenvolvimento de software full-stack. https://www.linkedin.com/in/matheuscampos450 |
 |
João César é Arquiteto de Soluções para startups na Amazon Web Services, baseado em São Paulo, Brasil. Com mais de 18 anos na área de tecnologia, já trabalhou com clientes enterprise na América Latina, modernização de aplicações e desenvolvimento de software. Fora do trabalho gosta de cuidar da família, cross-fiteiro e automatizar o seu homelab com serviços self-hosted. https://www.linkedin.com/in/joaogac |