O blog da AWS
Medir habilidades em escala: como a Ada reconstruiu suas entrevistas por IA no Amazon Bedrock AgentCore
Por Daniel Abib, arquiteto especialista sênior de soluções na AWS.
A Ada é uma startup brasileira que hoje se posiciona no encontro entre EdTech e HR Tech, mas que nasceu na educação e aposta nas habilidades de IA para reconstruir entrevistas. Fundada em 2018 (originalmente como Let’s Code) a empresa surgiu da percepção de Felipe Buendia Paiva, seu fundador, de que o modelo tradicional de formação para o mercado de trabalho não acompanhava a velocidade da tecnologia: uma graduação de quatro ou cinco anos entregava uma base sólida, mas dificilmente cobria a fronteira do conhecimento, que se expande mais rápido do que os currículos são montados. A proposta da Ada foi oposta: capacitação profissional express, focada no que há de mais novo, com professores que atuam no mercado.
Ao longo dos anos, esse DNA levou a empresa de cursos de formação (como as trilhas de um ano para cientista de dados e para desenvolvedor full-stack) a dois grandes serviços B2B. O primeiro é a avaliação e upskilling de talentos internos: mapeamento de habilidades, entrevistas técnicas e planos de desenvolvimento para equipes que já estão dentro das empresas. O segundo é o programa “treine para contratar”: uma empresa como o Nubank, por exemplo, patrocina uma turma de 50 alunos para preencher 10 vagas de engenharia; os 10 melhores são contratados, mas os outros 40 saem capacitados com uma nova skill no mercado, de graça, porque o patrocinador já custeou a formação. Esse modelo gera um impacto social direto: cada contrato fechado pela Ada capacita dezenas de profissionais que, mesmo sem serem contratados naquela vaga, ganham empregabilidade. No modelo de negócio atual, esse propósito se traduz em um objetivo direto: medir e desenvolver habilidades.
É nesse contexto que está o case desta publicação: como a Ada reconstruiu sua plataforma de entrevistas e avaliações conduzidas por IA sobre o Amazon Bedrock AgentCore, reduzindo falhas técnicas em entrevistas de cerca de 30% para aproximadamente 4,5%, aumentando drasticamente a precisão das avaliações e cortando custos em cerca de 25%.
O desafio: avaliar competências com rigor, em escala, sem ficar refém de um único provedor
A régua de senioridade no mercado de tecnologia é altamente individualizada: um “sênior” em uma empresa pode ser “pleno” em outra, e um “pleno” pode ser “tech lead” em uma terceira. No Brasil, o Panorama de Talentos em Tecnologia revelou que 54% dos candidatos consideram muito difícil cumprir todos os requisitos para vagas júnior, reflexo de critérios que variam de empresa para empresa. A Brasscom estima um déficit anual de 24 mil profissionais de tecnologia no país, agravado pelo descompasso entre o que cada organização define como “qualificado” para um mesmo nível. Globalmente, plataformas como a Levels.fyi existem justamente porque empresas usam sistemas de nivelamento com 7, 8 e até 13 faixas, tornando comparações diretas quase impossíveis sem normalização. A Ada queria resolver justamente isso (estabelecer um baseline objetivo de competências) e vinha fazendo esse mapeamento desde antes do boom dos modelos generativos.
As primeiras estratégias eram tradicionais: questões de teste, questões de gap, verdadeiro ou falso e exercícios de programação em um code runner na própria plataforma. Esse formato tinha duas limitações crescentes:
- Não capturava nuances. Uma prova de múltipla escolha ou um exercício isolado dizem pouco sobre como a pessoa realmente raciocina.
- Ficou frágil diante da IA generativa. Um exercício de código que levava 20 minutos passou a ser respondido em 1 minuto com um assistente de IA, comprometendo a validade da avaliação.
A resposta da Ada foi desenvolver uma IA conversacional capaz de conduzir entrevistas técnicas e de screening, extraindo tanto hard skills quanto soft skills. O fluxo tinha duas etapas: um modelo conversa com o candidato e, em seguida, um segundo modelo transforma a conversa em insumos de avaliação, por exemplo, atribuindo níveis a competências como navegação em nuvem, orquestração de contêineres e análise de dados.
Mas colocar essa IA para funcionar bem em português revelou gargalos sérios:
- Qualidade de voz em português. Para muitos provedores, o português é tratado quase como uma língua de “terceira prioridade” (tier 3), recebendo menos investimento de treinamento e ajuste que o inglês, e as vozes soavam robóticas. A Ada começou com o Gemini Live, migrou para o modelo real-time da OpenAI, e ainda assim convivia com limitações.
- Dependência de um único provedor. A implementação ficava amarrada a um fornecedor específico. Cada nova versão de voz ou de modelo lançada por um provedor exigia reescrever grande parte da arquitetura para acompanhá-la.
- Instabilidade e latência. Qualquer oscilação de conexão degradava a experiência do candidato (a voz travava ou ficava robótica), e a latência prejudicava a fluência da entrevista. Cerca de 30% das entrevistas apresentavam algum tipo de problema, de ruídos pontuais a sessões que caíam e não voltavam.
- Falta de uma suíte de avaliação robusta. A empresa não tinha instrumentação forte para medir a qualidade nem da conversa nem da voz, o que era crítico, já que atestar o nível de competência de uma pessoa é a principal moeda de reputação do negócio.
“Eu não acredito que a gente tenha capacidade de crescer e amadurecer a empresa sem uma infraestrutura que nos dê devolutivas muito rápidas do que está e do que não está funcionando. Sem isso, a gente fica dependente apenas da própria criatividade para inovar.” — Tiago Marto, Senior Machine Learning Engineer da Ada
A solução: Ada reconstrói a entrevista conversacional usando Amazon Bedrock AgentCore
A virada veio de uma confluência de fatores no fim de 2025. Em um workshop da AWS, a Ada conheceu o time de especialistas da AWS (WWSO) junto com o time da Binbash, AWS Partner, e teve o primeiro contato aprofundado com o Amazon Bedrock AgentCore, que começava a ser mais amplamente divulgado. Ficou claro que ali havia como resolver os gargalos de fluência, avaliação e dependência de provedor, inclusive habilitando avaliações (evals) em tempo real.
Com o acompanhamento técnico da AWS e da Binbash, a Ada migrou toda a camada conversacional da entrevista para o Amazon Bedrock AgentCore, mantendo apenas os modelos de voz fora dele. A nova arquitetura funciona assim:
- Um modelo no centro do raciocínio, orquestrado pelo AgentCore Runtime. Hoje a Ada usa o Anthropic Claude Haiku para o raciocínio da conversa, rodando via AgentCore diretamente em sua conta AWS. A empresa começou com o Claude Sonnet e migrou para o Haiku mantendo a qualidade dos resultados e reduzindo custo.
- LiveKit para orquestrar a conversa em tempo real. A Ada subiu o LiveKit em uma instância Amazon EC2 e o utiliza como camada de pipeline agêntico e distribuição da voz. Como o LiveKit já implementa gateways para praticamente todos os provedores, trocar de voz virou uma operação simples.
- Voz especializada nas pontas. Em vez de um modelo real-time de ponta a ponta, a Ada passou a usar provedores dedicados a voz, com destaque para o ElevenLabs, que investiu fortemente em português e, no momento do corte, estava à frente dos demais na qualidade em português (a empresa também avaliou a Cartesia). Modelos dedicados a TTS (text-to-speech) e STT (speech-to-text) capturam melhor as nuances da fala.
Independência de provedor: trocar de modelo virou uma questão de uma chave
O ganho arquitetural mais importante foi deixar de estar preso a um único provedor. Antes, adotar uma nova voz ou um novo LLM significava remanejar toda a implementação. Com o AgentCore Runtime somado ao LiveKit, trocar o modelo de raciocínio (por exemplo, de Claude para outro modelo) é questão de mudar um parâmetro, e trocar a voz é possível. Isso destrava testes A/B entre vozes e modelos e permite adotar rapidamente lançamentos compatíveis, sem reescrever a solução.
Avaliação (evals): de notas de 1 a 5 para sinais binários
Um dos maiores impactos veio da suíte de avaliação construída sobre a nova infraestrutura, apoiada no AgentCore Evaluations como ferramenta para medir sistematicamente a qualidade do agente. Pela primeira vez a Ada passou a acompanhar de forma consistente test completion, aderência ao formato de saída esperado pela API, alucinação, fuga do tema, coerência e latência.
Com esses dados em mãos, a empresa percebeu um problema conhecido na literatura, mas cujo tamanho só ficou evidente com números próprios: pedir ao modelo uma nota de 1 a 5 gerava muitos erros marginais (um 4 que deveria ser 5, um 3 que deveria ser 4). Para um processo seletivo idôneo (ou um ciclo de avaliação e feedback), um erro de um ponto é relevante.
A solução foi binarizar as avaliações: em vez de “avalie de 1 a 5 se a pessoa sabe análise de dados”, a competência é quebrada em sinais binários (“consegue abrir uma tabela via código?”, “consegue extrair estatísticas descritivas?”, “consegue fazer teste de hipótese?”). Cada sinal é um sim/não, e a soma reconstrói o nível de competência com muito mais precisão.
Avaliando a qualidade da voz em português
Para a voz, a Ada montou, com apoio de uma especialista em língua portuguesa, uma suíte de critérios majoritariamente binários, aplicada a cada transição de modelo de voz. Dois exemplos:
- Entonação de perguntas. Em português, uma pergunta tem entonação ascendente. Modelos real-time que processam token a token às vezes só “percebem” que era uma pergunta na última palavra, produzindo uma fala artificial. A Ada mede a frequência desse erro em um volume de conversas.
- Prosódia / pacing. O quanto o ritmo da fala respeita a pontuação (vírgulas, acentuação). Um modelo que “atropela” uma vírgula perde naturalidade.
Como esses critérios dependem de percepção auditiva, a suíte ainda não é 100% automatizada, mas já dá à Ada critérios objetivos para afirmar que uma voz está melhor em português do que outra.
Human in the loop: especialistas em língua portuguesa validando o fluxo
Um pilar que a Ada faz questão de destacar é que a solução de IA generativa não opera sozinha: há uma camada deliberada de human in the loop conduzida por profissionais especializados em língua portuguesa. É esse trabalho humano que dá lastro à automação, traduzindo conhecimento linguístico (prosódia, entonação, fonética, ritmo da fala) em critérios objetivos que o fluxo agêntico não consegue definir sozinho.
Na prática, esse trabalho aparece em duas frentes:
- Definição dos critérios de avaliação. Foi uma especialista em língua portuguesa que estruturou a suíte de testes de voz da Ada, transformando percepções subjetivas (“essa voz soa mais natural”) em sinais binários verificáveis, como a entonação ascendente de uma pergunta ou o respeito à pontuação no ritmo da fala. Sem esse conhecimento especializado, não haveria como estabelecer o que uma “boa voz em português” significa de forma mensurável.
- Validação e ajuste contínuo do fluxo. Como os critérios de voz dependem de percepção auditiva e ainda não são 100% automatizáveis, os profissionais atuam a cada transição de modelo, ouvindo as conversas, aferindo a qualidade e realimentando os ajustes nos prompts de conversa e de avaliação. É a validação humana que confirma se uma nova voz ou um novo modelo realmente melhorou a experiência em português antes de ir para produção.
Esse arranjo (a IA generativa conduzindo o fluxo de entrevista e avaliação, com especialistas humanos validando a qualidade e calibrando os critérios) é o que permite à Ada evoluir prompts em ciclos semanais a quinzenais com confiança. A automação escala o processo; os especialistas ajudam a manter que ele continue idôneo. Como a avaliação de competências é a principal moeda de reputação do negócio, manter humanos qualificados no circuito não é um detalhe operacional, mas parte central da estratégia de qualidade.
O projeto contou com o apoio direto da Binbash, AWS Partner que atuou lado a lado com a Ada na identificação da solução, nos testes e nas validações da nova arquitetura. Em parceria com o time da AWS, a Binbash tomou com a Ada as decisões de arquitetura semana a semana (do desenho do pipeline agêntico à definição de quais métricas de avaliação faziam sentido medir), o que acelerou a maturação técnica do projeto.
Arquitetura da solução
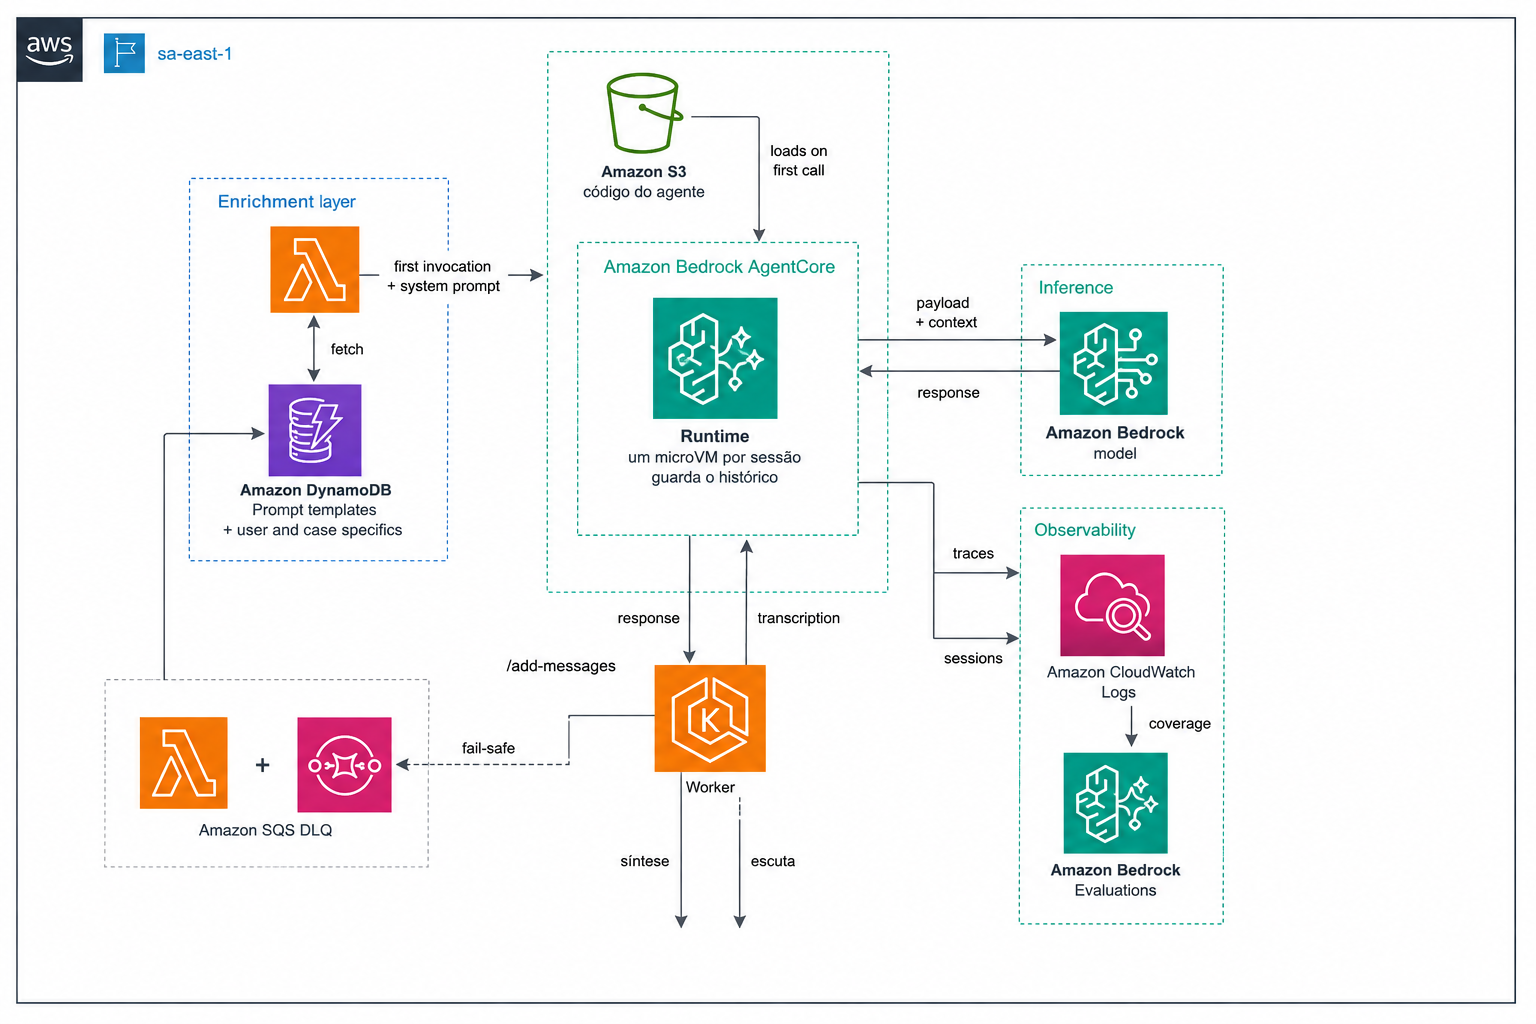
Figura 1 – Arquitetura alto nível da solução
O cold start acontece uma vez por sessão: o microVM sobe, busca o código no Amazon S3 e fixa o system prompt que o backend montou. A partir daí, cada turno de fala só carrega a transcrição; o histórico já vive dentro do runtime.
Um detalhe de infraestrutura fez diferença notável: o lançamento de recursos na região da América do Sul (São Paulo, sa-east-1) reduziu a latência em relação à operação fora da região.
Resultados
Os números a seguir refletem as medições consolidadas no fechamento do último mês de operação da nova arquitetura:
- Confiabilidade das entrevistas. A taxa de entrevistas com algum problema (quedas de conexão, falhas de API, ruídos que comprometiam a sessão) caiu de cerca de 30% para aproximadamente 4,5%. Descontados surtos pontuais de erro observados nas últimas semanas, a taxa atual está mais próxima de 2%. Os chamados de suporte caíram desde a adoção da nova arquitetura.
- Tempo de resposta a falhas. Os erros identificados na última semana foram resolvidos em cerca de 2 horas; antes, a correção podia levar até 3 dias.
- Precisão das avaliações. Com a binarização e a nova suíte de avaliação, o erro de “um clique para cima ou para baixo” em pelo menos um critério caiu de 27,5% das entrevistas para cerca de 1%: a taxa inicial vem de uma análise de 284 entrevistas do Impulsiona PcD e de programas da mesma época; nos sinais mais recentes, foram 26 erros de avaliação em 1.638 sinais.
- Redução de custo. Corte de cerca de 25% no custo por entrevista (de USD $0,5875 para $0,435, sendo cerca de $0,248 do provedor de voz e $0,187 dos demais componentes), combinando a facilidade de trocar por modelos mais econômicos (a migração de Claude Sonnet para Haiku sem perda de qualidade) e o modelo do AgentCore, que não cobra enquanto a inferência (pelo uso de CPU, quando usado no modelo de MicroVM) não está sendo executada, ao contrário de modelos real-time de ponta a ponta, que são caros.
- Velocidade de evolução do produto. Com a nova instrumentação, a Ada passou a fazer deploy de melhorias nos prompts de conversa e de avaliação em ciclos semanais a quinzenais, e a planejar as próximas features com muito mais objetividade.
- Novos negócios. A qualidade da nova voz e das avaliações binárias viabilizou um contrato que antes havia sido barrado justamente pela qualidade da voz: um programa de treinamento que começa com 100 alunos, com perspectiva de escalar para até 10.000 alunos, o que representaria cerca de quatro vezes o maior contrato atual da empresa.
“A gente é uma empresa muito data-driven. Antes, a gente delegava a nota de 1 a 5 e convivia com erros marginais. Com a infraestrutura que construímos na AWS, conseguimos enxergar exatamente onde precisávamos atacar, e reduzir a taxa de erro de avaliação de forma expressiva.” — Tiago Marto, Senior Machine Learning Engineer da Ada
Próximos passos
A nova arquitetura destravou um roadmap muito mais objetivo. Entre as próximas iniciativas da Ada:
- Memória de longo prazo (AgentCore Memory). Unificar o histórico do candidato ao longo da jornada (entrevistas diagnósticas e mentoria com IA, incluindo sessões de rubber duck), de modo que cada conversa leve em conta o que já foi discutido. Previsto para setembro de 2026.
- Novos tipos de agentes. Além dos agentes de entrevista e de mentoria já em produção, um agente de roleplay (para simular atendimento, pitch e conversas mais imersivas), reutilizando a mesma infraestrutura.
- Ampliar os guardrails usando o AgentCore, aproveitando a capacidade de interromper a conversa no meio quando ela sai do rumo, por exemplo, para validar normativas de conduta em avaliações.
- Evals em tempo real. Detectar durante a própria entrevista quando uma conversa destoa, permitindo ações imediatas do time de experiência (ex.: reoferecer a entrevista a um candidato afetado por uma falha).
- Redução adicional de latência. Buscar reduzir a latência para entrar na faixa de fluência humana, aplicando os quick wins mapeados durante o trabalho com a AWS.
Conclusão
A jornada da Ada mostra que IA generativa de alta qualidade não é privilégio de gigantes de tecnologia. Ao reconstruir sua plataforma de entrevistas e avaliações sobre o Amazon Bedrock AgentCore, uma startup brasileira conquistou independência de provedor, precisão de avaliação, fluência de voz em português e redução de custos, transformando a confiabilidade do produto e destravando novos negócios. Mais do que uma troca de tecnologia, foi a adoção de uma infraestrutura que torna a inovação mensurável e contínua.
Para saber como o Amazon Bedrock e o Amazon Bedrock AgentCore podem ajudar sua empresa a construir agentes de IA generativa, entre em contato com seu representante AWS ou visite o site do Amazon Bedrock.
Autor
 |
Daniel Abib é Arquiteto de Soluções Sênior e Especialista em Amazon Bedrock na AWS, com mais de 25 anos trabalhando com gerenciamento de projetos, arquiteturas de soluções escaláveis, desenvolvimento de sistemas e CI/CD, microsserviços, arquitetura Serverless & Containers e especialização em Machine Learning. Ele trabalha apoiando Startups, ajudando-os em sua jornada para a nuvem. |