亚马逊AWS官方博客
基于 Amazon Bedrock 的企业级 AI 数字员工平台 ava me+ 实践
摘要:本文分享神州泰岳 ava me+企业数字员工平台如何构建在 AWS 云基础设施之上,形成一套”访问 → 应用 → 模型 → Agent 执行 → 数据 → DevOps → 安全”的云原生分层架构。通过 Amazon Bedrock 提供模型推理能力、Amazon ECS Fargate 承载弹性应用、隔离沙箱承载 Agent 代码执行,me+ 让企业无需自建大模型基础设施,仅通过浏览器即可雇佣、编排一支”数字员工团队”,把市场内容生产、客户咨询响应、运营日报周报、产品调研与竞品分析、跨部门流程协同等专业能力沉淀为可复用、可协作的 AI 岗位。
目录
一、场景概述
在企业数字化转型进入深水区的今天,”让 AI 真正参与到日常业务流程”成为普遍诉求。然而大多数企业在落地生成式 AI 时都会遇到几类共性痛点:
1. 大模型基础设施门槛高
自建或直连大模型需要处理模型选型、GPU 资源、推理服务高可用、成本控制等一系列问题,中小企业难以承担,大型企业则面临多团队重复建设。
2. AI 能力难以沉淀与复用
大量提示词、业务知识散落在个人手中,一旦人员流动,能力随之流失;同一类任务(如写周报、做故障排查)在不同部门被反复”从零调教”,无法形成组织资产。
3. 单点 AI 助手难以覆盖真实业务流程
现实业务往往是多角色、多环节的协作链条,而市面上多数 AI 助手是”一问一答”的单点工具,无法像真人同事一样理解任务、自主执行、主动汇报的数字员工矩阵。
4. 数据安全与权限管控缺位
企业级应用必须解决多租户隔离、基于角色的访问控制(RBAC)、数据加密与审计等问题,直接把业务数据交给公网 AI 服务存在合规风险。
5. 与现有办公系统割裂
AI 能力若不能接入企业已有的 IM、知识库、业务系统,就只是”另一个要单独打开的工具”,难以真正嵌入工作流。
me+ 平台正是围绕上述痛点,基于 AWS 构建了一套面向企业的 AI 数字员工协作平台。
二、什么是 me+ 数字员工平台
ava me+是神州泰岳旗下 ava 2.0 数字员工矩阵的核心产品之一,定位为企业数字员工协作平台,与 avavox(语音数字员工)、ava app(个人语音助手)共同构成完整的数字员工生态。
在 me+ 中,”数字员工”是平台的核心协作单元。每位数字员工都封装了一种或多种专业能力(如撰写 PRD、做运维分析、分析数据),可以在任务或对话中被独立调用。数字员工的来源有三种:
- 平台预置专家:me+ 内置的行业专家,覆盖招聘、研发、运营、云运维等场景;
- 自建数字员工:由企业自己从零定义的个性化数字员工;
- 接入的外部 Agent:把已经在其他地方运行好的 Agent(如 OpenClaw、Hermes、DeerFlow)接入 me+ 平台。
与传统”单点 AI 助手”最大的不同在于,me+ 支持数字员工的组织化协作——通过 @ 直接向对应数字员工发布任务,多名员工自动分工、层层派发,一屏掌握全局进展。像管理真人团队一样管理 AI 团队。
me+ 具备但不限于以下能力边界,需要客观说明:它是一个数字员工协作与编排平台,模型推理能力来自其接入的大模型服务(如 Amazon Bedrock),并非替代企业既有的安全、合规、身份治理体系,而是在其之上进行编排与协作。
三、为什么选择 AWS 构建 ava me+
me+ 选择 AWS 作为底座,核心在于其”托管模型服务 + 弹性容器 + 完整安全生态”能够直接支撑数字员工平台的关键诉求。
1. Amazon Bedrock 提供开箱即用的模型推理能力
me+ 通过 Amazon Bedrock 统一接入 Anthropic Claude 系列模型(如 Claude Opus 用于复杂推理、Claude Sonnet 用于高频交互),无需自建 GPU 集群即可获得高可用的模型推理服务,并原生支持流式输出(Streaming)、工具调用(Tool Calling)、提示词缓存(Prompt Caching)等能力。参考:Amazon Bedrock 用户指南。
2. Amazon ECS Fargate 承载弹性、免运维的应用层
平台前后端以容器方式运行在 Amazon ECS Fargate 上,按需扩缩容、无需管理底层服务器,天然适配 SaaS 多租户的流量波动。参考:AWS Fargate 用户指南。
3. 隔离沙箱支撑 Agent 代码执行的安全边界
数字员工在执行数据分析、文件处理等任务时需要运行代码,me+ 通过独立的隔离沙箱(Amazon Bedrock AgentCore Code Interpreter / ECS Fargate / Lambda MicroVM 隔离任务)承载这部分工作负载,实现任务级隔离,避免用户代码触及主服务权限。参考:Amazon Bedrock AgentCore、Lambda MicroVM。
4. 完整的数据与安全服务生态
从 Amazon RDS(关系型数据)、Amazon ElastiCache(缓存)、Amazon OpenSearch Service(向量检索)到 Amazon S3(对象存储),再到 IAM、KMS、CloudWatch、VPC 私有子网等,AWS 提供了构建企业级 SaaS 所需的全套托管服务,帮助 me+ 在数据隔离、加密、审计、监控等方面达到企业级标准。
四、解决方案
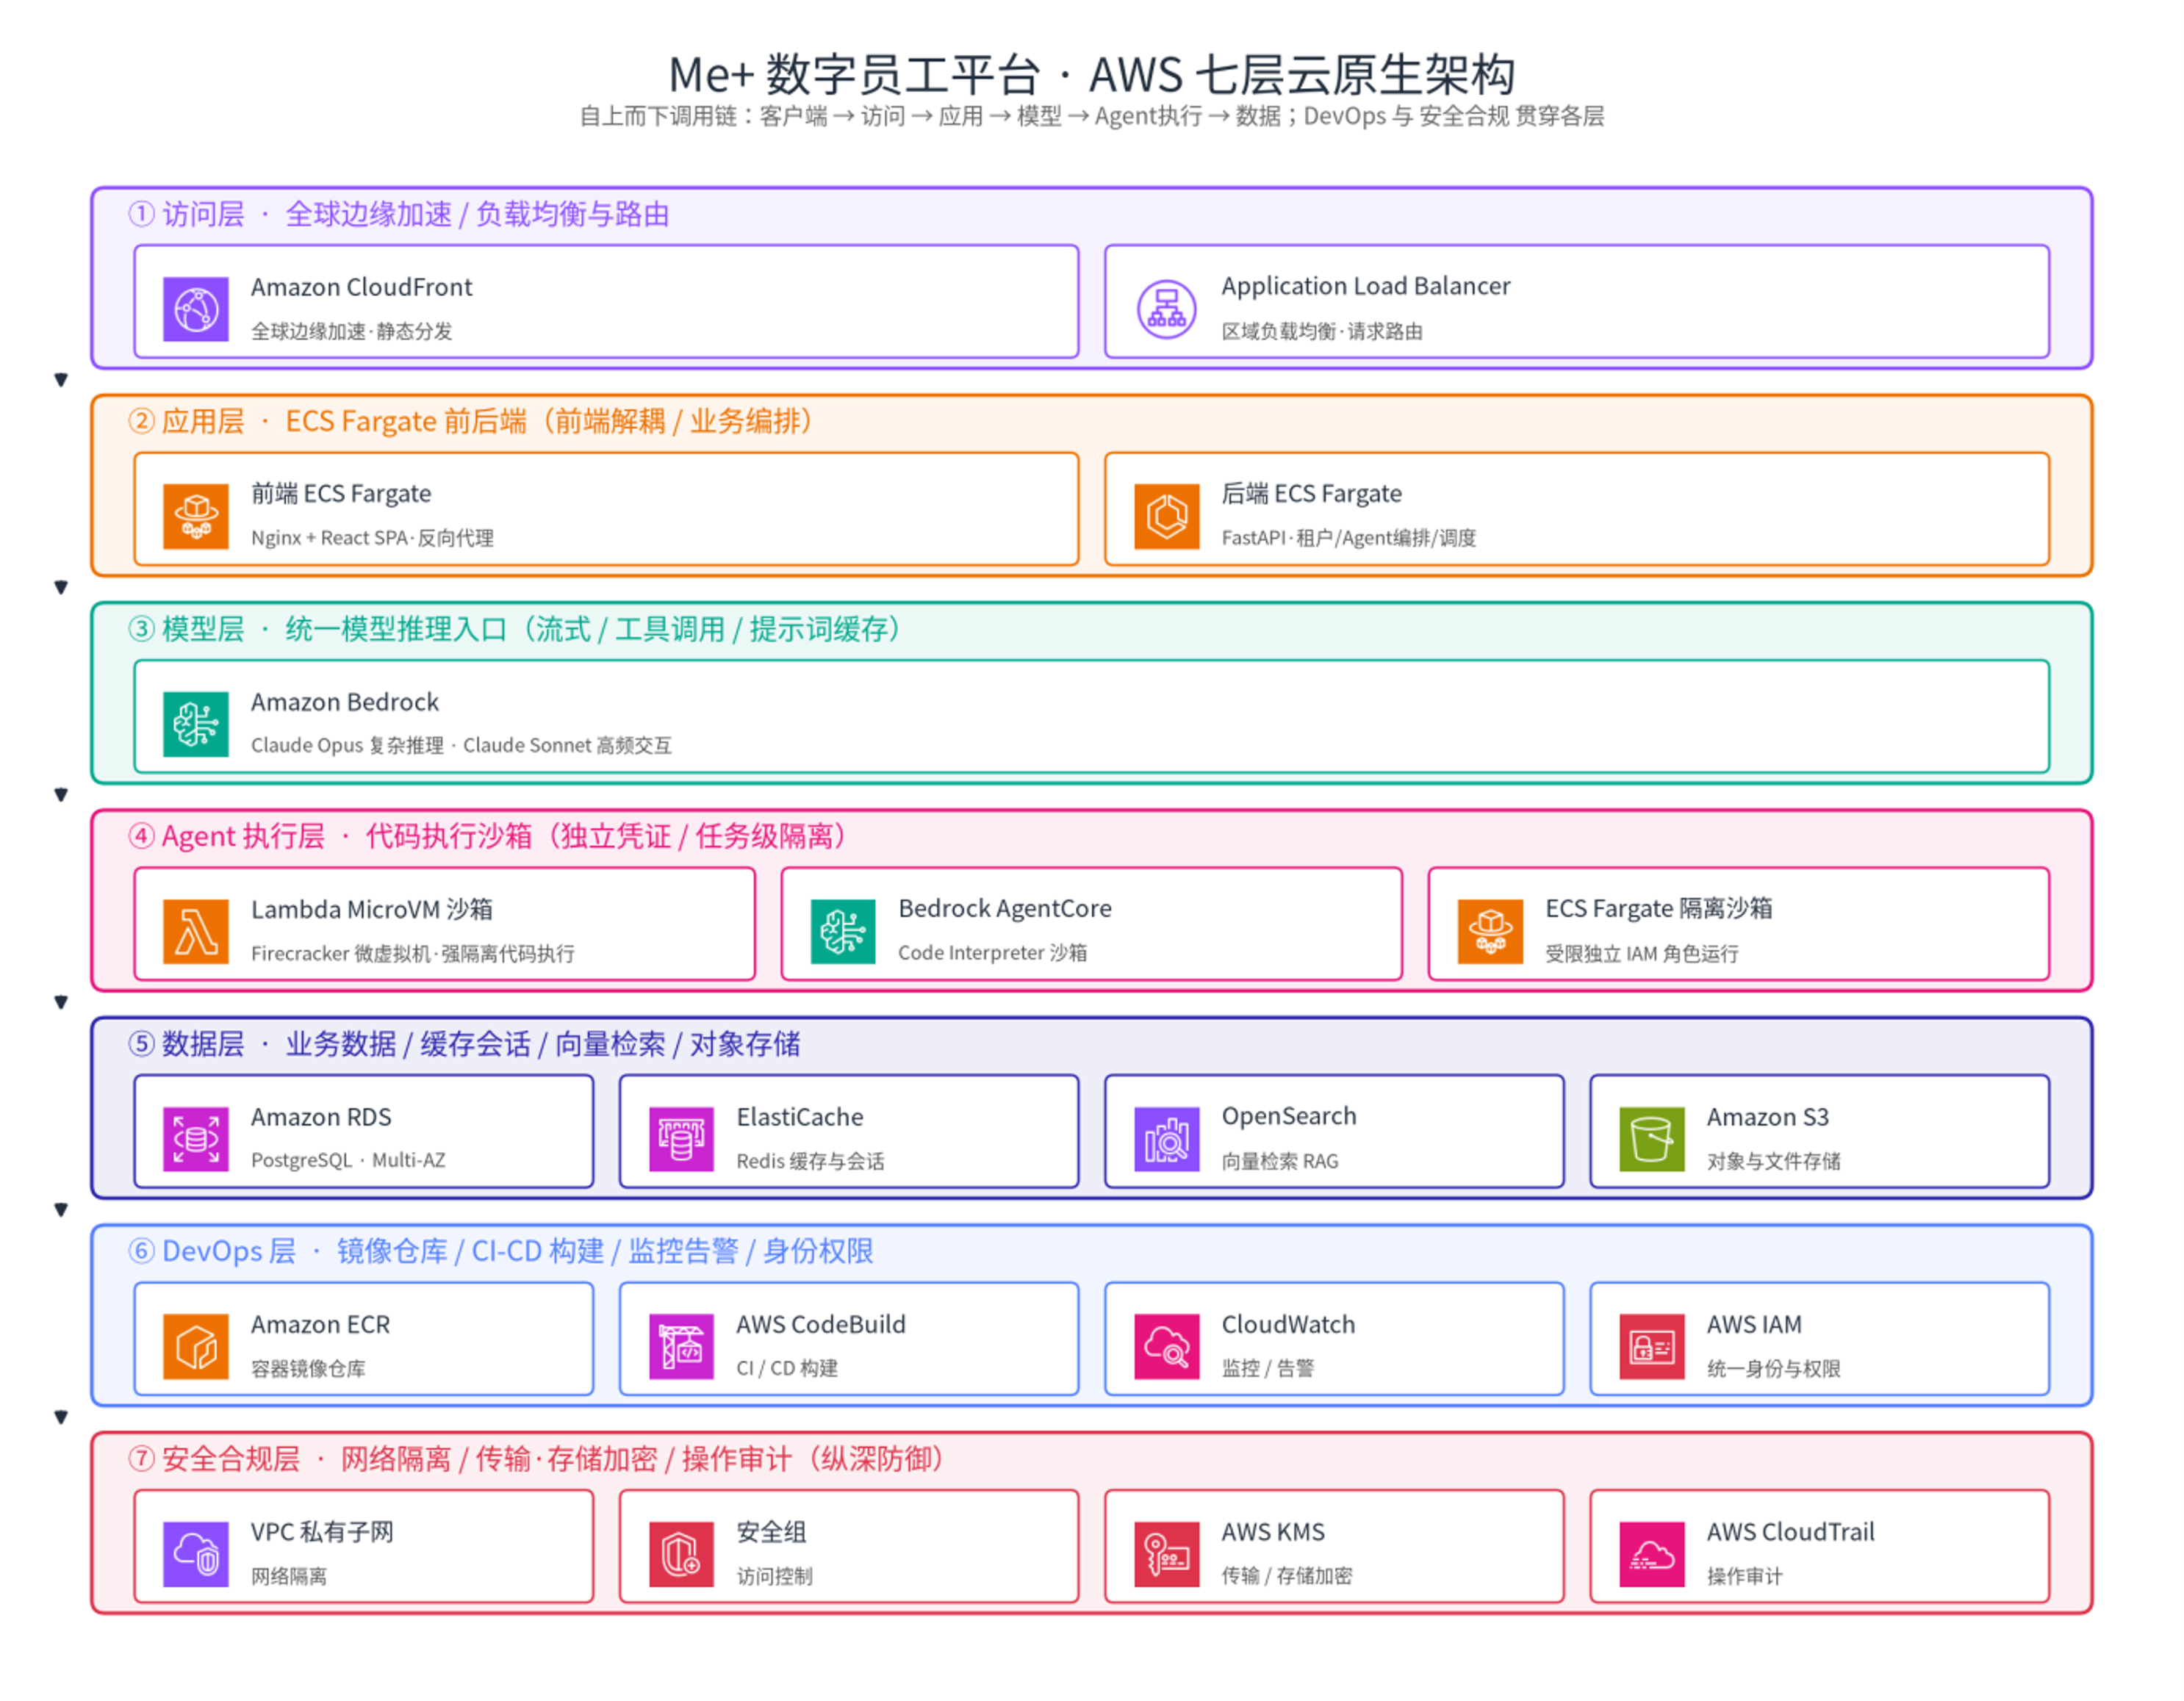
me+ 采用现代化的云原生分层架构,构建在 AWS 云基础设施之上(部署于 us-west-2 区域,Dev / Prod 双账号隔离),从用户接入到底层资源实现全链路覆盖。
4.1 整体架构
[图 1] |
平台整体划分为七个逻辑层,自上而下依次为:
| 层次 | 组成 | 职责 |
| ① 访问层 | Amazon CloudFront + Application Load Balancer (ALB) | CloudFront 提供全球边缘加速与静态资源分发,ALB 在区域内做智能负载均衡与请求路由 |
| ② 应用层 | Amazon ECS Fargate(前端 Nginx + React SPA / 后端 API) | 前端承载单页应用与反向代理,后端承载用户与租户管理、Agent 编排、后台任务调度等核心业务模块 |
| ③ 模型层 | Amazon Bedrock(Claude Opus / Claude Sonnet) | 统一的模型推理入口,支持流式输出、工具调用、提示词缓存 |
| ④ Agent 执行层 | Amazon Bedrock AgentCore Code Interpreter / ECS Fargate/Lambda MicroVM 隔离沙箱 | 承载数字员工的代码执行任务,以独立凭证与任务级隔离运行 |
| ⑤ 数据层 | Amazon RDS (PostgreSQL, Multi-AZ) + Amazon ElastiCache (Redis) + Amazon OpenSearch Service + Amazon S3 | 分别承载业务数据、缓存与会话、向量检索(RAG)、对象与文件存储 |
| ⑥ DevOps 层 | Amazon ECR + AWS CodeBuild + Amazon CloudWatch + AWS IAM+Langfuse | 镜像仓库、CI/CD 构建、监控告警与统一身份权限管理 |
| ⑦ 安全合规层 | VPC 私有子网 + 安全组 + KMS 加密 + CloudTrail 审计 | 提供网络隔离、传输与存储加密、操作审计等纵深防御 |
这种分层设计的最大优势在于高度模块化与可扩展性:各层可以独立开发、部署和扩展,前端与后端解耦、模型层与应用层解耦,使得平台在承载 SaaS 多租户流量的同时,保持良好的可维护性和成本可控性。
4.2 核心技术组件
1. 用户接入与负载分发
用户通过域名访问平台,CloudFront 完成边缘加速后,请求经 ALB 智能分发到最优的前端服务节点,确保访问体验与响应速度。
2. 应用服务解耦
前端服务(Nginx + React SPA)完成用户身份验证、权限校验和会话管理后,将请求安全转发至后端核心服务。后端按功能拆分为用户/租户管理、数字员工编排引擎、后台任务调度等模块,实现前后端与业务模块的有效解耦。
3. 模型推理编排
后端通过 Amazon Bedrock 调用 Claude 系列模型。对于复杂推理任务路由到 Claude Opus,对于高频交互任务路由到 Claude Sonnet,并结合流式输出提升交互体验、结合工具调用(Tool Calling)让数字员工能够调用外部工具与系统。
4. Agent 代码执行沙箱
当数字员工需要执行代码(如数据清洗、图表生成、文档转换)时,任务被下发到隔离沙箱执行。沙箱以受限的独立凭证运行,与主服务隔离,执行结果回传后落盘到 S3 或返回给前端。
5. 知识检索增强(RAG)
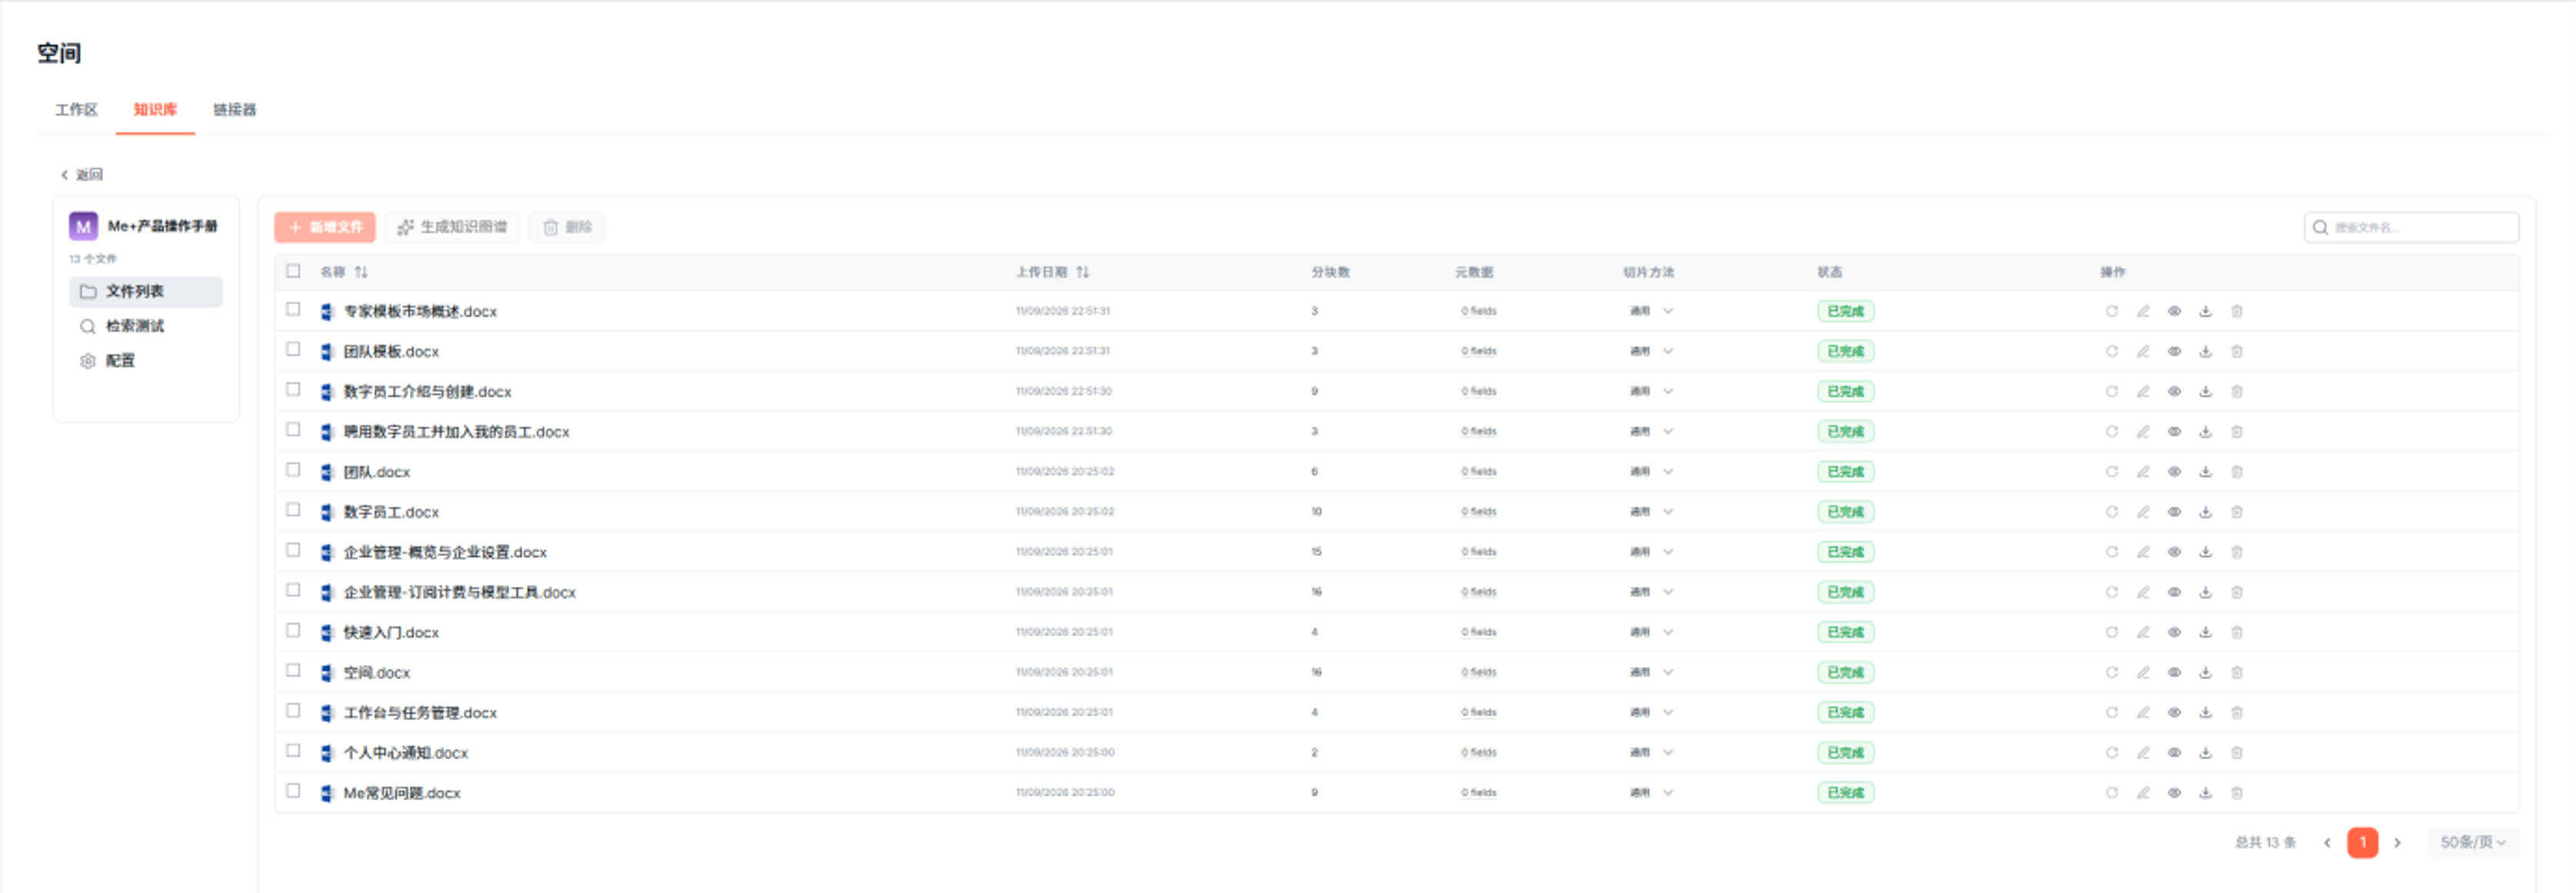
平台通过 Amazon OpenSearch Service 存储文档向量,采用混合检索(BM25 关键词检索 + k-NN 向量检索,RRF 融合并 Rerank)为数字员工提供企业知识库的检索增强能力,让回答基于企业自有知识而非泛化知识。
4.3 关键能力
me+ 在上述架构之上提供了面向企业的关键能力:
1. 人才市场,即招即用
预置产品经理、运营经理、客服专员、运维专员等多岗位模板,无需从零训练,一键雇佣、分钟级上岗,覆盖企业主要职能。
2. 真正能干活的”数字同事”
每位员工都具备独立角色身份、长期记忆、专业知识、自主执行能力与成长机制——越用越懂业务,能独立跑完整条工作流,而不只是回答问题。
3. 一句话派活,团队自动协作
通过 @ 直接向对应数字员工发布任务,多名员工自动分工、层层派发,一屏掌握全局进展,像管理真人团队一样管理 AI 团队。
4. 企业级治理,安全可控
权限分级管理 + 流程审批 + 全链路审计日志,确保每位数字员工都在安全边界内运行,让关键业务放心交付。
4.4 典型业务流程
[图 2] |
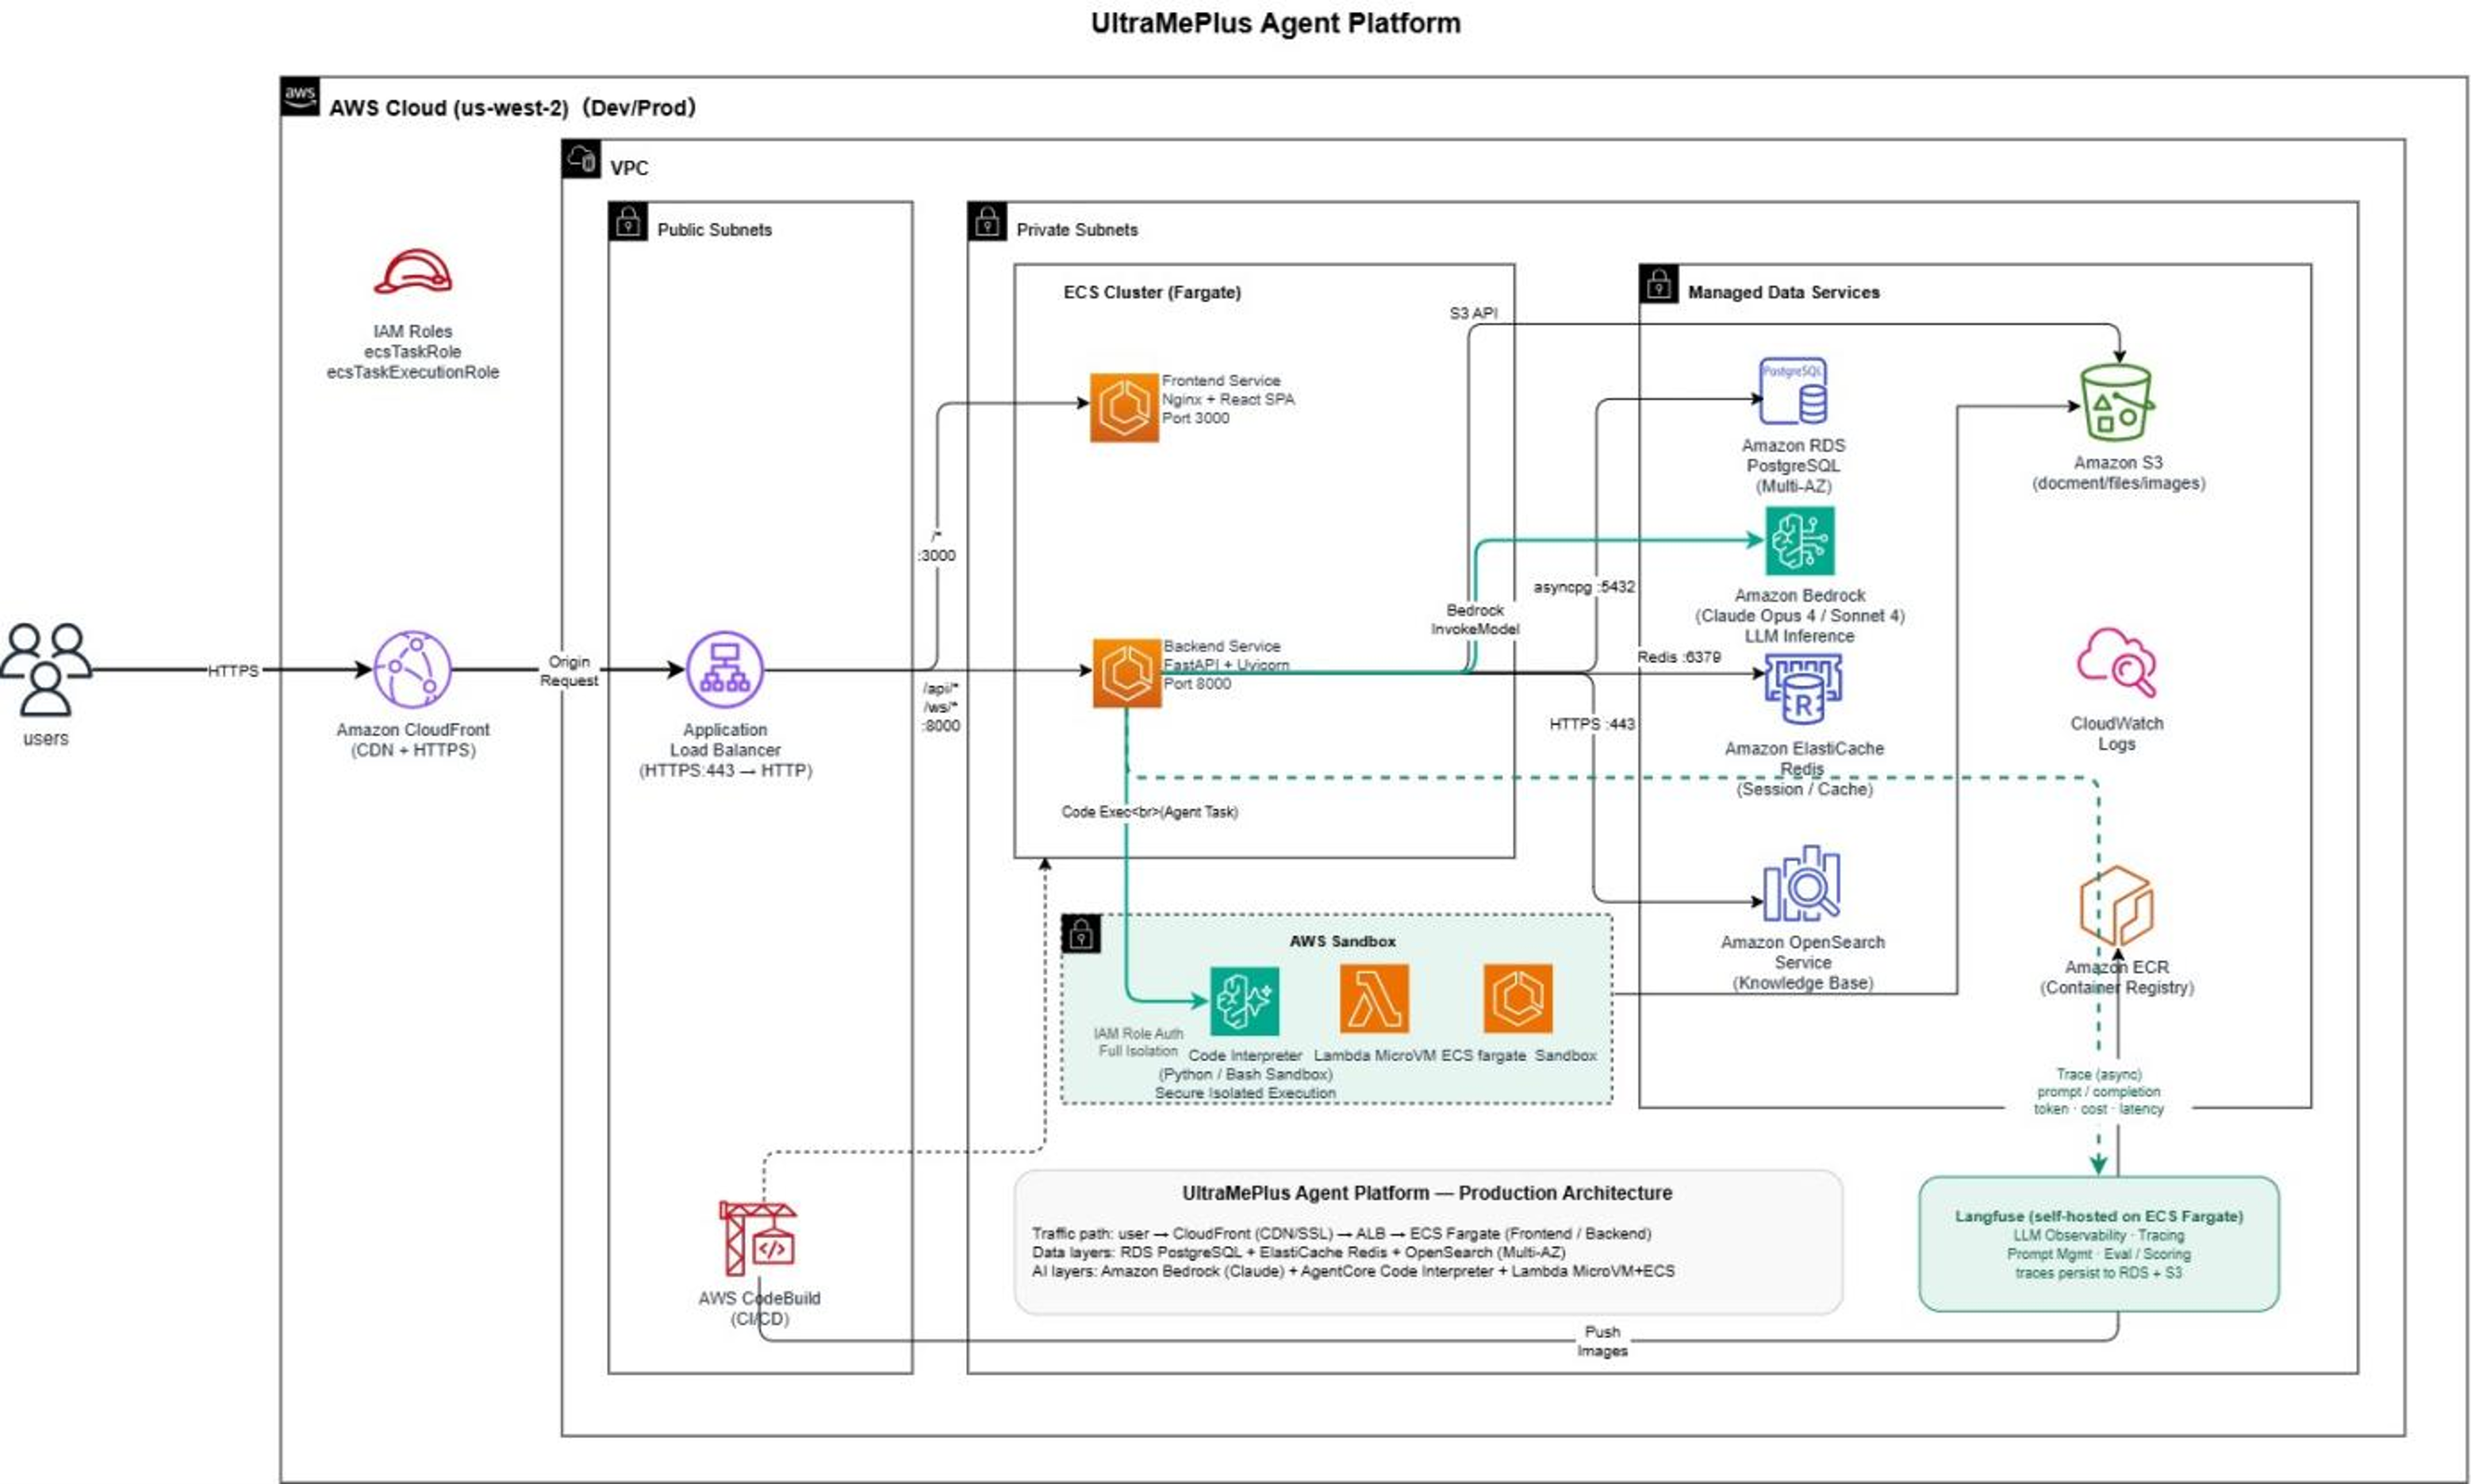
以”用户向数字员工发起一次带知识检索与代码执行的任务”为例,一次完整请求在平台内的数据流转如下(自上而下 7 步):
1. 用户发起请求
用户通过浏览器以 HTTPS 访问平台域名,系统识别用户身份并校验其访问权限(未通过则直接拒绝)。
2. 边缘接入与路由
请求先经 Amazon CloudFront 做全球边缘加速,再由 Application Load Balancer 在区域内按路径路由:/* 转发到前端服务,/api/*、/ws/* 转发到后端服务。
3. 身份认证与会话加载
前端服务(ECS Fargate)完成 Token 鉴权与会话管理,从 Amazon ElastiCache(Redis)载入该会话的上下文,随后将请求安全转发至后端 API 服务。
4. 知识检索(可选)
当任务需要企业知识时,后端先向 Amazon OpenSearch Service 发起混合检索,取回最相关的文档片段作为上下文注入模型。
[图 3] |
5. 模型推理编排
后端按任务复杂度路由到合适的 Claude 模型(复杂推理走 Claude Opus、高频交互走 Claude Sonnet),通过 Amazon Bedrock 发起推理,支持流式输出(Streaming)与工具调用(Tool Calling)。
6. 工具与代码执行
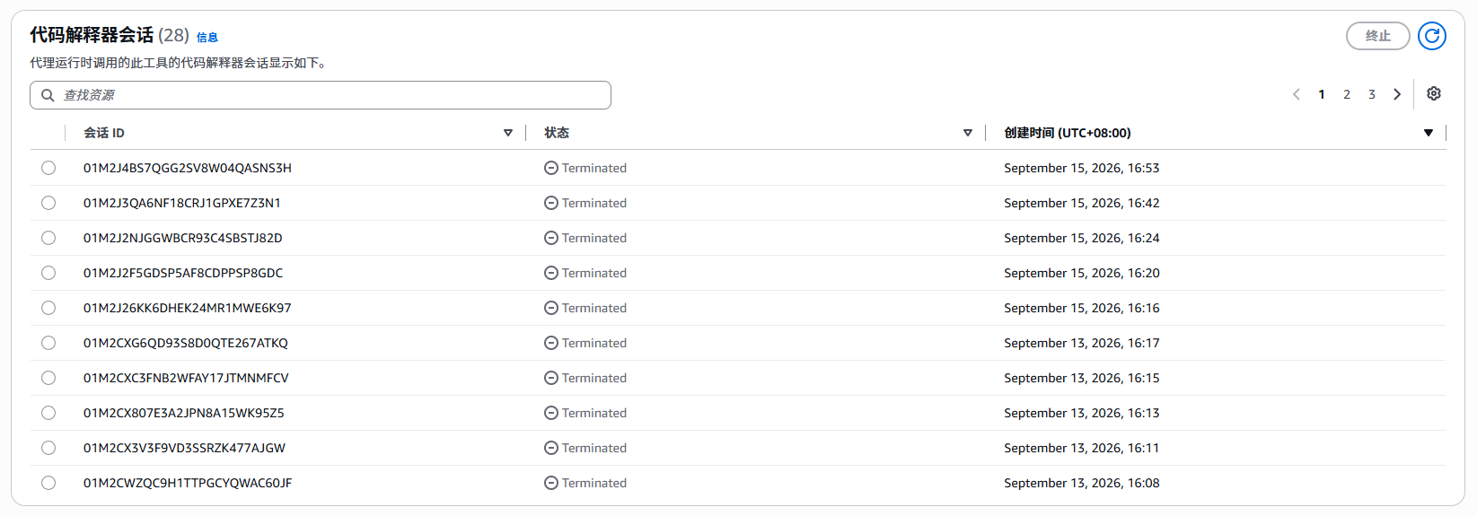
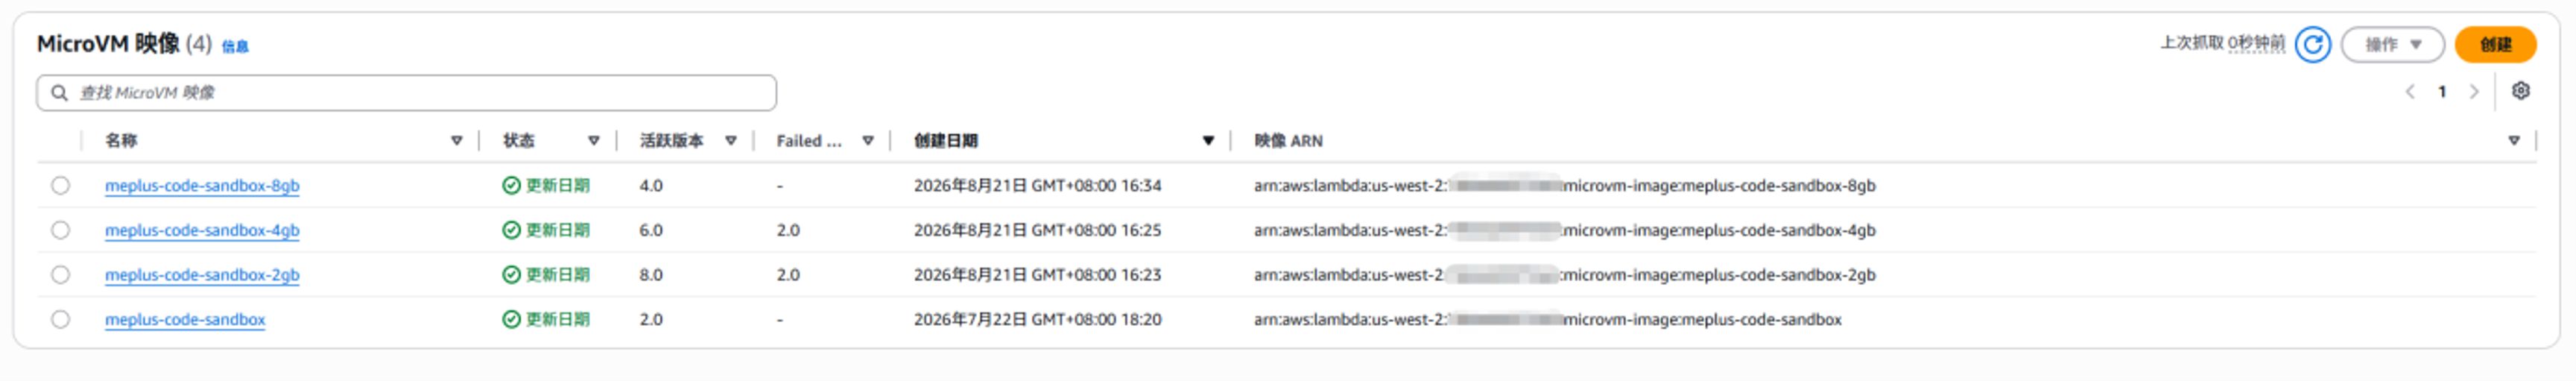
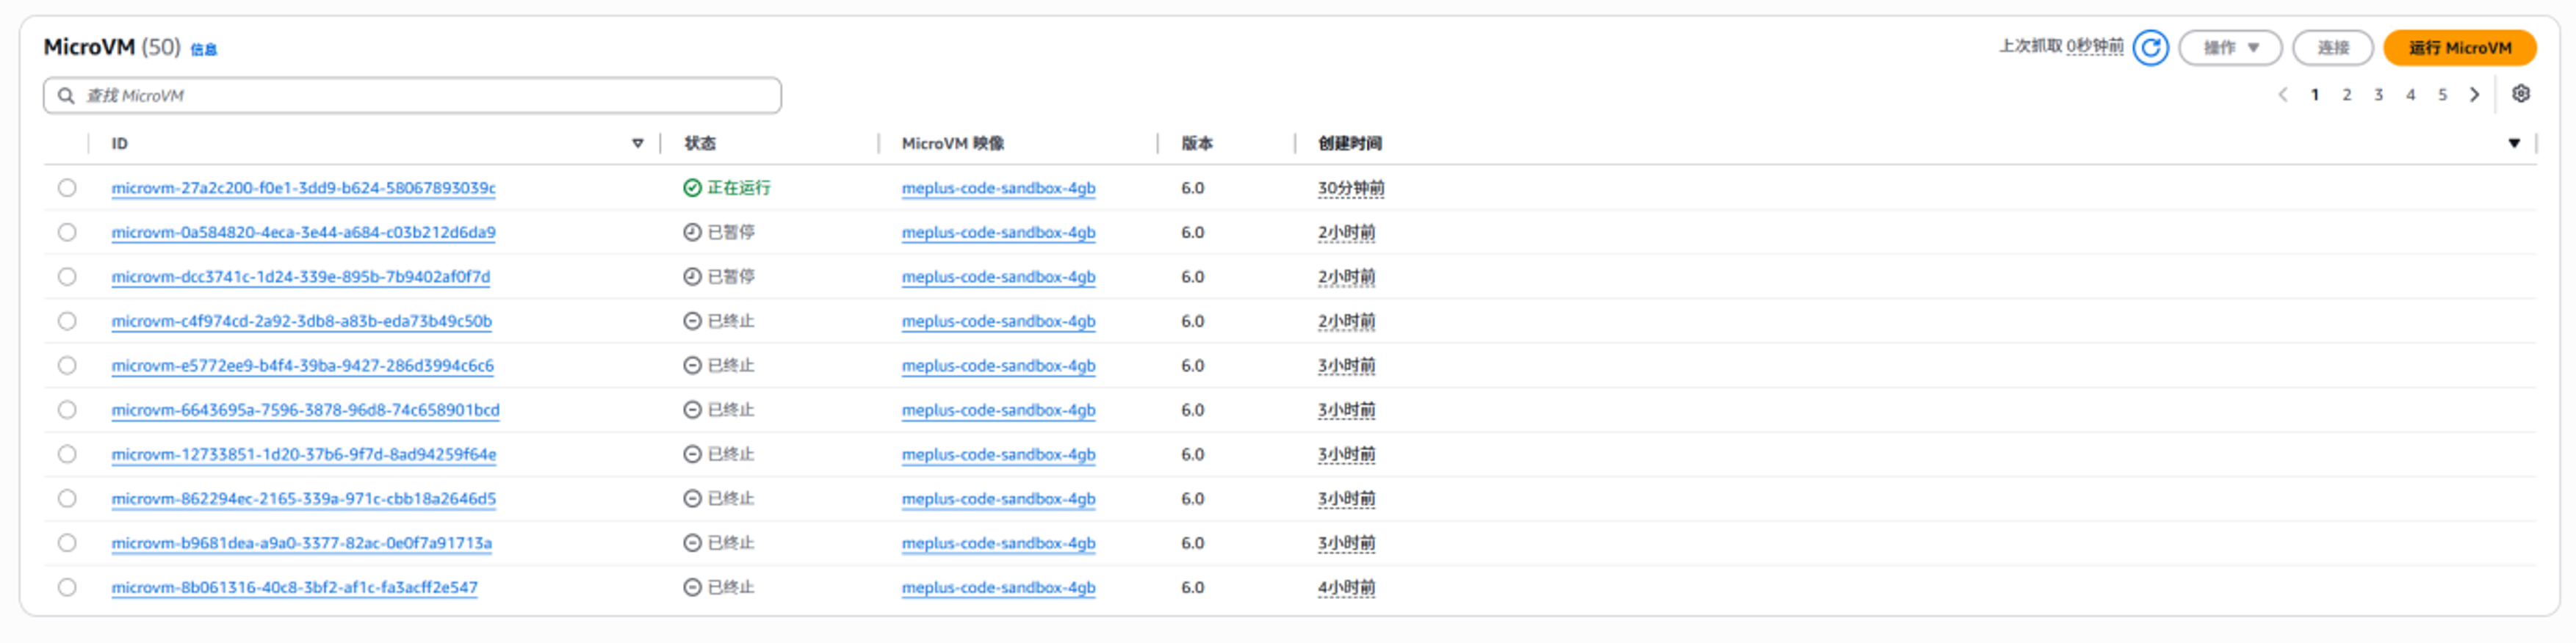
当模型返回 tool_use(需要执行代码或调用工具)时,后端把代码执行任务下发到隔离沙箱运行——可选 Lambda MicroVM 沙箱(Firecracker 微虚拟机)、Bedrock AgentCore Code Interpreter 或 ECS Fargate 隔离任务,每个沙箱以受限的独立 IAM Role 运行,与主服务完全隔离,执行结果回传后端。
[图 4] |
[图 5] |
[图 6] |
7. 结果落盘与流式返回
产物文件写入 Amazon S3,结构化结果写入 Amazon RDS(PostgreSQL),会话状态回写 ElastiCache,最终经 WebSocket / SSE 流式返回前端呈现给用户。
8. 贯穿全链路的支撑能力
CI/CD 发布流水线:开发提交代码(Git push)触发 AWS CodeBuild 完成编译、单元测试与容器镜像构建,镜像推送至 Amazon ECR 版本化存储,再滚动部署到 ECS Fargate 更新前/后端服务——为运行时持续供货,与业务请求链路解耦。
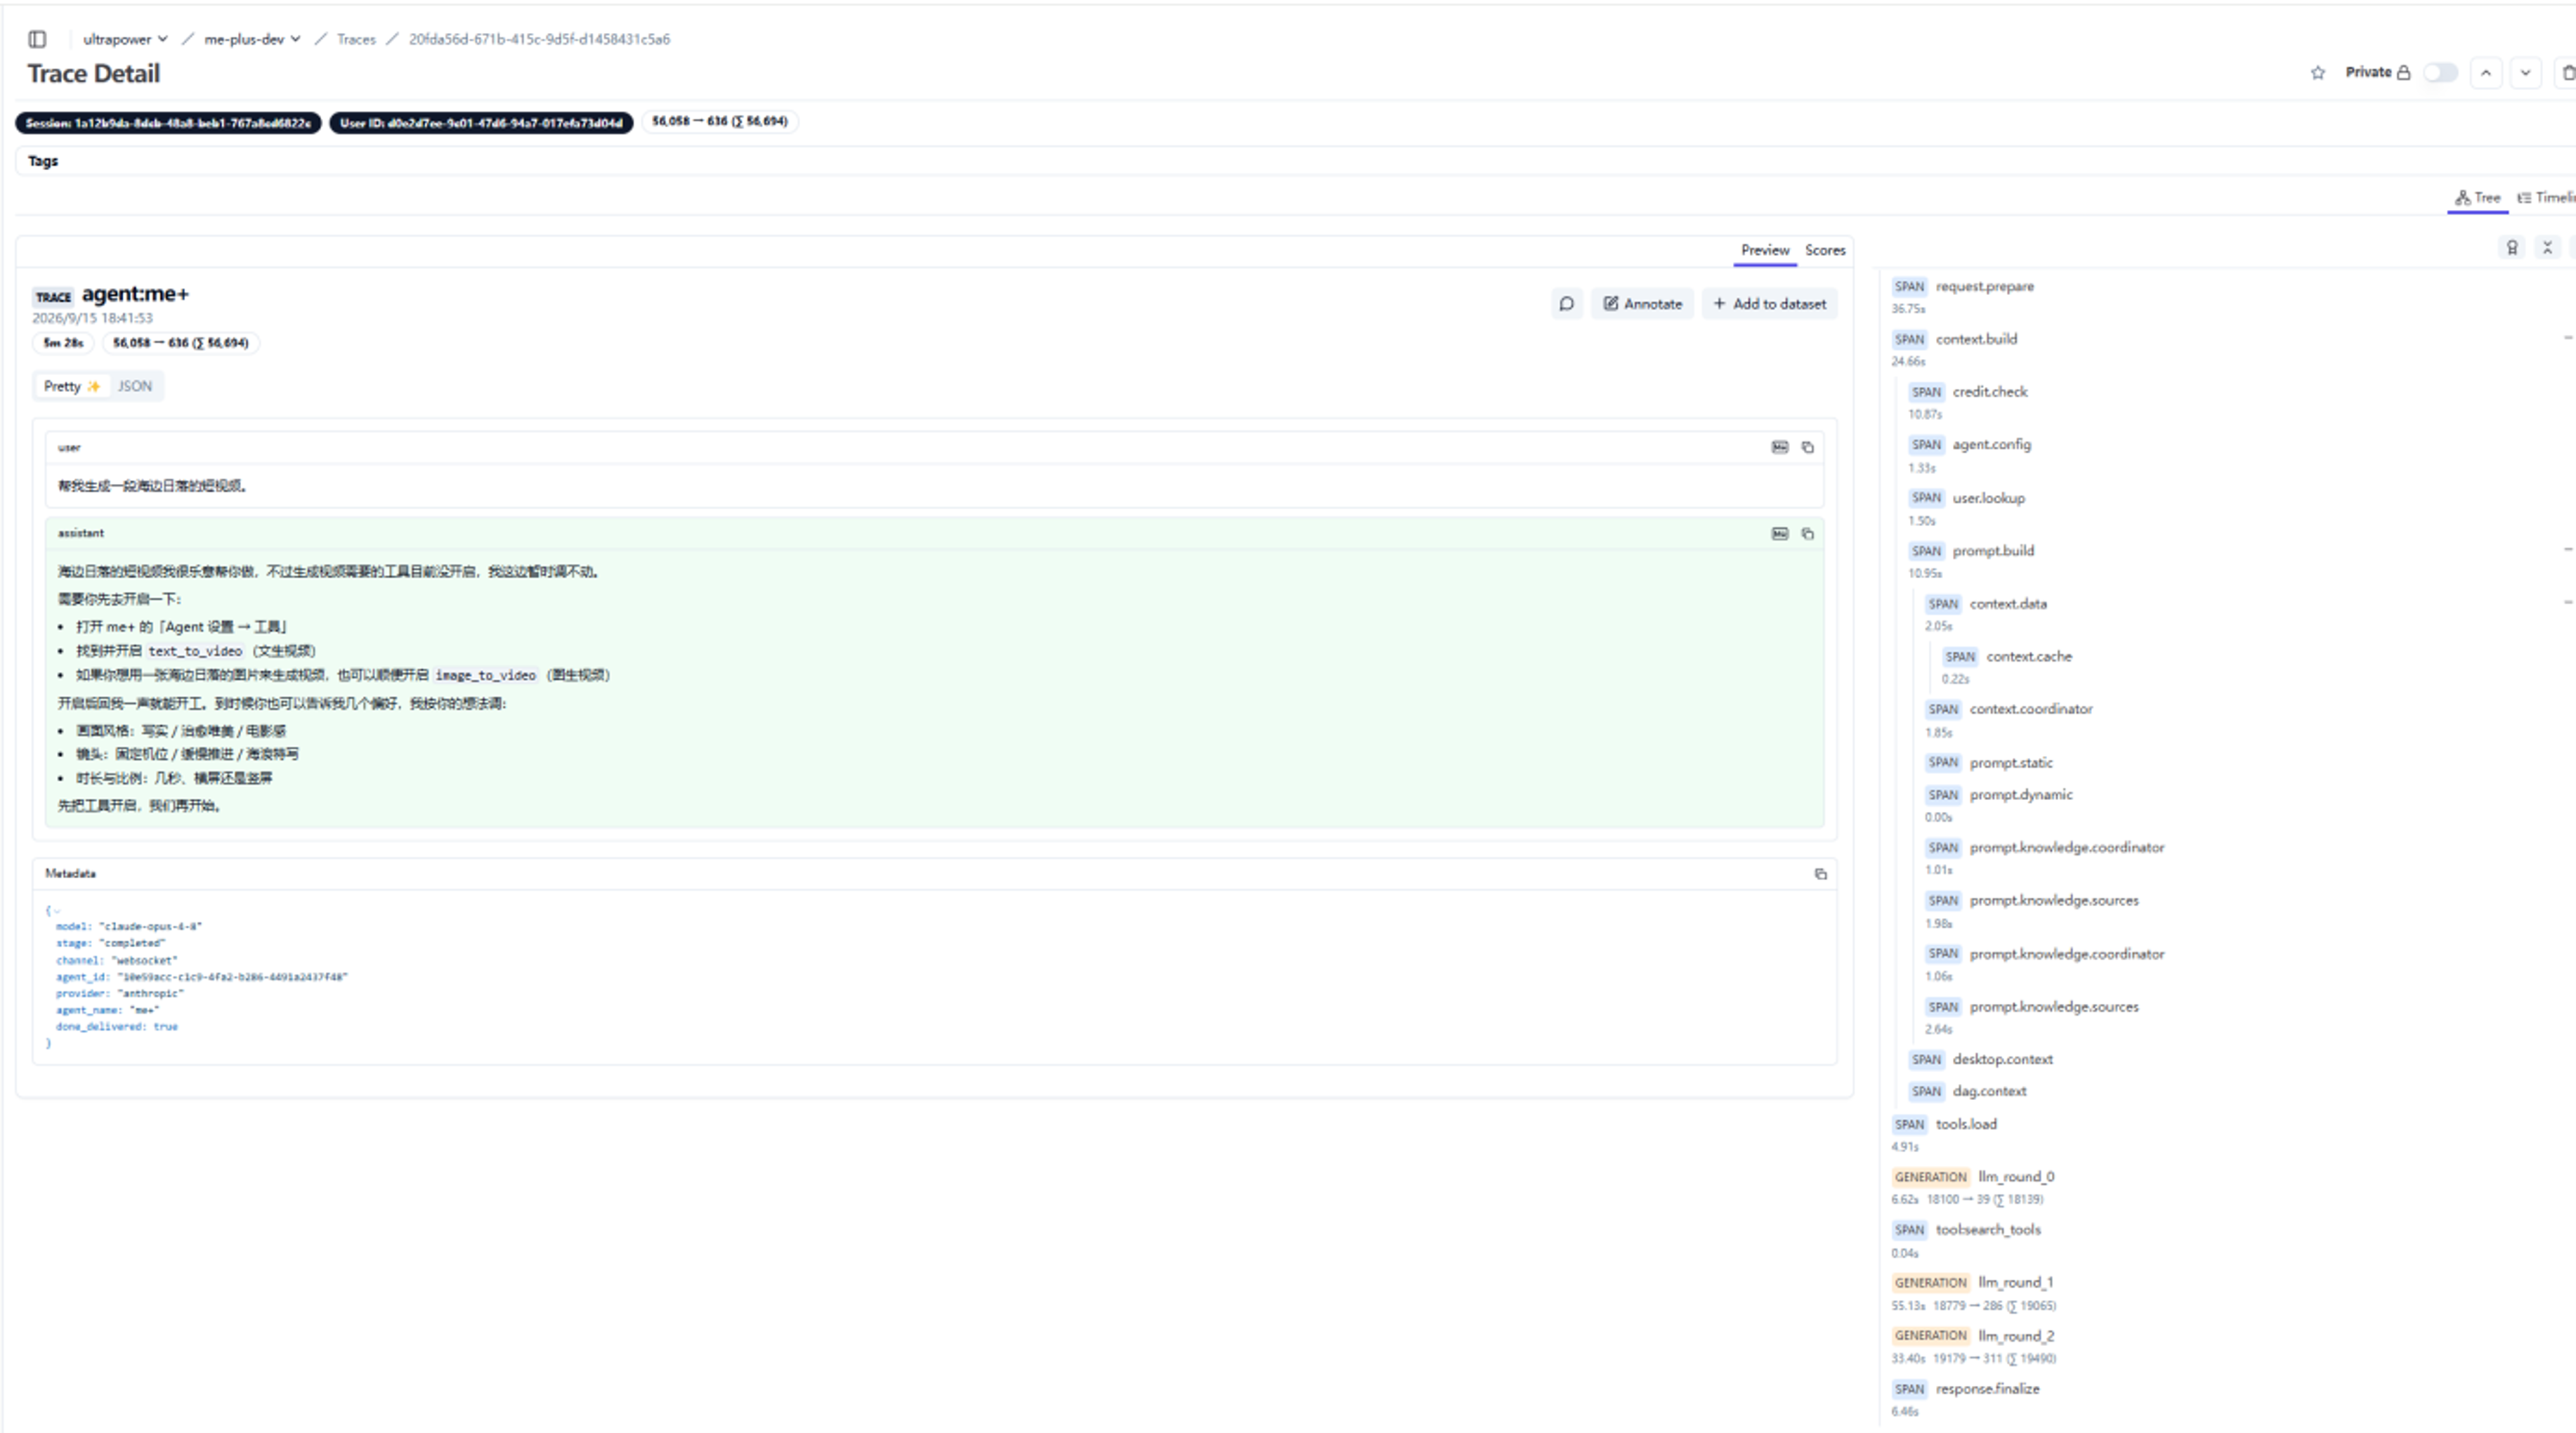
可观测与审计:分三个层次形成完整可观测体系——基础设施层由 Amazon CloudWatch 采集全链路性能指标与日志;操作审计层由 AWS CloudTrail 记录关键 API 操作;
模型调用层由自建的 Langfuse(部署于 ECS Fargate)做 LLM 语义级追踪,记录每次 Bedrock 调用与工具调用的 prompt、completion、token 用量、成本与时延,并支持 Prompt 版本管理与效果评估(Eval / Scoring)。后端以异步方式将 trace 上报 Langfuse,不阻塞业务主链路;trace 数据留在 VPC 内并经 KMS 加密,保障可观测性与合规性。
安全基座:服务运行在 VPC 私有子网内,经安全组做访问控制;访问凭证遵循 IAM 最小权限原则,数据传输与存储由 AWS KMS 加密。
4.5 关键实现
下面以模型推理编排和知识检索增强两个环节为例,给出说明性的实现片段(示意代码,用于阐述实现思路)。
1. 通过 Amazon Bedrock 发起流式推理并支持工具调用
后端使用 AWS SDK for Python(Boto3)调用 Bedrock 的 Converse Stream 接口,实现流式输出与工具调用:
参考:Amazon Bedrock Converse API 与工具调用。
2. 基于 OpenSearch 的混合检索
知识检索环节对同一查询同时执行 BM25 关键词检索与 k-NN 向量检索,并用 RRF(Reciprocal Rank Fusion)融合两路结果:
检索得到的片段作为上下文注入模型 messages,实现检索增强生成(RAG)。参考:Amazon OpenSearch Service 开发者指南。
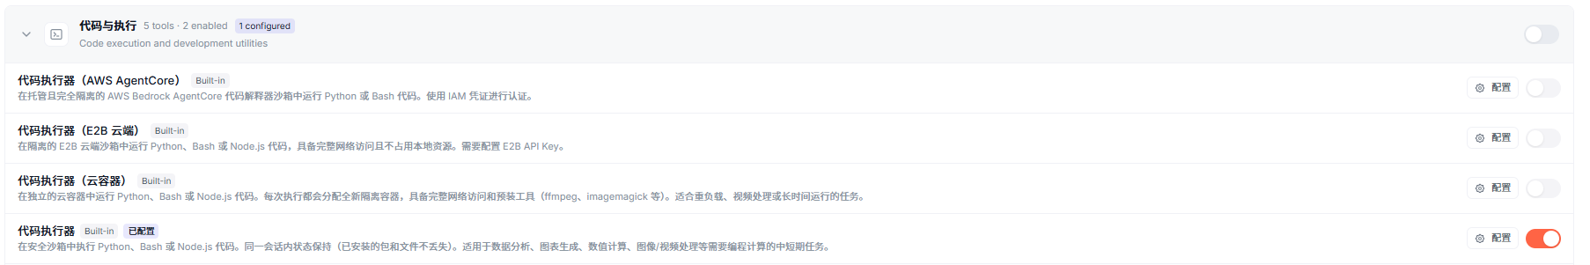
3. Agent 代码执行的隔离
代码执行任务被下发到独立沙箱运行,沙箱使用受限的独立 IAM 角色,与主服务凭证隔离,确保用户代码无法触及主服务权限。这一设计遵循最小权限原则,是平台安全边界的关键一环。
[图 7] |
4.6 经验总结
在基于 AWS 构建 me+ 的实践中,我们沉淀出以下几点经验:
1. 模型层与应用层解耦,按任务复杂度路由模型
将模型调用统一收敛到 Bedrock,通过任务复杂度动态路由到不同模型(Opus/Sonnet),在保证效果的同时优化成本;流式输出显著改善长回答的交互体验。
2. 代码执行必须做任务级隔离
数字员工执行用户代码是天然的高风险面。务必使用独立沙箱 + 独立受限凭证,避免沙箱内代码继承主服务的环境变量与权限。这是安全设计中优先级最高的一环。
3. RAG 用混合检索而非单一向量检索
单纯向量检索在专有名词、精确匹配场景下召回不佳,BM25 + k-NN 混合检索配合 RRF 融合与 Rerank,能显著提升企业知识库场景的检索质量。
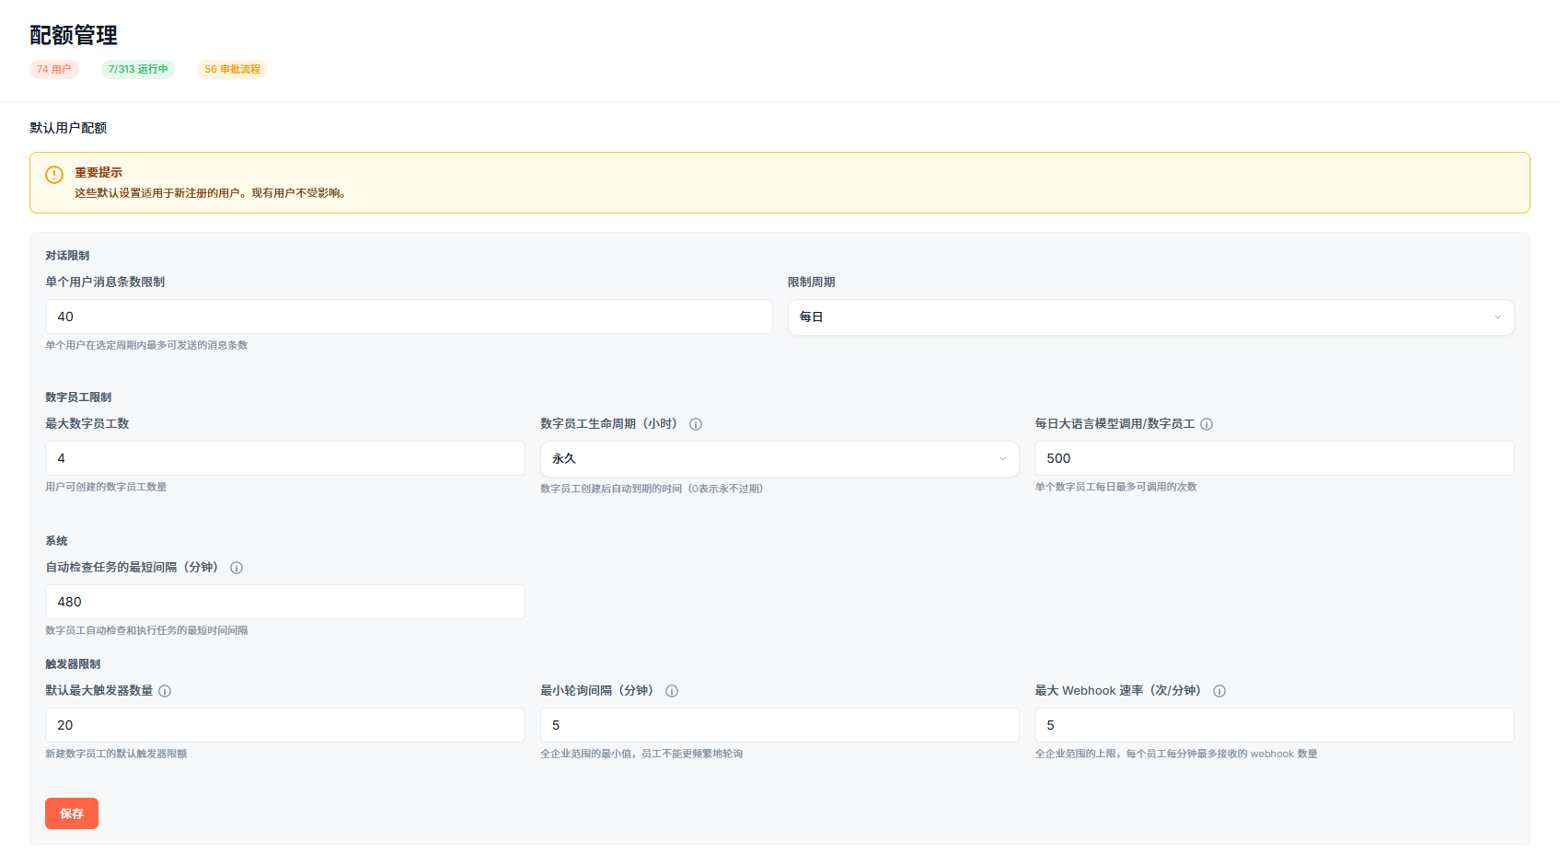
4. 多租户 SaaS 从第一天就要规划隔离与配额
在数据层(RDS 行级/schema 级隔离)、身份层(RBAC)、资源层(配额管理)三个维度同步规划隔离,避免后期改造成本。
[图 8] |
5. 可观测性前置
将 CloudWatch 指标与 CloudTrail 审计、langfuse 在架构设计阶段就纳入,而非上线后补救,能大幅降低故障排查与合规成本。
[图 9] |
五、总结
通过将 me+ 数字员工平台构建在 AWS 之上,我们实现了从”单点 AI 助手”到”可协作的数字员工团队”的跃迁:Amazon Bedrock 免去了自建大模型基础设施的负担,Amazon ECS Fargate 承载了弹性免运维的应用层,隔离沙箱守住了 Agent 代码执行的安全边界,RDS/ElastiCache/OpenSearch/S3 构成完整的数据底座,IAM/KMS/CloudWatch/CloudTrail 与 VPC 网络隔离则提供了企业级的安全与可观测能力。
更重要的是,这套架构让企业能够把撰写文档、故障排查、数据分析等专业能力沉淀为可复用、可协作、可编排的”数字员工”,真正把 AI 嵌入到日常业务流程中,成为组织的长期资产。
说明:本文所述架构为 me+ 在 AWS 上的参考实践架构,具体服务配置需结合企业实际业务规模、合规要求与成本预算进行调整;文中效果与能力描述基于合理的工程假设,不构成对特定业务指标的承诺。
➡️ 下一步行动:
相关产品:
- Amazon Bedrock — 用于构建生成式人工智能应用程序和代理的端到端平台
- Amazon ECS — 完全托管的容器编排服务
- Amazon Fargate — 适用于容器的无服务器计算
- Amazon OpenSearch — 搜索和分析引擎
- Amazon S3 — 适用于 AI、分析和存档的几乎无限的安全对象存储
相关文章:
- 基于 Amazon ECS Fargate 和 Graviton 构建企业级多租户 AI Agent 平台:OpenClaw + Hermes 双 Agent 实践
- 基于 Amazon ECS Fargate 自建 Keycloak 作为 AWS IAM Identity Center 外部 IdP,为 Kiro 提供企业级 SSO 登录
- 构建无服务器Kiro调度平台:用Kiro CLI + EventBridge + ECS Fargate实现定时AI任务
- ECS + CodePipeline 企业轻量级容器化 CI/CD 实战—基于 GitHub + CodePipeline + CodeBuild + ECS Fargate 的全托管容器化部署方案
- 基于SGLang的大模型推理实践——从benchmark方法论到部署方案选型与调优
六、参考资源
相关 AWS 官方文档
- Amazon Bedrock 用户指南
- Amazon Bedrock Converse API 与工具调用
- Amazon Bedrock AgentCore
- AWS Fargate 用户指南
- AWS Lambda MicroVMs 指南
- Amazon CloudFront 开发者指南
- Application Load Balancer 用户指南
- Amazon RDS 用户指南
- Amazon ElastiCache 用户指南
- Amazon OpenSearch Service 开发者指南
- Amazon S3 用户指南
- AWS IAM 最佳实践
*前述特定亚马逊云科技生成式人工智能相关的服务目前在亚马逊云科技海外区域可用。亚马逊云科技中国区域相关云服务由西云数据和光环新网运营,具体信息以中国区域官网为准。
本篇作者
AWS 架构师中心:云端创新的引领者探索 AWS 架构师中心,获取经实战验证的最佳实践与架构指南,助您高效构建安全、可靠的云上应用
|
 |