Amazon Web Services ブログ
はじめての自動推論
本ブログは 2021 年 12 月 1 日に公開された Amazon Science Blog “A gentle introduction to automated reasoning” を翻訳したものです。
2021 年、Amazon Science は研究領域のリストに自動推論を追加しました。この変更を行ったのは、自動推論が Amazon にもたらしている影響が大きいからです。例えば、Amazon Web Services のお客様は現在、IAM Access Analyzer、S3 Block Public Access、VPC Reachability Analyzer といった自動推論ベースの機能を直接利用できます。また、Amazon の開発チームが自動推論ツールを開発プロセスに統合し、製品のセキュリティ、耐久性、可用性、品質の水準を高めている例も見られます。
この記事の目的は、自動推論についてまったく知識はないものの詳しく学んでみたいと考えている業界の実務者に向けて、自動推論をわかりやすく紹介することです。この記事を理解するために必要な前提知識は、短い C と Python のコード断片を読めることだけです。途中でいくつかの専門的な概念に触れますが、あくまで堅苦しくない形で紹介するにとどめます。最後に、さらに深く学びたい方のために、一般に公開されているおすすめのツール、動画、書籍、記事へのリンクを紹介します。
まずは簡単な例から始めましょう。次の C 関数を考えてみてください。
bool f(unsigned int x, unsigned int y) {
   return (x+y == y+x);
}
少し時間を取って、次の質問に答えてみてください。「f が false を返すことはあり得るか?」これはひっかけ問題ではありません。論点を明確にするため、意図的に簡単な例を使っています。
網羅的テストで答えを確認するなら、次の二重にネストしたテストループを実行するという方法が考えられます。このループは、unsigned int 型のあらゆる値の組み合わせに対して f を呼び出します。
#include<stdio.h>
#include<stdbool.h>
#include<limits.h>

bool f(unsigned int x, unsigned int y) {
   return (x+y == y+x);
}

void main() {
   for (unsigned int x=0;1;x++) {
      for (unsigned int y=0;1;y++) {
         if (!f(x,y)) printf("Error!\n");
         if (y==UINT_MAX) break;
      }
      if (x==UINT_MAX) break;
   }
}
残念ながら、最新のハードウェアであっても、この二重ループは非常に長い時間動き続けます。私はこれをコンパイルして 2.6 GHz の Intel プロセッサ上で 48 時間以上実行したところであきらめました。
なぜテストにこれほど時間がかかるのでしょうか。UINT_MAX は通常 4,294,967,295 なので、検討すべき f の呼び出しは 18,446,744,065,119,617,025 通りあります。私の 2.6 GHz のマシンでは、コンパイルされたテストループは f を 1 秒あたり約 4 億 3,000 万回呼び出しました。それでも、この性能で約 1,844 京通りのすべてのケースをテストするには 1,360 年以上かかります。
上記のコードを業界の実務者に見せると、ほぼ即座に、基盤となるコンパイラ/インタープリタとハードウェアが正しく動作する限り f が false を返すことはないという結論に達します。どのようにしてわかるのでしょうか。コードについて推論しているのです。学校で学んだ知識から x + y は y + x と書き換えられることを思い出し、f は常に true を返すと結論づけます。
自動推論ツールは、この作業を私たちの代わりに行います。数学における既知の技法を使って、プログラム (または論理式) に関する問いに答えようと試みるのです。この例であれば、ツールは代数を使って x + y == y + x が単純な式 true に置き換えられることを導出します。
自動推論ツールは、対象領域が無限である場合 (例えば、有限の C の int ではなく非有界の数学的整数の場合) でも、非常に高速に動作することがあります。残念ながら、場合によってはツールが「Don’t know」 (わからない) と答えることもあります。その有名な例は後ほど見ていきます。
自動推論の科学は、本質的にこうした「Don’t know」という回答の頻度を可能な限り下げることに焦点を置いています。ツールが「Don’t know」と報告する (あるいは試行中にタイムアウトする) 頻度が低いほど、そのツールは有用になるのです。
今日のツールは、かつてのツールでは答えられなかったプログラムやクエリに対しても答えを出せるようになっています。明日のツールはさらに強力になるでしょう。この分野では急速な進歩が続いており、だからこそ Amazon ではそこから得られる価値がますます大きくなっています。実際、自動推論の分野でも、Amazon 流の好循環が独自に形成されつつあると考えています。より多くの入力問題がツールに与えられることでツールが改善され、それがツールのさらなる活用を促すのです。
次に、少し複雑な例です。自動推論とは何かの大まかな輪郭がつかめたところで、次の小さな例では、ツールが私たちの代わりにどのような複雑な問題を扱っているのかを、もう少し現実に近い形で見ていきます。
void g(int x, int y) {
   if (y > 0)
      while (x > y)
         x = x - y;
}
あるいは、非有界整数を扱う同様の Python プログラムを考えてみましょう。
def g(x, y):
   assert isinstance(x, int) and isinstance(y, int)
   if y > 0:
      while x > y:
         x = x - y
次の質問に答えてみてください。「g は必ず最終的に呼び出し元へ制御を返すか?」
このプログラムを業界の実務者に見せると、たいていはすぐに正しい答えを導き出します。ただし一部の人、特に理論計算機科学の成果を知っている人は、「これは停止性問題の例であり、解けないことが証明されている」という理由で、この質問には答えられないと誤解することがあります。実際には、このプログラムを含む特定のプログラムについて、停止するかどうかを推論することは可能です。この点については後で詳しく説明します。
この問題を見たとき、ほとんどの業界の実務者が用いる推論は次のとおりです。
- y が正でない場合、実行は関数 g の末尾へ飛びます。これは簡単なケースです。
- ループのすべての反復で変数 x の値が減少するのであれば、最終的にループ条件 x > y が成立しなくなり、g の末尾に到達します。
- x の値が常に減少するのは、y が常に正である場合だけです。そのときにのみ x の更新 (すなわち
x = x - y) が x を減少させるからです。そして y が正であることは条件式によって保証されているため、x は常に減少します。
経験豊富なプログラマーであれば、通常はこの C プログラムの x = x - y という命令でのアンダーフローを心配するでしょう。しかし、x の更新前に x > y が成り立っているため、アンダーフローは起こり得ないことに気づきます。
ここまでの 3 つのステップを自分で追ってみたなら、コンピュータプログラムについて推論する際に自動推論ツールが私たちの代わりにどのような思考を行っているかを、とても直感的に理解できたはずです。実際には、ツールが向き合わなければならない厄介な細部が数多くあります (例えば、ヒープ、スタック、文字列、ポインタ演算、再帰、並行性、コールバックなど)。しかし、これらやその他のトピックを扱う技法については数十年分の研究論文があり、そのアイデアを実際に活用するさまざまな実用的ツールも存在します。
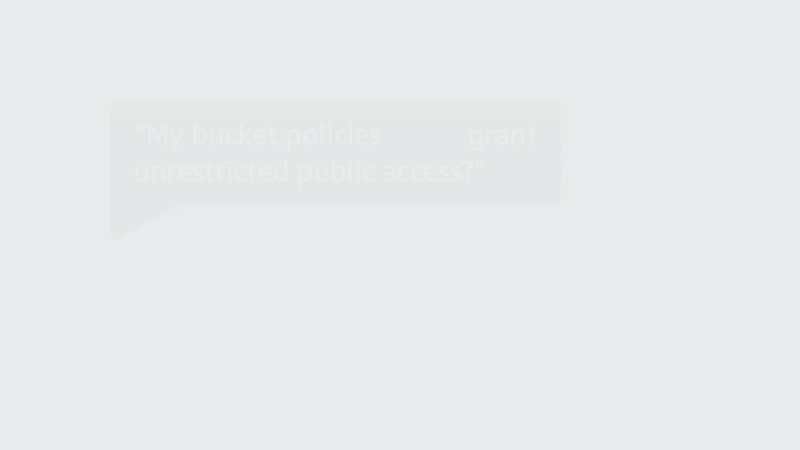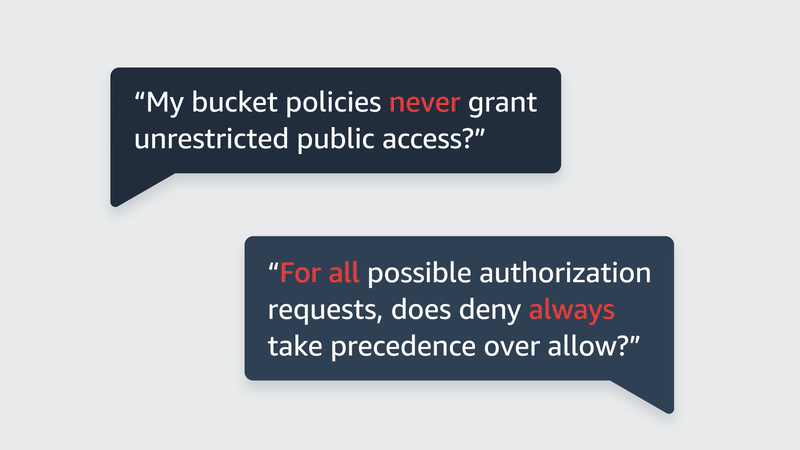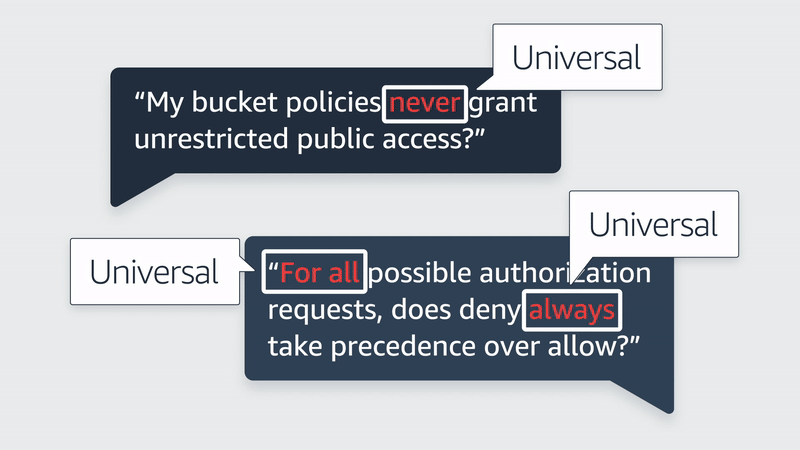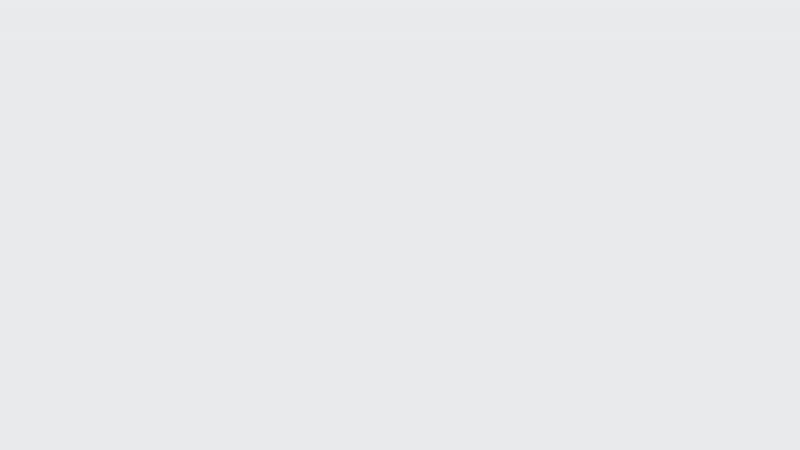
重要なポイントは、自動推論ツールは通常、上記の 3 つのステップを私たちの代わりに実行しているということです。ステップ 1 はプログラムの制御構造についての推論です。ステップ 2 はプログラム内で最終的に真になることについての推論です。ステップ 3 はプログラム内で常に真であることについての推論です。
なお、AWS のリソースポリシー、VPC のネットワーク記述、さらには makefile のような設定アーティファクトも、コードとみなすことができます。この視点に立てば、C や Python のコードについて推論するのと同じ技法を用いて、設定の解釈に関する問いに答えられます。この着想があるからこそ、IAM Access Analyzer や VPC Reachability Analyzer のようなツールが生まれるのです。
テストは不要になるのか?
f と g の例で見たように、自動推論は網羅的テストよりも大幅に高速になる場合があります。今日利用できるツールを使えば、網羅的テストで何世代分もの時間を待つのではなく、f や g の性質をミリ秒単位で示せます。
では、テストツールを捨てて自動推論に移行してよいのでしょうか。そうとは言えません。テストへの依存を大幅に減らすことはできますが、テストを完全になくせる日は、近いうちには来ないでしょうし、そもそも来ないかもしれません。最初の例をもう一度考えてみてください。
bool f(unsigned int x, unsigned int y) {
   return (x + y == y + x);
}
バグのあるコンパイラやマイクロプロセッサが原因で、このソースコードから作られた実行可能プログラムが実際には false を返してしまうかもしれないという懸念を思い出してください。言語のランタイムについても心配する必要があるかもしれません。例えば、C の数学ライブラリや Python のガベージコレクターにバグがあり、プログラムが正しく動作しなくなる可能性もあります。
テストに関して興味深く、しかもしばしば見落とされがちなのは、テストが C や Python のソースコードについて教えてくれるだけではないということです。テストはコンパイラ、ランタイム、インタープリタ、マイクロプロセッサなども同時に検証しています。テストの失敗は、スタック内のいずれのツールに起因していてもおかしくありません。
一方、自動推論は通常、そのスタックのうち 1 つの層 – ソースコードそのもの、あるいは場合によってはコンパイラやマイクロプロセッサ – にのみ適用されます。推論が非常に価値あるものだと感じるのは、検査対象の層について、私たちが知っていることと知らないことの両方を明確に定義できるからです。
さらに、自動推論ツールが用いる周辺環境のモデル (例えばコンパイラや、対象手続きを呼び出す手続き) によって、私たちの前提がきわめて厳密なものになります。計算スタックの層を分離することで、時間、労力、費用と、今日および将来のツールの能力をより有効に活用できます。
残念ながら、自動推論を使う際には、ほとんどの場合、何らかのことについて前提を置く必要があります。例えば、シリコンチップを支配する物理の原理などです。したがって、テストが完全に置き換えられることはありません。前提をできる限り検証するために、エンドツーエンドテストは今後も行うことになるでしょう。
不可能なプログラム
先に、自動推論ツールが「yes」や「no」ではなく「Don’t know」を返すことがあると述べました。また、永遠に実行を続ける (あるいはタイムアウトする) ために、まったく答えを返さないこともあります。ここでは、ツールが「yes」や「no」を返すことができないとわかっている、有名な「停止性問題」のプログラムを見てみましょう。
terminates という名前の自動推論 API があると想像してください。この API は、C 関数が常に停止する場合は「yes」を返し、関数が永遠に実行され得る場合は「no」を返します。一例として、こちらで説明されているツールを使えば、このような API を構築できます (著者自身の過去の研究成果です)。停止性判定ツールが何をしてくれるかを理解するために、2 つの基本的な C 関数を考えてみましょう。1 つは (前述の) g です。
void g(int x, int y) {
   if (y > 0)
      while (x > y)
         x = x - y;
}
もう 1 つは g2 です。
void g2(int x, int y) {
   while (x > y)
      x = x - y;
}
既に述べた理由により、関数 g は常に呼び出し元へ制御を返すため、terminates(g) は true を返すはずです。一方、terminates(g2) は false を返すはずです。例えば g2(5, 0) は決して停止しないからです。
ここで難しい関数が登場します。h を考えてみましょう。
void h() {
   if terminates(h) while(1){}
}
これが再帰的であることに注目してください。terminates(h) の正しい答えは何でしょうか。答えは「yes」ではあり得ません。「no」でもあり得ません。なぜでしょうか。
terminates(h) が「yes」を返すとしましょう。h のコードを読めばわかるように、この場合は h のコード内の条件文が無限ループ while(1){} を実行するため、関数は停止しません。したがってこの場合、terminates(h) の答えは誤りとなります。h は自分自身に対して terminates を呼び出す形で再帰的に定義されているからです。
同様に、terminates(h) が「no」を返すとすれば、h は実際には停止して呼び出し元へ制御を返します。条件文の if の条件が満たされず、else 分岐も存在しないからです。この場合もやはり答えは誤りとなります。だからこそ、このケースでは「Don’t know」という答えが避けられないのです。
プログラム h は、決定可能性に関する Turing の 1936 年の有名な論文や、1931 年のゲーデルの不完全性定理で示された例の変種です。これらの論文が教えているのは、停止性問題のような問題は「解けない」ということです。ただしここで「解ける」とは、解法手続き自体が常に停止し、「yes」か「no」のいずれかを答え、決して「Don’t know」とは答えないことを意味します。しかし、それは私たちの多くが念頭に置いている「解ける」の定義ではありません。多くの人にとっては、ときにタイムアウトしたり、ときおり「Don’t know」と返すことはあっても、答えを返すときには必ず正しい答えを返すツールであれば十分なのです。
この問題は飛行機での移動に似ています。過去に墜落事故が起きており、将来も起きるであろうことは確実なので、100% 安全ではないとわかっています。しかし、無事に着陸したなら、そのときはうまくいったとわかるのです。航空業界の目標は、原理的には避けられないとしても、失敗を可能な限り減らすことです。
これを自動推論の文脈に置き換えると、h のような一部のプログラムについては、「Don’t know」という答えをなくせるほどツールを改善することは決してできません。しかし、今日のツールが「Don’t know」と答えるものの、将来のツールなら「yes」や「no」と答えられるようになるケースは他に数多くあります。自動推論の専門家にとっての現代の科学的な課題は、実用的なツールが「yes」か「no」を返す頻度を可能な限り高めることです。現在進行中の取り組みの一例として、CMU 教授であり Amazon Scholar でもある Marijn Heule 氏によるコラッツの停止性問題を解く挑戦をご覧ください。
もう 1 つ覚えておきたいのは、自動推論ツールが日常的に「計算困難な」問題、例えば複雑性クラス NP に属する問題を解こうとしているという点です。ここでも、停止性問題で見たのと同じ考え方が当てはまります。自動推論ツールは強力なヒューリスティックを備えており、特定のケースでは計算困難性の問題を回避できることがよくあります。しかし、そうしたヒューリスティックは失敗し得ますし (実際に失敗することもあり)、その結果として「Don’t know」という答えや、実用に耐えない長い実行時間が生じます。ヒューリスティックを改善してその問題を最小化することが、この科学の役割です。
用語について
科学文献では、相互に関連するトピックを表すために多くの名称が使われており、自動推論はその 1 つにすぎません。簡単な用語集を示します。
- 論理とは、何が真であり何が真でないかを定義するための形式的かつ機械的な体系です。例: 命題論理や一階述語論理。
- 定理とは、論理において真である命題です。例: 四色定理。
- 証明とは、定理に対する論理上の妥当な論証です。例: Gonthier 氏による四色定理の証明。
- 機械的定理証明器とは、多くの場合人間が書き下した証明を機械可読な形で表現したものを検査する半自動推論ツールです。これらのツールはしばしば人間の手助けを必要とします。例: HOL-light。開発者は Amazon の研究者 John Harrison です。
- 形式的検証とは、コンピュータシステムのモデルに定理証明を適用して、システムの望ましい性質を証明することです。例: 検証済み C コンパイラ CompCert。
- 形式手法とは最も広い意味の用語で、単にシステムのモデルについて論理を用いて形式的に推論することを指します。
- 自動推論は、形式手法の自動化に焦点を置いています。
- 半自動推論ツールとは、ユーザーからのヒントを必要とするものの、論理において妥当な証明を見つけるツールです。
このように、この領域で仕事をする際には呼び名の選択肢がいくつもあります。Amazon では自動推論という呼び方を選びました。自動化とスケールに対する私たちの意欲を最もよく表していると考えているからです。実際には、社内のチームの一部は自動推論ツールと半自動推論ツールの両方を使っています。私たちが採用してきた科学者は、完全自動の推論におけるヒューリスティックが失敗しかねない場面でも、半自動推論ツールを使って成功させられることが多いからです。外部のお客様向け機能については、現在は完全自動のアプローチのみを使用しています。
次のステップ
この記事では、ごく小さなトイプログラム (例示用の簡単なプログラム) を用いて自動推論という考え方を紹介しました。ヒープや並行性を含む現実的なプログラムの扱い方には触れていません。実際には、自動推論のツールと技法は非常に多岐にわたり、中にはかなり狭い領域もありますが、多種多様な領域の問題を解いています。それらすべてと、この分野の数多くの系統や下位分野 (例えば「充足可能性モジュロ理論 (satisfiability modulo theories、SMT) の求解」「高階論理の定理証明」「分離論理」) を説明するには、数千本のブログ記事と書籍が必要になるでしょう。
自動推論の起源は、コンピュータの初期の発明者たちにまで遡ります。そして論理そのもの (自動推論が解こうとしている対象) には数千年の歴史があります。この記事を簡潔に保つため、ここで筆を置き、さらに読むべき資料の紹介に移ります。なお、この分野を深さ優先で読み進めると細部に迷い込みやすく、始めたときより混乱してしまう可能性があります。1 つの側面だけを深く学ぶのではなく、深さを制限した深さ優先探索のアプローチで、さまざまなツールや技法をそれぞれ少しずつ順に見ていき、次へ進むことをお勧めします。
おすすめの書籍
- Handbook of Practical Logic and Automated Reasoning
- Temporal Verification of Reactive Systems
- Decision Procedures
- Model Checking
- Software Foundations
- Specifying Systems
- Introduction to Static Analysis
- Logic in Computer Science: Modelling and Reasoning about Systems
- Functional Algorithms, Verified!
- Handbook of Satisfiability
- The Calculus of Computation
国際会議・ワークショップ
- https://etaps.org/2020/tacas
- https://ijcar2020.org/
- https://popl21.sigplan.org/
- http://smt-workshop.cs.uiowa.edu/
ツールコンペティション
- http://termination-portal.org/wiki/Termination_Competition
- https://sv-comp.sosy-lab.org/2020/
- https://smt-comp.github.io/2020/
- http://www.satcompetition.org/
ツールの例
- AGREE: http://loonwerks.com/tools/agree.html
- Alloy: https://alloytools.org/
- Aprove: https://aprove.informatik.rwth-aachen.de/
- BioModelAnalyzer: https://biomodelanalyzer.com/
- Boogie: https://github.com/boogie-org/boogie.git
- CBMC: https://www.cprover.org/cbmc/
- Checked C: https://plum-umd.github.io/projects/checkedc.html
- Checker Framework: https://checkerframework.org/
- CoCoSim: https://github.com/NASA-SW-VnV/CoCoSim
- Coq: https://coq.inria.fr/
- CPA Checker: https://cpachecker.sosy-lab.org/
- CVC4: https://cvc4.github.io/
- Dafny: https://github.com/dafny-lang/dafny
- Dreal: https://github.com/dreal/dreal4
- HOL light: https://www.cl.cam.ac.uk/~jrh13/hol-light/
- Infer: https://fbinfer.com
- Iris: https://iris-project.org/
- Isabelle: https://isabelle.in.tum.de/
- Java PathFinder: https://github.com/javapathfinder
- JKind: https://github.com/loonwerks/jkind
- KeYmaera X: https://keymaerax.org/
- Kind2: https://kind.cs.uiowa.edu/
- KLEE: https://klee.github.io
- Lean: https://leanprover.github.io/
- MiniSat: http://minisat.se/
- Nagini: https://github.com/marcoeilers/nagini
- P: https://github.com/p-org/P
- PRISM: https://www.prismmodelchecker.org
- PVS: https://pvs.csl.sri.com
- Rosette: http://emina.github.io/rosette/
- Rust プログラミング言語: https://www.rust-lang.org/ [Rust でプログラミングすることは、本質的に型システムの中でメモリ破壊が起こらないことを証明していることになります (unsafe 領域を使用していない場合)]
- Sally: https://github.com/SRI-CSL/sally
- SAW: https://github.com/GaloisInc/saw-script
- SeaHorn: http://seahorn.github.io/
- SMACK: https://smackers.github.io
- Soot: http://soot-oss.github.io/soot/
- SPIN: http://spinroot.com/spin/whatispin.html
- T2: https://mmjb.github.io/T2/
- TLA+: https://lamport.azurewebsites.net/tla/tla.html
- Vampire: https://vprover.github.io/
- VCC: https://github.com/microsoft/vcc
- Verifast: https://github.com/verifast/verifast
- Z3: https://github.com/Z3Prover/z3
自動推論の活用について語る Amazon スタッフへのインタビュー
- Byron Cook PLDI’20 Ask Me Anything
- Byron Cook on The CUBE
- Neha Rungta on The CUBE
- Neha Rungta が AWS Config ルールにおける制約ベースの推論ツールについて語る
- Serdar Tasiran CAV’21 Ask Me Anything
- LogMeIn: How LogMeIn Automates Governance and Empowers Developers at Scale
お客様と業界に向けた AWS の講演
- Automating Compliance Verification on AWS Using Provable Security。AWS のコンプライアンス担当 VP である Chad Woolf と、コンプライアンス監査企業 Coalfire の CEO である Tom McAndrew 氏による講演
- An AWS Approach to Higher Standards of Assurance w/ Provable Security、Byron Cook
- Dive Deep into IAM Access Analyzer。Andrew Gacek 他による講演
- The Evolution of automated reasoning Technology at AWS。AWS のセキュリティ担当 VP である Eric Brandwine による講演
- AWS の CISO 兼セキュリティ担当 VP である Steve Schmidt による、AWS における形式的/制約ベースのツールの開発と活用に関する講演
- AWS re:Invent 基調講演、CTO ワーナー ヴォゲルス
自動推論の科学コミュニティに向けた AWS の発表
- Debugging Network Reachability with Blocked Paths、CAV’21
- Embedded World 2021: Formally Verifying the FreeRTOS IPC Mechanism、Embedded World ’21
- Formal reasoning about the security of Amazon Web Services、FLoC 2018 基調講演
- Formal reasoning about the security of Amazon Web Services、OOPSLA/SPLASH 2018 基調講演
- How I learned to stop worrying and start applying automated reasoning、FACC’21 (その他の関連発表は FACC のウェブサイトをご覧ください)
- On automated reasoning for compliance certification、Formal Approaches to Certifying Compliance (FACC) に関する CAV ワークショップ
- Pre-Deployment Security Assessment for Cloud Services through Semantic Reasoning、CAV’21
- Provable Security at AWS、USENIX Enigma 2019
- [30 分の箇所までスキップしてください]: SideTrail: Verifying Time-Balancing of Cryptosystems
- Stratified abstraction of access control policies、CAV’20
- Verified Cryptographic Code for Everybody、CAV’21
- What is automated reasoning? How Is it Used at AWS?
AWS のブログ記事と解説動画
- A simpler way to assess the network exposure of EC2 instances: AWS releases new network reachability assessments in Amazon Inspector
- AWS CTO による自動推論グループについてのブログ記事: Proving security at scale with automated reasoning
- AWS CTO が S3 の整合性について語る
- AWS ポッドキャストのインタビュー: Provable security podcast: Byron interviews Moshe Vardi
- AWS ポッドキャストのインタビュー: Next Generation Security with automated reasoning, an Artificial Intelligence Technology
- AWS Config アップデート – S3 バケットをセキュアに管理する新しいマネージド ルール。IAM ポリシーに対する自動的な制約解決技法を活用した AWS Config のイベント駆動チェックについて解説しています。さらに詳細はこちら
- 新しい Amazon S3 暗号化 & セキュリティ機能。Amazon Web Services の S3 コンソールにおける、ポリシーに関する制約ベースの推論の活用について解説しています
- ブログ 1、2、3: Galois と協力して、Amazon の暗号インフラストラクチャコンポーネントである s2n の正しさを証明した取り組みについて解説しています
- Chad Woolf (AWS のコンプライアンス担当 VP) が、コンプライアンス認証を簡素化し水準を高めるために自動推論を活用することへの関心について語る
- Daniel Schwartz-Narbonne が、AWS のブートコードにおける証明可能なセキュリティの実現に自動推論がどのように役立っているかを紹介
- How automated reasoning helps us innovate at S3 scale
- How automated reasoning improves Prime Video experience
- How AWS SideTrail verifies key AWS cryptography code
- How AWS uses automated reasoning to help you achieve security at scale
- Jeff Barr による IoT 設定検証ツールの紹介
- 新機能 – VPC Reachability Analyzer
- Zelkova ベースの新しい AWS Config ルール s3-blacklisted-actions-prohibited と bucket-policy-not-more-permissive がリリース
- Podcast: AI tech named automated reasoning provides next-gen cloud security
- Amazon Macie で用いられている制約ベースの IAM ポリシー分析の詳細については、こちらを参照してください
- Tightening application security with Amazon CodeGuru
- Using Formal Methods to validate OTA Protocol
- … その他の AWS ブログ
Amazon Scholar として Amazon と協働する大学教授による講義ノート
- https://courses.cs.washington.edu/courses/cse507/21au/
- http://www.cs.cmu.edu/~mheule/15816-f21/
- https://www.cs.cmu.edu/~mheule/15217-f21/
とっておきの深掘りトピック
今日私たちが使っている自動定理証明器に見られるアルゴリズムの一部は、1959 年にまで遡ります。この年に Hao Wang 氏が自動推論を用いて証明したのは Principia Mathematica の定理です。
本ブログは Security Solutions Architect の 中島 章博 が翻訳しました。