Amazon Web Services ブログ
Agent Skills で Amazon Bedrock の自動推論ポリシーのライフサイクルを自動化
本ブログは 2026 年 8 月 6 日に公開された AWS Blog “Agent Skills for Automated Reasoning policies in Amazon Bedrock” を翻訳したものです。
Amazon Bedrock の自動推論チェック (Automated Reasoning checks) を導入したチームの多くは、ポリシーのライフサイクルをコードで実行したいと考えています。コードで実行すれば、作業の再現性とレビューのしやすさを確保でき、普段使っているコーディングエージェントで進められます。ただし、優れた自動推論ポリシー (Automated Reasoning policy) を作成するにはある程度の習熟が必要で、ライフサイクルにはつまずきやすい制約もあります。ルールは SMT-LIB (自動定理証明器の標準入力形式) のサブセットで記述します。そのうえで、サービスが実際のユーザーの言葉を正しく変換できるようになるまで、変数の説明を調整します。さらに、独自の API と制約を持つビルド、テスト、改善のループを回しながら、ポリシーを仕上げていくことになります。
自動推論チェックは、出力を統計的にサンプリングするのではなく、形式論理に照らして検証するため、こうした労力をかける価値があります。このアプローチにより、AI の回答がルールに準拠していることを数学的な確実性をもって保証できます。以前の記事「Amazon Bedrock の自動推論チェックによる信頼できる AI システムの構築 – パート 1」では、Amazon Bedrock コンソールを使ってこのループを順に説明しました。最初に試すときや、対象分野の専門家と共同作業するときには、コンソールが適しています。
この記事では、Agent Skills のスイートを使用して、Amazon Bedrock の自動推論ポリシーの構築、テスト、デプロイ、検証をコーディングエージェントからエンドツーエンドで行う方法を説明します。また、このスイートを Amazon Bedrock に対して実行して明らかになった、サービスの動作に関する知見も紹介します。
Agent Skills とは?
Agent Skills は、Anthropic が提供する軽量でオープンなフォーマットです。スキルは、専門的な知識とワークフローによってコーディングエージェントの機能を拡張します。その実体は、特定のサービスやドメインを正しく使う方法をエージェントに教える、構造化されたコンテキストパッケージです。これにより、エージェントは、不完全または古い可能性のある一般的なトレーニングデータに頼らずに済みます。各スキルには、検証済みのパターン、避けるべきよくある間違い、ステップバイステップのワークフローが含まれています。このガイダンスがあることで、エージェントはもっともらしい推測ではなく、タスクに適した API 呼び出しを生成できます。フォーマットがオープンなため、スキルは Kiro、Claude Code、Cursor、Codex など、このフォーマットをサポートするあらゆるエージェントにインストールできます。インストール後は、スキルの対象となるタスクをエージェントに依頼すると、スキルが自動的に有効になります。
エージェントが自動推論のライフサイクルに適している理由
自動推論チェックは 2 つのステップで実行されます。この役割分担を理解することが、自動推論チェックを使いこなす鍵です。まず、一連の基盤モデル (FM) が質問と回答を形式論理に変換し、自然言語をポリシー内の変数にマッピングします。次に、SMT (Satisfiability Modulo Theories、充足可能性モジュロ理論) ソルバー、すなわち制約に照らして論理式をチェックする自動推論エンジンが、その論理をルールに照らして検証し、判定を返します。検証ステップは数学的に健全であり、変換が忠実であれば判定は正しくなります。この健全性は、結果の説明可能性も支えています。すべての判定には、その判定を裏付ける、またはそれと矛盾する具体的なルールが併せて返されます。
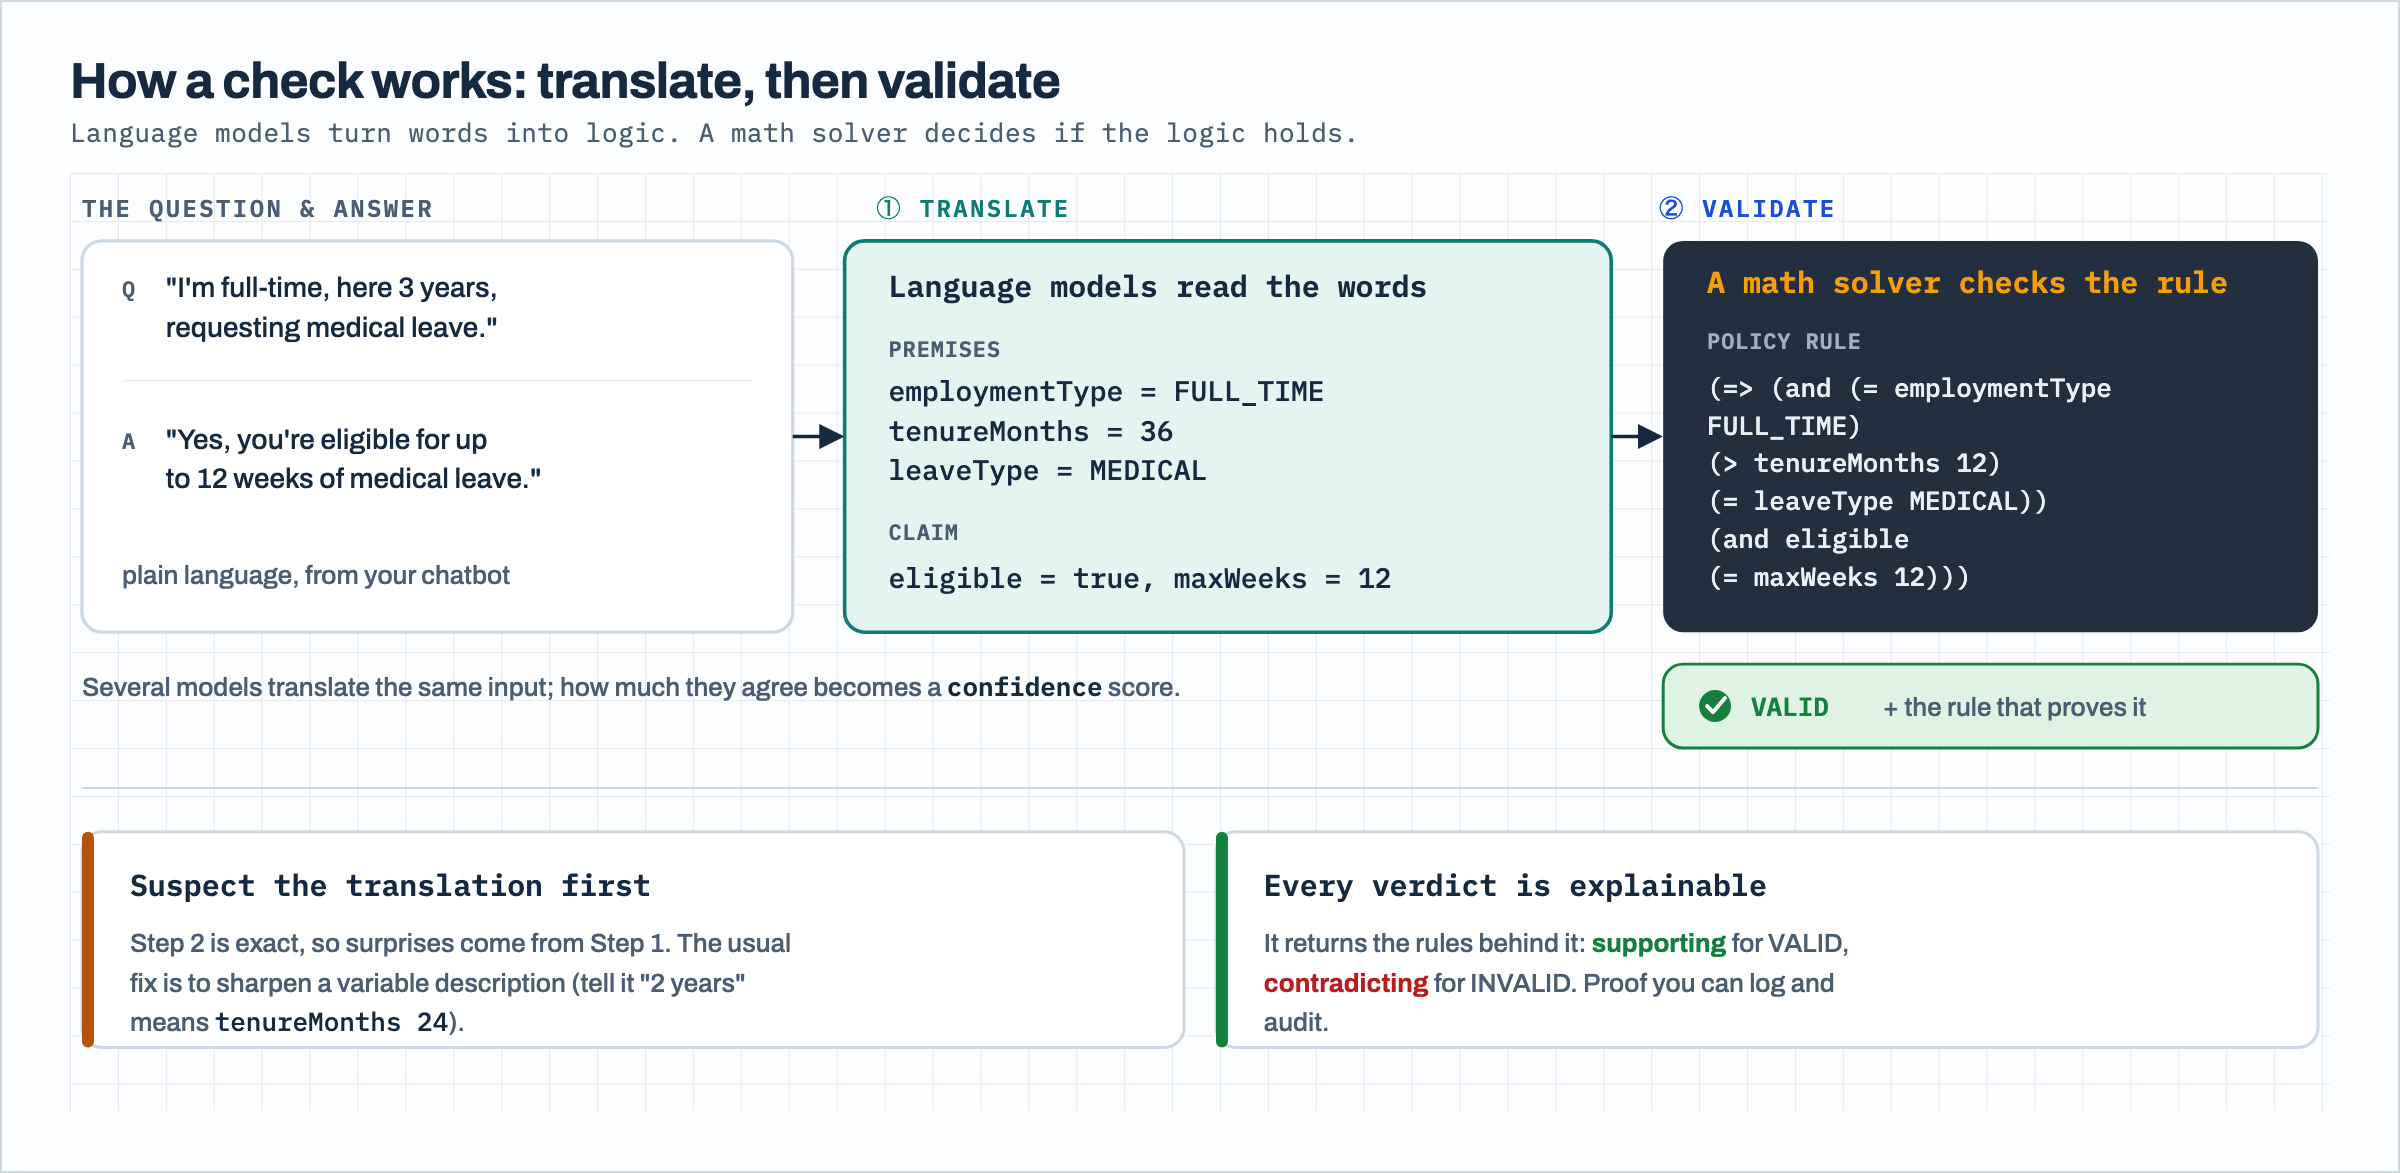
図 1: 自動推論チェックの仕組み
実際に手間がかかるのは、このチェックを取り巻くライフサイクルです。ソースドキュメントからルールを抽出し、サービスが生成した内容をレビューし、ユーザーの実際の質問のしかたを反映したテストを作成し、失敗の原因を診断して、バージョン管理されたポリシーをガードレールに関連付けてデプロイします。各ステップの API 呼び出しにはそれぞれ固有の形式があり、中にはつまずきやすい制約を持つステップもあります。これは、ルールも失敗パターンも明確な、反復的で細部への注意を要する作業です。このような作業こそ、適切な指示を与えればコーディングエージェントが得意とするものです。
ポリシーのライフサイクル全体にわたる 6 つのスキル
このスイートは 6 つの Agent Skills で構成されており、ライフサイクルの各段階に 1 つずつ対応しています。各スキルは、その段階で必要な判断をエージェントに教える短い指示ファイルで、Amazon Bedrock の自動推論 API を呼び出す小さな実行可能スクリプトがそれを支えています。すべてのスキルは、API の仕様、検出結果のタイプ、ルールの構文を説明する 1 つのリファレンスドキュメントを共有しているため、スイート全体でガイダンスの一貫性が保たれます。
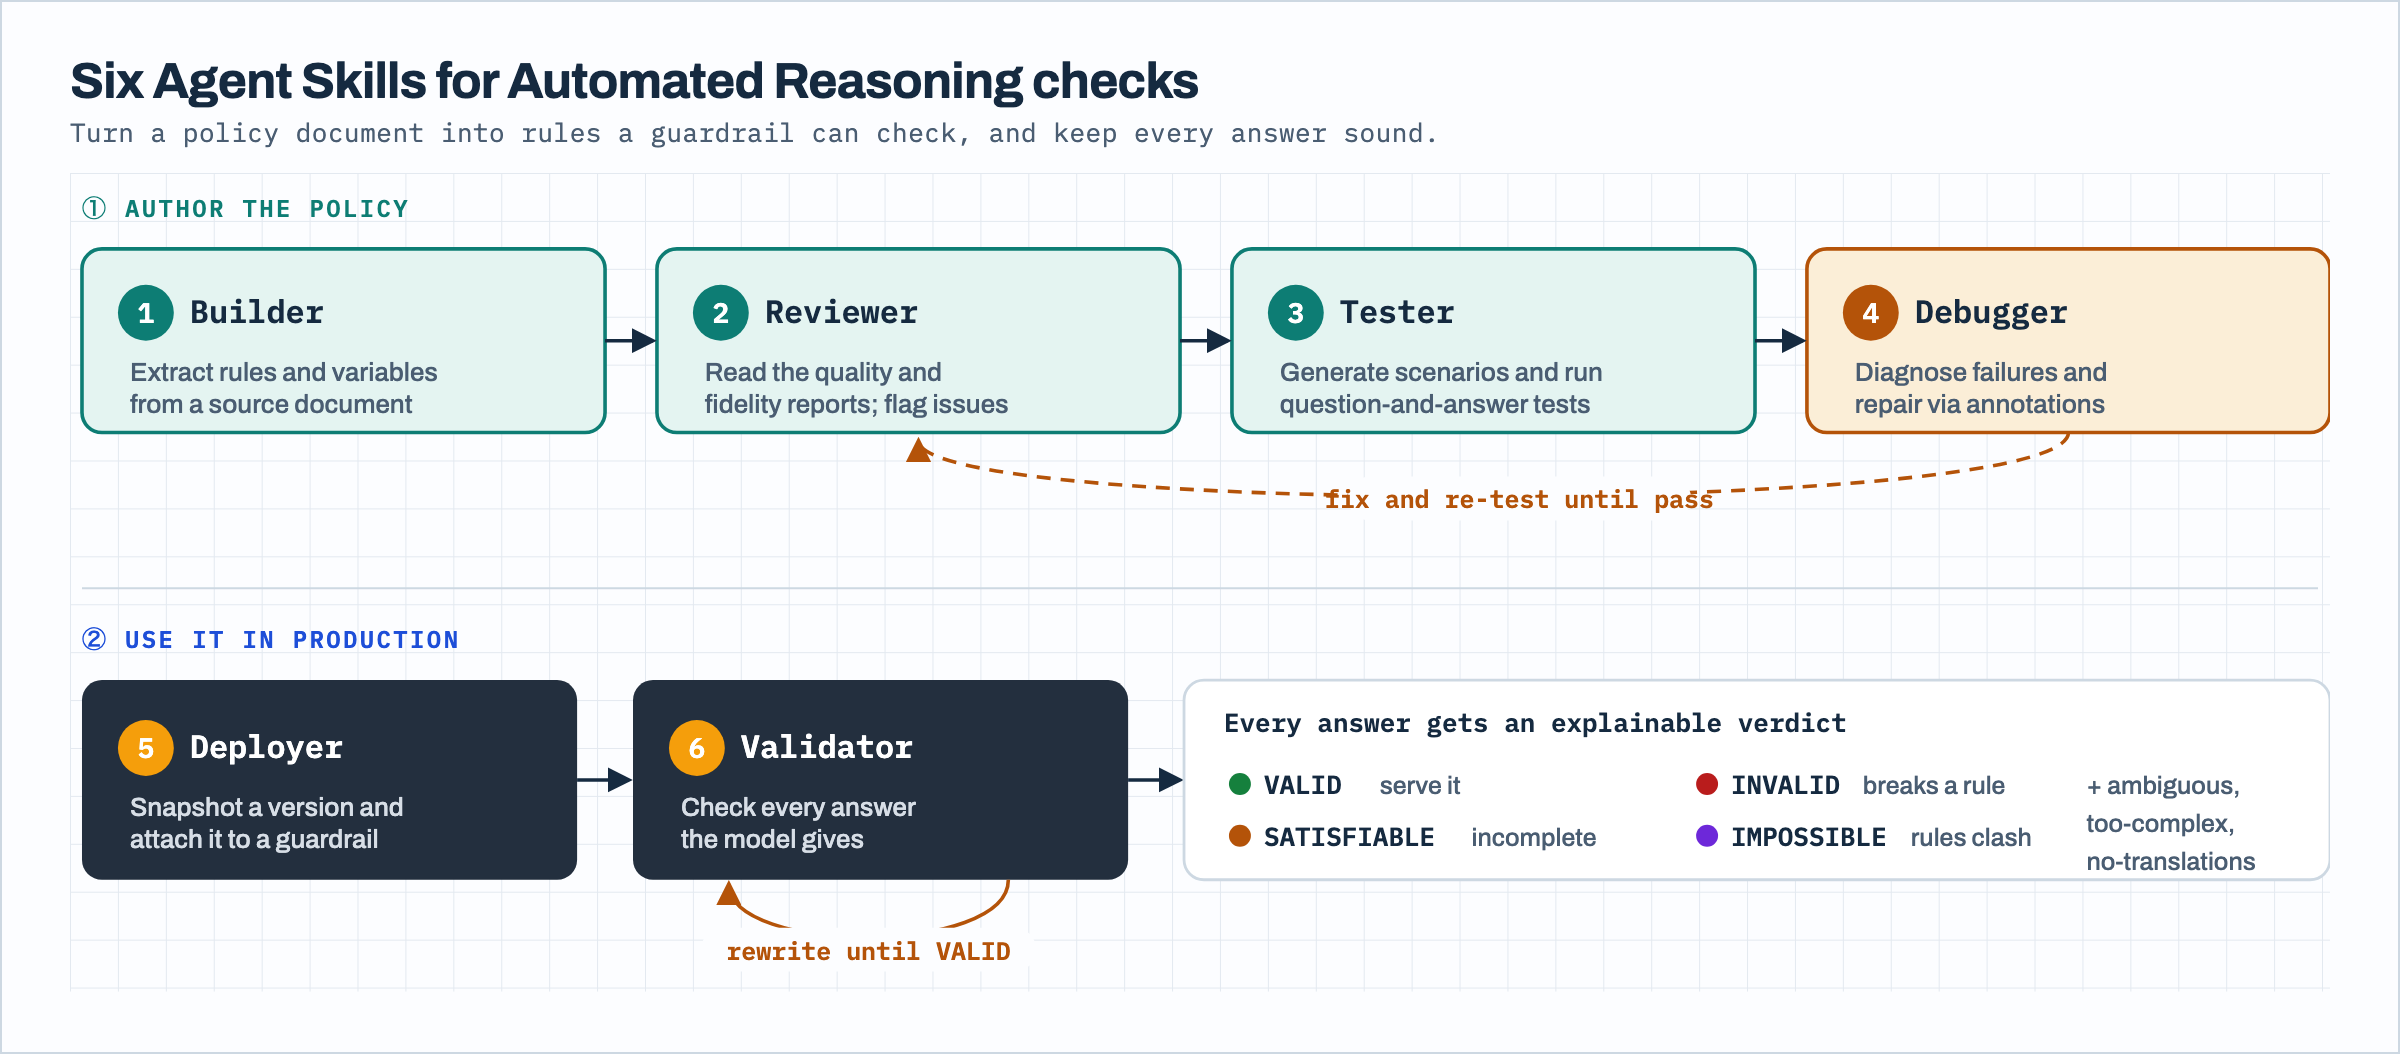
図 2: ポリシーのライフサイクル全体にわたる 6 つのスキル
ポリシーの作成時には、builder スキルがソースドキュメントからポリシーを作成し、ルールと変数を抽出します。reviewer スキルは、ビルドで生成された品質レポートと忠実度レポートを読み取り、ルールの競合、未使用の変数、条件を伴わないアサーションなどの問題を指摘します。tester スキルはシナリオを生成し、質問と回答のテストを実行して、ポリシーが実際の入力を想定どおりに変換および検証できるかを確認します。debugger スキルは失敗を診断してポリシーを修正します。その際は、誤った判定の原因はほぼ常にルールではなく変換にある、という原則に基づいて作業します。
ランタイムでは、deployer スキルがポリシーのスナップショットを番号付きバージョンとして作成し、ガードレールにアタッチします。validator スキルは、ApplyGuardrail API を使用して回答をチェックします。さらに、失敗した回答に矛盾するルールをモデルにフィードバックし、回答の妥当性が確認されるまで繰り返す書き換えループを実行することもできます。
スキルの構成
各スキルは、Agent Skills の標準的なレイアウトに従っています。SKILL.md ファイルには、その段階の中核となる指示が記述されています。これには、スキルを適用するタイミングや、その段階に固有の判断が含まれます。references/ フォルダには、検出結果のタイプやルールの構文など、より深い内容の資料が格納されており、エージェントは詳細が必要なときにだけこれを読み込みます。scripts/ フォルダには、Amazon Bedrock の自動推論 API を呼び出す実行可能な Python コードが格納されています。スクリプトはスタンドアロンで動作し、--help フラグと --dry-run フラグに対応しています。これにより、オペレーションの内容を確認したり、実際に送信されるリクエストを Amazon Bedrock に届く前に検査したりできます。6 つのスキルの基盤となる共有ライブラリは、クライアントの作成、ビルドワークフローのポーリング、検出結果の解析、この記事の後半で説明するビルドスロットの制限の管理といった共通処理を担います。
ポリシードキュメントから検証済みの回答まで
以下のウォークスルーでは、育児休暇の取得資格に関する短い人事ポリシーを例に、ライフサイクル全体を実行します。流れをわかりやすくするために例は簡潔にしていますが、ローンの適格性ポリシーや保険の補償ポリシーなど、回答が明文化されたルールに従う必要がある他のドメインにも同じ手順を適用できます。
前提条件
自動推論チェックが利用可能な AWS リージョンで Amazon Bedrock にアクセスできる AWS アカウント、Amazon Bedrock のコントロールプレーン API とランタイム API に対する権限、スクリプトを実行するための Python と uv が必要です。リージョンごとの機能の提供状況については、Amazon Bedrock ドキュメントの「自動推論チェック」を参照してください。訳注: 2026 年 9 月現在、自動推論チェックがサポートする言語は英語です。最新の対応状況は、Amazon Bedrock ユーザーガイドの「Amazon Bedrock ガードレールの自動推論チェックとは」を参照してください。リポジトリをクローンし、コーディングエージェントにスキルをインストールします。
Claude Code では、スイートをプラグインマーケットプレイスとして追加し、必要なスキルをインストールします。
Kiro、Cursor、Codex など、このオープンフォーマットをサポートする他のエージェントでは、npx でインストールします。
どちらの方法でインストールした場合も、ドキュメントからのポリシー作成や失敗したテストのデバッグなど、対応するタスクをエージェントに依頼すると、スキルが自動的に有効になります。
ポリシーの作成とルールの抽出
まず、ルールを平易な言葉で記述した短いソースドキュメントを用意します。例えば、「勤続 12 か月を超えるフルタイム従業員には育児休暇の取得資格があり、パートタイム従業員には資格がない」といった内容です。builder スキルがポリシーリソースを作成し、ドキュメントから形式的なルールと変数スキーマを抽出するビルドを開始します。
ある実行では、3 文のソーステキストから、ビルドによって 6 つのルール、4 つの変数、1 つのカスタム型が抽出されました。この中には、勤続期間が負の値にならないようにする境界ルールも含まれています。
サービスが生成した内容のレビュー
ルールの抽出は決定論的ではないため、テストの前に結果をレビューします。reviewer スキルは、品質レポートとポリシー定義を取得し、その内容を要約します。
監査では、ルール、変数、型の数が報告され、構造上の問題が重大度別に示されます。このポリシーでは、未使用の変数が 1 つと、他のルールと変数を共有しないルールセット (disjoint rule set) が 1 つ指摘されました。いずれもエラーではなく、検討の余地がある重大度の低い項目です。また、忠実度レポートが作成されなかったことも報告されます。これは、標準のコンテンツビルドでは忠実度レポートが生成されないためです。対象分野の専門家がソースとの対応関係を確認できるビューが必要な場合は、別のビルドタイプを指定して忠実度レポートをリクエストします。
テストの作成と実行
tester スキルは、質問と回答のテストを作成し、完了したビルドに対して実行します。テストでは、ユーザーがたずねそうな質問、モデルが返しそうな回答、想定される判定を指定します。
テストワークフローは、想定される判定と実際の判定、およびそれらが一致したかどうかを返します。このポリシーでは回答が VALID と判定され、実際の結果は想定どおりでした。
ガードレールに関連付けたデプロイと回答の検証
ポリシーがテストに合格したら、deployer スキルが変更不可能な番号付きバージョンとしてスナップショットを作成し、ガードレールにアタッチします。その後、validator スキルが実際の回答をチェックします。
validator スキルは検出結果を返し、チェックが実行されたことを確認します。この例では回答が VALID と判定され、裏付けとなるルールが添付されていました。これが、検証済みの回答の監査証跡として保持する情報になります。
スイートの実行から学んだこと
Amazon Bedrock に対してライフサイクル全体を実行したところ、特に重要な教訓が 2 つ得られました。どちらもスキルの動作に反映されています。
1 つ目は、説明可能性がこの機能の中核にあるということです。すべての判定では、その根拠となるルール、すなわち VALID の回答には裏付けとなるルールが、INVALID の回答には矛盾するルールが返されます。validator スキルはこれらをログに記録します。これにより、検証済みの回答には、許可された理由を示す数学的に検証可能な証明が添えられます。また、拒否された回答については、違反したルールがそのまま書き換えステップに引き継がれます。次の図は、このランタイムの書き換えループを示しています。チェックは VALID 以外の判定を、回答が違反したルールとともに返します。モデルはそのルールを使って回答を書き換え、回答の妥当性が確認されるまでチェックが繰り返されます。
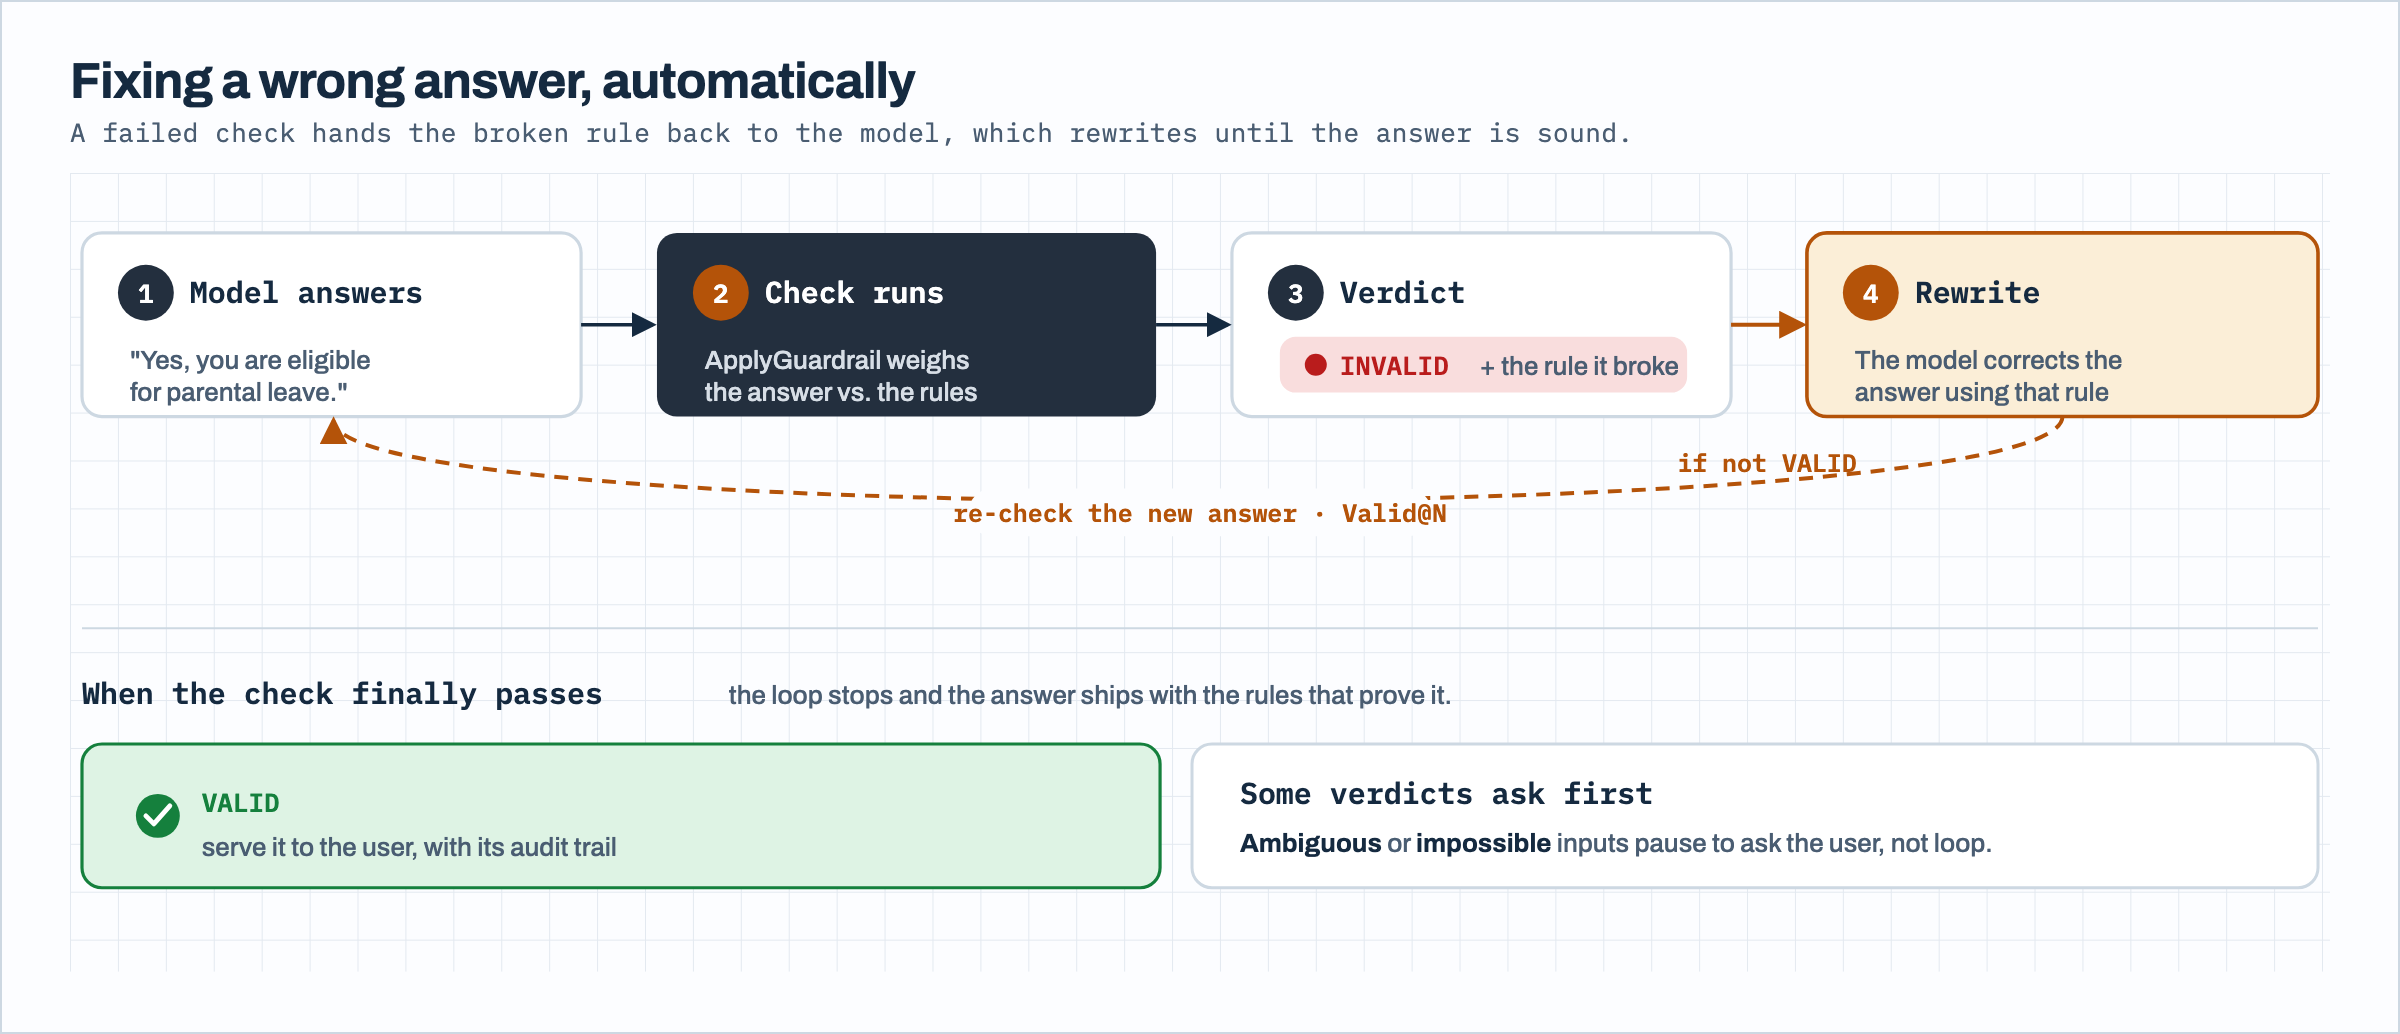
図 3: ランタイムの書き換えループ
2 つ目は、SATISFIABLE という判定は失敗ではないということです。自動推論では、ポリシーと矛盾しない回答と、ポリシーから論理的に導かれる回答を区別します。例えば、「十分な勤続期間を持つフルタイム従業員には資格がある」というルールがあるとします。資格があると主張する回答はポリシーと矛盾しませんが、ポリシーによって証明されるわけではありません。そのため、サービスは VALID ではなく SATISFIABLE を返します。この結果を失敗と解釈すると、正しいルールまで変更してしまうことになります。debugger スキルにはこの区別が組み込まれているため、エージェントはサービスの定義どおりに判定を解釈できます。
スキルが自動的に対処する実用上の制約についても、1 つ触れておきます。1 つのポリシーで同時に実行できるビルドワークフローの数には制限があり、長時間にわたって改善を繰り返すと、この上限に達することがあります。スキルは各ビルドの前に、完了済みの最も古いビルドを削除してスロットを自動的に解放します。そのため、エージェントが複数回の改善を進めても、上限に達して処理が止まることはありません。
クリーンアップ
継続して料金が発生しないように、作成したリソースを依存関係の順序に従って削除します。テストケース、ビルドワークフロー、バージョンのいずれかが残っている間は、ポリシーを削除できないためです。まずテストケースを削除し、次にビルドワークフローと番号付きバージョン、続いてポリシー、最後にガードレールを削除します。スキルでリソースを削除する場合も、この順序に従います。Amazon Bedrock コンソールからすべてのリソースを削除することもできます。
まとめ
自動推論チェックは、AI の回答に対して検証可能かつ説明可能な判定を提供しますが、その判定の品質は背後にあるポリシーによって決まります。この記事で紹介した Agent Skills を使うと、ポリシー作成のライフサイクル全体をコードで扱えるようになります。ポリシーの構築、レビュー、テスト、デバッグ、デプロイ、検証が、コーディングエージェントで実行でき、人がレビューできる反復可能なステップになります。このアプローチは、育児休暇の例や特定のエージェントに限定されません。金融、保険、ヘルスケアなど、さまざまなドメインのポリシーに適用でき、スキルは普段使っているコーディングエージェントにインストールできます。
まずは次の手順から始めてみてください。
- コードリポジトリから、コーディングエージェントにスキルをインストールします。
- builder スキルに独自のポリシードキュメントを指定し、品質レポートをレビューします。
- ユーザーの実際の質問のしかたを反映した質問と回答のテストを追加し、すべて合格するまでポリシーを改善します。
- バージョン管理されたポリシーをガードレールに関連付けてデプロイし、ランタイム用のスキルで回答を検証します。
さらに詳しく知りたい場合は、次の関連リソースを参照してください。
- 「Amazon Bedrock の自動推論チェックによる信頼できる AI システムの構築 – パート 1」(コンソールでのワークフロー)
- 「Amazon Bedrock の自動推論チェックが変える生成 AI のコンプライアンス」(コンプライアンスの観点)
- 「自動推論チェックで回答を書き換えてハルシネーションを抑えるチャットボットのリファレンス実装」(ランタイムのリファレンス実装)
- ドキュメント: 「Amazon Bedrock 自動推論チェックのユーザーガイド」および「Amazon Bedrock API リファレンス」
著者について
本ブログは Security Solutions Architect の 中島 章博 が翻訳しました。